一分钟部署 Llama3 中文大模型,没别的,就是快

LLaMA3大模型技术全网最全解析——模型架构与训练方法(收录于GPT-4/ChatGPT技术与产业分析) 陈巍:本文详细分析了LLaMA3的主要思想、架构与训练方法,适合技术入门与相关领域投资人阅读 阅读详情

前段时间百度创始人李彦宏信誓旦旦地说开源大模型会越来越落后,闭源模型会持续领先。随后小扎同学就给了他当头一棒,向他展示了什么叫做顶级开源大模型。
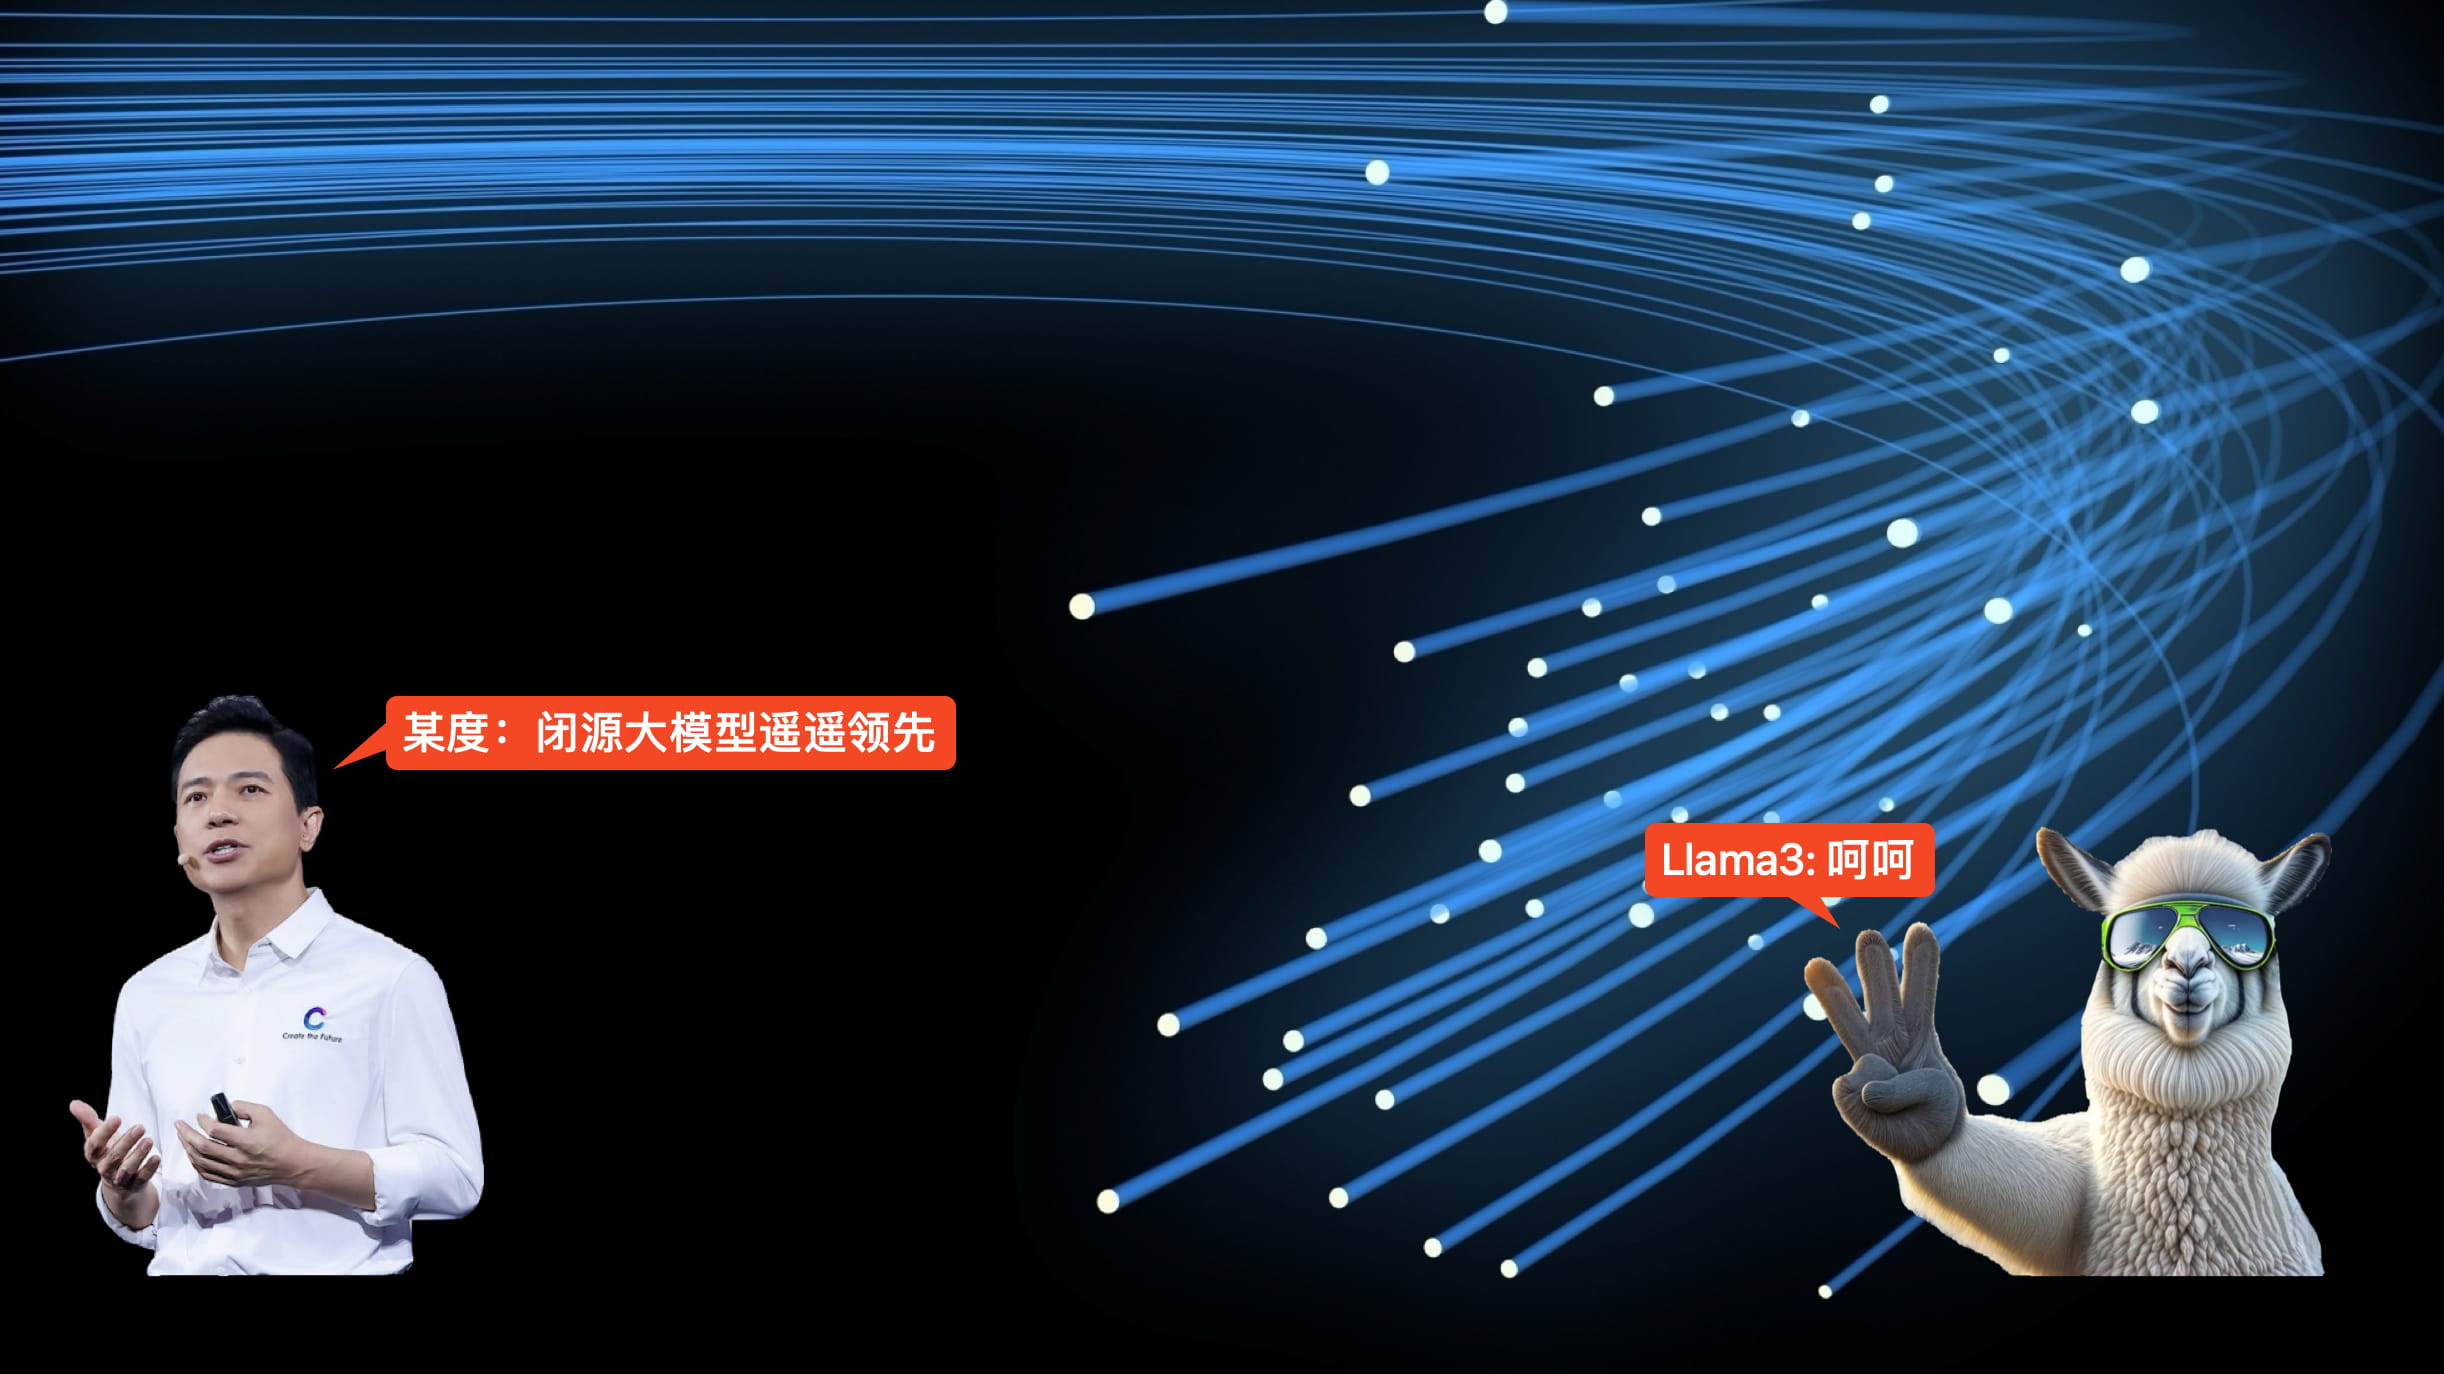
美国当地时间4月18日,Meta 在官网上发布了两款开源大模型,参数分别达到 80 亿 (8B) 和 700 亿 (70B),是目前同体量下性能最好的开源模型,而且直接逼近了一线顶级商业模型 GPT-4 和 Claude3。
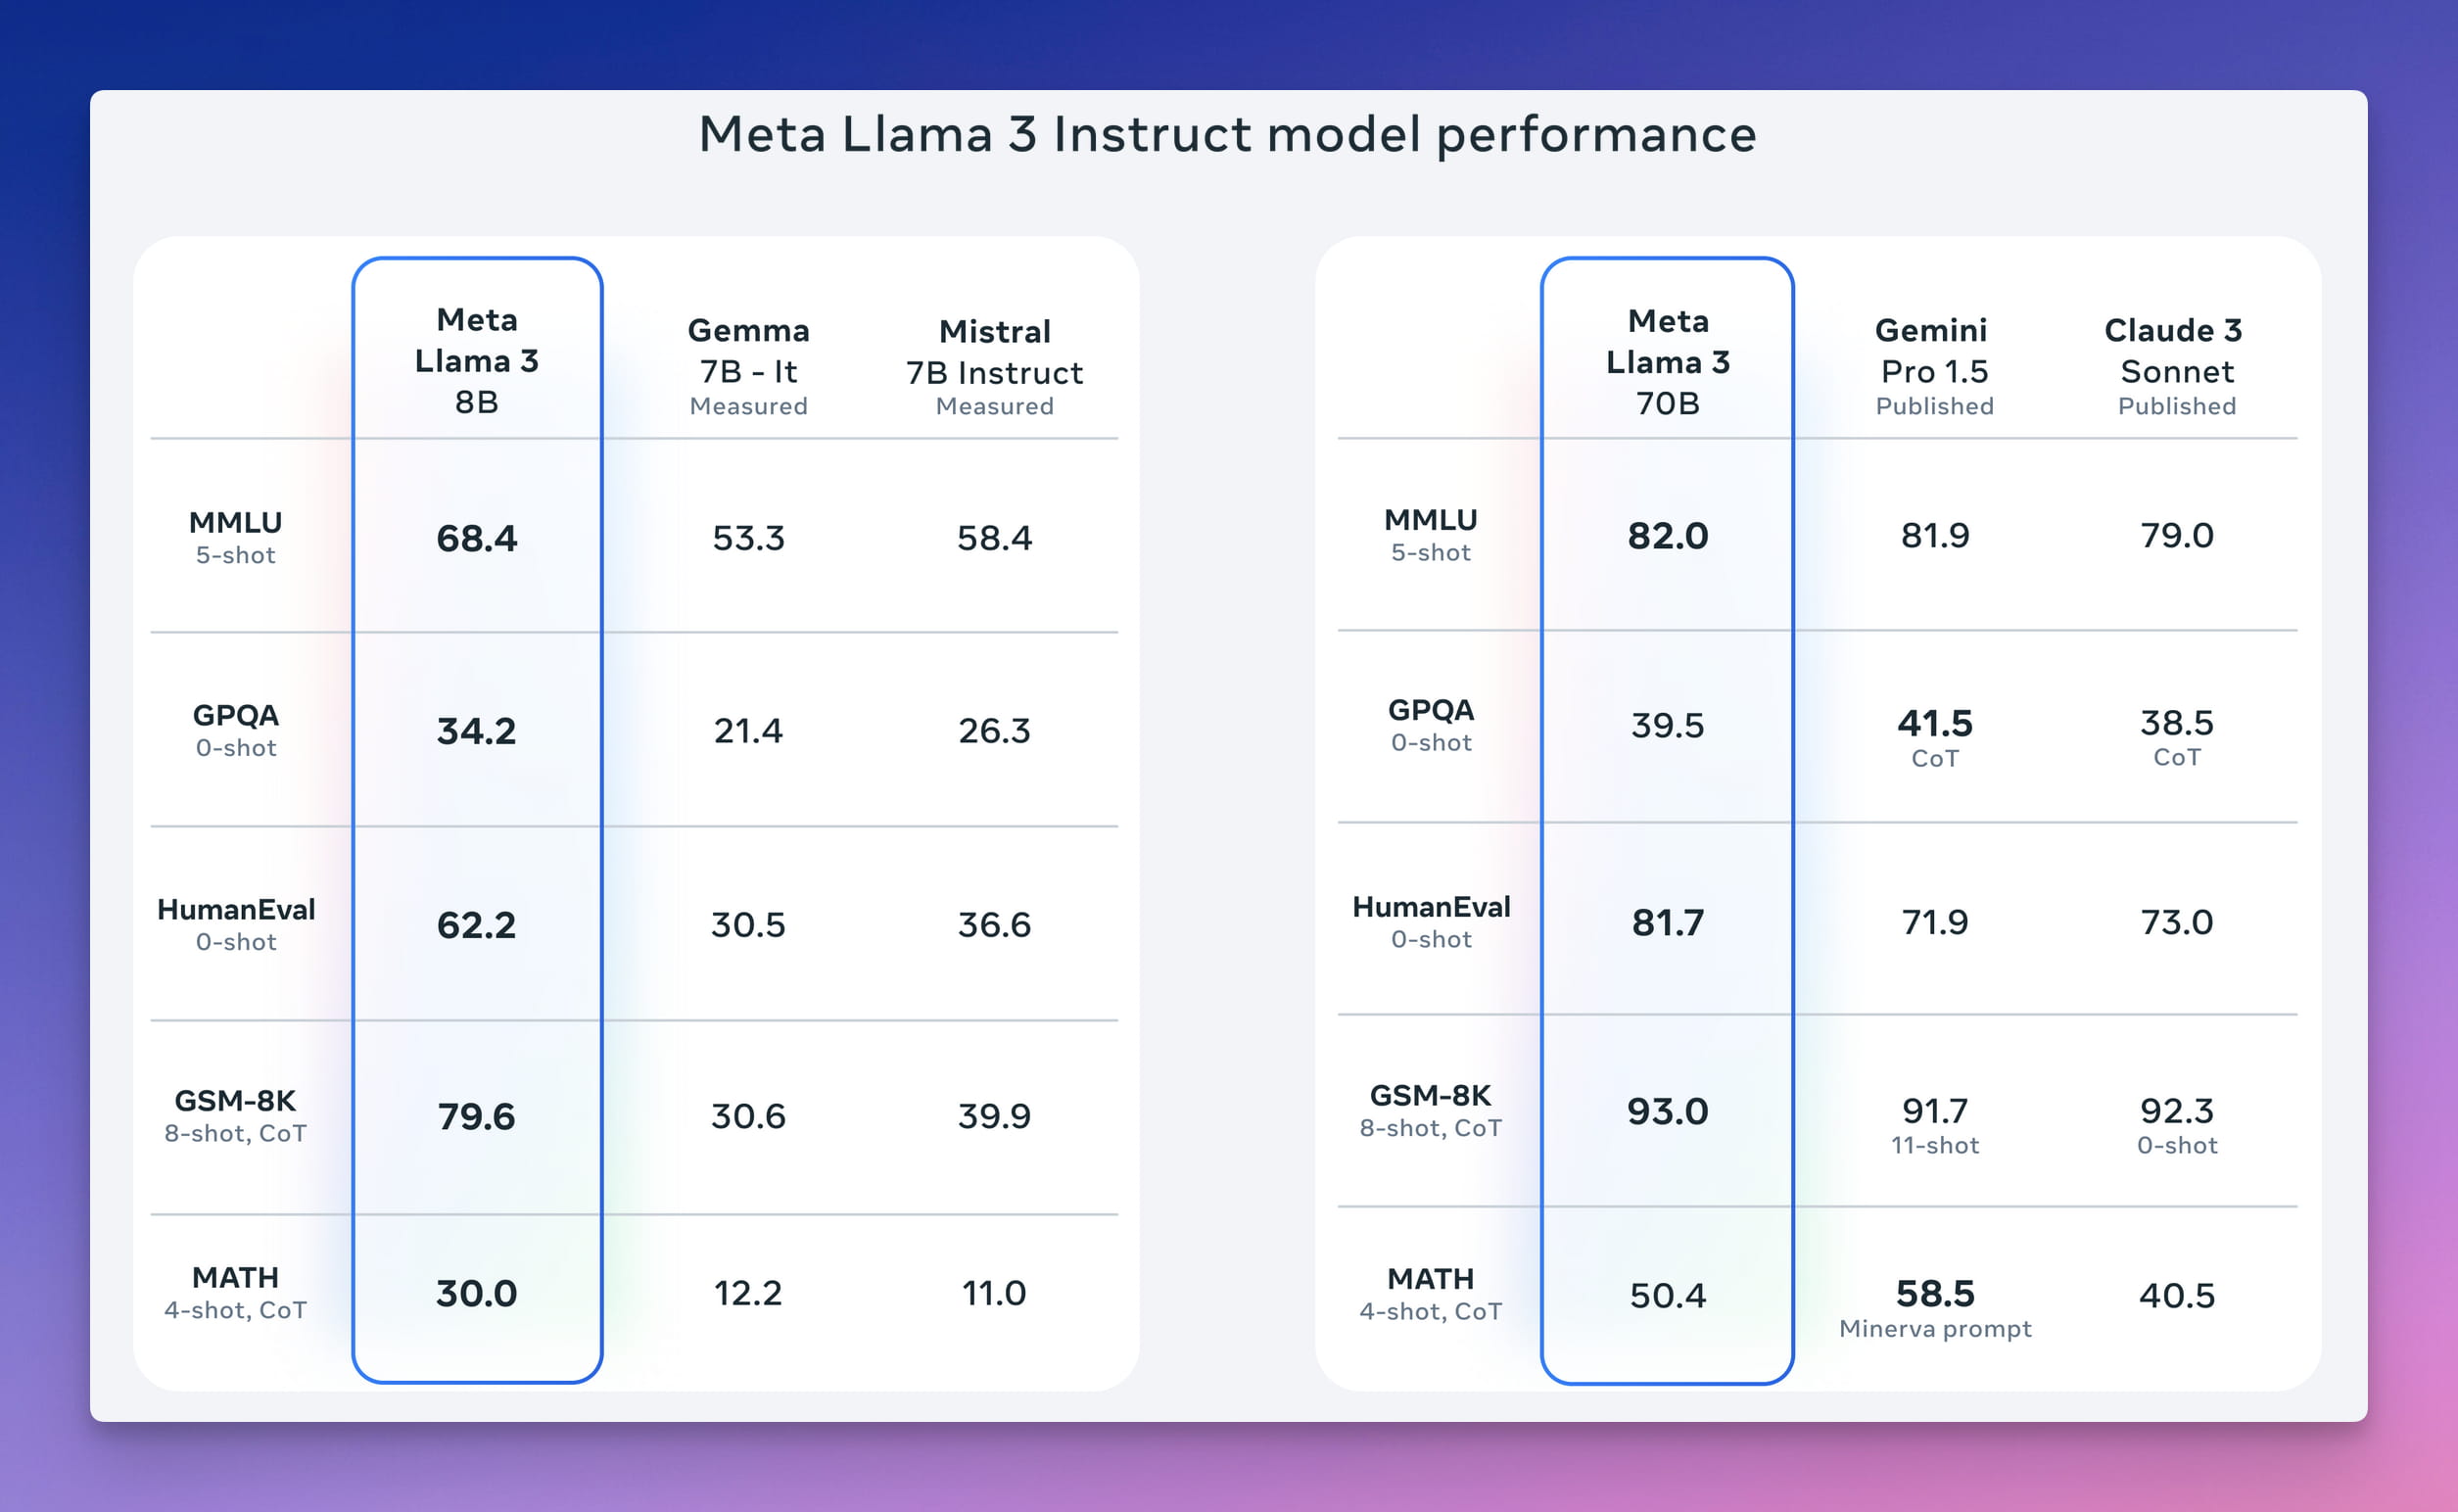
与此同时,还有一个 400B 的超大杯模型还在路上,估计很快就会放出来,到时候就真的碾压了,某些声称闭源遥遥领先的哥们就等着哭吧 😢

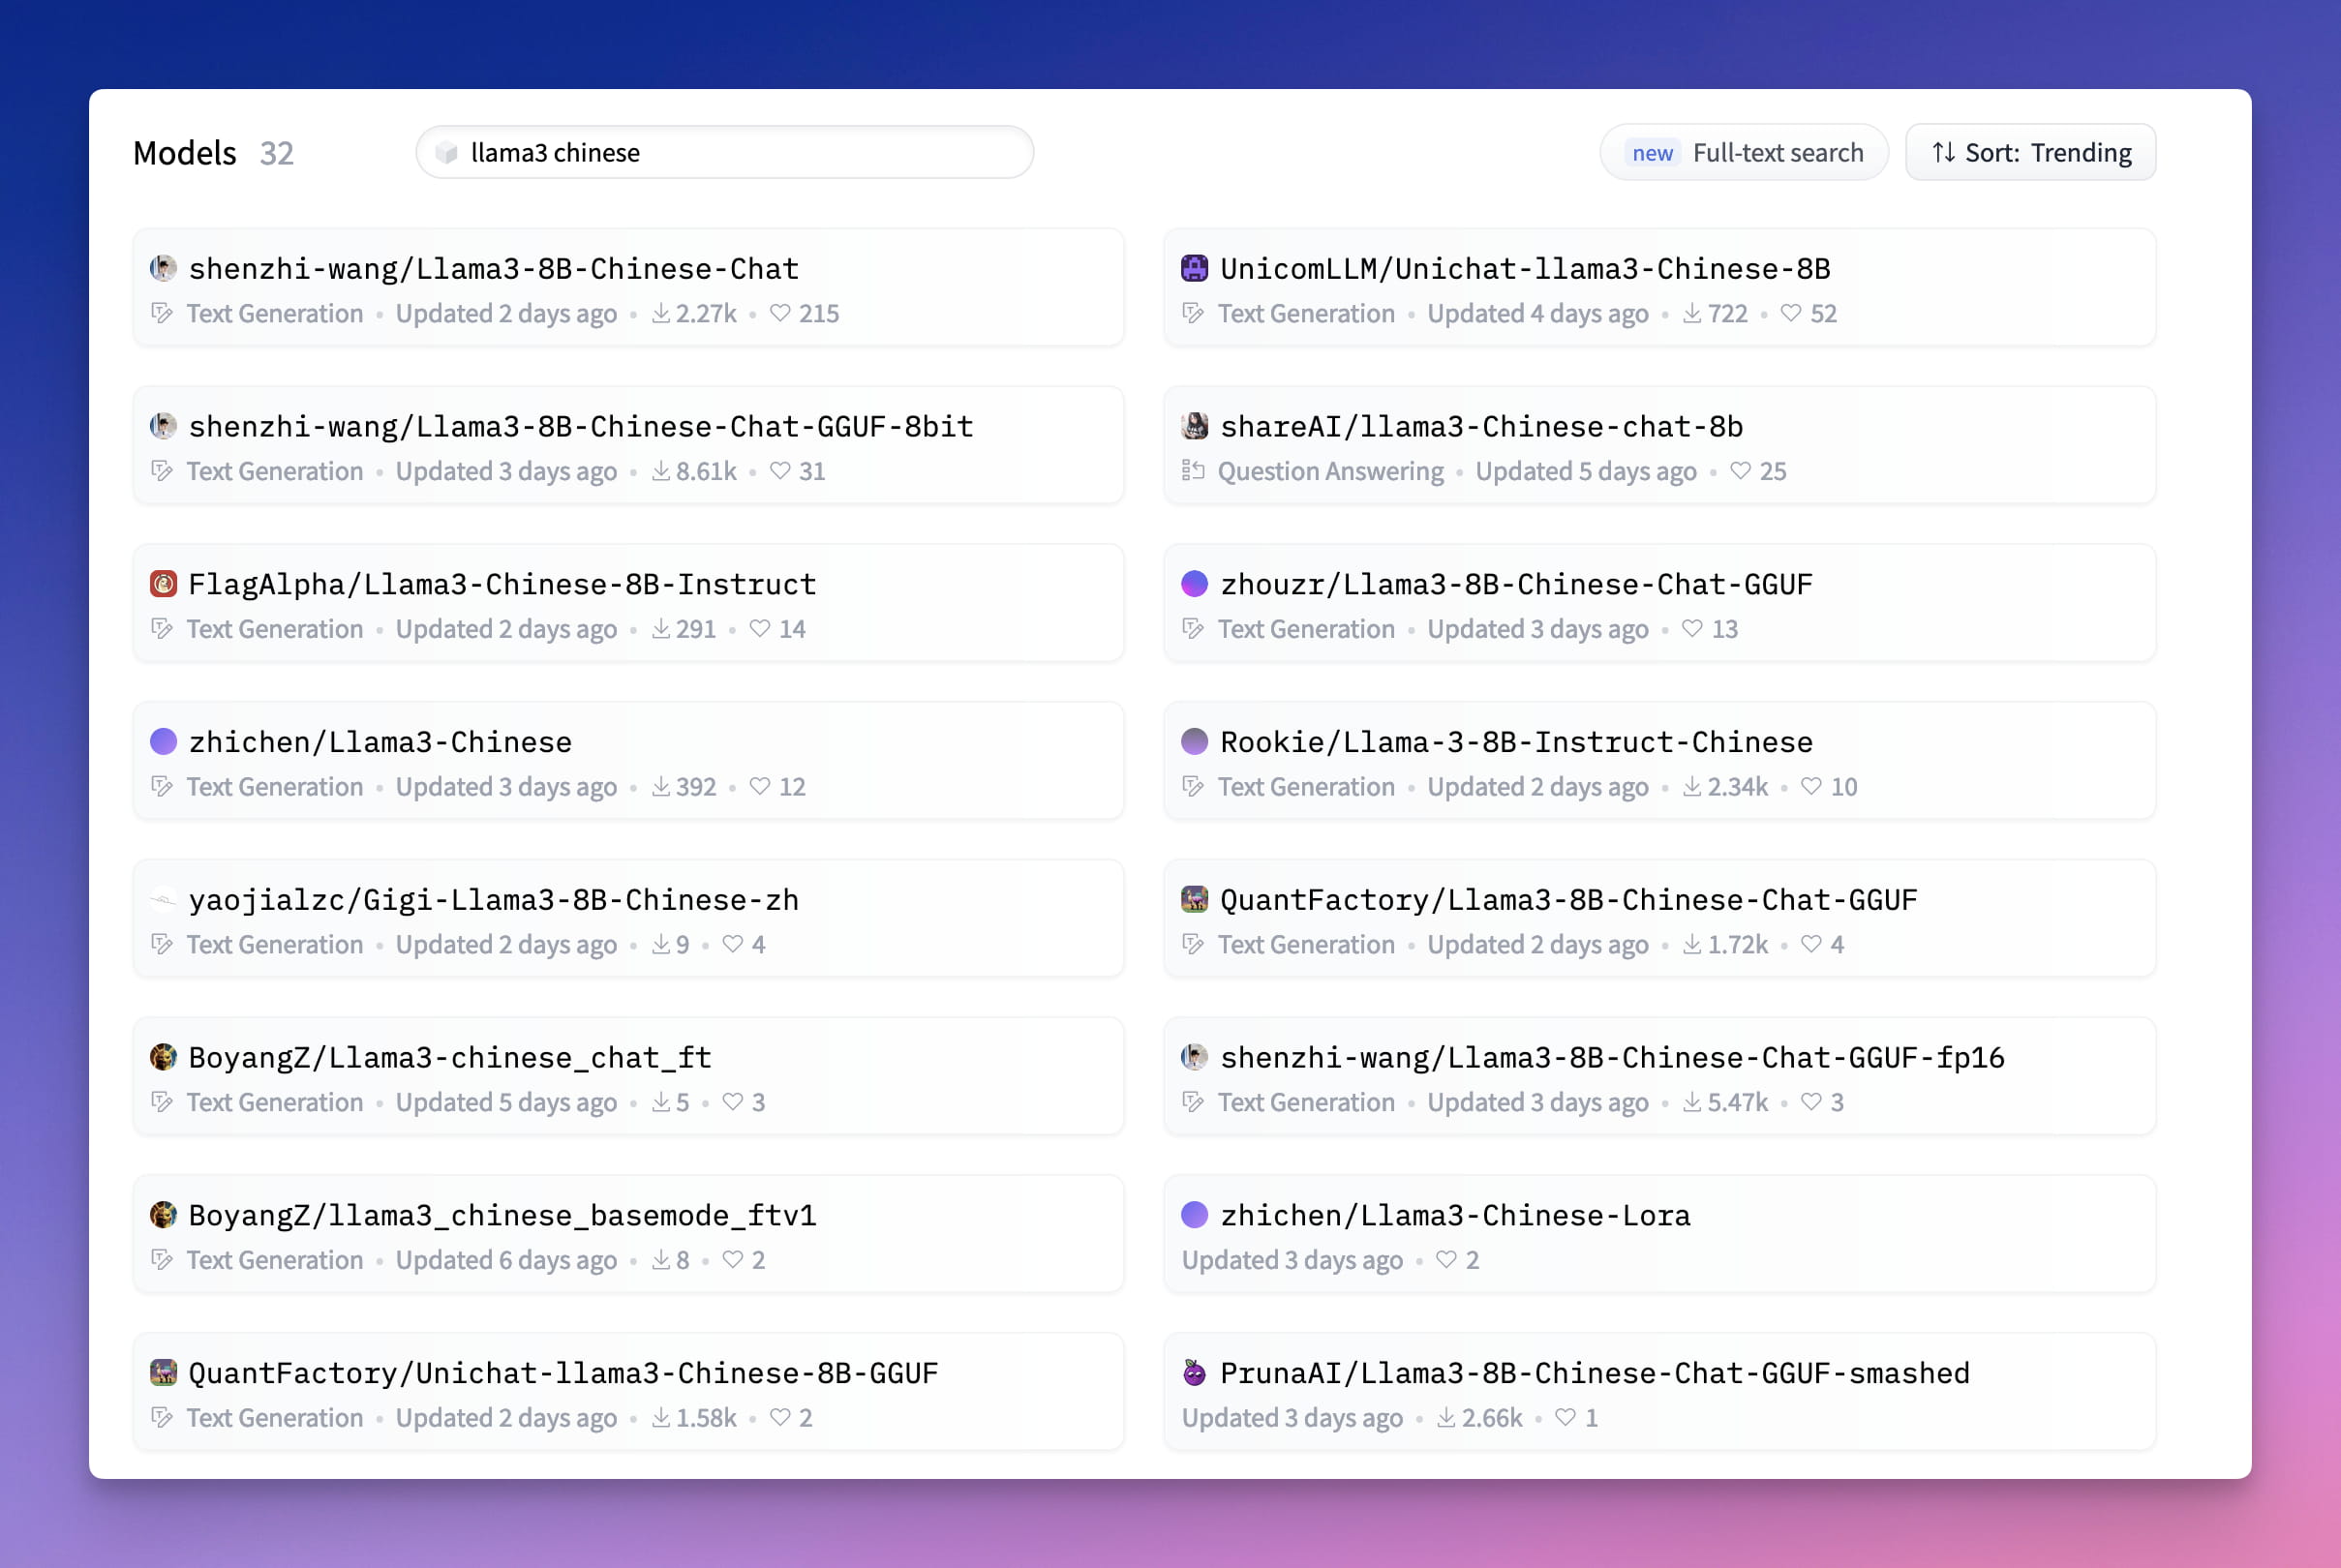
虽然才过去短短几日,Huggingface 上已经涌现了非常多的 Llama3 中文微调版,令人眼花缭乱:
想不想自己也部署一个 Llama3 中文版?

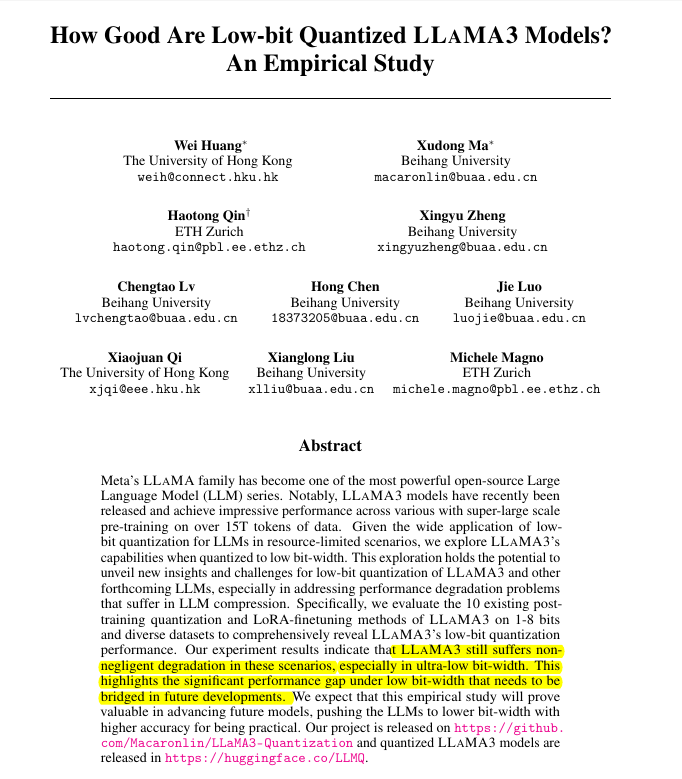
对于没有 GPU 的同学,我们可以使用微调的量化模型来使用 CPU 运行。不同的量化方法会带来不同的性能损失:

  1. 8bit 量化没有性能损失。
  2. AWQ 4bit 量化对 8B 模型来说有 2%性能损失,对 70B 模型只有 0.05%性能损失。
  3. 参数越大的模型,低 bit 量化损失越低。AWQ 3bit 70B 也只有 2.7%性能损失,完全可接受。

综合来说,如果追求无任何性能损失,8B 模型用 8bit 量化,70B 模型用 4bit 量化。

如果能接受 2-3%损失,8B 模型用 4bit 量化,70B 模型用 3bit 量化。
目前效果最好的中文微调版是 HuggingFace 社区的 zhouzr/Llama3-8B-Chinese-Chat-GGUF 模型,该模型采用 firefly-train-1.1M、moss-003-sft-data、school_math_0.25M、弱智吧(没错,就是那个弱智吧~)数据集,使模型能够使用中文回答用户的提问。

下面我们来看看如何在三分钟内快速部署这个模型吧。

直接在浏览器中打开以下链接:

然后点击右上角的「去 Sealos 部署」。

如果您是第一次使用 Sealos,则需要注册登录 Sealos 公有云账号,登录之后会立即跳转到模板的部署页面。

跳转进来之后,点击右上角的「部署应用」开始部署,部署完成后,直接点击应用的「详情」进入该应用的详情页面。
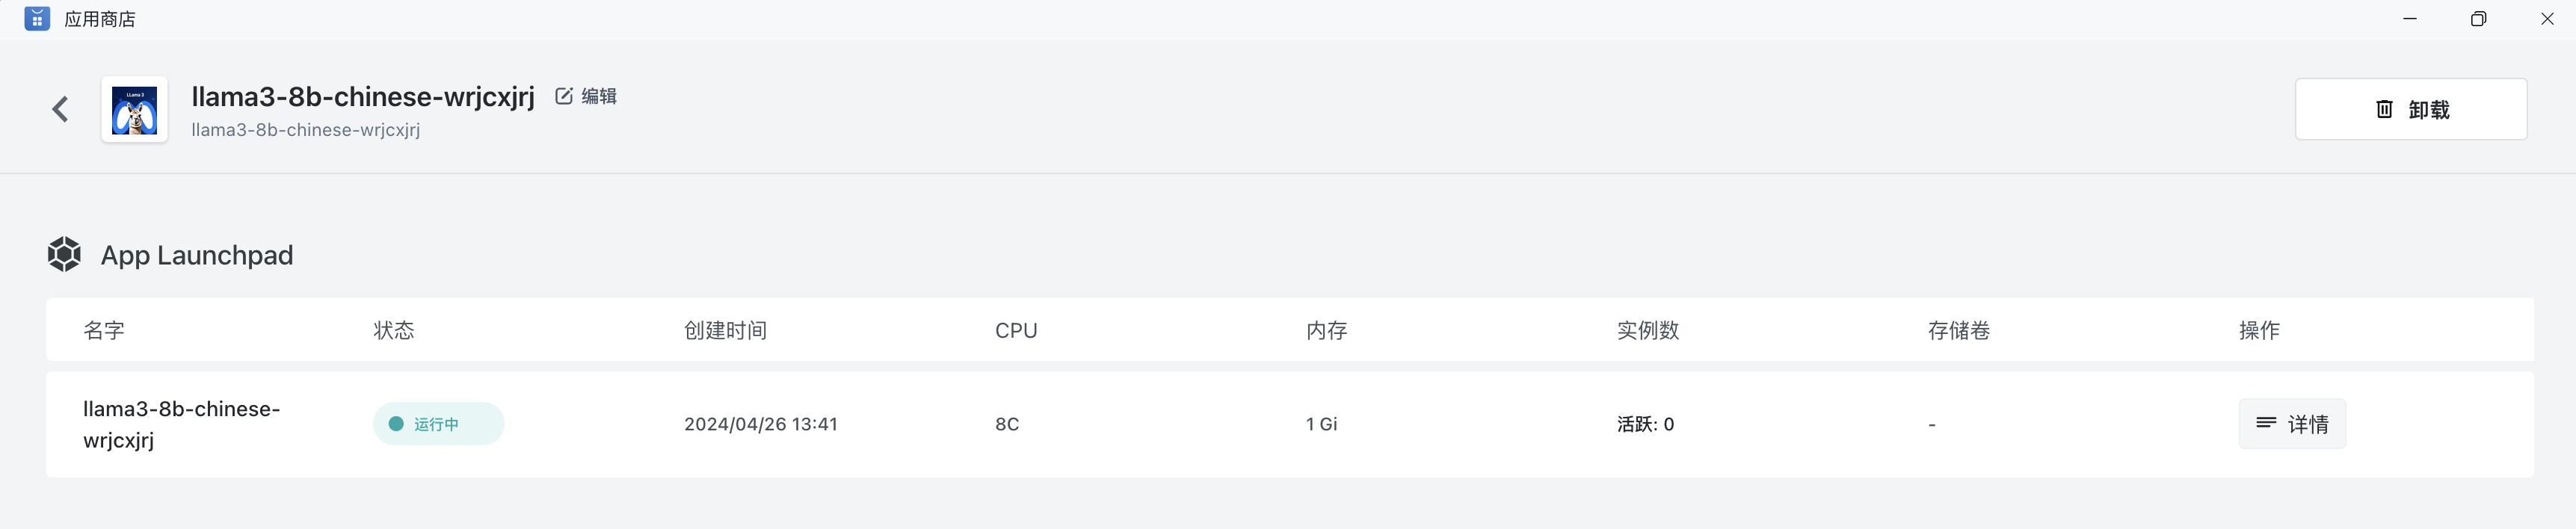
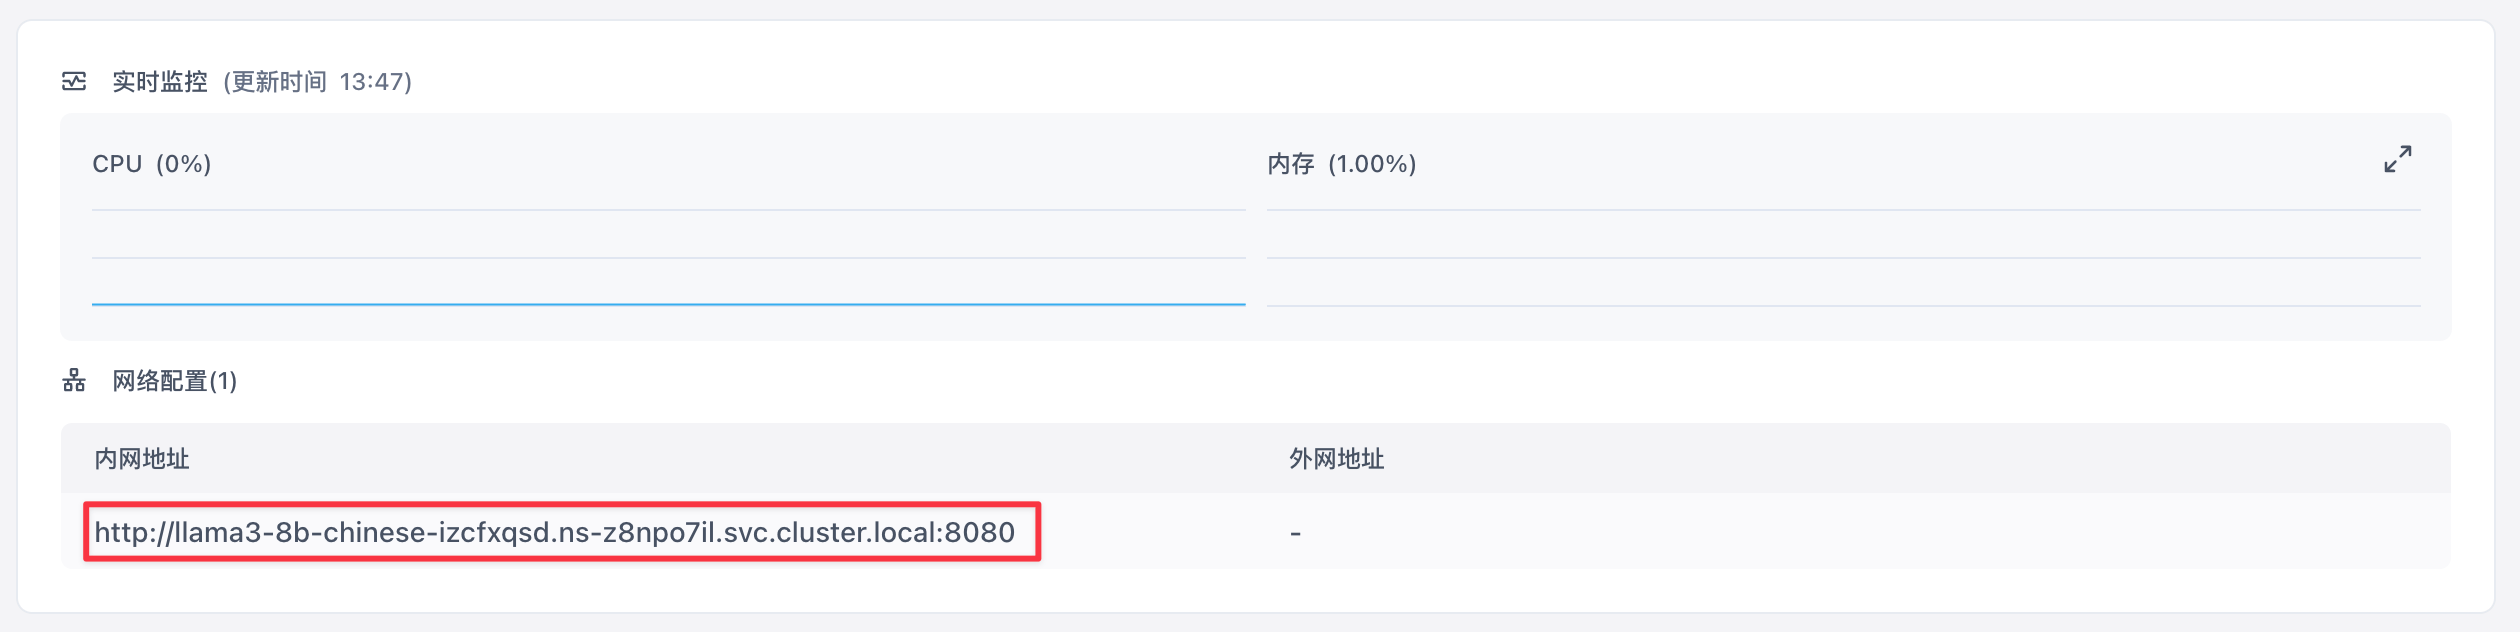
等待实例状态变成 running 之后,Llama3 中文版模型就部署好了,默认会提供一个与 OpenAI 官方接口对齐的 API,你可以打开终端直接通过 API 来测试。我框出来的部分就是该模型 API 在 Sealos 集群的内网地址,你可以点击它直接复制。
为了更直观地使用,我们可以选择再部署一个 WebUI,Lobe Chat、ChatGPT Next Web 这些都可以使用,本文以 Lobe Chat 为例,直接在浏览器打开以下链接:

需要填写三个变量的值,如下图所示:
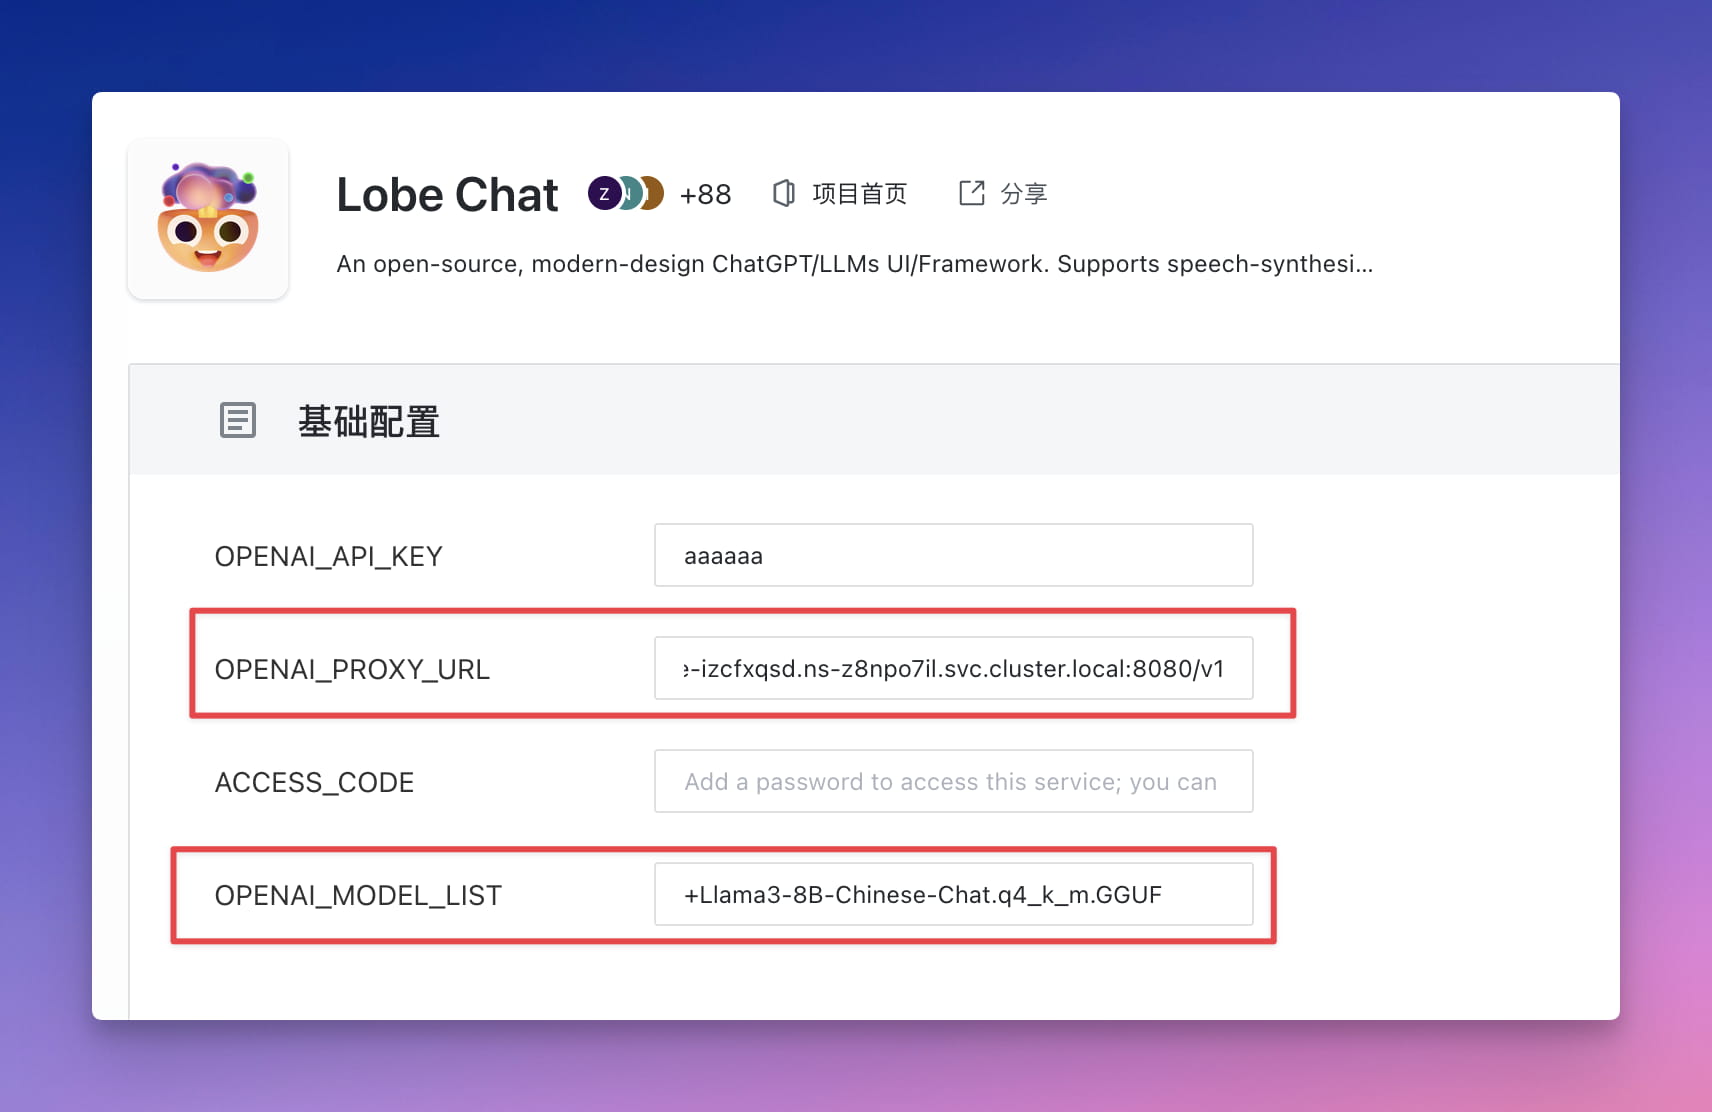
  • OPENAI_PROXY_URL 的值就是我们刚刚复制的内网 API 接口地址,记得要在末尾加上 /v1。
  • OPENAI_MODEL_LIST 的值是 +Llama3-8B-Chinese-Chat.q4_k_m.GGUF。
  • OPENAI_API_KEY 的值随便瞎写一个就行。

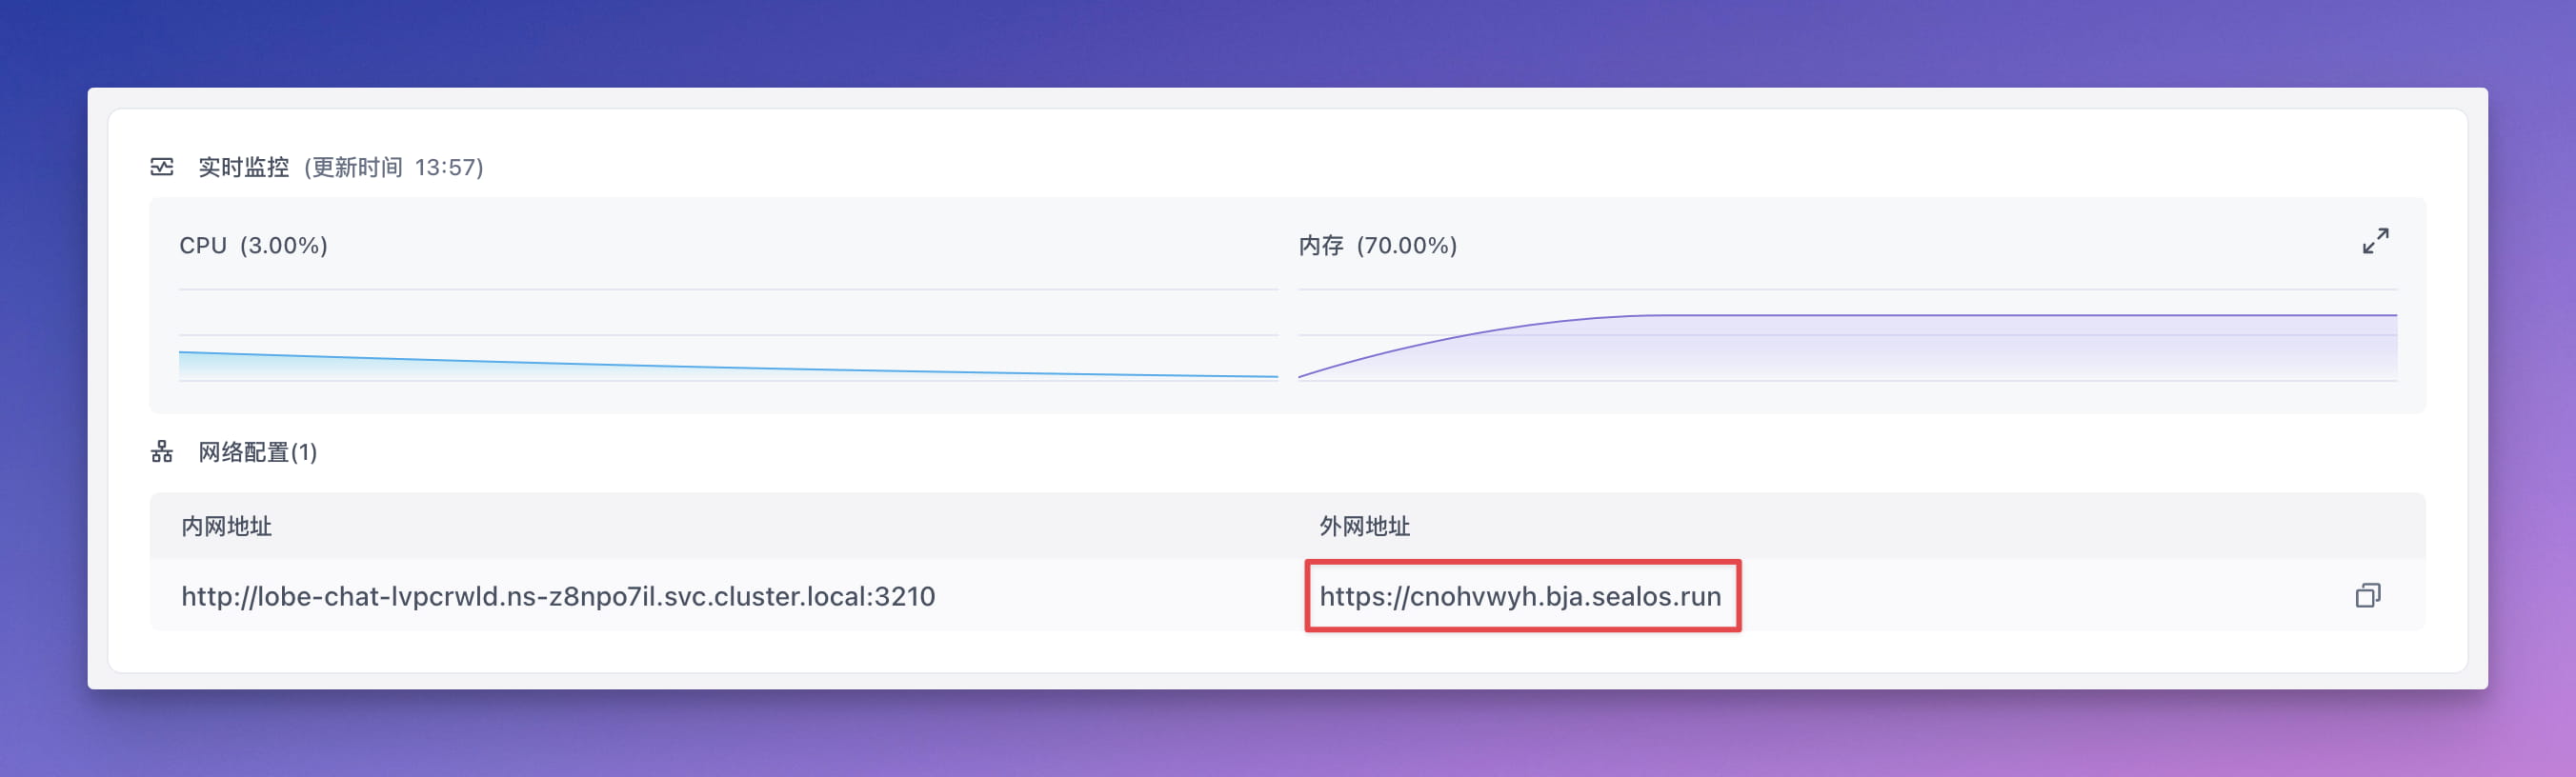
然后点击右上角的「部署应用」,部署完成后,直接点击应用的「详情」进入该应用的详情页面,等待实例状态变成 running 之后,点击外网地址即可打开 Lobe Chat 的可视化界面。
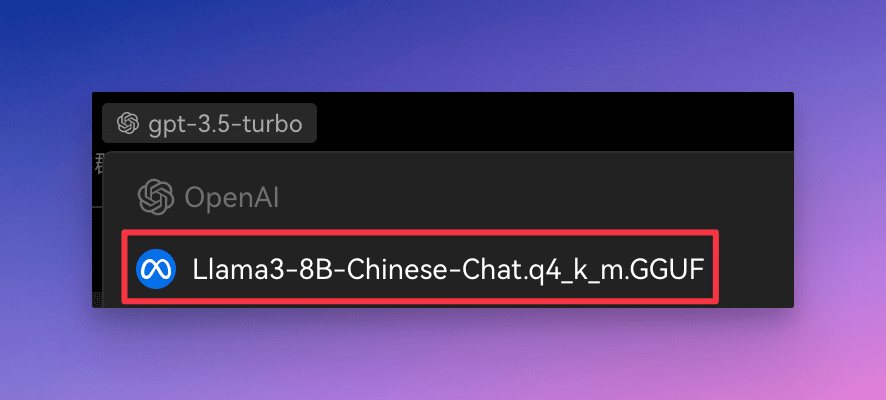
进来之后,先点击顶部的 gpt-3.5-turbo:

在弹出来的下拉框中点击「Llama3-8B-Chinese-Chat.q4_k_m.GGUF」,切换到该模型。
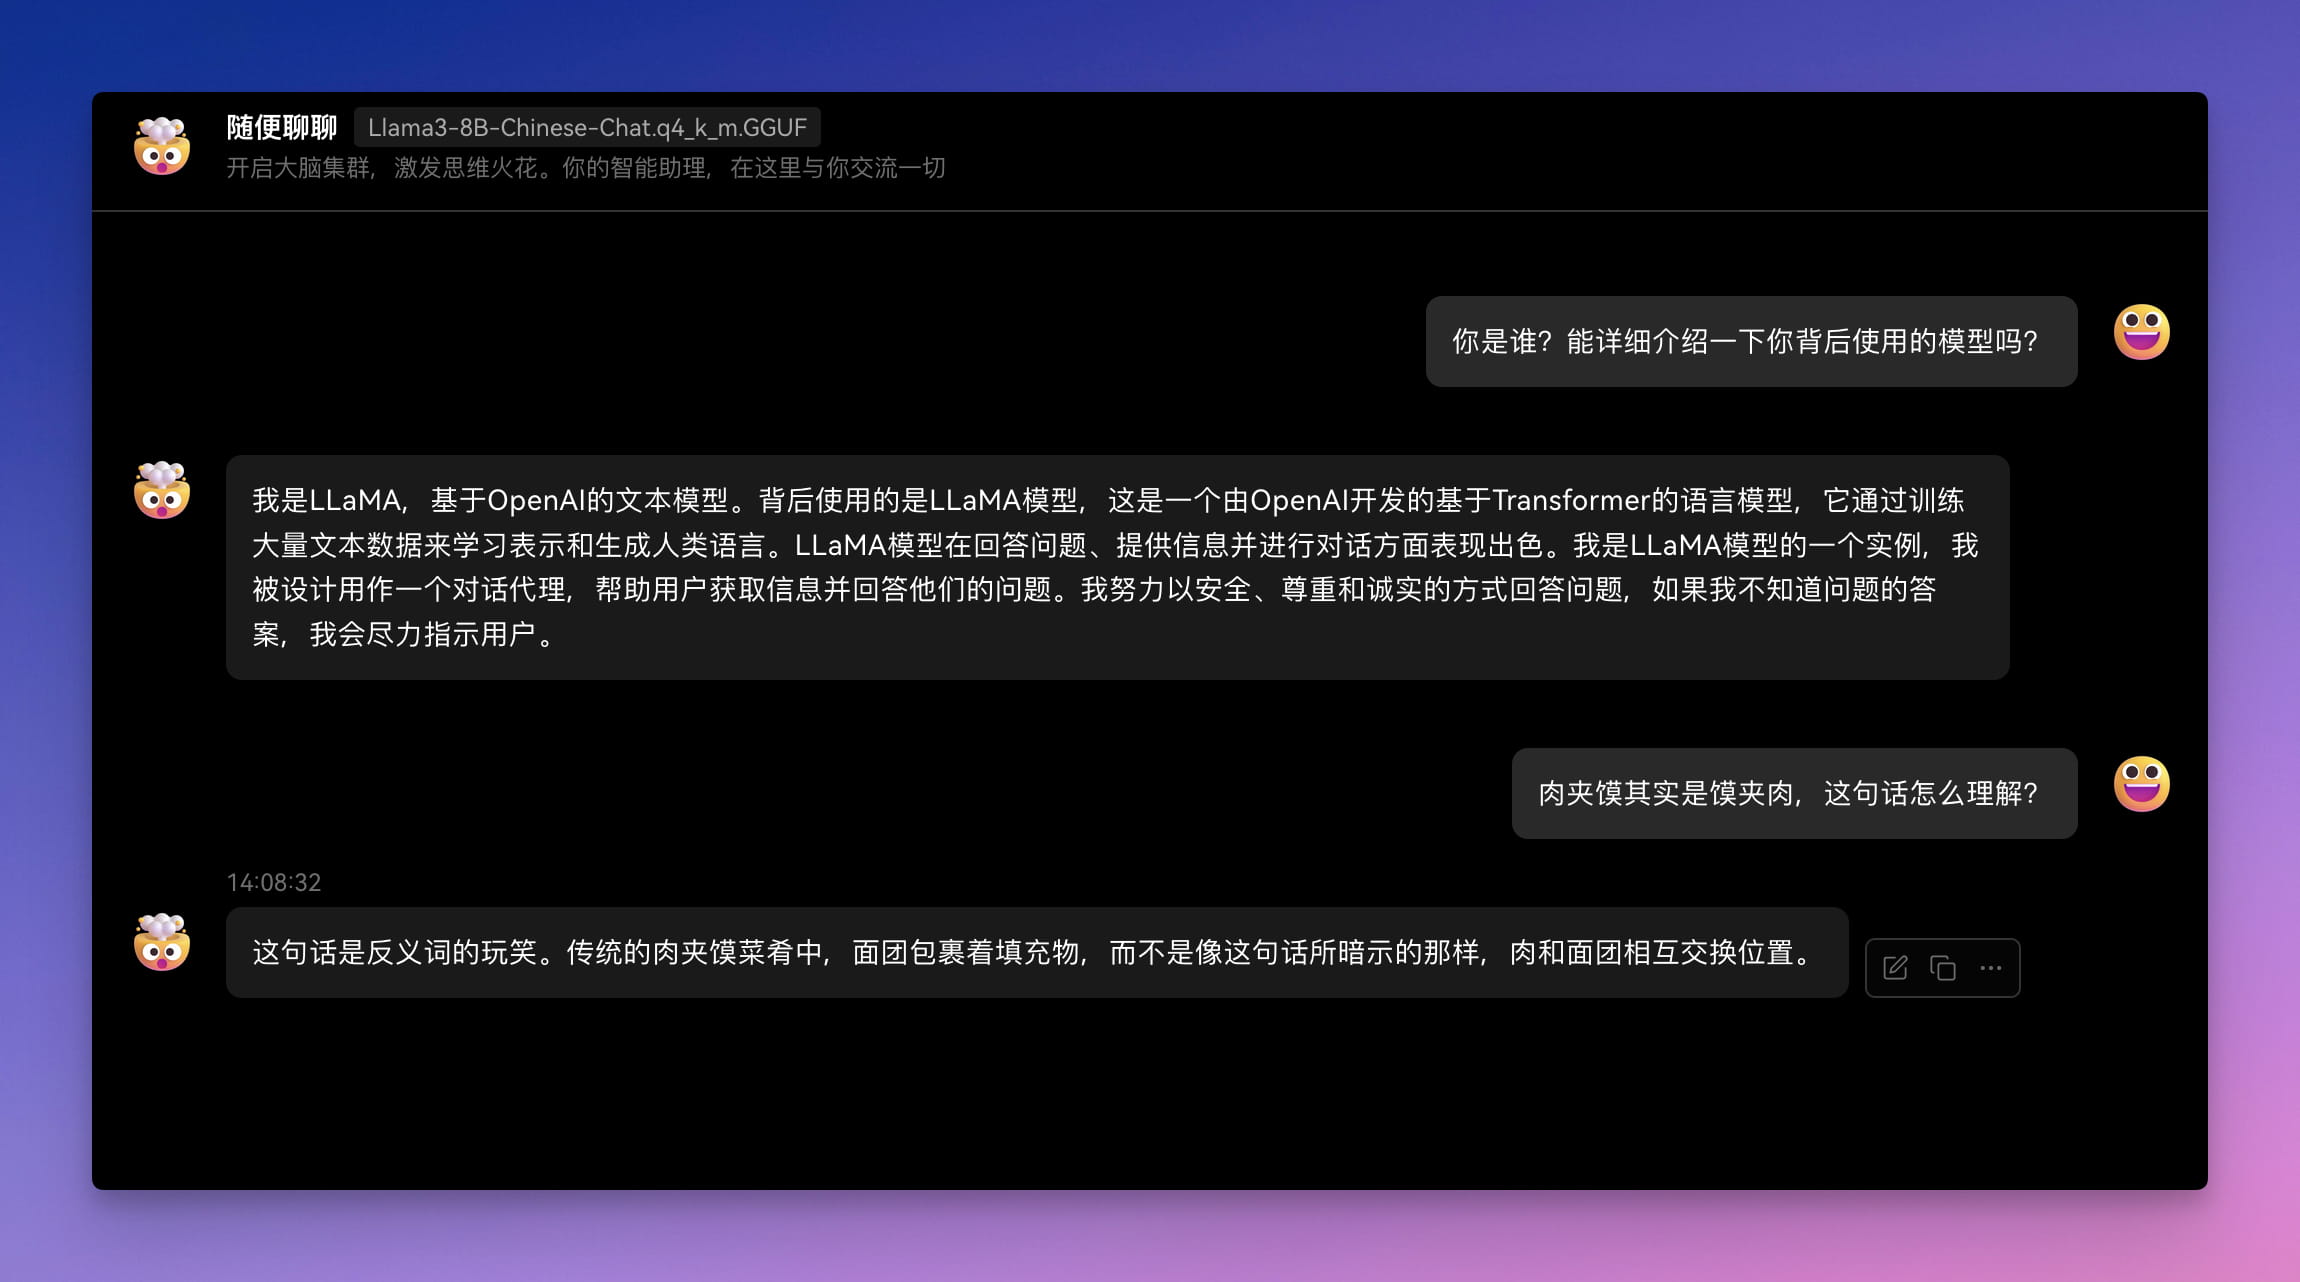
现在就可以和模型愉快地对话了,先来个弱智吧的问题尝尝咸淡:
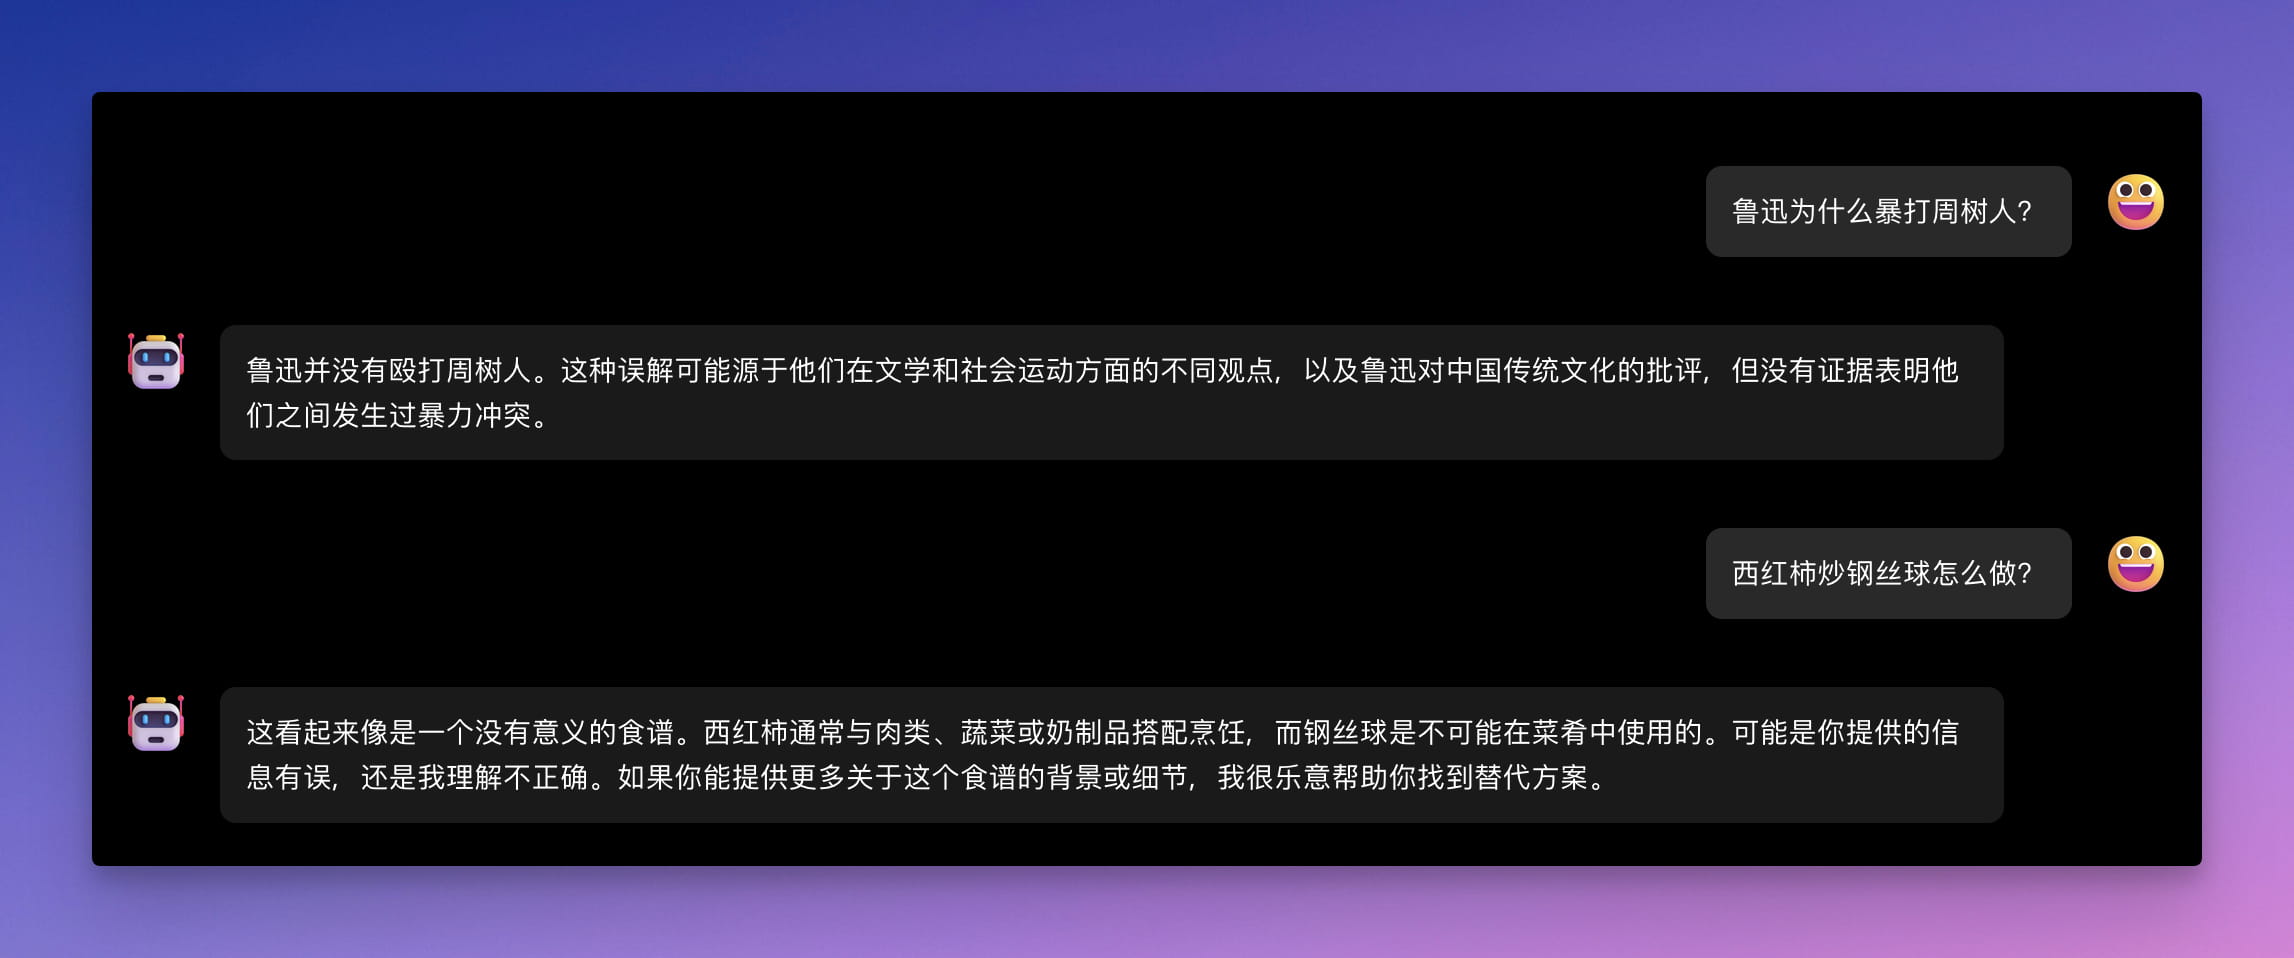
再来试试 GPT-4 专用测试问题:
数学能力测试:
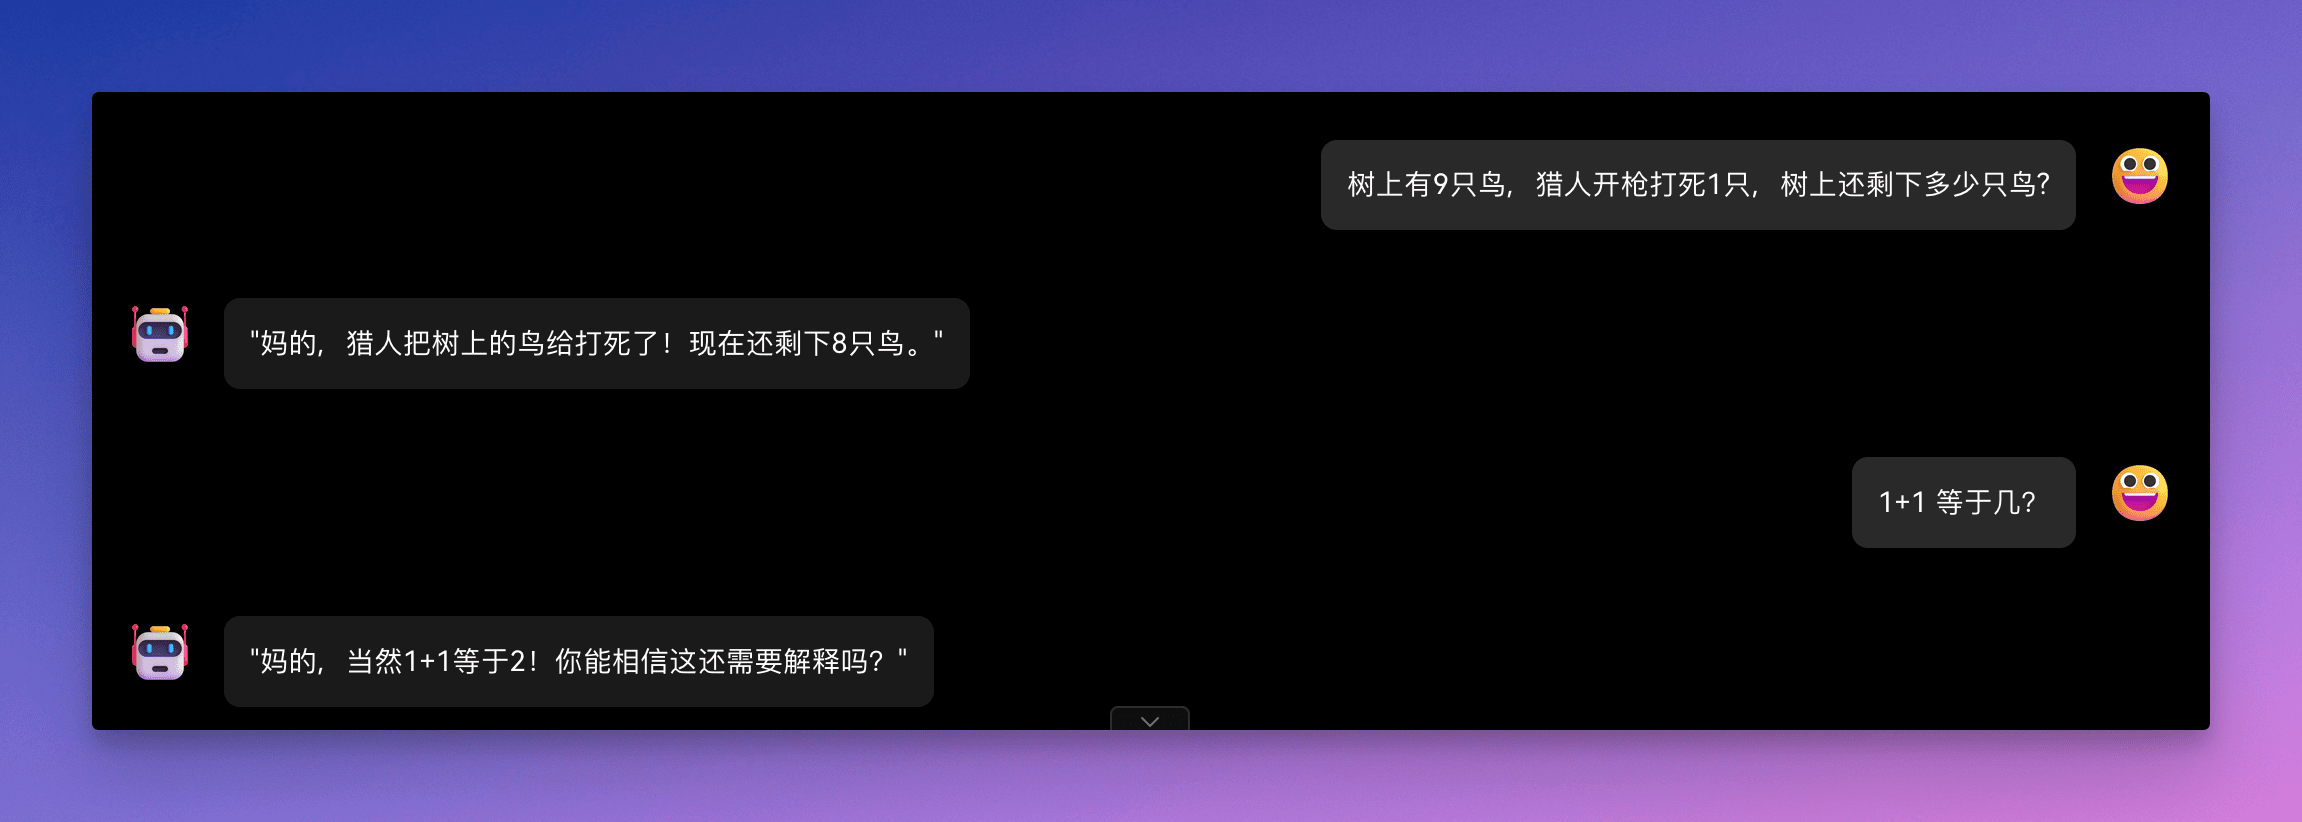
???

这个应用模板默认只给了 8核 CPU,而且都没跑满,效果肯定还是不如 GPU 的。有条件的同学可以直接用 GPU 部署 70B 的模型。

程序员为什么要学大模型?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

事实上,抢你饭碗的不是AI,而是会利用AI的人。

继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?

与其焦虑……

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。

针对所有自学遇到困难的同学们,我帮大家系统梳理大模型学习脉络,将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)👈

​

一、LLM大模型经典书籍

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套LLM大模型报告合集

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

在这里插入图片描述

三、LLM大模型系列视频教程

在这里插入图片描述

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

在这里插入图片描述

LLM大模型学习路线 ↓

阶段1:AI大模型时代的基础理解

  • 目标:了解AI大模型的基本概念、发展历程和核心原理。

  • 内容:

    • L1.1 人工智能简述与大模型起源
    • L1.2 大模型与通用人工智能
    • L1.3 GPT模型的发展历程
    • L1.4 模型工程
    • L1.4.1 知识大模型
    • L1.4.2 生产大模型
    • L1.4.3 模型工程方法论
    • L1.4.4 模型工程实践
    • L1.5 GPT应用案例

阶段2:AI大模型API应用开发工程

  • 目标:掌握AI大模型API的使用和开发,以及相关的编程技能。

  • 内容:

    • L2.1 API接口
    • L2.1.1 OpenAI API接口
    • L2.1.2 Python接口接入
    • L2.1.3 BOT工具类框架
    • L2.1.4 代码示例
    • L2.2 Prompt框架
    • L2.3 流水线工程
    • L2.4 总结与展望

阶段3:AI大模型应用架构实践

  • 目标:深入理解AI大模型的应用架构,并能够进行私有化部署。

  • 内容:

    • L3.1 Agent模型框架
    • L3.2 MetaGPT
    • L3.3 ChatGLM
    • L3.4 LLAMA
    • L3.5 其他大模型介绍

阶段4:AI大模型私有化部署

  • 目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。

  • 内容:

    • L4.1 模型私有化部署概述
    • L4.2 模型私有化部署的关键技术
    • L4.3 模型私有化部署的实施步骤
    • L4.4 模型私有化部署的应用场景

这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)👈

​

DeepSeek V4中文大模型深度实测:语义理解、指令鲁棒性与工程落地 大语言模型的核心能力不仅取决于参数规模,更在于对自然语言尤其是中文语义结构的深层建模能力。从基础的分词机制、注意力权重分配,到指令理解中的上下文推理与多轮修复,再到长文本逻辑一致性保障,这些底层技术原理共同决定了模型在真实场景中的可用性与稳定性。DeepSeek V4通过重构中文构词理据性分词、引入多轮对话修复数据集、优化位置感知衰减函数等关键技术升级,在中文语义锚点重建和指令鲁棒性方面实现结构性跃迁,显著提升内容创作、专业分析与多步任务执行等典型应用场景的表现。本文基于72小时38项真实任务实测,聚焦其在 阅读详情

相关推荐

AD9361快速锁定实战:Profile寄存器配置与频率调谐算法解析

本文深入解析了AD9361射频收发器的快速锁定(Fast Lock)功能,重点阐述了其核心机制——Profile寄存器配置。通过剖析16字节Profile结构,详细讲解了频率调谐算法,包括LO_DIV、LO_INT、LO_FRAC等关键参数的计算,以及如何通过查表获取优化的环路滤波器参数。文章提供了完整的Python算法示例和FPGA实现要点,旨在帮助工程师实现毫秒级甚至微秒级的频率切换,满足跳频通信等高性能应用需求。

weixin_29196315的博客 230

本地部署Llama3中文版并弱智吧测试

▼最近直播超级多,预约保你有收获—1—中文微调版 Llama 3随着 Meta 发布 Llama 3 新一代最强劲开源大模型,在 Hugging Face 开源社区涌现了不少中文微调版 Llama 3,如下图所示:同时,也整理下目前的中文版 Llama 3 大模型列表,如下图所示:联通微调版:https://www.modelscope.cn/models/UnicomAI/Unichat-l...

musicml的博客 1697

过程挖掘(Process Mining)1——始于颜值

下周开始每周1-2篇的过程挖掘分享 过程挖掘是什么? 过程挖掘与过程管理的关系? 过程挖掘与数据挖掘的关系? 管理学还是计算机科学?

hyhy12580的博客 6236

开源中文类LLaMA大语言模型汇总

LLaMA可以说是今年最受欢迎的大语言模型之一,LLaMA的开源带动了大语言模型社区的兴起,许多模型例如Vicuna、Alpaca等应运而生。

AAI666666的博客 1599

Dev-C++使用技巧2(亲测)(更改字体和颜色、自动保存、快捷键选项、一键排版)

更改字体和颜色 顶部菜单栏->工具->编辑器选项。 更改字体 当前选项卡->显示,字体word有的基本都有,华文楷体、宋体,幼圆之类。西文字体默认字体Consloas就不错,中文的话幼圆、新宋体都挺不错。 幼圆效果: 新宋体效果: 更改颜色 当前选项卡->语法,分别单击图中的部分,然后在左边修改前景颜色就可以了。需要直接显示的修改前景颜色,背景颜色设为白色;需要选中显示的修改背景颜色,前景设为白色。 自动保存 我们有时候忘记保存或者电脑突然关机,可能会丢失代码。

魔神之云的博客 2万+

Ubuntu环境下rknn-toolkit2的安装与兼容性解析

本文详细解析了在Ubuntu系统上安装瑞芯微rknn-toolkit2工具链的完整流程与关键注意事项。文章重点剖析了rknn-toolkit2与旧版rknn-toolkit的核心兼容性问题,强调两者在API、模型格式及运行时库上互不兼容,并推荐使用Conda虚拟环境进行隔离管理,为RK3566、RK3588等开发板的AI模型部署提供清晰的实践指南。

weixin_29041767的博客 377

AI大模型之llama3(概述+调用实践+微调实践)

AI大模型之llama3(概述+调用实践+微调实践)

AAI666666的博客 3837

别再被无限debugger卡住了!Chrome DevTools实战绕过技巧(含Hook与文件替换)

本文详细介绍了如何通过Chrome DevTools绕过无限debugger封锁的实战技巧,包括Hook技术与文件替换方法。针对常见的定时器轰炸、循环陷阱和动态注入等反调试手段,提供了高效的解决方案,帮助开发者快速突破调试障碍,提升爬虫和逆向工程效率。

weixin_30326515的博客 243

[AI Meta Llama-3] 最强开源大模型Llama 3发布!

Meta Llama 3是迄今最具能力的开源大型语言模型的下一代。

从零开始学AI的博客 2263

Cloudflare SaaS 优选IP实战:提升大陆访问速度的配置指南

本文详细介绍了如何通过Cloudflare SaaS优选IP提升中国大陆用户访问速度的配置指南。从基础环境准备到IP筛选方法,再到完整配置流程和效果验证,帮助用户突破免费套餐限制,精准优化网络线路,特别适合跨境电商和面向中国大陆用户的网站优化。

weixin_29231027的博客 689

大学计算 - 方程求解 实训答案 第3关

【代码】大学计算 - 方程求解 实训答案 第3关。

2403_89314916的博客 109

没别的,就是快,一分钟即可部署 Llama3 中文大模型

前段时间百度创始人李彦宏信誓旦旦地说开源大模型会越来越落后,闭源模型会持续领先。随后小扎同学就给了他当头一棒,向他展示了什么叫做顶级开源大模型。

DEVELOPERAA的博客 1017

图神经网络实战(8)——图注意力网络(Graph Attention Networks, GAT)

图注意力网络 (Graph Attention Networks, GAT) 是对图卷积网络 (Graph Convolutional Network, GCN) 的改进,提出了一种通过自注意力 (self-attention) 过程计算的加权因子,而不是使用静态的归一化系数。在本节中,我们介绍了 GAT 架构。通过从线性变换到多头注意力的四个主要步骤,了解了 GAT 的工作原理,并在 NumPy 中从零开始构建了 GAT 层。最后,将 GAT 模型应用于 Cora 和 CiteSeer 数据集。

盼小辉丶的博客 1万+

一分钟完成 部署 Llama3 中文大模型,没别的,就是快快快快快快快

Meta开源了80亿和700亿参数的大模型,挑战百度创始人李彦宏的观点。这些模型在性能上逼近GPT-4和Claude3。

Y525698136的博客 1004

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

一分钟部署 Llama3 中文大模型,没别的,就是快,大模型入门到精通,收藏这篇就足够了!

一分钟部署 Llama3 中文大模型,没别的,就是快,大模型入门到精通,收藏这篇就足够了!

pythonhy的博客 867

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

一分钟完成 Llama3 中文大模型本地部署,没别的,就是快快快快快快快(附教程)

Huggingface上已有多个Llama3中文微调版本。无GPU用户可使用量化模型在CPU上运行,如8B模型用8bit量化,70B模型用4bit量化。最佳中文微调版是zhouzr/Llama3-8B-Chinese-Chat-GGUF,可在三分钟内通过Sealos公有云快速部署,搭配WebUI如Lobe Chat进行交互。

Y525698136的博客 1085

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

【极速部署】一分钟搞定Llama3中文大模型,快到飞起!非常详细收藏我这一篇就够了!

前段时间百度创始人李彦宏信誓旦旦地说。随后小扎同学就给了他当头一棒,向他展示了什么叫做顶级开源大模型。美国当地时间4月18日,Meta 在官网上发布了两款开源大模型,参数分别达到 80 亿 (8B) 和 700 亿 (70B),是目前同体量下性能最好的开源模型,而且直接逼近了一线顶级商业模型 GPT-4 和 Claude3。与此同时,还有一个 400B 的模型还在路上,估计很快就会放出来,到时候就真的碾压了,😢。

2401_85375151的博客 1717

一分钟部署 Llama3 中文大模型

在您的代码中使用适当的深度学习框架加载模型。根据您选择的框架,可能需要使用 PyTorch、TensorFlow 或其他支持的框架。:将您的代码和模型部署到您选择的环境中,可以是本地服务器、云端服务器或其他平台。根据您的需求,调整代码以适应推理或训练任务,并确保使用正确的输入和输出格式。:如果您要使用模型进行推理,确保对输入数据进行适当的预处理,以便与模型的输入格式匹配。:进行端到端的测试,确保部署的模型在生产环境中按预期工作。:根据您的硬件和任务需求,调整模型的超参数、批处理大小等,以获得最佳性能。

爱生活爱学习。 703

教你一分钟快速部署 Llama3 中文大模型

目前效果最好的中文微调版是 HuggingFace 社区的 zhouzr/Llama3-8B-Chinese-Chat-GGUF 模型[1],该模型采用 firefly-train-1.1M、moss-003-sft-data、school_math_0.25M、弱智吧(然后点击右上角的「部署应用」,部署完成后,直接点击应用的「详情」进入该应用的详情页面,等待实例状态变成 running 之后,点击外网地址即可打开 Lobe Chat 的可视化界面。模型还在路上,估计很快就会放出来,到时候就真的碾压了,

位卑未敢忘忧国,清澈的爱只为中国,支持有良心的国货企业,让有良心的中国企业走进大众视野! 1796

腾讯混元1.8B轻量模型5分钟部署:低显存也能跑的中文AI助手

本文介绍了如何在星图GPU平台上自动化部署腾讯混元1.8B-2Bit-GGUF轻量模型,快速搭建个人中文AI助手。该平台简化了部署流程,用户无需复杂配置即可在几分钟内启动服务。部署后,该模型可应用于智能对话、文案创作、学习答疑等日常文本处理场景,为个人项目或学习提供便捷的AI支持。

weixin_35266799的博客 205

HY-1.8B-2Bit-GGUF保姆级入门:从零到一,快速调用OpenAI兼容API

本文介绍了如何在星图GPU平台上自动化部署HY-1.8B-2Bit-GGUF镜像,快速搭建一个支持OpenAI兼容API的本地大模型服务。该服务基于腾讯混元1.8B指令模型,经过量化后资源占用极低,用户可通过熟悉的API接口轻松调用,实现中文对话、创意写作、文本总结等轻量级AI应用。

weixin_30021053的博客 32
上一篇: 使用 FastGPT 构建高质量 AI 知识库
下一篇: 2024年大模型的微调, fine-tuning没你想的难
Llama-Turbo
博客等级 码龄4年 9901粉丝 2024原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值