【AI大模型部署】Llama 3 8B模型微调实战

详细简明懒人教程,含部署:Llama3-Chinese-8B-Instruct,cpp量化 无非:gh、hf、ms这三个里面找来找去,但是现在hf真的连不上,唉。。 阅读详情

大多数人工智能领域的工具都会使用到Python,这个需要提前安装,同时推荐使用虚拟环境进行环境的隔离,比如用Anaconda(conda create -n xxx )或者使用Python自带的模块创建虚拟环境(python -m venv xxx)。同时在使用前请记得激活环境。

训练

我们使用llama-3-chinese-8b-instruct-v3,好处是它已经通过中文语料进行了训练,将https://huggingface.co/hfl/llama-3-chinese-8b-instruct-v3/tree/main链接下的文件下载到本地目录。

注:如果在Huggingface上直接申请Llama模型的访问权限,国家最好不要选择中国,Alan的测试是选择中国遭拒,而选择美国则通过申请。

想过执行代码来自Chinese-LLaMA-Alpaca-3项目,执行代码这里使用了Git Bash,这样在Windows下可以获取和Linux相似的使用体验。

训练的代码位于scripts/training目录下,如果使用的是Mac或Linux,可以直接修改run_sft.sh中相关目录直接运行Shell脚本。以下演示为通过Python代码运行:

 `python run_clm_sft_with_peft.py --model_name_or_path /d/workspace/llama-3-chinese-8b-instruct-v3 --tokenizer_name_or_path /d/workspace/llama-3-chinese-8b-instruct-v3 --dataset_dir /d/workspace/Chinese-LLaMA-Alpaca-3/data --per_device_train_batch_size 1 --per_device_eval_batch_size 1 --do_train 1 --do_eval 1 --seed 42 --bf16 1 --num_train_epochs 3 --lr_scheduler_type cosine --learning_rate 1e-4 --warmup_ratio 0.05 --weight_decay 0.1 --logging_strategy steps --logging_steps 10 --save_strategy steps --save_total_limit 3 --evaluation_strategy steps --eval_steps 100 --save_steps 200 --gradient_accumulation_steps 8 --preprocessing_num_workers 8 --max_seq_length 1024 --output_dir /d/workspace/output --overwrite_output_dir 1 --ddp_timeout 30000 --logging_first_step True --lora_rank 64 --lora_alpha 128 --trainable "q_proj,v_proj,k_proj,o_proj,gate_proj,down_proj,up_proj" --lora_dropou 0.05 --modules_to_save "embed_tokens,lm_head" --torch_dtype bfloat16 --validation_file /d/workspace/Chinese-LLaMA-Alpaca-3/data/ruozhiba_qa2449_gpt4t.json --load_in_kbits 16 --low_cpu_mem_usage True`

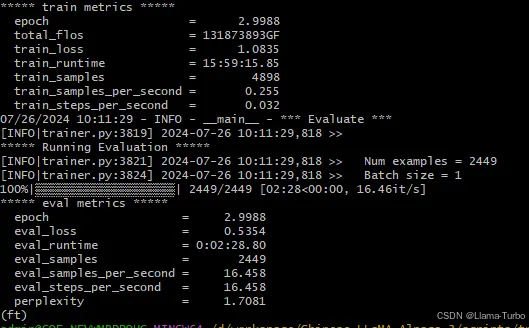
以上数据集和验证集在做私有数据训练时需做相应修改,这里使用原仓库中的数据进行了演示,训练时间取决于硬件设备,我这里跑了一整夜:
在这里插入图片描述

llama 3 Chinese微调

合并

训练完成后如需具备通用模型的能力还应与原模型进行合并操作,这一代码在Alpaca的scripts目录下,命令如下:

 `python merge_llama3_with_chinese_lora_low_mem.py --base_model /d/workspace/llama-3-chinese-8b-instruct-v3 --lora_model  /d/workspace/output --output_dir /d/workspace/output_merge`

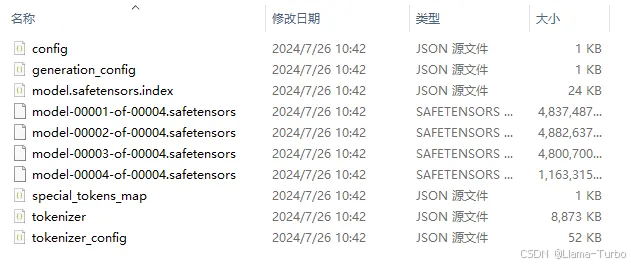
得到的文件如下:
在这里插入图片描述

微调合并操作

量化

可以看到上图中的文件占用约15 GB,文件也较多,不利于部署,通常都会先进行量化处理,这里选择的项目为:https://github.com/ggerganov/llama.cpp

git clone https://github.com/ggerganov/llama.cpp.git   cd llama.cpp/   pip install -r requirements/requirements-convert_hf_to_gguf.txt   

Linux和Mac下直接执行make,Windows如无cmake,下载cmake,然后执行:

cmake -B build   cmake --build build --config Release      python convert_hf_to_gguf.py ../output_merge --outtype f16 --outfile ../output_models/llama3_chinese-8B-F16.gguf   ./llama-quantize ../output_models/llama3_chinese-8B-F16.gguf  ../output_models/llama3_chinese-8B-q4_0.gguf q4_0   

量化后的llama3_chinese-8B-q4_0.gguf文件仅为4.5 GB。量化的算法较多,

WSL在make时会出现报错:scripts/build-info.sh: 31: Syntax error: end of file unexpected (expecting "then"),需执行:

sudo apt install dos2unix   find -type f -print0 | xargs -0 dos2unix   

出现CMake Error at CMakeLists.txt:2 (project): Running 'nmake' '-?' failed with: 系统找不到指定的文件。尝试删除build目录再执行cmake,如仍有问题可能和cmake与Visual Studio的安装有关,Alan直接使用Visual Studio所安装的cmake执行并没有发生异常(我安装在D盘,所以添加的环境变量为:D:\Program Files\Microsoft Visual Studio\2022\Community\Common7\IDE\CommonExtensions\Microsoft\CMake\CMake\bin)。编译后的命令位于build/bin/Release目录中。

部署

依然使用Alpaca项目,我们将使用Ollama进行部署,所以进入scripts/ollama目录,将Modelfile文件中FROM后的文件修改为刚刚所保存的llama3_chinese-8B-q4_0.gguf文件路径,然后创建模型,名称可自己选择:

ollama create llama3-chinese-8b-q4 -f Modelfile   

执行以下命令运行该模型:

ollama run llama3-chinese-8b-q4   

此时就会发现模型不仅具备底座模型的能力,还可以回答我们微调数据集中的相关问题。

程序员为什么要学大模型?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

事实上,抢你饭碗的不是AI,而是会利用AI的人。

继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?

与其焦虑……

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。

针对所有自学遇到困难的同学们,我帮大家系统梳理大模型学习脉络,将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)👈

​

一、LLM大模型经典书籍

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套LLM大模型报告合集

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

在这里插入图片描述

三、LLM大模型系列视频教程

在这里插入图片描述

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

在这里插入图片描述

LLM大模型学习路线 ↓

阶段1:AI大模型时代的基础理解

  • 目标:了解AI大模型的基本概念、发展历程和核心原理。

  • 内容:

    • L1.1 人工智能简述与大模型起源
    • L1.2 大模型与通用人工智能
    • L1.3 GPT模型的发展历程
    • L1.4 模型工程
    • L1.4.1 知识大模型
    • L1.4.2 生产大模型
    • L1.4.3 模型工程方法论
    • L1.4.4 模型工程实践
    • L1.5 GPT应用案例

阶段2:AI大模型API应用开发工程

  • 目标:掌握AI大模型API的使用和开发,以及相关的编程技能。

  • 内容:

    • L2.1 API接口
    • L2.1.1 OpenAI API接口
    • L2.1.2 Python接口接入
    • L2.1.3 BOT工具类框架
    • L2.1.4 代码示例
    • L2.2 Prompt框架
    • L2.3 流水线工程
    • L2.4 总结与展望

阶段3:AI大模型应用架构实践

  • 目标:深入理解AI大模型的应用架构,并能够进行私有化部署。

  • 内容:

    • L3.1 Agent模型框架
    • L3.2 MetaGPT
    • L3.3 ChatGLM
    • L3.4 LLAMA
    • L3.5 其他大模型介绍

阶段4:AI大模型私有化部署

  • 目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。

  • 内容:

    • L4.1 模型私有化部署概述
    • L4.2 模型私有化部署的关键技术
    • L4.3 模型私有化部署的实施步骤
    • L4.4 模型私有化部署的应用场景

这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)👈

​

Llama3本地部署与高效微调入门 为了保持公司在AI(人工智能)开源大模型领域的地位,社交巨头Meta推出了旗下最新开源模型。当地时间4月18日,Meta在官网上宣布公布了旗下最新大模型Llama 3。目前,Llama 3已经开放了80亿(8B)和700亿(70B)两个小参数版本,上下文窗口为8k。Meta表示,通过使用更高质量的训练数据和指令微调,Llama 3比前代Llama 2有了“显著提升”。未来,Meta将推出Llama 3的更大参数版本,其将拥有超过4000亿参数。 阅读详情

相关推荐

【AI大模型】LLaMa羊驼大模型详解

LLaMa模型结构:前面的词预测后面的词,经典的解码结构。位置编码用的是旋转自编码。大语言模型为什么取名为LLaMa(美洲鸵)?LLM发音困难。两个LL跟绕口令一样挑战舌头。大家想给它加点原音,帮助发音。有人加了A,就是LLaMa。3.模型的训练和数据:65B的模型使用2048块A100 80G的GPU,训练21天左右。(训练成本还是比较高的,训练的数据集同GPT一样)LLaMa模型训练的数据集。

weixin_53880910的博客 2808

Llama3中文微调模型-Llama3-Chinese-8B-Instruct概述

Llama3的最大模型参数规模达到了惊人的400B。),8B模型和70B模型全系列都采用了GQA,GQA通过将查询分成不同的部分并给予它们不同的重点来理解查询的层次结构,这有助于系统更好地理解复杂问题并找到更相关的信息。通过LoRA微调,我们不仅保留了Llama3模型在预训练阶段获得的知识,还通过针对性的架构调整和参数优化,进一步提升了模型对中文语境的适应性和任务执行的准确性。这一过程中,我们特别注重了超参数的精细调整,并通过反复的模型评估与迭代,确保了微调后的模型能够在实际应用中稳定地提供高质量的输出。

ASS-ASH的博客 7619

非常可靠,手把手教你本地部署AI大模型-llama3:70b

Llama 3是Meta 公司开发的Llama系列模型的第三个版本,本次提供 8B 和 70B 参数大小的版本。Llama3拥有改进的推理能力。

lvaolan8888的博客 4054

【LLM】-10-部署llama-3-chinese-8b-instruct-v3 大模型

​ 由于在【LLM】-09-搭建问答系统-对输入Prompt检查-优快云博客关于提示词注入问题上, 使用Langchain 配合chatglm3-6b 无法从根本上防止注入攻击问题。 并且在Langchian中无法部署llama3模型(切换模型错误,原因暂未解决) 所以直接部署llama3中文大模型。 选择llama-3-chinese-8b-instruct-v3 模型,需要16G显存。 部署使用参考文档https://github.com/ymcui/Chinese-LLaMA-A

宣晨光 2546

最强开源模型 Llama 3.1 部署推理微调实战大全

在人工智能的浪潮中,大型语言模型(LLMs)已成为推动技术进步的关键力量。随着Meta公司最新开源的Llama 3.1模型的问世,我们见证了开源AI领域的一大飞跃。Llama 3.1以其卓越的性能和广泛的应用潜力,为开发者和研究者提供了一个强大的工具,以探索和实现各种复杂的AI应用。

寻道AI,探索AI无限可能! 9525

【Qwen2微调实战】LLaMA-Factory框架对Qwen2-7B模型的微调实践

在人工智能的浪潮中,大型语言模型(LLMs)正逐渐成为研究和应用的热点。它们在自然语言处理(NLP)的各个领域,如文本生成、翻译、问答等任务中展现出了卓越的能力。Qwen2-7B模型,作为该领域的佼佼者,不仅因其庞大的参数量和强大的表示能力受到关注,更因其在微调后能够更好地适应特定任务而备受关注。本文将详细介绍如何利用LLaMA-Factory这一高效的微调框架对Qwen2-7B进行微调,以期达到提升模型在特定任务上的表现。

寻道AI,探索AI无限可能! 2万+

ollama相关

ollama create 名字 -f Modelfile。ollama run 模型名称。1.根据gguf创建模型。

m0_66829891的博客 226

FPGA+滨淞CCD实战:手把手教你搭建S7031/S10142成像电路(附避坑指南)

本文详细介绍了使用FPGA驱动滨淞CCD传感器(S7031/S10142)构建高精度成像系统的完整实战流程。内容涵盖核心器件选型、系统架构规划、电路板(焦面板与接口板)设计要点、FPGA Verilog逻辑实现,并提供了从电源管理、信号调理到数据采集的详细避坑指南,帮助读者从零搭建稳定可靠的成像电路。

weixin_29271263的博客 227

ubuntu 本地部署体验Llama3的中文微调模型Llama3-Chinese-8B-Instruct

ubuntu 本地部署体验Llama3的中文微调模型Llama3-Chinese-8B-Instruct

huachangzai的博客 3396

继电器的选型规范

触点是继电器中最重要的结构件,触点的使用寿命受触点材料、触点上的电压及电流值(特别是接通时及断开时的电压、电流波形)、负载种类、切换频率、环境情况、接触形式、触点回跳现象等的影响,触点失效多以触点的材料转移、粘连、异常消耗、接触电阻增大等故障现象出现,使用时需要注意。为了稳定工作, DC 型继电器的线圈两端所加电压推荐使用波纹变化率小于±5%的线圈额定电压,否则继电器会工作不稳定,引起触点的粘接或异常损耗,特别是在继电器的驱动电路上连接有电动机、螺线管、变压器等器件时,这种情况更为明显。

qq_43416206的博客 1881

TransUnet官方代码训练自己数据集(彩色RGB3通道图像的分割)

官方代码:https://github.com/Beckschen/TransUNet 目的:训练5个类别的汽车部件分割任务(测试在另一篇博客中) 实现效果: 1. github下载代码,并解压。 项目里的文件可能跟你下载的不一样,不急后面会讲到! 2. 配置数据集(尽最大努力还原官方数据集的格式)。 通常自己手上的数据集分images和labels文件夹,分别存放着原始图像和对应的mask图像,如下图所示; mask图像中的像素有0,1,2,3,4 分别代表背景,车身,轮子,车灯,窗户,一共五个

qq_37652891的博客 5万+

AI大模型本地化部署:Llama 3 8B模型微调实战

我们使用llama-3-chinese-8b-instruct-v3,好处是它已经通过中文语料进行了训练,将https://huggingface.co/hfl/llama-3-chinese-8b-instruct-v3/tree/main链接下的文件下载到本地目录。

Y525698136的博客 1286

ffmpeg 4.4 cenc-aes-ctr 加解密 MP4 工程性质分析

ffmpeg 4.4 cenc-aes-ctr 加解密 MP4 工程性质分析

Dream_Dynasty的博客 3045

8GB 显存也能跑大模型!2026 轻量化 AI 部署实战

本文针对8GB显存这一主流瓶颈,提出了INT4量化、智能卸载、LoRA微调、KV缓存优化四大技术组合方案,旨在G实现低显存下的大模型高效推理与微调,并从技术原理、实战部署等多维度展开详细指导。

2401_89688708的博客 977

EtherCAT FOE从站开发实战:SSC工具包实现固件在线升级与文件传输

EtherCAT从站开发中,固件在线升级与文件传输是常见需求。FOE(File Access over EtherCAT)作为邮箱通信协议,在实时总线上提供可靠的文件读写通道,与PDO、DC同步共存。其原理基于SM邮箱和状态机,通过SSC工具包可快速启用。技术价值在于无需拆机即可更新固件、导出日志,提升产线效率。应用场景包括伺服驱动器、IO模块等从站的固件升级与参数配置。本文深入讲解从站侧FOE读写实现、主站调用及工程化建议,助力嵌入式工程师高效开发。

weixin_29169899的博客 127

手把手教你用AirSim生成无人机训练数据集:RGB/深度图/分割图全攻略

本文详细介绍了如何使用AirSim仿真插件在UE4环境中生成无人机训练数据集,涵盖RGB、深度图和分割图等多种模态数据的采集与处理。通过实战指南,读者可以掌握环境配置、多模态数据采集、自动化流程设计及数据后处理等关键技术,为无人机视觉算法开发提供高质量训练数据。

weixin_29008805的博客 449

Llama3 中文版本地环境搭建和部署实战

嗨,各位科技迷们!你们好呀!今天我将为大家带来一篇关于最新科技动态的文章,我们将一起探讨近期备受关注的事件——Llama3发布及其中文微调测试。让我们一起来看看这次发布的背景和重要内容吧!在2024年4月19日,MetaLlama3发布了一份引人注目的概况,成为科技界的焦点。这次发布带来了两种模型参数规模,分别为8B和70B,以满足不同领域的需求。其功能特点十分丰富,包含多种预训练和指令调优的变体,广泛适用于商业和研究领域。

2301_76161259的博客 985

蓝牙开发实战:如何用Wireshark抓取HCI协议包(附完整分析步骤)

本文详细介绍了如何使用Wireshark抓取和分析蓝牙HCI协议包,包括环境搭建、过滤器配置技巧、数据包深度解析及高级调试方法。通过实战案例,帮助开发者快速定位蓝牙连接问题,提升调试效率。

cuda7parallel的博客 1148

Ministral 3B/8B:轻量级开源大模型的工程化突围

轻量级大语言模型(LLM)是边缘计算、终端AI与教育实践的关键技术路径,其核心在于平衡参数规模、推理效率与任务可用性。基于Transformer架构的微型模型通过结构精简、分层量化与指令强化训练,在有限算力下实现高精度中文理解与稳定长文本处理。Ministral系列以3B和8B为典型代表,突破传统小模型在法律、金融、技术文档等垂直场景的能力瓶颈,支持GGUF量化、llama.cpp/Ollama开箱部署,并在Jetson、MacBook M系列及RTX消费级显卡上实现实时低功耗推理。本文深入解析其RoPE位

weixin_30323631的博客 378

WindTerm 安装使用教程

WindTerm是一款Github上开源的 SSH 终端工具,它是完全可以比肩MobaXterm工具的。

m0_69576880的博客 4028

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

【大模型实战案例】手把手教大家微调大模型 Llama 3

Llama 3 近期重磅发布,发布了 8B 和 70B 参数量的模型,我们对 Llama 3 进行了微调!!!今天手把手教大家使用 XTuner 微调 Llama 3 模型。

weixin_59191169的博客 4858

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

ChatGLM3-6B大模型部署、微调【0到1小白教程】

小白教程,快速部署ChatGlm3大模型、快速使用loar微调大模型!

weixin_44480960的博客 2万+

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

大模型实战—Llama3-8B 中文微调

2.1.什么是 Llama3?Lllma3 是 META 公司发布的开源语言大模型,与 chatGPT 类似,它可以完成一系列诸如对话,翻译,上下文理解等等复杂任务,你可以把它理解为一个免费,可以部署在你的电脑无须联网就可以使用的 AI 助手。2.2.什么是 Ollama?Ollama 是一个支持在本地运行大语言模型的工具,兼容 Windows 和 MacOS 操作系统。使用 Ollama,您仅需一行命令即可下载并启动模型。

m0_59235699的博客 6865

玩转AI,笔记本电脑安装属于自己的Llama 3 8B大模型和对话客户端

2024 年 4 月 18 日,Meta**开源**了 Llama 3 大模型,把 AI 的门槛降低到了最低,这是人工智能领域的一个重要飞跃。我们个人也可以部署大模型了,这简直就是给个人开发者发了个大红包!Llama 3 模型有不同的参数版本,本文主要分享我在个人笔记本电脑是部署 8B 参数过程和编写客户端,让我们大家都参与进来,推动 AI 应用更上一层楼……

老牛啊 3180

【本地大模型部署与微调】ChatGLM3-6b、m3e、one-api、Fastgpt、LLaMA-Factory

本文档详细介绍了使用ChatGLM3-6b大模型、m3e向量模型、one-api接口管理以及Fastgpt的知识库,成功的在本地搭建了一个大模型。此外,还利用LLaMA-Factory进行了大模型的微调。

m0_73679391的博客 1万+

使用GpuGeek高效完成LLaMA大模型微调:实践与心得分享

本文分享了在GpuGeek平台上对LLaMA-7B模型进行微调的实践经验。通过选择LLaMA-7B模型并结合LoRA方法,作者在GpuGeek平台上快速创建了训练环境,并完成了模型微调。GpuGeek平台提供了丰富的GPU资源、快速实例创建和预置镜像,显著降低了训练门槛和成本。整个微调过程仅耗时4小时,展示了平台在资源调度、模型市场和镜像支持方面的优势。最后,作者总结了GpuGeek平台在AI项目落地中的高性能与高性价比,推荐开发者使用该平台进行大模型实践。

LucianaiB的博客 1万+
上一篇: Git开源爆火教程推荐:llm-action+开源大模型食用指南 (附课件教程)
下一篇: 【AI大模型】使用LLama-Factory训练和微调LLama3
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值