【AI落地应用实战】RAGFlow + 知识图谱 + Deepseek 初步探索

为什么说知识图谱 + RAG > 传统 RAG? 你是否曾觉得自己的大脑充斥了一团乱麻般的随机事实?知识图谱模拟了我们大脑思考事物,以及事物间关系的方式,同时又规避了大脑会遗忘和错误决策等问题。我们可以将知识图谱视为带了主语、谓语和宾语的三元组。它们将信息表示为一个由相互连接的实体组成的网络,以及实体之间的关系。本质上,知识图谱利用基于图的数据模型,其中节点代表实体(如人、地点或概念的主体和宾语),边表示这些实体之间的关系或谓语。OpenSPG 是一个语义增强的可编程知识图谱,GitHub地址如下,欢迎大家Star关注~ 阅读详情
AI摘要

本文探讨传统RAG表现不佳的原因,如知识结构空心化等问题,阐述在RAG中引入知识图谱的优势,如捕捉复杂关系等。还介绍了图谱+RAG需考虑的点,如构建图谱、内容去重等。最后进行RAGFlow + GraphRAG+ 知识图谱 + Deepseek的初步实践,包括配置模型、知识库等。

人们对 LLM + RAG 的期望其实是很高的,认为它可能会颠覆知识产业。

从逻辑上讲,这么想是有些道理的,LLM已经吃进去了互联网上所有的公开数据,而RAG机制则构建了动态的知识增强回路,相当于学到了数据里面所表示的知识,自然可以解答信息或知识层面的「任何」问题,理论上似乎是确实能端到端地做掉的。

但是从另一方面来说,知识的运用远非简单的数据检索游戏。

如果只是把一堆文件扔给学生,而不教给他们如何理解和分析,他们真的能找到问题的答案吗?

一、写在前面

1.1、传统RAG为什么表现不尽如意?

用RAG搭建过知识库就知道,在使用RAG搭建知识库的时候,整个索引、检索是基于文本块的,当有请求过来的时候,RAG首先根据请求去寻找哪些文本块是最相关、最匹配的,再把找到的文本块作为参考资料,连同请求一起给到大模型。
在这里插入图片描述

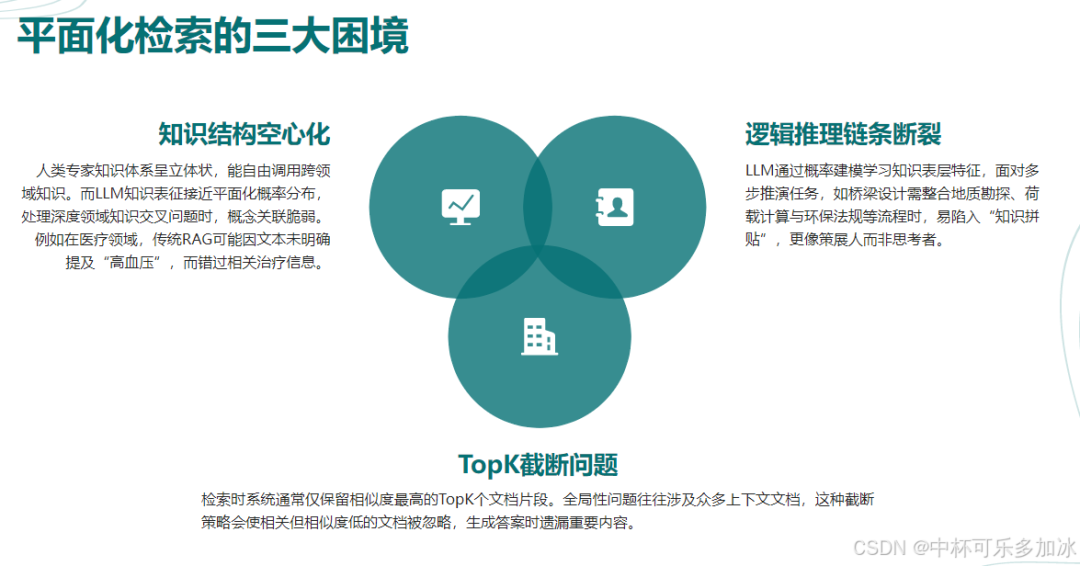
这种流程是极度依赖于基于相似度的向量检索技术,存在几个核心问题:

  1. 知识结构的空心化:人类专家的知识体系是立体建构的,既有学科主干脉络,又能自由调用跨领域知识节点。而LLM的知识表征更接近平面化的概率分布,当处理需要深度领域知识交叉的问题时,容易暴露概念关联的脆弱性。举个例子,用户询问“哪些药物可以治疗高血压?”,而知识库中有一段描述“β受体阻滞剂可以降低心率,从而减轻心脏负担”。尽管这段文本与高血压治疗相关,但由于未明确提及“高血压”,传统RAG可能根本无法将其纳入检索结果。
  2. 逻辑推理链条的断裂:LLM都是通过概率建模习得知识的表层特征,在面对需多步推演的任务(比如桥梁设计需同步整合地质勘探报告、荷载计算模型与环保法规等等流程)时,模型容易陷入"知识拼贴"的陷阱,很多时候,其更像博闻强记的策展人,而非真正意义上的思考者。
  3. TopK截断问题:在检索过程中,系统通常只保留相似度最高的TopK个文档片段。而对于全局性问题往往涉及到非常多的上下文文档,这种截断策略可能导致与查询相关但相似度较低的文档被忽略,生成答案时遗漏重要内容。

对应以上核心技术问题就会导致两个很普遍的现象:

  1. 缺少事情之间关系的理解:当需要关联不同信息以提供综合见解时,传统 RAG 很难将这些点连接起来。
  2. 缺乏整体视角:当要求 RAG 全面理解大型知识库甚至单个大型文档的整体语义概念时,缺乏宏观视角。

1.2、为什么要在RAG中引入知识图谱?

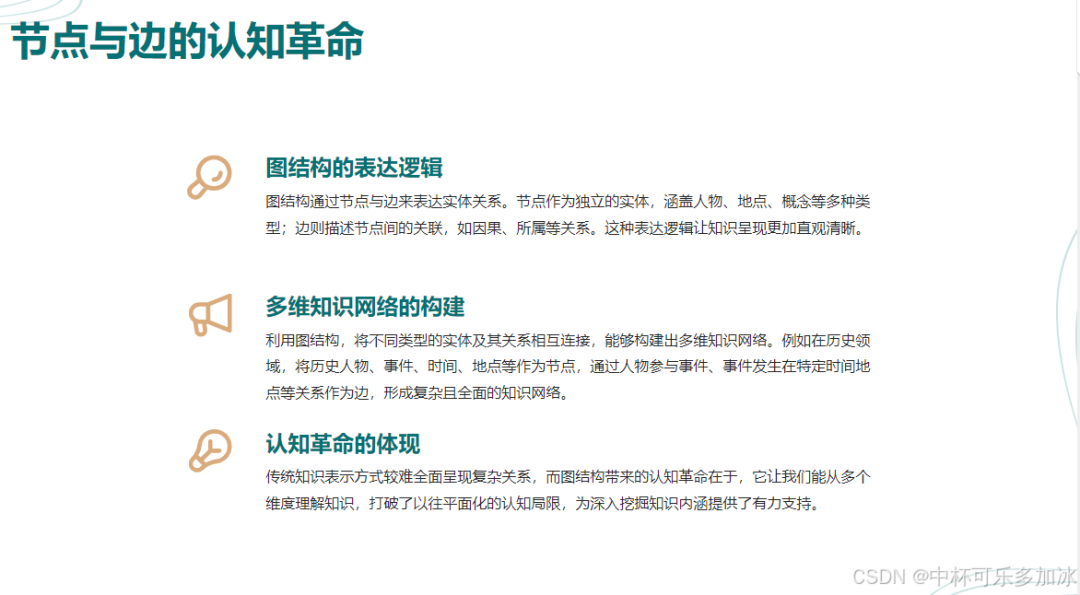
知识图谱是对现实世界实体及其关系的结构化表示。它们由两个主要部分组成:节点和边。节点表示独立的实体,例如人物、地点、物体或概念。而边则表示节点之间的关系,表示它们如何相互关联。
img

这种结构使 LLM 能够访问精确且与上下文相关的的数据,从而极大地提高了其生成信息丰富答案的能力,其核心优势在于:

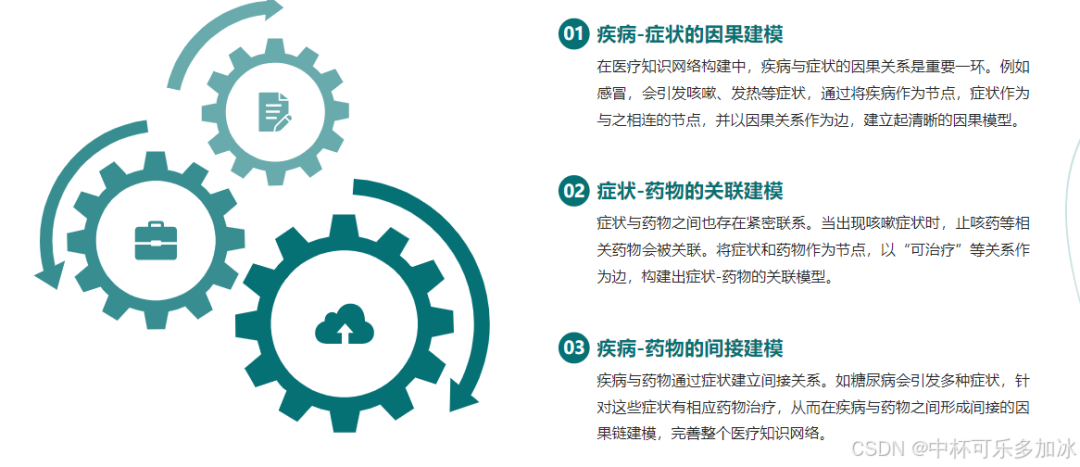
  • 捕捉复杂关系:知识图谱能够表示实体间的多层次、多类型关系。例如,在医疗领域,知识图谱可以表示“药物-疾病-症状”之间的复杂关联。在这里插入图片描述

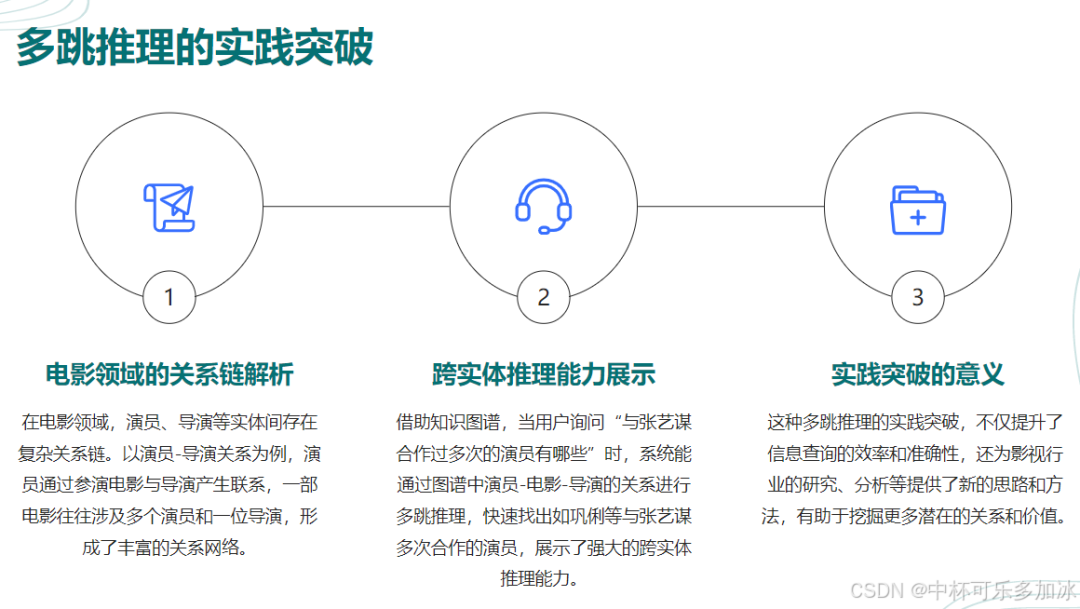
  • 支持语义推理:基于图结构的遍历和推理能力,知识图谱能够回答涉及多跳关系(Multi-hop Reasoning)的复杂查询。例如在电影领域,知识图谱可以表示“演员-电影-导演”之间的关系。当用户查询“汤姆·克鲁斯主演的科幻电影有哪些?”时,系统可以通过图谱快速找到相关电影,如《碟中谍》系列。在这里插入图片描述

    将知识图谱(KG)引入 RAG 体系,就像为 AI 构建了一张清晰的“知识地图”。知识图谱能够表达实体之间的复杂关系,例如父子关系、朋友关系、因果关系等等,从而让 AI 不仅能够“查到”信息,更能够“理解”信息之间的逻辑,给出更准确、更智能的答案。从依赖自身到检索外部信息,再到利用知识图谱进行深度理解。在这里插入图片描述

1.3、图谱+RAG需要考虑和关注的点

  • 构建知识图谱:构建图谱是一项非常耗时的工作,通常需要人工完成。目前有方案通过大型模型来构建图谱,通过提示词和文本,让大模型提取文本中的实体和关系,构建三元素,但基于LLM来建图,会引入非常多的噪声。如何在充分利用LLM知识的基础上,在人为可控的方式下建图?也是非常重要的一个问题。
  • 内容去重过滤:合并后的信息可能包含重复内容,比如“特朗普、川普、Trump、唐纳德·特朗普”都是一个人,通常需要对合并后的内容进行过滤。
  • 建模的合理性:图模型能够直观地表示实体之间的复杂关系,但不代表图这种方式就能对现实世界的信息进行全面的建模。对于一些特殊类型的数据,如历史数据、时间序列数据,仍然面临挑战。
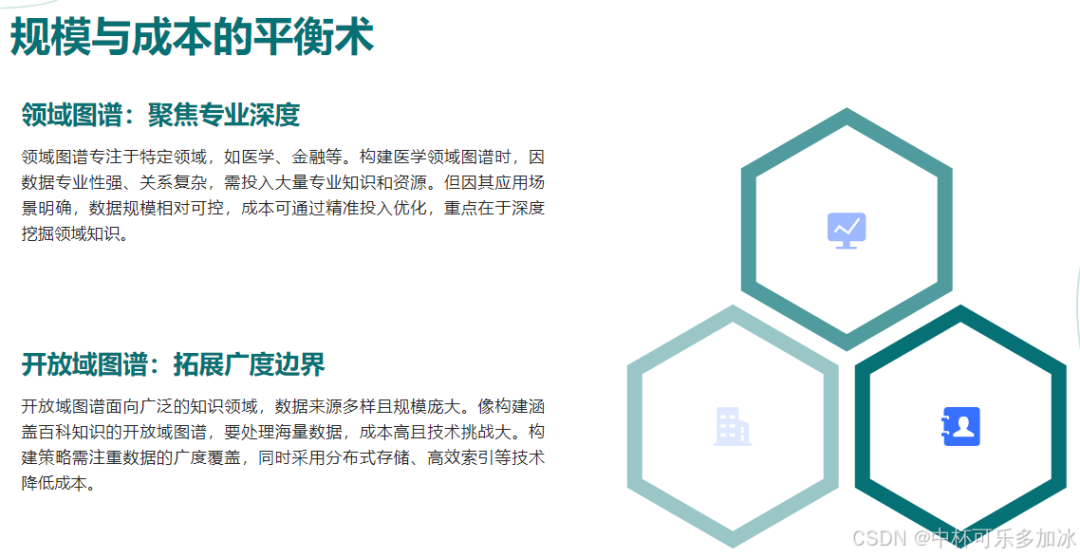
  • 图谱的规模:知识图谱到底能支持多大规模,还是未经验证的问题。它能应用到开放域,还是只能够用于特定领域?另一方面,随着数据规模的增大,建图的成本也会急剧上升。在这里插入图片描述
  • 适合的应用场景:通常来说,具备如下特征的数据和场景更适合使用图谱+RAG。 第一类是有较多相互关联实体与复杂关系,且结构较明确的数据。比如:
  • 人物关系网络数据:社交网络中的用户关系、历史人物关系、家族图谱等。
  • 企业级关系数据:公司结构、供应链、客户等之间的关系。
  • 医学类数据:疾病、症状、治疗、药物、传播、病例等之间复杂关系。
  • 法律法规数据:法律条款之间的引用关系、解释、判例与适用法律条
  • 推荐系统数据:产品、用户、浏览内容、产品之间的关联、用户之间的关系等。

第二类是涉及复杂关系、语义推理和多步逻辑关联的查询,比如:

  • 多跳关系查询:在华东区所有的门店中,哪个导购的消费者客单价最高?
  • 知识推理查询:根据患者的症状和病史,推断可能的疾病并提供治疗方案。
  • 聚合统计查询:在《三国演义》中,出场次数最多的人是谁?
  • 时序关联查询:过去一年都有哪些AI大模型的投资与并购事件?
  • 跨多文档查询:在《三体3》中,有哪些人物在《三体1》中出现?

二、RAGFlow + GraphRAG+ 知识图谱 + Deepseek 初步探索实践

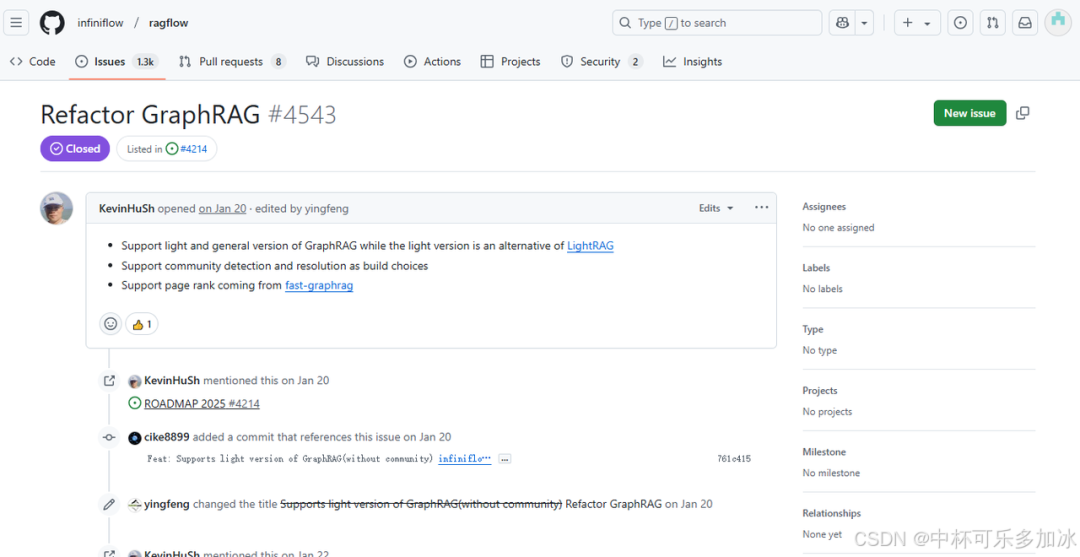
RAGFlow的V0.16.0版本以后对内置的GraphRAG做了重构,并且目前支持轻量级别的LightRAG和GraphRAG两种框架。

GraphRAG利用图结构增强上下文关联性,适用于医疗、法律等复杂领域,LightRAG则强调轻量化和高效,能够显著降低延迟和计算成本。这里做一个实践记录与分享,实践略过了RAGFlow在window或者linux的安装步骤,需要的话可以留言,后面可以补充再出一篇安装教程。
在这里插入图片描述

2.1、配置模型供应商

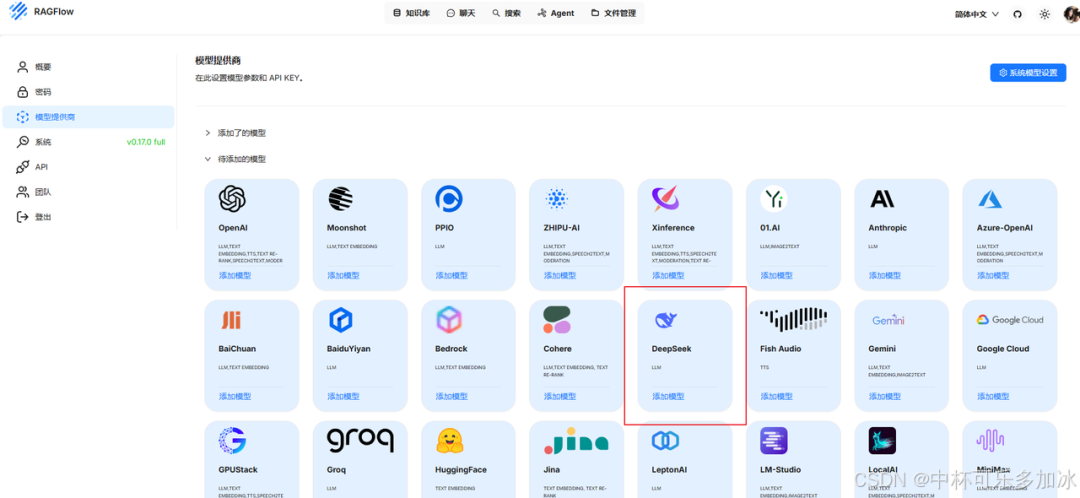
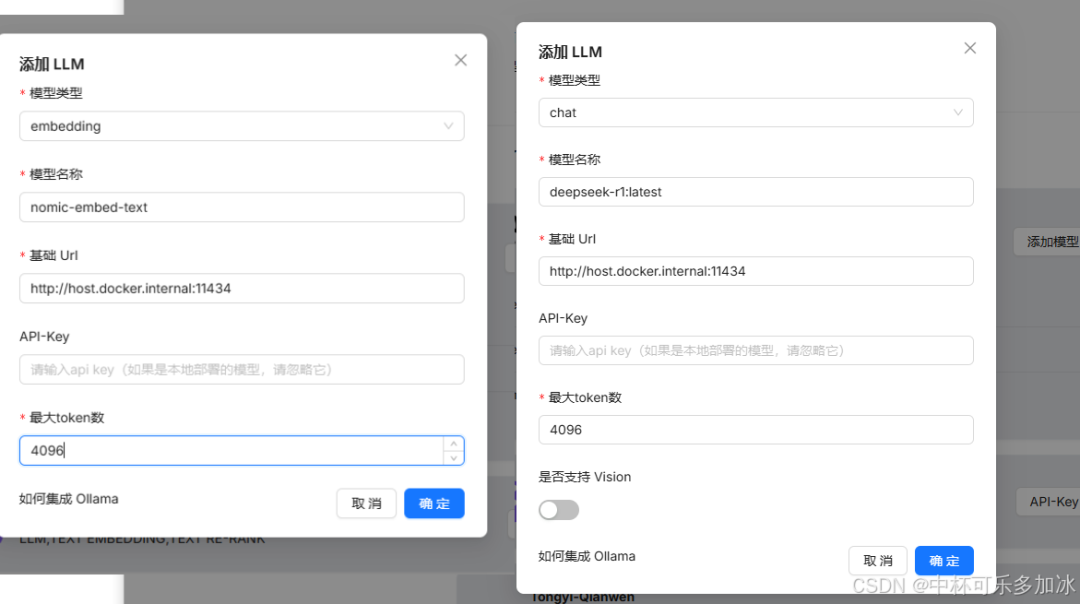
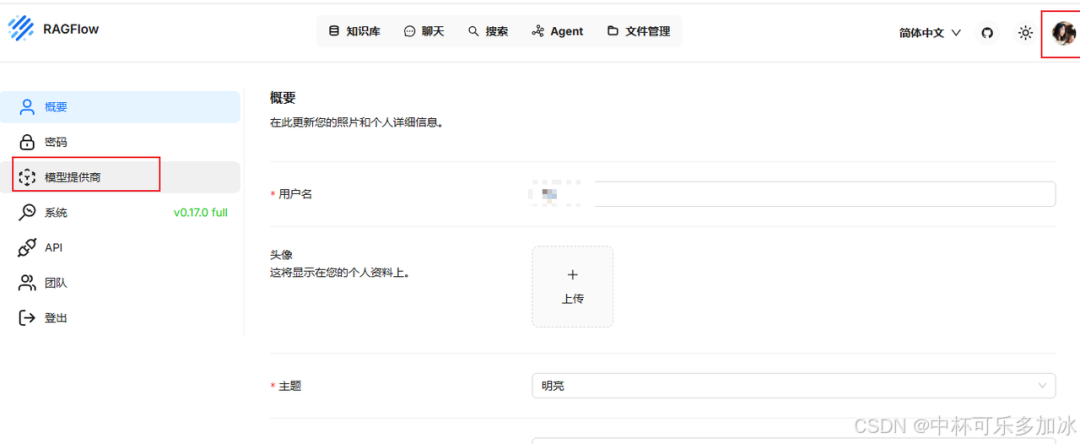
RAGFlow 支持大多数主流 LLM平台,还支持使用 Ollama、Xinference 或 LocalAI 在本地部署 LLM,这里首先要添加并配置 LLM,点击页面右上角的徽标> 模特提供商:在这里插入图片描述每个 RAGFlow 帐户都可以免费使用通义千问的嵌入模型text-embedding-v2,这里单击你所拥有的 LLM平台并相应地更新 API 密钥,deepseek也有:在这里插入图片描述如果是采用本地部署的模型的话,可以找到Ollama,配置对应的embedding和chat模型,Ollama的基础URL为:http://host.docker.internal:11434
在这里插入图片描述

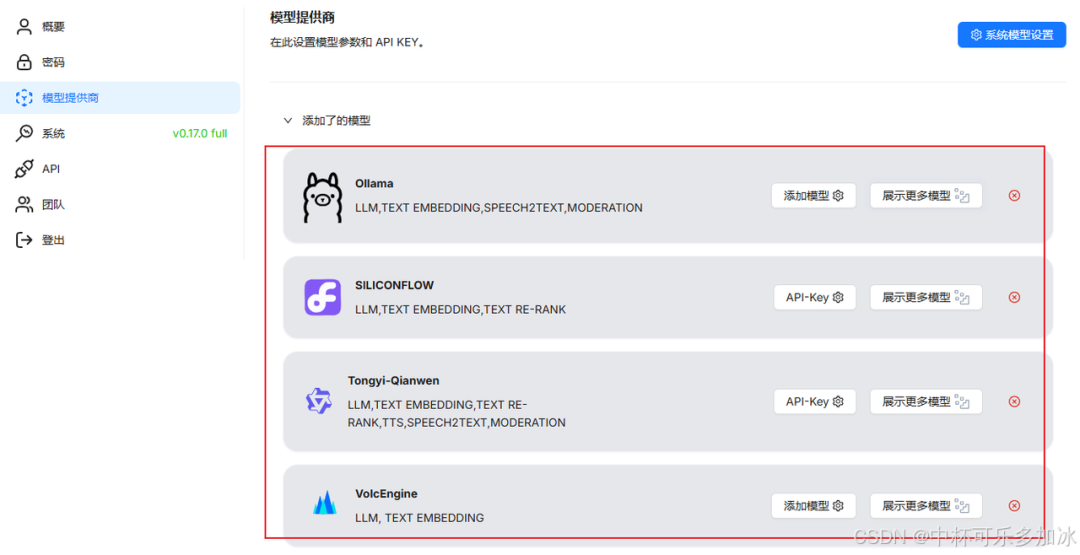
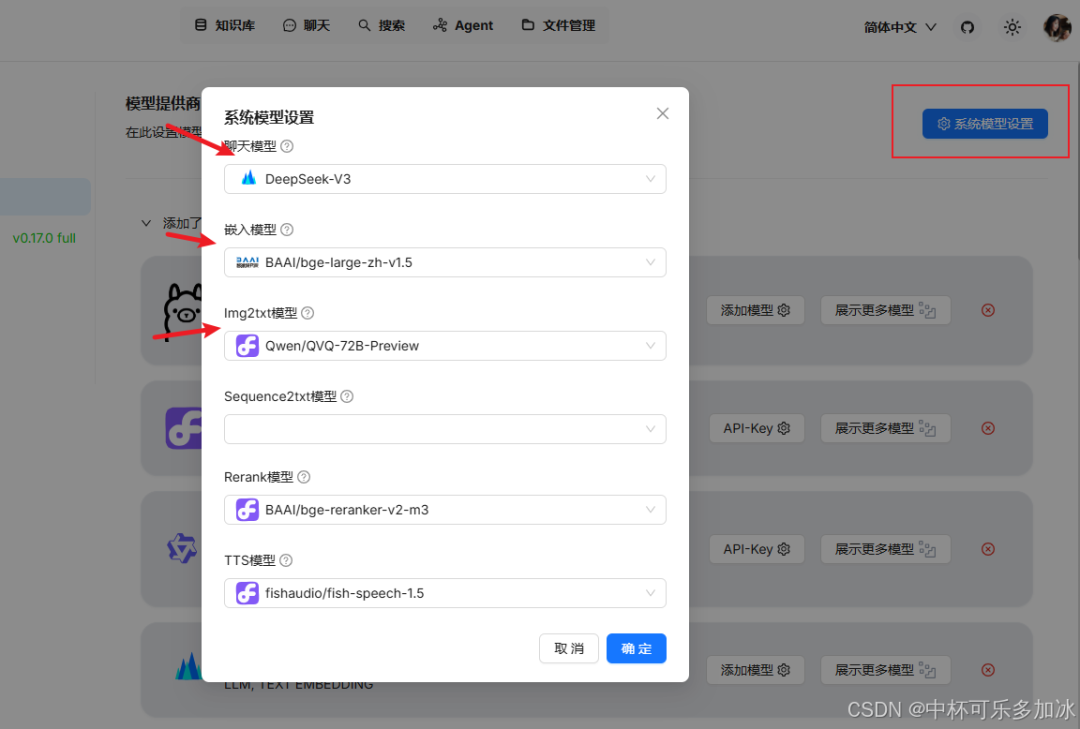
配置好后的模型列表,可以从“添加了的模型”这里看到:在这里插入图片描述配置好后,打开系统模型设置,其中img2txt模型就是OCR模型:在这里插入图片描述

2.2、配置知识库

正确配置知识库对于 AI 智能助手至关重要,选择错误的嵌入模型或块方法很容易导致聊天中出现意外的语义丢失或答案不匹配。在这里插入图片描述在知识库配置中,RAGFlow 通过嵌入模型、解析方法、页面排名、自动关键词、自动问题、召回增强及 RAPTOR 策略等技术,提升检索和生成效果,其中:
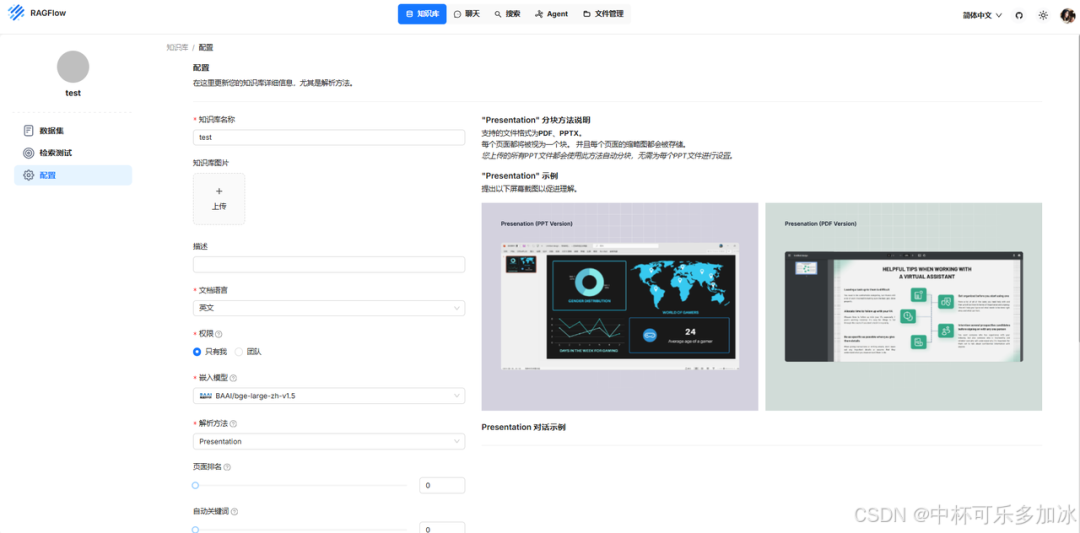
  1. 嵌入模型:将文本转换为向量,捕捉语义信息,常用于文本相似度计算和检索。RAGFlow 使用嵌入模型将文档和查询转换为向量,以便在向量空间中进行相似度匹配。
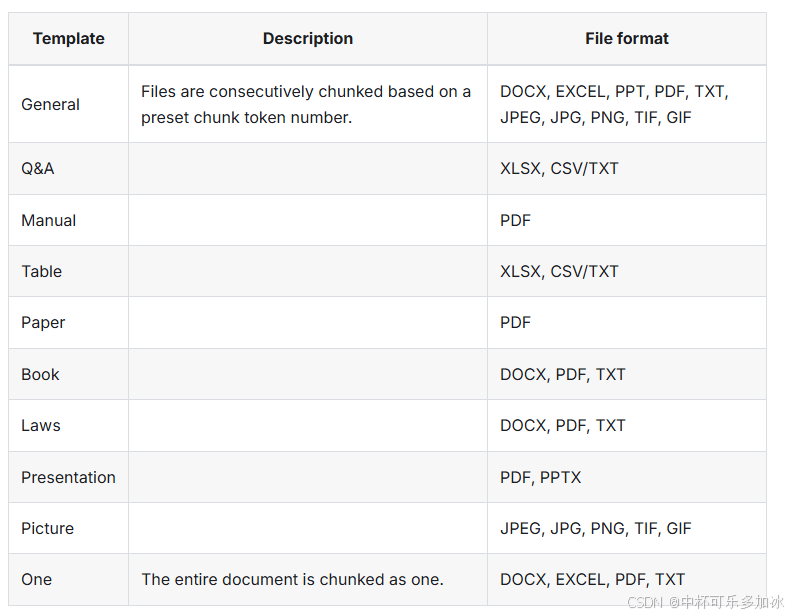
  2. 解析方法:RAGFlow 提供多种分块模板,方便对不同布局的文件进行分块。通过不同的解析方法,其可以将原始文本(如 PDF、HTML)转换为结构化数据,便于后续处理。在这里插入图片描述
  3. 页面排名:页面排名用于评估文档或段落的重要性,帮助系统优先检索更相关的内容,优先返回高质量信息。
  4. 自动关键词:用于在查询此类关键词时,为每个块提取 N 个关键词以提高其排名得分。
  5. 自动问题:自动问题生成从文本中生成相关问题,用于增强检索和生成。
  6. 使用召回增强RAPTOR策略:结合召回增强和任务导向的排序,优化检索结果。RAGFlow 可能通过动态调整检索范围或重新排序,确保生成模型获得最相关的信息。

2.3、配置知识图谱方法

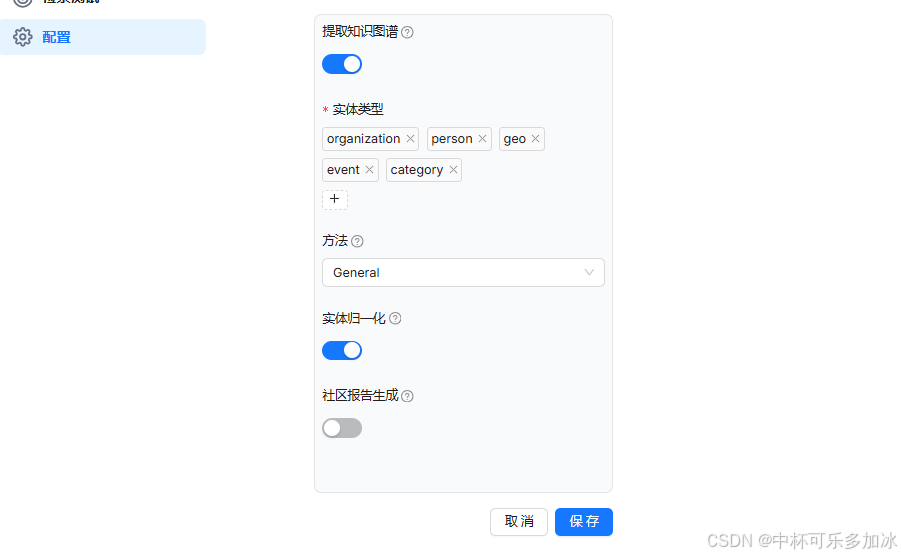
往下翻到知识图谱部分,打开提取知识图谱,实体类型可以就选默认的,然后方法选择General,然后打开实体归一化和社区报告生成,其中,实体类型是知识图谱的重要组成部分。常见的实体类型包括:

  • Organization(组织):如公司、机构、政府等。例如,“阿里巴巴”、“联合国”。
  • Person(人物):如历史人物、名人、科学家等。例如,“马云”、“爱因斯坦”。
  • Geo(地理):如国家、城市、地区等。例如,“中国”、“北京”。
  • Event(事件):如历史事件、会议、比赛等。例如,“第二次世界大战”、“奥运会”。
  • Category(类别):如产品、技术、学科等。例如,“人工智能”、“量子力学”。在这里插入图片描述

实体归一化是指将不同表达方式的实体统一为标准形式。例如,“马云”可能在不同的文本中被表达为“Jack Ma”、“阿里巴巴创始人”等。 实体归一化的目的是确保知识图谱中的实体具有唯一性和一致性,包括:

  • 同义词处理:将不同表达方式的实体映射到同一个标准实体。例如,“Jack Ma”和“马云”都映射到“马云”。
  • 消歧:处理同名实体的歧义问题。例如,“苹果”可能指“苹果公司”或“水果”,需要通过上下文进行消歧。社区报告生成是 RAGFlow 中的一个重要功能,在这一步,区块被聚集成层次化的社区,实体和关系通过更高抽象层次将每个部分连接起来,它通过分析知识图谱中的实体和关系,生成结构化的报告。具体步骤包括:通过图算法(如 Louvain 算法)发现知识图谱中的社区结构。社区是指一组紧密相连的实体,例如“科技公司社区”可能包括“阿里巴巴”、“腾讯”、“百度”等。

2.4、建立知识图谱

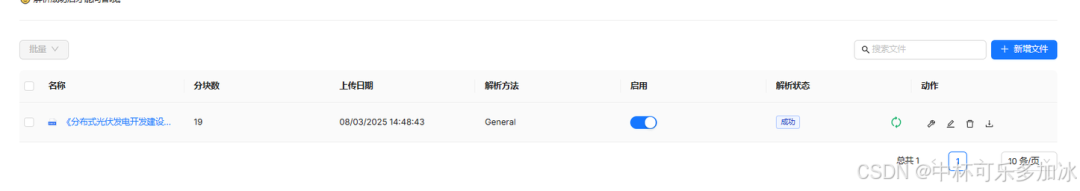
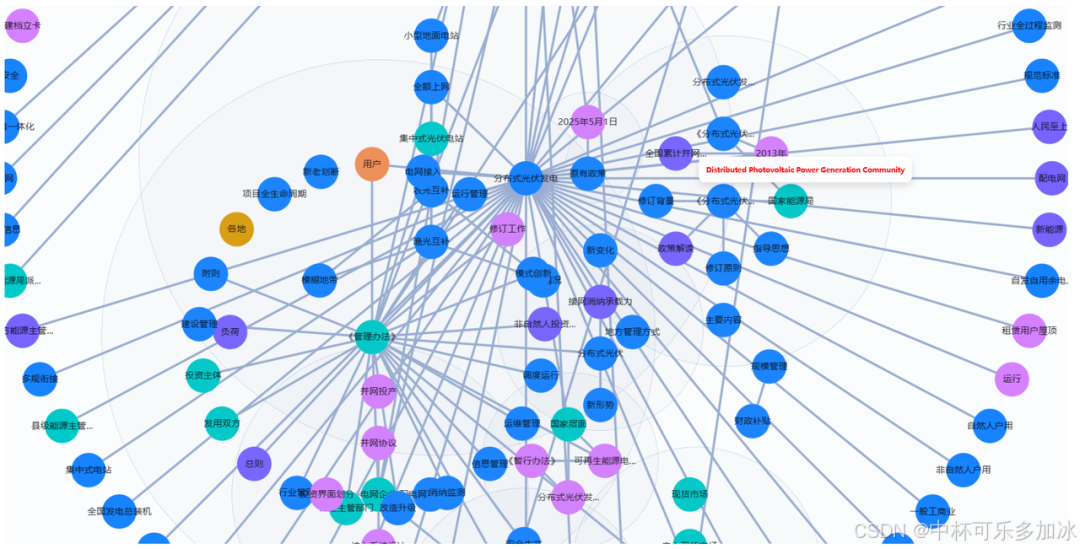
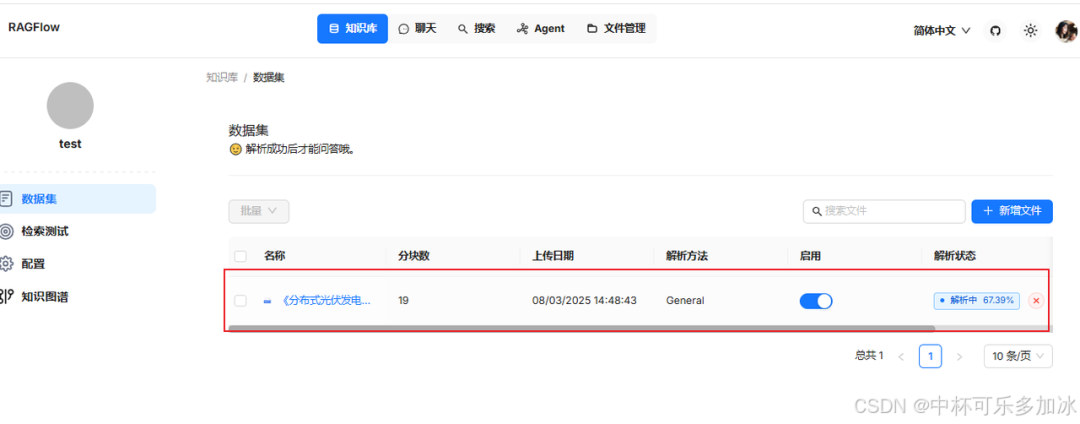
配置完数据库后,上传一条文件,然后点击开始解析:在这里插入图片描述在这里插入图片描述解析完后点击刷新,左侧会出现知识图谱菜单,点击进入查看建立好的知识图谱,其中每个深色的圆圈代表一个实体,实体之间的连线代表实体之间存在的关系。在这里插入图片描述外围淡色的圆圈代表实体组成的社区:[图片]
2.5、基于图谱+RAG的实践效果测试

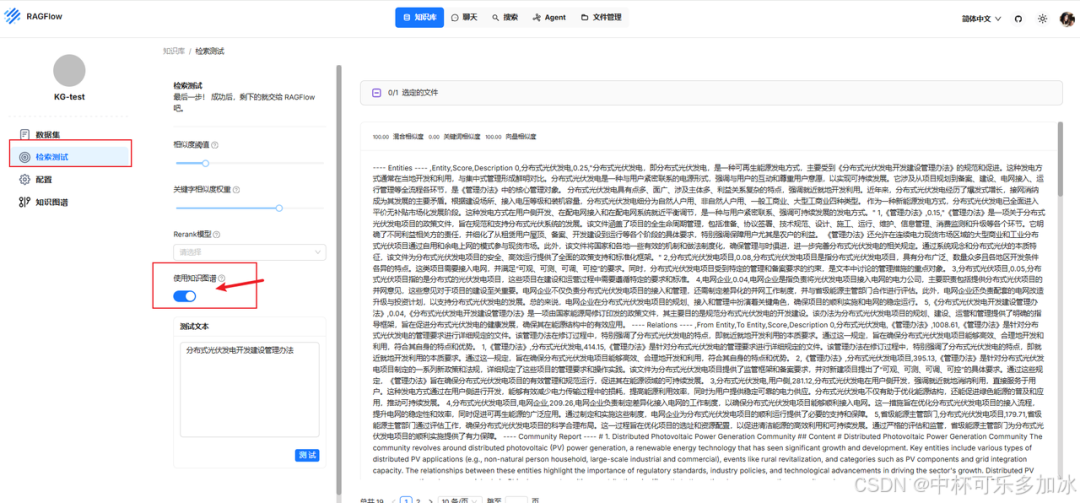
这里先来试一下检索,这是没有打开知识图谱的检索结果:
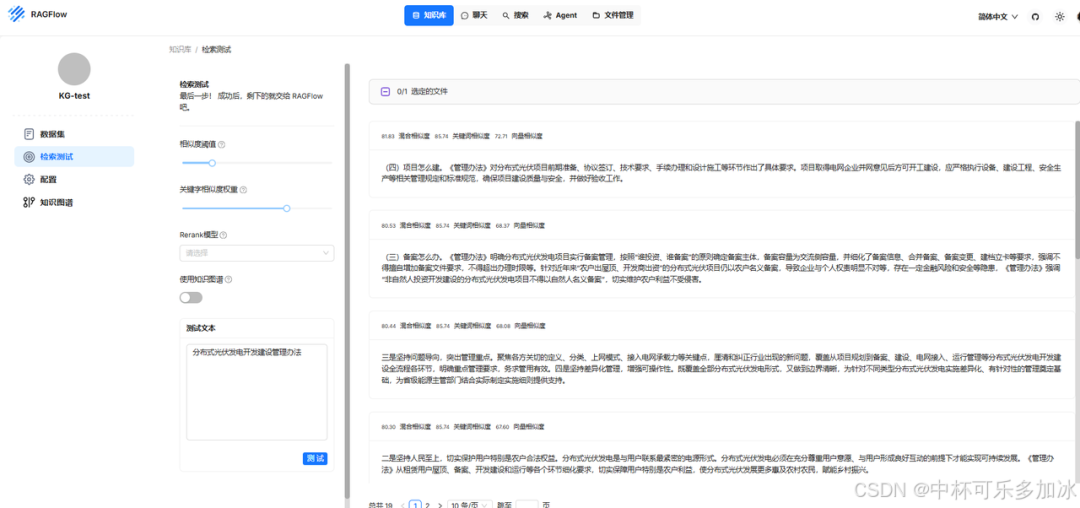
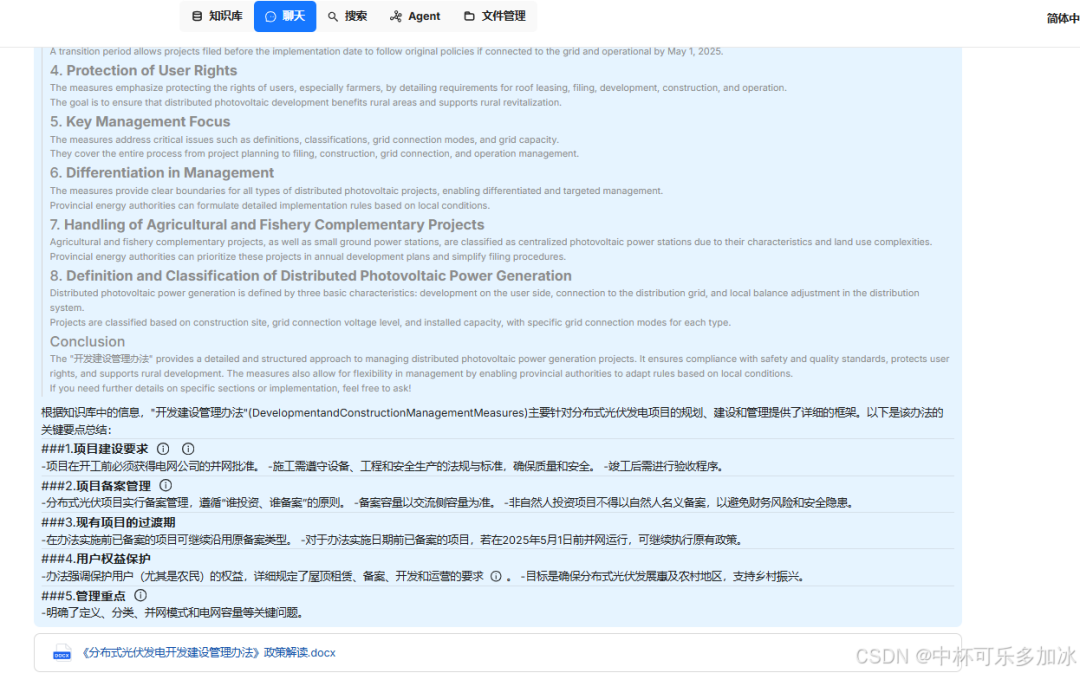
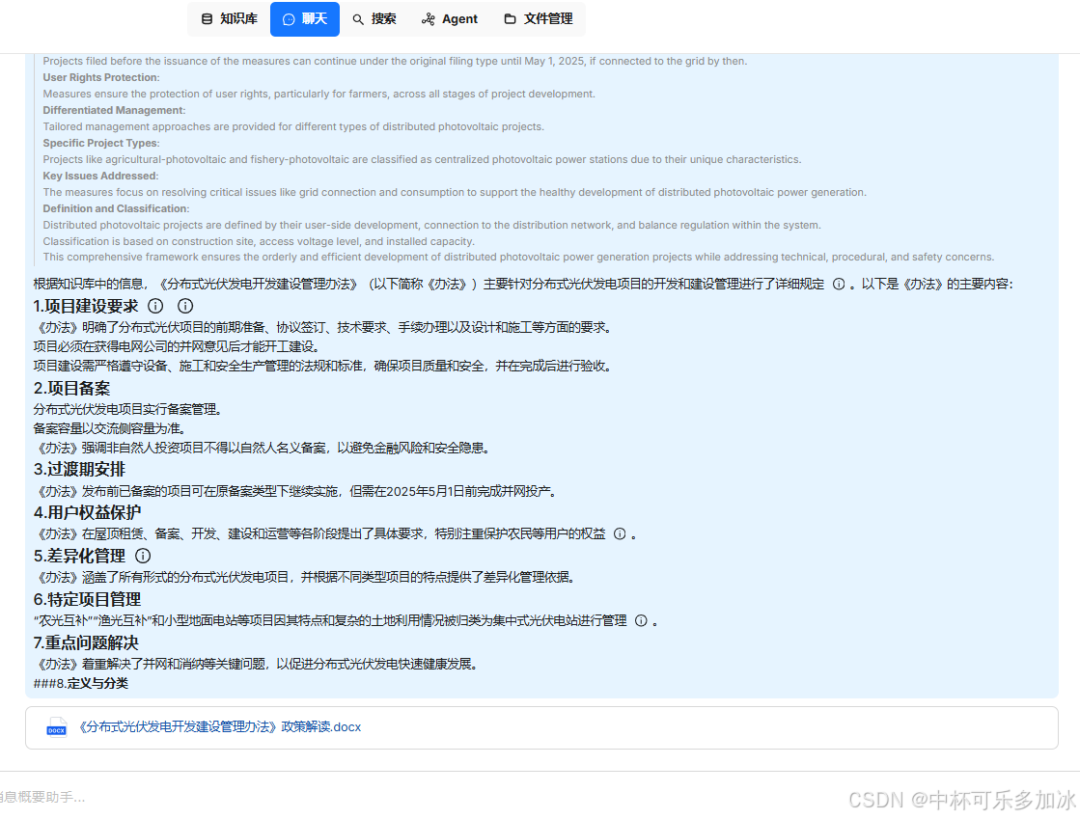
在这里插入图片描述这是打开了知识图谱的检索结果:在这里插入图片描述然后,再测试一下,这个是没有带知识图谱的回答效果:在这里插入图片描述这个是带知识图谱的回答效果:在这里插入图片描述

如何零基础入门 / 学习AI大模型?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高

那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

全套AGI大模型学习大纲+路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

read-normal-img

640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

在这里插入图片描述
在这里插入图片描述

在这里插入图片描述
在这里插入图片描述

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

img

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

来自工业界的知识库 RAG 服务(七),RagFlow 知识图谱实践与优化方案探索 在2024年,我曾撰写过RagFlow 源码全流程深度解析,对 RagFlow 的完整 RAG 流程进行了深入剖析。自那时起,RagFlow 经历了多轮迭代演进,不仅增强了 Agent 能力,更是在知识图谱支持方面取得了显著进展。最近,RagFlow 公众号发布了RAGFlow 0.16.0 特性总览,详细介绍了 RagFlow 对知识图谱机制的优化。本文将对 RagFlow 的知识图谱实现流程与机制进行深入分析,帮助读者更好地理解其实现细节,从而更有效地利用 RagFlow 的相关功能。 阅读详情

相关推荐

基于RAPTOR实现高质量长上下文的RAG

具体实现中,RAGFlow 在基于Deepdoc 的文档解析预处理阶段完成后,可选择性的打开 RAPTOR 开关进行聚类并生成摘要,随后把这些生成的内容跟原始的 Chunking 结果合并,然后共同送到数据库,分别建立全文索引和向量索引,后续的操作跟常规的 RAG 没有区别。今天我们要讲的是在 RAGFlow 正在开发的版本上 (github main 分支,docker dev tag),针对上面的第三点,提供了的一个实验性功能,就是本文标题所提到的基于 RAPTOR 实现长上下文 RAG。

datageek的博客 6775

全网首发!小白也能读懂的GraphRAG知识图谱全流程解析,多图预警!

全网首发!小白也能读懂的GraphRAG知识图谱全流程解析,多图预警!

Python单行客的博客 5042

DeepSeek部署及ragflow知识库问题汇总

普通的AI大模型:基于训练好的数据回答,知识库+AI:基于知识库和训练数据回答,网络Tools+知识库+AI:再加上网络数据回答,涉及到agent等知识,后续如果需求的朋友多会考虑出一期。A:仍然是镜像源的问题,设置镜像源后建议重启docker,截至视频发布,视频内镜像源仍可访问,如果还是不行,可以增加镜像源,配置如下。,如果不太熟悉git,一键安装包中已经下载好了,ragflow文件夹中就是,跳过下载,按照步骤操作即可。4.启动模型:也可以启动快捷图标ollama 即可在CMD模式下 使用交互窗口交互。

qq_40358970的博客 8877

学习 RAGFlow 的知识图谱功能,非常详细收藏我这一篇就够了!

昨天我们学习了 RAGFlow 的 RAPTOR 分块策略,今天我们将继续学习另一种高级配置 —— 提取知识图谱(use_graphrag):

WANGJUNAIJIAO的博客 3487

本地部署DeepSeek + Ragflow

Mac、Windows 本地部署DeepSeek + Ragflow,ollama + docker

效率开发者手札 1938

1.5元主控搞定高精度电流电压采集?STC8G1K08+INA180A3硬件设计全解析

本文详细解析了如何利用成本仅1.5元的STC8G1K08单片机与INA180A3电流检测放大器,构建一套高精度、低成本的电流电压采集系统。文章深入剖析了硬件设计精髓,包括利用MCU内部上拉电阻直驱数码管以节省成本、INA180A3的配置与计算,以及实现高频率采集并与上位机高速通信的软件策略,为嵌入式开发中的极致性价比设计提供了完整方案。

weixin_29166013的博客 599

【AI落地应用实战】RAGFlow + 知识图谱Knowledge Graph + Deepseek + 知识库构建初步探索

用RAG搭建过知识库就知道,在使用RAG搭建知识库的时候,整个索引、检索是基于文本块的,当有请求过来的时候,RAG首先根据请求去寻找哪些文本块是最相关、最匹配的,再把找到的文本块作为参考资料,连同请求一起给到大模型。知识结构的空心化人类专家的知识体系是立体建构的,既有学科主干脉络,又能自由调用跨领域知识节点。而LLM的知识表征更接近平面化的概率分布,当处理需要深度领域知识交叉的问题时,容易暴露概念关联的脆弱性。举个例子,用户询问“哪些药物可以治疗高血压?

白洞,白色的明天在等着我们 1万+

AD服务器搭建

一、角色安装1)打开服务器管理器,添加 角色和功能;2) 点 下一步;3)点 下一步;4)点 下一步;5)点击安装;6-1)将此服务器提升为域控制器;6-2)点下一步;6)输入密码 点 下一步;7)自动生成LIXF,点击下一步;8)确认目录,点下一步;8)确认安装条件,点安装; 8)安装成功,点关闭;...

潇峰的博客 6445

【AI落地应用实战】RAGFlow + 知识图谱Knowledge Graph + Deepseek + 知识库构建初步探索_ragflow 知识图谱

摘要:传统检索增强生成(RAG)系统在处理多实体、多关系的复杂查询时存在局限性,主要表现为知识结构空心化、逻辑推理断裂和TopK截断问题。为优化这些问题,引入知识图谱(KG)成为有效解决方案。知识图谱通过结构化的节点和边表示实体间复杂关系,支持语义推理和多跳查询,从而提升RAG系统的精准性和理解能力。研究表明,结合知识图谱的RAG系统能更高效地处理跨领域关联问题,提供更全面的答案,具有显著的技术优势与实践价值。

qkh1234567的博客 1839

RPA实战-UiPath自动化处理Outlook邮件附件全流程解析

本文详细解析了如何使用UiPath实现Outlook邮件附件的自动化处理全流程,涵盖环境配置、核心流程实现、高级功能扩展及性能优化技巧。通过RPA技术,企业可大幅提升邮件附件处理效率,减少人工操作错误,适用于财务、物流等多个场景。

weixin_33701251的博客 426

【TC3xx芯片】TC3xx芯片UCB详解

TC3xx芯片UCB详解

qq_36056498的博客 1万+

【AI落地应用实战】DeepSeek + RagFlow + Ollama + 私有知识库 构建本地知识库系统实战指南

本文将带您构建一个集大模型推理、智能检索、知识加工于一体的本地知识库系统,深度融合DeepSeek认知大模型的语义理解能力、RagFlow的文档智能处理能力以及Ollama的本地化部署优势。本文将以DeepSeek、RagFlow、Ollama为核心,手把手带你搭建一套支持GPU加速的私有知识库系统,助你快速实现AI技术的本地化部署与私有知识管理。

白洞,白色的明天在等着我们 1万+

第四节:Vben Admin登录对接后端getUserInfo接口

上一节,我们完成了/api/auth/login接口的创建,通过login接口,我们完成了登录和Token的生成。但是登陆还是报404返回,发现是Vben Admin又请求了一个/api/getUserInfo接口,本节我们就来分析完成这个接口本节,我们完成了getUserInfo接口,完成了登录操作,成功的进入到工作台页面。

cuiwin的专栏 2845

【AI落地应用实战】DeepSeek + RagFlow + 本地私有知识库 构建本地知识库系统实战指南

大模型应用的关键,不只是构建好模型算法,更重要的是做好数据的处理、挖掘等问题。数据贯穿了大模型从预训练到产业落地的全过程。一定程度上,智能时代,而能力再强大的 LLM 也只能取代人部分学习和推理能力,无法取代存储和访问数据的能力;参数再多的 LLM 也不能仅凭基于通用数据的训练就能精确表达企业内部海量且丰富的数据。而处理这类数据,才是私有化场景的主要需求。

Python_cocola的博客 1273

python:实现矩阵SVD分解(附完整源码)

python:实现矩阵SVD分解(附完整源码)

希望我的博客,能帮上你解决学习中工作中所遇到的问题 603

【TC3xx芯片】TC3xx DMA模块详解

TC3xx DMA模块详解

qq_36056498的博客 5916

0基础玩deepseek+RAGFlow本地部署+搭建知识库

宝子们😎,还在为找资料东奔西走,被付费知识 “割韭菜” 而烦恼吗🧐?今天就给大家分享超实用的技术干货 ——DeepSeek 和 RAGFlow 本地部署,再手把手教你搭建专属知识库📚,让知识管理和获取变得轻松又高效,而且 0 基础也能轻松上手!宝子们😎,还在为找资料东奔西走,被付费知识 “割韭菜” 而烦恼吗🧐?今天就给大家分享超实用的技术干货 ——DeepSeek 和 RAGFlow 本地部署,再手把手教你搭建专属知识库📚,让知识管理和获取变得轻松又高效,而且 0 基础也能轻松上手!1、安装。

m0_58592891的博客 2万+

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

AI大模型应用实战: DeepSeek+RAGflow纯本地化知识库搭建全教程

作者在搭建私有知识库部署ragflow过程中踩了很多坑,在此分享一下本地安装部署经验。话不多说,本文全程干货。

zhishi0000的博客 1856

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

DeepSeek+Ragflow搭建个人知识库

利用Deepseek+Ragflow搭建的知识库过程还是比较简单,正常跟着流程走不容易出错。如果投喂的数据经过整合处理,那么反馈的结果还是有一定的实际意义。当前个人能部署的模型参数太少,尚处于体验阶段。相信不久的将来,大模型不断发展,个人能部署性能更强大的模型。

m0_63171455的博客 7081

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

上一篇: GitHub Star 41.9k,全网疯传的《从零构建大模型》配套视频来啦!
下一篇: 使用Dify + DeepSeek在本地电脑搭建工作流,太香了
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论 4
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值