


原文:Leveraging LLMs for Unsupervised Dense Retriever Ranking
地址:https://arxiv.org/abs/2402.04853
代码:https://github.com/ielab/larmor/
出版:SIGIR '24
机构: 昆士兰大学、澳大利亚联邦科学与工业研究组织
1 研究问题
本文研究的核心问题是: 如何在无监督和零样本场景下为特定目标语料库选择最佳的密集检索器(也是RAG检索增强中重点研究环节)。
想象一个小型法律咨询公司刚刚建立了一个包含数千份法律文件的数据库。他们想要实现一个高效的搜索系统,但面临两个挑战:首先,他们没有足够的资源来为这个特定领域的数据集训练一个新的检索模型;其次,他们也没有现成的查询-文档相关性标注数据。在这种情况下,如何从现有的预训练密集检索器中选择一个最适合他们数据库的模型就成为了一个关键问题。
本文研究问题的特点和现有方法面临的挑战主要体现在以下几个方面:
-
缺乏目标语料库的查询和相关性判断:传统方法通常依赖于目标语料库的查询和人工标注的相关性判断来评估检索器性能,但在实际应用中,这些资源往往难以获得或成本很高。
-
领域偏移问题:预训练的密集检索器在面对与其训练数据不同领域的目标语料库时,性能往往会下降。
-
模型选择的复杂性:随着各种密集检索器模型的不断涌现,如何在众多模型中选择最适合特定目标语料库的一个变得越来越具有挑战性。
-
评估方法的局限性:现有的一些无监督评估方法,如基于分数的查询性能预测(QPP)技术,在跨模型比较时效果不佳,因为不同模型产生的分数分布可能有很大差异。
总的来说这个调整非常普片,基本上现在RAG都会有这个痛点。针对这些挑战,本文提出了一种名为"大语言模型辅助检索模型排序"(LARMOR)的方法:
LARMOR的核心思想是利用大语言模型(LLM)的强大能力来模拟人类专家在评估检索系统时的行为。就像一个法律专家可以根据文档内容构造相关查询并判断检索结果的相关性一样,LARMOR使用LLM为目标语料库生成伪查询、伪相关性判断和伪参考列表。这些生成的数据然后被用来评估和排序各种密集检索器。具体来说,LARMOR首先从目标语料库中采样一部分文档,并使用LLM为每个文档生成多个相关查询。这就像是模拟了可能的用户查询。然后,它使用这些生成的查询来获取各个密集检索器的检索结果。接下来,LARMOR再次调用LLM来为这些检索结果生成相关性判断或重新排序,从而创建伪相关性判断和伪参考列表。最后,基于这些生成的数据,LARMOR可以计算各种评估指标(如nDCG或RBO)来对密集检索器进行排序。这种方法巧妙地解决了缺乏真实查询和相关性判断的问题,同时也能适应不同领域的目标语料库。它就像是创造了一个"虚拟评估员",可以为任何给定的语料库生成评估数据并进行检索器选择。
2 研究方法
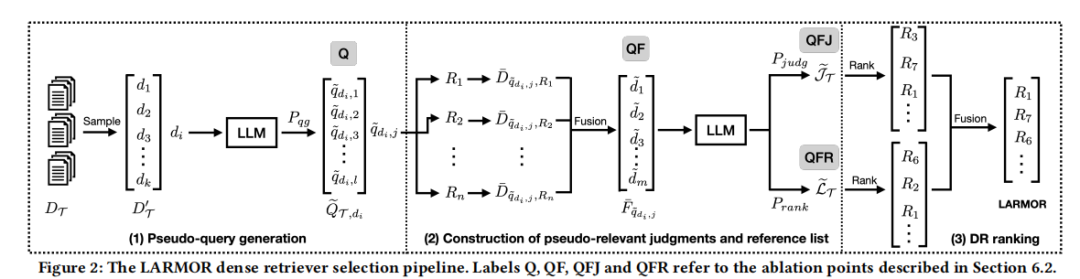
论文提出了一种名为LARMOR(Large Language Model Assisted Retrieval Model Ranking)的方法,用于解决密集检索器选择问题。这种方法巧妙地利用了大语言模型(LLM)的能力,在没有目标语料库查询和相关性判断的情况下,对密集检索器进行无监督排序。LARMOR主要包括三个关键步骤:伪查询生成、伪相关性判断和参考排序列表构建,以及密集检索器排序。下面我们将详细介绍这三个步骤。
2.1 伪查询生成
在实际应用中,我们经常面临这样的情况:有一个目标语料库需要应用密集检索器,但没有相应的查询集。LARMOR方法的第一步就是解决这个问题,通过生成伪查询来模拟真实的查询场景。
具体来说,论文采用以下步骤生成伪查询:
-
从目标语料库中随机抽样个文档,形成子集。
-
对于每个抽样文档,使用LLM生成个查询。生成过程可以表示为:其中是针对特定领域的查询生成提示。
举个例子,假设我们正在处理一个维基百科文章的集合。对于一篇关于"人工智能"的文章,我们可能会使用这样的提示:“生成一个这篇维基百科文章可以回答的问题。避免生成一般性问题。维基百科页面:{}”。LLM可能会生成如下查询:
-
“什么是图灵测试,它与人工智能有什么关系?”
-
“深度学习在人工智能发展中起到了什么作用?”
-
“人工智能在医疗领域有哪些具体应用?”
通过这种方式,我们可以为目标语料库生成一组与领域相关的伪查询,这些查询将在后续步骤中用于评估密集检索器的性能。
2.2 伪相关性判断和参考排序列表构建
有了伪查询后,下一步是构建评估密集检索器所需的信号。LARMOR方法创新性地提出了两种评估信号:伪相关性判断和伪参考排序列表。
2.2.1 伪相关性判断
为了生成伪相关性判断,LARMOR采用以下步骤:
-
对于每个生成的查询,使用所有待评估的密集检索器检索文档,得到排序结果。
-
使用排序融合算法(如RRF)合并这些排序结果,得到一个融合排序。
-
从中选取前个文档,让LLM为这些文档生成相关性判断:这里,是用于生成相关性判断的提示。
举个例子,对于之前生成的查询"深度学习在人工智能发展中起到了什么作用?",LLM可能会被要求判断一篇讨论神经网络的文章是否相关。提示可能是这样的:“对于以下查询和文档,判断它们是’高度相关’、‘somewhat相关’还是’不相关’。查询:{} 文档:{}”。
2.2.2 伪参考排序列表
除了生成相关性判断,LARMOR还提出了生成伪参考排序列表的方法:
-
使用与生成相关性判断相同的融合排序。
-
让LLM重新排序这个文档,生成一个理想的排序列表:这里,是用于生成排序列表的提示。
具体来说,LLM可能会被要求:“请根据与查询’深度学习在人工智能发展中起到了什么作用?'的相关性,对以下文档进行排序,最相关的排在前面。”
这两种评估信号的结合为后续的密集检索器排序提供了强有力的支持。
2.3 密集检索器排序
有了伪相关性判断和伪参考排序列表,LARMOR方法可以对密集检索器进行排序。这个过程分为三个步骤:
- 使用伪相关性判断进行排序:
-
对于每个密集检索器,使用生成的查询检索文档。
-
使用评估指标E(如nDCG@10)和伪相关性判断评估检索结果。
-
计算每个检索器的平均评估分数。
-
根据对检索器进行降序排序。
- 使用伪参考排序列表进行排序:
-
对于每个密集检索器,计算其检索结果与伪参考排序列表之间的平均RBO(Rank Biased Overlap)值。
-
根据RBO值对检索器进行降序排序。
- 融合两种排序结果:
- 使用排序融合算法(如RRF)合并上述两种排序结果,得到最终的检索器排序。
这个过程可以用一个具体的例子来说明。假设我们有三个密集检索器A、B和C,需要为一个医学文献库选择最合适的一个。
- 使用伪相关性判断:
-
检索器A的平均nDCG@10为0.8
-
检索器B的平均nDCG@10为0.7
-
检索器C的平均nDCG@10为0.9 排序结果为: C > A > B
- 使用伪参考排序列表:
-
检索器A的平均RBO为0.85
-
检索器B的平均RBO为0.9
-
检索器C的平均RBO为0.8 排序结果为: B > A > C
- 融合结果: 最终排序可能是: A > C > B
这个例子展示了LARMOR如何综合考虑不同的评估信号,得出一个全面的密集检索器排序结果。
LARMOR方法的创新之处在于,它完全不依赖目标语料库的真实查询和相关性判断,而是巧妙地利用LLM生成所需的评估信号。这使得它能够在零样本场景下,为各种领域的语料库选择最合适的密集检索器。
直觉上,LARMOR的工作原理类似于模拟考试。我们可以把LLM看作是一个经验丰富的教师,它根据目标领域的特点出题(生成伪查询),然后为学生(密集检索器)的答卷(检索结果)打分(生成相关性判断和理想排序)。最后,我们根据这些"模拟考试"的结果来评估哪个"学生"(密集检索器)最适合这个特定的"学科"(目标语料库)。
总的来说,LARMOR为解决密集检索器选择这一关键问题提供了一种创新且有效的方法,尤其是在缺乏目标语料库标注数据的情况下。这种方法不仅适用于学术研究,也有很大的实际应用价值,可以帮助各种领域的信息检索系统选择最合适的密集检索器,从而提高检索效果。
3 实验
3.1 实验场景介绍
该论文提出了一种名为LARMOR的方法,用于在零样本场景下选择最适合目标集合的密集检索器(Dense Retriever,DR)。实验主要验证LARMOR在各种数据集上的性能,并与现有方法进行对比。此外,还探究了LARMOR各组件的作用以及不同LLM配置对性能的影响。
3.2 实验设置
-
Datasets:使用BEIR基准测试中的13个语料库,涵盖9个不同任务,包括Natural Questions、FiQA、ArguAna等
-
Baseline:包括MSMARCO performance、Binary Entropy、Query Alteration等多个基线方法
-
Implementation details:
-
使用FLAN-T5作为主要的LLM模型
-
对每个语料库随机采样100个文档,每个文档生成10个查询,共1000个生成查询
-
使用top-p采样策略,p=0.9
-
使用Reciprocal Rank Fusion (RRF)作为融合算法
-
metric:
-
Kendall Tau相关性:评估方法生成的DR排名与真实排名的相似度
-
Δe:评估所选DR与最佳DR之间的性能差距
3.3 实验结果
实验1、主要结果实验
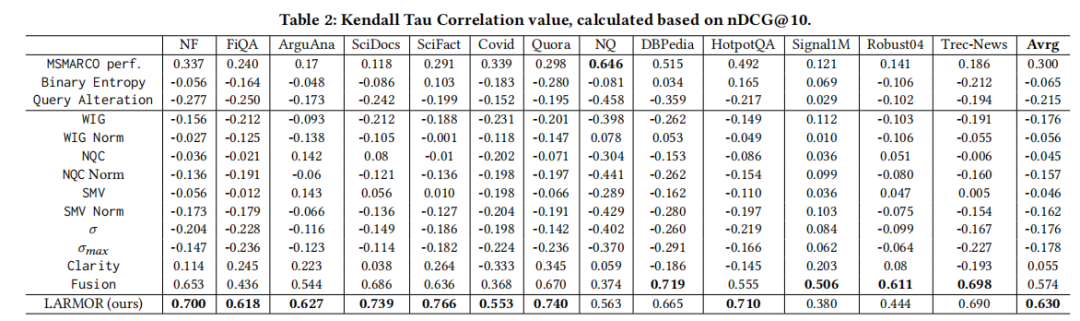
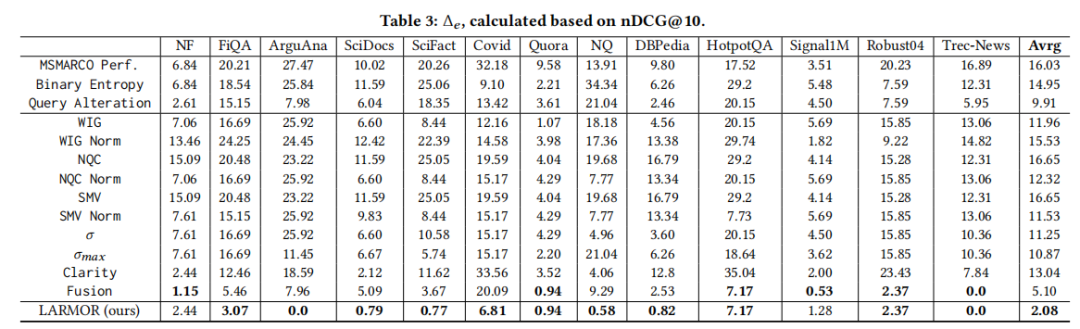
目的:评估LARMOR与其他基线方法在DR选择任务上的性能
涉及图表:表2(展示了各方法的Kendall Tau相关性值)、表3(展示了各方法的Δe值)
实验细节概述:在13个BEIR数据集上比较LARMOR与多个基线方法的性能
结果:
-
LARMOR在Kendall Tau和Δe两个指标上都显著优于其他方法
-
LARMOR在两个数据集上选择了最佳DR,平均nDCG下降仅为2.08%
-
基于分数的方法(如WIG、NQC等)表现较差,可能是由于不同DR的分数分布差异
实验2、LARMOR组件消融实验
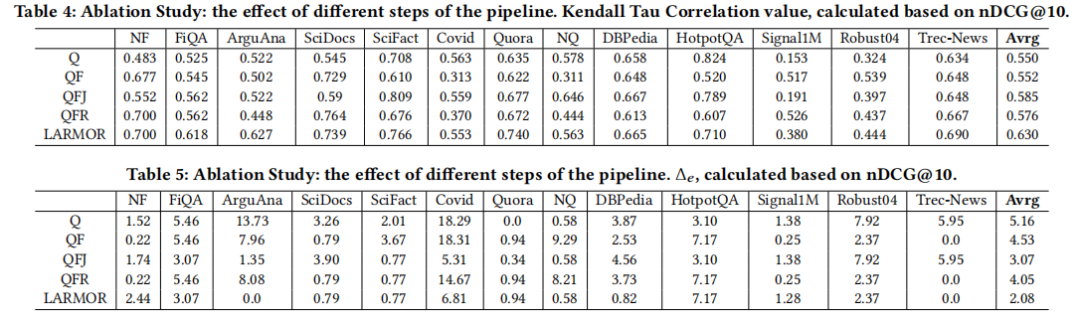
目的:评估LARMOR各组件对模型性能的贡献
涉及图表:表4(展示了不同组件对Kendall Tau的影响)、表5(展示了不同组件对Δe的影响)
实验细节概述:分别测试Query generation (Q)、Rank fusion (QF)、Pseudo-judgments (QFJ)和Pseudo-reference lists (QFR)的效果
结果:
-
仅使用Q组件就能达到优于多数基线的性能
-
QF进一步提升性能,甚至在Δe上超过了使用真实查询的QPP Fusion
-
QFJ和QFR都显著提升了性能
-
完整的LARMOR pipeline通过融合QFJ和QFR达到最佳性能
实验3、LLM模型大小影响实验
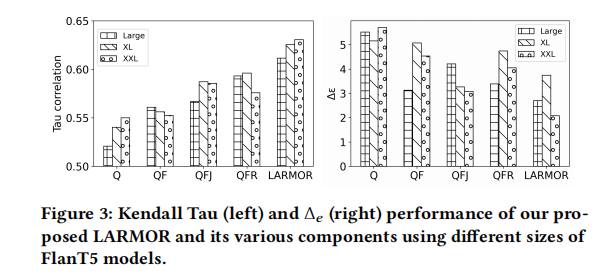
目的:研究不同大小的FlanT5模型对LARMOR及其组件性能的影响
涉及图表:图3(展示了不同FlanT5模型大小对LARMOR各组件Kendall Tau和Δe性能的影响)
实验细节概述:比较FLAN-T5-large (780M)、FLAN-T5-XL (3B)和FLAN-T5-XXL (11B)三种模型在LARMOR各组件上的表现
结果:
-
模型大小对性能的影响在不同pipeline步骤中表现不一致
-
较大的模型不总是表现更好,传统的LLM缩放定律可能不适用于此任务
-
FLAN-T5-XXL在完整LARMOR pipeline中表现最佳
实验4、LLM骨干和生成查询数量影响实验
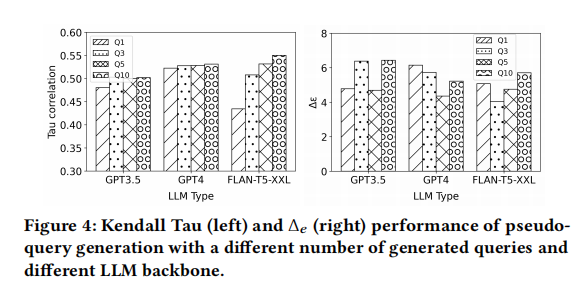
目的:分析不同LLM骨干和生成查询数量对伪查询生成性能的影响
涉及图表:图4(展示了不同数量的生成查询和不同LLM骨干对Kendall Tau和Δe性能的影响)
实验细节概述:比较FLAN-T5-XXL、GPT-3.5和GPT-4在不同生成查询数量下的性能
结果:
-
增加生成查询数量通常能提升性能,尤其是对FLAN-T5-XXL
-
GPT-4在Kendall Tau上整体表现较好,但FLAN-T5-XXL在生成10个查询时可以超越它
-
在特定任务(如Arguana)上,GPT模型表现出色,可能是由于其生成反驳论点的能力更强
4 总结后记
本论文针对密集检索器(Dense Retriever, DR)选择问题,提出了一种名为LARMOR(Large Language Model Assisted Retrieval Model Ranking)的无监督方法。LARMOR利用大语言模型(LLM)为目标语料生成伪相关查询、标签和参考列表,然后基于这些生成的信号对DR进行排序。实验结果表明,LARMOR在13个BEIR集合上显著优于现有的DR选择方法,能够准确预测DR在零样本场景下的有效性排序。
疑惑和想法:
-
LARMOR目前只考虑了DR,是否可以扩展到其他类型的检索模型,如稀疏检索器或混合检索模型?
-
论文使用了特定领域的提示来生成查询,这些提示是如何设计的?是否可以进一步优化提示以提高生成质量?
-
目前LARMOR使用的是FlanT5模型,随着更先进开源LLM的发布(如Mistral、Llama3等),如何利用这些模型来进一步提升LARMOR的性能?
-
LARMOR的计算开销如何?对于大规模语料库,如何提高其效率?
可借鉴的方法点:
-
利用LLM生成伪相关信号的思路可以应用到其他信息检索任务中,如查询扩展、相关性判断等。
-
LARMOR的模块化设计(查询生成、伪判断生成、参考列表生成)为其他利用LLM的系统提供了良好范例。
-
将不同组件(如QFJ和QFR)的输出进行融合的方法可以借鉴到其他需要综合多个信号的任务中。
-
论文中设计特定领域提示的方法可以推广到其他需要LLM生成特定类型内容的场景。
本文内容如有不对烦请留言指正
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 1307


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


