大模型也有小偷?为保护你的参数,上交大给大模型制作「人类可读指纹」

Python中LLM的模型版权保护:数字水印与模型指纹 在当今的人工智能领域,大型语言模型(LLM)如GPT-3、BERT等已经成为推动技术进步的重要力量。这些模型不仅在自然语言处理、图像识别等领域表现出色,还在商业应用中展现了巨大的潜力。然而,随着这些模型的广泛应用,模型版权保护问题也日益凸显。如何在开放共享的同时,保护模型的版权和知识产权,成为了一个亟待解决的问题。本文将深入探讨Python中LLM的模型版权保护技术,特别是数字水印与模型指纹的应用。 阅读详情

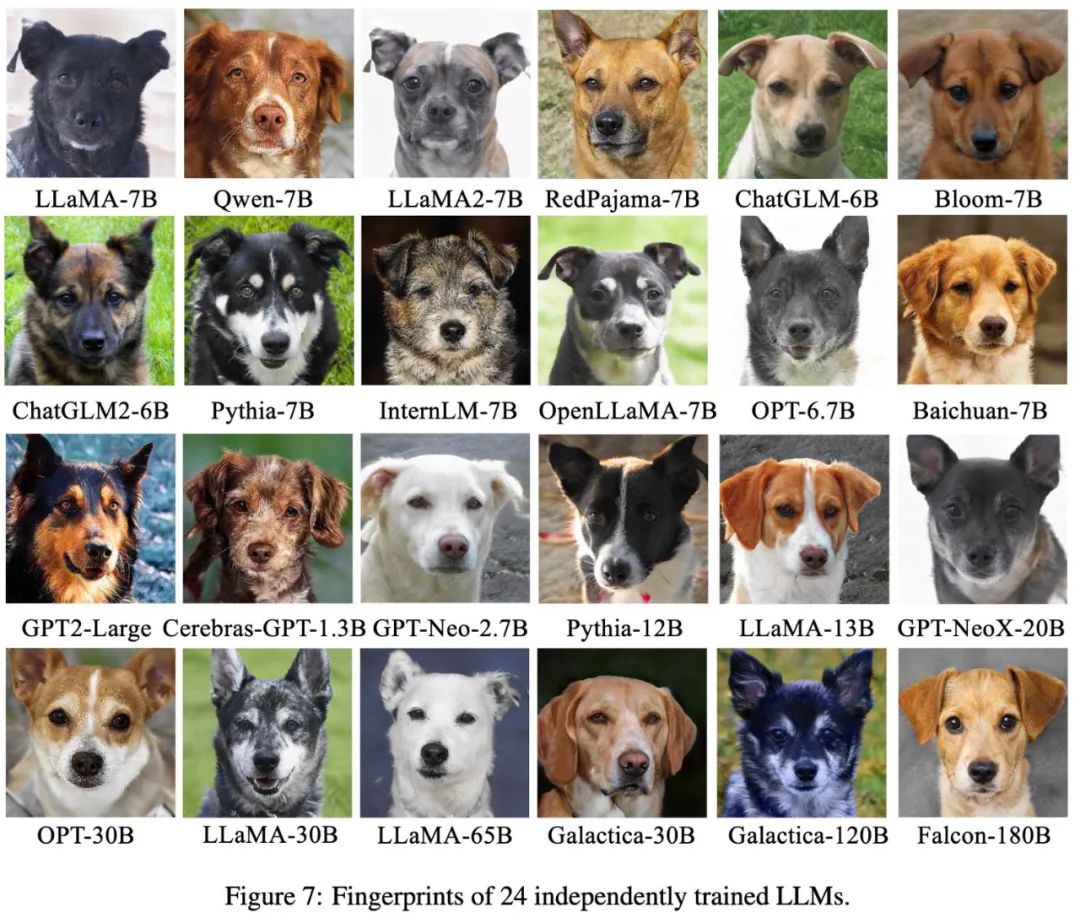
将不同的基模型象征为不同品种的狗,其中相同的「狗形指纹」表明它们源自同一个基模型。

大模型的预训练需要耗费巨量的计算资源和数据,因而预训练模型的参数也正成为各大机构重点保护的核心竞争力和资产。然而,不同于传统的软件知识产权保护可以通过比对源代码来确认是否存在代码盗用,对预训练模型参数盗用的判断存在以下两方面的新问题:

1) 预训练模型的参数,尤其是千亿级别模型的参数,通常不会开源。

2) 更重要的是,预训练模型的输出和参数都会随着 SFT、RLHF、continue pretraining 等下游处理步骤而变化。这使得无论是基于模型输出还是基于模型参数,都很难判断某一模型是否是基于另一现有模型微调得来。

因此,对大模型参数的保护是一个尚缺乏有效解决方案的全新问题。

为此,来自上海交通大学林洲汉老师的 Lumia 研究团队研发了一种人类可读的大模型指纹,这一方法可以在不需要公开模型参数的条件下,有效识别各个大模型之间的血统关系。

该方法提供两种判别方式:一种是定量的判别方式,通过给出被测大模型和一系列基模型之间的相似度来揭示被测是否盗用了某个预训练基模型;第二种是定性的判别方式,通过对每一个模型生成一张人类可读的「狗图」,来快速发现模型之间的相互继承关系。
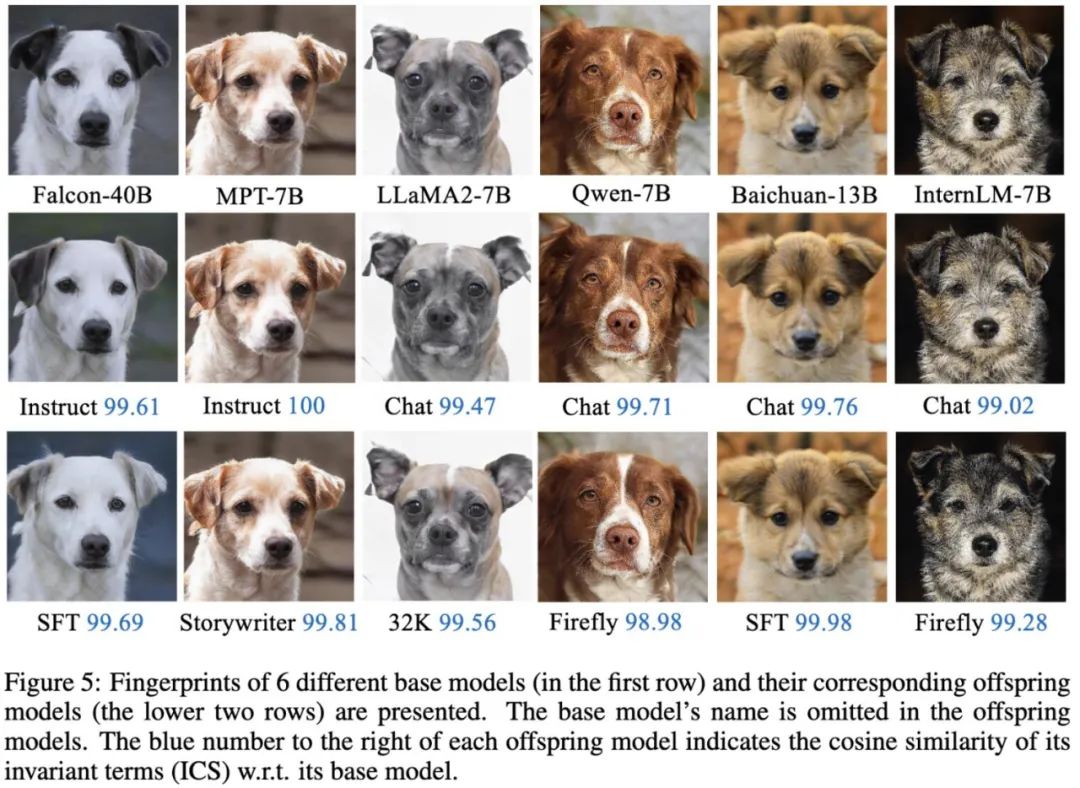
img

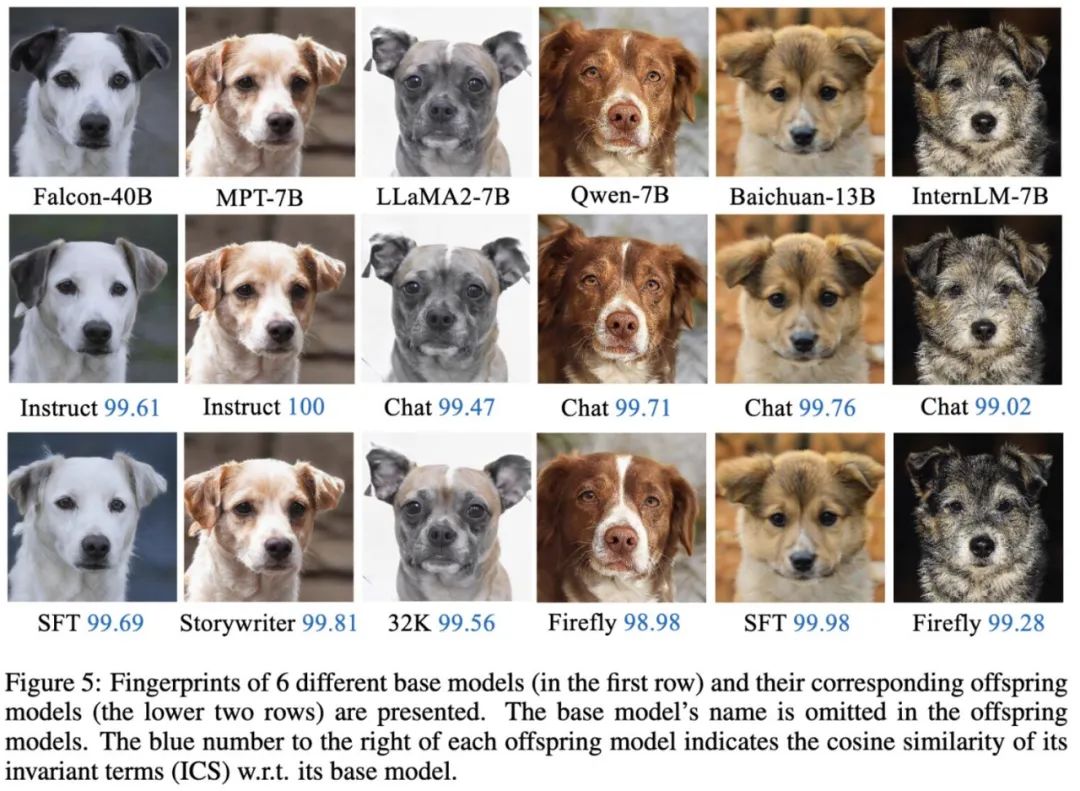
6 个不同基础模型(第一行)及其相应后代模型(下面两行)的指纹。

img

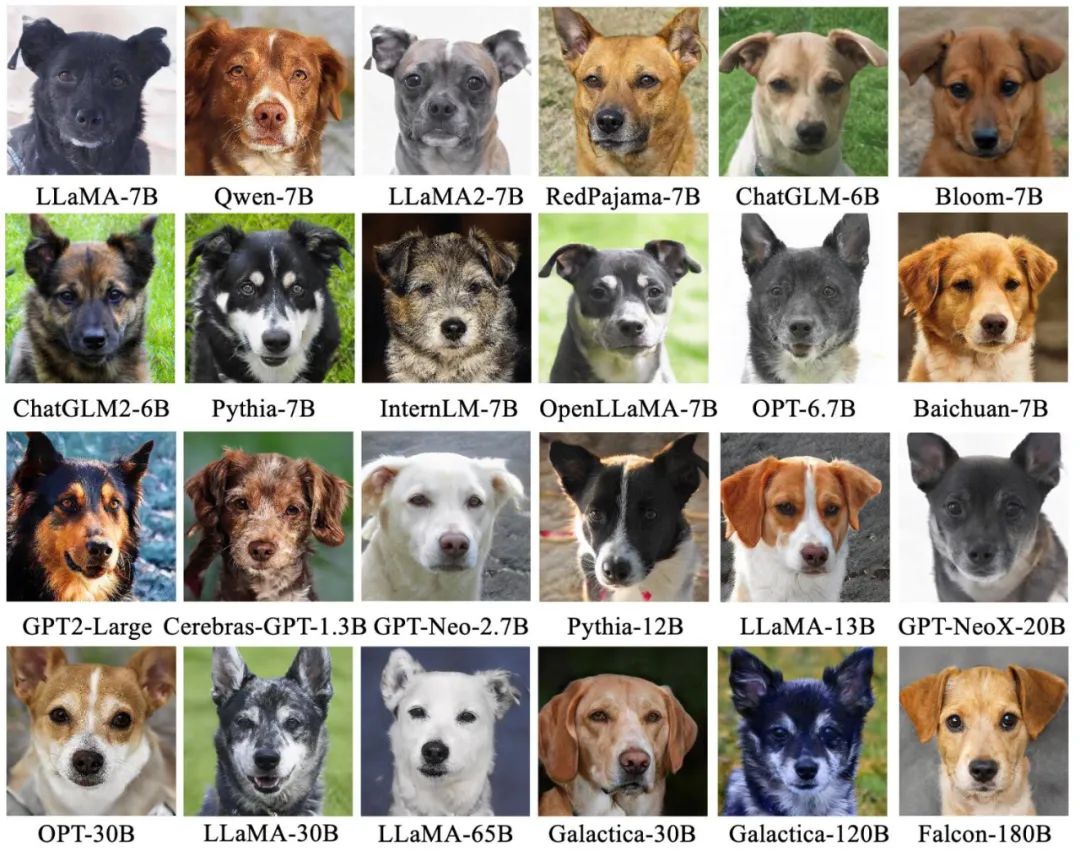
对 24 个不同的大模型所制作的人类可读大模型指纹。

动机和总体方法

大型模型的快速发展带来了广泛的应用前景,但同时也引发了一系列新的挑战。其中突出的两个问题包括:

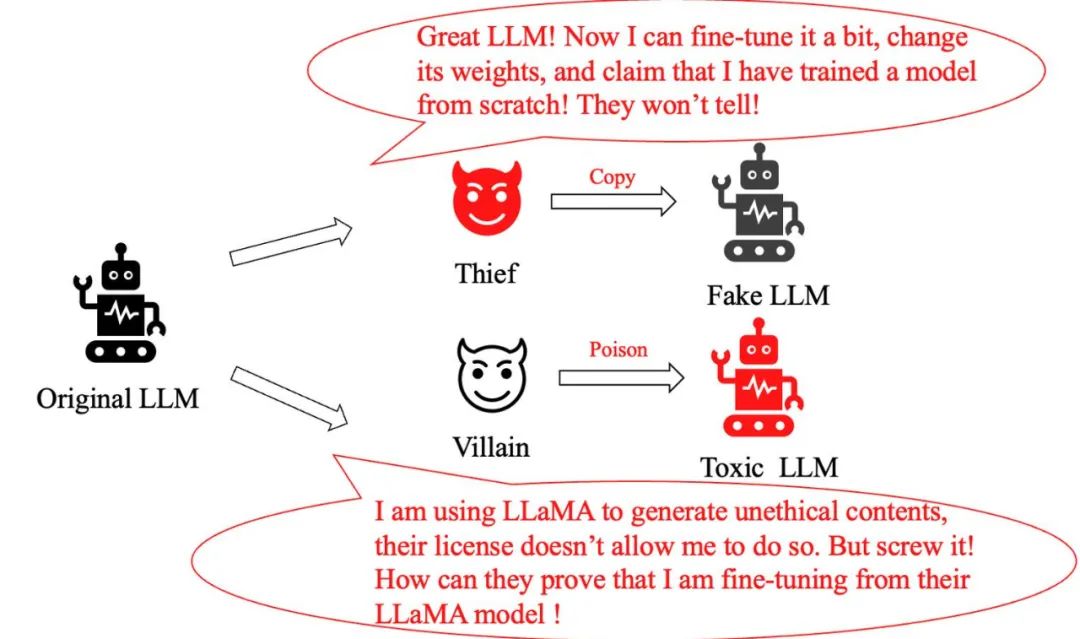
  • 模型盗用问题:一个聪明的「小偷」,他们仅对原有的大型模型进行微小调整,随后便声称创建了一个全新的模型,夸大自己的贡献。我们如何识别出它是盗版模型?
  • 模型滥用问题:当一个不法分子恶意修改 LLaMA 模型并用它来产生有害信息时,尽管 Meta 的政策明确禁止这种行为,我们如何证明它所使用的正是 LLaMA 模型呢?
img

在此之前,解决这类问题的常规方法包括在模型训练和推理过程中加入水印,或对由大型模型生成的文本进行分类。然而,这些方法要么会削弱大型模型的性能,要么容易被简单的微调或 further pretrain 规避。

这引发了一个关键问题:是否存在一种方法,既不干扰大型模型的输出分布,又能对微调和 further pretrain 鲁棒,同时还能够准确追踪大模型的基模型,从而有效保护模型版权的目的。

上海交通大学的团队从人类指纹的独一无二特性中汲取灵感,研究开发了一种为大模型制作「人类可读指纹」的方法。他们将不同的基模型象征为不同品种的狗,其中相同的「狗形指纹」表明它们源自同一个基模型。

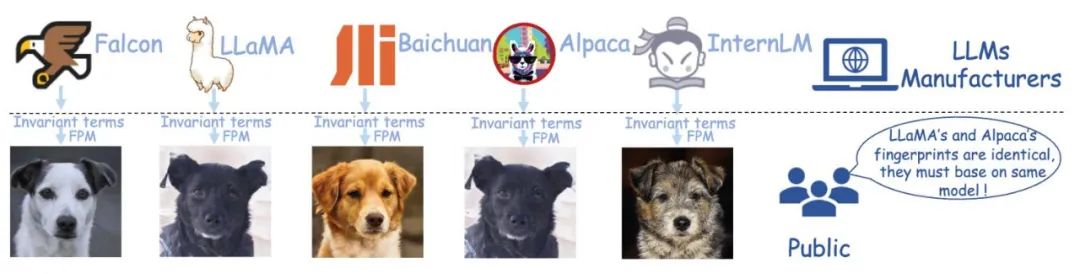
这种直观的方法使公众能够轻松辨识不同大模型之间的联系,并通过这些指纹追踪到模型的基模型,有效预防模型的盗版和滥用。值得注意的是,大模型的制造商无需公布其参数,仅需公开不变项用于生成指纹。
img

Alpaca 和 LLaMA 的「指纹」极其相似,这是因为 Alpaca 模型是通过对 LLaMA 进行微调得到的;而其他几种模型的指纹则显示了明显的差异,反映了它们源自不同的基模型。

论文《HUREF: HUMAN-READABLE FINGERPRINT FOR LARGE LANGUAGE MODELS》:
img

论文下载地址:https://arxiv.org/pdf/2312.04828.pdf

从实验观察到不变项

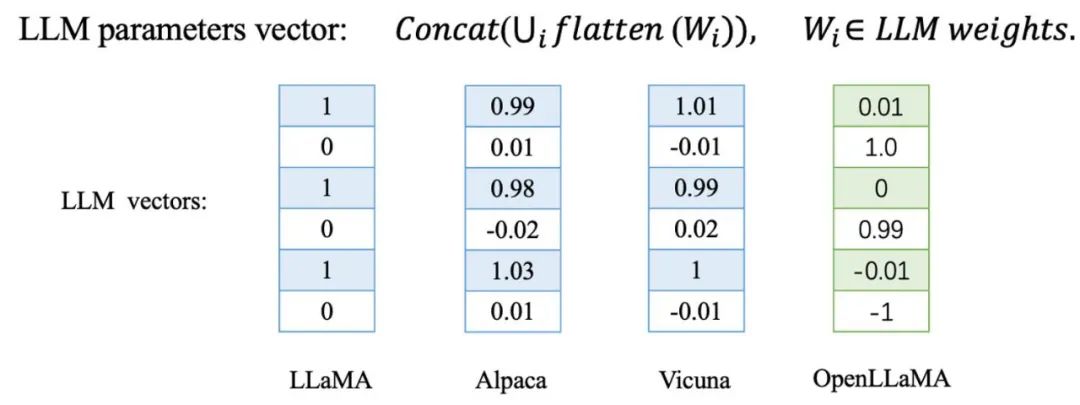
交大团队发现,在对大模型进行微调或 further pretrain 时,这些模型的参数向量方向变化非常微小。相反,对于从新开始训练的大模型,其参数方向将与其他基模型完全不同。
img

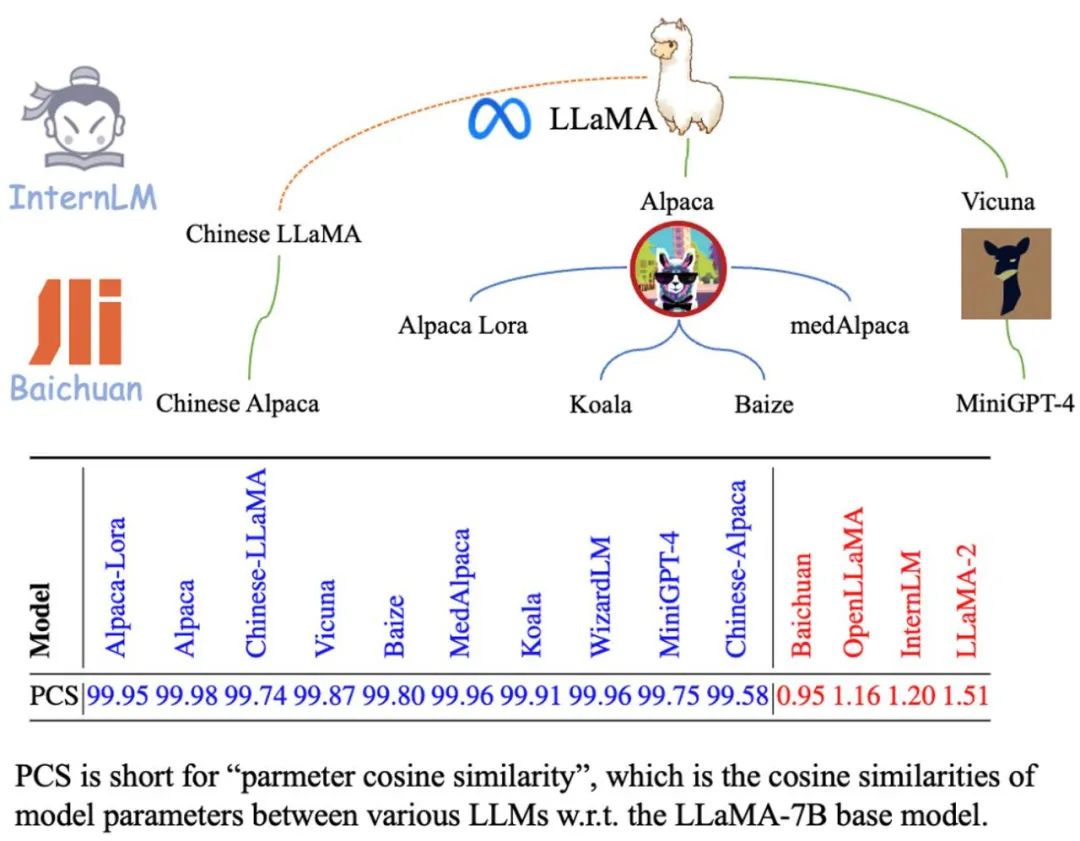
他们在 LLaMA 的一系列衍生模型上进行了验证,包括通过对 LLaMA 进行微调得到的 Alpaca 和 Vicuna,以及由 LLaMA further pretrain 得到的 Chinese LLaMA 和 Chinese Alpaca。此外,他们还测试了如百川和书生等独立训练的基模型。
img

表格中用蓝色标记的 LLaMA 衍生模型与 LLaMA-7B 基模型在参数向量上展现出了极高的余弦相似度,意味着这些衍生模型在参数向量方向上与基模型极为接近。相比之下,用红色标记的独立训练的基模型则呈现出截然不同的情况,它们的参数向量方向完全无关。

基于这些观察,他们考虑是否可以依据这种经验规律来创建模型的指纹。然而,存在一个关键问题:这种方法对于恶意攻击是否足够鲁棒?

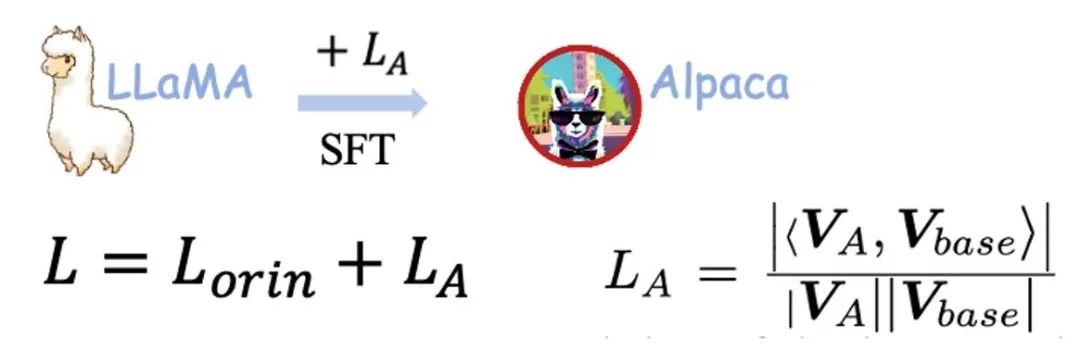
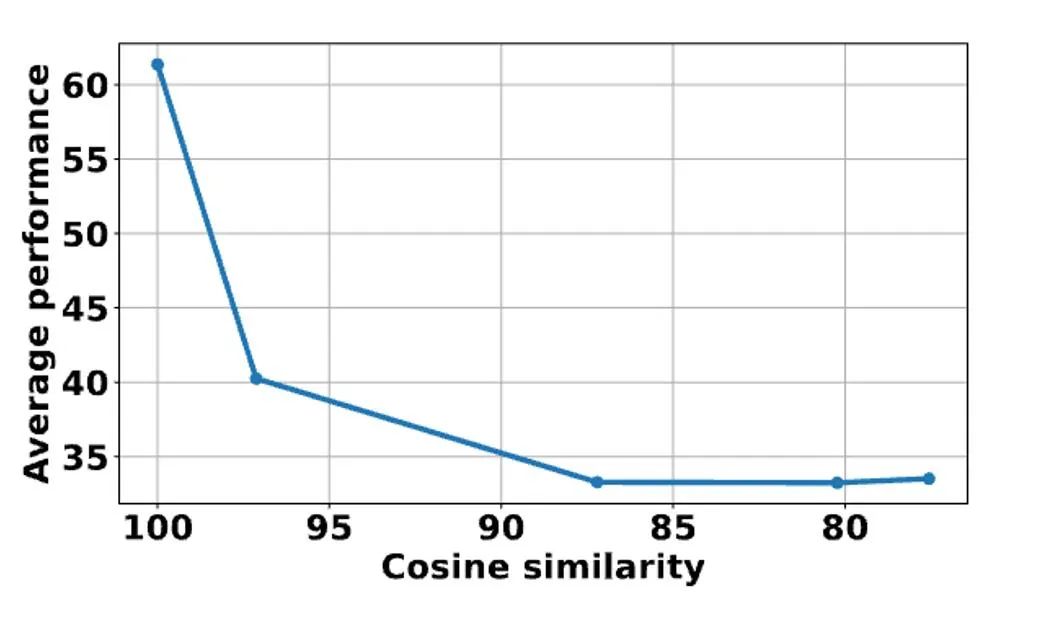
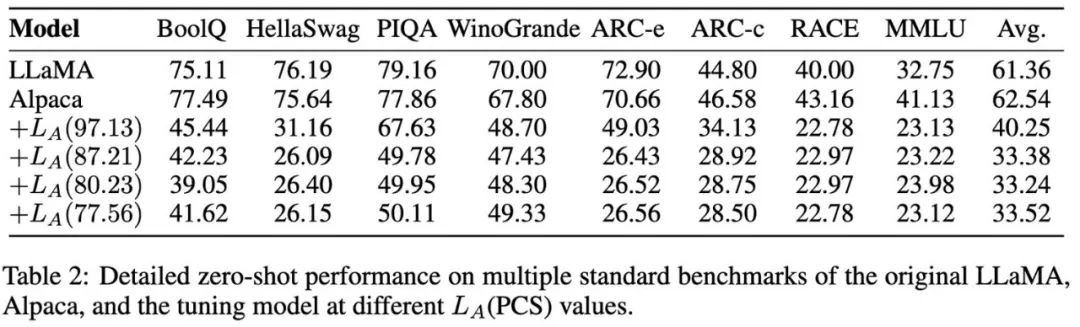
为了验证这一点,研究团队在对 LLaMA 进行微调时,加入了模型间参数的相似度作为惩罚损失,以使模型在微调的同时,参数方向尽量偏离基模型,测试模型能否在保持性能的同时偏离原参数方向:
img

他们在 BoolQ 和 MMLU 等 8 个 benchmark 上测试了原模型和加入惩罚损失微调得到的模型。从下图表中可见,模型的性能随着余弦相似度的下降迅速恶化。这说明,想要在不损害基模型能力的情况下偏离原参数方向是相当困难的!
img

img

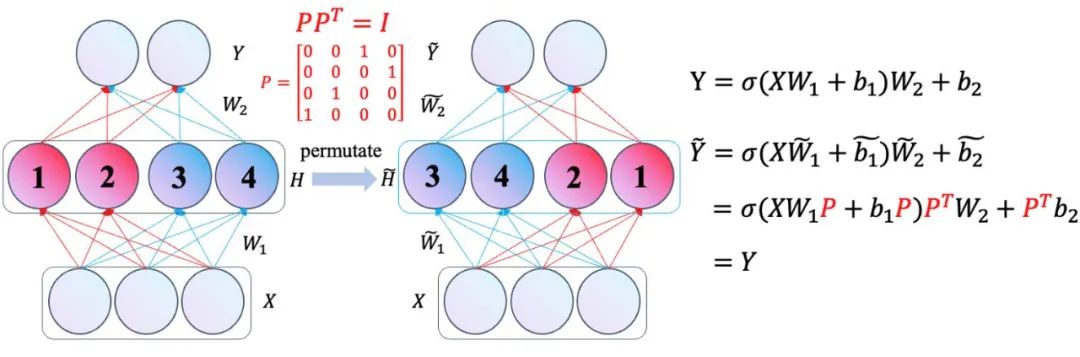
目前来看,大模型的参数向量方向成为识别其基模型的一个极为有效且鲁棒的指标。但是,直接利用参数向量方向作为识别工具似乎还存在一些问题。首先,这种方法需要揭示模型的参数,这对于许多大型模型可能是不可接受的。其次,攻击者有可以通过简单地置换隐藏单元,从而在不牺牲模型性能的情况下对参数向量方向发起攻击。

以 Transformer 中的前馈神经网络(FFN)为例,仅对隐藏单元进行简单的置换,并相应地调整其权重,就可以在不改变网络输出的情况下实现对权重方向的修改。
img

此外,该团队还深入分析了线性映射攻击以及对大模型 word embedding 的置换攻击。这些发现引发了一个问题:在面对如此多样化的攻击手段时,我们应该如何有效地应对和解决这些问题?

他们通过参数矩阵间的乘法消除攻击矩阵,从而推导出了三组对这些攻击鲁棒的不变项。
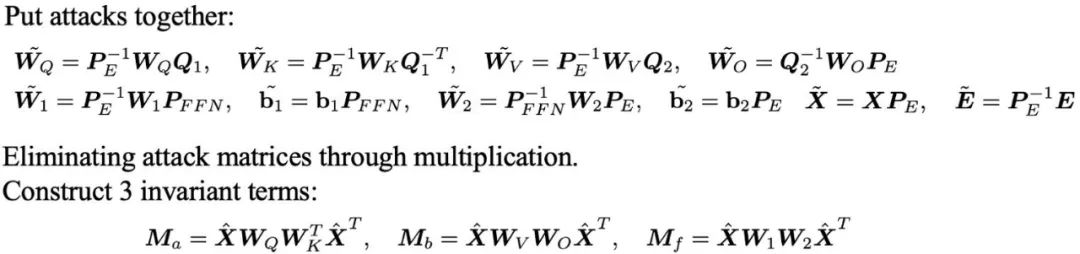
img

从不变项到人类可读的指纹

虽然上述推导出的不变项已足以作为大型型的[身份标识],但它们通常以庞大的矩阵形式出现,不仅不够直观,而且还需要进行额外的相似度计算来判定不同大模型之间的关系。是否存在一种更加直观且易于理解的方法来展示这些信息?

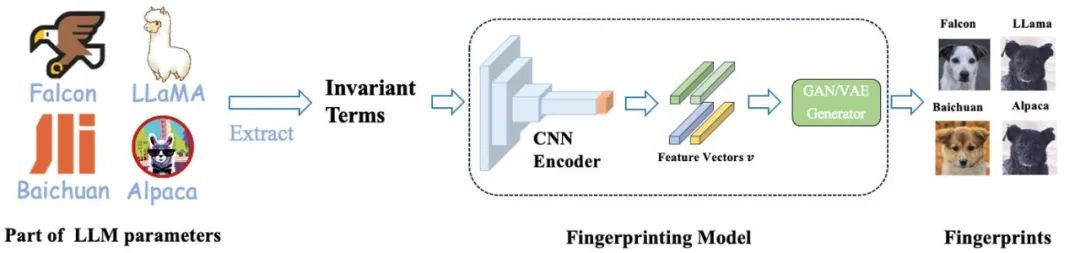
为了解决这一问题,上海交大团队研发了一套由模型参数生成人类可读指纹的方法 —HUREF。
img

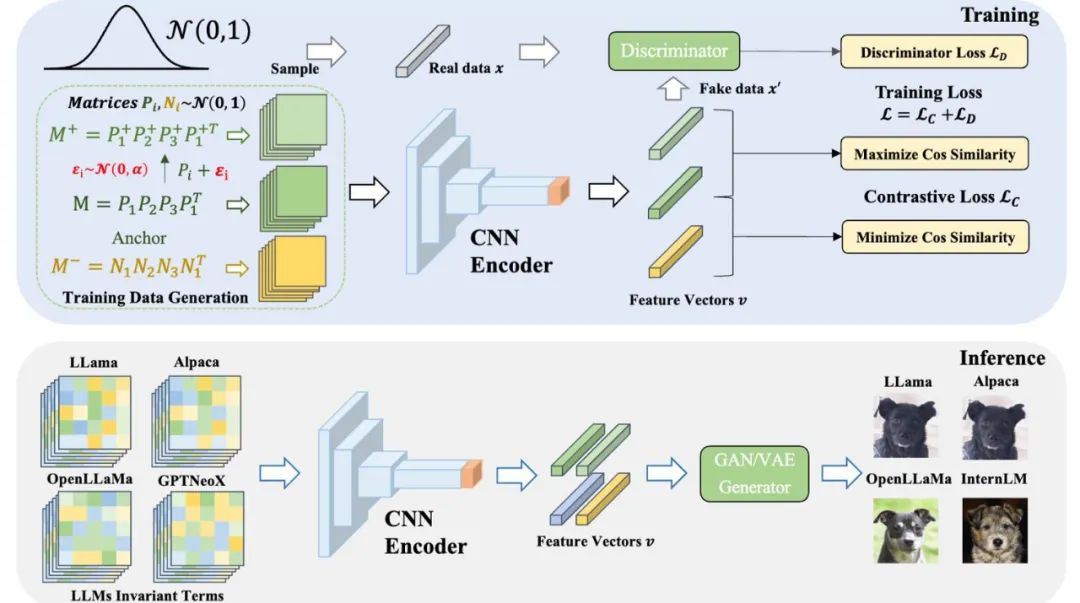
他们首先从大模型的部分参数中提取出不变项,然后利用 CNN Encoder 在保持局部性(locality)的前提下,将不变项矩阵编码成服从高斯分布的特征向量,最后使用使用平滑的 GAN 或 VAE 作为图片生成器,将这些特征向量解码成可视化图像(即狗的图片)。这些图片不仅人类可读,而且直观地展示了不同模型之间的相似性,有效地作为大型模型的「视觉指纹」。以下是详细的训练和推理过程。
img

在该框架中,CNN Encoder 是唯一需要训练的部分。他们采用对比学习确保 Encoder 的局部保持性,同时通过生成对抗学习确保特征向量服从高斯分布,以此与 GAN 或 VAE 生成器的输入空间保持一致。

重要的是,在训练过程中,他们无需使用任何真实的模型参数,所有数据都是通过正态分布采样获得。在实际应用中,直接采用经过训练的 CNN Encoder 和现成的在 AFHQ 犬类数据集上训练得到的 StyleGAN2 生成器来进行推理。

为不同大模型生成指纹

为了验证这一方法的有效性,团队在多种广泛使用的大模型上进行了实验。他们选取了若干知名的开源大模型,如 Falcon、MPT、LLaMA2、Qwen、Baichuan 和 InternLM,以及它们的衍生模型,计算了这些模型的不变项,并据此生成了如下图所示的指纹图片。
img

衍生模型的指纹与其原始模型极为相似,我们可以直观地从图像中辨认出它们是基于哪个原型模型构建的。此外,这些衍生模型与原模型在不变项上也保持了很高的余弦相似性。

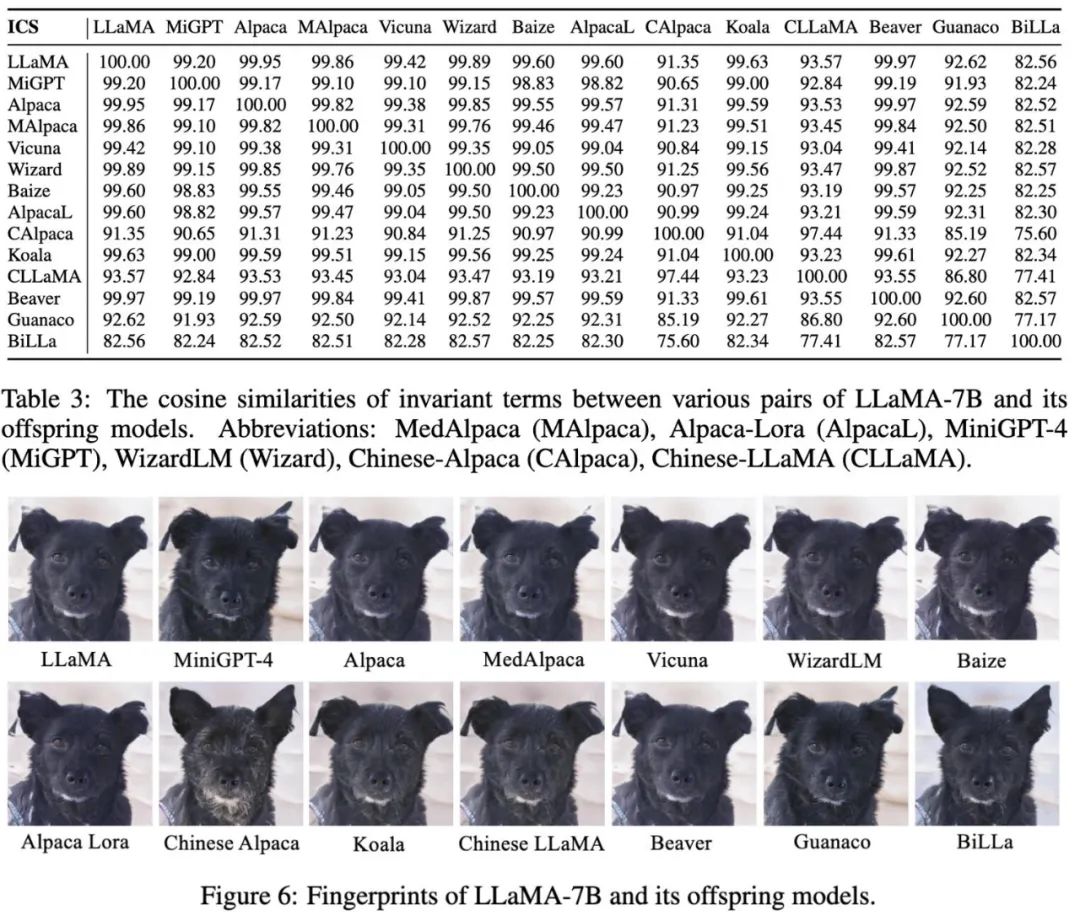
随后,他们对 LLaMA 家族模型进行了广泛的测试,包括通过 SFT 得到的 Alpaca 和 Vicuna,扩展了中文词汇表的模型,通过 further pretrain 得到的 Chinese LLaMA 和 BiLLa,通过 RLHF 得到的 Beaver 以及多模态模型 Minigpt4 等。
img

表中展示了 LLaMA 家族模型之间不变项的余弦相似度,同时,图中是为这 14 个模型生成的指纹图片,它们的相似度依然很高。我们能够根据指纹图片判断出它们来自相同的模型,值得注意的是,这些模型涵盖了 SFT,further pretrain,RLHF 和多模态等多种不同的训练方法,这进一步验证了团队所提出的方法对大模型后续不同训练范式的鲁棒性。

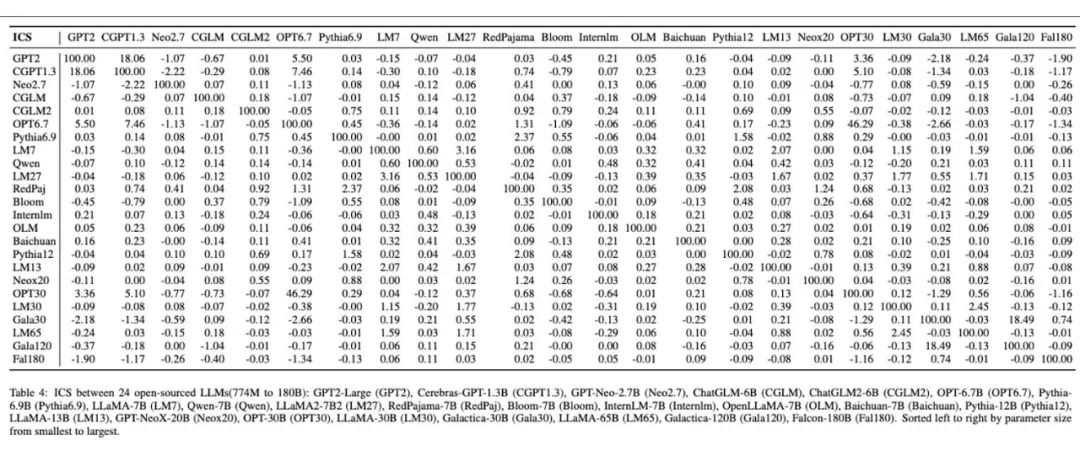
此外,下图是他们在 24 个独立训练的开源基模型上进行的实验结果。通过他们的方法,各个独立的基模型被赋予了独特的指纹图像,这些图像生动地展现了不同大模型间指纹的多样性和差异性。表中,这些模型间的相似度计算结果与其指纹图像所呈现的差异性保持了一致。
img

img

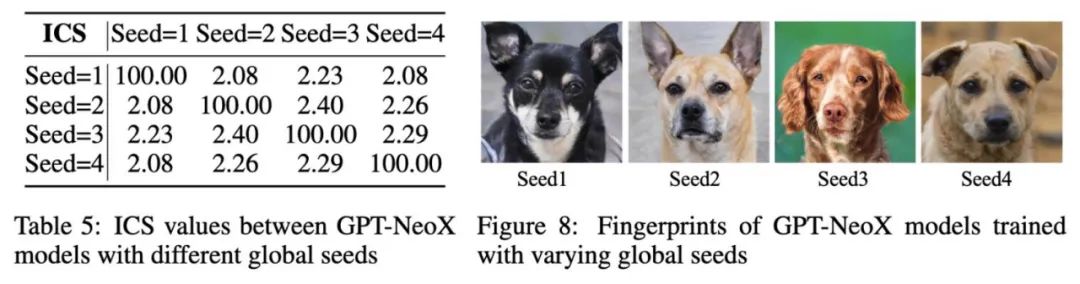
最后,该团队进一步验证了小规模独立训练的语言模型参数方向的唯一性和稳定性。他们利用 Pile 数据集的十分之一从零开始预训练了四个 GPT-NeoX-350M 模型。

这些模型在设置上完全相同,唯一的区别在于使用了不同的随机数种子。从下图表中可以明显看出,仅随机数种子的差异就导致了模型参数方向和指纹的显著不同,这充分说明了独立训练的语言模型参数方向的唯一性。
img

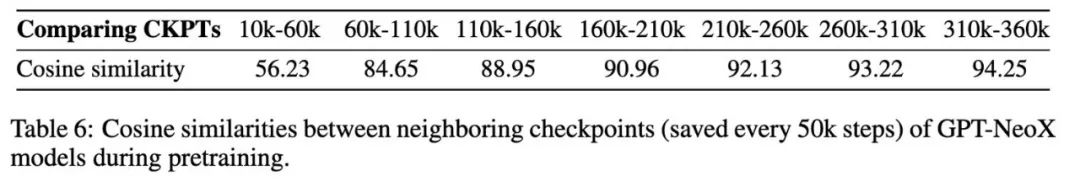
最后,通过比较相邻 checkpoints 的相似度,他们发现,在预训练过程中,模型的参数逐渐趋向稳定。他们认为这种趋势在更长的训练步骤和更大规模的模型中将更为明显,这也在一定程度上解释了他们方法的有效性。
img
​

如何学习AI大模型?

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
在这里插入图片描述

一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

四、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

Web与APP反爬虫及业务风控核心技术解析与实战指南 在当今互联网应用中,反爬虫与业务风控是保障数据安全与业务稳定的核心技术体系。反爬虫技术旨在通过提高自动化数据采集的成本与难度,保护网站数据免遭大规模爬取,其核心原理涉及网络层拦截、前端JavaScript混淆加密、请求频率限制等手段。业务风控则聚焦于识别与阻断恶意行为,如欺诈交易、薅羊毛等,以防止直接经济损失,其技术价值在于通过设备指纹、行为序列分析和规则引擎进行实时风险决策。这两套系统在实际应用中紧密协同,共同构成了从外围流量过滤到核心业务保护的立体化防御体系。本文以**电商平台**和**金融APP**等 阅读详情

相关推荐

YOLOv11的模型指纹技术:唯一标识模型防止盗版保护方案

本文介绍了YOLOv11模型指纹技术的基础概念、核心原理及其应用。模型指纹通过提取深度学习模型的独特特征生成唯一标识符,分为静态指纹和动态指纹两类,后者更适合YOLOv11的黑盒场景保护。文章详细阐述了指纹的数学表达、YOLOv11架构特点对指纹生成的优势,以及指纹技术在版权保护、盗版追踪、完整性校验等五大应用场景。此外,还提出了包含触发集生成、特征提取和指纹编码三个模块的系统设计方案,重点说明了触发集的设计原则和实现方法。该技术为YOLOv11模型提供了有效的版权保护和安全验证手段。(149字)

本博客聚焦 YOLOv11 全流程落地,涵盖架构优化、数据集处理、训练技巧与多场景部署,兼及国产数据库、Java 开发与 AI 模型应用,内容兼顾理论与工程实践,为开发者提供系统干货,助力高效提升技术能力。 476

(2021,deepfake 溯源)用于生成模型的人工指纹:扎根于训练数据中的深度造假溯源

我们通过在模型中引入人工指纹,寻求一种主动且可持续的 deepfake 检测解决方案,该解决方案与生成模型的演变无关。它通过为每个模型分配一个唯一的指纹,为发明人的责任披露开辟了可能性。

qq_44681809的博客 2399

爬虫写得好,牢饭...?教你三招避开法律雷区的“无感”抓取术

爬虫技术的尽头,不是攻破了多么复杂的加密,而是**“无感”**。做得好的爬虫,就像一个礼貌的访客:轻轻地来,带走需要的信息,轻轻地走,不给服务器带去一丝负担,也不触碰任何隐私的红线。这才是资深技术人该有的“吃相”。附赠demo供大家参考# 核心魔法在这里:impersonate 参数# 这行代码告诉底层:"请完全模拟 Chrome 110 浏览器的 TLS 握手特征"try:url,print("【伪装请求】穿透成功!")# 你会发现,返回的 ja3_hash 和真正的浏览器一模一样。

BUG猿的博客 1411

技术、产品双维度看LLM指纹

大模型指纹(LLM Fingerprint)是一种或一组可稳定复现的、独特的、能代表特定大模型内在属性的输出特征。就像人类的指纹一样,这种特征可以用来高精度地识别、验证或追踪一个特定的、甚至未知的模型。简单来说,如果猫哥向10个不同的聊天机器人问同一个“刁钻”的问题,它们各自的回答风格、用词、知识盲点、甚至“胡说八道”的方式,都会有所不同。这些差异化的、可被捕捉和分析的特征,就是它们的“指纹”。技术角度:指纹从何而来?大模型的指纹并非单一来源,而是其复杂系统在多个层面留下的综合印记。

Arthur Guo 的专栏 1169

实现 PDF 添加水印的五种方式

PDF(Portable Document Format,便携式文档格式)是一种流行的文件格式,它可以在多个操作系统和应用程序中进行查看和打印。在某些情况下,我们需要对 PDF 文件添加水印,以使其更具有辨识度或者保护其版权。本文将介绍如何使用 Spring Boot 来实现 PDF 添加水印的方式。

逸轩 6472

从零到一:PrimeTime静态时序分析入门指南

本文详细介绍了PrimeTime静态时序分析(STA)的入门指南,从基础概念到实际应用全面覆盖。内容包括时序路径分类、PrimeTime环境搭建、时序约束设置与验证、时序分析与报告解读等核心内容,帮助工程师快速掌握STA技术,解决数字芯片设计中的时序收敛问题。

weixin_28730131的博客 268

HUREF

随后,他们对 LLaMA 家族模型进行了广泛的测试,包括通过 SFT 得到的 Alpaca 和 Vicuna,扩展了中文词汇表的模型,通过 further pretrain 得到的 Chinese LLaMA 和 BiLLa,通过 RLHF 得到的 Beaver 以及多模态模型 Minigpt4 等。他们选取了若干知名的开源大模型,如 Falcon、MPT、LLaMA2、Qwen、Baichuan 和 InternLM,以及它们的衍生模型,计算了这些模型的不变项,并据此生成了如下图所示的指纹图片。

whaosoft143ai的博客 687

告别混乱!AutoSar BswM模式管理实战:手把手教你配置Rule与ActionList(附避坑指南)

本文详细解析了AutoSar BswM模式管理的实战配置,重点介绍了Rule与ActionList的高效组合方法,帮助开发者避免常见陷阱。通过具体案例演示了从基础到复杂的配置步骤,包括模式仲裁、逻辑表达式构建及ActionList优化策略,提升汽车电子系统的协调性与可靠性。

weixin_27066963的博客 259

大模型日报-20240204

本文分享最新的AI动态,我们可以深入了解人工智能领域的迅猛发展,推动业务实践与应用。我每日发布AI&LLM日报,欢迎大家积极阅读并在其中展开讨论与交流。让我们一同体验人工智能领域的最新动态,拓宽我们对科技的认知与见解吧!

分享技术,记录思考和感悟 1434

RK3576开发板ROS2部署实战:从Buildroot配置到Hello World Demo

本文详细介绍了在RK3576开发板上部署ROS2的完整实战流程。从Buildroot工程配置、集成ROS2依赖,到搭建Docker交叉编译环境、处理编译难题,最终完成系统镜像打包并在板端成功运行Talker-Listener Demo。该指南旨在帮助开发者深入理解嵌入式机器人系统的构建链,实现从底层到应用的完全掌控。

mac99的博客 1156

Xilinx FPGA中利用JTAG实现MicroBlaze调试信息输出

本文详细介绍了在Xilinx FPGA开发中,如何利用JTAG接口为MicroBlaze软核处理器实现调试信息输出的完整方案。通过配置调试模块、设置Vitis软件工程以及使用XSCT工具,开发者可以建立一条不依赖外部硬件的可靠调试通道,有效解决早期硬件验证阶段串口不可用的问题,大幅提升调试效率。

weixin_29201859的博客 290

什么是浏览器指纹识别?

这些第三方供应商会跟踪你的在线活动和你的具体信息,包括你的年龄、位置、兴趣、你使用的社交媒体平台、你消费的内容以及你在谷歌上搜索的内容。不过,这并不都是令人讨厌的黑幕。举例来说,如果你的网上银行信息被盗,小偷试图登录你的账户,你的银行就会注意到这一可疑行为,因为它来自一个带有非你的指纹的设备。这意味着,99% 的情况下,这种跟踪技术都能准确读取你的信息,并创建独一无二的指纹。虽然浏览器指纹识别是一件相当棘手的事情,而且从技术上讲也不可能完全阻止,但你最好的办法是伪造参数,让你的网络存在不那么独特。

SmartGarret的博客 606

热力学仿真软件:COMSOL Heat Transfer_(18).案例研究:工业加热炉优化

工业加热炉的优化设计和操作参数调整是提高制造过程效率和产品质量的关键。通过仿真软件如COMSOL Multiphysics,可以精确地分析炉内的温度分布、能耗和热损失,从而提出有效的优化方案。本文通过一个实际应用案例,展示了如何利用仿真技术进行工业加热炉的综合优化,并通过实验验证了优化方案的有效性。希望这些方法和案例可以为其他制造企业提供参考,帮助他们在实际生产中提高加热炉的性能和效率。

kkchenjj的博客 1008

[2022 S&P] Copy, Right? 深度学习模型版权保护的测试框架

深度学习模型,尤其是那些大规模和高性能的模型,训练成本可能非常高,需要大量的数据和计算资源。因此,深度学习模型已成为现代人工智能中最有价值的资产之一。未经授权复制或复制深度学习模型会导致侵犯版权,给模型所有者造成巨大的经济损失,需要有效的版权保护技术。现有的保护技术大多基于水印,将所有者指定的水印嵌入到模型中。虽然能够提供精确的所有权验证,但这些技术是1) 侵入性的,即它们需要篡改训练过程,这可能会影响模型效用或给模型带来新的安全风险;2)容易遭受试图去除/替换水印或对抗性阻止水印检索的适应性攻击;

sinat_38007523的博客 1864

virtuoso如何导出def?

在DEF Out界面,填写def name,library name以及cell name ,cell view既layout,把Output "Floating Shapes" into SPECIAL NETS Section勾上,OK即可。2)在要导出的layout界面选中PAD和prBoundary(shift+左键),快捷键C copy到空cell里,这时需要调整copy过来的object坐标,让两边prBoundary的坐标相同。我正在「拾陆楼」和朋友们讨论有趣的话题,你⼀起来吧?

m0_61544122的博客 2307

Xilinx FPGA平台GTX简易使用教程(汇总篇)

Xilinx平台GTX简易使用教程,先“知其然”,慢慢再研究“所以然”。

数字IC/FPGA杂货铺,找一找,或许有你想要的~ 3万+

保险柜选购核心指标:认证、指纹锁与安装固定全指南

选购保险柜时,许多用户往往被钢板厚度、开锁方式数量等表面参数吸引,却忽略了真正决定安全性的底层逻辑。一台合格的保险柜需要先通过3C或CSP等国家强制认证,建立合规底线;再看锁具系统是否具备主用、应急、兜底的三层冗余设计,例如指纹锁解决便捷性,密码锁承担无钥匙主入口,机械钥匙在电子失效时提供最终保障。此外,全钢柜体、防火结构以及嵌入式安装固定同样关键,柜体若未可靠锚固,再厚重的箱体也可能被整体搬移。从认证合规、锁具冗余到物理安装,理解这些基础原理,能帮助家庭、办公室或店铺用户把模糊的购买需求转化为可验证的选型

weixin_33798152的博客 409

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

家庭消费类摄像头选择攻略和隐私保护小建议

​问题背景: 由于毕业后一直在这个安防圈内,朋友有时咨询我应该买哪家的摄像头,说想装到家里看娃看门和陪伴老人。为了避免广告嫌疑,下面推荐几款,各有利弊大家自由选择。同时给出买消费类摄像头的注意事项。其实这种推荐和大家买手机一样,就是看下品牌,外观和功能,专业一点的人会看下CPU型号、内存、拍照功能。摄像头也类似,基本也需要关注一些基本功能和设备参数,同时家庭消费类摄像头有一个关注点比较重要就是隐...

weixin_41422027的博客 3273

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

AI时代原创保护:把创作过程变成数字胎记

在生成式AI快速普及的背景下,'原创保护'已不再局限于作品结果的版权登记,而需深入创作过程本身——即人类独有的感知路径、试错节奏与决策逻辑。其技术原理在于:AI可复刻视觉/文本结果,却难以模拟真实创作中的非完美痕迹(如笔触压力曲线、图层命名习惯、泊松噪点分布)和结构化意图(如隐喻来源、色彩选择依据)。这种‘过程即证据’的范式,赋予创作者法律认可的数字指纹能力,支撑确权、维权与IP资产沉淀。典型应用场景包括设计师防AI风格盗用、文字作者应对提示词反向拆解、音频创作者识别盗播源。本文聚焦‘AI生成’与‘原创保护

weixin_34254848的博客 217

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

AI商业秘密防护:从法律判决失效到技术可证明性

AI商业秘密已突破传统代码、文档等静态载体,演变为数据分布、微调权重、调试痕迹等瞬态知识流。其核心挑战在于‘可证明性’缺失与‘可防御性’断层——法院难以认定虚化客体,企业又缺乏面向语义层的实时感知能力。本文聚焦AI商业秘密、模型泄露两大热词,解析如何通过数据指纹、模型水印、eBPF过程日志与环境指纹构建法律可采信的技术锚点,并落地动态脱敏网关、Firecracker沙箱、行为基线建模等工程方案,覆盖大模型研发、部署与合规全链路,为CTO、算法负责人及安全工程师提供72小时可启动的防御基线。

weixin_32736961的博客 329

智能保险箱选购与配置指南:从指纹识别到WiFi报警全解析

随着物联网与智能安防技术的普及,家庭和办公场景对贵重物品的保护已从单纯物理隔断升级为逻辑安全与远程感知并重。指纹识别作为生物认证的核心技术,通过特征点提取与比对实现无钥匙快捷开启;虚位密码机制则有效对抗肩窥攻击,在真实密码前后插入干扰数字仍能正确认证。报警机制融合震动、倾斜、防拆等传感器,结合状态机判定异常事件,并通过WiFi智联推送至手机App,形成本地威慑与远程通知的闭环。同时,3C认证确保设备基本电气与安全性能,而合理配置管理员密码、指纹权限及定期固件更新,是保障智能保险箱长期可靠运行的关键。本文以智

weixin_31774841的博客 351

天外客AI翻译机中API请求签名防止中间人攻击

本文深入剖析天外客AI翻译机中API请求签名机制,揭示如何通过HMAC-SHA256、时间戳和随机数构建防篡改、防重放的安全体系,有效抵御中间人攻击,保障智能设备通信安全。

weixin_35920379的博客 355

camofox-browser深度解析:基于Firefox的浏览器指纹伪装与反追踪实践

在数字时代,浏览器隐私保护早已超出清除Cookie的范畴。隐身模式只能避免本地记录,却无法阻止网站通过Canvas、WebGL、字体等参数采集浏览器指纹,从而跨站点追踪用户行为。指纹伪装技术因此成为反追踪的关键手段——通过修改浏览器特征、阻断渲染指纹提取、隔离网络行为,让设备在追踪系统中变得平凡无奇。camofox-browser正是这样一套基于Firefox深度定制的开源配置方案,它利用user.js和约上百项参数调整,将普通Firefox改造为具有强抗指纹识别能力的浏览器,同时兼顾日常可用性。本文从指纹

weixin_27875131的博客 250

你的边缘网关,真的“锁门”了吗?——论嵌入式硬件加密的重要性

很多人觉得嵌入式设备“没什么值钱数据”,丢了就丢了。但事实是——一台被破解的工业设备,可能让整个产线、整个储能站、整个工厂的核心数据全部泄露。硬件加密,就是解决这个问题的最后一道防线。

钡铼技术工业物联网 293

家用隐蔽式保险箱选购指南:从密码锁原理到安全存储实践

密码锁作为基础安防设备,其核心原理是通过机械或电子方式控制锁舌的启闭,实现物理隔离与访问控制。从技术实现看,机械密码锁依赖轮盘组合的精确对位,电子密码锁则基于电路验证与电机驱动,两者在安全性、便捷性与可靠性上各有侧重。这类技术的工程价值在于为家庭环境提供了非侵入式的财物保护方案,尤其适用于需要兼顾美观与安全的现代居住场景。在实际应用中,隐蔽式保险箱通过伪装成书籍、台灯等日常物品,巧妙利用心理盲区提升防盗效果。本文聚焦于铜灯书架密码锁这一具体形态,深入解析其机械密码锁与电子密码锁的工作原理、选型参数及故障排查

weixin_33910385的博客 522

【TEE从入门到精通及实战】32 模型窃取防御:让攻击者“看得到”却“学不会”

本文揭示了机器学习模型在安全防护中的常见误区——仅加密模型参数和输入输出数据并不足以防止模型窃取攻击。作者通过一个金融科技公司反欺诈模型被逆向的真实案例,说明攻击者可以通过系统性地查询模型输出(对抗样本)来复制决策逻辑。 核心问题在于模型输出暴露了决策边界这一"行为指纹"。作者提出了双重防御方案:1)在输出层添加可控的拉普拉斯噪声(差分隐私技术);2)实施用户查询频率限制。文中提供了可运行的Python代码示例,展示如何实现带噪声注入和速率限制的安全推理接口。 进阶方案还包括自适应噪声和模型蒸馏防御。测试数

企鹅码农的专属播客,分享10多年的实战案例和经验解读,包含YOLO、RT-DETR、AI等各个工作领域。 51
上一篇: 在对齐 AI 时,为什么在线方法总是优于离线方法?
下一篇: 会颠勺的国产机器人来了:大模型加持,家务能力满分
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值