在对齐 AI 时,为什么在线方法总是优于离线方法?

Feature Store实战:构建离线在线一致的特征基础设施 Feature Store 是 MLOps 中支撑模型高效迭代的核心基础设施,其本质是解决特征定义、计算、存储与服务的标准化问题。原理上需同时保障离线批处理的可重现性与在线服务的低延迟强一致性,并通过统一计算逻辑、时间语义和数据 Schema 实现数学级特征对齐。技术价值在于显著降低特征重复开发成本、提升复用率与问题追溯效率,支撑模型快速上线与稳定回滚。典型应用场景覆盖电商实时推荐、金融风控建模及内容个性化等对特征时效性与准确性双敏感的领域。本文聚焦生产级 Feature Store 的落地实践,深入拆解离 阅读详情

在线和离线对齐算法的性能差距根源何在?DeepMind实证剖析出炉

在 AI 对齐问题上,在线方法似乎总是优于离线方法,但为什么会这样呢?近日,Google DeepMind 一篇论文试图通过基于假设验证的实证研究给出解答。
图片

根据人类反馈的强化学习(RLHF)随着大型语言模型(LLM)发展而日渐成为一种用于 AI 对齐的常用框架。不过近段时间,直接偏好优化(DPO)等离线方法异军突起 —— 无需主动式的在线交互,使用离线数据集就能直接对齐 LLM。这类方法的效率很高,也已经得到实证研究的证明。但这也引出了一个关键问题:

AI 对齐是否必需在线强化学习?

对于这个问题,人们希望既知道其理论上的答案,也希望明晰实验给出的解答。

从实证角度看,相比于大家常用的在线 RLHF(由偏好建模和从模型采样组成),离线算法实现起来要简单得多,成本也低得多。因此,收集有关离线算法的充分性的证据可让 AI 对齐变得更加简单。另一方面,如果能明晰常用在线 RLHF 的优势,也能让我们理解在线交互的基本作用,洞见离线对齐方法的某些关键挑战。

在线算法与离线算法的对比

要公平地比较在线和离线算法并非易事,因为它们存在许多实现和算法方面的差异。举个例子,在线算法所需的计算量往往大于离线算法,因为它需要采样和训练另一个模型。因此,为了比较公平,需要在衡量性能时对不同算法所耗费的预算进行一定的校准。

在 DeepMind 的这项研究中,研究团队在比较时并未将计算量作为一个优先考虑因素,而是采用了 Gao et al. (2023) 的论文《Scaling laws for reward model overoptimization》中的设置:使用 RLHF 策略和参考 SFT 策略之间的 KL 散度作为预算的衡量指标。

在不同的算法和超参数设置中,KL 散度是以一种统一的方式衡量 RLHF 策略与 SFT 策略的偏离程度,从而能以一种经过校准的方式对算法进行比较。

基于古德哈特定律比较在线和离线算法的性能

首先,该团队比较了在线和离线算法的过度优化(over-optimization)行为 —— 该行为可通过将古德哈特定律外推至 AI 对齐领域而预测得到。

简单总结起来,古德哈特定律(Goodhart’s law)可以表述成:一项指标一旦变成了目标,它将不再是个好指标。

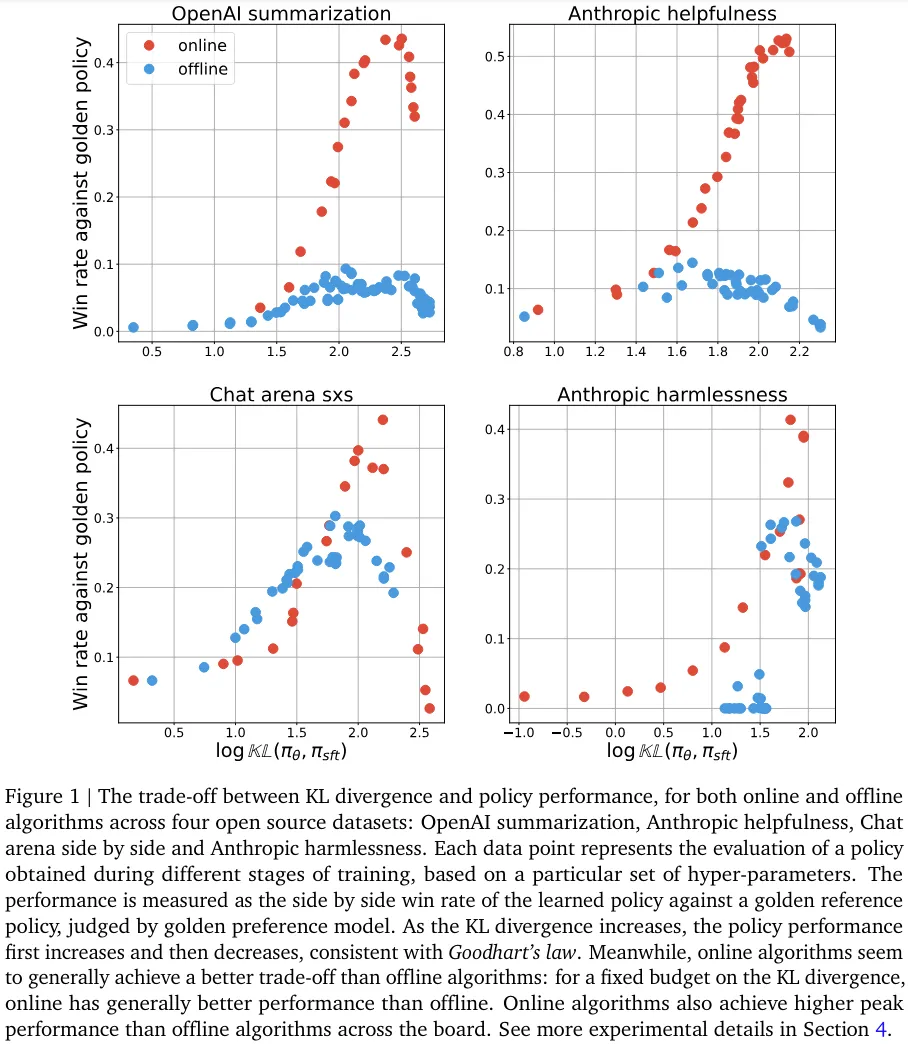
该团队采用了与 Gao et al. (2023) 类似的设置,基于一组开源数据集进行了实验,结果表明:在同等的优化预算(相对于 SFT 策略的 KL 散度)下,在线算法的性能表现通常优于离线算法。

图 1 给出了在线和离线算法在四个不同的开源数据集上表现出的 KL 散度与策略性能之间的权衡。图中的每个数据点代表了在训练过程中某个特定检查点下,针对特定一组超参数的策略评估结果。
在这里插入图片描述

其中,对于在线算法,超参数并未被大量调整,而是始终使用一组固定的超参数;对于离线算法,则是将不同超参数的结果池化后得出。可以观察到如下结果:

  • 符合古德哈特定律的过度优化。不管是在线还是离线算法,性能都会随 KL 散度先升后降。后期下降的原因是过度优化效应,这符合古德哈特定律的预测。

  • 在线算法能比离线算法更高效地使用 KL 散度预算。相比于离线算法,在线算法似乎通常能实现更好的权衡。具体而言,在 KL 散度度量的预算一样时,在线算法得到的性能通常优于离线算法。在不同的 KL 散度层级上,在线算法在所有任务上的峰值性能都高于离线算法。其中,在 OpenAI 摘要和 Anthropic 辅助任务上的峰值性能差异显著,在另两个任务上的峰值差异较小。

总之,在线算法完全胜过离线算法,这也奠定了后续研究的基础。

对于在线和离线算法性能差异的假设

为了更好地理解在线和离线算法性能差异的根源,该团队通过假设验证的形式进行了研究。

也就是说首先提出一些假设,然后验证它是否正确。先来看看他们提出了怎样的假设。

假设 1:数据覆盖情况。在线算法更优的原因是其覆盖的数据比离线数据集更多样化(即随时间变化采样自不同的学习器策略)。

假设 2:次优的离线数据集。离线算法处于劣势,因为其初始的偏好数据集是由一个次优的策略生成的。如果使用有更高绝对质量的响应训练离线算法,则性能会更好。

假设 3:分类能力更好,则性能更好。离线算法通常是将策略作为分类器进行训练。但是,作为分类器,它们可能并不如代理偏好模型那样准确(因为对分类进行参数化的有效方式不同)。如果准确度提升,则其性能也会提升。

假设 4:非对比式损失函数。在这样的性能差异中,有多大部分可归因于对比式的损失函数,而不是离线的样本?

假设 5:扩展策略就足够了。要弥合在线和离线算法之间的差距,只需提升策略大小就足够了。

实验和结果

实验设置

为了验证上述假设,该团队进行了大量对照实验。

所有实验都使用 T5X 模型,并搭配了 T5X 数据和计算框架。为了较好地覆盖 RLHF 问题,他们研究了四种任务:OpenAI 摘要、Anthropic 辅助、聊天竞技场、Anthropic 无害性。
在这里插入图片描述

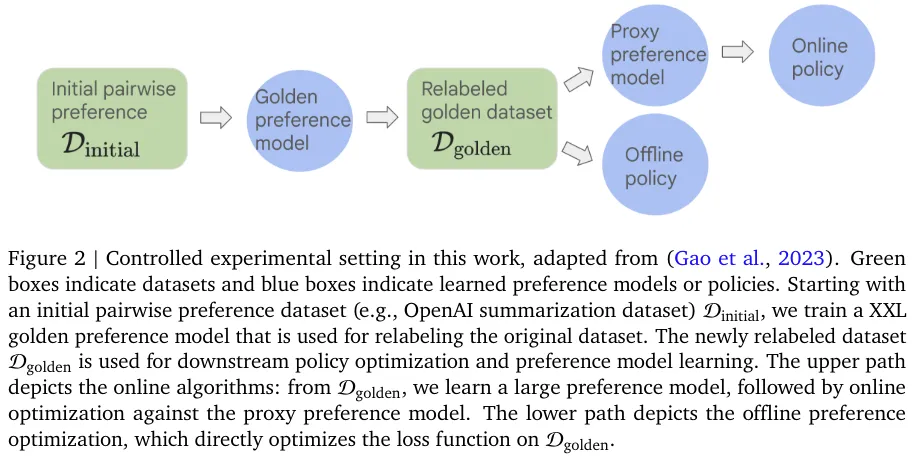
图 2 给出了这些对照实验的设置情况,其整体上基于 Gao et al., 2023。其中,绿框表示数据集,蓝框表示学习到的偏好模型或策略。
在这里插入图片描述

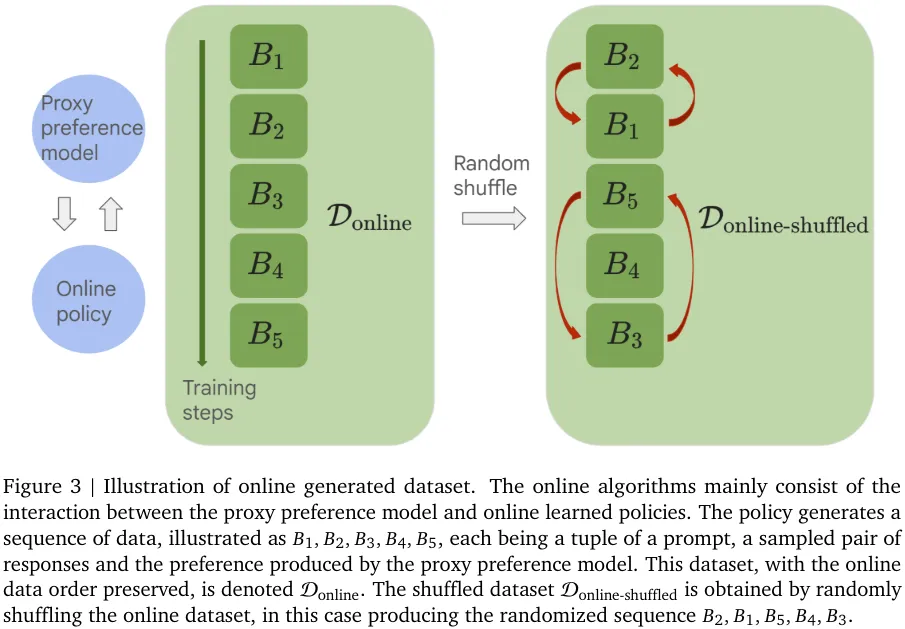
图 3 则给出了在线生成数据集的图示。这里的在线算法主要由代理偏好模型和在线学习的策略之间的交互组成。

该团队的实验研究涉及多个维度,其得到的主要结果如下。

数据

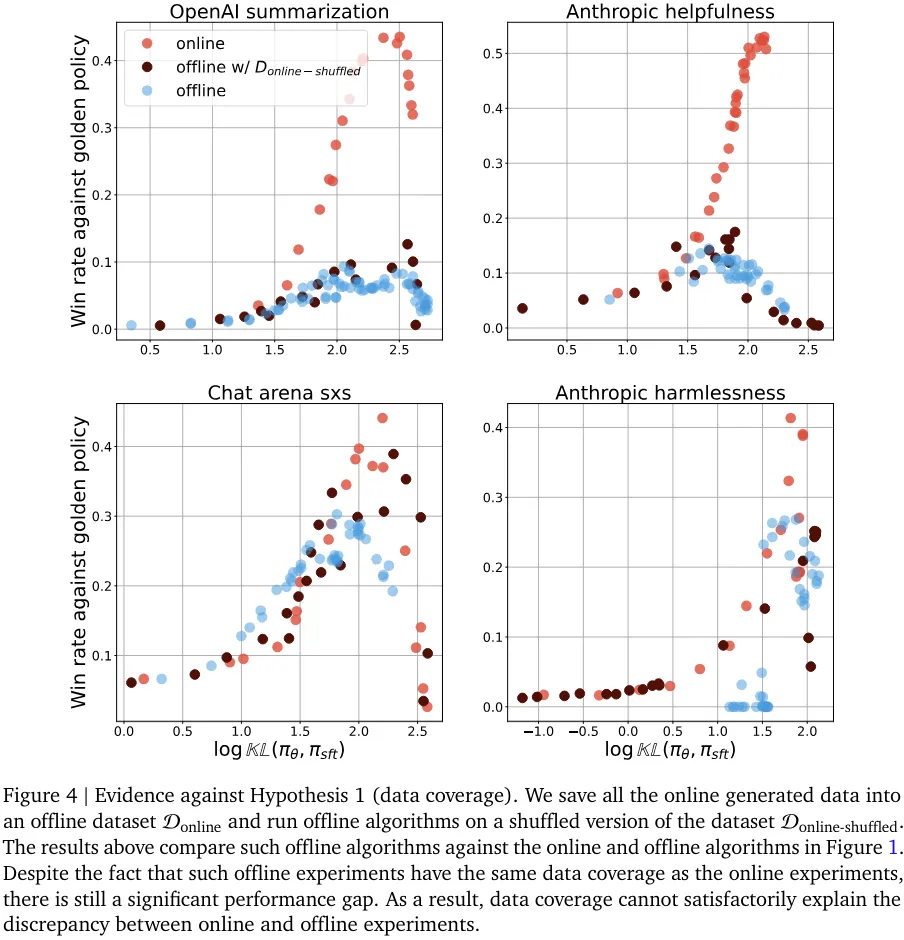
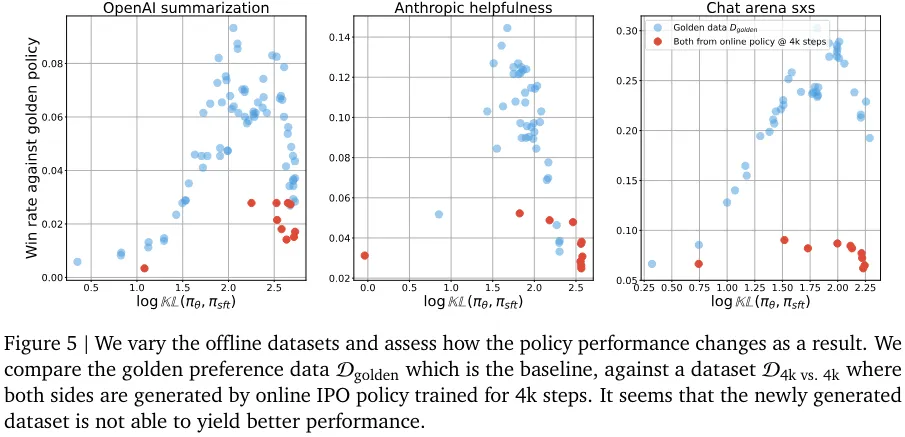
该团队提出的一些假设涉及到离线数据集的性质。其中包括假设离线数据集的覆盖情况比在线生成的数据集差;假设离线算法对离线数据集更敏感,而离线数据集中响应的绝对质量要差一些。(图 4 和图 5 分别证否了这两个假设)。
在这里插入图片描述

在这里插入图片描述

尽管这些假设听上去似乎是对的,但实验结果表明它们无法可信地解释在线和离线算法的性能差距。

他们通过消融研究发现,提升离线优化的一种有效方法是生成分布上接近起始 RLHF 策略(这里就刚好是 SFT 策略)的数据,这本质上就模仿了在线算法的起始阶段。

优化性质

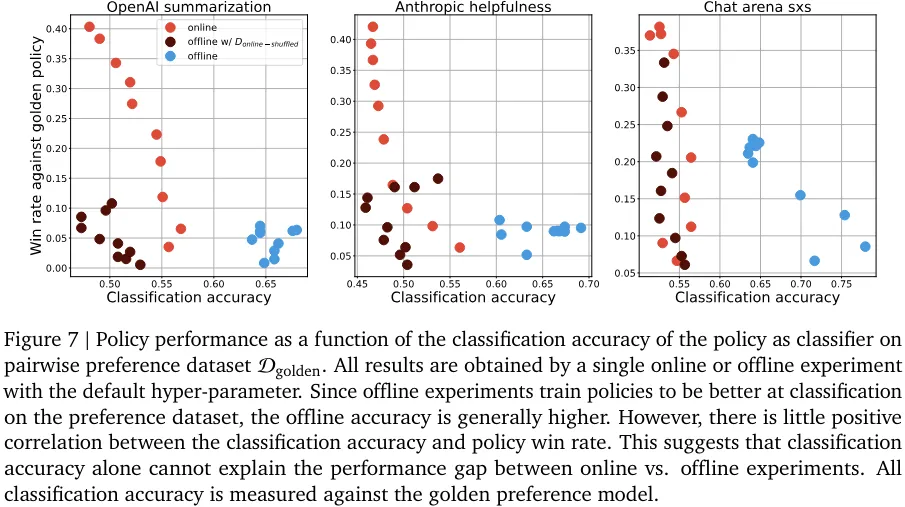
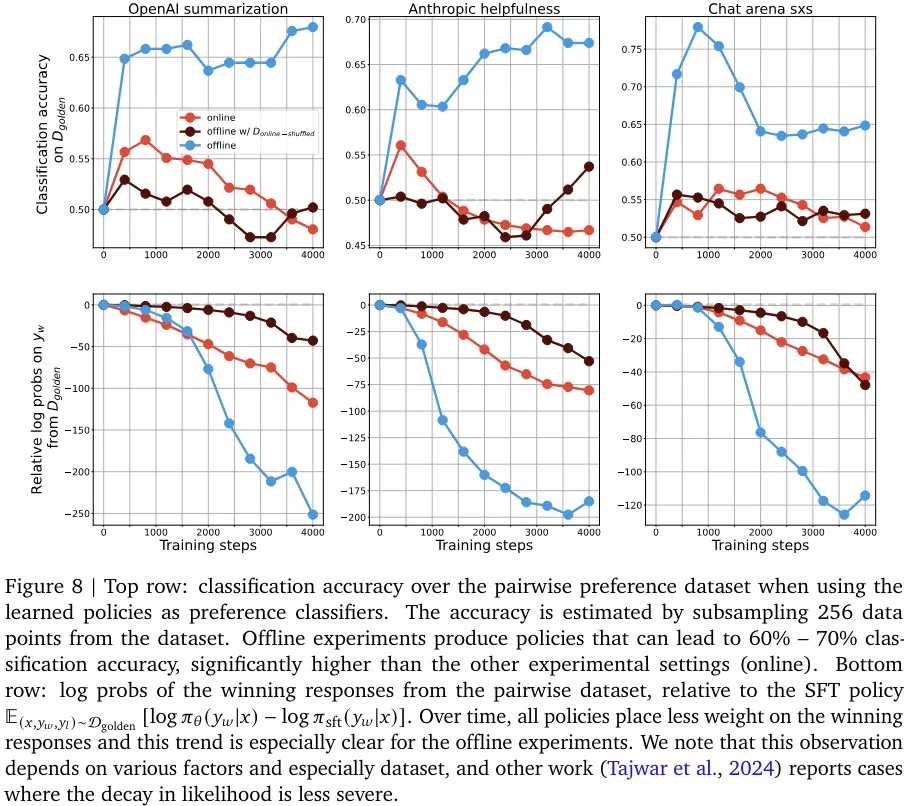
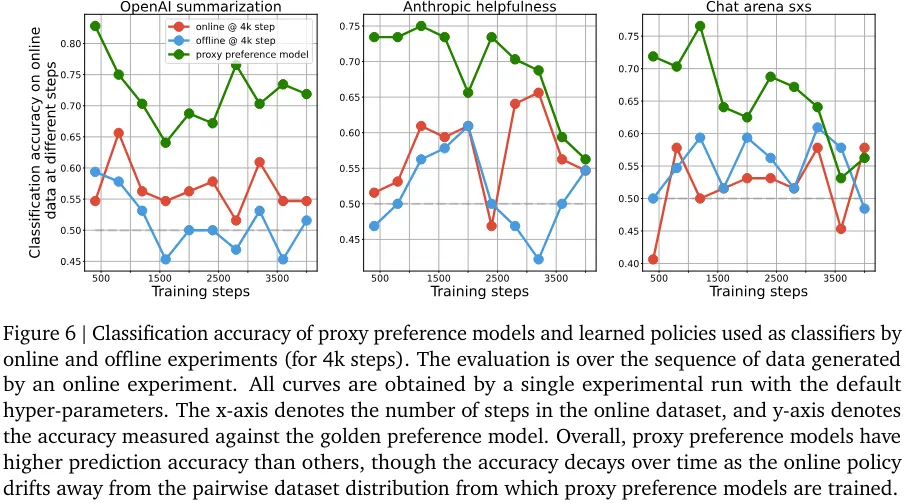
该团队发现判别能力和生成能力之间存在一种有趣的相互作用:尽管离线策略的分类能力胜过在线策略,但离线策略生成的响应却更差(见图 6、7、8)。
在这里插入图片描述

在这里插入图片描述

在这里插入图片描述

不管是类间分类还是类内分类实验,分类性能和生成性能之间的关联似乎都不大。尽管离线和在线采样都是针对一个判别目标优化的,但离线采样是提升在一个静态数据集上的分类准确度,而在线采样则是通过不断改变采样分布来提升生成质量。实验表明,离线策略的生成性能提升不如在线策略的直接。

损失函数与扩展

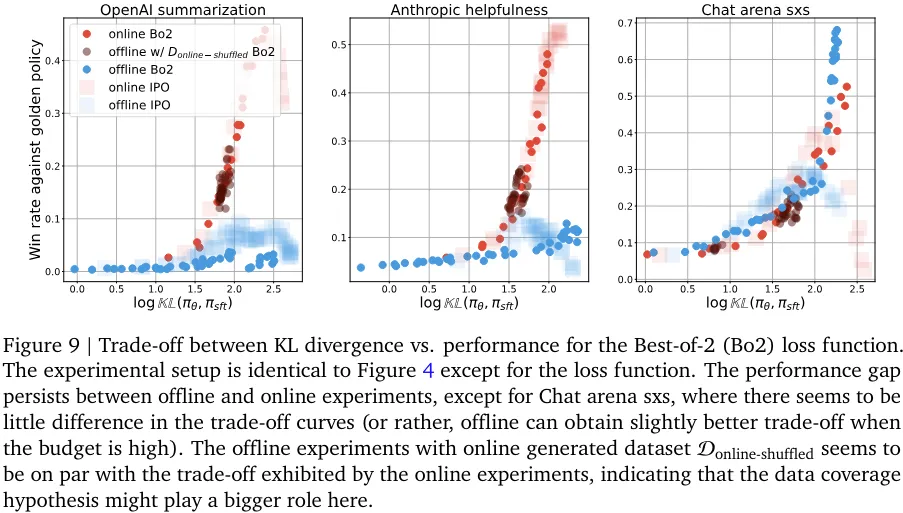
为了确保所得结果更普适,他们还研究了用于 RLHF 的对比式和非对比式损失函数。
在这里插入图片描述

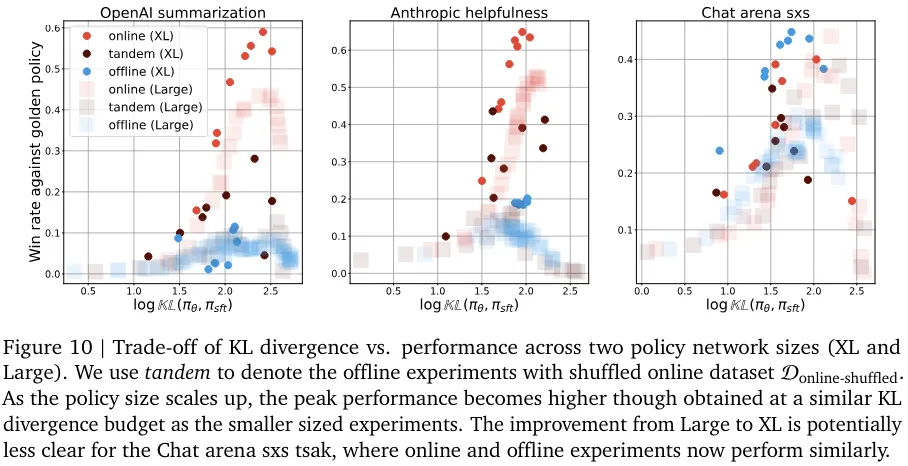
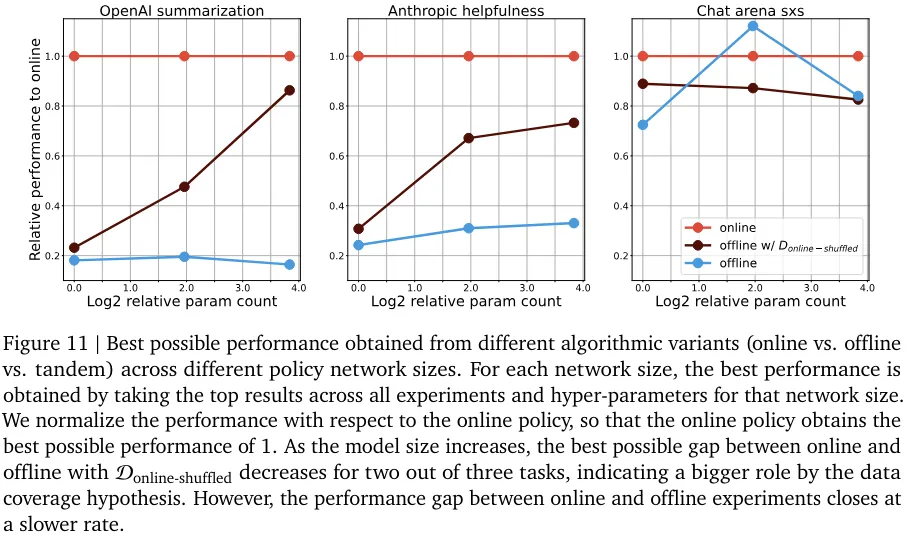
在线与离线性能之间的差距似乎总体上持续存在,尽管这种差异的根本原因可能与算法有关。他们也研究了性能差距随策略网络规模扩展的变化情况(见图 10 和 11)。性能差距一直存在这一事实说明:只是扩展模型规模可能无法解决采样问题。
在这里插入图片描述
在这里插入图片描述

尽管实验结果暗示了在策略采样对模型对齐的根本重要性,但这些结果也许有助于揭示离线对齐算法的实验内部工作原理,并揭示性能差异的根源。总而言之,这些发现为 RLHF 实践者提供了有趣的见解和挑战,并为更有效的 AI 对齐实践铺平了道路。

根据现有的强化学习研究成果,在线比离线更好似乎是显而易见的结论。在线和离线强化学习算法之间的性能差距也已经被多项研究发现,所以这项研究给出了什么不一样的结论呢?

最重要的是,在线 RLHF 算法依赖于一个学习后的奖励模型,该奖励模型是使用与离线 RLHF 算法一样的成对偏好数据集训练得到的。这与常规强化学习设置存在根本性差异 —— 常规强化学习假设能以在线方式获取基本真值奖励,在这种情况下,在线强化学习的优势明显。假设 RLHF 受到奖励信号的瓶颈限制,我们就不清楚在线与离线的差距是否还会这样显著。

从更技术性的角度来看,许多 RLHF 算法采用了上下文赌博机的设计形式,并针对参考策略应用了正则化。这样的算法细节让 RLHF 偏离了常规的强化学习设置,这可能会影响离策略学习问题的严重程度。

​

如何学习AI大模型?

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
在这里插入图片描述

一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

四、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

平滑在线凸优化算法(python) 平滑在线凸优化 (SOCO) 是在某个决策空间中选择一系列点的问题,最小化为选择一个点而支付的命中成本,该成本在轮次之间发生变化,以及为移动而支付的移动成本。决策空间。 因此,SOCO 可以理解为带有额外平滑元素的在线凸优化。 这项工作的一个特别关注点是应用到数据中心的动态调整规模 立即下载

相关推荐

Delphi 12.3 精简绿色版下载

Delphi精简绿色版基于原版安装,去掉了InterBase、法语、德语、日语,只保留了Delphi Windows 32和Delphi Windows 64桌面开发,其余部分未做任何修改。Delphi精简绿色版不含任何破解,仅供学习和研究,24小时后请自行删除,如需继续使用Delphi,请购买正版。绿色版基于原版安装,未做任何精简和修改。绿色版不含任何破解,仅供学习和研究,24小时后请自行删除,如需继续使用RAD Studio,请购买正版。

全粘工程师 4303

在线最优化求解(Online Optimization)之一:预备篇

在线最优化求解(Online Optimization)之一:预备篇 动机与目的 在实际工作中,无论是工程师、项目经理、产品同学都会经常讨论一类话题:“从线上对比的效果来看,某某特征或因素对xx产品的最终效果有很大的影响”。这类话题本质上说的是通过已有的数据反映出某些特定的因素对结果有很强的正(或负)相关性。而如何定量计算这种相关性?如何得到一套模型参数能够使得效果达到最优?这就是最优化计算要...

weixin_34198797的博客 1584

距离多普勒谱(RD谱)绘制方法及理解

RD谱是信号处理领域常用的图形。原始信号往往是一维时域序列,如何将其二维化,并进行变换生成RD谱呢?由于刚刚接触,查阅了网络上、老师手里的资料,发现RD谱的绘制方法并不统一,有些存在一定问题。在此,将心得体会记录下来。

mddh_123的博客 3万+

AI本地绘画软件(无需联网)+7Glatest模型+10G数据整合包

Midjourney虽然很强,但也仅仅只是针对官方已有的模型,对于官方不支持的模型画出来的效果也就那样,如果你想再生成刺激一点的作品,它也难以满足你的需求。强烈建议大家试试civitai这个网站,它所提供的AI模型量简直多到爆炸,诸如动漫风、国风、写实风、机甲风、真人小姐姐等统统都有,只要模型选的好,就没有画不出来的作品!一个女孩,上身,高细节脸,微笑,[灰金色|姜黄色|棕灰色头发],富士胶片XT3,短裙,中性色调,如米色或驼色或银色或蓝色,搭配白衬衫和蝴蝶结,创造一个优雅而有力的外观。

夜栩的博客 2658

CHB-MIT波士顿儿童医院癫痫EEG脑电数据处理(一)

CHB-MIT癫痫EEG脑电数据处理CHB-MIT头皮脑电图数据介绍CHB-MIT头皮脑电图数据下载CHB-MIT头皮脑电图数据处理提取原始数据滤波(0.1~50hz)数据分块(时间窗口) CHB-MIT头皮脑电图数据介绍 该数据库收集自波士顿儿童医院,其中包括患有难治性癫痫发作的儿科患者的脑电图记录。停用抗癫痫药物后最多持续几天对受试者进行监测,以表征其癫痫发作并评估其对手术干预的候选资格。 从22位受试者中收集了23个病例的记录(5例男性,3至22岁; 17例女性,1.5至19岁)。 (案例chb21是

AI_DOG的博客 1万+

DIC新手避坑指南:压缩实验中的应变测量常见错误与数据校验技巧

本文为DIC技术新手提供了压缩实验中应变测量的全面避坑指南。文章系统梳理了从试样尺寸录入、散斑质量到数据后处理中应变方向与符号混淆、数据插值对齐等常见错误,并分享了基于MATLAB的自动化数据校验与可视化对比技巧,帮助建立可靠的实验数据分析SOP,确保DIC测量结果的准确性。

weixin_29313423的博客 113

在线学习(Online learning)与离线学习(Offline learning)

在线学习与离线学习的简要介绍 ...

weixin_42267615的博客 3万+

unity pc运行包导入glb

本文介绍了在Unity中实现GLB/GLTF模型动态导入的方法。主要使用glTFast插件进行模型导入,配合StandaloneFileBrowser实现文件选择功能。文章提供了详细的插件安装方式(包括国内镜像源),并给出了核心导入脚本代码。脚本实现了模型加载、父对象设置、材质修复等功能,解决了常见的材质显示异常问题。该方法支持编辑器和PC平台,兼容不同版本的glTFastAPI,通过简易UI操作即可完成模型导入,适合需要运行时加载3D模型的Unity项目开发。

懒懒的蓝的博客 544

本地离线部署Ai大模型的三种方案,含安装教程!

大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。包括:大模型学习线路汇总、学习阶段,大模型实战案例,大模型学习视频,人工智能、机器学习、大模型书籍PDF。带你从零基础系统性的学好大模型!观看零基础学习书籍和视频,看书籍和视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。

2301_82275412的博客 3127

lvgl 实现表格table,并且固定表头

嵌入式实现table,lvgl 实现原生表格table组件

m0_61704502的博客 1271

SAP S/4HANA 可扩展性 – 面向初学者的简化指南

可扩展性(Extensibility)是 SAP ECC 和 SAP S/4HANA 的一项关键功能。它使客户能够通过定制其业务流程来创造竞争优势,并使合作伙伴能够通过量身定制的解决方案来丰富核心 ECC 或 S/4HANA。在过去的几十年中,SAP 的 on-premise 版本客户和合作伙伴主要使用经典的 ABAP 扩展性来扩展他们的 ERP 解决方案。经典扩展性允许 ABAP 开发人员使用甚至修改所有 SAP 对象。尽管经典扩展性非常强大和灵活,但在当今的云世界中,它已不再是一个好的选择。

SAP学习成长之路的博客 1809

离线学习+在线对齐!扩散模型驱动的四足机器人运动

点击下方卡片,关注“具身智能之心”公众号作者| 具身智能之心 编辑|具身智能之心本文只做学术分享,如有侵权,联系删文>>点击进入→具身智能之心技术交流群更多干货,欢迎加入国内首个具身智能全栈学习社区:具身智能之心知识星球(戳我),这里包含所有你想要的。想象一下,一位经验丰富的登山者行走在蜿蜒的山路上,脚下的草地中混杂着碎石,身旁有大片茂密的灌木丛。或许连他自己都没有意识到,每一...

CV_Autobot的博客 889

Fiddler抓包实战:5分钟搞定微信公众号历史消息接口分析(附完整Python代码)

本文详细介绍了如何使用Fiddler抓包工具逆向分析微信公众号历史消息接口,并提供完整的Python代码实现。从环境准备、动态参数捕获到商业级采集系统架构设计,全面解析了突破官方接口限制的技术方案,帮助开发者高效获取公众号文章数据。

tree8的博客 329

离线到在线强化学习论文导引

近年来,离线到在线强化学习(O2O RL)研究快速发展,提出多种创新方法优化预训练与微调过程...

qq_45029633的博客 1094

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

【机器学习】RLHF:在线方法与离线算法在大模型语言模型校准中的博弈

RLHF是一种结合人类反馈与强化学习的技术,旨在通过人类反馈来优化语言模型的输出。其基本思想是通过预先训练好的语言模型生成多个候选输出,然后由人类对这些输出进行排序或评分。这些排序或评分作为奖励信号,被用于指导模型在后续生成中“更喜欢”某些结果。通过这种方式,模型可以逐步学会根据人类偏好生成更安全、更准确的输出。提高模型输出的安全性和可信度。通过人类反馈,模型可以学会避免生成不恰当或有害的内容。增强模型对特定任务的理解和执行能力。

2401_85343303的博客 1110

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

大语言模型离线强化学习对齐技术解析

强化学习(RL)作为机器学习的重要分支,通过智能体与环境的交互学习最优策略。在自然语言处理领域,离线强化学习(Offline RL)通过利用预收集的静态数据集进行策略优化,有效解决了在线学习的高成本问题。大语言模型(LLM)的对齐技术借助强化学习从人类反馈(RLHF)实现价值观校准,而宪法AI等创新方法进一步提升了数据利用效率。本文介绍的端到端离线策略优化框架,通过重要性采样和保守策略更新等技术,在保持生成安全性的同时显著降低训练成本,为AI对齐提供了可落地的工程解决方案。该技术已在安全评估基准测试中展现出

weixin_33736048的博客 316

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

ICLR 高分:深入研究多模态大模型的对齐策略

多模态大模型(MLLMs)虽然在视觉与语言理解任务上取得了显著进展,但仍面临“幻觉”现象,即生成的描述可能不符合视觉内容。为了解决这一问题,研究人员提出了偏好对齐(preference alignment)方法来增强模型与图像内容的契合度。然而,由于偏好数据集、基模型类型和对齐方法的差异,目前尚不清楚具体哪些因素对性能提升最为关键。因此,本研究旨在通过独立分析各个因素,探索不同的对齐方法对MLLMs性能的影响。

m0_59164304的博客 1691

具身智能从离线学习到在线学习的范式转变

它不再满足于在静态数据集上达到顶峰,而是勇敢地投身于动态、复杂、充满未知的真实世界,在与环境的持续交互中实现自我迭代和终身成长。这不仅是技术的演进,更是我们对智能本质理解的深化——真正的智能,不在于背诵多少知识,而在于能否在变化的世界中持续学习和适应。离线模型在训练时假设“训练数据”和“真实世界”是独立同分布的。🚀 在线学习的“高光时刻”:从“能用”到“好用”的飞跃。从离线学习到在线学习的范式转变,本质上是AI从。在线学习让AI具备了“活到老,学到老”的能力。🔄 范式转变:从“离线”到“在线”的核心差异

xhlo521的博客 227

离线与在线混合数据强化学习论文导引

摘要:近年来,强化学习领域涌现出多种融合离线与在线数据的方法。。。

qq_45029633的博客 636

论文浅尝 | 大型语言模型的人类对齐

笔记整理:方润楠、习泽坤,浙江大学硕士,研究方向为自然语言处理链接:https://arxiv.org/abs/2307.12966概述这份综述探讨了针对大型语言模型(LLMs)的人类期望进行对齐的技术,涵盖了以下几个方面:1. 数据收集:有效收集LLMs对齐所需的高质量指令的方法,包括使用NLP基准、人工注释和利用强大的LLMs。2. 训练方法:对LLMs对齐采用的主要训练方法进行详细审查。涵盖...

开放知识图谱 1568

普渡大学首创f-GRPO:让AI对齐变得像调音师一样精准

普渡大学首创f-GRPO:让AI对齐变得像调音师一样精准

weixin_49122920的博客 85

8个实用AI翻译工具盘点:CSANMT支持离线部署更灵活

本镜像基于 ModelScope 的模型构建,专为中文到英文翻译任务优化。该模型由阿里达摩院研发,在多个中英翻译评测集上表现优异,尤其擅长处理长句语义对齐与地道表达生成。系统已集成Flask Web 服务,提供直观的双栏式对照界面,左侧输入原文,右侧实时输出译文,适合人工校对与快速验证。同时开放 RESTful API 接口,便于嵌入现有业务流程或自动化系统。项目还修复了原始模型输出格式不统一导致的结果解析兼容性问题,确保在各种输入条件下输出稳定可靠。💡 核心亮点高精度翻译。

weixin_28988985的博客 1010

全面解读 LLM 对齐技术:RLHF、RLAIF、PPO、DPO…… 一览无余

(全套教程文末领取哈)从大模型系统设计入手,讲解大模型的主要方法;在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;以SD多模态大模型为主,搭建了文生图小程序案例;以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。

weixin_42924914的博客 1465

为什么你应该试试这款免费在线PPT制作神器?

还在为制作PPT而烦恼吗?安装Office软件太占空间,在线工具又要收费?PPTist这款基于Vue3.x + TypeScript开发的免费在线演示文稿应用,让你在浏览器中就能完成专业级的PPT制作!🎯 ## 🌟 PPTist:你的在线PPT制作新选择 PPTist是一款功能强大的开源在线PPT制作工具,完美还原了Office PowerPoint的核心功能。它支持文本、图片、形状、图表

gitblog_00103的博客 763
上一篇: AI大模型迈入应用时代,每日互动推动“可控大模型”落地
下一篇: 大模型也有小偷?为保护你的参数,上交大给大模型制作「人类可读指纹」
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值