


 本文介绍Codex Harness如何将Agentic产品解耦为客户端与App Server两层架构,使产品团队专注业务逻辑与用户服务,而会话管理、工具调度、状态维护等复杂能力由预编译的Codex App Server统一承载。App Server以本地服务形式集成,支持对接任意大模型API,实现模型厂商与业务代码解耦,显著降低大模型应用开发门槛。
本文介绍了Codex Harness如何将Agentic产品拆分为两层,即客户端和包含业务代码及编译好开源Codex的App Server。客户端不直接连接大模型,而是通过App Server进行交互。产品团队只需关注定义场景、业务规则和用户服务,而会话、调用记录和执行管理等复杂管理由Codex Harness负责。这种方式简化了大模型开发流程,让小白和程序员也能轻松入门。
朋友圈里一直在传“Codex harness开源了,很好用”。我把文档和自己跑起来的结构放在一起看,觉得大家兴奋的那个点,其实已经不只是“又多了一个能聊天的官方窗口”。
一个 Agent,可以看成 Harness 加上LLM。 Harness 管会话、工具循环、上下文和执行,LLM是外面那台模型服务器。Codex Harness 做成了可以放进你自己服务里的一层。产品团队要守住的,是客户端和业务代码。
Codex Harness 已经把 Agentic 产品拆成可以分开交付的两层
这张图就是这次跑通之后的分层。左边可以有很多客户端,它们不直接去找模型,而是进入你的 Agent 服务。服务跑在本地 Mac 或者你的服务器上。里面并排着两块:一块是你的代码,一块是 codex app server。app server 里面装着已经编译好的开源 Codex。代码和 app server 互相通信,再由 app server 向大模型服务器发起请求,把响应拿回来。

这就是新的交付方式。客户端和业务代码仍然是产品自己的。最复杂的那一层,以 app server 的形式装进服务里,由已经编译好的 Codex 去承担。模型厂商继续提供外面的大模型,业务代码处理自己的场景和规则。
过去做 Agentic 产品,团队得自己扛下 Harness 里的复杂管理
以前要把一个 Agent 做成别人能用的产品,常见就是两条路。一条是把官方 Codex 整套部署出去。界面、会话和切模型的方式都已经定好了,用户用到的是那套客户端,不是你要做的产品。另一条是拿 LangChain,或者一套智能体工作流框架自己搭。能搭起来,但人会先耗在循环、状态和工具调度上,业务和用户服务被挤到后面。
两条路最后都把产品团队留在 Harness 里面。团队的时间花在引擎上,场景里那句话怎样回到用户面前,被留到了最后。
App Server 让 Harness 以服务的形式被产品调用
App server 把这件事翻了过来。你不必先在机器上装一整套官方客户端,再想办法把它的界面拆开。代码部署到本地 Mac 或服务器之后,会把 Codex 这套已经编译好的程序带出来,成为一个可以通信的进程。你的代码先跟它握手,打开 RPC 通道,用户的一句话从这里送进去,模型的响应从这里回来。
模型仍然在服务外面,就是图上右边的大模型服务器。演示里,模型的 API key、base URL 和上下文窗口写在项目的 .env 里。请求由 app server 发出,响应再回到你的代码,最后回到你自己的客户端。DeepSeek 这类模型可以按 API key 和 base URL 接进来,所以模型厂商和这套 Harness 程序,也不必绑死成同一家。
我觉得范式就是在这里变的。顶尖模型厂商把最复杂的管理做成一套可调用的 Harness,你以服务的形式把它放进自己的 Agentic 产品里。你要定义的,是业务代码和客户端里的用户服务。
单轮打通之后,产品侧要决定的是业务规则和用户服务
以单轮问答为例,我们可以清晰的表露把这条边界。用户在客户端说一句话,代码把这句话交给 app server,app server 带着编译好的 Codex 去请求大模型,结果再回到你的界面。产品侧要先定的是:模型从哪来,这句话代表什么业务,结果在你的客户端里怎么呈现。
项目真正跑起来之后,目录会多出两块。一块是程序,一块是运行数据。

project/.data 和 project/.runs 是代码跑出来的数据存储。node_modules 里是这次跑出来的程序。项目里原来就有 .env,真正去连 app server 的入口是 05-app-server.mjs。
打开 node_modules/@openai,能看到 codex,以及当前这台机器对应的 codex-darwin-arm64。图上标的就是这件事:代码跑完,这里出现了一个 Codex。你没有单独装官方客户端,这个可执行程序已经在依赖里了。

数据侧也能分开看。.runs 下面有多组 app-server- 开头的目录。目录里的 models.json 是 app server 调用模型的配置,protocol.jsonl 是调用记录。模型从 .env 走进这次运行,配置就落在这些目录里。

.data/codex 是这个 Agent 服务自己的数据存储。里面有 config.toml,也有 goals、logs、memories、queue、state 这些 sqlite。messages.json 记的是会话。会话、记忆、队列和状态都堆在这一层,业务代码就不必再自建一套同样的账本。

所以单轮打通以后,产品还要认真做的是业务规则和用户服务。引擎侧这些目录,是 Harness 跑起来之后自己留下的。
未来的 Agentic 开发只留下一件事:定义业务逻辑,把复杂管理交给顶尖模型厂商
回到第一张图。客户端可以很多,Agent 服务是你的。你要写的是服务里的业务代码,以及用户真正接触的那一层。codex app server 带着已经编译好的开源 Codex,负责和代码之间的调用,再负责去连大模型。会话记录在 .data/codex/messages.json,调用记录和模型配置在 .runs 里,执行状态也在这层数据里。
未来的 Agentic 产品,开发上要定义好业务逻辑。 我说的业务逻辑,是用户场景、规则,以及结果如何回到自己的客户端。Harness 作为服务放进 Agent 里,最复杂的会话、循环和执行管理,交给做出这套程序的模型厂商。
这句话有它的边界。哪一个工具可以执行、哪一步必须等人确认,仍然要由产品来定,单轮演示还看不出这块成本。Codex 的源码是开放的,团队仍然可以自己改这套引擎;如果你的差异就在那个循环上,就继续自己拿着它。现在这张图能看清的,是你的 Mac 或服务器上已经能把 Harness 当成服务来跑,模型请求走向外面的大模型服务器。
朋友圈说 Codex 开源了、很好用。好用如果只是换了一个官方窗口,产品并没有变。变了的是,你可以留下自己的客户端,把 Harness 装进自己的 Agent 服务,让最复杂的管理留在这层已经编译好的程序里。
如果之后做一个自己的客户端,主要工期仍然花在手写循环和会话状态上,这个判断就不成立。如果一换掉这层 Harness,业务规则就得跟着重写,那它也还不是一个可以替换的服务。
大模型的知识又多又杂,到底怎么学?
做这行久了,被问最多的问题就一个:大模型的知识又多又杂,我到底先学啥?翻了一堆资料,看啥都像重点,结果啥都没学进去。今天把我自己一路摸出来的顺序捋一遍,零基础、应届生、转行的都适用。跟着走,至少方向不乱、不瞎忙,学完拿得出手。
第一阶段(10天):初阶应用
这一阶段就一个目标:把大模型真正"玩明白",不是只会聊天那种,而是能调教它、能用代码把大模型和业务接起来。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
这阶段正式进实战,目标很实在:做出两个能拿出手的东西——一个私有知识库,一个 agent 对话机器人。
-
为什么要做 RAG
-
搭建一个简单的 ChatPDF
-
检索的基础概念
-
什么是向量表示(Embeddings)
-
向量数据库与向量检索
-
基于向量检索的 RAG
-
搭建 RAG 系统的扩展知识
-
混合检索与 RAG-Fusion 简介
-
向量模型本地部署
-
…
走完这 30 天,Python 或 JavaScript 背景的基本能独立做一套 RAG 应用,简历上也敢写"大模型应用开发"了。
第三阶段(约20天):动手微调
学到这,你已经开始 “造” 模型了 —— 通过微调,搞出垂直领域的专用小模型。
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你从 “只会用” 变成 “能造” 的 AI 小子。那么你还想往下探索吗?
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方优快云官方认证二维码,即可100%免费领取全套学习资料!
第四阶段(20天):商业闭环,部署落地
技术学完,落地才算数。这阶段带你搞明白大模型怎么真正跑起来、用起来。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
想要入坑大模型的朋友,给大家准备了一份2026 年最新 AI 大模型全套学习资料:
1、大模型系统化学习路线
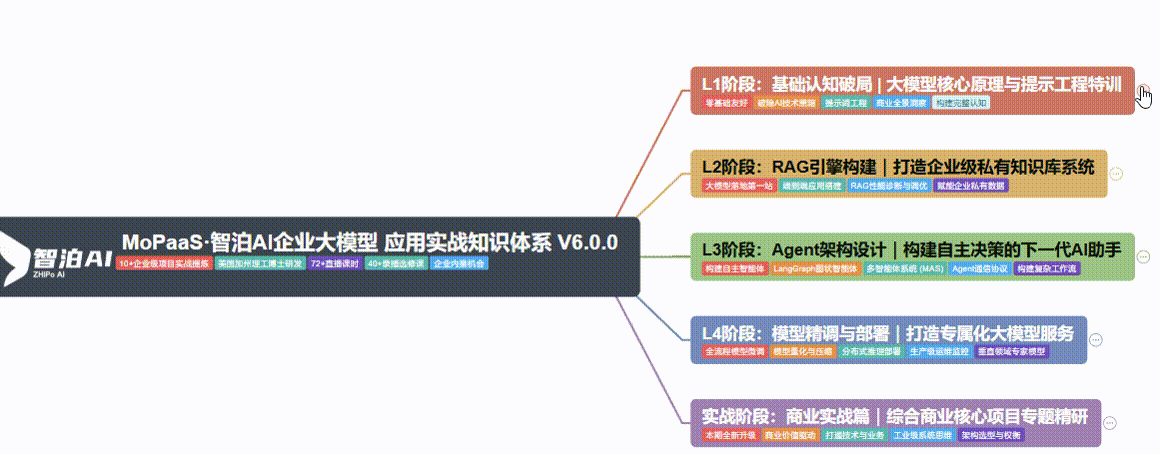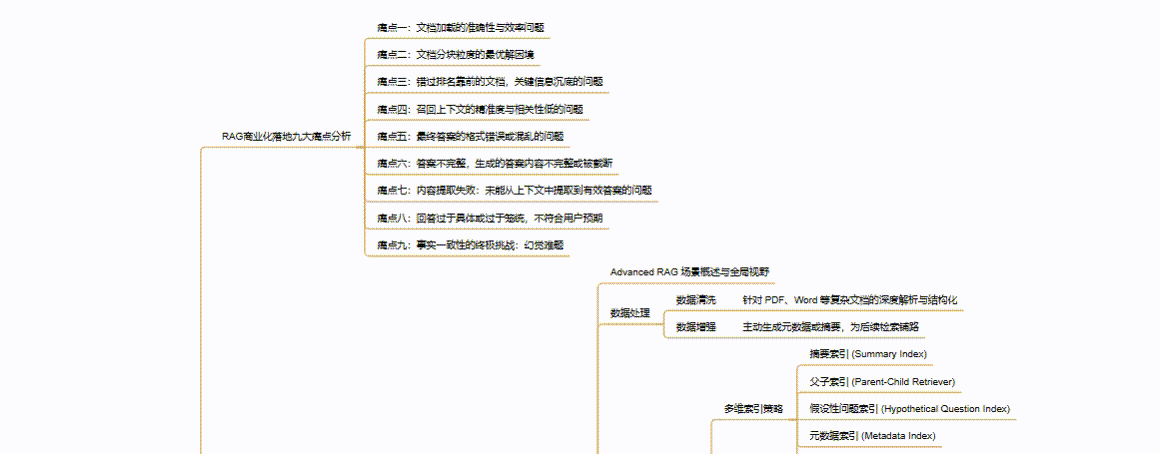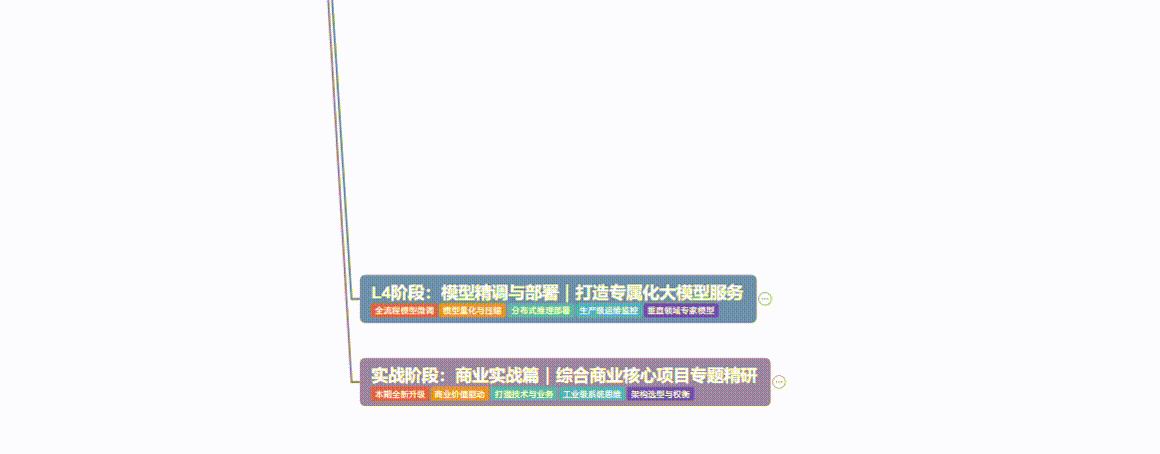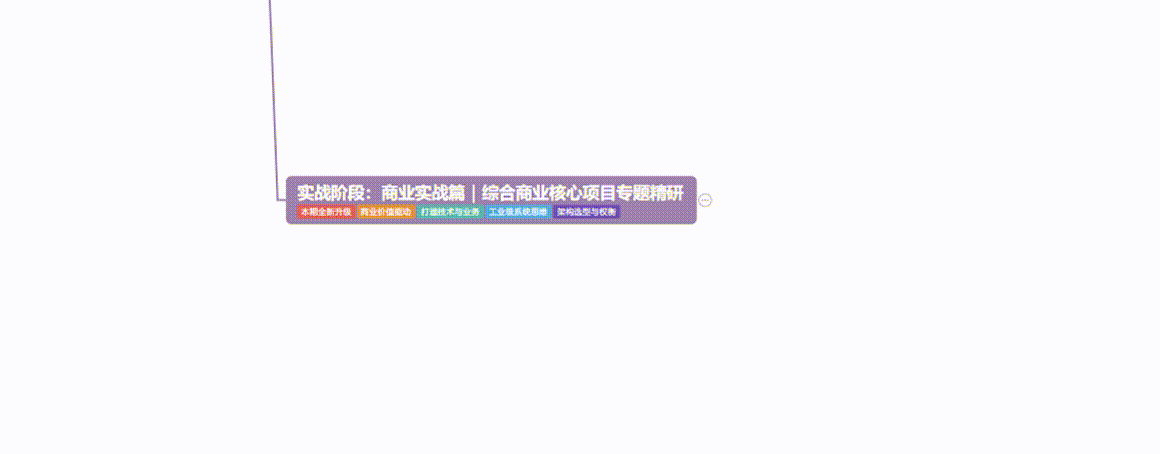
2、大模型学习视频教程

3、大模型学习书籍&电子文档
4、AI大模型最新行业报告

5、大模型项目实战&配套源码

6、2026大模型大厂面试真题

7、为什么要学习大模型?
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。


8、适合谁学?
- 传统后端 / Java / 前端开发,想转型 AI 应用
- 大学生、应届生,想拿更好的 offer
- 产品经理、运营,想武装职业竞争力
- 技术负责人,想给团队落地提效
学习是反人性的,但回报是真金白银。技术会更新,赛道会切换,但只要你先动手,机会就永远站在你这边。
9、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方优快云官方认证二维码,即可100%免费领取全套学习资料!
好了,就写到这。路线是死的,人是活的,卡住了随时来问我。觉得有用就点个收藏,别让它进收藏夹吃灰——动起来比啥都强。


 扫一扫


 4835

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


