


 本文剖析了AI大模型领域激烈的人才争夺现状,涵盖从顶尖研究员亿级年薪、应届生600万年包到博士实习生5000元日薪的薪酬跃迁现象;揭示企业争抢核心‘配方’人才(如大规模预训练经验、多模态调优能力)的本质动因,并指出人才流动正加速行业技术扩散。同时系统梳理了大模型学习四阶段路径:初阶应用、高阶RAG/Agent开发、微调实践、商业部署落地,强调工程化能力与产业闭环的重要性。
文章深入剖析了当前AI行业,尤其是大模型领域的人才争夺战。从一线算法研究员的惊人年薪到顶尖应届生的600万年包,展现了AI人才市场的火热。文章指出,大厂和创业公司都在争抢掌握核心“配方”的人才,因为这些人能够显著提升模型训练效率,推动行业进步。同时,文章还分析了人才流动对AI行业格局的影响,以及不同公司在人才争夺战中的策略和变化。最后,文章预测了AI人才市场未来的发展趋势,认为虽然最高潮的阶段已经过去,但人才争夺战仍将持续。
热钱
得知那位98年的同事,一位一线算法研究员跳槽去腾讯后的年薪时,朱可欣觉得眩晕。
涨幅高达3倍——朱可欣和这家大厂的同事们在聚餐上猜测对方拿了多少时,“大胆猜测涨50%”。但答案揭晓,是从100万涨到300万,这远超他们预料。一顿饭的时间,饭桌上所有人对自我定价都重估了一遍。
旧有的薪资坐标被迅速改写,“眩晕”不断发生。距离那次跳槽仅一年过去,朱可欣说,现在已经没人会对一线研究员拿300万年薪感到惊讶了。
高昂年薪的年龄层还在下探。
在腾讯混元,一名00后研究生还没走出校园,就以实习生的身份领着5000元的日薪,月收入比这座大城市的大部分白领都高出许多。他的上级跟他交过底,“毕业转正可以给到年薪300万。”这位年轻人很直白地告诉36氪,他今年就想马上毕业。
从硅谷到中国,当顶尖AI人才在以亿级年薪和“一号位送温暖”被争抢时——字节AI一号位吴永辉是张一鸣花了8个月才促成的;腾讯AI一号位姚顺雨是总裁刘炽平亲自去硅谷谈下来的;而Meta不仅能开天价,扎克伯格会给他想挖的OpenAI研究员“送亲手做的汤”——整个AI人才金字塔中,从塔尖到塔基,每一层人才的价格都在被不断推高。
塔尖上的人,能拿到上亿年包——姚顺雨入职腾讯,DeepSeek郭达雅转投字节,都被传年薪上亿。但这个人群非常小,每家的模型团队只有几个人。

往下一层,是在大厂里拿超千万年包的人。一位猎头告诉36氪,每家大体量的公司里有差不多有10-20个这样的人,每位都是职位变动会牵动行业关注的业界明星。
再下一层,是“500万及以上”年包量级的TopSeed、阿里星、腾讯“大咖”等顶尖应届生,每家几十人。一位今年入职字节的博士候选人对36氪解释了600万年薪的构成:“不全是现金,还包含字节期权,豆包股、还有奖金。”他还提到,有的应届生能拿到比600万更多的数字,“但那是极个别”。
再往下,是200万-300万的一线AI算法,被称为“打工仔”,人数最多,定价依据是学术代表作和核心项目经验。“今年,年薪200万+是一个普通算法研究员能接受的基准线,去年还是100万+。”一位大厂算法说,“我有个朋友之前拿到了Seed 200万+的年包,最后没选,因为另一家AI公司给了他300万+,以及更高的职级。”
金字塔的最底层,是AI算法实习生。字节、腾讯、阿里核心方向的博士实习生日薪可达5000-6000元,而两年前,博士实习生的平均薪资还是1万元/月,相当于现在两天的薪水。
当实习生的月薪都来到了十万元以上,对AI人才的争夺,尤其是对大模型研究员的争夺,可以说是从塔尖到塔底全方位地进入了白热化。
这背后,是中国模型厂之间的竞争演化:字节原本是市场上最慷慨的AI人才买家,但最近一年,腾讯也突击抢人,成为顶级人才大金主。同时,DeepSeek、月之暗面在一级市场大额融资,智谱、MiniMax上市,大模型创业公司也筹集了加码的钱。
一直以来,“人才”在各个行业的竞争中都是一个重要的变量。但当下AI行业人才争夺的烈度,明显高于上一个热钱涌入的行业——互联网。可以与之匹敌的,恐怕只有1950-1970年之间的半导体行业刚兴起时对核心人才的抢夺。
这两个行业的共同特点都是:公司看起来拥有技术,但真正拥有技术的,是那几十个核心的技术人员。所以,人才成了公司竞争中“卡脖子”的关键变量。
就这样,AI公司之间的竞争,演变成了人才间的竞争。而人才的流动,剧烈地改变着每一家置身其中的公司,也深切地影响着整个AI行业的格局变化。
买配方
大厂和大模型公司所争夺的,其实是核心人才手中的技术“配方”。
在训模型时,研究员用“配方”这个词来描述模型训练中的方方面面:模型多大尺寸、数据怎么配比、训练路线怎么选,有哪些关键tricks…
模型的成功,是趟过大量的试错经验而实现的。而经历这一切的人,掌握着这些认知。就好像半导体行业早期也是如此:工艺参数、良率、材料、制造诀窍很难完全写进专利。所以,挖到一个对的人,可以拿到这些“隐形认知”,迅速缩抹平模型代差,缩小跟竞争对手的差距。
配方贵有贵的道理。模型训练的重置成本极高:训练一个基座模型,或微调千亿参数模型,一次完整的实验所花费的算力成本可能高达几千万甚至上亿。若训练方向、方法错误,其损失远远超过几个研究员的年薪。
更关键的是,能拿到核心配方的人实际非常少。
与互联网时代大部分所谓的创业经验不同,模型圈讲求的“万卡训练经验”,只有少数头部大厂和顶级实验室才有足够的算力和数据支持;而在这少量公司里能获得“训练指挥官”资格的人,也是凤毛麟角。
“全中国能牵头搞大规模预训练的,就那200个人。”猎头York说。一位字节HR也告诉36氪,当他们在2024年开始集中挖猎核心研究员时拉了一张名单,名单上也就小几百人。
当掌握核心配方的人流动起来,这些原本掌握在少数公司手里的模训练识就会随之被“开源”,完成跨公司的迁移,最后抬高整个行业的天花板。这就好比:一道菜的配方一开始只由几个厨师掌握,那这几个厨师供职的饭店暂时就会看起来很强;可一旦一个王牌厨师跳槽,配方立刻就会流传开来,没有哪家饭店能持续领先,但越来越多好吃的饭店会抬高整个行业的天花板。

2024年下半年原本在阿里负责过多模态预训练的周畅加盟字节,虽然字节为此付出了千万级年薪,但周畅的到来迅速帮字节在多模态能力上取得突破,这是如今大爆的Seedance模型的基础。
另有业内人士告诉36氪,原智谱研究员、GLM-4.5及GLM-4.5V核心贡献者程晔安在今年加入了月之暗面,并位列K3技术报告作者名单。他的主要贡献就在Agentic Coding后训练上,而这正是智谱的强项。
对一家公司来说,当核心人才离开,损失的不只是一份劳动力,而是团队共同积累的知识——实验路径、失败记录、调试经验——被完整地交付给了竞争对手。而这种交付甚至不需要等到入职。有人从面试起就开始把团队内部是怎么做的,悄悄讲给了对家听。面试本身,成了技术细节最高频的外泄渠道。
如果掌握配方的人选择创业,也一定会成为资本的宠儿。
前商汤研究总监刘宇在多模态刚刚起步的2024年,就经历过从数据处理、训练基础设施、模型研发到产品落地的完整闭环,并且调度了超过4000张GPU来训模型。而当时,拥有千卡训练的人才都已经很稀缺。所以,当他离职创业后,投资人立刻蜂拥而上。由于找来的投资人太多,刘宇甚至大部分都只能闭门不见,以至于行业内称他为“投资圈轻易见不到的人”。
人才的流动,本身就是这一轮国内大模型公司能力竞赛中重要的一部分。“模型竞争的核心,主要是算力、数据和人。”猎头Sam告诉36氪,“能找到合适的人,算力和数据才不会白费。否则花了再多的钱也无济于事。”
这就是为什么“人”会成为AI行业竞争中的重要争夺资产。
当然,除了要找到那一小撮掌握配方的人,大模型公司还需要找大量聪明靠谱的年轻人来“剥葱扒蒜”。人才争夺战就这样全面打响了。
怪招
早两年,AI人才的高地和流失源头,原本是技术上先行一步的百度和阿里,但最近,AI人才极其充沛的字节也成为了新的“山头”和被挖对象。一位模型大厂内部人士对36氪透露,他们正在对标字节的数据体系,岗对岗地挖人,“只要挖过去,薪酬就能double”。
字节很快做出反应。2025年底,字节跳动发出全员邮件,宣布奖金和调薪投入分别提升35%和1.5倍,并启用新的职级体系,抬高了每一个职级的薪资上限。这其中职级相关的调整被认为是重点针对AI人才的举措:高薪的研究员没法塞进原有的职级框架内。
留人举措今年还在继续加码:字节只对AI相关业务员工发放的“豆包股”有了明确的标价和回购机会,并且,有豆包股的人还可以选择把自己年终奖或者总包里更多的现金换成豆包股。这就好比字节创立之初时的期权一样值钱。而这些举措或许都有一个共同的触发原因——去年一整年,Seed走掉了近70名技术骨干。
腾讯则不止舍得给钱,还舍得给职位。如姚顺雨、田永龙等硅谷的明星研究员,来到腾讯就可以直接带一个团队,甚至成为整个模型团队的负责人。有了这样的例子后,猎头在挖人的时候也有了话术:“你留在OpenAI可能就是几百个顶级研究员中的一个,你来中国大厂的话,就能做业务一号位。”
不过,钱和职位也不是一切。不少创业公司有自己的招聘“怪招”。
上海两家AI创业公司常常同时盯上同一个人。今年,这两家都看上了一位博士生,他原本已经准备接受其中一家的offer,最后却被背靠高校的另一家挖走。原因不是钱,而是对方称能给他提供“上海某大学的教职”。
智谱可能是这个“高校赛道”上的鼻祖。公司创始人兼首席科学家唐杰,以及公司的核心管理层几乎都来自清华,在这种浓厚的“学院氛围”下,不少清华学生为了读唐杰的硕士或博士,都会选择以加入智谱为敲门砖。
如果拿不出太强势的资源,HR或猎头则会采取“攻心术”。
李清供职的公司位列“大模型六小虎”之一。近段时间,他每周都会接到数通猎头电话,电话往往挑上班时间打来,对方会采用“攻心”打法——他们不着急谈岗位和薪资,而是绕着李清任职公司的股价、工作强度、他本人的健康状况这些负面话题做文章,从侧面动摇李清对当下公司的信心。
李清记得有一位猎头,每次通话都热衷于聊李清所在公司的股票。“你们公司股价跌了,要不要考虑外面的机会?xx上市以后潜力肯定更大。”
大厂有一套更为体系化的打法,我们称其为“饱和式用人”。
一位字节员工告诉36氪,Seed在一些比较核心的研究领域,一定会超出资源配置地保留两个能力相近的团队。“所以就算一个团队被竞争对手整锅端走了,另一个团队也绝对可以填上。你就算在再核心的岗位离职了,在字节也不会溅起水花。”
在猎头侧,也能感受到这种“饱和式用人”。一名猎头告诉36氪,在他承接的各家公司中,腾讯会在组建团队期间集中挖掘人才,但字节的挖人节奏几乎没有什么波动,“不管当下缺不缺人,字节都会持续性地去挖人。”
还有“釜底抽薪式挖角”。
某大厂人士告诉36氪,他们正在“定向孵化其公司的模型人才”。“我们定位了竞争对手最重要的10个人,把他们全部撬一遍。如果他们愿意跳槽过来就最好;如果不愿意过来、就鼓动他们自己创业,我们可以帮他们找投资。”
在他的描述里,这套动作是有名单、有配额的:比如,字节定位Seed最重要的10个人,逐一mapping,然后想办法接触上。跳槽是A方案,投资创业是B方案,两个方案都能达到削弱对手的目的。
VC称这种做法为“投负一轮”:在创业者还没开始创业的时候就投。一些投资人会在字节员工还在职时,就撺掇他们出来,并且帮他们搭好班子、找好第一笔钱;或者扎堆在清华、北大校门口,抓教授、聊学生,甚至投学生创业。
相比被竞对挖走,HR对于人被投资人拐跑的情况态度相对中立,“期权能绑住那些‘可能会被竞对挖走的人’,但绑不住真想创业的人。想创业的人,早晚都会出来。至少不是去给竞对添砖加瓦了。”一位投资人说。
挖角与反挖角,如今是每家AI公司HR的必修课。
一位大厂研究员告诉36氪,某些公司的HR面对想要锁定的候选人,会逐字逐句地教对方一套话术,让他用来应付别家HR。但这很多时候只是一厢情愿——因为一些新人拿到offer后,会直接用offer作为“跟下一家HR谈薪资的资本”。在两家竞争严重的公司之间,新人甚至可以直接跳过面试环节,空手套到一个涨幅。
有的AI公司把招聘搞出了“拍卖会”的感觉:新人拿到offer后,一周内入职给3个月签约奖金,两周内入职则减少到2个月签约奖金,三周以上没有奖金,这就是为了缩短新人的犹豫时间。
猎头找人的办法也在不断变化。
AI人才最大的特点之一是“隐形”,真正符合企业需求的人,往往不会把自己挂在招聘软件上。“一个普通程序员在招聘平台能搜出成千上万,但大模型的人,你找不到10个,有时候5个都找不到”。猎头裴小科说。
但这些人才也不是无迹可寻。他们的名字往往在顶会论文的作者栏里,位列GitHub的贡献者名单中,在X上的技术帖子中,许多人在个人主页上直接留了邮箱。
这代表猎头的工作方式要改变:不再筛简历、打电话,而是要读论文、发邮件。
但是要读完、读懂这些论文实在太难了,有猎头开始用AI来干这个活——用AI读论文、发邮件,对方收到的邮件都是一对一定制的:“张教授,我读了你的论文,你对多模态的理解我觉得特别有道理。”随后,这一套办法快速普及开来,所有猎头都开始这么干,研究员们的邮箱里瞬间充满了大量AI味很重的猎头邮件,小聪明迅速被识破。
“他们根本就不读我写的论文!”小红书上有很多这样的吐槽帖。
渠道被公开后立即失效,研究员们不再搭理这些邮件,猎头们不得不返璞归真,回到原始时代,靠熟人关系和线下蹲人来建联。他们蹲在清华北大门口、混迹教授与学生的圈子、跑大会、定向邀请会、闭门会、after party……凡是有人才扎堆的地方,必有猎头的身影。
大模型的知识又多又杂,到底怎么学?
做这行久了,被问最多的问题就一个:大模型的知识又多又杂,我到底先学啥?翻了一堆资料,看啥都像重点,结果啥都没学进去。今天把我自己一路摸出来的顺序捋一遍,零基础、应届生、转行的都适用。跟着走,至少方向不乱、不瞎忙,学完拿得出手。
第一阶段(10天):初阶应用
这一阶段就一个目标:把大模型真正"玩明白",不是只会聊天那种,而是能调教它、能用代码把大模型和业务接起来。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
这阶段正式进实战,目标很实在:做出两个能拿出手的东西——一个私有知识库,一个 agent 对话机器人。
-
为什么要做 RAG
-
搭建一个简单的 ChatPDF
-
检索的基础概念
-
什么是向量表示(Embeddings)
-
向量数据库与向量检索
-
基于向量检索的 RAG
-
搭建 RAG 系统的扩展知识
-
混合检索与 RAG-Fusion 简介
-
向量模型本地部署
-
…
走完这 30 天,Python 或 JavaScript 背景的基本能独立做一套 RAG 应用,简历上也敢写"大模型应用开发"了。
第三阶段(约20天):动手微调
学到这,你已经开始 “造” 模型了 —— 通过微调,搞出垂直领域的专用小模型。
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你从 “只会用” 变成 “能造” 的 AI 小子。那么你还想往下探索吗?
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方优快云官方认证二维码,即可100%免费领取全套学习资料!
第四阶段(20天):商业闭环,部署落地
技术学完,落地才算数。这阶段带你搞明白大模型怎么真正跑起来、用起来。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
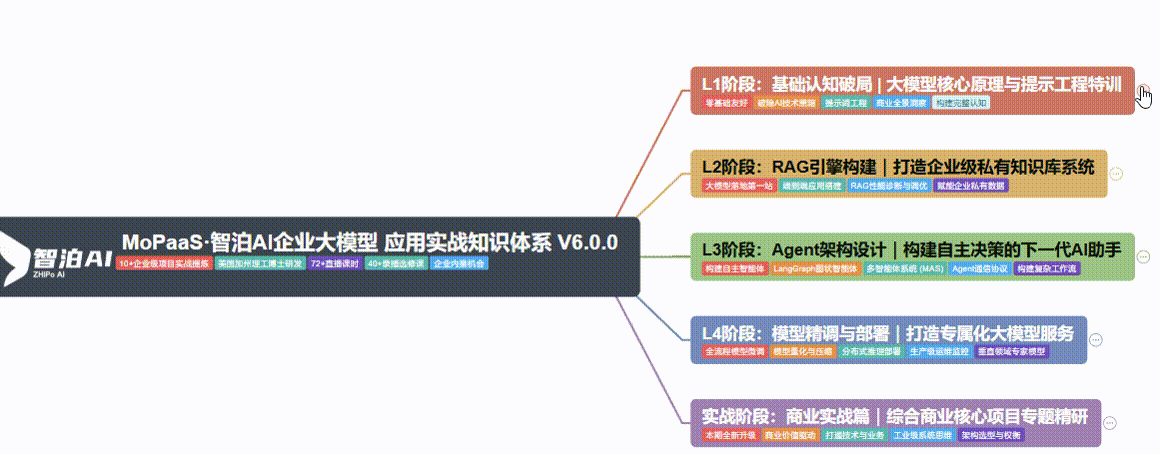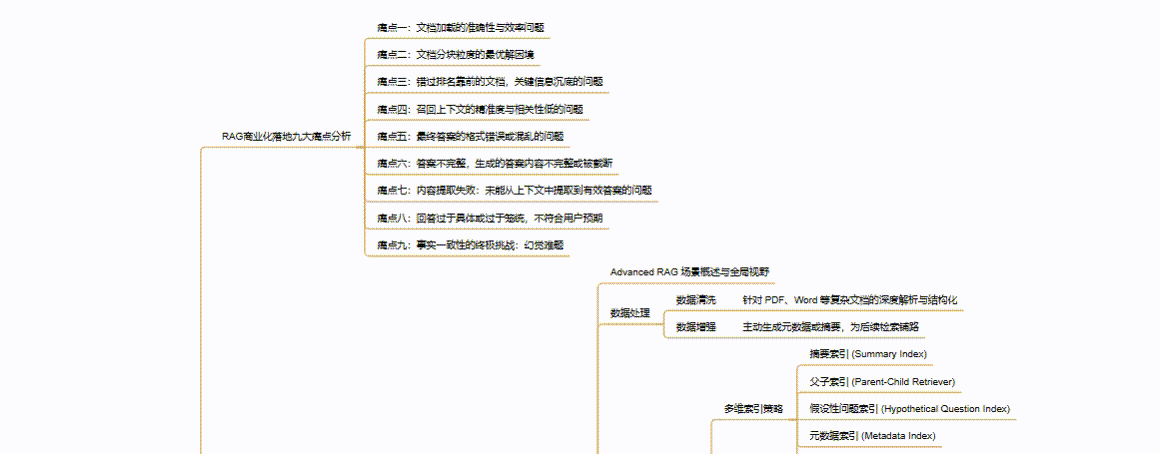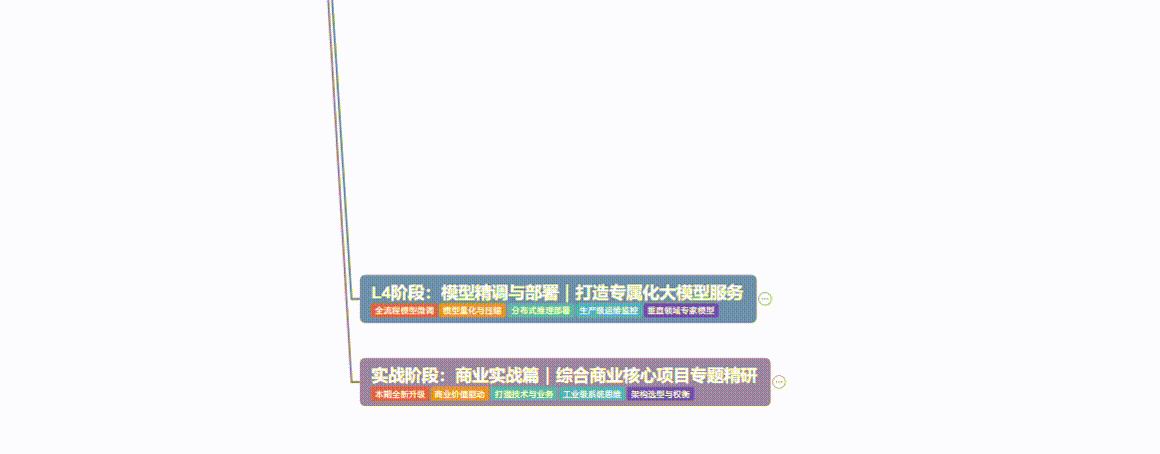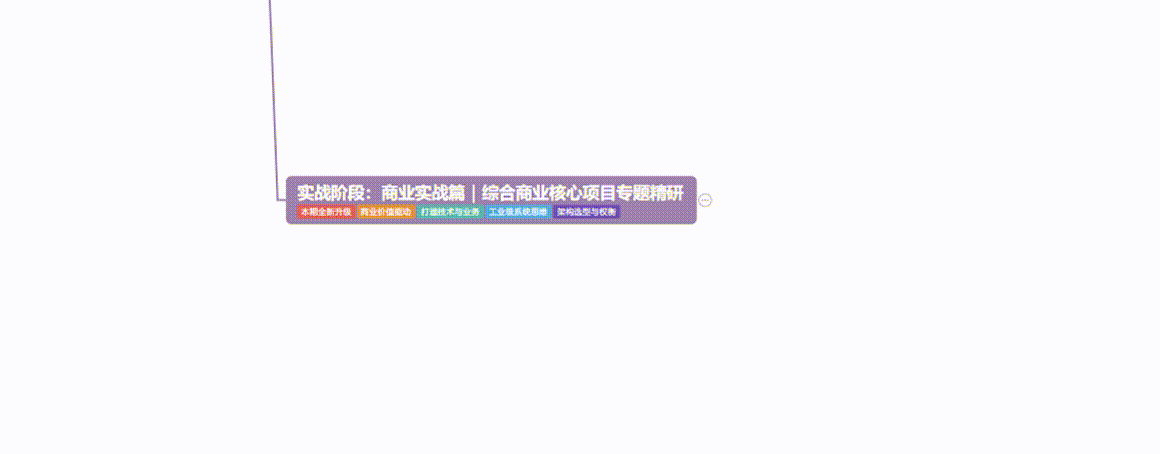
想要入坑大模型的朋友,给大家准备了一份2026 年最新 AI 大模型全套学习资料:
1、大模型系统化学习路线
2、大模型学习视频教程

3、大模型学习书籍&电子文档
4、AI大模型最新行业报告

5、大模型项目实战&配套源码

6、2026大模型大厂面试真题

7、为什么要学习大模型?
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。


8、适合谁学?
- 传统后端 / Java / 前端开发,想转型 AI 应用
- 大学生、应届生,想拿更好的 offer
- 产品经理、运营,想武装职业竞争力
- 技术负责人,想给团队落地提效
学习是反人性的,但回报是真金白银。技术会更新,赛道会切换,但只要你先动手,机会就永远站在你这边。
9、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方优快云官方认证二维码,即可100%免费领取全套学习资料!
好了,就写到这。路线是死的,人是活的,卡住了随时来问我。觉得有用就点个收藏,别让它进收藏夹吃灰——动起来比啥都强。


 扫一扫


 598

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


