


 本文面向Python背景的软件开发与数据分析师,提供6个月AI应用开发转型路径:从LLM API调用、Prompt工程、RAG检索增强、Agent构建,到多Agent协作、LLMOps部署及求职准备。强调工程化能力与业务落地,不需算法推导,聚焦大模型API集成、工具调用、向量检索、状态化工作流与生产级部署,覆盖LangChain、LangGraph、RAGAS、MCP等核心技术栈。
本文专为数据分析或软件开发背景的程序员设计,旨在引导读者顺利转型AI应用开发(大模型应用+AI应用方向)。文章强调这是过去十年程序员最友好的转型窗口期,AI应用开发不要求懂算法、论文或Transformer数学推导,而是注重调用大模型API、接入业务系统及产品实现能力,这与传统程序员的技术优势高度契合。文章提供了清晰的6个月转型路径,包括补齐Python及API调用基础、掌握Prompt工程、实现RAG检索增强、构建Agent与工具调用、开发多Agent协作及复杂工作流,最后进行LLMOps与生产部署,最终形成完整的端到端项目并准备求职。转型路径注重工程化能力、系统思维和业务理解,强调做项目的重要性,并给出实战建议,帮助读者高效学习并抓住AI应用开发的红利期。
如果你现在是做数据分析或软件开发的程序员,懂一些机器学习知识,想转AI应用开发(大模型应用+AI应用方向),这篇文章是写给你的。
我先说一个判断——这是过去10年,程序员最友好的转型窗口期。
理由很简单。AI应用开发这个岗位,2025年下半年开始爆发,2026年进入大规模招聘阶段。它有一个非常关键的特性:不卷算法、不要求写论文、不要求你懂Transformer的数学推导。它要的是【能调用大模型API、能把大模型接到业务系统里、能做出可用产品】的工程师。
这正好是传统软件开发和数据分析师的强项——工程化能力、系统思维、业务理解。
但友好不代表简单。这个转型有清晰的路径,也有大量的坑。下面我把6个月的路径,按周给你拆开。

一、先认清你要转的是什么岗位
在开始之前,必须先搞清楚一件事——AI应用开发 ≠ AI算法工程师,这是两个完全不同的岗位。
| 维度 | AI算法工程师 | AI应用开发工程师 |
|---|---|---|
| 主要工作 | 训练/微调大模型 | 调用大模型API,构建应用 |
| 核心能力 | 数学、论文、PyTorch | 工程化、系统设计、业务理解 |
| 入门门槛 | 极高(博士级) | 中等(程序员可转) |
| 招聘规模 | 小 | 大(2026年暴增) |
| 薪资 | 高但岗位少 | 25-40K,岗位多 |
| 你要转的 | 不是这个 | 是这个 |
记住这个区分。很多想转岗的人,被【AI算法】吓退了——以为要重新学数学、看论文。你要转的不是那个,是【AI应用开发】,它的核心是【用大模型做产品】,不是【造大模型】。
下面所有的路径,都是围绕【AI应用开发】这个岗位设计的。
二、6个月路径总览
先给一个全景图,后面每一步详细拆:
| 阶段 | 时间 | 目标 | 产出 |
|---|---|---|---|
| 阶段0 | 第1周 | 补Python+API调用基础 | 跑通第一个LLM调用 |
| 阶段1 | 第2-4周 | Prompt工程+大模型API | 一个能用的对话应用 |
| 阶段2 | 第5-8周 | RAG检索增强 | 一个文档问答系统 |
| 阶段3 | 第9-12周 | Agent+工具调用 | 一个能联网/查数据库的Agent |
| 阶段4 | 第13-16周 | LangGraph+多Agent | 一个复杂工作流Agent |
| 阶段5 | 第17-20周 | LLMOps+部署 | 一个生产可用的AI应用 |
| 阶段6 | 第21-24周 | 完整项目+求职 | GitHub作品集+面试准备 |
6个月,每周20-25小时投入,可以完成转型。 如果你全职投入,可以压缩到4个月;如果只能周末投入,建议拉长到8个月,但不要超过一年——这个窗口期不会一直开着。
三、阶段0:第1周——补齐基础,跑通第一个LLM调用
目标
让你亲手调通一次大模型API,看到模型返回结果。这件事看起来简单,但它是整个转型的心智门槛——很多想转的人,卡在【从来没真正跑过一次LLM】这一步。
具体操作
- 确认Python环境
AI应用开发的主流语言是Python。如果你是Java/Go/前端转过来的,先补Python。
- 不用买课,不用看视频。直接用Cursor/Claude Code/Copilot这类AI编程助手,边写边学。
- 重点掌握:函数、类、装饰器、异步(async/await)、虚拟环境、pip包管理。
- 资源:Real Python的入门教程 + 官方文档。
- 申请大模型API Key
选一个国内能直接用的:
- DeepSeek API:性价比最高,中文能力强,适合练手
- 通义千问API:阿里云生态,稳定
- Kimi API:长上下文,适合文档处理
不要一上来就用OpenAI——网络麻烦、计费复杂,会分散精力。先用国内API跑通,再考虑国际API。
- 写第一个调用脚本
from openai import OpenAI # DeepSeek兼容OpenAI SDK

client = OpenAI(
 api_key="你的key",
 base_url="https://api.deepseek.com"
)

response = client.chat.completions.create(
 model="deepseek-chat",
 messages=[
 {"role": "user", "content": "用一句话解释什么是RAG"}
 ]
)

print(response.choices[0].message.content)
跑通这个脚本,你就跨过了第一道门槛。
本周检查清单
- Python环境配置完成,虚拟环境会用
- 申请到至少一个国内大模型API Key
- 写出第一个调用脚本,看到模型返回
- 用Cursor或Claude Code作为日常编程助手
四、阶段1:第2-4周——Prompt工程+大模型API深入
目标
理解Prompt是AI应用开发的核心技能,掌握结构化Prompt、Few-shot、思维链等技巧,能做出一个能用的对话应用。
为什么这一步这么重要
很多人对Prompt工程有偏见,觉得是【玄学】。但在AI应用开发里,Prompt就是你最常写的代码。一个AI应用的质量,70%取决于Prompt设计,30%取决于工程实现。
具体操作
第2周:Prompt基础
学完这些概念,并且每个都手写一遍:
- Zero-shot / Few-shot Prompting
- 角色设定(System Message)
- 结构化输出(让模型返回JSON)
- 思维链(CoT, Chain of Thought)
- 多轮对话的状态管理
资源:
- OpenAI Prompt Engineering指南
- DeepSeek官方Prompt指南
第3周:函数调用(Function Calling / Tool Calling)
这是Agent的底层能力,必须吃透。学会让模型:
- 判断什么时候需要调用外部工具
- 生成结构化的调用参数
- 处理工具返回结果,继续对话
每个大模型API都有Function Calling文档,跟着写一遍。
第4周:做一个完整应用
做一个【智能助手】,要求:
- 多轮对话(带历史)
- 能调用一个简单工具(比如查天气、算数学)
- 用Streamlit或Gradio做Web界面
不要跳过Web界面这一步——有界面的应用,才能让你直观感受产品形态。Streamlit 50行代码就能做出一个能用的Web界面。
本周检查清单
- 能写出结构化Prompt,让模型稳定输出JSON
- 跑通Function Calling,理解工具调用流程
- 用Streamlit做出一个对话+工具调用的Web应用
- 把这个项目传到GitHub
五、阶段2:第5-8周——RAG检索增强生成
目标
掌握RAG全套技术,做出一个能对PDF/文档库问答的系统。这是AI应用开发岗位的硬技能,面试必考。
为什么RAG是核心
企业做AI应用,80%的需求都是【让大模型基于我们自己的文档/知识库回答问题】——客服系统、文档助手、法律咨询、医疗问诊,本质都是RAG。你能不能找到工作,很大程度取决于RAG做得好不好。
具体操作
第5周:RAG基础
- 理解RAG的完整流程:文档加载 → 切分 → Embedding → 入向量库 → 检索 → 拼接Prompt → 生成
- 学会用LangChain的基础RAG组件
- 跑通一个最简单的Naive RAG
技术栈:
- Embedding模型:国内用BGE-m3或通义的text-embedding-v3
- 向量数据库:先用Chroma(本地、简单),后期换Milvus或Pinecone
- 文档加载:LangChain的DocumentLoader
第6周:高级RAG——切分与检索优化
Naive RAG在真实场景一定会崩。你需要学:
- 智能切分:RecursiveCharacterTextSplitter vs 语义切分 vs 基于标题切分
- 多路召回:向量检索 + BM25关键词检索 + 重排(Rerank)
- 查询改写:把用户问题改写成更适合检索的形式
- Parent-Child检索:小块检索,大块返回
这一周的技术深度最大,但也是面试官最看重的部分。
第7周:RAG工程化
- 接入真实文档库(找一批PDF/网页测试)
- 加缓存(Semantic Cache,相似问题不重复检索)
- 加引用标注(让模型回答时标出来源)
- 评估RAG质量(RAGAS框架,做检索准确率和生成质量评估)
第8周:RAG项目完成
做一个【企业知识库问答系统】:
- 上传PDF/Word/网页
- 自动建索引
- 用户提问,系统检索+生成+标注来源
- Web界面用Streamlit
这个项目要写进简历——它是AI应用开发岗位最有说服力的作品。
本周检查清单
- 跑通Naive RAG,理解完整流程
- 实现高级RAG:多路召回+Rerank+查询改写
- 用RAGAS评估系统质量
- 完成企业知识库问答项目,上传GitHub
六、阶段3:第9-12周——Agent与工具调用
目标
掌握Agent架构,做出能联网搜索、查数据库、调用API的智能体。这是2026年最热的方向,薪资溢价最高。
为什么Agent是高薪核心
RAG解决的是【大模型不懂你的私有知识】,Agent解决的是【大模型不能行动】。一个会查数据库、会发邮件、会调用业务系统的Agent,价值远超一个只会问答的RAG系统。
2026年AI应用开发岗位的招聘JD里,Agent是出现频率最高的关键词。
具体操作
第9周:Agent基础概念
- ReAct模式(Reasoning + Acting)
- Plan-and-Execute模式
- 理解Agent = LLM + Tools + Memory + Planning
资源:Lilian Weng的Agent综述——这篇是Agent领域的奠基性文章,必读。
第10周:LangChain Agent
- 用LangChain的Agent能力,实现:
-
联网搜索(Tavily/SerpAPI)
-
查数据库(SQLDatabaseChain)
-
调用自定义工具(自己写Python函数包装成Tool)
第11周:深入LangGraph
LangGraph是2026年Agent开发的事实标准框架,必须掌握。 它和LangChain的关系是——LangChain是组件库,LangGraph是编排框架,用来构建有状态的复杂Agent。
学LangGraph的:
- StateGraph(状态图)基础
- 节点(Node)和边(Edge)
- 条件分支
- 人工介入(Human-in-the-loop)
- 持久化(Checkpoint)
第12周:Agent项目
做一个【数据分析助手Agent】:
- 用户用自然语言提问【上个月华东区销售额最高的产品是什么】
- Agent自动:连接数据库 → 生成SQL → 执行 → 分析结果 → 生成报告
- 用Streamlit做界面
这个项目对标的是企业真实的BI+AI场景,非常有说服力。
本周检查清单
- 理解ReAct和Plan-and-Execute两种Agent模式
- 用LangChain做出会调用工具的Agent
- 用LangGraph构建有状态的Agent
- 完成数据分析助手Agent项目
七、阶段4:第13-16周——多Agent协作+复杂工作流
目标
掌握多Agent协作,能构建复杂工作流。这是中高级AI应用开发的分水岭。
具体操作
第13周:多Agent架构
- 学CrewAI / AutoGen / LangGraph的多Agent模式
- 理解Supervisor-Worker模式、Hierarchical模式
- 实战:做一个【内容生产流水线】——一个Agent负责选题,一个负责写稿,一个负责审核,一个负责排版
第14周:Memory与长期记忆
- 短期记忆(对话内)
- 长期记忆(用向量库存储)
- 事件记忆(Episodic Memory)
- 语义记忆(Semantic Memory)
- 工具:Mem0、Letta(原MemGPT)
第15周:复杂工作流实战
做一个【研究报告生成Agent】:
- 给定一个主题
- Agent自动:拆解子问题 → 分配给多个研究Agent → 各自搜索+整理 → 汇总 → 生成结构化报告
- 这对标的是咨询/研究机构的真实工作流
第16周:MCP协议
MCP(Model Context Protocol)是2025年底Anthropic推出的开放协议,2026年成为Agent连接外部工具的事实标准。学会MCP,你会比80%的候选人更值钱。
- 理解MCP的Server/Client架构
- 写一个MCP Server(包装你的工具,让任何Agent都能调用)
- 集成现有的MCP Server(GitHub/数据库/搜索等)
本周检查清单
- 能用LangGraph构建多Agent协作系统
- 实现长期记忆功能
- 完成研究报告Agent项目
- 写过至少一个MCP Server
八、阶段5:第17-20周——LLMOps与生产部署
目标
学会把AI应用从Demo变成生产级系统。这是初级和中级工程师的分水岭,也是面试加分项。
为什么这一步容易被忽略
很多转岗的人,做完Demo就停了。但企业要的是能上线、能维护、能监控的系统。LLMOps就是AI时代的DevOps,是把你从【会做Demo】提升到【能交付产品】的关键。
具体操作
第17周:模型层运维
- 模型路由:不同任务调用不同模型(贵模型处理复杂任务,便宜模型处理简单任务)
- 限流与重试
- Token成本监控与优化
- 用LiteLLM做统一API网关
第18周:应用层运维
- 用Docker容器化你的AI应用
- 用FastAPI把AI应用做成API服务
- 加监控(Prometheus + Grafana)——监控:响应时间、Token消耗、错误率、用户满意度
- 加日志结构化日志,方便追溯
第19周:评估与测试
- 做Golden Set——一批标准问答对,定期回归测试
- 用LangSmith / Langfuse做Trace和评估
- A/B测试不同Prompt/模型的效果
第20周:完整生产级应用
把前面阶段2/3/4做的项目,升级成生产级:
- 容器化部署
- 接入监控
- 加评估体系
- 写技术文档
本周检查清单
- 用Docker+FastAPI部署AI应用
- 接入监控和日志
- 搭建评估体系
- 完成一个生产级AI应用项目
九、阶段6:第21-24周——完整项目+求职
目标
把前面学的整合成一个有说服力的作品集,开始投简历、面试。
具体操作
第21-22周:做一个端到端的【杀手级项目】
选一个有真实业务价值的项目,完整做出来。建议方向:
| 方向 | 项目示例 | 适配行业 |
|---|---|---|
| 企业知识库 | 法律/医疗/HR文档问答 | 任意企业 |
| 数据分析助手 | 自然语言查询数据库+生成报告 | 金融/电商/咨询 |
| 工作流自动化 | 邮件分类+回复+跟进 | 客服/销售 |
| 多模态应用 | 图像理解+文档解析 | 制造/医疗 |
杀手级项目的标准:
- 解决真实问题(不是玩具)
- 用了RAG + Agent + LLMOps全套技术
- 有Web界面,能演示
- GitHub有完整README+架构图+部署文档
第23周:简历+作品集整理
- 简历重写:把传统开发经验,重新用AI视角描述(比如【做了数据处理系统】改成【构建了数据Pipeline,为后续RAG检索提供基础】)
- GitHub Profile整理:每个项目有清晰README
- 写1-2篇技术博客(掘金/知乎/优快云),讲你的项目
第24周:面试准备
AI应用开发面试的高频考点:
技术面:
- RAG的完整流程,每个环节的优化点
- Agent的ReAct模式,怎么避免死循环
- 怎么评估一个AI应用的质量
- Token成本怎么优化
- 多Agent协作的几种模式
- MCP协议是什么
项目面:
- 你的项目架构是什么,为什么这么设计
- 遇到过什么坑,怎么解决的
- 如果用户量上到10万,你的系统怎么扩展
业务面:
- 你怎么看AI应用在企业落地的最大障碍
- 哪些场景适合AI,哪些不适合
本周检查清单
- 完成端到端杀手级项目
- 简历重写,GitHub整理
- 发2篇技术博客
- 面试高频考点准备完毕
- 开始投简历
十、给转型者的5条实战建议
建议1:不要追求【把所有框架都学一遍】
LangChain、LangGraph、LlamaIndex、CrewAI、AutoGen、Dify、Coze——框架太多,你不可能都学。选一个主线深耕,其他了解即可。 推荐主线:LangChain(基础) → LangGraph(进阶) → 自研框架(高阶)。能把一条线打穿,比十个框架都皮毛强十倍。
建议2:不要跳过【原理】只学API
很多人直接上LangChain,用得挺顺,但一遇真实场景就崩——RAG检索不准、Agent死循环、模型瞎编。根本原因是不懂原理。
每个API背后都是一篇论文/一套设计思想。Function Calling背后的设计、Embedding的原理、Attention机制的大致逻辑——这些不必深挖到数学,但要知道它【为什么这么设计】。懂原理的人,Debug能力是学API的人的10倍。
建议3:用AI编程助手加速,但别依赖到不会写
Cursor、Claude Code、GitHub Copilot——这些工具能让你的学习效率翻倍。但有个陷阱——如果你完全依赖AI生成代码,自己不看,3个月后你会发现【自己什么都写不出来】。
正确用法:让AI帮你写样板代码,核心逻辑自己写;让AI帮你Debug,但要理解为什么这么修。你的目标是成为【能驾驭AI的工程师】,不是【被AI替代的工程师】。
建议4:做项目 > 看视频 > 读书
AI领域变化太快,书出版时已经过时。视频相对快,但被动学习吸收率低。最高效的学习方式是做项目——遇到问题查文档、问AI、看源码,这种主动学习的吸收率是看视频的5倍。
每周必须有代码产出,不允许【只看不写】。
建议5:关注3个方向,警惕2个陷阱
值得All in的方向:
- Agent——2026-2027年最大红利,薪资溢价最高
- RAG——企业刚需,岗位最多
- MCP——新兴协议,会的人少,稀缺性强
要警惕的陷阱:
- 微调大模型——除非你去算法岗,否则不要碰。企业级AI应用90%不需要微调,Prompt+RAG+Agent就够
- 从0学PyTorch+训练模型——同理,这是算法工程师的活,不是应用开发的活
写在最后
这个转型路径,本质是从【业务逻辑实现者】升级为【智能工作流设计者】。
你过去写SQL、做数据处理、做后端开发积累的工程能力,在AI应用开发里全部用得上——而且是大优势。算法工程师做不出来的产品,你能做出来;你做不出来的模型,他们能训练。这两个岗位是互补的,不是竞争的。
6个月看起来不短,但其实很快。每周稳定20小时,6个月就是520小时,足够你从【没调过LLM API】走到【能独立交付AI应用】。
唯一的风险是——这个窗口期不会一直开着。2026年是转型黄金期,2027年岗位饱和、门槛提高,转型难度会显著上升。
所以如果你真想转,今天就跑通第一个LLM调用。不要等明天,不要等周末,不要等【学完Python再说】。这一步迈出去,后面才有意义。
大模型的知识又多又杂,到底怎么学?
做这行久了,被问最多的问题就一个:大模型的知识又多又杂,我到底先学啥?翻了一堆资料,看啥都像重点,结果啥都没学进去。今天把我自己一路摸出来的顺序捋一遍,零基础、应届生、转行的都适用。跟着走,至少方向不乱、不瞎忙,学完拿得出手。
第一阶段(10天):初阶应用
这一阶段就一个目标:把大模型真正"玩明白",不是只会聊天那种,而是能调教它、能用代码把大模型和业务接起来。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
这阶段正式进实战,目标很实在:做出两个能拿出手的东西——一个私有知识库,一个 agent 对话机器人。
-
为什么要做 RAG
-
搭建一个简单的 ChatPDF
-
检索的基础概念
-
什么是向量表示(Embeddings)
-
向量数据库与向量检索
-
基于向量检索的 RAG
-
搭建 RAG 系统的扩展知识
-
混合检索与 RAG-Fusion 简介
-
向量模型本地部署
-
…
走完这 30 天,Python 或 JavaScript 背景的基本能独立做一套 RAG 应用,简历上也敢写"大模型应用开发"了。
第三阶段(约20天):动手微调
学到这,你已经开始 “造” 模型了 —— 通过微调,搞出垂直领域的专用小模型。
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你从 “只会用” 变成 “能造” 的 AI 小子。那么你还想往下探索吗?
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方优快云官方认证二维码,即可100%免费领取全套学习资料!
第四阶段(20天):商业闭环,部署落地
技术学完,落地才算数。这阶段带你搞明白大模型怎么真正跑起来、用起来。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
想要入坑大模型的朋友,给大家准备了一份2026 年最新 AI 大模型全套学习资料:
1、大模型系统化学习路线
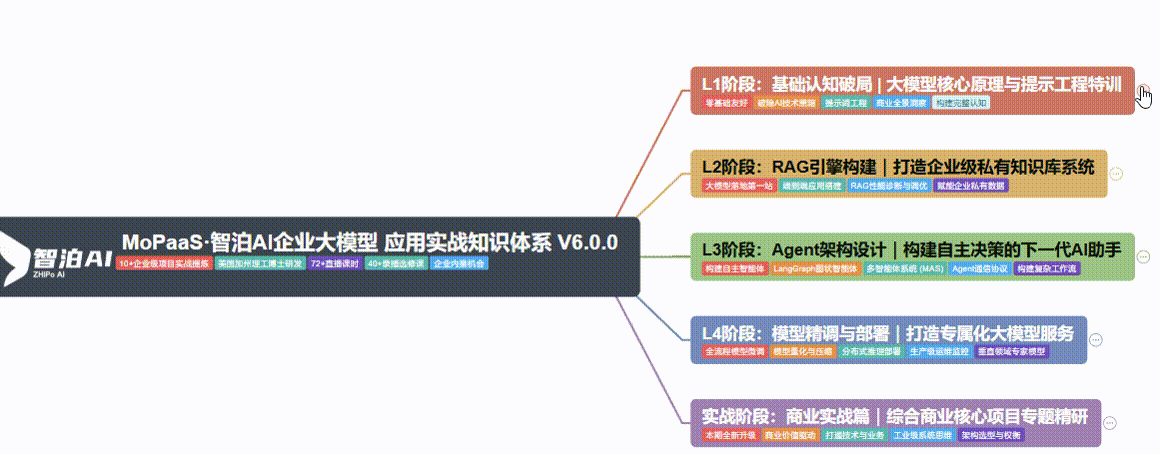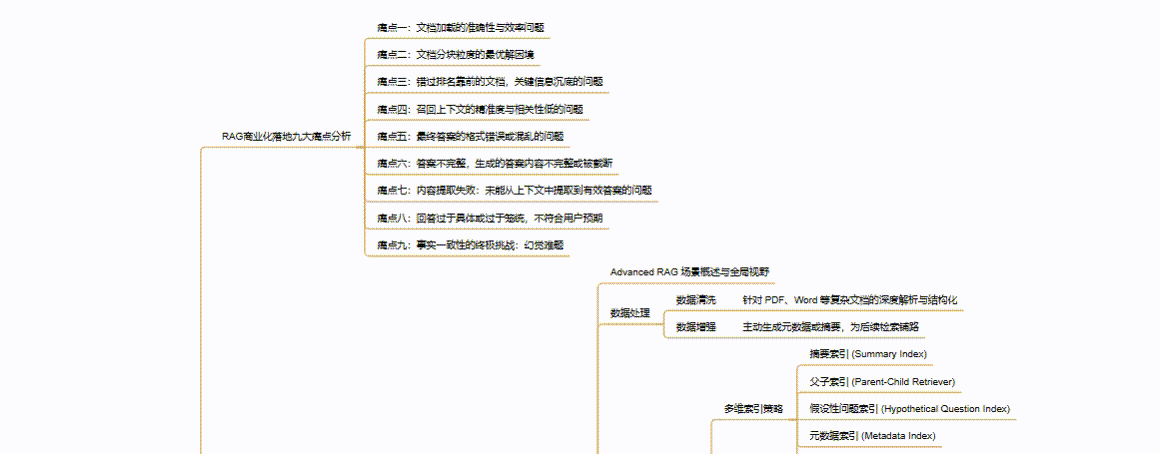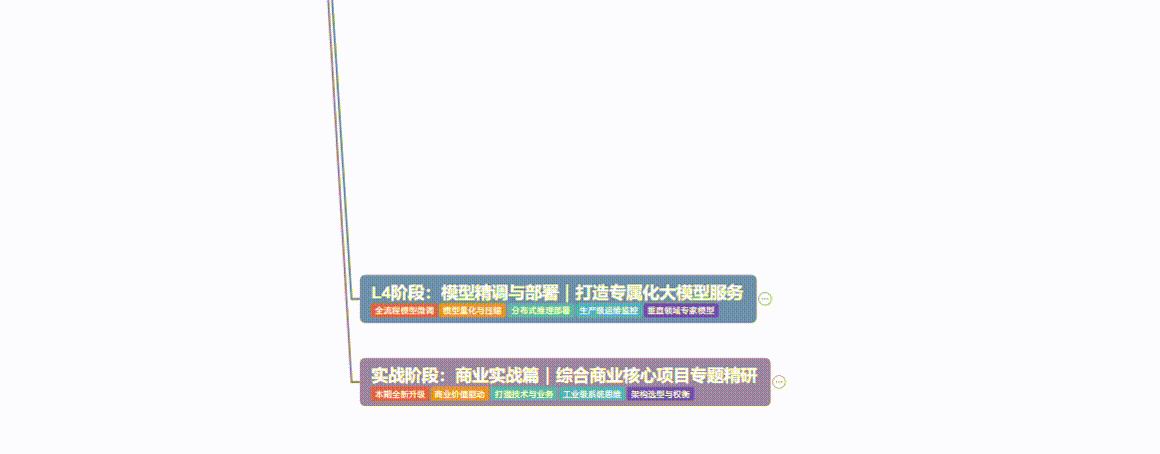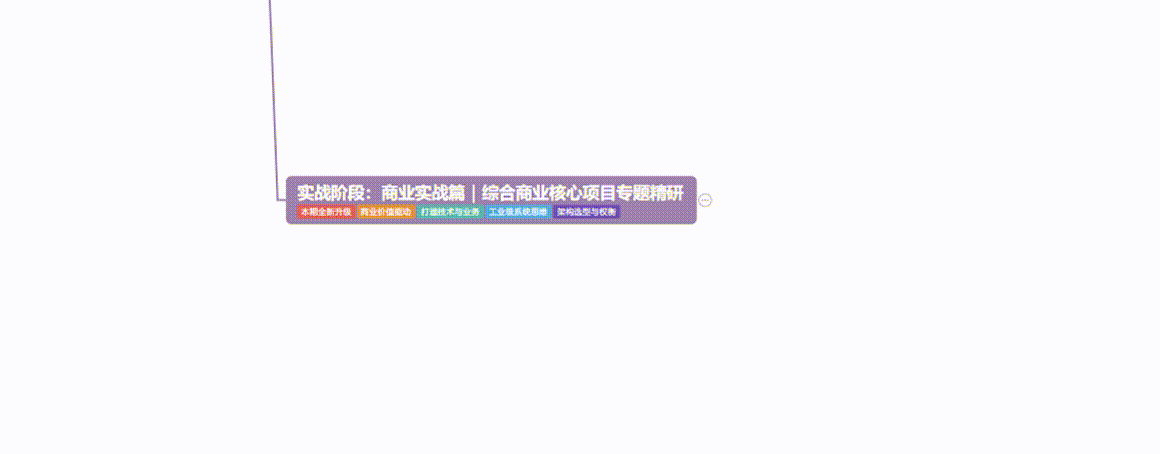
2、大模型学习视频教程

3、大模型学习书籍&电子文档
4、AI大模型最新行业报告

5、大模型项目实战&配套源码

6、2026大模型大厂面试真题

7、为什么要学习大模型?
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。


8、适合谁学?
- 传统后端 / Java / 前端开发,想转型 AI 应用
- 大学生、应届生,想拿更好的 offer
- 产品经理、运营,想武装职业竞争力
- 技术负责人,想给团队落地提效
学习是反人性的,但回报是真金白银。技术会更新,赛道会切换,但只要你先动手,机会就永远站在你这边。
9、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方优快云官方认证二维码,即可100%免费领取全套学习资料!
好了,就写到这。路线是死的,人是活的,卡住了随时来问我。觉得有用就点个收藏,别让它进收藏夹吃灰——动起来比啥都强。


 扫一扫


 362

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


