


 本文系统阐述RAG(检索增强生成)技术原理与工业级实现,聚焦两大核心流水线:文档处理流水线(含多格式解析、智能切片、去重、双写存储)和检索流水线(含向量检索、BM25全文检索、RRF混合融合、Cross-encoder重排序及结果后处理)。深入剖析两级切分策略、责任链与策略模式在架构中的应用,并强调向量+关键词混合检索、粗排+精排范式等关键技术要点。
本文深入解析了RAG(检索增强生成)技术,阐述了为何需要RAG以解决大模型在知识更新、幻觉问题和私有数据访问上的局限。文章详细介绍了RAG的双流水线架构:文档处理流水线(含多格式解析、智能切片、去重机制、双写存储等)和检索流水线(含加载配置、向量检索、BM25全文检索、混合融合、重排序、结果后处理等)。同时,文章还梳理了构建RAG系统的技术栈,并提出了架构设计的关键要点,如责任链模式、策略模式加模板方法、统一存储抽象和全链路耗时监控。最后,展望了RAG技术的未来发展方向,如Graph RAG、Agentic RAG、Multi-modal RAG等。
一、为什么需要 RAG?
先问一个问题:你让 ChatGPT 写一篇关于你公司最新产品的介绍,它能写得出来吗?
答案是不能。原因很简单:
-
1. 知识截止:大模型的训练数据是有截止日期的,你的新产品它根本没见过
-
2. 幻觉问题:即使它知道,也可能胡编乱造,把 A 产品的特性安到 B 产品上
-
3. 无法访问私有数据:你的内部文档、数据库、企业知识库,大模型根本看不到
那怎么办?有两个主流方案:
- Fine-tuning(微调):用你的数据再训练一遍模型。成本高、周期长,而且模型可能会"学忘"了原有的能力
- RAG(检索增强生成):在回答前先去知识库里检索相关信息,然后让模型基于检索结果生成答案
RAG 的核心思想可以用一句话概括:先检索,再回答。
打个比方:这就好比给大模型配了一个专属图书馆管理员。每次有人来问问题,管理员先去书架上翻阅几本相关的书,找到答案所在的页面,然后把书摆在模型面前,让模型翻着书来回答。这样一来,答案既有依据,又不会跑偏。
相比微调,RAG 的优势非常明显:
- 实时更新:知识库里加一份新文档,马上就能检索到,无需重新训练
- 成本低廉:不需要昂贵的 GPU 算力去训练模型
- 可解释性强:可以追溯答案来自哪份文档,出了问题能追责
- 幻觉可控:回答有据可依,模型编造的空间大大减少
这篇文章会从一个工业级 RAG 系统的真实架构出发,带你完整理解 RAG 的工作原理和技术细节。
二、RAG 的两条核心流水线
一个完整的 RAG 系统,可以抽象为两条独立的流水线:

文档处理流水线负责"喂数据"——把各种格式的文档(PDF、Word、Excel 等)解析成纯文本,切成合适大小的小块,然后向量化后存入知识库。
检索流水线负责"找答案"——用户提问时,从知识库中找出最相关的内容片段,交给大模型去生成回答。
两条流水线配合,就构成了完整的 RAG 闭环。下面我们逐条拆解。
三、文档处理流水线详解
文档处理流水线是 RAG 系统的"入口",它的工作就是把杂乱无章的原始文档,变成结构化的、可检索的知识库。
3.1 多格式文档解析
现实世界中的文档格式五花八门:PDF、Word、Excel、HTML、Markdown、纯文本……每种格式的解析方式都不同。
一个成熟的 RAG 系统通常会通过策略模式来应对——为每种格式定义一个解析器,它们实现同一个接口,系统根据文件类型自动选择对应的解析器:
| 文档格式 | 底层解析技术 |
|---|---|
| PDF(.pdf) | Apache PDFBox |
| Word(.docx) | Apache POI |
| Excel(.xlsx / .xls) | Apache POI |
| 网页(.html) | HTML 解析器 |
| Markdown(.md) | Markdown 解析器 |
| 纯文本(.txt) | 直接读取 |
这一层的目标很简单:把各种非结构化文档,统一转化为纯文本。只有转成纯文本,后续才能进行切片和向量化。
3.2 智能文档切片(核心)
解析完成后得到了一篇完整的文本。但大模型有上下文窗口限制——比如一次只能处理几千到几万个 token。你不能把整本《三体》直接塞进去。
所以需要把长文档切成小块。这些小块就是 Chunk(切片)。
切片是个看似简单、实则很有讲究的步骤。切得太碎,上下文不连贯;切得太粗,一块可能超限。一个工业级 RAG 系统通常采用两级切分的设计来兼顾语义完整性和长度约束:先用策略做粗粒度切分(分出段落),再对每个段落做细粒度递归切分(确保每块长度合规)。每个最终 chunk 都会携带来源段落(paragraphIndex)和段内序号(chunkIndex)两个标记。
下面先介绍一级切分的四种策略,再说明二级递归切分的逻辑。
3.2.1 四种切分策略
一级切分有四种策略可选,每种策略关注不同的"语义边界":
- 按长度切分:最简单的兜底方案,整篇作为一个段落送入二级切分,适用于结构不明确的文档。
- 按分隔符切分:按自然分隔符(如换行符、句号)切分,尊重原文段落结构,是最常用的策略。
- 按正则切分:按自定义正则表达式切分,适合处理有明确格式的文档(如日志、代码文件)。
- 智能语义切分:调用大语言模型按语义话题边界切分,效果最好但成本最高,适用于结构复杂的文档。
3.2.2 二级递归切分
无论一级切分使用了哪种策略,每个一级段落都会进入同一切分流程:若 token 数不超过 maxTokens,直接作为一个 chunk;若超过,则递归切割直到每块合规。相邻 chunk 之间保留 overlap 个 token 的重叠,避免语义断裂。典型参数为 maxTokens=500、overlap=50。
3.2.3 两级切分的关系总结

两级切分的定位可以这样理解:
- 一级切分是"战略层":决定按什么逻辑拆分文档——是按自然段落?按句子?按语义话题?还是不做拆分?
- 二级切分是"执行层":确保每个 chunk 的长度不超过 maxTokens,同时通过 overlap 保持上下文连贯性
两级切分的组合关系是通过模板方法模式实现的——抽象基类定义了"先一级切分、再对每个段落执行二级切分"的骨架,子类只需实现一级切分的具体逻辑。典型参数为 maxTokens=500、overlap=50。
3.3 去重机制
同一份文档可能被不同的人多次上传到知识库。如果不做去重,知识库里就会充满重复内容,不仅浪费存储空间,还会影响检索效果。
RAG 系统通常会内置多种去重策略:
| 去重策略 | 行为说明 |
|---|---|
| 不去重 | 允许重复上传 |
| 按文件名去重 | 同一知识库中文件名相同即视为重复 |
| 按内容去重 | 通过 SHA-256 对内容做哈希,相同哈希值视为重复 |
| 文件名或内容去重 | 上述两者任一命中即重复 |
命中重复后怎么处理?通常有三种动作:
| 动作 | 行为 |
|---|---|
| 拒收 | 直接拒绝,并提示用户文件已存在 |
| 跳过 | 静默忽略,不报错 |
| 覆盖 | 删除旧文档(包括它的所有切片和向量),重新处理新文档 |
此外,在向量化阶段还可以做更细粒度的去重:如果某一段文本的内容哈希值在知识库中已经存在,就直接复用之前生成的向量,不再重复调用嵌入模型。这一步能有效节省 API 调用成本。
3.4 双写存储——关键设计
切片完成后,系统会执行一个非常关键的操作——双写(Dual Write):

为什么需要双写? 这就要理解两种检索方式的差异了:
- 向量检索(语义搜索):擅长"意会"。搜索"我想买手机",它能找到"iPhone 15 Pro 评测"——虽然关键词不同,但语义相近
- BM25 全文检索(关键词搜索):擅长"言传"。搜索"华为 Mate60",它会精确命中包含"华为 Mate60"这个关键词的文档
日常使用中,用户可能用语义模糊的表达,也可能用精确的关键词。两份结果融合在一起,效果远胜单一方案。
值得注意的是,向量存储和搜索引擎的写入是解耦的——可以同时开启,也可以只用向量存储。对于成本敏感的场景,只开向量存储也能获得不错的检索效果。
四、检索流水线详解
文档处理好了,知识库建起来了。现在来到最核心的问题:用户提问时,怎么从海量的 Chunks 中找出最相关的那几个?
一个工业级的检索流水线,通常不会只做一次向量搜索就完事。它会像工厂流水线一样,经过多个环节的层层筛选:
┌─────────────────────────────────────────────────────────────┐
│                       检索流水线                              │
│                                                             │
│  1. 加载知识库配置     ─── 读取搜索参数、模型参数等            │
│  2. 查询改写(可选)   ─── 优化用户查询(预留扩展)           │
│  3. 向量检索           ─── 语义搜索,粗筛候选结果             │
│  4. BM25 全文检索      ─── 关键词搜索,补充结果              │
│  5. 混合融合           ─── 合并两份结果,取长补短             │
│  6. 重排序             ─── 精细排序,精筛最优结果             │
│  7. 结果后处理         ─── 补充信息、扩展上下文              │
└─────────────────────────────────────────────────────────────┘
每个环节用一个独立的"处理器"来实现,这样每个环节可以独立开发、独立测试、独立开关。下面逐一分析。
4.1 准备阶段:加载配置
流水线的第一步是加载知识库的完整配置。一个知识库除了文档数据外,还包含大量控制检索行为的参数:
- 搜索参数:每页返回多少条结果、是否启用阈值过滤、阈值分数等
- 模型参数:用哪个嵌入模型做向量化、用哪个重排序模型等
- 切片参数:前面提到的 maxTokens、overlap 等
- 存储配置:使用哪个向量数据库实例、是否启用搜索引擎等
这些参数决定了后续流水线怎么跑。比如配置了 threshold=0.7,那么得分低于 0.7 的检索结果会被直接丢弃。
4.2 第一轮筛选:向量检索
这是检索流水线中最核心的一步。当用户输入查询后,系统会做以下事情:
-
1. 根据知识库配置,创建对应的向量存储实例(ES 或 Milvus 或 PGVector)
-
2. 构建索引名(通常格式为
rag_{知识库ID}) -
3. 调用嵌入模型,将用户查询也转化为向量
-
4. 在向量数据库中搜索与查询向量最相似的前 N 条结果
// 以下是向量检索的核心逻辑(伪代码)
List<SearchResult> search(String query, KnowledgeBase kb) {
    // 1. 创建向量存储实例
    VectorStore store = createVectorStore(kb);

    // 2. 构建索引名
    String indexName = "rag_" + kb.getId();

    // 3. 执行向量相似性搜索
    // topK 通常取最终需要的数量 × 2
    List<SearchResult> results = store.search(indexName, query, topK = resultCount * 2);

    // 4. 按阈值过滤,去掉低分结果
    return filterByThreshold(results, kb.getThreshold());
}
这里有一个重要细节:topK 通常会取最终需要数量的一倍。比如用户想看 5 条结果,系统会先取 10 条候选。为什么?因为后面还有融合和重排序步骤,多准备一些候选供进一步筛选。
当前主流的向量数据库对比:
| 向量数据库 | 相似度计算 | 索引算法 | 连接方式 |
|---|---|---|---|
| Elasticsearch | 余弦相似度 / 点积 / L2 | HNSW | REST API |
| Milvus | 余弦相似度 / L2 / 内积 | IVF_FLAT / HNSW / AUTOINDEX | gRPC |
| PostgreSQL (pgvector) | 余弦相似度 / L2 / 内积 | HNSW | JDBC |
选哪个?看你的场景。如果团队已经用了 ES,直接基于 ES 做向量检索是最省事的;如果对性能要求极高,Milvus 专为向量检索而生;如果追求简单运维,pgvector 作为 PG 扩展最轻量。
4.3 第二轮筛选:BM25 全文检索
向量检索跑完一轮后,如果知识库配置了搜索引擎,系统还会并行执行一次 BM25 全文检索。
BM25 是一种经典的文本检索算法,它计算查询词在文档中的出现频率(TF)和逆文档频率(IDF),给每个文档打分。简单说就是:查询词出现得越多、这个词越稀有,得分越高。
为什么要额外做 BM25?来看个例子:
用户搜索:“2024年iPhone销量”
- 向量检索能理解"iPhone"和"苹果手机"是同义词,能召回语义相似的内容
- BM25 检索能精确命中包含"2024年"和"iPhone 销量"这两个完整短语的文档
两者各有千秋,合并使用效果最好。
对于中文场景,全文检索需要特别处理分词问题。中文不像英文用空格分词,所以需要用专门的分词器。Elasticsearch 提供了 CJK 分析器(支持中文、日文、韩文),用 Bigram 二元分词的方式来处理——比如"中华人民共和国"会被切分为"中华"、“华人”、“人民”、“民共”、“共和”、“和国”。
4.4 合并结果:混合融合
向量检索有了一份结果,BM25 也有一份,现在要把两份合并成一份更好的结果。
常用的融合算法有两种:
RRF(倒数排名融合)——最常用的方案
RRF 的原理很简单:不看具体分数,只看排名。它的计算公式是:
对每条结果,最终得分 = 1 / (k + 排名)
其中 k 是一个常数,默认 60。
举个例子:某条结果在向量检索中排第 2 名,得分为 1/(60+2) ≈ 0.016;在 BM25 中排第 5 名,得分为 1/(60+5) ≈ 0.015。那它的最终得分就是 0.016 + 0.015 = 0.031。
如果某条结果在两个列表中都出现,它的总分就会更高。如果只出现在一个列表中,也能拿到相应分数。
RRF 的优势在于不需要调权重参数,对排名敏感而非分数敏感,鲁棒性很好。
加权和融合——另一个可选方案
先分别对向量分数和 BM25 分数做归一化(映射到 0-1 之间),然后按权重加权求和:
最终得分 = α × 向量得分(归一化) + β × BM25 得分(归一化)
α 和 β 的权重可以根据业务场景调整。比如对语义匹配要求高,可以设 α = 0.7, β = 0.3。
4.5 精筛:重排序
经过混合融合后,结果质量已经不错了。但系统中还可能有一道"精细工序"——重排序。
向量检索和 BM25 都是"粗排"阶段,用轻量级模型快速从海量数据中筛选出候选集。重排序阶段则使用 Cross-encoder 模型,对查询和文档的配对进行更精细的相关性评分:

Cross-encoder 和向量检索的区别在于:
- 向量检索(Bi-encoder):把查询和文档分别编码成向量,然后计算余弦相似度。速度快,可以预计算。
- 重排序(Cross-encoder):把查询和文档拼接在一起输入模型,让模型直接输出相关性分数。精度高,但速度慢。
所以重排序只会对前几十条结果执行,不会对整个知识库做。这是一个经典的"粗排 + 精排"两阶段策略。
如果重排序 API 调用失败(比如模型服务挂了),系统需要有降级策略——直接按融合后的 score 排序返回。
4.6 收尾:结果后处理
最后一步是结果后处理,主要做三件事:
-
1. 数据富化:从数据库补充缺失的信息,比如文档名称、完整内容等
-
2. 相邻切片扩展:如果命中了某个 chunk,把它前后的几个相邻 chunk 也一并返回。因为切片时可能把一句话切成两段,返回相邻内容可以保持上下文完整
-
3. Lost-in-the-Middle 优化:研究(Liu et al., 2023)表明,大模型对长上下文中间部分的内容关注度较低,对开头和结尾的内容更敏感。因此可以将最相关的结果放在首位和末尾
至此,检索流水线完成,把最终结果返回给调用方。
五、技术栈全景图
看完核心流程,我们整理一下构建一个 RAG 系统需要用到的技术栈:
| 类别 | 技术选型 | 说明 |
|---|---|---|
| 基础框架 | Spring AI / LangChain4j | 提供了 Embedding、向量存储、大模型等抽象 |
| 向量数据库 | Elasticsearch / Milvus / PGVector | 三选一,各有优劣 |
| 全文搜索 | Elasticsearch + 中文分词器 | IK 分词器或 CJK 分析器 |
| 文档解析 | Apache PDFBox / Apache POI | PDF 和 Office 文档解析 |
| 文本切片 | 递归字符分割器 | 按 token 数递归切分,保留 overlap |
| 嵌入模型 | 各类 Embedding API 或本地模型 | 将文本转为向量 |
| 重排序 | Cross-encoder 重排模型 | 精细化排序 |
| ORM | MyBatis-Plus / Hibernate | 数据持久化 |
对于 Java 生态的团队,Spring AI 是目前最成熟的选择,它提供了统一的操作接口,屏蔽了底层向量数据库和大模型 API 的差异。
六、架构设计要点
一个优秀的 RAG 系统,在架构设计上有几个值得关注的要点:
6.1 使用责任链模式组织检索流程
检索流水线的每一步是一个独立的"处理器",它们通过排序串联起来。想增加一个新环节?只需实现处理器接口,配置好顺序,自动加入流水线。这种设计让系统非常灵活:想关掉重排序?去掉这个处理器即可。
6.2 使用策略模式 + 模板方法管理算法
切片策略、融合策略、去重策略……这些场景既有"多种算法可选"的维度(策略模式),又有"算法骨架固定、具体步骤可定制"的维度(模板方法模式)。比如两级切片中,抽象基类固定了"先一级切分、再遍历段落依次二级切分"的完整流程,子类只需实现一级切分的具体逻辑。
6.3 统一的存储抽象
// 向量存储统一接口
interface VectorStore {
    void add(List<Document> docs);
    void delete(String indexName, List<String> ids);
    List<SearchResult> search(String query, int topK);
}

// 搜索引擎统一接口
interface SearchEngine {
    void insert(List<Document> docs);
    List<SearchResult> search(String query, int size);
}
上层业务代码只依赖这些抽象接口,不关心底层是 ES 还是 Milvus。每个知识库可以独立配置不同的存储后端,互不干扰。
6.4 全链路耗时监控
每个检索环节的耗时都应该被记录:
{
  "向量检索耗时": 120ms,     ← 向量查询
  "BM25检索耗时": 80ms,      ← 全文检索
  "混合融合耗时": 2ms,       ← 基本可忽略
  "重排序耗时": 350ms,       ← 可能是瓶颈
  "总耗时": 567ms
}
通过这些指标,可以直观地看到系统瓶颈在哪里。如果重排序占了大部分时间,可以考虑减少重排序的候选数量,或者换更快的重排序模型。
七、总结与展望
RAG 的核心价值在于:它是连接大语言模型和私有知识库的桥梁。
回到文章开头的问题——你让大模型写一篇关于公司最新产品的介绍。有了 RAG 系统后,流程变成了:
-
1. 把产品文档、技术手册导入知识库
-
2. 用户提问时,系统从知识库中检索出相关片段
-
3. 大模型基于检索到的内容生成回答
整个过程不需要训练模型,知识可以随时更新,回答有据可循。
总结一下 RAG 系统的关键要点:
- 文档处理流水线把非结构化数据转化为可检索的向量和全文索引
- 检索流水线(向量 + BM25 + 融合 + 重排序)从海量知识中精确定位最相关的内容
- 粗排 + 精排的两阶段策略在效果和性能之间取得平衡
- 多种设计模式的灵活运用,让系统保持高扩展性和可维护性
当然,RAG 技术还在快速演进。当前值得关注的几个方向:
- Graph RAG:结合知识图谱的关系推理能力,回答需要跨文档推理的复杂问题
- Agentic RAG:让 AI Agent 自主决定何时检索、检索什么、如何推理,更加智能化
- Multi-modal RAG:不仅检索文本,还能检索图片、表格、代码等多模态数据
- RAG 评估体系:如何科学地评估 RAG 系统的检索质量和生成质量,是一个持续研究的课题
但无论方向怎么变,这篇文章讲到的这些核心思想——文档解析与切片、向量+关键词混合检索、多级排序与融合——始终是 RAG 系统的基础。理解了这些,你就掌握了搭建 RAG 系统的核心能力。
大模型的知识又多又杂,到底怎么学?
做这行久了,被问最多的问题就一个:大模型的知识又多又杂,我到底先学啥?翻了一堆资料,看啥都像重点,结果啥都没学进去。今天把我自己一路摸出来的顺序捋一遍,零基础、应届生、转行的都适用。跟着走,至少方向不乱、不瞎忙,学完拿得出手。
第一阶段(10天):初阶应用
这一阶段就一个目标:把大模型真正"玩明白",不是只会聊天那种,而是能调教它、能用代码把大模型和业务接起来。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
这阶段正式进实战,目标很实在:做出两个能拿出手的东西——一个私有知识库,一个 agent 对话机器人。
-
为什么要做 RAG
-
搭建一个简单的 ChatPDF
-
检索的基础概念
-
什么是向量表示(Embeddings)
-
向量数据库与向量检索
-
基于向量检索的 RAG
-
搭建 RAG 系统的扩展知识
-
混合检索与 RAG-Fusion 简介
-
向量模型本地部署
-
…
走完这 30 天,Python 或 JavaScript 背景的基本能独立做一套 RAG 应用,简历上也敢写"大模型应用开发"了。
第三阶段(约20天):动手微调
学到这,你已经开始 “造” 模型了 —— 通过微调,搞出垂直领域的专用小模型。
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你从 “只会用” 变成 “能造” 的 AI 小子。那么你还想往下探索吗?
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方优快云官方认证二维码,即可100%免费领取全套学习资料!
第四阶段(20天):商业闭环,部署落地
技术学完,落地才算数。这阶段带你搞明白大模型怎么真正跑起来、用起来。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
想要入坑大模型的朋友,给大家准备了一份2026 年最新 AI 大模型全套学习资料:
1、大模型系统化学习路线
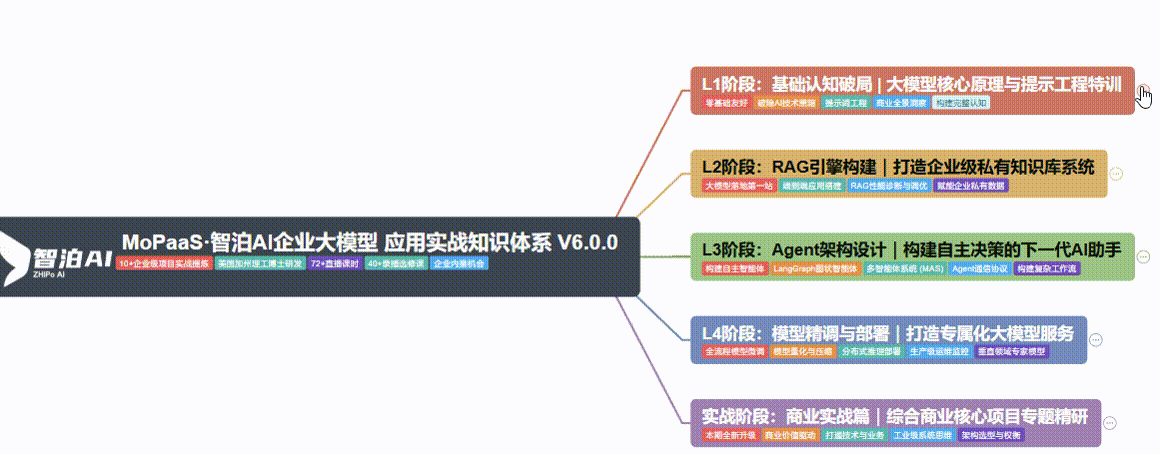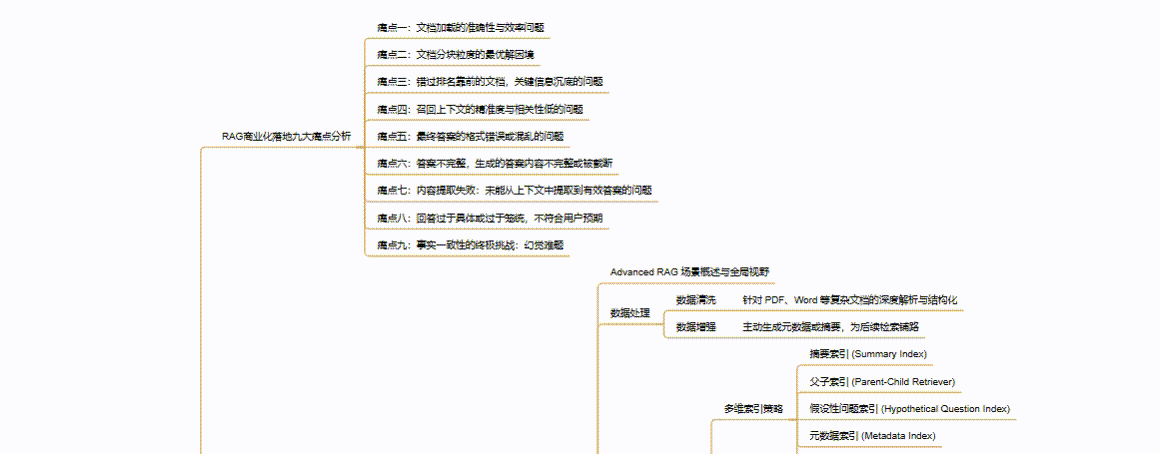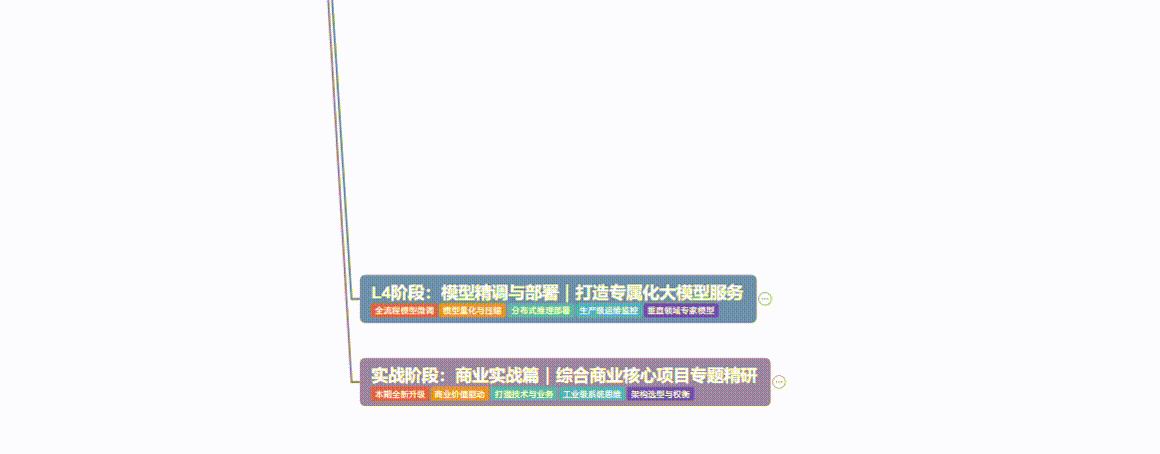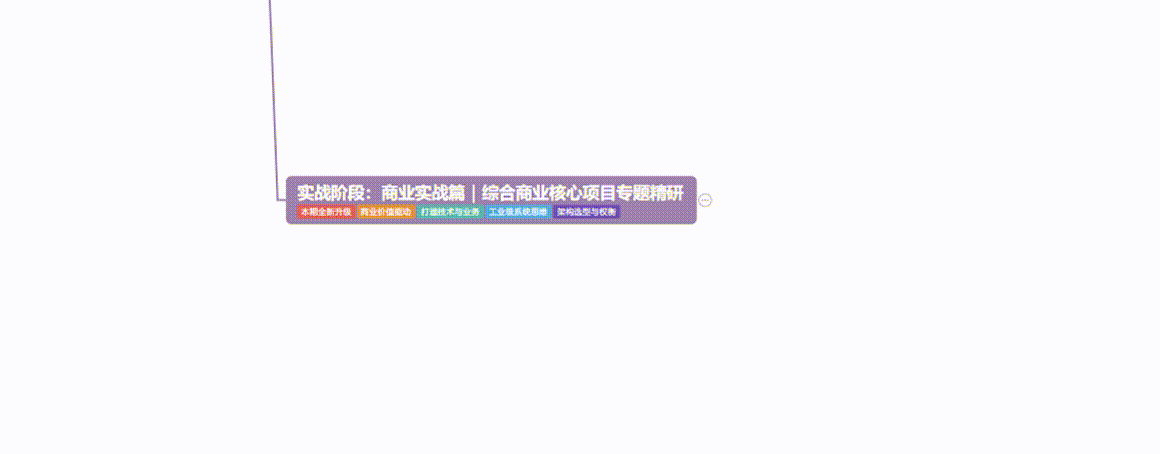
2、大模型学习视频教程

3、大模型学习书籍&电子文档
4、AI大模型最新行业报告

5、大模型项目实战&配套源码

6、2026大模型大厂面试真题

7、为什么要学习大模型?
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。


8、适合谁学?
- 传统后端 / Java / 前端开发,想转型 AI 应用
- 大学生、应届生,想拿更好的 offer
- 产品经理、运营,想武装职业竞争力
- 技术负责人,想给团队落地提效
学习是反人性的,但回报是真金白银。技术会更新,赛道会切换,但只要你先动手,机会就永远站在你这边。
9、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方优快云官方认证二维码,即可100%免费领取全套学习资料!
好了,就写到这。路线是死的,人是活的,卡住了随时来问我。觉得有用就点个收藏,别让它进收藏夹吃灰——动起来比啥都强。


 扫一扫


 1990

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


