


本文系统讲解了Agent记忆机制,从基础的上下文窗口讲起,逐步深入到短期记忆、长期记忆、向量检索、结构化profile、知识图谱等高级应用。文章详细剖析了Claude Code、OpenClaw、LangGraph、Mem0、Zep、Letta、CrewAI等框架的内存设计思路,并提出了设计记忆系统前需要考虑的关键问题。通过阅读本文,即使是小白也能轻松掌握大模型记忆的核心技术,为开发高效、可靠的Agent应用打下坚实基础。
这两年,Agent 这个词被讲得太热了。
一开始,大家讨论的是模型会不会调用工具。后来讨论的是它能不能自己拆任务、跑代码、查网页、操作浏览器、调用 API。再往后,大家开始讨论多 Agent、工作流、MCP、Computer Use、代码助手、个人助理、企业数字员工。
但如果你认真用过一段时间 Agent,会发现一个很朴素的问题:
它经常忘。
你上周告诉它项目用 pnpm,它今天又给你写 npm install。你昨天刚纠正过接口权限逻辑,它今天又犯同样的错。你反复强调公众号文章要"深入浅出、不要堆术语",它下一次还是写成论文摘要。你让它帮你做长期项目,它干到一半开始忘记最初目标。
所以很多人会说:Agent 需要记忆。
这句话当然对。但问题在于,很多人对"记忆"的理解太窄了。
一提到 Agent 记忆,最常见的反应是:不就是把历史对话存进向量库,然后相似度检索出来,塞回 prompt 吗?
这个答案不能说错,但它只讲到了第一层。
如果 Agent 只是一个聊天机器人,向量检索可能够用。但如果 Agent 要变成一个长期协作者,一个能持续理解你、理解项目、理解组织规则、理解过去失败经验的系统,记忆就不再是一个简单的"存储 + 检索"问题。
它会变成一个更复杂的问题:
- 什么值得记?
- 记成什么格式?
- 谁来决定写入?
- 什么时候召回?
- 旧记忆和新事实冲突怎么办?
- 错误经验要不要删?
- 哪些记忆能影响行动,哪些只能作为参考?
- 用户能不能查看和修改?
- 企业能不能审计和隔离?
如果把这些问题放在一起看,你会发现:
Agent 记忆不是向量库,而是一套管理过去的操作系统。
它的任务是在正确的时间想起正确的东西,同时知道什么时候该忘。
这篇文章试着系统讲清楚 Agent 记忆机制。我们会从最基础的上下文窗口讲起,一路讲到短期记忆、长期记忆、向量检索、结构化 profile、知识图谱,以及 Claude Code、OpenClaw、LangGraph、Mem0、Zep、Letta、CrewAI 等框架到底在做什么。
你可以把它当成一张 Agent 记忆地图。
- 先拆掉一个误解:大模型本身并不"记得"
我们平时说"模型记得上下文",其实容易产生误解。
大模型本质上是一个无状态函数。每一次调用接收输入,输出响应。下次调用若不将历史内容重新作为输入提供,模型并不知道此前发生过任何交互。
所谓"记得",是应用层在背后做了几件事:
保存最近对话
保存当前任务状态
压缩旧上下文
检索相关历史
把这些内容重新放进 prompt
模型并不凭空想起过去,而是在回答前重新看见了过去。
这个区别很重要。
如果你以为模型本身有持久记忆,就会把问题想得很神秘——好像只要模型越来越强,长期记忆会自然解决。但如果明确记忆发生在模型外部,就会立刻意识到:Agent 记忆是一个工程架构问题。
它需要存储系统、检索系统、上下文构造器、写入策略、更新策略、遗忘机制和权限治理。这也是为什么 Mem0、Zep、Letta、Supermemory、Honcho、Cognee 等记忆框架会独立成为专门基础设施。它们都在解决同一问题:
如何让一个本来无状态的模型,表现得像一个可以长期协作的主体?
- 最原始的记忆:上下文窗口
最简单的记忆,就是把历史直接放进上下文窗口。
一个聊天 Agent 可能这样组织输入:
System Prompt
+ 用户最近 N 轮消息
+ 助手最近 N 轮回复
+ 当前用户问题
一个 Coding Agent 可能这样组织:
System Prompt
+ 项目规则
+ 当前任务目标
+ 已读文件摘要
+ 最近工具调用结果
+ 当前计划
+ 用户最新指令
这就是短期记忆,也叫工作记忆。
它的特点是:对当前任务很有用,但生命周期短。任务结束后,大部分可以丢掉。
但它有两个天然限制:
第一,容量有限。不管上下文窗口是 32K、128K 还是 1M token,真实任务总有一天会撑爆它。
第二,长上下文 ≠ 好上下文。上下文越长,模型越容易被无关信息干扰,成本越高,延迟越大。更大的问题是:旧信息可能已经过时,却依然混在上下文里影响判断。比如你早期说项目用 npm,后来改成了 pnpm,两条同时存在时模型不知道该信哪条。
所以 Agent 记忆的第一课是:
不要把"塞更多上下文"当成记忆能力。真正的记忆能力,是选择。
- 摘要记忆:用压缩换连续性
当上下文太长时,最直接的办法是总结。
系统会把旧对话压缩成摘要,只保留主线:
用户正在研究 Agent 记忆机制。
已经讨论过 Claude Code、OpenClaw、LangGraph。
偏好中文、结构化、深入浅出。
下一轮对话时只放:
历史摘要 + 最近几轮原文
这就是滚动摘要记忆(rollup summary)。Claude Code、OpenClaw、LangGraph、LlamaIndex 这类系统里,都有某种形式的 compaction 或 memory flush。
摘要记忆的优势:便宜、简单、可解释。
但风险也很明显:
| 风险 | 说明 |
|---|---|
| 丢细节 | 模型觉得不重要的内容,可能恰恰是未来任务的关键 |
| 引入错误 | 模型总结时可能把推测写成事实,把临时结论写成最终决策 |
| 错误滚雪球 | 一旦摘要出错,后续在错误基础上继续压缩,记忆逐步偏离真实历史 |
所以摘要适合承载"主线",不适合承载"证据"。低风险聊天场景没问题,但在代码修改、医疗、金融、合同等需要追溯原始证据的场景,不能只靠摘要。
- 向量检索:很多人以为这就是全部
向量检索是目前最常见的长期记忆实现。流程如下:
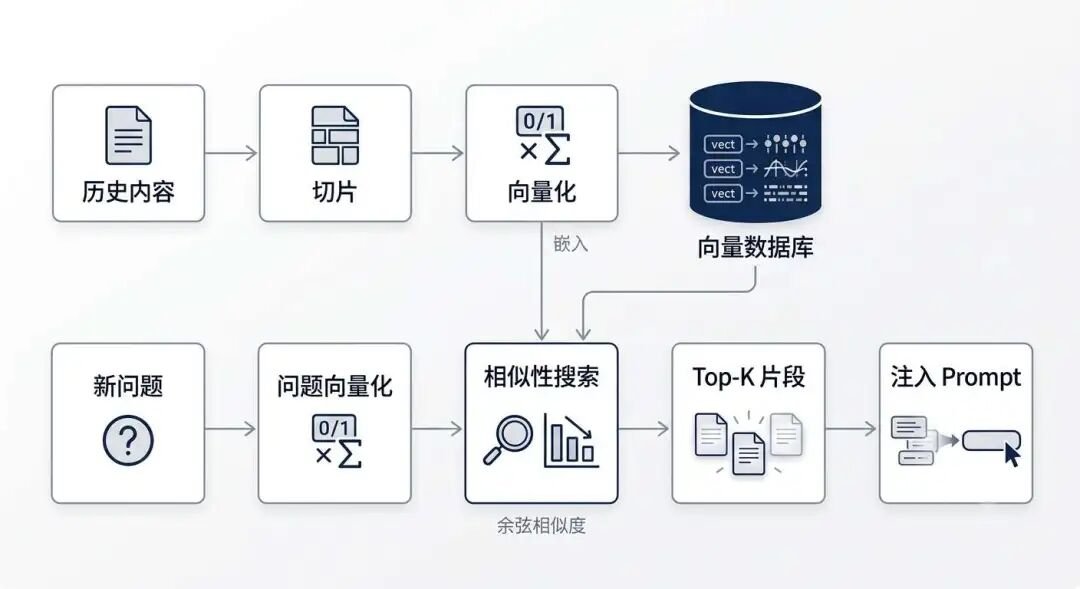
向量检索流程
典型实现代码(以 ChromaDB 为例):
from uuid import uuid4
import chromadb
from sentence_transformers import SentenceTransformer

embedder = SentenceTransformer('all-MiniLM-L6-v2')
collection = chromadb.Client().create_collection("agent_memory")

def add_memory(text):
    embedding = embedder.encode(text).tolist()
    collection.add(
        ids=[str(uuid4())],
        embeddings=[embedding],
        documents=[text]
    )

def recall(query, k=5):
    query_embedding = embedder.encode(query).tolist()
    results = collection.query(
        query_embeddings=[query_embedding],
        n_results=k
    )
    return results['documents'][0]
这套机制允许 Agent 处理大规模历史数据,按语义召回而非简单关键词匹配,与 RAG、知识库、文档问答天然兼容。
但它有一个根本限制:
向量检索解决的是"相似",不是"可信"。
相似 ≠ 相关 ≠ 正确 ≠ 最新 ≠ 应被当前决策采用。
举个例子。你过去和 Agent 说过三件事:
1. **我们准备用 npm。**

2. **团队后来决定改成 pnpm。**

3. **临时排查问题时,可以试一下 npm install。**
当你问"怎么安装依赖",向量库可能把三条都召回。它们语义都相关,但行动含义完全不同:第一条是历史决定,第二条是当前决定,第三条是临时备选。
如果没有时间排序、决策状态、冲突处理,Agent 就可能做出错误判断。
这就是为什么越来越多的 memory framework 不再满足于"向量库 + top-k",而是开始加入更丰富的机制:
| 增强机制 | 解决什么问题 |
|---|---|
| metadata filtering | 按作用域/时间/类型过滤 |
| recency weighting | 按时效加权,旧记忆降权 |
| importance scoring | 区分哪些信息更关键 |
| entity extraction | 从文本中抽取实体和关系 |
| temporal graph | 表达事实随时间的演化 |
| memory consolidation | 合并重复、整合碎片 |
| contradiction handling | 检测并处理新旧冲突 |
| provenance tracking | 追溯每条记忆的来源 |
| user-editable memory | 用户可查看、修改、删除 |
向量库仍然重要,但它只是记忆系统里的一个器官,不是整个人。
- 结构化 Profile:从碎片到用户画像
如果 Agent 每次都从历史片段里猜用户偏好,效率很低,也不稳定。
更常见的做法是,把对话中稳定的信息抽取成结构化 profile:
{
  "language": "zh-CN",
  "role": "全栈开发者,主力 TypeScript",
  "project": "my-saas-app",
  "preferences": [
    "项目使用 pnpm,不要用 npm",
    "API 路由统一放 src/routes/",
    "提交信息用英文,格式遵循 Conventional Commits",
    "修改代码前先跑一遍测试"
  ]
}
ChatGPT 的 saved memories、Claude 的 memory、Mem0 的 user memory、Supermemory 的 user profile,都有类似思想。
结构化 profile 的优势:
| 优势 | 说明 |
|---|---|
| 可控 | Agent 直接读取字段,无需从几十段历史中猜 |
| 可编辑 | 用户可以看到"系统记住了什么",可以修改或删除 |
| 省上下文 | 一份 500 字 profile 可替代数万字历史对话 |
但 profile 有一个很大的工程难题:更新。
用户说"我喜欢短文",后来又说"这篇我要万字长文"。这到底是偏好变化,还是某一次任务的特殊要求?用户说"项目用 React",后来某个子项目用 Vue。系统应该覆盖原记忆,还是增加作用域?
以下是一个冲突解决决策表:
| 情景 | 处理策略 |
|---|---|
| “我喜欢短文” → “这篇我要万字长文” | 区分偏好 vs 特殊任务,特殊任务不更新全局 profile |
| “项目用 React” → 子项目用 Vue | 增加作用域字段(scope),不覆盖全局 |
| “准备马拉松” → “脚踝受伤,暂时不跑” | 保留历史目标,标记旧目标为 suspended |
| 同一来源、时间晚者冲突 | 按时间覆盖,保留旧值作为历史证据 |
| 不同来源、置信度不同 | 保留双方,标记来源和置信度 |
一个成熟的 profile 记忆系统,至少要处理这些维度:
- 作用域:全局偏好 / 项目偏好 / 会话偏好
- 时间:长期稳定状态 / 近期状态 / 临时约束
- 冲突:新旧事实如何合并
- 置信度:用户明确说的 vs 模型推断的
- 来源:用户 / 文件 / 工具 / 第三方
- 敏感性:是否应该保存
所以 profile 记忆看起来简单,真正做好很难。
- 情节记忆:记住自己做过什么
对个人聊天助手来说,记住事实很重要。但对工具型 Agent 来说,记住自己的经历更关键。
这就是情节记忆(episodic memory),对过去特定经历的记录。
比如一次代码修复的任务轨迹:
{
  "task": "修复登录失败",
"context": "用户反馈线上 401 错误增多",
"plan": "检查 auth middleware 和 refresh token",
"actions": ["读取 auth.ts", "运行 auth 测试"],
"observations": ["refresh token 判断条件写反"],
"fix": "调整判断逻辑",
"outcome": "测试通过",
"lesson": "遇到 401 时优先检查 refresh 分支",
"timestamp": "2026-06-13T10:00:00Z",
"successful": true
}
它记录的是一段完整的任务轨迹。下次遇到类似问题,Agent 可以检索这段经验作为行动参考。
这类记忆对 Coding Agent、运维 Agent、数据分析 Agent、自动化工作流 Agent 尤为关键。因为它们不只是回答问题,而是执行任务。它们需要知道:上次怎么成功的、上次哪里失败了、哪些工具有效、哪些路径应避免。
但情节记忆也有风险:坏经验会污染未来。如果 Agent 曾经用一种错误方案解决了问题,后续召回该经验可能重复错误。
所以一段好的情节记忆至少要包含:
任务是什么 → 环境是什么 → 采取了什么动作
→ 观察到什么 → 是否成功 → 用户/测试如何反馈
→ 这段经验是否仍然适用
否则它不是记忆,而是风险。
- 程序性记忆:从"记住事情"到"改变做事方式"
人类记忆里有一种很重要的类型,叫程序性记忆(procedural memory)。它记住的是"怎么做事":骑自行车、打字、排查问题的流程。
Agent 也需要这种记忆:
修改代码前先读相关文件。
遇到测试失败,先复现,再定位,再修复。
用户要求 review 时,先列风险和 bug,再给总结。
这些是反复使用的行为规则。
Claude Code 的 CLAUDE.md 是非常典型的程序性记忆。开发者把构建命令、测试命令、代码风格、团队约定写进去,Claude 每次会话启动时加载它,就像读取项目的工作手册。
OpenClaw 的 SOUL.md、AGENTS.md、skills 也有类似作用,既能记住事实,也能塑造 Agent 的人格、工具使用方式和工作习惯。
LangGraph 文档也把 procedural memory 列为三类长期记忆之一,可以是系统 prompt、agent code、工具规则,或通过 reflection 生成的新指令。
程序性记忆的价值很大——它能让 Agent 越用越顺手。但它的风险也最大:事实记错了影响一次回答,规则记错了持续影响行为。如果 Agent 把"用户临时允许跳过测试"记成"以后都可以不跑测试",后果很严重。
所以程序性记忆需要更强的治理:哪些规则可以自动写入?哪些必须用户确认?是否需要版本记录和回滚?是否区分项目级/用户级/组织级?
这里要特别注意一个区分:
记忆不是权限系统。
你可以在记忆里写"不要删除生产数据",但真正防止删除的应该是权限、沙箱、审批和审计,而不是希望模型乖乖遵守一段文字。记忆塑造行为倾向,权限决定行为边界。两者不能混。
- 三类长期记忆速查
把前面三类长期记忆放在一起对比:
| 维度 | 语义记忆(Semantic) | 情节记忆(Episodic) | 程序性记忆(Procedural) |
|---|---|---|---|
| 记什么 | 事实、偏好、状态 | 任务轨迹、经历 | 行为规则、工作流 |
| 示例 | “用户偏好中文” | “上次修 401 的完整过程” | “修改代码前先读文件” |
| 存储方式 | Profile + 向量库 | 事件日志 + 向量库 | 规则文件 + System Prompt |
| 召回策略 | 按作用域直接读取 | 相似任务匹配 + 时间窗口 | 会话启动时加载 |
| 核心风险 | 推断当事实 | 坏经验污染未来 | 规则记错持续影响行为 |
| 典型框架 | Mem0、ChatGPT Memory | Hindsight | Claude Code CLAUDE.md |
| 更新难度 | 中(冲突合并) | 高(经验评价) | 高(行为治理) |
一个成熟的 Agent 记忆系统,通常需要同时支持这三类。
- 记忆的完整生命周期
把以上机制抽象起来,一个完整的 Agent 记忆系统有六个环节:
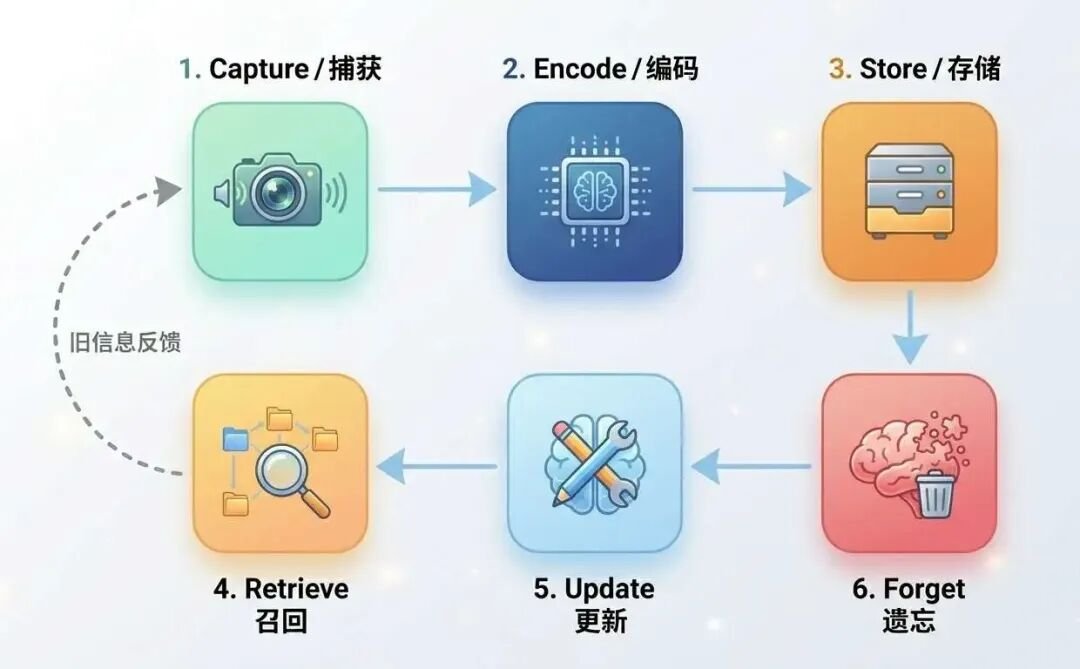
记忆系统六大环节
很多系统只做了 Store 和 Retrieve,所以看起来像向量库。但真正的难点集中在另外四端。
捕获(Capture):什么信息值得写入记忆?候选来源包括用户对话、助手回复、工具调用结果、文件内容、代码 diff、测试结果、环境状态。"今天北京下雨"对天气助手可能重要,对代码助手没意义。
编码(Encode):同一段信息可采用不同编码形态:
| 编码形态 | 示例 | 适用场景 |
|---|---|---|
| 原始文本 | “用户说:以后默认用 pnpm” | 可追溯,适合证据保留 |
| 结构化字段 | {"project": "app", "pkg": "pnpm"} | 稳定读取,适合 profile |
| 程序性规则 | “安装依赖时优先使用 pnpm” | 影响行为,适合规则注入 |
| 事件记录 | 2026-06-13: npm → pnpm | 时间推理,适合时序分析 |
存储(Store):可选介质包括 prompt 上下文、本地文件、SQLite、Postgres、Redis、向量数据库、图数据库、对象存储、专用 memory service。
召回(Retrieve):当前任务需要记忆吗?需要哪类?召回多少?放在 prompt 哪个位置?是否显示来源?召回少了像失忆,多了被噪声淹没。
更新(Update):长期记忆的核心。用户说"我不做这个项目了",系统如何处理旧的项目偏好?客户状态从"潜在"变"已签约",旧状态保留吗?不能只 append-only,也不能简单覆盖。
遗忘(Forget):遗忘不是缺陷,是能力。它可以是删除、降权、归档、过期、标记废弃。没有遗忘机制的长期记忆,最终会变成长期污染。
- 知识图谱的回归
过去几年,RAG 让向量数据库变得很流行。但 Agent 记忆发展到一定阶段,知识图谱会重新变重要。
原因很简单:真实世界不是一堆相似文本,而是一张不断变化的关系网。
企业场景尤其典型:
客户 A 属于 金融行业
客户 A 使用 产品 B
产品 B 依赖 服务 C
服务 C 最近出现 故障 D
销售 E 负责 客户 A
合同 F 将在 下个月 到期
如果问:“哪些下个月要续约、但最近受故障影响的金融客户,需要销售优先跟进?”——这不是向量检索能优雅解决的问题。它需要实体、关系、时间和多跳推理。
以下是一个 Cypher 查询示例(Neo4j):
MATCH (c:Customer)-[:BELONGS_TO]->(i:Industry {name: "金融"}),
      (c)-[:USES]->(p:Product),
      (p)-[:DEPENDS_ON]->(s:Service),
      (s)-[:HAD_INCIDENT]->(inc:Incident),
      (c)-[:HAS_CONTRACT]->(ct:Contract)
WHERE inc.time > datetime("2026-05-01")
  AND ct.expires > datetime("2026-07-01")
  AND ct.expires < datetime("2026-08-01")
RETURN c.name, inc.description, ct.expires
图谱记忆可以表达:谁和谁有关、关系何时建立、关系是否仍然有效、哪些事实互相冲突。
当然,图谱不是银弹,构建成本高,实体抽取错误会传播,查询比向量检索更重。但在企业 Agent、CRM Agent、项目管理 Agent 等场景中,图谱几乎是迟早要面对的方向。
| 维度 | 向量检索 | 知识图谱 |
|---|---|---|
| 核心能力 | 语义相似度匹配 | 实体关系 + 多跳推理 |
| 适合场景 | “找一段相似文本” | “理解一个动态世界” |
| 查询类型 | Top-K 近邻 | 结构化图查询 |
| 时间推理 | 弱(需额外机制) | 强(边带时间戳) |
| 冲突处理 | 无(可能召回矛盾双方) | 有(可标记事实有效期) |
| 构建成本 | 低 | 高 |
| 代表框架 | Chroma、Pinecone | Zep/Graphiti、Cognee |
- 产品实例对比:不同 Agent 怎么做记忆
理解具体产品,会比抽象概念更直观。
Claude Code:代码库中心的记忆
Claude Code 的记忆围绕代码仓库(repo)展开:
CLAUDE.md          → 人写的项目说明和长期规则
.claude/rules/     → 项目级规则文件
auto memory        → Agent 自动积累的调试经验和用户偏好
session context    → 当前会话的工作状态
compaction         → 超出窗口时的摘要策略
它本质上是 repo-centric memory,主要解决:这个代码库怎么构建、哪些目录放什么、修改前要跑哪些测试、团队有什么约定、用户上次纠正过什么。
通用个人 Agent:跨场景的记忆
面向个人日常协作的 Agent 需要更宽的记忆范围,跨越多个工作场景和较长时间跨度。典型机制包括长期用户画像、每日笔记、混合检索(关键词 + 向量)、记忆整合(短期信号晋升为长期记忆)。
这类 Agent 的关键是"跨渠道、跨时间、跨工作流地理解你",也就是 workspace-centric personal memory。
企业 Agent:业务上下文的记忆
面向企业场景的 Agent 还需要关注:用户日程和 App 使用习惯、企业系统状态、多角色 profile 隔离、本地数据处理、移动端上下文感知。强调不同用户角色之间的隔离与权限管控,也就是 device/business-profile-centric memory。
三者的核心差异:
| 维度 | Coding Agent | 个人助理 Agent | 企业 Agent |
|---|---|---|---|
| 记忆中心 | 代码库 | 个人工作空间 | 设备 + 业务 profile |
| 核心内容 | 构建规则、代码风格 | 用户偏好、跨对话上下文 | 日程、ERP、角色隔离 |
| 记忆载体 | CLAUDE.md + auto memory | 日志 + 向量库 + 人格定义 | 本地数据 + 权限系统 |
| 生命周期 | 项目周期 | 用户长期使用周期 | 企业运营周期 |
| 代表产品 | Claude Code | OpenClaw、Mem0 | Zep、Honcho |
这三个方向会长期并存。
- 主流框架的记忆设计思路
理解具体产品之后,再来看框架。当前的 Agent 记忆框架,设计思路差异很大。与其比谁"更好",不如看它们各自从哪个角度切入:
通用框架(多 Agent / 通用应用,记忆只是其中一个模块)
| 框架 | 核心机制 |
|---|---|
| AutoGPT | scratchpad + 向量记忆 + 文件工作区,早期自主 Agent 样本 |
| MetaGPT | Role memory + SOP + 共享产物,多 Agent 软件开发 |
| LlamaIndex | ChatMemoryBuffer + VectorMemory + Summary,RAG 深度集成 |
| AutoGen | Memory protocol(add/query/update_context),协议层抽象 |
| CrewAI | 统一 Memory 类,LLM 推断 scope/importance,多角色协作 |
| LangGraph | checkpoint + store + retriever + instruction,工程化最完整 |
其中 LangGraph 的记忆设计最值得研究。它把状态、存储、检索、线程、命名空间都拆开了,明确对应人类记忆的三类:semantic(事实)、episodic(经历)、procedural(规则)。
专门记忆框架(记忆本身就是产品)
| 设计思路 | 代表框架 | 核心特点 |
|---|---|---|
| 检索增强型 | Mem0、LlamaIndex Memory | 把信息存好,需要时搜出来 |
| 操作系统型 | Letta (MemGPT)、MemOS | 像操作系统管理内存和硬盘一样管理记忆 |
| 认知推理型 | Hindsight、Honcho | 不止存和搜,还要推理和更新信念 |
| 协作共享型 | CrewAI | 多个 Agent 之间共享记忆 |
| 图谱时序型 | Cognee、Zep/Graphiti 、Supermemory | 实体关系 + 时间推理,理解动态世界 |
这些框架共同指向一个趋势:
记忆系统正在从"检索模块"变成"可学习、可演化、可治理的认知层"。
- 设计记忆系统前,先问 8 个问题
如果你正在做 Agent 应用,不要一上来就选向量库。先问这 8 个问题:
问题 1:你的 Agent 需要记住谁?
个人助手要记用户偏好。Coding Agent 要记 repo 规则。企业 Agent 要记组织知识和权限边界。不同对象需要不同 scope。
问题 2:需要记住什么类型?
事实 → 用户偏好、项目背景、业务状态
经历 → 过去任务轨迹、失败案例、工具调用结果
规则 → 工作流、行为约束、编码习惯
不要把三者混在一个向量库里就完事。
问题 3:哪些记忆会影响行动?
有些记忆只是背景(“用户喜欢简洁表达”)。有些记忆会影响行动(“生产环境必须审批后才能写”)。后者不能只靠记忆,要进入权限系统和审批机制。
问题 4:写入策略是什么?
| 策略 | 适用场景 |
|---|---|
| 自动写入 | 低风险偏好、稳定事实 |
| 用户确认 | 行为规则、敏感信息 |
| 从不写入 | 临时信息、高隐私内容 |
| 分层写入 | 普通偏好自动记,行为规则需确认 |
问题 5:如何处理冲突?
| 策略 | 适用场景 |
|---|---|
| 时间优先(later wins) | 偏好和状态的正常演进 |
| 来源优先 | 用户明说 > 模型推断 > 第三方 |
| 作用域隔离 | 同一实体的不同上下文 |
| 显式决议 | 高风险冲突(如安全规则) |
问题 6:如何召回?
召回不是单纯 top-k。你可能需要综合语义相似度、关键词、时间、重要性、作用域、实体关系、当前任务、风险级别。
问题 7:如何遗忘?
遗忘可以是删除、过期、降权、归档、标记废弃、从当前 profile 移出但保留历史证据。
问题 8:用户如何控制记忆?
用户应该能知道 Agent 记住了什么、哪些记忆影响了这次回答、能不能改、能不能删。这是长期信任的基础。
- 评估记忆系统:不能只看召回率
评估 Agent 记忆,不能只看"能不能找到历史片段"。真正要看的是:
| 评估维度 | 核心问题 | 示例 |
|---|---|---|
| 事实一致性 | 能否正确回答过去明确说过的事实? | “上次说项目用 pnpm,现在问用什么?” |
| 时间推理 | 是否理解事实随时间的变化? | 一月说训练马拉松、三月说恢复低强度 |
| 多跳推理 | 能否跨多个记忆片段连接关系? | 客户→产品→服务→故障,哪些客户需安抚? |
| 行动改善 | 记忆是否降低了重复错误率? | Coding Agent 同类错误重犯率是否下降 |
| 成本与延迟 | 检索 p50/p99、token 消耗增量 | 记忆系统不能又慢又贵 |
| 可控性 | 用户能否查看/修改/删除?企业能否审计? | 生产环境中比 benchmark 分数更重要 |
- 7 个最常见的坑
| # | 坑 | 表现 | 解法 |
|---|---|---|---|
| 1 | 什么都记 | 写入所有内容,召回时噪声淹没信号 | 实现重要性评估和写入过滤 |
| 2 | 只做向量检索 | 向量库无法处理冲突、时间、权限 | 融合 metadata、时间加权、冲突检测 |
| 3 | 没有作用域 | 项目 A 的偏好污染项目 B | 增加 scope 字段,查询时强制过滤 |
| 4 | 推断当事实 | “用户最近有点忙"→ 存为"用户偏好短回复” | 区分来源,保存置信度 |
| 5 | 没有过期 | 旧会议安排仍被召回 | 实现 TTL、时间衰减或主动过期 |
| 6 | 记忆不可见 | 用户不知道 Agent 记住了什么 | 召回时附来源,提供记忆查看界面 |
| 7 | 让记忆承担安全职责 | "记住不要删生产数据"就完事 | 安全靠权限、沙箱、审批、审计,记忆只辅助提醒 |
- 结尾
工具调用让 Agent 从"会说"变成"会做",规划能力让 Agent 从"单步反应"变成"多步执行"。记忆机制要解决的是另一个问题:让 Agent 变成一个可以长期协作的伙伴。
一个真正可靠的 Agent,应该能记住你的稳定偏好,忘掉过时的信息,从失败中总结经验,在相似任务中复用策略,解释它为什么想起某段历史,并且让你控制它能记什么、不能记什么。
但这件事比想象中难。
因为记忆不是越多越好。人类也不是靠记住一切来思考的。我们会压缩、抽象、遗忘、修正,把经历变成经验,把经验变成规则,把规则再放回行动。
Agent 也正在走这条路。从上下文窗口,到摘要,到向量检索,到结构化 profile,到情节记忆,到程序性记忆,到知识图谱,到可推理的记忆网络。方向其实很清楚:
Agent 记忆正在从"存历史"走向"管理过去"。
未来的 Agent 竞争,模型强弱、工具多少、上下文长短是一方面,记忆系统是否可靠同样关键。
最后
如果说程序员已经是高薪职业,那么干AI的程序员,就是高薪中的高薪。

现在的市场,已经用数据给程序员指明了方向:学AI大模型,就是冲刺高薪的最优解!

看着身边越来越多的同行转型大模型、拿到高薪offer,很多人心里都动了心,但真正的难题来了:零基础小白不知道从哪入门?有基础的程序员找不到系统学习路径?实战项目练手无门?面试不知道考什么?
别慌!今天就给大家整理了一份【2026年最新版】AI大模型免费学习资源包,覆盖从入门到实战、从理论到面试、从基础到进阶的全流程,所有资料均已整理归档,无冗余、无套路,免费分享给每一位想抓住AI风口的程序员和小白!
👇👇扫码免费领取全部内容👇👇

1、大模型系统化学习路线
2、大模型学习书籍&文档

3、AI大模型最新行业报告
4、大模型项目实战&配套源码

5、大模型大厂面试真题

四阶段精细化学习规划(附时间节点,可直接照做)
结合上述资源,给大家整理了一份可直接落地的四阶段学习规划,总时长约2个月,小白可循序渐进,程序员可根据自身基础调整节奏,高效掌握大模型核心能力,快速实现从“入门”到“能落地、能面试”的跨越。
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
👇👇扫码免费领取全部内容👇👇
6、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 460


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


