收藏!大模型知识体系L3-1:RAG知识库入门篇,小白也能轻松掌握

阿里最强小钢炮上线!Qwen3.6-35B-A3B+OpenClaw本地部署全记录 阿里发布高效轻量级开源模型Qwen3.6-35B-A3B,本文详细介绍了基于Ollama的本地部署方案,包括与OpenClaw与飞书机器人的集成方案 阅读详情

本文介绍了RAG知识库的常见痛点及解决方案,包括内容缺失、文档加载效率、切分粒度、内容重叠、错过排名靠前的文档、提取上下文与答案无关、格式错误、答案不完整、提取到答案、答案特异性等问题,并提供了优化建议。此外,还深入探讨了高级RAG的检索增强策略,包括预检索、检索优化和后检索过程优化,旨在提升知识库的检索效率和准确性。

1、 RAG常见痛点分析及建议方案

失败痛点痛点描述优化建议 / 解决方案
1. 内容缺失 (Missing Content)知识库中不存在回答问题所需的知识。1. 增加知识库:将相关文本加入向量库。 2. 数据清洗与增强:提高输入数据质量。 3. 优化 Prompt:引导模型在无答案时回答“无法回答”,防止胡乱回答。
2. 文档加载准确性与效率文档格式不一导致读取效果差。1. 优化读取器:针对不同文档格式设计专门的读取器。 2. 数据清洗:对原始数据进行预处理。
3. 切分粒度问题文档切分方式影响语义连贯性与模型表现。1. 结构化分块:利用 HTML/Markdown 标题段落保持逻辑。 2. 递归分块:按段落、换行、空格等规则不断细分。 3. 优化 Chunk Size:匹配嵌入模型最佳输入大小(如 256/512)。 4. 内容重叠 (Overlapping):保持块间语义连贯。
4. 错过排名靠前的文档 (Missed Top Ranked)知识块存在但向量相似度排名靠后,导致无法召回。1. 增加召回数量:提高 TopK 召回阈值(如从 3 增加到 5)。 2. 重排 (Reranking):利用 Reranker 重新评估候选块的相关性。
5. 提取上下文与答案无关 (Not in Context)召回的内容无法有效支持答案生成。这是“内容缺失”或“错过排名靠前文档”的具体体现。
6. 格式错误 (Wrong Format)模型输出未遵循要求的格式。1. Prompt 调优:明确格式要求。 2. 格式验证:使用 Pydantic 等工具进行校验。 3. 自修复 (Auto-Fixing):对不合规格式进行自动修正。
7.答案不完整 (Incomplete)回答遗漏部分信息或过于片面。1. 引导用户:鼓励一次提问一个问题。 2. 问题拆分:将复杂问题拆分为子问题,汇总后再回复。
8.提取到答案 (Not Extracted)模型在提供的上下文中未能找到正确答案。1. 更换模型:使用推理能力更强的大模型。 2. 增强聚焦:在 Prompt 中强调必须基于上下文,或对关键句加粗。
9.答案太具体或太笼统 (Incorrect Specificity)回答的详略程度不符合预期。1. 改善提示词:在 Prompt 中明确要求的特异性程度。 2. 提升基座能力:使用更高水平的底座模型。

2、高级RAG

Advanced RAG重点聚焦在检索增强,即优化Retrieval阶段。增加了Pre-Retrieval预检索和Post-Retrieval后检索阶段,同时对检索本身也有优化。

  1. 预检索过程优化/检索前优化(Pre-Retrieval)

高级RAG着重优化了索引结构和查询的方式。优化索引旨在提高被索引内容的质量,包括增强数据颗粒度、优化索引结构、添加元数据、对齐优化等策略。查询优化的目标则是明确用户的原始问题,使其更适合检索任务,使用了查询重写、查询转换、查询扩展等技术。下面讲述索引优化和查询优化的方式:

1.1 摘要索引

1.2 父子索引

1.3 假设性问题索引

1.4 元数据索引

1.5 Enrich完善问题

1.6 多路召回

1.7 多路召回

  1. 检索优化(Retrieval)

检索阶段的目标是确定最相关的上下文。通常,检索基于向量搜索,它计算查询与索引数据之间的语义相似性。因此,大多数检索优化技术都围绕嵌入模型展开,比如微调嵌入模型,将嵌入模型定制为特定领域的上下文,特别是对于术语不断演化或罕见的领域。还有其他检索技术,例如:混合搜索,通常是指将向量搜索与基于关键字的搜索相结合的概念。

3、 后检索过程优化/检索后优化(Post-Retrieval)

对于由问题检索得到的一系列上下文,后检索策略关注如何优化它们与查询问题的集成。这一过程主要包括重新排序、RAG-Fusion和压缩上下文。重新排列检索到的信息,将最相关的内容予以定位标记,这种策略已经在LlamaIndex2、LangChain等框架中得以实施。有时直接将所有相关文档输入到大型语言模型(LLMs)可能导致信息过载,为了缓解这一点,后检索工作集中选择必要的信息,强调关键部分,并限制了相应的上下文长度。

3.1 重排(Reranking)

3.2 RAG-Fusionimg3.3 压缩上下文img

最后

对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?

答案只有一个:人工智能(尤其是大模型方向)

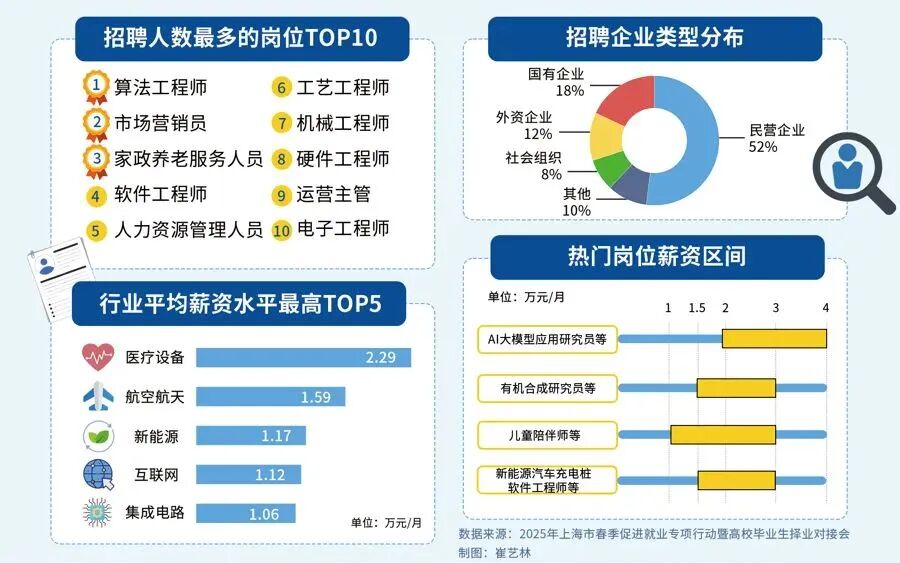
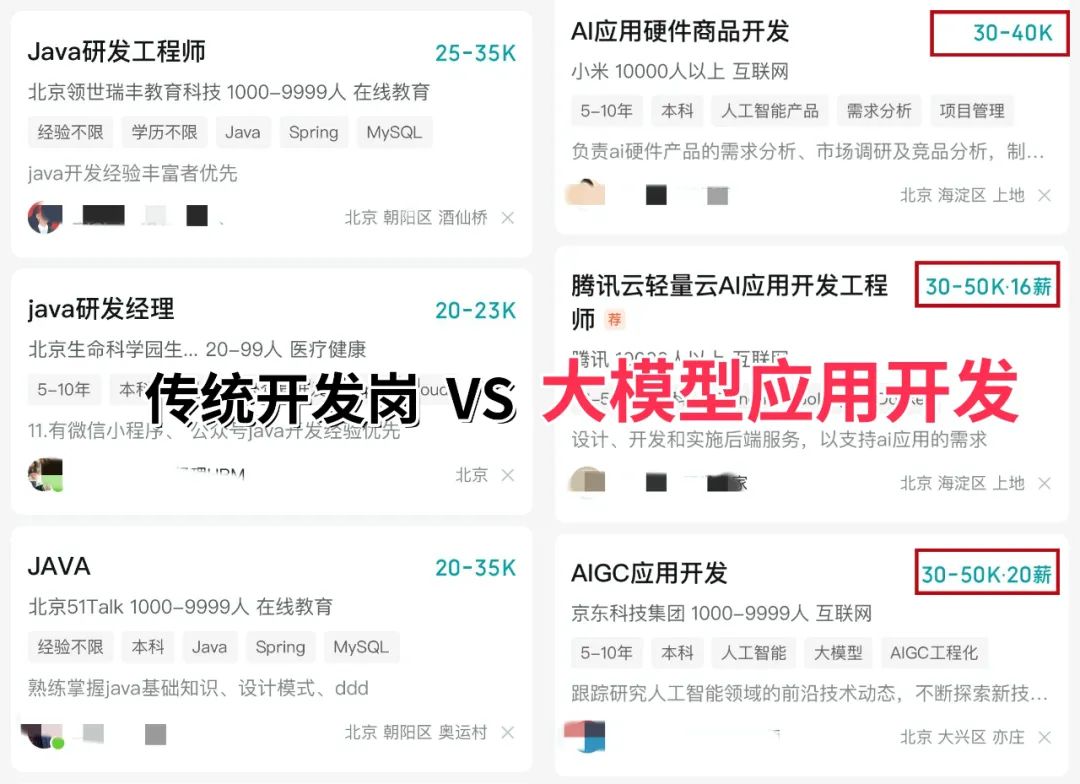
当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。

再看阿里、腾讯两大互联网大厂,非“人才计划”的AI相关岗位应聘者,月基础工资也约有3万元,远超其他行业同资历岗位的薪资水平,对于程序员、小白来说,无疑是绝佳的转型和提升赛道。
图片
图片
对于想入局大模型、抢占未来10年行业红利的程序员和小白来说,现在正是最好的学习时机:行业缺口大、大厂需求旺、薪资天花板高,只要找准学习方向,稳步提升技能,就能轻松摆脱“低薪困境”,抓住AI时代的职业机遇。

如果你还不知道从何开始,我自己整理一套全网最全最细的大模型零基础教程,我也是一路自学走过来的,很清楚小白前期学习的痛楚,你要是没有方向还没有好的资源,根本学不到东西!

下面是我整理的大模型学习资源,希望能帮到你。

图片

👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

最后

1、大模型学习路线

img

2、从0到进阶大模型学习视频教程

从入门到进阶这里都有,跟着老师学习事半功倍。

在这里插入图片描述

3、 入门必看大模型学习书籍&文档.pdf(书面上的技术书籍确实太多了,这些是我精选出来的,还有很多不在图里)

在这里插入图片描述

4、 AI大模型最新行业报告

2026最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

img

5、面试试题/经验

img

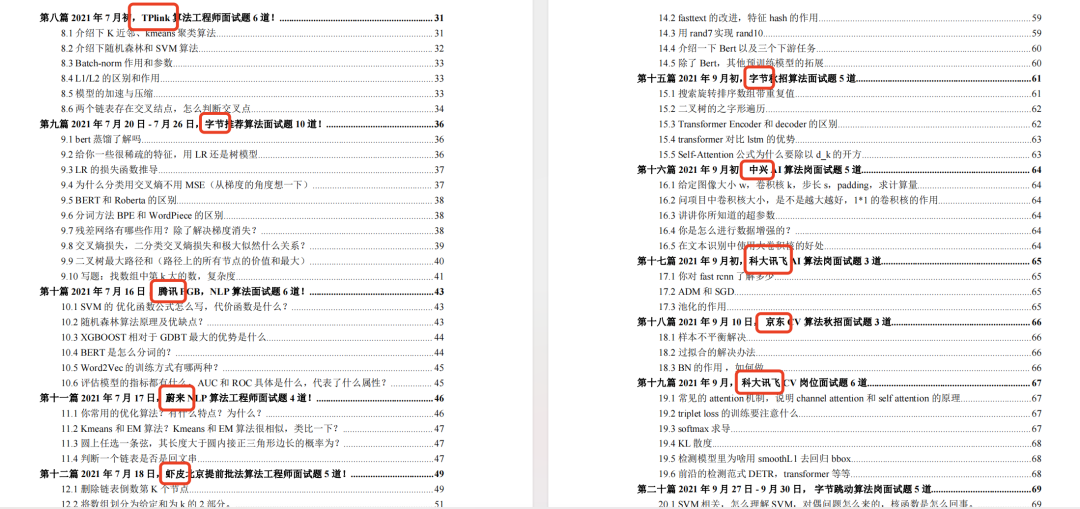
【大厂 AI 岗位面经分享(107 道)】

img

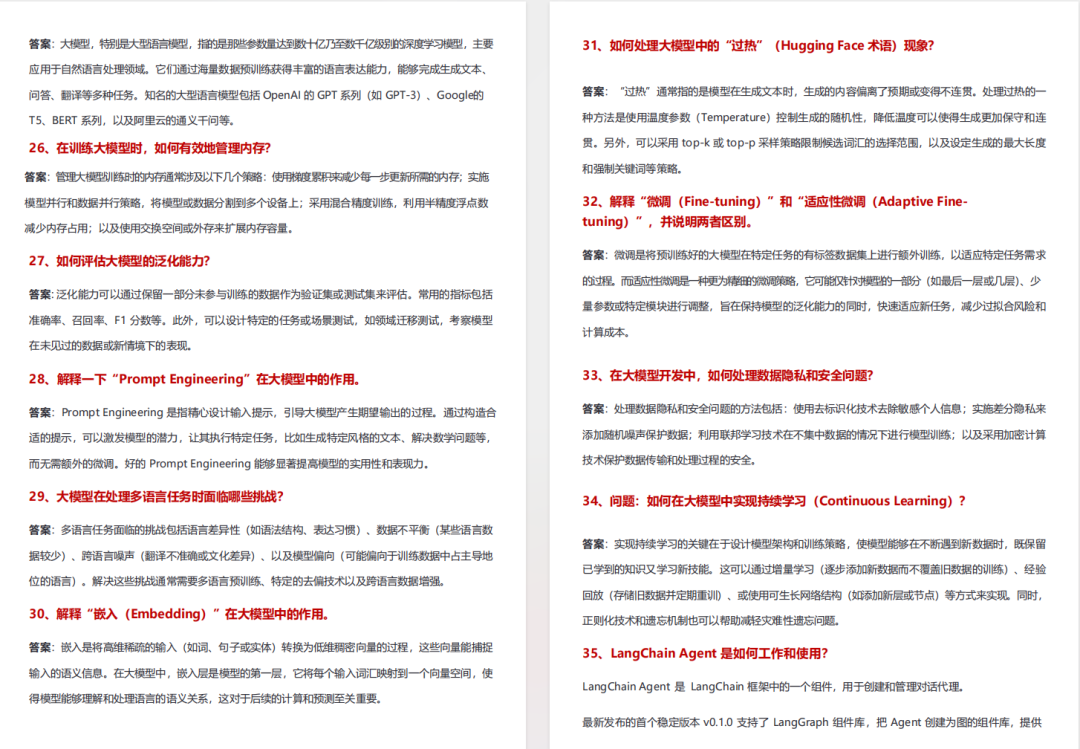
【AI 大模型面试真题(102 道)】

img

【LLMs 面试真题(97 道)】

img

6、大模型项目实战&配套源码

img

适用人群

在这里插入图片描述

四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …
第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …
第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …
第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型

  • 带你了解全球大模型

  • 使用国产大模型服务

  • 搭建 OpenAI 代理

  • 热身:基于阿里云 PAI 部署 Stable Diffusion

  • 在本地计算机运行大模型

  • 大模型的私有化部署

  • 基于 vLLM 部署大模型

  • 案例:如何优雅地在阿里云私有部署开源大模型

  • 部署一套开源 LLM 项目

  • 内容安全

  • 互联网信息服务算法备案

  • …

    👇👇扫码免费领取全部内容👇👇

    在这里插入图片描述

3、这些资料真的有用吗?

这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。

资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。

在这里插入图片描述
在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

一文搞懂 Agent Skills:从“会聊天”到“会干活”,Agent Skills 到底改变了什么? Agent Skills 通常可以直译为“智能体技能”,是一种给智能体“加技能包/工作流插件”的标准化方式。从本质上看,它的作用类似于给 Agent 安装“技能包”或“工作流插件”——把完成某一类任务所需的知识步骤和工具使用方式整体封装起来,供 Agent 在合适的时机自动调用和执行,而不再依赖人类反复编写提示词来引导。如果将 Agent 理解为一个能够自主完成任务的“数字员工”,那么 Skills 就是它所掌握的具体“工种”或“手艺”。 阅读详情

相关推荐

深度对比 OpenClaw 与 Harness:个人助理 vs 企业级 AI 工程范式

维度OpenClawHarness(架构层面)架构形态具体产品/框架抽象范式/方法论核心组件执行层 + 评估层 + 控制层通信方式WebSocket 总线,本地回环优先依赖具体实现,无统一标准扩展方式插件机制(Skills)+ Channels七大模块各自独立选型架构思想致敬 Unix 哲学,三层解耦工业级分层管控维度OpenClawHarnessGitHub 星标34 万+(历史第一)分散到多个项目大厂支持多家云厂商一键部署。

lukabruce的博客 1162

金三银四跳槽季必藏!2026 字节校招薪资大揭秘,AI 岗成应届生薪资天花板

对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?答案只有一个:人工智能(尤其是大模型方向)当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。

大模型研究中心 996

Streamlit安装避坑指南:从零到一键启动你的第一个数据可视化应用

本文提供了一份详尽的Streamlit安装避坑指南,帮助用户从零开始快速启动第一个数据可视化应用。文章深入剖析了安装过程中常见的网络超时、依赖冲突、环境变量缺失等核心问题,并给出了使用虚拟环境、配置国内镜像源、利用.whl文件离线安装等多种经过验证的解决方案,确保安装过程顺畅无阻。

weixin_29065015的博客 614

一文看懂Agent Skills带来的AI变革!

Skills 通过指令和代码为 Claude 提供新功能,虽然这使它们功能强大,但也意味着恶意 Skill 可以指导 Claude 以与 Skill 声称的目的不匹配的方式调用工具或执行代码。Skills 是可重用的、基于文件系统的资源,为 Claude 提供特定领域的专业知识:工作流、上下文和最佳实践,将通用代理转变为专家。Claude 在具有文件系统访问权限的虚拟机中运行,允许 Skills 作为包含指令、可执行代码和参考资料的目录存在,组织方式就像你为新团队成员创建的入职指南。

JavaEdge全是干货的技术号 4202

开漏输出(漏极开路输出与集电极开路输出)和推挽输出怎么判断

判断一个引脚是还是。

weixin_56838517的博客 1055

国产FPGA开发实战:紫光同创编程软件中的约束文件详解与常见问题

本文详细解析了紫光同创FPGA编程软件中约束文件的关键配置技巧与常见问题。通过基础架构解析、时钟约束实践、物理约束调控及典型问题排查指南,帮助开发者高效掌握国产FPGA开发中的约束文件应用,提升开发效率与设计稳定性。

gin88的博客 908

开启智能体和知识库探索之旅:Dify知识库搭建RAG,大模型入门到精通,收藏这篇就足够了!

今天我们介绍一下用Dify搭建一个简单RAG知识库,基于Prompts+ Embedding+Rerank混合方案,实现更高准确率。

瓦罗兰特顶级C位的博客 1438

区块链技术在碳足迹数据存证与溯源中的应用深度解析

消费者扫描产品上的二维码,即可通过区块链浏览器查询到该产品的数字碳标签,并追溯其从茶园到货架的每一步碳足迹数据,以及这些数据是如何被智能合约自动计算和认证的,从而建立起强大的品牌信任。如果说哈希链解决了数据的“存”与“证”的问题,那么智能合约则解决了数据“用”与“管”的自动化问题。综上所述,虽然针对“碳足迹数据可追溯性”这一特定应用场景的公开、标准化的性能基准案例尚不丰富,但现有研究和企业级解决方案(特别是联盟链)已经证明,通过合理的技术选型和架构设计,区块链的性能可以满足实际商业需求。

百态·数智思维 | 聚焦大数据、量化与未来AI 1106

轻松搭建个人知识库,做知识的主人,知识库本地部署,收藏这篇就足够了

在这个数字化时代,我觉得个人知识库已经成为高效学习的必备工具。

2301_81888214的博客 1200

TCMSP数据库+R语言实战:从网页爬虫到中药-靶点网络图的全流程解析

本文详细解析了如何使用R语言从TCMSP数据库抓取中药-靶点数据,并通过数据清洗、网络分析和可视化构建完整的中药作用机制研究流程。涵盖动态网页爬虫、ADME参数筛选、网络图构建及高级可视化技巧,为中医药现代化研究提供实用的生物信息学方法。

weixin_31304817的博客 337

ResNet改进(45):结合通道混洗(ShuffleNet)的混合架构

本文提出了一种创新的卷积神经网络(CNN)架构CustomResNet,它将ResNet34与通道混洗(ChannelShuffle)技术相结合。该模型通过ShuffleBlock模块替换原始ResNet层,包含三个核心组件:1) ChannelShuffle模块实现通道分组混洗;2) ShuffleBlock模块整合点卷积、分组卷积和残差连接;3) CustomResNet主模型保持ResNet整体架构但替换核心层为ShuffleBlock。这种设计既保留了ResNet的残差学习能力,又通过通道混洗增强特

2401_82355416的博客 210

本地RAG知识库搭建全攻略,一文搞定大模型文档检索技术,值得收藏!

文章介绍了如何使用开源模型nomic-embed-text搭建本地RAG知识库,实现高效文档检索。详细说明了模型的基本信息、特性和性能优势,提供了完整的搭建步骤,包括下载模型、创建工作区、文档向量化与存储,以及检索测试。同时展示了模型的两种使用方式,通过Hugging Face Transformers或Nomic官方API,满足不同开发需求,让新手也能轻松上手构建自己的知识库。有些努力,虽然暂时看不见结果,却在悄悄改变你。-摘。

2401_85375298的博客 2062

从登录到应用可见:在 SAP S/4HANA Cloud Private Edition 中创建用户与打通 SAP Fiori 权限的完整思路

在SAP S/4HANA系统中,用户创建远非简单的账号开通,而是涉及认证、授权、数据访问等多维度的复杂过程。用户主数据记录(User Master Record)是系统访问的起点,包含登录方式、角色分配等关键信息。认证解决"你是谁"的问题,授权则决定"你能做什么"。SAP Fiori访问链路涉及Launchpad内容分配、应用启动映射、OData服务权限等多层校验。角色(Role)通过PFCG维护,包含业务目录(Catalog)和空间(Space)等元素,共同构成完整

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 149

Python入门到企业大模型实战:收藏这份系统学习指南,小白也能轻松掌握AI核心技能!

本文构建了企业大模型应用的完整知识框架,包含五个递进维度:Python编程基础(L1)、大模型核心原理与提示词工程(L2)、RAG构建企业知识库(L3)、Agent设计(L4)、大模型微调与部署(L5)。该体系从技术基础到业务落地,涵盖数据处理、模型优化、系统部署等全流程,强调实战应用与场景适配,帮助企业实现从技术选型到业务增值的完整闭环。每个模块均设置明确学习目标和实操内容,结合主流工具框架,兼顾理论深度与实践价值,助力企业高效构建专属AI能力。

Trb701012的博客 604

华为MetaERP PTP采购到应付全流程解析

摘要:本文系统解析华为MetaERP中的PTP(采购到应付)全流程管理方案,涵盖从采购申请到付款执行的完整业务流程。文章详细分解了PR、PO、GR、IV、AP等关键环节的财务核算规则,并提供了预算校验、库存更新等Python代码示例。同时阐述了IT落地架构设计,包括会计引擎配置、系统集成方案及银企直连支付接口实现。该方案通过三单匹配自动化和智能会计引擎,将处理效率提升10倍(200笔/人天→2000笔/人天),实现98%的自动化率,为集团企业提供了高效的数字化财务管理样板。文中所有技术方案均需根据实际场景调

金牌架构师 1743

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

手把手教你!轻松构建专属 RAG 知识库

1. 大语言模型(LLM)与RAG(检索增强生成)的组合架构,本质是“LLM+外部知识库”的协同模式,核心用来解决大模型的三大关键问题:生成内容“幻觉”、知识更新滞后、私域知识无法调用。 2. LLM+RAG架构的本质,是让大语言模型联动外部知识库——通过这种组合,精准破解大模型“幻觉”生成、知识时效性不足、私域知识难以接入的核心痛点。 大语言模型(LLM)结合RAG(检索增强生成)的架构,本质是“大模型+外部知识库”的融合方案,专门针对大模型“幻觉”、知识过时、私域知识不可用等问题提供解决方案。

qq_46094651的博客 948

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

【2025版】最新RAG知识库之知识库图谱应用,零基础入门到精通,收藏这篇就够了

上篇文章介绍了使用大模型构建生成知识图谱,其实也可不用大模型用其他方式构建生成知识图谱,但RAG要结合知识图谱使用关键还是怎么把图谱的内容查询出来;简单来说可以先查出在关联查出每个Chunk所关联的实体Entity再查询出实体之间的的;这里说的RAG结合知识图谱和微软开源的GraphRAG具体实现是不同的,效果提升会更好。在Neo4j中使用查询语言可以轻松实现图谱数据的查询,通过Chunk元数据fileName以及Document与Chunk节点的关系、Chunk与实体的关系。

Libra1313的博客 1776

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

收藏!从RAG到Agent Memory:大模型检索技术的完整演进指南,小白也能轻松掌握

文章详解了RAG技术的三阶段演进:1.0静态检索、2.0智能多步检索、3.0增加记忆写入的Agent Memory。通过智能客服案例展示区别,分析Agent Memory面临的写入策略、读取策略、遗忘机制和隐私安全挑战。结论:RAG未死,三者将共同构成知识+记忆+推理的一体化代理,支撑Agent发展。

datian1234的博客 839

企业本地知识库的搭建选型方案,大模型入门到精通,收藏这篇就足够了!

企业知识库的建立,可以有效的将信息/知识积累保存下来,并有利于加快企业内部信息和知识的流通,实现组织内部知识的共享。

Y525698136的博客 678

【大模型RAG实战】RAG与大模型应用,零基础入门到精通,收藏这篇就够了

一种能够生成各类内容的技术,包括文本、图像、音频和合成数据。自2022年底ChatGPT在全球范围内推广以来,基于Transformer解码器结构的大模型已能在短时间内为用户生成高质量的文本、表格、代码,使整个AI领域迈入了新的时代。大语言模型(Large Language Model,LLM)经过海量文本数据的训练后,能将这些文本数据以一种黑盒形式压缩在模型参数中。预训练完成后,模型便掌握了大量的人类知识世界。

Javachichi的博客 1172

【2025版】最新轻松搭建自己的RAG知识库,零基础入门到精通,收藏这篇就够了

Retrieval-Augmented Generation (检索增强生成)

leah126的博客 3040

10分钟,部署一个只属于你的大模型本地知识库-上篇(纯教程)大模型入门到精通,收藏这篇就足够了!

部署一个本地知识库,将你所有的东西都丢进去,一查即出,重要的是不用担心泄密,是不是很优秀。

pythonhy的博客 658

【2025版】最新轻松搭建自己的RAG知识库,(非常详细)零基础入门到精通,收藏这篇就够了

Retrieval-Augmented Generation (检索增强生成)

Libra1313的博客 1263

使用 AnythingLLM 轻松部署本地知识库,大模型入门到精通,收藏这篇就足够了!

AnythingLLM 是一个功能强大且灵活的工具,专为在本地环境中部署和管理知识库而设计。它支持多种数据格式的导入,并提供高效的搜索、索引和管理功能,适用于个人、团队或企业用户。

瓦罗兰特顶级C位的博客 614

如何用 Java 构建企业级 RAG 私有知识库系统?

用 Java 构建企业级 RAG 私有知识库,核心不是“和 Python 比模型调用便捷性”,而是“用 Java 生态解决企业最关心的安全、高可用、可扩展问题”。你的 Spring 微服务经验、分布式架构设计能力、安全管控经验,都是纯 Python 方案难以替代的。按“知识库构建→检索增强→大模型调用→工程化保障”的流程推进,复用 Java 成熟工具链,就能搭建出满足企业需求的 RAG 系统。

2501_91798322的博客 1257

打造本地私有化知识库系统:在家轻松部署Dify、FastGPT,大模型入门到精通,收藏这篇就足够了!

今天我要和大家分享一个本地知识库DIY项目:如何在家搭建自己的基于AI大模型的知识库系统。听起来是不是有点高大上?别担心,跟着我一步步来,保证你也能轻松上手!

瓦罗兰特顶级C位的博客 954
上一篇: A2A协议与大模型协作:小白也能掌握的AI Agent通信秘籍(收藏学习)
下一篇: 【建议收藏】2026春招AI人才争夺战白热化!小白/程序员必看,大模型学习黄金窗口期已至
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值