


对于35+程序员而言,转型大模型并非“从零重启”,核心是抓住“技术迁移+经验复用”两大关键,避开盲目跟风学习的内耗,精准匹配自身技术背景找对方向,才能快速实现职业升级,摆脱行业内卷困境。本文专为35岁及以上程序员整理,包含精准转型方向、高适配岗位清单、分阶段学习路径,还有避坑指南,小白也能看懂、程序员可直接落地,建议收藏慢慢看,转型路上少走弯路~

一、精准转型定位:按技术栈匹配两大方向,不做无用功
35岁转型的核心的是“扬长避短”,而非盲目追赶年轻人的学习节奏。结合自身技术背景,主要分为两大转型方向,每类方向都能最大化复用原有经验,降低转型门槛:
\1. 有数据/算法基础的程序员(含数据开发、大数据工程师、传统机器学习工程师、算法工程师):可直接主攻“大模型工程化”核心赛道,重点瞄准大模型微调工程师、模型部署专家、大模型数据策略师等高薪岗位。无需放弃多年积累的技术经验,核心是补充大模型专属技术栈——比如吃透Transformer架构核心逻辑、掌握LoRA/QLoRA等高效微调框架、熟练使用模型优化工具,将原有数据处理、模型训练、运维监控经验,无缝迁移到大模型应用场景中,实现“旧经验新价值”的增值效果,比从零学起效率提升50%以上。
\2. 纯业务开发程序员(含后端Java/Go/Python、前端Vue/React、移动端iOS/Android):无需焦虑“不懂算法、没接触过大数据”,“大模型应用落地”赛道就是最佳选择,比如RAG系统开发工程师、大模型插件开发工程师、AI全栈应用工程师、行业AI解决方案顾问等岗位,均无需深入底层算法。核心逻辑是“大模型工具+原有开发能力”的组合复用:后端开发可聚焦大模型API集成、服务封装与性能优化;前端开发可专攻AI交互界面设计、生成式UI开发;有电商、金融、医疗等行业业务经验的,重点打造“行业+AI”的差异化竞争力,这是年轻人难以替代的核心优势。
二、35岁适配的大模型岗位清单:避开内卷,发挥经验优势
35+程序员求职,更看重“落地能力、经验沉淀、岗位稳定性”,结合这一核心诉求,筛选出4类高适配、低内卷、需求旺盛的岗位,每类岗位都明确了核心要求与经验复用点,帮你快速匹配自身定位,避免盲目投递:
- 大模型工程化工程师:核心职责覆盖大模型训练、微调、量化、部署全流程落地,是目前市场需求最旺盛的岗位之一。核心要求:掌握Python/PyTorch基础、熟悉LoRA/QLoRA微调技术、懂Docker/K8s云原生技术、具备模型性能优化经验。经验复用点:原有后端运维、云原生部署、数据工程经验可直接复用,转型门槛最低,且薪资稳定(一线城市25-40K/月),适合有工程化经验的程序员。
- 大模型应用开发工程师:核心职责是基于大模型API或开源模型,开发贴合行业的AI应用系统,无需深入底层原理。核心要求:熟悉OpenAI/通义千问等主流大模型API、掌握LangChain/RAG技术栈、具备全栈开发能力、能精准拆解业务需求。经验复用点:原有业务系统开发、API集成、前后端联动经验可直接套用,上手最快,2-3个月就能积累可展示的项目经验,适合纯业务开发转型入门。
- 大模型行业解决方案顾问:35+程序员的“黄金岗位”,年龄越大、行业经验越深厚,竞争力越强。核心职责是结合行业痛点,设计大模型落地方案并推动实施。核心要求:具备某一行业(金融、医疗、工业、教育等)深度业务经验、了解大模型基础能力、具备方案撰写与客户沟通能力。经验复用点:多年行业业务开发、需求分析、项目管理经验,能快速精准捕捉行业痛点,比年轻从业者更易做出贴合实际的方案。
- 大模型技术支持/运维专家:适合追求稳定、不喜欢高强度编码的程序员。核心职责是大模型服务的日常运维、故障排查、性能监控、安全防护。核心要求:熟悉Linux系统、掌握容器化部署、具备日志分析与问题定位能力、了解大模型基础架构。经验复用点:原有IT运维、后端支撑、系统监控经验可直接复用,转型难度最低,工作强度适中,稳定性强。
确定岗位方向后,学习就要“靶向发力”——35岁转型,拒绝“广撒网”式学习,重点围绕岗位需求,复用原有经验,高效补充核心技能。下面分两大转型方向,给出分阶段、可落地的学习路径,每一步都明确“学什么、怎么学、做什么项目”,小白也能跟着走。
三、有数据/算法基础:转型大模型工程化(3步进阶,4-6个月落地)
适合有数据处理、模型训练经验的程序员,重点补充大模型专属工程化技术,复用原有算法、数据、运维经验,快速成长为“大模型工程化专家”,求职时突出“落地能力”,避开纯算法理论内卷。
第一步:补全大模型基础,衔接原有经验(1-2个月)
无需重新学习数学(原有概率、线性代数基础完全足够),重点是理解大模型核心架构与工具使用,快速打通“旧经验”与“新场景”的衔接,避免做无用功。
- 核心知识学习:① 大模型核心架构:重点吃透Transformer架构、注意力机制(必读论文《Attention Is All You Need》,结合原有机器学习基础理解,不用逐字逐句啃,1周可掌握核心逻辑);② 主流大模型认知:了解GPT、LLaMA、ChatGLM、文心一言的技术特点与适配场景(无需深入底层源码,知道“什么场景用什么模型、哪些模型适合微调、哪些适合部署”即可);③ 学习资源推荐:李沐《动手学深度学习》大模型章节(B站有免费视频,搭配笔记食用)、Hugging Face官方文档(最权威的大模型工具教程,小白可先看中文翻译版)。
- 核心工具实操:① 编程语言:强化Python(原有Java/Go程序员可快速迁移,重点掌握NumPy、Pandas数据处理库,1-2周就能搞定基础用法);② 大模型框架:重点学习Hugging Face Transformers(模型加载、微调基础)、PyTorch(张量操作、自定义数据集,复用原有机器学习框架经验,无需重新入门);③ 必做小项目:用Hugging Face加载ChatGLM-6B模型,实现“文本生成+多轮对话”功能(1-2周可完成,重点熟悉大模型工具链,不用追求复杂效果,能跑通流程即可)。
第二步:攻克大模型工程化核心能力(2-3个月)
这是转型的核心环节,重点掌握“微调、优化、部署”三大核心技能——这些能力直接对接岗位需求,是求职时的核心竞争力,也是原有经验复用的关键场景。
- 大模型微调技术:① 重点掌握LoRA、QLoRA高效微调技术(中小模型首选,落地场景广,无需大量算力,个人电脑就能实操,3-4天可掌握基础用法,1周可熟练运用);② 数据准备:学习大模型训练数据的清洗、标注、格式转换(复用原有数据处理经验,重点关注“数据质量对模型效果的影响”,比如去重、去噪、标注规范,这是很多小白容易忽略的点);③ 实战练习:用ChatGLM-6B微调金融领域文本数据(如金融新闻分类、风险事件识别),完整走完“数据准备→模型微调→效果评估”全流程,留存实操笔记和代码,为后续求职铺垫。
- 模型优化与部署:① 模型优化:学习INT4/INT8量化技术(核心是降低模型体积与算力需求,适配企业实际部署场景)、剪枝技术,推荐工具:GPTQ、AWQ、LLaMA.cpp(小白可先从GPTQ入手,操作更简单);② 部署落地:复用原有Docker/K8s经验,学习大模型容器化部署、用FastAPI封装模型API、实现服务高可用(重点练习“量化后模型的部署流程”,这是企业高频需求);③ 必做项目:将微调并量化后的ChatGLM-6B模型,部署到K8s集群,实现支持并发访问的对话服务(完整复刻企业级落地流程,求职时可作为核心项目展示,加分效果明显)。
第三步:行业落地+项目沉淀,对接求职(1个月)
35岁转型,“项目经验”比“证书”更重要——HR招聘35+程序员,最看重“能不能解决实际问题”。重点沉淀1-2个有行业属性的完整项目,突出工程化落地能力和经验复用优势。
- 行业场景实战:① 结合原有行业经验,开发大模型行业应用(如原有金融经验:做“大模型金融舆情分析系统”;原有医疗经验:做“医学文献问答系统”),贴合自身经验,开发效率更高,也能突出差异化;② 补充运维监控能力:学习大模型服务的性能监控(响应时间、吞吐量)、异常检测、版本管理(复用原有运维经验,重点关注大模型特有的监控指标,比如模型推理延迟、显存占用)。
- 项目沉淀与求职准备:① GitHub项目沉淀:每个项目需包含“需求文档、技术方案、代码实现、部署流程、效果评估”,重点突出“工程化落地”和“经验复用”亮点(比如“复用原有数据处理经验,优化训练数据质量,提升模型准确率15%”);② 开源贡献:参与Hugging Face生态、vLLM(大模型部署工具)等开源项目的Issue修复、文档优化,不用做复杂贡献,简单的文档纠错、Issue回复,也能提升行业认可度;③ 简历优化:重点写“原有经验如何迁移到大模型场景”“完成的大模型项目及业务价值”,避开“纯算法理论”描述,比如不说“精通Transformer架构原理”,要说“基于Transformer架构,完成ChatGLM-6B模型微调与部署,支撑企业对话服务落地”。
四、纯业务开发:转型大模型应用落地(3步上手,2-4个月见效)
适合后端、前端、移动端等纯业务开发程序员,核心原则是“不深入大模型底层原理,用好大模型工具,解决业务问题”。全程复用原有开发经验,快速实现从“业务开发”到“AI应用开发”的转型,2-4个月就能积累可展示的项目经验,对接求职需求。
第一步:掌握大模型API与核心工具(1-2个月)
核心是“快速上手能直接落地的工具”,利用原有编程基础,实现大模型能力的快速集成,完成初步转型过渡——不用学习复杂的算法知识,小白也能快速上手。
- 大模型API实战:① 熟练使用主流API:OpenAI API、通义千问API、百度文心一言API(重点学习接口调用、参数调优、多轮对话、上下文管理,小白可先从通义千问API入手,中文适配更好,文档更易懂);② Prompt工程基础:掌握“角色设定+任务描述+约束条件”的黄金指令结构(比如“作为电商客服助手,精准回答用户订单查询问题,语气亲切,简洁明了,不泄露无关信息”),提升API调用效果,这是很多小白容易忽略的“低成本提效点”;③ 必做小项目:用Python+Flask/FastAPI封装OpenAI API,开发“智能问答接口”,支持多轮对话(复用原有后端API开发经验,1周可完成,重点跑通流程,后续可逐步优化)。
- 核心应用工具学习:① RAG系统核心工具:LangChain(大模型应用开发框架,小白必学)、Milvus/Pinecone(向量数据库,重点学习Milvus,中文文档完善,上手简单),掌握“文档加载→文本分割→向量存储→检索问答”全流程(RAG是大模型应用的核心场景,几乎所有AI应用都会用到,必须掌握);② 全栈能力补充:若有前端经验,学习React+AI组件开发(如集成文本生成、图像生成的前端界面);若无前端经验,可复用后端经验,重点做“API服务+数据处理”,不用强行补前端,聚焦自身优势;③ 学习资源推荐:LangChain中文教程、Milvus官方文档、B站“大模型应用开发”实战视频(跟着做1-2个案例,快速上手,比单纯看文档效率高)。
第二步:聚焦业务场景,开发完整AI应用(1-2个月)
这是转型的关键一步——重点锻炼“将大模型能力与行业业务结合”的能力,沉淀可展示的完整项目,直接对接岗位需求。全程复用原有业务开发经验,不用做无意义的技术堆砌。
- 经典场景实战:① RAG系统开发:基于LangChain+Milvus开发“企业知识库问答系统”(如公司内部文档查询助手),覆盖“文档上传→检索→问答→权限管理”全流程(复用原有业务系统开发经验,是求职高频项目,几乎所有AI公司都会考察);② 大模型插件开发:开发适配ChatGPT的“电商订单查询插件”“天气查询插件”,学习插件开发规范、API对接、身份验证逻辑(复用原有第三方API集成经验,难度不高,却能体现实操能力);③ 全栈AI应用:开发“智能写作助手”(前端+后端+大模型API),实现文本生成、编辑、导出、模板管理功能(展示全栈能力,适合转型AI全栈工程师,求职时竞争力更强)。
- 工程化落地优化:① 复用Docker/K8s经验,将AI应用容器化部署,实现服务高可用、可扩展(贴合企业实际部署需求,提升项目含金量);② 性能优化:学习大模型API调用缓存、并发控制、错误重试、限流熔断机制(复用原有后端性能优化经验,提升应用稳定性,这是区别于小白的核心亮点)。
第三步:沉淀行业解决方案,提升求职竞争力(1个月)
35岁程序员的核心竞争力,从来不是“技术多新”,而是“行业经验+技术能力”的结合。这一步要将“AI应用开发”与“原有行业经验”深度绑定,打造差异化优势,让年轻从业者无法替代。
- 行业解决方案沉淀:① 结合原有行业经验,输出1份“大模型行业落地方案”(如原有电商经验:《电商智能客服+商品推荐大模型落地方案》;原有教育经验:《智能题库生成与个性化辅导大模型方案》);② 方案需包含“行业痛点、大模型应用场景、技术架构、实施步骤、预期效果”,重点突出“用技术解决业务问题”的核心逻辑,不用堆砌专业术语,贴合企业实际需求即可。
- 求职准备与投递:① 项目与方案沉淀:将完整项目代码上传GitHub,方案文档整理成PDF,作为求职附件(HR能快速看到你的实操能力和行业认知);② 岗位投递:优先选择有你原有行业经验的AI公司(如原有金融经验,投递金融科技AI公司),这类公司更看重你的行业认知,年龄不是障碍;③ 面试技巧:重点讲解“原有经验如何迁移到AI项目”“项目解决的业务问题”“工程化落地的难点与解决方案”,少讲纯理论,多讲实战细节(比如“开发RAG系统时,如何解决检索准确率低的问题,复用原有数据检索经验,优化文本分割策略,提升准确率20%”)。
五、两大转型方向核心对比(一目了然,快速选型)
| 对比维度 | 大模型工程化方向 | 大模型应用落地方向 |
|---|---|---|
| 适配人群 | 数据开发、大数据、传统机器学习、算法工程师 | 后端、前端、移动端等纯业务开发程序员 |
| 核心技能 | 1. Python/PyTorch;2. LoRA/QLoRA微调;3. 模型量化与部署;4. 云原生(Docker/K8s) | 1. 大模型API调用;2. LangChain/RAG开发;3. 全栈开发;4. 业务需求拆解 |
| 学习周期 | 4-6个月(复用数据/工程经验,效率更高) | 2-4个月(复用业务开发经验,见效最快,小白首选) |
| 核心工具 | Hugging Face、PyTorch、GPTQ/AWQ、vLLM、K8s | OpenAI/通义千问API、LangChain、Milvus、FastAPI/Flask、React/Vue |
| 代表项目 | 1. 金融大模型微调项目;2. 大模型量化部署系统;3. 行业大模型落地平台 | 1. 企业RAG知识库系统;2. 大模型电商插件;3. 智能写作全栈应用 |
| 职业发展 | 大模型工程化工程师→高级专家→技术负责人→架构师 | AI应用开发工程师→行业解决方案专家→AI业务负责人→创业 |
| 薪资水平 | 25-40K/月(一线城市),需求稳定,薪资涨幅可观 | 20-35K/月(一线城市),入门门槛低,晋升空间大,后期可转型管理 |
六、35岁转型避坑指南:4个关键提醒,少走1年弯路
35岁转型,“避坑”比“努力”更重要——很多程序员转型失败,不是能力不够,而是踩了盲目学习、脱离经验等误区。以下4个避坑点,一定要牢记:
- 避坑1:不要盲目学底层算法。35岁转型不是“重返校园”,无需深入研究大模型数学原理、逐字啃论文,重点放在“工程化落地”“应用开发”上,快速兑现价值,避免陷入“学了不会用”的内耗。
- 避坑2:不要忽视项目沉淀。HR招聘35+程序员,最看重“能不能解决实际问题”,1个完整的行业项目(带代码、带部署流程、带效果评估),比10个理论课程、10本证书更有说服力,拒绝“纸上谈兵”。
- 避坑3:不要脱离原有行业经验。转型时优先选择有你原有行业经验的AI公司,你的行业认知、业务理解,是年轻从业者不具备的核心优势,能让你快速建立竞争力,避免和年轻人在“纯技术熟练度”上内卷。
- 避坑4:不要追求“全能”。大模型技术体系庞大,从底层算法到上层应用,覆盖范围极广。35岁转型,要聚焦一个细分赛道(如工程化、RAG应用、行业解决方案)深耕,成为“细分领域专家”,比“什么都懂一点、什么都不精”更易求职、更易拿到高薪。
最后想说
35岁程序员转型大模型,从来不是“被迫转行”,而是“技术升级”“经验增值”的选择。你多年的编程积淀、工程经验、行业认知,都不是无用功,而是转型路上最坚实的底气。
不用害怕年龄,不用焦虑不懂新技术——35岁的你,比年轻人更懂业务、更懂落地、更懂如何解决实际问题,这才是你的核心竞争力。只要找准方向、高效复用经验、扎实沉淀项目,就能平稳过渡到大模型新赛道,甚至实现职业的“二次腾飞”。
建议收藏本文,转型路上遇到困惑时,随时翻看——愿每一位35+程序员,都能避开内卷,在大模型赛道上,找到属于自己的职业新可能~
那么,如何系统的去学习大模型LLM?
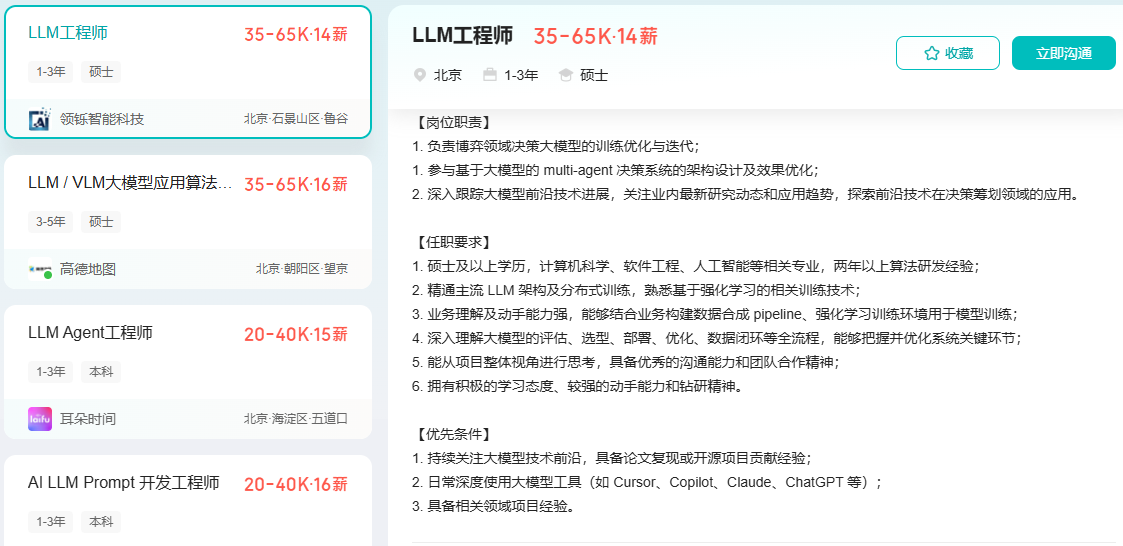
到2026年,大型语言模型将不再是“实验性工具”,而将成为核心基础设施。 过去三年,大型语言模型(LLM)已从研究实验室走向生产系统,为客户支持、搜索、分析、编码助手、医疗保健工作流程、金融和教育等领域提供支持。但在这股热潮背后,一些重要的事情正在发生:
企业不再招聘“人工智能爱好者”,而是招聘大语言模型LLM工程师。在2026年迅速成为排名前五的科技职业之一。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
为了让大家不浪费时间踩坑!2026 年最新 AI 大模型全套学习资料已整理完毕,不管你是想入门的小白,还是想转型的传统程序员,这份资料都能帮你少走 90% 的弯路
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
下面是我整理的大模型学习资源,希望能帮到你。
👇👇扫码免费领取全部内容👇👇

大模型资料包分享

1、 AI大模型学习路线图(含视频解说)

2、从入门到精通的全套视频教程

3、学习电子书籍和技术文档

4、 AI大模型最新行业报告
2026最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

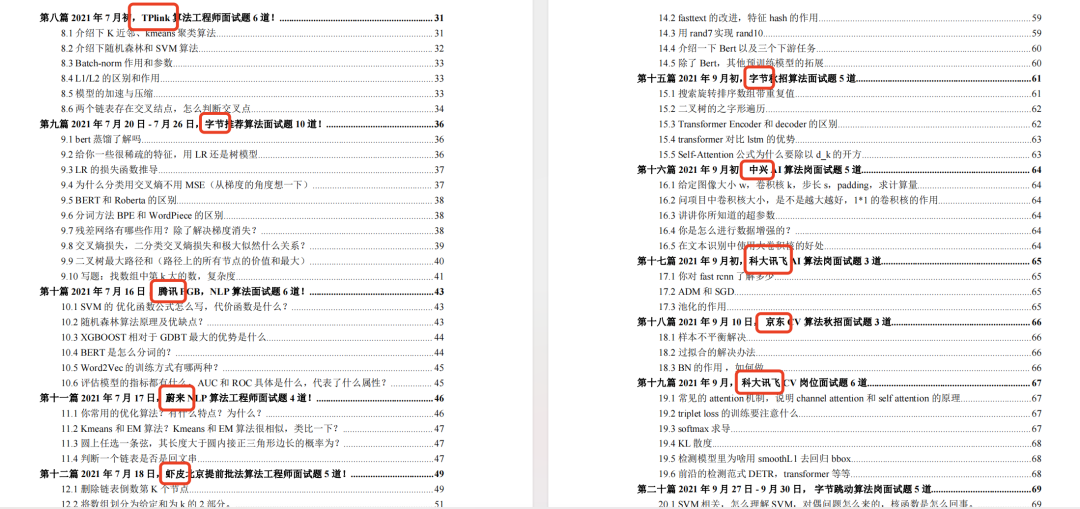
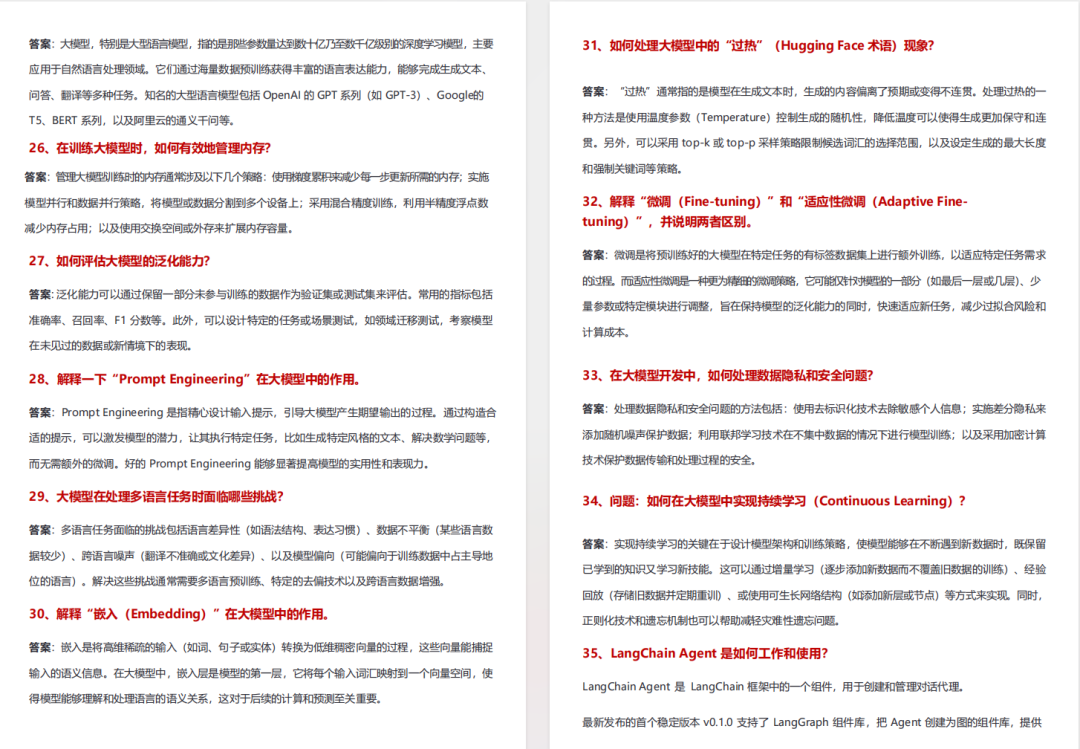
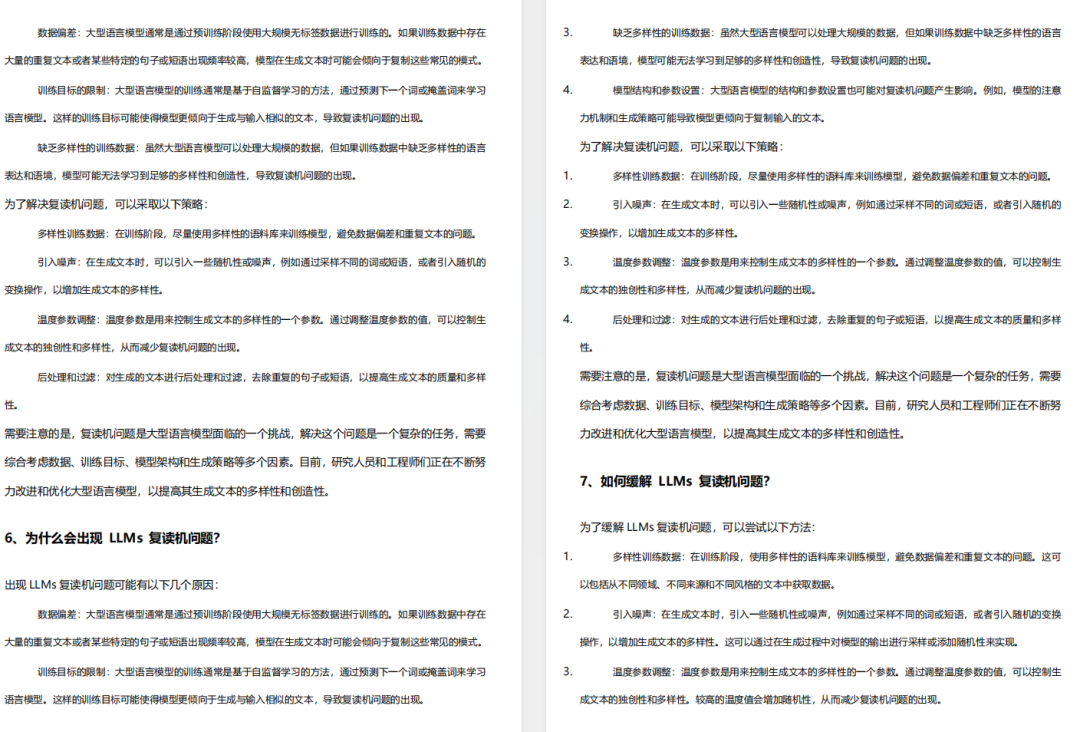
5、各大厂大模型面试题目详解

【大厂 AI 岗位面经分享(107 道)】
【AI 大模型面试真题(102 道)】
【LLMs 面试真题(97 道)】
6、大模型项目实战&配套源码

适用人群


👇👇扫码免费领取全部内容👇👇
3、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 113


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


