


本文详细分析了RAG系统中的九种主要文本分块策略,包括固定大小、基于句子、基于语义、递归、滑动窗口、层次化、基于主题、特定模态和智能代理分块。每种策略都有其适用场景、优势、局限性和实现方法。选择合适的分块策略需综合考虑文档类型、应用需求、计算资源和性能要求,开发者可根据具体需求选择单一策略或组合多种策略,以构建高效准确的RAG系统。
检索增强生成(Retrieval-Augmented Generation, RAG)技术通过将外部知识检索与大语言模型生成能力相结合,实现了基于检索文本块(chunk)上下文的高质量内容生成。RAG系统的性能很大程度上依赖于文本分块策略的选择和实施。
文本分块是RAG系统中的关键预处理环节,文本块定义为从大型文档或数据集中按照特定规则和策略分割而成的文本片段,这些片段将被嵌入并索引到RAG知识库中以支持检索操作。例如,简单的文档分割可以产生两个独立的文本块,如下图所示。

文本块作为可管理的嵌入、索引和检索单元发挥着核心作用。检索系统通过这些单元为查询找到相关上下文,相较于将完整文档传递给生成模型,传递最相关的文本段落在计算效率和响应质量方面都具有明显优势。
不同的分块策略各有其适用场景、优势和局限性。本文将深入分析九种主要的文本分块策略及其具体实现方法。下图概括了我们将要讨论的内容。

文本分块技术概述
文本分块是将大型文档分解为可管理处理单元的结构化过程。该过程的目标是将文档重新组织为多个部分,使RAG系统能够根据输入查询高效检索最相关的内容片段。
RAG系统的工作机制是在推理阶段对查询进行嵌入编码,然后从向量数据库中检索前k个最相关的文本块。这些文本块作为上下文信息提供给生成模型,以产生准确且相关的响应。
文本块的粒度可以从句子级别扩展到段落或章节级别,具体取决于应用场景和所采用的分割规则。这些规则构成了我们所说的分块策略。目前存在多种分块策略,每种策略都有其特定的优势和限制条件。
1、固定大小分块策略(Fixed-Size Chunking)
固定大小分块是一种将文本按照统一长度标准进行分割的策略,分割标准可以是词数、标记数或字符数。例如,可以将文档分割为每块包含200个词的片段。
该方法基于直接的文本分割操作,实现简单且计算效率高。当需要确保输入数据具有一致尺寸时(如为具有固定输入维度的机器学习模型提供数据),通常采用这种策略。

固定大小分块的主要优势包括实现简单快速,需要最少的计算资源或语言分析,可以快速部署;同时具有良好的可预测性,生成的统一大小文本块简化了数据库中的存储、索引和检索操作。
然而,该策略也存在明显的局限性。首先是上下文碎片化问题,由于分割位置的随意性,经常会切断句子或段落,从而破坏语义完整性。其次是缺乏灵活性,无法适应文本的自然结构和流程,可能将相关概念分离到不同的文本块中。
以下代码演示了固定大小分块策略的实现:
deffixed_size_chunk(text, chunk_size=500):

    words=text.split()

    return [" ".join(words[i:i+chunk_size]) foriinrange(0, len(words), chunk_size)]

chunks=fixed_size_chunk(pdf_text, chunk_size=500)
2、基于句子的分块策略(Sentence-Based Chunking)
基于句子的分块策略根据句子边界对文本进行分割。实现方式可以采用基于句点符号的简单规则,或者使用spaCy、NLTK等自然语言处理库来准确识别句子边界。
该策略尊重语法和上下文单元的完整性,特别适用于句子完整性至关重要的任务,如机器翻译或情感分析等应用场景。

基于句子分块的主要优势在于语义保持能力,通过保持完整句子结构,显著降低了语义信息丢失的风险。该策略遵循自然的语言边界,与人类阅读习惯保持一致,提高了结果的可解释性。
该策略的局限性主要体现在文本块大小的可变性上。短句子会产生过小的文本块,而长句子可能超出预期的大小限制,导致处理的不一致性。此外该方法依赖自然语言处理工具的质量,句子分词器在处理复杂标点符号或非标准文本时可能出现错误。
使用spaCy库实现基于句子的分块策略的代码如下:
importspacy

nlp=spacy.load("en_core_web_sm")

defsentence_chunk(text):

    doc=nlp(text)

    return [sent.text.strip() forsentindoc.sents]

chunks=sentence_chunk(pdf_text)
3、基于语义的分块策略(Semantic-Based Chunking)
基于语义的分块策略通过分析文本的语义内容来进行分组。该方法通常使用嵌入技术计算句子或段落之间的语义相似性,根据设定的语义阈值(如余弦相似度)形成聚类,确保文本块内容在语义上具有高度相关性。

该策略的主要优势在于能够生成具有强语义关联的文本块,这种上下文相关性使其特别适合检索增强生成应用。同时,该方法具有良好的适应性,能够动态适应文档内容,避免了严格大小限制带来的问题。
基于语义分块的局限性主要体现在计算成本方面,嵌入生成和相似性计算是资源密集型操作,在大规模数据集上可能面临性能瓶颈。该方法对阈值参数较为敏感,需要仔细调整以平衡文本块大小和相关性,存在过度碎片化或过度聚合的风险。
以下代码实现了基于语义的分块策略:
importspacy

fromsentence_transformersimportSentenceTransformer, util

nlp=spacy.load("en_core_web_sm")

model=SentenceTransformer("all-MiniLM-L6-v2")

defsemantic_embedding_chunk(text, threshold=0.75):

    """

    使用句子嵌入将文本分割成语义块。

    使用 spaCy 进行句子分割,使用 SentenceTransformer 生成嵌入。

    :param text: 要分块的完整文本。

    :param threshold: 用于将句子添加到当前块的余弦相似度阈值。

    :return: 语义块列表(每个块为字符串)。

    """

    # 句子分割

    doc=nlp(text)

    sentences= [sent.text.strip() forsentindoc.sentsifsent.text.strip()]

    chunks= []

    current_chunk_sentences= []

    current_chunk_embedding=None

    forsentenceinsentences:

        # 为当前句子生成嵌入

        sentence_embedding=model.encode(sentence, convert_to_tensor=True)

        # 如果开始一个新的块,则用当前句子初始化它

        ifcurrent_chunk_embeddingisNone:

            current_chunk_sentences= [sentence]

            current_chunk_embedding=sentence_embedding

        else:

            # 计算当前句子与块嵌入之间的余弦相似度

            sim_score=util.cos_sim(sentence_embedding, current_chunk_embedding)

            ifsim_score.item() >=threshold:

                # 将句子添加到当前块,并更新块的平均嵌入

                current_chunk_sentences.append(sentence)

                num_sents=len(current_chunk_sentences)

                current_chunk_embedding= ((current_chunk_embedding* (num_sents-1)) +sentence_embedding) /num_sents

            else:

                # 完成当前块并开始一个新块

                chunks.append(" ".join(current_chunk_sentences))

                current_chunk_sentences= [sentence]

                current_chunk_embedding=sentence_embedding

    # 如果存在,则附加最后一个块

    ifcurrent_chunk_sentences:

        chunks.append(" ".join(current_chunk_sentences))

    returnchunks

semantic_chunks=semantic_embedding_chunk(pdf_text, threshold=0.75)

fori, chunkinenumerate(semantic_chunks):

    print(f"Chunk {i+1}:\n{chunk}\n{'-'*60}")
通过调整阈值参数,可以控制文本块的语义聚合程度,实现不同粒度的分块效果。
4、递归分块策略(Recursive Chunking)
递归分块是一种迭代式文本分割策略,按照层次化的分割规则(如段落、句子、词汇)逐步分割文本,直到文本块满足预设的大小约束。例如,当一个长段落超出大小限制时,系统会进一步将其分割为句子和更小的标记组合。

递归分块的主要优势在于能够严格遵守大小限制,确保所有生成的文本块都符合预设的尺寸要求。同时,该策略具有良好的灵活性,能够优雅地处理各种长度的文本内容,适应不同类型的文档结构。
该策略的局限性主要体现在碎片化风险和处理效率方面。过度分割可能破坏文本的连贯性和语义完整性,而多层递归处理会显著增加计算时间,在处理大规模文档时可能影响系统性能。
递归分块的实现代码如下:
importPyPDF2

defiterative_chunk(text, max_length=500):

    chunks= []

    whilelen(text) >max_length:

        separators= ["\n\n", "\n", " ", ""]

        found=False

        forsepinseparators:

            ifsep=="":

                # 如果没有找到分隔符,则直接在 max_length 处截断文本。

                chunk=text[:max_length]

                chunks.append(chunk.strip())

                text=text[max_length:]

                found=True

                break

            idx=text.rfind(sep, 0, max_length)

            ifidx!=-1andidx!=0:

                chunk=text[:idx]

                chunks.append(chunk.strip())

                text=text[idx:]

                found=True

                break

        ifnotfound:

            # 如果没有找到合适的分隔符,则直接在 max_length 处截断。

            chunk=text[:max_length]

            chunks.append(chunk.strip())

            text=text[max_length:]

    iftext.strip():

        chunks.append(text.strip())

    returnchunks

chunks=iterative_chunk(pdf_text, max_length=500)
开发者可以根据具体需求调整递归逻辑,实现最适合特定应用场景的分块模式。
5、滑动窗口分块策略(Sliding-Window Chunking)
滑动窗口分块策略通过在文本上移动固定大小的窗口来创建具有重叠内容的文本块。例如,使用200个标记的窗口大小,每次移动150个标记(重叠50个标记),这种重叠机制确保上下文信息能够跨越相邻文本块传递,有效减轻边界信息丢失的问题。

该策略的主要优势在于上下文连续性的保持,重叠区域确保了跨文本块的概念关系得以保留,这对于需要理解文档整体脉络的应用特别重要。同时,窗口大小和重叠程度的可调性使其能够适应不同的应用需求和文档特征。
滑动窗口分块的局限性主要表现为存储冗余和计算负载增加。重复内容会增加存储成本并使去重处理变得复杂,而重叠区域的存在会增加下游任务的处理步骤和计算资源消耗。
Python实现代码如下:
importPyPDF2

defsliding_window_chunk(text, window_size=100, overlap=20):

    words=text.split()

    chunks= []

    step=window_size-overlap

    foriinrange(0, len(words), step):

        chunk=" ".join(words[i:i+window_size])

        chunks.append(chunk)

    returnchunks

chunks=sliding_window_chunk(pdf_text, window_size=100, overlap=20)
6、层次化分块策略(Hierarchical Chunking)
层次化分块策略利用文档的内在结构(如标题、章节、小节)来创建具有嵌套关系的文本块。该策略反映了文档的逻辑组织结构,例如章节作为父级文本块包含多个小节子块,而小节又包含段落级别的内容。这种结构类似于XML或HTML的树形组织框架。

层次化分块的主要优势在于结构保真性,能够保持文档的逻辑流程和多层次上下文关系。该策略支持多粒度访问模式,用户可以从广泛的主题概念深入到具体的细节内容,实现灵活的信息检索。
该策略的局限性主要体现在对文档结构的依赖性上,需要处理格式良好的结构化文档,对于非结构化文本的处理能力有限。此外,实现复杂性较高,需要构建稳健的算法来检测标题、列表或标记标签等结构元素。
层次化分块可以采用手动和自动两种实现方式。手动方式根据预定义的标记进行分割:
# 手动层次化分块

importPyPDF2

defhierarchical_chunk_manual(text, markers=["INTRODUCTION", "CONCLUSION"]):

    """

    根据手动提供的标记将文本分割成块。

    """

    lines=text.splitlines()

    chunks= []

    current_chunk= []

    forlineinlines:

        # 如果在行中找到任何手动标记并且已经有累积的内容

        ifany(markerinlineformarkerinmarkers) andcurrent_chunk:

            chunks.append("\n".join(current_chunk).strip())

            current_chunk= [line]

        else:

            current_chunk.append(line)

    ifcurrent_chunk:

        chunks.append("\n".join(current_chunk).strip())

    returnchunks

manual_chunks=hierarchical_chunk_manual(pdf_text, markers=["INTRODUCTION", "CONCLUSION"])
自动层次化分块通过算法逻辑检测文档结构,甚至可以结合大语言模型来实现:
# 自动层次化分块

defdetect_markers(text):

    """

    自动检测潜在的标题标记。

    启发式方法:任何短行(<= 10 个词)且全部大写或以冒号结尾的行都被视作标记。

    """

    lines=text.splitlines()

    markers= []

    forlineinlines:

        words=line.split()

        ifwordsandlen(words) <=10:

            ifline.isupper() orline.endswith(":"):

                markers.append(line.strip())

    returnlist(set(markers))

defhierarchical_chunk_auto(text):

    """

    使用自动检测到的标记将文本分割成块。

    返回块和检测到的标记。

    """

    auto_markers=detect_markers(text)

    # 按出现顺序对标记进行排序

    lines=text.splitlines()

    detected= []

    forlineinlines:

        formarkerinauto_markers:

            ifmarkerinlineandmarkernotindetected:

                detected.append(marker)

    chunks= []

    current_chunk= []

    forlineinlines:

        # 如果找到任何检测到的标记并且有累积的文本,则开始一个新的块

        ifany(markerinlineformarkerindetected) andcurrent_chunk:

            chunks.append("\n".join(current_chunk).strip())

            current_chunk= [line]

        else:

            current_chunk.append(line)

    ifcurrent_chunk:

        chunks.append("\n".join(current_chunk).strip())

    returnchunks, detected

auto_chunks, auto_markers=hierarchical_chunk_auto(pdf_text)
7、基于主题的分块策略(Topic-Based Chunking)
基于主题的分块策略应用机器学习聚类算法(如潜在狄利克雷分配LDA、k-means聚类)按照主题相关性对文本进行分组。该方法通过词频分析或嵌入向量模式识别,生成代表连贯主题的文本块,例如"气候变化"或"市场趋势"等专题内容。

该策略的主要优势在于主题一致性,能够显著提高主题驱动应用程序中的检索准确性。同时具有良好的动态分组能力,无需预定义规则即可自适应文档内容,实现智能化的内容组织。
基于主题分块的局限性主要体现在主题重叠问题上,语义模糊的文本可能同时属于多个聚类,需要额外的消歧处理。此外,主题建模算法的计算开销较大,在大规模数据集上的扩展性存在挑战。
以下代码实现了基于主题的分块策略:
fromsklearn.feature_extraction.textimportCountVectorizer

fromsklearn.decompositionimportLatentDirichletAllocation

deftopic_based_chunk(text, n_topics=2):

    # 将文本分割成句子(使用句点后跟空格作为简单的分割符)

    sentences=text.split('. ')

    vectorizer=CountVectorizer(stop_words='english')

    X=vectorizer.fit_transform(sentences)

    lda=LatentDirichletAllocation(n_components=n_topics, random_state=42)

    lda.fit(X)

    topic_distribution=lda.transform(X)

    topics= {}

    fori, sentinenumerate(sentences):

        topic=topic_distribution[i].argmax()

        topics.setdefault(topic, []).append(sent)

    returntopics

topics=topic_based_chunk(pdf_text, n_topics=2)
8、特定模态分块策略(Modality-Specific Chunking)
特定模态分块策略专门处理包含多种内容类型的混合文档,将文本、图像、表格等不同模态的内容分离为相应的处理片段。该方法为每种模态采用专门的处理工具,例如将表格提取为CSV格式,图像保存为PNG格式,文本内容组织为段落结构,并使用OCR等技术处理图像中的文本信息。

该策略的主要优势在于能够保持不同模态内容的完整性,维护非文本元素的结构和语义信息。同时,针对每种内容类型的定制化处理能够实现最优的信息提取和处理效果。
特定模态分块的局限性主要表现为系统复杂性的显著增加,需要为每种模态建立专门的处理管道,并设计逻辑将不同模态的输出重新整合。此外,该方法需要多种专门工具的支持,如表格提取器、图像分类器等,增加了资源开销和维护成本。
以下代码演示了特定模态分块策略的基础实现:
import PyPDF2

import pdfplumber

def extract_pdf_text(pdf_path):

    """

    使用 PyPDF2 从 PDF 的每一页提取文本,并将其作为一个字符串返回。

    """

    reader = PyPDF2.PdfReader(pdf_path)

    full_text = ""

    for page in reader.pages:

        page_text = page.extract_text()

        if page_text:

            full_text += page_text + "\n\n"  # 使用双换行符分隔页面

    return full_text

def extract_tables(pdf_path):

    """

    使用 pdfplumber 从 PDF 中提取表格。

    返回一个表格列表(每个表格是一个列表的列表)。

    """

    tables = []

    with pdfplumber.open(pdf_path) as pdf:

        for page in pdf.pages:

            page_tables = page.extract_tables()

            for table in page_tables:

                tables.append(table)

    return tables

def extract_images(pdf_path):

    """

    使用 PyPDF2 从 PDF 中提取图像。

    注意:PyPDF2 的图像提取功能有限。

    返回一个包含图像数据和元数据的字典列表。

    """

    reader = PyPDF2.PdfReader(pdf_path)

    images = []

    for page_num, page in enumerate(reader.pages):

        resources = page.get("/Resources")

        if resources and "/XObject" in resources:

            xObject = resources["/XObject"].get_object()

            for obj in xObject:

                if xObject[obj].get("/Subtype") == "/Image":

                    data = xObject[obj].get_data()

                    # 从过滤器确定图像类型

                    if "/Filter" in xObject[obj]:

                        if xObject[obj]["/Filter"] == "/DCTDecode":

                            ext = "jpg"

                        elif xObject[obj]["/Filter"] == "/FlateDecode":

                            ext = "png"

                        else:

                            ext = "bin"

                    else:

                        ext = "bin"

                    images.append({"page": page_num, "data": data, "ext": ext})

    return images

def modality_chunk(pdf_path):

    """

    从 PDF 文件中提取文本、表格和图像。

    - 文本被分割成段落(使用双换行符)。

    - 表格使用 pdfplumber 提取。

    - 图像使用 PyPDF2 提取。

    返回一个字典,键为:"text_chunks"、"tables" 和 "images"。

    """

    text = extract_pdf_text(pdf_path)

    text_chunks = [p.strip() for p in text.split("\n\n") if p.strip()]

    tables = extract_tables(pdf_path)

    images = extract_images(pdf_path)

    return {"text_chunks": text_chunks, "tables": tables, "images": images}

result = modality_chunk(pdf_file)
9、智能代理分块策略(Agentic Chunking)
智能代理分块策略利用大语言模型和智能代理技术动态识别最优的文本分割点或选择最适合的分块技术。该方法依赖智能代理执行类似人类专家在分析和分割文档时的决策过程,实现高度智能化的文本处理。

该策略的主要优势在于具备上下文感知能力,能够生成类似人类专家水平的精细化文本块。同时具有出色的适应性,能够根据文档类型、写作风格和内容复杂性进行动态调整,提供个性化的分块解决方案。
智能代理分块的局限性主要体现在成本和延迟方面,多次大语言模型API调用会显著增加费用和处理时间。此外,该方法对提示工程的质量高度敏感,输出质量很大程度上依赖于精心设计的提示模板。
以下代码基于Ranjith的智能代理分块方法,通过大语言模型生成的命题执行分块,并使用智能代理创建文本块组:
import uuid

import google.generativeai as genAI

import time

from typing import List, Dict

import os

class AgenticChunker:

    def __init__(self):

        self.chunks = {}  # 块信息

        self.agent = genAI.GenerativeModel("gemini-2.0-flash")  # 更新的模型名称

        self.chunk_id_length = 5  # 用于截断块 ID

        self.configure = genAI.configure(api_key="YOUR-API-KEY")

    def add_propositions(self, propositions: List[str]):

        """带速率限制地添加多个命题"""

        for idx, proposition in enumerate(propositions):

            print(f"Processing proposition {idx+1}/{len(propositions)}")

            self.add_proposition(proposition)

            time.sleep(4)  # 在命题之间等待 4 秒以遵守 15 rpm 的限制

    def add_proposition(self, proposition: str):

        """将单个命题添加到适当的块中"""

        print(f"Evaluating: {proposition[:50]}...")  # 显示截断的命题

        if not self.chunks:

            print("No existing chunks - creating first chunk")

            self.create_new_chunk(proposition)

            return

        relevant_chunk_id = self.find_relevant_chunk(proposition)

        if relevant_chunk_id:

            print(f"Adding to existing chunk: {self.chunks[relevant_chunk_id]['title']}")

            self.add_proposition_to_chunk(relevant_chunk_id, proposition)

        else:

            print("Creating new chunk for proposition")

            self.create_new_chunk(proposition)

    def add_proposition_to_chunk(self, chunk_id: str, proposition: str):

        """将命题添加到现有块并更新元数据"""

        self.chunks[chunk_id]["propositions"].append(proposition)

        # 批量更新以减少 API 调用:当达到 3 个命题的倍数时更新

        if len(self.chunks[chunk_id]["propositions"]) % 3 == 0:

            self.chunks[chunk_id]["summary"] = self.update_chunk_summary(self.chunks[chunk_id])

            self.chunks[chunk_id]["title"] = self.update_chunk_title(self.chunks[chunk_id])

    def _generate_content(self, prompt: str) -> str:

        """Gemini API 调用的包装器,具有错误处理和速率限制功能"""

        try:

            response = self.agent.generate_content(prompt)

            # 每次 API 调用后等待 5 秒,以避免超出速率限制

            time.sleep(5)

            return response.text.strip()

        except Exception as e:

            print(f"API Error: {str(e)}")

            return ""  # 返回空字符串以防止管道故障

    def update_chunk_summary(self, chunk: Dict) -> str:

        """生成更新的块摘要"""

        prompt = f"""

        您是一组代表关于相似主题的句子的块的管理者。

        刚刚添加了一个新的命题。生成一个非常简短的 1 句话摘要,告知查看者该块的内容。

        仅回复新的摘要,不要包含其他内容。

        块的命题:

        {chr(10).join(chunk['propositions'][-3:])}

        当前摘要: {chunk['summary'] if 'summary' in chunk else ''}

        """

        return self._generate_content(prompt)

    def update_chunk_title(self, chunk: Dict) -> str:

        """生成更新的块标题"""

        prompt = f"""

        您是一组代表相关命题的块的管理者。

        刚刚添加了一个新的命题。生成一个非常简短的更新块标题(2-4 个词),总结该块的主题。

        仅回复新的标题,不要包含其他内容。

        块的命题:

        {chr(10).join(chunk['propositions'][-3:])}

        块摘要: {chunk['summary'] if 'summary' in chunk else ''}

        当前块标题: {chunk['title'] if 'title' in chunk else ''}

        """

        return self._generate_content(prompt)

    def get_new_chunk_summary(self, proposition: str) -> str:

        """为新块生成初始摘要"""

        prompt = f"""

        您是一组代表讨论相似主题的句子组的块的管理者。

        根据以下命题,生成一个非常简短的 1 到 2 句话的摘要,描述新块的主题。

        仅回复新的块摘要,不要包含其他内容。

        命题:

        {proposition}

        """

        return self._generate_content(prompt)

    def get_new_chunk_title(self, summary: str) -> str:

        """根据其摘要为新块生成初始标题"""

        prompt = f"""

        您是一组块的管理者。根据以下摘要,生成一个简洁的标题(2-4 个词),抓住块的精髓。

        仅回复新的块标题,不要包含其他内容。

        块摘要:

        {summary}

        """

        return self._generate_content(prompt)

    def create_new_chunk(self, proposition: str):

        """使用初始命题创建新块"""

        new_chunk_id = str(uuid.uuid4())[:self.chunk_id_length]  # 唯一的块 ID

        new_chunk_summary = self.get_new_chunk_summary(proposition)

        new_chunk_title = self.get_new_chunk_title(new_chunk_summary)

        self.chunks[new_chunk_id] = {

            'chunk_id': new_chunk_id,

            'propositions': [proposition],

            'title': new_chunk_title,

            'summary': new_chunk_summary,

            'chunk_index': len(self.chunks)

        }

        print(f"Created new chunk {new_chunk_id}: {new_chunk_title}")

    def find_relevant_chunk(self, proposition: str) -> str:

        """为命题找到匹配的块"""

        prompt = f"""

        确定以下命题是否应属于现有块之一。

        如果应该,则返回块 ID。如果不应该,则返回 'NO_MATCH'。

        现有块 (ID: 标题 - 摘要):

        {self._format_chunk_outline()}

        命题:

        {proposition}

        仅回复匹配的块 ID 或 'NO_MATCH'。

        """

        response = self._generate_content(prompt)

        resp = response.strip()

        if resp == "NO_MATCH" or resp not in self.chunks:

            return None

        return resp

    def _format_chunk_outline(self) -> str:

        """格式化块信息以供 LLM 输入"""

        return "\n".join(

            f"{c['chunk_id']}: {c['title']} - {c['summary']}"

            for c in self.chunks.values()

        )

    def pretty_print_chunks(self):

        """显示所有块及其元数据"""

        print("\n----- Chunks Created -----\n")

        for _, chunk in self.chunks.items():

            print(f"Chunk ID    : {chunk['chunk_id']}")

            print(f"Title       : {chunk['title'].strip()}")

            print(f"Summary     : {chunk['summary'].strip()}")

            print("Propositions:")

            for prop in chunk['propositions']:

                print(f"    - {prop}")

            print("\n")

    def print_chunks(self):

        self.pretty_print_chunks()

chunker = AgenticChunker()

chunker.add_propositions(pdf_text)

chunker.print_chunks()
总结
本文详细分析了九种主要的RAG系统文本分块策略,每种策略都有其特定的适用场景和技术特点。在实际应用中,选择合适的分块策略需要综合考虑文档类型、应用需求、计算资源和性能要求等因素。
固定大小分块适用于需要一致性输入的场景,基于句子和语义的分块策略更适合注重语义完整性的应用。递归和滑动窗口分块提供了灵活的大小控制,而层次化和主题分块策略则适合处理结构化内容。特定模态分块专门处理多媒体文档,智能代理分块则代表了未来发展的方向。
开发者可以根据具体需求选择单一策略或组合多种策略,以实现最优的RAG系统性能。通过深入理解这些分块策略的原理和实现方法,我们能够构建更加高效和准确的RAG系统,为用户提供更好的信息检索和生成体验。
如何从零学会大模型?小白&程序员都能跟上的入门到进阶指南
当AI开始重构各行各业,你或许听过“岗位会被取代”的焦虑,但更关键的真相是:技术迭代中,“效率差”才是竞争力的核心——新岗位的生产效率远高于被替代岗位,整个社会的机会其实在增加。
但对个人而言,只有一句话算数:
“先掌握大模型的人,永远比后掌握的人,多一次职业跃迁的机会。”
回顾计算机、互联网、移动互联网的浪潮,每一次技术革命的初期,率先拥抱新技术的人,都提前拿到了“职场快车道”的门票。我在一线科技企业深耕12年,见过太多这样的案例:3年前主动学大模型的同事,如今要么成为团队技术负责人,要么薪资翻了2-3倍。
深知大模型学习中,“没人带、没方向、缺资源”是最大的拦路虎,我们联合行业专家整理出这套 《AI大模型突围资料包》,不管你是零基础小白,还是想转型的程序员,都能靠它少走90%的弯路:
- ✅ 小白友好的「从零到一学习路径图」(避开晦涩理论,先学能用的技能)
- ✅ 程序员必备的「大模型调优实战手册」(附医疗/金融大厂真实项目案例)
- ✅ 百度/阿里专家闭门录播课(拆解一线企业如何落地大模型)
- ✅ 2025最新大模型行业报告(看清各行业机会,避免盲目跟风)
- ✅ 大厂大模型面试真题(含答案解析,针对性准备offer)
- ✅ 2025大模型岗位需求图谱(明确不同岗位需要掌握的技能点)
所有资料已整理成包,想领《AI大模型入门+进阶学习资源包》的朋友,直接扫下方二维码获取~
① 全套AI大模型应用开发视频教程:从“听懂”到“会用”
不用啃复杂公式,直接学能落地的技术——不管你是想做AI应用,还是调优模型,这套视频都能覆盖:
- 小白入门:提示工程(让AI精准输出你要的结果)、RAG检索增强(解决AI“失忆”问题)
- 程序员进阶:LangChain框架实战(快速搭建AI应用)、Agent智能体开发(让AI自主完成复杂任务)
- 工程落地:模型微调与部署(把模型用到实际业务中)、DeepSeek模型实战(热门开源模型实操)
每个技术点都配“案例+代码演示”,跟着做就能上手!

课程精彩瞬间
② 大模型系统化学习路线:避免“学了就忘、越学越乱”
很多人学大模型走弯路,不是因为不努力,而是方向错了——比如小白一上来就啃深度学习理论,程序员跳过基础直接学微调,最后都卡在“用不起来”。
我们整理的这份「学习路线图」,按“基础→进阶→实战”分3个阶段,每个阶段都明确:
- 该学什么(比如基础阶段先学“AI基础概念+工具使用”)
- 不用学什么(比如小白初期不用深入研究Transformer底层数学原理)
- 学多久、用什么资料(精准匹配学习时间,避免拖延)
跟着路线走,零基础3个月能入门,有基础1个月能上手做项目!

③ 大模型学习书籍&文档:打好理论基础,走得更稳
想长期在大模型领域发展,理论基础不能少——但不用盲目买一堆书,我们精选了「小白能看懂、程序员能查漏」的核心资料:
- 入门书籍:《大模型实战指南》《AI提示工程入门》(用通俗语言讲清核心概念)
- 进阶文档:大模型调优技术白皮书、LangChain官方中文教程(附重点标注,节省阅读时间)
- 权威资料:斯坦福CS224N大模型课程笔记(整理成中文,避免语言障碍)
所有资料都是电子版,手机、电脑随时看,还能直接搜索重点!

④ AI大模型最新行业报告:看清机会,再动手
学技术的核心是“用对地方”——2025年哪些行业需要大模型人才?哪些应用场景最有前景?这份报告帮你理清:
- 行业趋势:医疗(AI辅助诊断)、金融(智能风控)、教育(个性化学习)等10大行业的大模型落地案例
- 岗位需求:大模型开发工程师、AI产品经理、提示工程师的职责差异与技能要求
- 风险提示:哪些领域目前落地难度大,避免浪费时间
不管你是想转行,还是想在现有岗位加技能,这份报告都能帮你精准定位!
⑤ 大模型大厂面试真题:针对性准备,拿offer更稳
学会技术后,如何把技能“变现”成offer?这份真题帮你避开面试坑:
- 基础题:“大模型的上下文窗口是什么?”“RAG的核心原理是什么?”(附标准答案框架)
- 实操题:“如何优化大模型的推理速度?”“用LangChain搭建一个多轮对话系统的步骤?”(含代码示例)
- 场景题:“如果大模型输出错误信息,该怎么解决?”(教你从技术+业务角度回答)
覆盖百度、阿里、腾讯、字节等大厂的最新面试题,帮你提前准备,面试时不慌!
以上资料如何领取?
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
为什么现在必须学大模型?不是焦虑,是事实
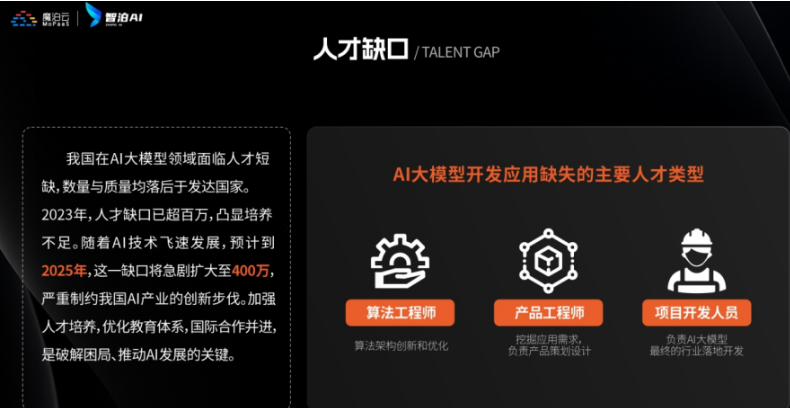
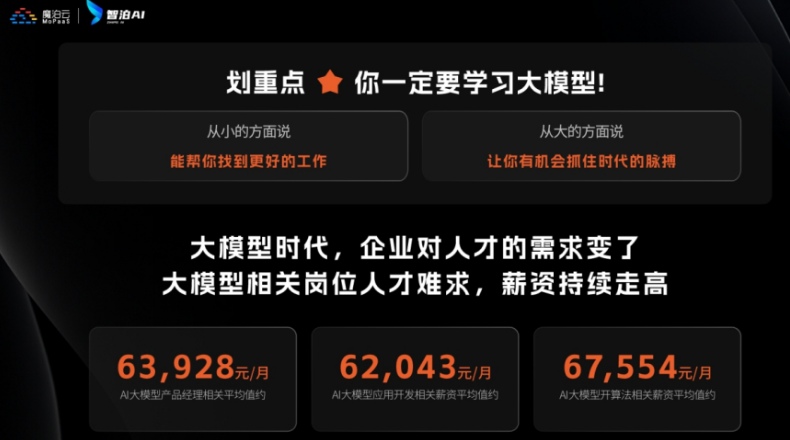
最近英特尔、微软等企业宣布裁员,但大模型相关岗位却在疯狂扩招:
- 大厂招聘:百度、阿里的大模型开发岗,3-5年经验薪资能到50K×20薪,比传统开发岗高40%;
- 中小公司:甚至很多传统企业(比如制造业、医疗公司)都在招“会用大模型的人”,要求不高但薪资可观;
- 门槛变化:不出1年,“有大模型项目经验”会成为很多技术岗、产品岗的简历门槛,现在学就是抢占先机。
风口不会等任何人——与其担心“被淘汰”,不如主动学技术,把“焦虑”变成“竞争力”!
最后:全套资料再领一次,别错过这次机会
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 2160


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


