为什么 AI 能精准匹配你的需求?Embedding 模型工作原理 + RAG 应用,新手也能看懂

《企业知识库实战01》Embedding 与 RAG 的协同原理与落地指南 AI文档阅读分析工具。 阅读详情

当你随口问AI“新手怎么养多肉不烂根”,它既不会误解成“多肉的品种分类”,还能从成千上万条养护攻略里,精准挑出最贴合“新手”“防烂根”需求的答案——你有没有好奇过?AI不像人类那样逐字逐句读内容,却能快速“抓”住语言的核心意思,这背后藏着一个关键技术:Embedding模型。

简单说,Embedding模型不是传统的“翻译官”,它不转换语言种类,而是翻译“语义”。它会把我们说的每句话、写的每个词,转化成机器能“读懂”的数学符号——向量。这个过程,就像给每个表达的“核心意思”发了一张专属的“数字身份证”,让机器能清晰“看见”不同表达之间的关联。

今天我们就用几个生活化的比喻,拆解Embedding模型的工作逻辑,看看它为什么能成为AI理解世界的“核心引擎”。

一、核心比喻:一套按“语义”排序的智慧书架

与其说Embedding模型构建了一座图书馆,不如说它打造了一套“会分类的智慧书架”——这里的每一本书(对应一段文本),都不是按书名首字母或学科分类摆放,而是根据内容的“内在意思”归位。

1.1 “语义导航员”:Embedding模型的角色

这套书架的“导航员”,就是Embedding模型。它拿到一段文本(比如一篇多肉养护文),不会纠结标题里有没有“新手”二字,而是先“读透”内容:比如文中是否提到“控水”“颗粒土”“通风”这些关键信息,再给这段文本分配一个唯一的“数字坐标”——这个坐标就是向量。

哪怕两段文字用词不同,只要核心意思一致(比如“多肉别多浇水”和“多肉养护要控水”),导航员也会给它们分配相近的坐标。

1.2 “三维书架”:多维度的语义空间

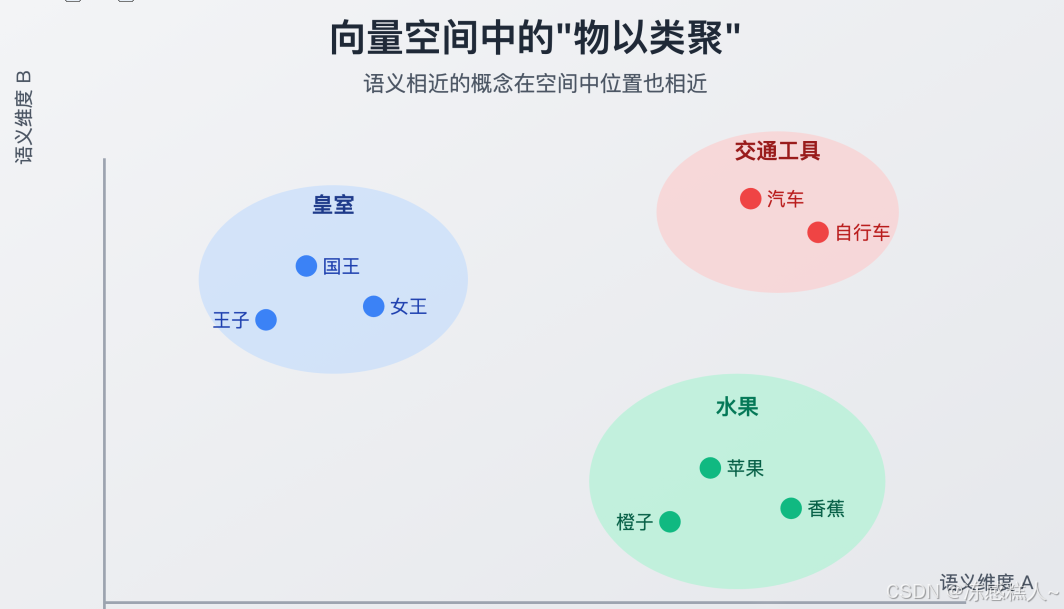
整个书架所在的区域,不是普通的平面,而是一个“多维度语义空间”——你可以理解成一个看不见的“立体网格”,每个坐标都对应网格里的一个点。这里的摆放规则特别直观:

  • 意思越像,位置越近:讲“多肉控水技巧”的书,会和“多肉防烂根方法”的书紧紧挨在一起;甚至和“绿萝浇水频率”的书也离得不远(因为核心都是“植物浇水”)。它们在网格里的“距离”,直接对应语义的“相似度”。
  • 意思无关,距离很远:一本“多肉养护”的书,和一本“量子物理入门”的书,在这个空间里会隔得“十万八千里”,机器一眼就能看出它们毫无关联。
在这里插入图片描述
语义空间中的邻近关系

1.3 “找书逻辑”:从“关键词匹配”到“语义贴合”

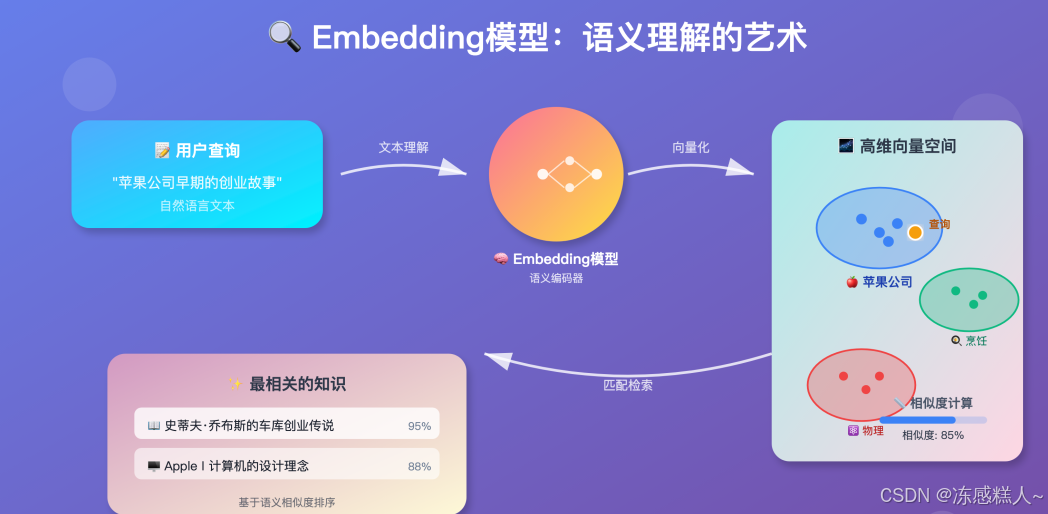
假设你想找“新手养多肉怎么避免烂根”的答案,你把需求告诉导航员(输入问题),它会做两件关键事:

  1. 把你的需求“坐标化”:先将“新手”“多肉”“防烂根”这几个核心语义提炼出来,转化成一个对应的“需求坐标”——这个坐标精准代表了你想要的信息方向。
  2. 找“最近”的书:导航员拿着这个坐标,在语义空间里筛选出离它最近的书。比如优先挑出“多肉新手养护:颗粒土配比+控水技巧”这类书,而跳过“多肉稀有品种图鉴”“多肉历史起源”这类无关内容。

这正是Embedding模型在RAG(检索增强生成)系统里的核心作用:它把“海量知识”和“用户需求”都变成了可对比的“坐标”,让AI不用翻遍所有资料,就能快速锁定最相关的信息——效率比传统“关键词搜索”高太多。
在这里插入图片描述
语义书架的检索逻辑

二、模型的“成长记”:从“语义新手”到“理解大师”

这么聪明的“导航员”不是天生的,它更像一个“语义品鉴师”,得通过大量“学习”才能掌握精准判断语义的能力——而它的“教材”,就是互联网上的海量文本数据。

2.1 初学时:先建立“词语关联感”

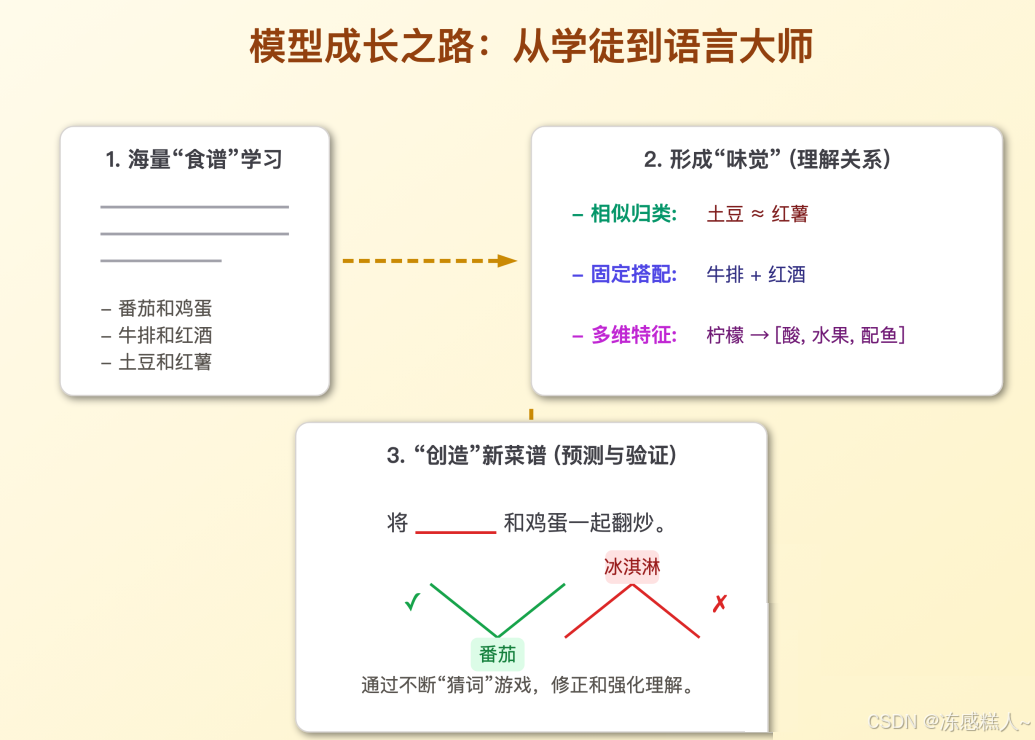
刚起步时,这个“品鉴师”就像个新手:它会先死记硬背词语的“搭配规律”。比如看到“多肉”常和“浇水”“阳光”“土壤”一起出现,“咖啡”常和“研磨”“水温”“手冲”搭配,它会先记下这些“固定组合”,但还不懂背后的逻辑。

随着学习的文本越来越多,它慢慢形成了自己的“语义感知力”:

  • 找“近义词兄弟”:它发现“控水”和“少浇水”说的是一回事,“颗粒土”和“透气土”作用相近,于是把它们归为“语义近亲”,在坐标里离得很近。
  • 辨“细微差异”:它还能分清“开心”和“欣慰”的不同——前者是即时的情绪愉悦,后者多了“放下心来”的意味,所以会给它们分配相近但不重叠的坐标,不会混为一谈。
  • 懂“层级关系”:它知道“多肉”属于“观赏植物”,“观赏植物”又属于“植物”,这种“大类-小类”的层级,会体现在坐标的“维度”上,让每个词的语义形象更立体。
在这里插入图片描述
语义品鉴师的成长路径

2.2 进阶时:在“完形填空”中练精准度

要成为“理解大师”,光记关联还不够,还得会“预测”——这就像厨师要能根据菜谱的前半部分,猜出后半部分该放什么食材。

Embedding模型的“进阶训练”,就是在海量文本里做“完形填空”:比如看到句子“养多肉时,_____的土壤能减少烂根风险”,模型需要根据上下文猜出括号里填“透气”“颗粒多”才合理,而不是“保水强”“黏重”。

如果猜对了,系统会给它“加分”,强化它的语义判断;如果猜错了(比如填了“多浇水”),系统会提醒它“错了,多浇水会导致烂根”,模型就会调整自己的“语义坐标规则”,下次不再犯类似错误。

就这样,通过千万次的“猜题-纠错-优化”,模型慢慢摸清了语言的“潜规则”,从只会记搭配的新手,变成能精准理解语义的“大师”。
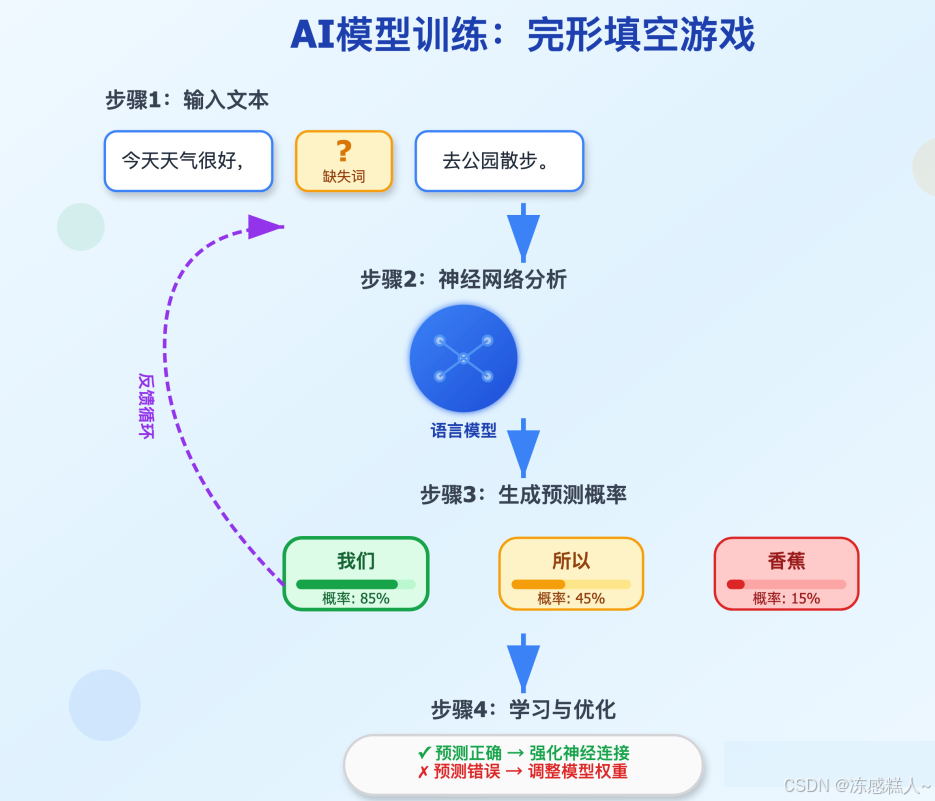
在这里插入图片描述
语义预测训练示意图

结语:Embedding——AI的“语义直觉”从哪来?

看到这里你会发现,AI能“懂”人,本质是Embedding模型给了它一种“语义直觉”:既像人类的“第六感”,能快速捕捉信息的核心;又像人类的“语感”,能让表达更连贯。

这种“直觉”的作用,不止体现在RAG系统里:

在RAG中,它是“外置导航员”——帮AI在海量外部知识里找精准资料,解决了AI“记不住太多细节”的问题。比如你问AI“2024年中国新能源汽车销量”,Embedding会先把“2024”“中国”“新能源汽车”“销量”转化成坐标,在数据库里快速定位最新数据,而不是让AI凭“模糊记忆”回答。

而在GPT这类大模型里,它是“内置思维引擎”——扮演着“语境向量”的角色。当你和AI对话时,它会实时把你的每句话、甚至整个对话历史,都转化成动态的“语境坐标”:

  1. 感知当前语境:比如你先问“多肉怎么养”,又补充“我是新手,总烂根”,模型会把“新手”“烂根”的语义融入坐标,调整理解方向。
  2. 预测连贯表达:生成下一句话时,它会在语义空间里找“最贴合当前坐标”的词——比如优先说“建议用70%颗粒土”,而不是“推荐养稀有品种”。
  3. 更新语境记忆:新生成的内容会再融入“语境坐标”,比如AI说“颗粒土能透气”后,下次你问“那用什么土”,它会立刻关联到“颗粒土”,不用你重复解释。

这个过程,就像我们说话时会下意识“接话”一样——AI不是在机械查字典,而是在Embedding构建的“语义空间”里,靠着对“语境”的感知,进行自然的“思维接力”。

所以,Embedding不只是AI检索信息的工具,更是它理解世界、流畅表达的“底层逻辑”。下次你和AI轻松对话,或是它精准帮你找到答案时,不妨想想:是Embedding模型,给每个词、每句话,都赋予了“被理解”的可能。
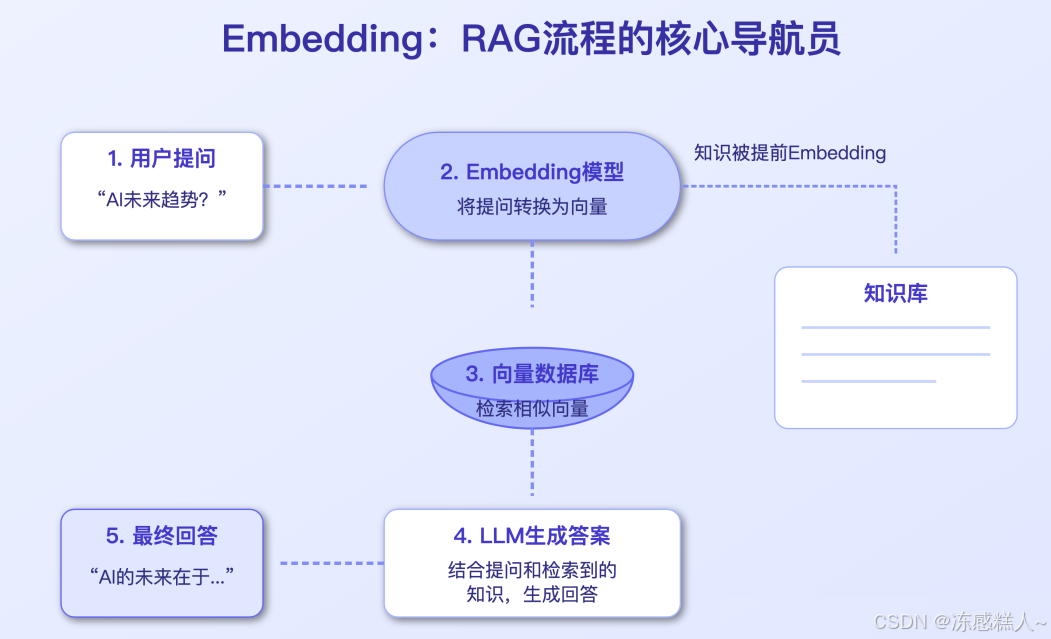
在这里插入图片描述

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

https://img-blog.csdnimg.cn/img_convert/05840567e2912bcdcdda7b15cba33d93.jpeg

在这里插入图片描述

为什么要学习大模型?

我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。

在这里插入图片描述

在这里插入图片描述

大模型入门到实战全套学习大礼包

1、大模型系统化学习路线

作为学习AI大模型技术的新手,方向至关重要。 正确的学习路线可以为你节省时间,少走弯路;方向不对,努力白费。这里我给大家准备了一份最科学最系统的学习成长路线图和学习规划,带你从零基础入门到精通!

img


2、大模型学习书籍&文档

学习AI大模型离不开书籍文档,我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。

在这里插入图片描述

3、AI大模型最新行业报告

2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

img

4、大模型项目实战&配套源码

学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。

img

5、大模型大厂面试真题

面试不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我精心整理了一份大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。

img

适用人群

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …
第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …
第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …
第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

https://img-blog.csdnimg.cn/img_convert/05840567e2912bcdcdda7b15cba33d93.jpeg

RAG中的Embedding模型:背景、定义与核心原理详解 大语言模型(如GPT系列、通义千问等)虽然具备强大的生成能力,但其训练数据存在知识时效性不足(如无法覆盖最新事件)和领域覆盖不全(如专业医学、法律知识)的问题^2^5。- 静态Embedding(如Word2Vec、GloVe):每个词对应固定向量,无法区分上下文(如“苹果”在水果和公司场景中的不同含义)^1^6。而Embedding模型在此过程中,负责将文本转换为语义向量,实现高效的语义匹配^1^3^8。- 将检索到的文档向量与查询向量拼接,输入生成模型(如GPT-4)生成答案^5^8。 阅读详情

相关推荐

Linux系统下奥比中光Astra Pro相机SDK部署与避坑指南

本文详细指导了在Linux系统下部署奥比中光Astra Pro深度相机SDK的全过程,涵盖系统准备、SDK安装、设备权限配置及常见问题排查。重点解析了USB设备规则配置这一关键步骤,并提供了Python与C++项目的集成方法,旨在帮助开发者快速完成相机配置,避免常见陷阱。

weixin_28455801的博客 300

开发RAG应用,你必须知道的11款Embedding模型

bge-en-icl 是一款专为英语语境下的嵌入任务设计的模型。

2401_85390073的博客 1万+

VASP+机器学习快速收敛AIMD

本文介绍了如何利用VASP结合机器学习技术快速收敛AIMD(从头算分子动力学)模拟。首先,通过训练机器学习力场,生成关键文件如ML_ABN(包含结构数据集)、ML_FFN(存储回归结果)和ML_LOGFILE(记录训练日志)。接着,配置INCAR文件以设置计算参数,包括并行化、分子动力学和机器学习相关参数。KPOINTS文件用于定义K点网格。计算完成后,备份CONTCAR文件作为后续模拟的初始结构。最后,利用训练好的力场文件进行纯机器学习力场分子动力学模拟,并提交任务执行。

qq_44812865的博客 1405

Embedding在LLM中的魔力:如何实现精准的文本匹配

在自然语言处理(NLP)领域,Embedding技术扮演着至关重要的角色。它将文本转换为计算机能够理解的数值形式,使得机器能够捕捉和处理文本之间的语义关系。尤其在大型语言模型(LLM)中,Embedding 技术更是实现精准文本匹配的核心。 Embedding 是指将高维度的数据(例如文字、图片、音频)映射到低维度空间的过程。embedding 向量通常是一个由实数构成的向量,它将输入的数据表示成一个连续的数值空间中的点。简单来说,embedding 就是一个N维的实值向量,它几乎可以用来表示任何事情,如文

python12345_的博客 928

神经网络基础概念总结(小白入门自用)

神经网络人工神经网络多层感知机激活函数反向传播算法损失函数权值初始化正则化方法 人工神经网络 人工神经元:人工神经元是人工神经网络的基本单元。模拟生物神经元,人工神经元有1个或者多个输入(模拟多个树突或者多个神经元向该神经元传递神经冲动);对输入进行加权求和(模拟细胞体将神经信号进行积累和树突强度不同);对输入之和使用激活函数计算活性值(模拟细胞体产生兴奋或者抑制);输出活性值并传递到下一个人工神经元(模拟生物神经元通过轴突将神经冲动输入到下一个神经元)。 人工神经网络:大量的人工神经元以某种链接方式得来的

qq_42011158的博客 648

OPNET网络仿真实验

外网

嚴 帅的博客 1万+

RAG技术解析:为什么Embedding模型需要Reranking模型加持?

文章介绍了RAG系统中Embedding模型与Reranking模型的协同工作机制。Embedding模型(双塔结构)适合做粗筛,高效从海量文档召回候选chunk;Reranking模型(交叉编码器)做精排,深入理解文本语义相关性。两者配合既保证效率又提高准确性。文章还列举了BGE-Reranker、Cohere Rerank等常见Reranking模型,为RAG系统实现提供参考。

嘴巴吃糖了 924

Kimi K3大模型API实战:从调用到本地知识库问答系统构建

大语言模型(LLM)作为人工智能的核心技术,通过海量数据训练获得理解和生成自然语言的能力。其工作原理基于Transformer架构,通过自注意力机制捕捉长距离依赖关系。这项技术的核心价值在于能够将非结构化文本转化为可计算、可交互的智能体,极大地提升了信息处理和自动化任务的效率。在应用场景上,大模型广泛应用于智能对话、代码生成、文档总结与问答等领域。其中,国产大模型如月之暗面推出的Kimi K3,凭借其在**长文本处理**和**中文场景优化**方面的优势,为开发者提供了新的技术选项。本文将以Kimi K3为例

weixin_30694389的博客 299

AI大模型 为什么你现在必须搞懂Embedding?

Embedding就是给每个东西(文字、图片、商品等)分配一个“身份证号码”,但这个号码不是12345这样的简单数字,而是一串有特殊含义的“密码数字串”。张三:爱运动、喜欢咖啡、IT行业、30岁李四:爱运动、喜欢茶、金融行业、35岁张三:[0.9, 0.8, 0.1, 0.3] (运动强、咖啡强、IT弱、年龄轻)李四:[0.9, 0.2, 0.9, 0.5] (运动强、茶弱、金融强、年龄中)这个数字串就是Embedding向量!如何让大模型知道它不知道的事情?

2502_94431433的博客 1441

LoRa项目实战:手把手教你为ESP32选配和焊接天线(从PCB到信号测试)

本文详细介绍了为ESP32选配和焊接LoRa天线的全流程,包括天线选型、PCB布局设计、焊接工艺及信号测试。重点解析了PCB板载天线、导线天线和陶瓷贴片天线的适用场景与性能特点,并提供专业的焊接技巧和信号测试方案,帮助开发者优化LoRa模块的无线通信性能。

weixin_30470643的博客 393

从ADS到SystemVue:当简单链路预算不够用时,我的射频系统级仿真方案升级实录

本文详细介绍了从ADS到SystemVue的射频系统级仿真升级路径,重点分析了基础链路预算在多端口元件和复杂场景下的局限性,并提供了SystemVue在非线性系统验证和跨域协同分析中的优势。通过实际案例展示了如何平滑迁移工具链,提升仿真精度和效率,适用于5G、毫米波雷达等现代射频系统设计。

weixin_34233974的博客 343

RAG检索系统的两大核心利器——Embedding模型和Rerank模型

在RAG系统中,有两个非常重要的模型一个是Embedding模型,另一个则是Rerank模型;这两个模型在RAG中扮演着重要角色。Embedding模型的作用是把数据向量化,通过降维的方式,使得可以通过欧式距离,余弦函数等计算向量之间的相似度,以此来进行相似度检索。而Rerank的作用是在Embedding检索的基础之上,进行更加准确的数据筛选;如果说Embedding模型进行的是一维筛选,那么Rerank模型就是从多个维度进行筛选。Embedding模型和Rerank模型。

weixin_58753619的博客 1297

SAP 创建PO时提示“不能确定任何组件”

SAP 创建委外加工的PO时提示“不能确定任何组件” 而如果BOM已经创建了,但还是提示该错误保存。 解决办法:1. BOM selection 未配置好; 2. 由于Purchasing prosessing time的设置,如果PO中的delivery time - Purchasing prosessing time是过去的日期,那么会找不到BOM,BOM的有效期需早 于PO审批的有效期。 3. BOM未...

willieyuan的博客 6118

全面解析RAG技术:原理拆解、行业应用与进阶调优,让AI输出精准度飙升

全面解析RAG技术:原理拆解、行业应用与进阶调优,让AI输出精准度飙升

大模型研究中心 1455

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

Embedding模型到底是怎么工作的?为什么这么重要?

所以,AI是怎么“读懂”世界的?靠的就是Embedding模型这个“翻译官”,它给了AI一种近似于人类的“第六感”——对意义的直觉。在RAG系统里,Embedding模型是外置的“超级导航员”,总能带着AI在海量知识库里找到最精准的参考资料。这解决了AI“记不住”海量事实的问题。如果没有RAG这座“图书馆”,现代大模型(如GPT)自己的“大脑”又是如何思考的?其实,Embedding同样是它们认知能力的核心,但扮演着一个更内在的角色——“语感神经网络”。

2401_85375186的博客 941

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

AI大模型RAG检索系统的两大核心利器——Embedding模型和Rerank模型

“ Embedding和Rerank模型是RAG系统中的核心模型。” 在RAG系统中,有两个非常重要的模型一个是Embedding模型,另一个则是Rerank模型;这两个模型在RAG中扮演着重要角色。 Embedding模型的作用是把数据向量化,通过降维的方式,使得可以通过欧式距离,余弦函数等计算向量之间的相似度,以此来进行相似度检索。

2401_85325557的博客 979

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

【收藏】RAG是什么?Embedding是什么?小白也能看懂的实战讲解

想象一下,你要教一个只懂数学的外星人理解“苹果”这个词。你没法直接解释“红色、圆形、能吃的水果”,但你可以把“苹果”转换成一组数字——这组数字就是向量。把人类语言中模糊的语义,转换成了计算机能计算的、精确的数字数组。比如“苹果”可能对应向量,“香蕉”对应,两个向量的数字越接近,代表语义越相似。RAG和Embedding是解决大模型幻觉问题的“黄金组合”——Embedding负责把文本变成可计算的向量,实现精准检索;RAG负责把检索结果喂给大模型,让它基于真实资料生成答案。

大模型教程的博客 983

开发RAG应用,你必须知道的11款Embedding模型_gte-qwen2-7b-instruct

bge-en-icl 是一款专为英语语境下的嵌入任务设计的模型。

jennycisp的博客 1770

【建议收藏】从零掌握Embedding技术:大模型RAG应用的底层原理与实践

【建议收藏】从零掌握Embedding技术:大模型RAG应用的底层原理与实践

youmaob的博客 1454

RAG Embedding 深度解析:3个关键问题帮你优化知识检索!

1.1 Embedding 的基本概念Embedding 是一种将数据表示为高维向量的方法,这些向量捕捉了数据的语义特性和相互关系。它们是现代自然语言处理和信息检索的基石,常用于表示文本、图像、音频等不同类型的数据。简单来说,Embedding 就是让机器能够“理解”数据的一种手段。它将语言或其他形式的数据转换为数值,这些数值以高维空间中的点的形式表示,使计算机能够通过数学操作捕捉语义关系。1.2 举例说明 Embedding 是什么?

xx_nm98的博客 1682

大模型RAG | 深入了解几种主流的检索策略(BM25、Embedding、混合检索、Reranker)

BM25:关键词检索的基石,简单高效,精确匹配场景下的可靠选择。Embedding 技术:开启语义理解大门。Sparse Embedding (如SPLADE):在关键词基础上融入初步语义,兼顾效率与可解释性。Dense Embedding (如SBERT, jina-embeddings-v3):强大的语义理解能力,应对复杂查询的利器。Multi-vector Embedding (如ColBERT):精细捕捉长文档中的局部信息,避免重要细节被稀释。

老皮的博客 2154

收藏!一文读懂Embedding模型:AI大模型的“语感“是如何形成的

文章通过图书馆比喻解释了Embedding模型如何将人类语言转换为向量表示,在多维空间中构建语义关系。这一技术使AI能够理解语言含义、匹配相关知识,是RAG系统和现代大语言模型的核心。Embedding模型通过海量文本训练,学习词语间的语义关联,赋予AI类似人类的"语感",使其能够进行连贯对话和精准回答。掌握Embedding技术对理解和应用AI大模型至关重要。

2401_85325726的博客 636

从零掌握Embedding技术:RAG精准检索的底层原理与实现指南!!

Embedding技术作为RAG系统的核心,将非结构化文本转化为语义向量,使机器能理解文本相似度。文章详解了从Word2Vec到Sentence-BERT的模型演进、Transformer自注意力机制原理、向量生成流程,以及在RAG系统中如何实现知识检索。同时分析了长文本处理、领域适配、计算效率等挑战及未来发展方向,强调了Embedding作为"机器理解人类语言的通用语言"对AI应用落地的关键价值。

2401_84495872的博客 702

RAG系统三大模型解析:为什么Embedding和Rerank不是“大模型“?

文章详细解析了RAG系统中的三类模型:Embedding模型负责文本向量化进行语义检索,Rerank模型对初步结果精细排序,生成式大模型整合信息生成回答。前两者通常是针对特定任务优化的"小模型",而非通用"大模型",因为它们任务相对简单、效率要求高且经过专门优化。理解这三类模型的区别与选择对构建高效的RAG系统至关重要。

2401_85328934的博客 923
上一篇: 新手必看!多模态大模型 (MM-LLMs) 是什么?10 分钟学懂核心
下一篇: 大模型面试刷题攻略:500 + 题一口气刷完,极简答案速记手册奉上
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值