


本文将介绍如果使用 LangChain 封装成 Api 提供给其他人使用。
环境搭建
在开始实际编码之前,首先需要搭建一个干净、稳定的开发环境。本文推荐使用 conda 管理虚拟环境,并利用 pip 安装所需的依赖包。以下将详细介绍如何创建环境并安装相关依赖。
创建开发环境
使用 conda 创建一个独立的虚拟环境,可以确保项目间依赖不会相互干扰。执行以下命令,即可创建名为 langchain-api 的 Python 3.10 环境:
bin/conda create -n langchain-api python=3.10
这条命令会自动下载并安装 Python 3.10,同时为该环境配置基本的包管理工具。使用虚拟环境不仅有助于依赖的隔离,还能在需要时轻松切换不同版本的 Python 环境,适应各种项目需求。
在创建环境后,记得激活该环境:
conda activate langchain-api
安装依赖包
在环境搭建好后,我们需要安装实现 API 所需的各个依赖包。本文主要涉及以下几个核心组件:
- • langserve:用于将 LangChain 链封装为 API 路由,便于与 FastAPI 集成。
- • langchain:核心链式处理框架,负责提示模板、模型调用等功能。
- • langchain_community:社区扩展包,提供了与 Ollama 大语言模型交互的接口。
- • FastAPI:轻量级、高性能的 Web 框架,用于构建 API 服务。
pip install "langserve[all]"
pip install langchain
pip install langchain_community
pip install fastapi
API 实现原理与代码详解
在完成环境搭建之后,接下来的重点工作便是构建 API 服务。本文将结合代码示例,详细介绍如何利用 LangChain 与 Ollama 模型进行交互,并将整个流程封装为一个 API 接口。
环境依赖导入与模型初始化
# 导入FastAPI库,用于创建Web服务
from fastapi import FastAPI
# 从langchain_community.llms模块导入Ollama类,它是与Ollama大语言模型进行交互的接口
from langchain_community.llms import Ollama
# 从langchain_core.prompts模块导入ChatPromptTemplate类,用于创建对话提示词模板
from langchain_core.prompts import ChatPromptTemplate
# 从langchain_core.output_parsers模块导入StrOutputParser类,用于将模型的输出解析为字符串
from langchain_core.output_parsers import StrOutputParser
# 从langserve模块导入add_routes函数,用于将LangChain链添加到FastAPI应用中作为API路由
from langserve import add_routes
对话提示模板与链式处理流程
# 创建输出解析器实例,其作用是将模型的输出转换为字符串类型
output_parser = StrOutputParser()

# 初始化Ollama模型的配置
llm = Ollama(
    # 指定要使用的Ollama模型名称为"deepseek-r1:14b"
    model="deepseek-r1:14b",
    # 模型的API端点URL,程序将通过此URL与Ollama模型进行通信
    base_url="https://203.0.113.10:8443"
)

# 构建对话提示模板
prompt = ChatPromptTemplate.from_messages([
    # 系统角色的提示信息,告知模型要用指定的开发语言实现需求代码
    # {dev_language} 是一个占位符,在运行时会被具体的开发语言替换
    ("system", "请用{dev_language}语言帮我实现这个需求代码"),
    # 用户角色的提示信息,{user_requirements} 是一个占位符,在运行时会被用户的具体需求替换
    ("user", "{user_requirements}")
])
这一部分主要完成了三个功能:
- • 输出解析器:创建了一个 StrOutputParser 实例,用于将模型返回的复杂数据解析为纯文本,便于后续展示和处理。
- • 模型初始化:通过 Ollama 类初始化了大语言模型,并配置了模型名称和 API 端点。此处我们将原有的敏感 URL 替换为示例地址,以保障信息安全。
- • 提示模板构建:利用 ChatPromptTemplate 构建了一个对话提示模板,通过定义系统角色与用户角色的对话内容,将具体的开发语言与用户需求参数化,确保在实际调用时能够灵活生成符合预期的提示信息。
在实际运行中,当用户通过 API 接口传递开发语言及需求描述后,提示模板会自动将占位符替换为具体内容,形成完整的请求文本,随后传递给 Ollama 模型进行处理。
FastAPI 路由注册与服务启动
# 构建处理流水线,它定义了数据的处理流程
# 首先,将输入的数据应用到提示词模板中,生成完整的提示信息
# 然后,将生成的提示信息传递给Ollama模型进行处理
# 最后,使用输出解析器将模型的输出转换为字符串
chain = prompt | llm | output_parser

# 以下代码注释掉了,它的作用是执行问答流程
# 调用chain的invoke方法,通过字典传递输入参数,这里的"input"可以替换为具体的需求
# 例如:{"dev_language": "Python", "user_requirements": "实现一个简单的加法函数"}
# print(chain.invoke({"input": "容器化相比传统虚拟化有哪些优势?"}))

# 把我们的程序部署成服务
# 创建FastAPI的应用实例
# title:应用的标题,用于描述应用的名称
# version:应用的版本号
# description:应用的描述信息,简要说明应用的功能
app = FastAPI(title='LangChain Api 服务', version='V1.0', description='基于 Ollama 的 LangChain Api 服务')

# 将LangChain链添加到FastAPI应用中作为API路由
# app:FastAPI应用实例
# chain:要添加的LangChain链
# path:API的访问路径,用户可以通过此路径调用该API
add_routes(
    app,
    chain,
    path="/coder",
)

# 当脚本作为主程序运行时执行以下代码
if __name__ == "__main__":
    # 导入uvicorn库,它是一个用于运行ASGI应用的服务器
    import uvicorn
    # 调用uvicorn的run方法启动服务器
    # app:要运行的FastAPI应用实例
    # host:服务器监听的主机地址,这里设置为本地主机
    # port:服务器监听的端口号,这里设置为12345
    uvicorn.run(app, host="localhost", port=12345 )
在这一部分中,我们首先将前面构建的提示模板、模型实例和输出解析器通过管道符号(|)串联起来,形成一个完整的数据处理链。该链条从接收用户输入开始,依次完成提示生成、模型调用、输出解析三个环节,最终输出处理后的结果。
接着,我们利用 FastAPI 创建了一个 Web 服务实例,并设置了服务的标题、版本号和描述信息。通过调用 add_routes 函数,将 LangChain 链注册为 API 路由,使得外部用户可以通过指定路径(此处为 /coder)访问我们的服务。最后,使用 uvicorn 启动服务器,使服务能够在本地监听指定端口(12345)。
完整代码,复制即可运行
# 导入FastAPI库,用于创建Web服务
from fastapi import FastAPI
# 从langchain_community.llms模块导入Ollama类,它是与Ollama大语言模型进行交互的接口
from langchain_community.llms import Ollama
# 从langchain_core.prompts模块导入ChatPromptTemplate类,用于创建对话提示词模板
from langchain_core.prompts import ChatPromptTemplate
# 从langchain_core.output_parsers模块导入StrOutputParser类,用于将模型的输出解析为字符串
from langchain_core.output_parsers import StrOutputParser
# 从langserve模块导入add_routes函数,用于将LangChain链添加到FastAPI应用中作为API路由
from langserve import add_routes

# 创建输出解析器实例,其作用是将模型的输出转换为字符串类型
output_parser = StrOutputParser()

# 初始化Ollama模型的配置
llm = Ollama(
    # 指定要使用的Ollama模型名称为"deepseek-r1:14b"
    model="deepseek-r1:14b",
    # 模型的API端点URL,程序将通过此URL与Ollama模型进行通信
    base_url="https://u573698-94e7-29ab86b7.nmb1.seetacloud.com:8443"
)

# 构建对话提示模板
prompt = ChatPromptTemplate.from_messages([
    # 系统角色的提示信息,告知模型要用指定的开发语言实现需求代码
    # {dev_language} 是一个占位符,在运行时会被具体的开发语言替换
    ("system", "请用{dev_language}语言帮我实现这个需求代码"),
    # 用户角色的提示信息,{user_requirements} 是一个占位符,在运行时会被用户的具体需求替换
    ("user", "{user_requirements}")
])

# 构建处理流水线,它定义了数据的处理流程
# 首先,将输入的数据应用到提示词模板中,生成完整的提示信息
# 然后,将生成的提示信息传递给Ollama模型进行处理
# 最后,使用输出解析器将模型的输出转换为字符串
chain = prompt | llm | output_parser

# 以下代码注释掉了,它的作用是执行问答流程
# 调用chain的invoke方法,通过字典传递输入参数,这里的"input"可以替换为具体的需求
# 例如:{"dev_language": "Python", "user_requirements": "实现一个简单的加法函数"}
# print(chain.invoke({"input": "容器化相比传统虚拟化有哪些优势?"}))

# 把我们的程序部署成服务
# 创建FastAPI的应用实例
# title:应用的标题,用于描述应用的名称
# version:应用的版本号
# description:应用的描述信息,简要说明应用的功能
app = FastAPI(title='LangChain Api 服务', version='V1.0', description='基于 Ollama 的 LangChain Api 服务')

# 将LangChain链添加到FastAPI应用中作为API路由
# app:FastAPI应用实例
# chain:要添加的LangChain链
# path:API的访问路径,用户可以通过此路径调用该API
add_routes(
    app,
    chain,
    path="/coder",
)

# 当脚本作为主程序运行时执行以下代码
if __name__ == "__main__":
    # 导入uvicorn库,它是一个用于运行ASGI应用的服务器
    import uvicorn
    # 调用uvicorn的run方法启动服务器
    # app:要运行的FastAPI应用实例
    # host:服务器监听的主机地址,这里设置为本地主机
    # port:服务器监听的端口号,这里设置为12345
    uvicorn.run(app, host="localhost", port=12345 )
API 接口部署与测试
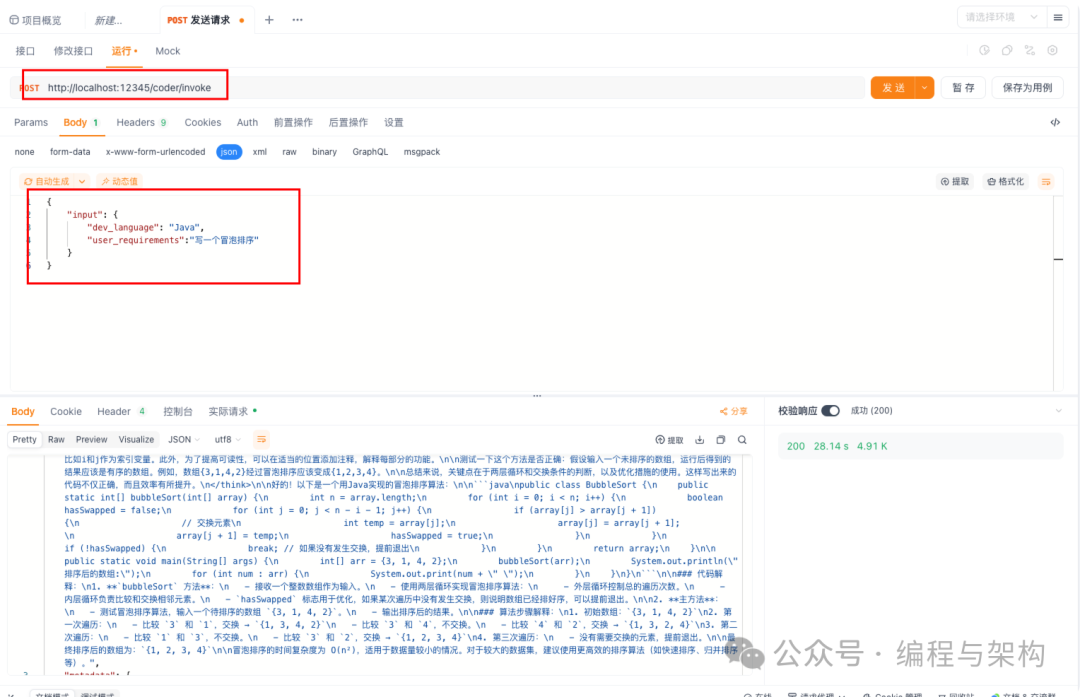
使用 curl 进行接口测试
curl -X POST -H "Content-Type: application/json" -d '{
    "input": {
        "dev_language": "Python",
        "user_requirements":"写一个冒泡排序"
    }
}' http://localhost:12345/coder/invoke
上述命令解释:
- •
-X POST:指定 HTTP 请求方法为 POST,因为调用/invoke接口通常是通过 POST 请求传递数据。 - •
-H "Content-Type: application/json":设置请求头,表明发送的数据是 JSON 格式。 - •
-d '{...}':-d参数用于在请求体中发送数据,花括号内是具体的 JSON 格式请求参数,按照接口要求构造,这里设置了dev_language为Java,user_requirements为写一个冒泡排序。 - •
http://localhost:12345/coder/invoke:指定请求的接口地址。
通过 ApiFox 调用
总结
本文详细介绍了如何利用 LangChain 将大语言模型封装成 API 接口,并基于 FastAPI 构建了一个高性能、模块化的服务平台。
如何零基础入门 / 学习AI大模型?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高
那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈
全套AGI大模型学习大纲+路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。


👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 7171


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


