


上周,我制作了一段关于DeepSeek-V3的视频,引起了全球AI社区的巨大轰动。
两天前,一个中国团队发布了基于推理的大规模语言模型“DeepSeek-R1”,并将其开源!
据说它的性能与OpenAI最准确的推理模型‘o1\’不相上下。更令人印象深刻的是,它是一个极具性价比的模型,API价格不到OpenAI o1的1/25。此外,它还在高度灵活的MIT许可证下开源,任何人都可以下载和使用该模型。
R1模型一经推出,便不仅反驳了之前关于提炼OpenAI o1的说法,官方也直接表示:“我们可以与o1的开源版本相媲美。”
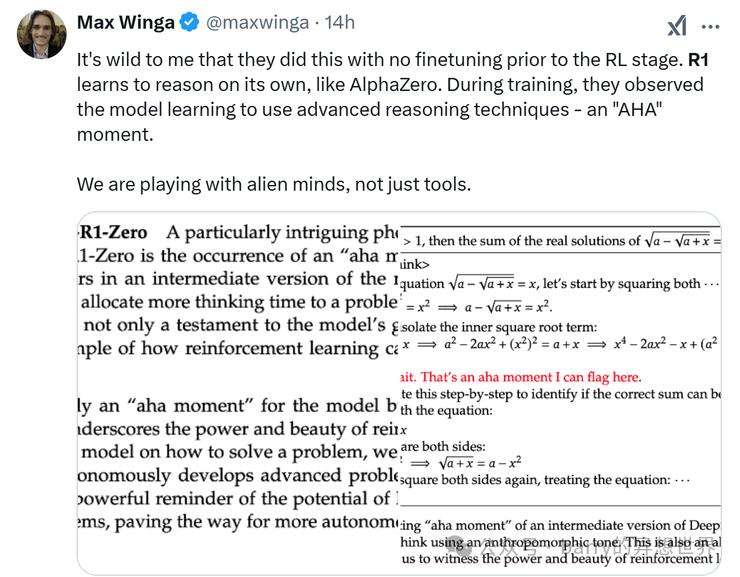
值得一提的是,R1突破了以往的模型训练方法,完全不使用任何SFT数据,而是通过纯粹的RL训练模型。这表明R1已经学会了独立思考问题——这实际上更符合人类的思维规则。
当我想开发RAG聊天机器人时,我发现LangChain在我使用它开发RAG聊天机器人之前进行了巨大的更新。不幸的是,它并不像ChatGPT那样记住对话内容,也不能像客服聊天机器人那样输入新数据或进行特定问题的训练。
所以,让我给你一个实时聊天机器人的快速演示,向你展示我的意思。
我将上传一个包含图像的PDF,然后问聊天机器人一个问题:“总结这个PDF。”随意问任何你想问的问题。如果你看看聊天机器人生成输出的方式,你会看到PDF文件将其内容存储在临时文件中,使用PDFPlumberLoader处理复杂数据,如表格,并清理临时文件。
它使用SemanticChunker将文档拆分为语义块,并使用FAISS进行高效的基于相似性的搜索。检索器为查询找到最相似的3个块,并使用history_aware_retriever增强代理将整个对话历史纳入检索过程的能力。
它还集成了context_chain以处理外部输入数据和docs_chain以记录对话,使用create_retrieval_chain形成完整的检索过程。它通过验证文档是否已上传、检索上下文以及使用RAG链生成响应来处理上下文感知的响应。
在视频结束时,你将了解Deepseek R1是如何训练的,以及如何使用Deepseek-R1与RAG。
DeepSeek R1 学习方法概述
DeepSeek R1 的特点是使用强化学习(RL)进行后训练。一般来说,大规模语言模型的开发经过以下步骤:
- \1. 预训练:通过大量语料库创建一个“预测下一个单词”的模型。
- \2. 监督微调(SFT):使用高质量的人类创建的指令-响应对来微调模型以完成特定任务。
- \3. RLHF(带有人类反馈的强化学习):人类评估模型的输出,并使用分数作为奖励来更新模型。
据报道,DeepSeek R1 在大规模上进行了强化学习,尤其是在第 3 步。此外,他们探索了一种通过直接应用 RL 的方法,而不使用传统的 SFT(称为 DeepSeek-R1-Zero),然后再添加 SFT 来完成 DeepSeek R1。这种方法被认为促进了模型的内部思维过程(思维链)和自我验证。
通常,有效处理思维链需要一些 SFT 数据和人类标签。然而,DeepSeek-R1-Zero 声称仅通过 RL 实现了推理能力,而没有经过 SFT。这种方法提供了以下优势:
- • 降低大规模数据收集的成本
- • 使模型能够在未知任务和复杂情况下进行自我纠正
然而,完全没有经过 SFT 的模型仍然存在一些问题,例如文本有些难以阅读和意外的多语言内容。
让我们构建应用程序
现在让我们逐步探索并揭示如何创建 RAG 应用程序的答案。我们将安装支持该模型的库。为此,我们将执行 pip install requirements
pip install -r requirements.txt
下一步是通常的步骤,我们将导入相关库,其重要性在后续过程中将变得明显。
PDFPlumberLoader 是一个非常强大的工具,用于处理复杂的结构化数据,例如来自 PDF 文件的表格。它可以提取文本、图像、表格、字段等。
SemanticChunker 根据语义相似性将文本拆分为块,确保相关内容保留在同一块中。
如果您想了解更多关于最新 langchain 升级的信息,我将在其中详细解释。
import os
import streamlit as st
from langchain_community.document_loaders import PDFPlumberLoader
from langchain_experimental.text_splitter import SemanticChunker
from langchain_huggingface import HuggingFaceEmbeddings
import os
from langchain_community.vectorstores import FAISS
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain.chains.history_aware_retriever import create_history_aware_retriever
from langchain.chains.combine_documents import create_stuff_documents_chain
from langchain.chains.retrieval import create_retrieval_chain
from langchain_core.messages import AIMessage, HumanMessage
import tempfile
from langchain_openai.chat_models.base import BaseChatOpenAI
我创建了一个函数来处理上传的文件,使用临时文件存储其内容。然后,我使用 PDFPlumberLoader 处理 PDF,以处理复杂的结构化数据,例如来自 PDF 文件的表格,确保在之后清理临时文件以保持系统整洁。最后,我返回提取的数据以供进一步使用。
def process_uploaded_file(uploaded_file):

    with tempfile.NamedTemporaryFile(delete=False, suffix='.pdf') as tmp_file:
        tmp_file.write(uploaded_file.getvalue())
        loader = PDFPlumberLoader(tmp_file.name)
        documents = loader.load()
    os.unlink(tmp_file.name)

    return documents
我创建了一个函数来处理文档列表并构建一个基于相似性的搜索检索器。首先,我使用 SemanticChunker 和 OpenAIEmbeddings 将文档拆分为较小的块,同时保留语义关系,确保相关内容保持在一起。
在确认拆分过程后,我使用 FAISS 开发了一个向量存储,它组织这些块以便于高效的相似性搜索。
最后,我返回一个检索器,可以为给定查询找到 3 个最相似的块,使文档检索过程既准确又高效。
def get_vs_retriever_from_docs(doc_list):

    text_splitter = SemanticChunker(HuggingFaceEmbeddings())
    documents = text_splitter.split_documents(doc_list)
    st.write('文档拆分完成')


    embedder = HuggingFaceEmbeddings()
    vector = FAISS.from_documents(documents, embedder)

    return vector.as_retriever(search_type="similarity", search_kwargs={"k": 3})
我创建了 init_ui() 函数,以设置一个用户友好的界面,用于使用 Streamlit 上传和分析 PDF 文档。首先,我配置页面的标题和描述性标题。
然后,我初始化会话状态变量,以管理检索器、聊天历史和上传状态。接下来,我提供一个文件上传小部件,供用户上传 PDF 文件。
一旦文件上传,我处理它以提取其内容,使用 get_vs_retriever_from_docs 创建一个检索器,并将其存储在会话状态中以供进一步使用。最后,我通知用户文档处理成功的消息。
def init_ui():
    st.set_page_config(page_title='文档上传器')
    st.markdown('#### :books:🧙高达烈 (Gao Dalie): 您的文档摘要工具')
    st.markdown("<h8 style='text-align: right; color: green;'>*分享您想阅读的书的 PDF*</h8>", unsafe_allow_html=True)

    if"vector_store"notin st.session_state:
        st.session_state.vector_store = None
    if"chat_history"notin st.session_state:
        st.session_state.chat_history = []
    if"doc_upload"notin st.session_state:
        st.session_state.doc_upload = False

    uploaded_file = st.file_uploader("上传 PDF", type=["pdf"])
    if uploaded_file:
        docs = process_uploaded_file(uploaded_file)
        if docs:
            retriever = get_vs_retriever_from_docs(docs)
            st.session_state.vector_store = retriever
            st.session_state.doc_upload = True
            st.success("文档处理成功")
我创建了 get_related_context() 函数,以改善对话系统中相关信息的检索。首先,我初始化 Ollama 模型(deepseek-r1)以处理用户输入。
然后,我定义一个提示模板,将聊天历史和用户输入结合在一起,指示模型根据正在进行的对话生成搜索查询。
最后,我使用 create_history_aware_retriever 来增强代理将整个对话历史纳入检索过程的能力。
def get_related_context(vector_store):

    # llm = Ollama(model="deepseek-r1")


    llm = BaseChatOpenAI(
        model='deepseek-reasoner',
        openai_api_key='sk-68f459660c7b4d179e074cbedce962c0',
        openai_api_base='https://api.deepseek.com',
        max_tokens=1024
    )
    prompt = ChatPromptTemplate.from_messages([
        ("system", "根据对话生成搜索查询。"),
        ("user", "{input}")
    ])
    return create_history_aware_retriever(llm, vector_store, prompt)
在这个函数中,我设计了一个集成两个核心链的函数:
- • context_chain 负责查找外部输入数据
- • 负责查找对话记录
最后,使用 retrieval_chain = create_retrieval_chain(context_chain, docs_chain)` 创建一个可以检索对话和外部输入数据的链,完成一个可以实现自然对话的链。
对话记录需要自己创建一个列表存储,即 chat_history 部分。
def get_context_aware_prompt(context_chain):
    # llm_! = Ollama(model="deepseek-r1")

    llm = BaseChatOpenAI(
        model='deepseek-reasoner',
        openai_api_key='sk-68f459660c7b4d179e074cbedce962c0',
        openai_api_base='https://api.deepseek.com',
        max_tokens=1024
    )
    prompt = ChatPromptTemplate.from_messages([
       ("system", "使用提供的上下文回答问题:\n\n{context}"),
       ("user", "{input}")
   ])
    # st.write(docs_chain)
    return create_retrieval_chain(context_chain, docs_chain)
在这个函数中,我处理生成针对给定查询的上下文感知响应的过程。我开始检查是否上传了必要的文档。
如果没有上传文档,我将返回一个错误。一旦验证了文档,我将检索一个 上下文链 以访问上传文档中的相关信息。如果检索上下文失败,我将返回一个错误。
然后,我创建一个 RAG 链,将上下文与对话历史和用户的查询结合在一起,以生成响应。最后,我调用 RAG 链,处理响应,并返回生成的答案。
def get_response(query: str) -> str:
    ifnot st.session_state.vector_store:
        return"错误:请先上传文档"
    try:
        context_chain = get_related_context(st.session_state.vector_store)
        # st.write(context_chain)
        ifnot context_chain:
            return"错误:无法处理上下文"

        rag_chain = get_context_aware_prompt(context_chain)
        # st.write(rag_chain)
        current_history = st.session_state.chat_history[-2:] iflen(st.session_state.chat_history) > 1else []
        return rag_chain.invoke({
            "chat_history": current_history,
            "input": query
        })["answer"].do
    except Exception as e:
        return f"错误:{str(e)}"
在这个函数中,我设置并显示一个聊天界面,以便用户互动。首先,我循环遍历存储的 聊天历史,并显示用户和 AI 消息。
然后,我提供一个输入框,用户可以在其中输入新问题。如果用户提交查询,我调用 get_response 函数生成答案,然后我将新消息和响应更新到聊天历史中。
def init_chat_interface():
    for message in st.session_state.chat_history:
        with st.chat_message("user"ifisinstance(message, HumanMessage) else"assistant"):
            st.write(message.content)

    if prompt := st.chat_input("问一个问题...", disabled=not st.session_state.doc_upload):
        st.session_state.chat_history.append(HumanMessage(content=prompt))
        response = get_response(prompt)
        st.session_state.chat_history.append(AIMessage(content=response))

if __name__ == "__main__":
    init_ui()
    if st.session_state.vector_store:
        init_chat_interface()
结论:
DeepSeek R1 的发布是一个技术突破,也是人工智能民主化的一个关键里程碑。它的开放方法正在重塑我们对人工智能的看法,使更多人能够参与其开发。
理解像 Retrieval Chain 和 Conversation Retrieval Chain 这样的概念对于使用 LangChain 至关重要。
只要理解这两个链的原理,您不仅可以了解基于语言模型的客户服务聊天机器人的操作原理,还可以使我们能够实现类似的应用。
然而,LangChain 不仅仅是这些。创建与语言模型相关的应用程序还需要学习许多功能和技巧。
DeepSeek无疑是2025开年AI圈的一匹黑马,在一众AI大模型中,DeepSeek以低价高性能的优势脱颖而出。DeepSeek的上线实现了AI界的又一大突破,各大科技巨头都火速出手,争先抢占DeepSeek大模型的流量风口。
DeepSeek的爆火,远不止于此。它是一场属于每个人的科技革命,一次打破界限的机会,一次让普通人也能逆袭契机。
DeepSeek的优点

掌握DeepSeek对于转行大模型领域的人来说是一个很大的优势,目前懂得大模型技术方面的人才很稀缺,而DeepSeek就是一个突破口。现在越来越多的人才都想往大模型方向转行,对于想要转行创业,提升自我的人来说是一个不可多得的机会。
那么应该如何学习大模型
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。
大模型岗位需求越来越大,但是相关岗位人才难求,薪资持续走高,AI运营薪资平均值约18457元,AI工程师薪资平均值约37336元,大模型算法薪资平均值约39607元。

掌握大模型技术你还能拥有更多可能性:
• 成为一名全栈大模型工程师,包括Prompt,LangChain,LoRA等技术开发、运营、产品等方向全栈工程;
• 能够拥有模型二次训练和微调能力,带领大家完成智能对话、文生图等热门应用;
• 薪资上浮10%-20%,覆盖更多高薪岗位,这是一个高需求、高待遇的热门方向和领域;
• 更优质的项目可以为未来创新创业提供基石。
可能大家都想学习AI大模型技术,也想通过这项技能真正达到升职加薪,就业或是副业的目的,但是不知道该如何开始学习,因为网上的资料太多太杂乱了,如果不能系统的学习就相当于是白学。为了让大家少走弯路,少碰壁,这里我直接把都打包整理好,希望能够真正帮助到大家。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【
保证100%免费】
👉AI大模型学习路线汇总👈
大模型学习路线图,整体分为7个大的阶段:(全套教程文末领取哈)

第一阶段: 从大模型系统设计入手,讲解大模型的主要方法;
第二阶段: 在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;
第三阶段: 大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;
第四阶段: 大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;
第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;
第六阶段: 以SD多模态大模型为主,搭建了文生图小程序案例;
第七阶段: 以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。
👉大模型实战案例👈
光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

👉大模型视频和PDF合集👈
观看零基础学习书籍和视频,看书籍和视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。


👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 242


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


