Qwen2.5 PyTorch模型微调入门实战

智谱AI发布国产最强大模型GLM4,理解评测与数学能力仅次于Gemini Ultra和GPT-4,编程能力超过Gemini-pro,还有对标GPTs商店的GLMs 这是在智谱AI开发者大会上推出的新一代基座大语言模型,GLM4相比较此前最大的特点是三个变化:性能全面提升、上下文长度更长、支持更强的多模态能力。GLM4(GLM4)详细信息 | 名称、简介、使用方法,开源情况,商用授权信息 | 数据学习 (DataLearner) 阅读详情

Qwen2.5是Qwen大型语言模型系列的最新成果。对于Qwen2.5,通义千问团队发布了从0.5到720亿参数不等的基础语言模型及指令调优语言模型。Qwen2.5相比Qwen2带来了以下改进:

  • 显著增加知识量,在编程与数学领域的能力得到极大提升,这得益于我们在这些领域的专业专家模型。

  • 在遵循指令、生成长文本(超过8K个token)、理解结构化数据(例如,表格)以及生成结构化输出特别是JSON方面有显著提升。对系统提示的多样性更具韧性,增强了聊天机器人中的角色扮演实现和条件设定。

  • 支持长上下文处理,上限为128K个token,并能生成最多8K个token。

  • 支持超过29种语言的多语言功能,包括中文、英语、法语、西班牙语、葡萄牙语、德语、意大利语、俄语、日语、韩语、越南语、泰语、阿拉伯语等。

环境准备

安装Ascend CANN Toolkit和Kernels

安装方法请参考安装教程(https://www.hiascend.com/document/detail/zh/CANNCommunityEdition/80RC2alpha002/quickstart/quickstart/quickstart_18_0004.html)或使用以下命令。

# 请替换URL为CANN版本和设备型号对应的URL  
# 安装CANN Toolkit  
wget https://ascend-repo.obs.cn-east-2.myhuaweicloud.com/Milan-ASL/Milan-ASL%20V100R001C17SPC701/Ascend-cann-toolkit_8.0.RC1.alpha001_linux-"$(uname -i)".run  
bash Ascend-cann-toolkit_8.0.RC1.alpha001_linux-"$(uname -i)".run --install  
  
# 安装CANN Kernels  
wget https://ascend-repo.obs.cn-east-2.myhuaweicloud.com/Milan-ASL/Milan-ASL%20V100R001C17SPC701/Ascend-cann-kernels-910b_8.0.RC1.alpha001_linux.run  
bash Ascend-cann-kernels-910b_8.0.RC1.alpha001_linux.run --install  
  
# 设置环境变量  
source /usr/local/Ascend/ascend-toolkit/set_env.sh  

安装openMind Library以及openMind Hub Client

  • 安装openMind Hub Client
pip install openmind_hub  

  • 安装openMind Library,并安装PyTorch框架及其依赖。
pip install openmind[pt]

更详细的安装信息请参考openMind官方的环境安装(https://modelers.cn/docs/zh/community/environment_installation.html)章节。

  • 安装llama-factory

在这里插入图片描述

模型链接和下载

Qwen2.5-7B模型系列由社区开发者在魔乐社区贡献,包括:

  • Qwen2.5-7B: https://modelers.cn/models/AI-Research/Qwen2.5-7B

  • Qwen2.5-7B-Instruct: https://modelers.cn/models/AI-Research/Qwen2.5-7B-Instruct

通过Git从魔乐社区下载模型的repo,以Qwen2.5-7B-Instruct为例:

# 首先保证已安装git-lfs(https://git-lfs.com)  
git lfs install  
git clone https://modelers.cn/AI-Research/Qwen2.5-7B-Instruct.git  

模型推理

用户可以使用openMind Library或者LLaMa Factory进行模型推理,以Qwen2.5-7B-Instruct为例,具体如下:

  • 使用openMind Library进行模型推理

新建推理脚本 inference_qwen2.5_7b_chat.py ,推理脚本内容为:

import argparse  
from openmind import AutoModelForCausalLM, AutoTokenizer  
from openmind_hub import snapshot_download  
  
def parse_args():  
    parser = argparse.ArgumentParser()  
    parser.add_argument(  
        "--model_name_or_path",  
        type=str,  
        help="Path to model",  
        default=None,  
    )  
  
    args = parser.parse_args()  
  
    return args  
  
def main():  
    args = parse_args()  
    if args.model_name_or_path:  
        model_path = args.model_name_or_path  
    else:  
        model_path = snapshot_download("AI-Research/Qwen2.5-7B-Instruct", revision="main", resume_download=True,  
                                    ignore_patterns=[" .h5", " .ot", "*.mspack"])  
  
    model = AutoModelForCausalLM.from_pretrained(  
        model_path,  
        torch_dtype="auto",  
        device_map="auto"  
    )  
    tokenizer = AutoTokenizer.from_pretrained(model_path)  
  
    prompt = '你是谁'  
    messages = [  
        {"role": "system", "content": "You are a helpful assistant."},  
        {"role": "user", "content": prompt}  
    ]  
    text = tokenizer.apply_chat_template(  
        messages,  
        tokenize=False,  
        add_generation_prompt=True  
    )  
    model_inputs = tokenizer([text], return_tensors="pt").to(model.device)  
  
    generated_ids = model.generate(  
        **model_inputs,  
        max_new_tokens=512  
    )  
    generated_ids = [  
        output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)  
    ]  
  
    response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]  
    print(response)  
  
if __name__ == "__main__":  
    main()

执行推理脚本:

python inference_qwen2.5_7b_chat.py

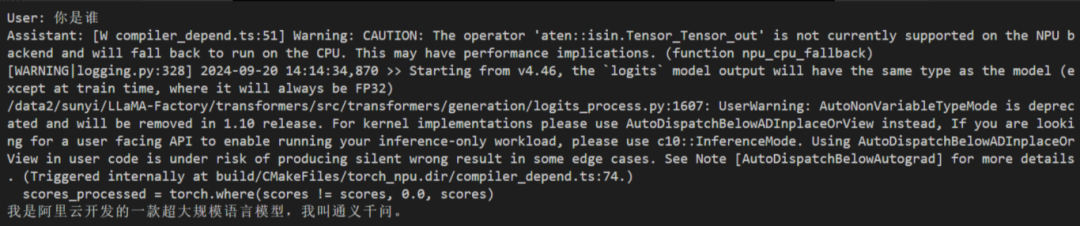
推理结果如下:
  • 使用LLaMa Factory与模型交互

在LLaMa Factory路径下新建examples/inference/qwen2.5_7b_chat.yaml推理配置文件,文件内容为:

model_name_or_path: xxx # 当前仅支持本地加载,填写Qwen2.5-7B-Instruct本地权重路径  
template: qwen  

使用以下命令与模型进行交互:

llamafactory-cli chat examples/inference/qwen2.5_7b_chat.yaml  

交互结果如下:

模型微调

数据集

使用Llama-Factory集成的identity数据集。

微调

新建examples/train_lora/qwen2.5_7b_lora_sft.yaml 微调配置文件,微调配置文件如下:

### model  
model_name_or_path: xxx/xxx  # 预训练模型路径  
  
### method  
stage: sft  
do_train: true  
finetuning_type: lora  
lora_target: all  
  
### dataset  
dataset: identity  
template: qwen  
cutoff_len: 1024  
max_samples: 1000  
overwrite_cache: true  
preprocessing_num_workers: 16  
  
### output  
output_dir: ./saves/qwen2.5_7b/lora/sft  
logging_steps: 10  
save_steps: 500  
plot_loss: true  
overwrite_output_dir: true  
  
### train  
per_device_train_batch_size: 1  
gradient_accumulation_steps: 8  
learning_rate: 1.0e-4  
num_train_epochs: 10.0  
lr_scheduler_type: cosine  
warmup_ratio: 0.1  
bf16: true  
ddp_timeout: 180000000  
  
### eval  
val_size: 0.1  
per_device_eval_batch_size: 1  
eval_strategy: steps  
eval_steps: 500

使用以下命令进行微调:

llamafactory-cli train examples/train_lora/qwen2.5_7b_lora_sft.yaml

微调可视化

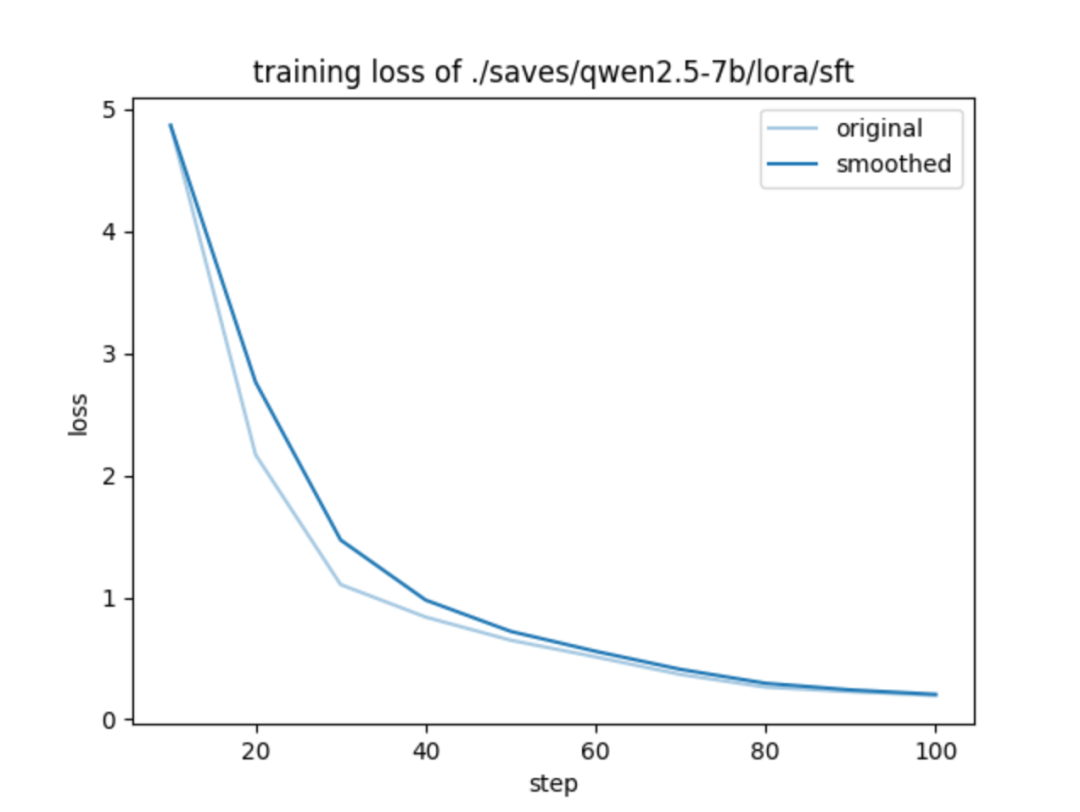
  • 训练Loss可视化:

微调后推理

模型推理

修改examples/inference/qwen2.5_7b_chat.yaml推理配置文件,文件内容为:

model_name_or_path: xxx # 当前仅支持本地加载,填写Qwen2.5-7B-Instruct本地权重路径  
adapter_name_or_path: ./saves/qwen2.5_7b/lora/sft  
template: qwen

使用以下命令进行推理:

llamafactory-cli chat examples/inference/qwen2.5_7b_chat.yaml  

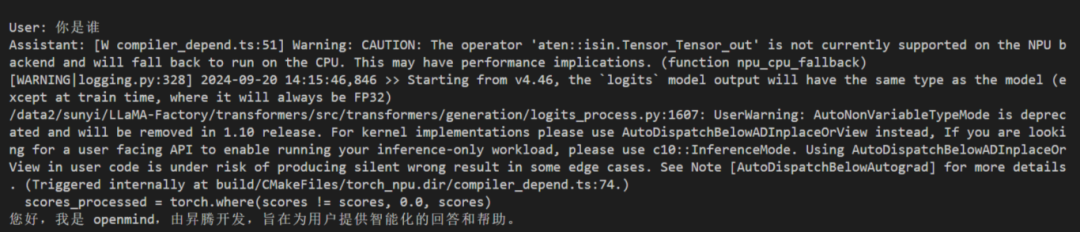
推理结果
结语

在之前华为全联接大会2024上,了解到openMind应用使能套件在AI生态社区中发挥的技术能力。此次Qwen模型的微调经验,也让人看到了openMind在AI模型调优和推理能力。openMind是AI开发者的强有力的助手,它让微调过程变得更加高效和直观。希望每一位开发者都来尝试它,一起交流经验,更好地提升它的能力。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

用ollama本地部署Lamma3.1 ollama create 自定义模型名字 -f Modelfile。让lamma3.1写一个贪吃蛇小游戏,一次run成功。例如:ollama run llama3.1。例如:ollama run llama3.1。 阅读详情

相关推荐

Windows 中 利用 ollama 来搭建 deepseek R1

近年来,大模型凭借其强大的语言理解和生成能力,在自然语言处理、计算机视觉等领域取得了突破性进展。从GPT系列到国内的,文心一言、[Qwen]、,大模型已成为推动人工智能发展的核心力量。ollama作为新兴的大模型搭建工具,以其开源、高效、易于部署的特点,在人工智能开发者社区中崭露头角,为大模型的搭建和应用提供了新的解决方案。在当今数字化浪潮中,人工智能的发展可谓日新月异,而大模型作为其核心驱动力,正重塑着各个行业的格局。

一个专注于机器学习基础与实战的技术博客,内容涵盖算法推导、模型实现、数学原理与代码实践。用通俗的语言解析复杂概念,记录学习过程中的思考与总结,适合机器学习爱好者和从业者参考。 2554

使用 Ollama 本地运行各种 LLM

今天看看另外一个产品Ollama。Ollama 的安装非常简单,只需从官网(https://ollama.com/download)下载后解压缩,并在 Terminal 中运行脚本即可完成环境设置。我尝试运行 Llama3,虽然在运行时占用了大量电脑资源,使得其他应用运行变慢,但整体体验尚可。Ollama 支持多种大型语言模型(https://ollama.com/library)。

python123456_的博客 1734

开源模型应用落地-qwen2-7b-instruct-LoRA微调-unsloth(让微调起飞)-单机单卡-V100(十六)

使用unsloth高效微调qwen2-7b-instruct

以微薄之力,予他人些许温暖. 2万+

AI大模型探索之路-基础篇5:GLM-4解锁国产大模型的全能智慧与创新应用

随着人工智能技术的飞速发展,大型预训练语言模型已成为推动行业进步的重要力量。它们在理解自然语言、生成文本、执行复杂任务等方面展现出惊人的能力。在此背景下,国产大模型GLM-4的问世,不仅展现了中国在AI领域的实力,也为国内外研究者和开发者提供了新的研究与应用平台。

寻道AI,探索AI无限可能! 8679

Python实战:从中国气象局天擎平台自动化获取与处理雷达基数据

本文详细介绍了如何利用Python脚本实现从中国气象局天擎平台自动化获取与处理雷达基数据。通过环境搭建、安全认证、核心代码编写及工程化优化,构建了一个包含自动查询、批量下载、错误重试和格式转换的完整数据管道,旨在帮助气象水文领域的研究者与数据分析师从繁琐的手动操作中解放出来,高效管理海量数据。

ipfs8storage的博客 924

JSP期末考试复习习题及答案

以下习题是对于平时课堂小测的整理,如有错误敬请指正! 欢迎一起交流~ 预祝各位小伙伴们考试顺利! Test1 一. 单选题 – 1.(单选题)当用户请求jsp页面时,JSP引擎就会执行该页面的字节码文件响应客户的请求,执行字节码文件的结果是() A. 发送一个JSP源文件到客户端 B. 发送一个Java文件到客户端 C. 发送一个HTML页面到客户端 D. 什么都不做 – 2.(单选题)下列动态网页和静态网页的根本区别描述错误的是( D) A. 静态网页服务器端返回的HTML文件是事先存储好的 B. 动.

技术小白 2万+

【大模型实战教程】Qwen2.5 PyTorch模型微调入门实战

在之前的华为全联接大会2024上,了解到openMind应用使能套件在AI生态社区中发挥的技术能力。此次Qwen模型的微调经验,也让人看到了openMind在AI模型调优和推理能力。openMind是AI开发者的强有力的助手,它让微调过程变得更加高效和直观。希望每一位开发者都来尝试它,一起交流经验,更好地提升它的能力。​。

python1222_的博客 2599

深信服aCloud虚拟存储VS3.0实战:从数据分片到仲裁机制的全流程解析

本文深度解析了深信服aCloud虚拟存储VS3.0的核心架构与生产级实践。从数据分片、条带化写入、多副本机制到智能缓存分层,详细阐述了其如何实现高性能与高可靠性的平衡。同时,深入剖析了动态均衡、平滑扩容以及故障恢复与仲裁机制,为运维人员和技术决策者提供了在超融合基础架构(HCI)中部署和管理虚拟存储的实战指南。

net55的博客 588

Qwen2大模型微调入门实战(完整代码)

是通义千问团队的开源大语言模型,由阿里云通义实验室研发。以Qwen2作为基座大模型,通过指令微调的方式实现高准确率的文本分类,是学习的入门任务。指令微调是一种通过在由(指令,输出)对组成的数据集上进一步训练LLMs的过程。其中,指令代表模型的人类指令,输出代表遵循指令的期望输出。这个过程有助于弥合LLMs的下一个词预测目标与用户让LLMs遵循人类指令的目标之间的差距。在这个任务中我们会使用模型在数据集上进行指令微调任务,同时使用SwanLab进行监控和可视化。本教程参考了。

SoulmateY的博客 3万+

四旋翼无人机Matlab建模

本文主要分享一下四旋翼无人机的建模过程,然后在Matlab的simulink模块搭建起四旋翼无人机的模型,下一章将结合这个模型设计双环PID控制器并调节参数。 一、无人机建模过程

qq_36903625的博客 3万+

EFR32无线SoC开发指南:从环境搭建到性能优化

物联网边缘设备开发中,无线SoC芯片的选择与开发环境配置是关键第一步。EFR32作为Silicon Labs推出的多协议无线SoC系列,配合Simplicity Studio IDE,为开发者提供了完整的解决方案。本文以EFR32xG22开发套件为例,详细介绍开发环境搭建、工程创建、硬件配置等核心环节,特别针对RAILtest示例工程进行深入解析。通过实际案例演示如何配置无线参数、优化低功耗模式,并分享串口终端交互、吞吐量测试等实战技巧。对于开发者常见的问题如设备识别失败、无线通信异常等,提供了系统化的排查

weixin_30342363的博客 352

【机器学习】QLoRA:基于PEFT亲手量化微调Qwen2大模型

本文首先对量化和微调的原理进行剖析,接着以Qwen2-7B为例,基于QLoRA、PEFT一步一步带着大家微调自己的大模型,本文参考全网peft+qlora微调教程,一步一排坑,让大家在网络环境不允许的情况下,也能丝滑的开启大模型微调之旅。

人工智能领域博客 9435

智驾芯片&软件分层&测试

智能驾驶相关的芯片,软件分层,测试相关内容

天赐好车的博客 436

Qwen2-VL多模态大模型微调实战教程

Qwen2-VL是通义千问团队最近开源的大语言模型,由阿里云通义实验室研发。以Qwen2-VL作为基座多模态大模型,通过的方式实现特定场景下的OCR,是学习的入门任务。本文我们将简要介绍基于 transformers、peft 等框架,使用 Qwen2-VL-2B-Instruct 模型在上进行Lora微调训练,同时使用监控训练过程与评估模型效果。

SoulmateY的博客 1万+

逻辑电平(TTL/CMOS/LVDS/LVPECL/CML)

逻辑电平介绍 TTL------晶体管-晶体管逻辑门(Transistor-Transistor Logic gate) TTL采用5V电源

sinat_15677011的博客 2万+

015:机载三维激光扫描技术相关知识

机载三维激光扫描系统(LiDAR)是集激光、GPS、INS等尖端技术于一体的三维航空遥感技术,能高效准确获取地表三维信息。该系统由GPS、INS、激光扫描测距系统、成像装置和工作平台组成,各部件协同工作以获取精确的空间定位、运动状态、地表三维坐标及真实色彩信息。通过制定飞行计划、安置GPS基站、激光扫描测量、惯性测量及获取高清数码影像等步骤,机载LiDAR技术能实时获取大范围高精度三维数据。该技术具有扫描速度快、精度高、全数字特征等优势,广泛应用于测绘、工程、环境监测和城市建设等领域,如城市三维模型重建、灾

qq_31762031的博客 1726

Qwen2大模型微调入门实战(附完整代码)

大模型指令微调(Instruction Tuning)是一种针对大型预训练语言模型的微调技术,其核心目的是增强模型理解和执行特定指令的能力,使模型能够根据用户提供的自然语言指令准确、恰当地生成相应的输出或执行相关任务。指令微调特别关注于提升模型在遵循指令方面的一致性和准确性,从而拓宽模型在各种应用场景中的泛化能力和实用性。在实际应用中,我的理解是,指令微调更多把LLM看作一个更智能、更强大的传统NLP模型(比如Bert),来实现更高精度的文本预测任务。

m0_59235699的博客 3198

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

最实战的Qwen2微调入门:从文本分类开始

以Qwen2作为基座大模型,通过指令微调的方式实现高准确率的文本分类,是学习的入门任务。指令微调是一种通过在由(指令,输出)对组成的数据集上进一步训练LLMs的过程。其中,指令代表模型的人类指令,输出代表遵循指令的期望输出。这个过程有助于弥合LLMs的下一个词预测目标与用户让LLMs遵循人类指令的目标之间的差距。在这个任务中我们会使用模型在数据集上进行指令微调任务,同时使用SwanLab进行监控和可视化。

SoulmateY的博客 8510

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

基于lora的通义千问qwen大模型微调实战

基于通义千问qwen官方微调实例的1.8b的最小大模型lora微调,目前是基于单卡单机微调最简单实操,Qwen微调

IT大头的博客 9728

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

大模型微调学习笔记Qwen2.5-1.5B

初尝大模型,Qwen2.5-1.5B模型在LLaMa-Factory上进行可视化微调的全流程

M00Rue_的博客 1643

基于Qwen2.5模型的RAG微调+langchain

本文使用Qwen2.5作为示例,是通义千问最新发布的开源大模型,适合中文场景。同时,我会提供微调步骤和参数设置。

ytt0523_com的博客 2077

A16a_昇腾MindSpeed MM微调多模态Qwen2.5-VL

本文介绍如何在昇腾MindSpeed MM框架下微调Qwen2.5-VL多模态大模型。内容涵盖环境准备、权重转换、数据预处理、微调参数配置、推理及评测全流程。重点展示了昇腾NPU相较于GPU的硬件优势,包括集群并行加速、自动化数据处理、显存优化等特性。教程适用于熟悉PyTorch和多模态开发的AI工程师,旨在2小时内掌握模型在昇腾平台的部署与优化方法。文中详细列出了关键环境变量配置和版本要求,为开发者提供开箱即用的实践指南。

昇腾开发者知识体系 2029
上一篇: RAG 系统评测实践详细版:Coze 及相关产品评测对比,以及下一代 RAG 技术
下一篇: 转行在大模型公司做Prompter是种怎样的体验
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值