


欢迎来到AI产品经理从0到1研习之旅。
“AI Agent”系列的第二篇,它来了!我说过,AI Agent才是我最看好的(大模型落地应用)未来,嘿嘿,目测有很多大佬与我有相似的看法。
本文从吴恩达(Andrew Ng)教授关于AI agentic workflows的主题分享视频说起,介绍以下4种能够更好地利用大语言模型的能力、辅助我们的工作和产品应用表现的Agent模式:
- 反思:LLM检查自己的工作,提出改进方法。
- 工具使用:给予LLM如网络搜索、代码执行或任何其他功能的工具,帮助它收集信息、采取行动或处理数据。
- 规划:LLM提出并执行多步骤计划以实现目标。
- 多代理合作:多个AI代理一起工作,分配任务并讨论和辩论观点,以产生比单个代理更好的解决方案。
00
—
缘起:一场主题分享
吴恩达(Andrew Ng)教授,DeepLearning.AI和AI Fund的创始人,在美国红杉资本于2024年3月26日举办的AI Ascent活动中,谈到了人工智能代理工作流程的未来及其潜力,这些工作流程有可能显著推动人工智能的进步,甚至可能超越下一代基础模型的影响力。
演讲大致内容总结如下:
作为早期参与神经网络和GPU发展的科学家,以及Coursera和deepLearning.ai的创始人,我见证了人工智能领域的快速发展。特别是,我领导的Google Brain项目在推动深度学习和大规模计算方面发挥了重要作用。然而,今天我想聚焦的是AI代理,这是一个我认为每个从事AI工作的人都应该关注的兴奋趋势。
我们当前使用语言模型的方式,很像是一个非代理的工作流程,你给出一个提示,它生成一个回答。这就好比让一个人写一篇论文,但从头到尾不能使用退格键。尽管这样做非常困难,但我们的模型做得出奇的好。
而代理工作流程则不同,它更像是这样:让AI先写一个大纲,然后决定是否需要进行网络搜索,接着撰写初稿,之后是自我审阅并思考哪些部分需要修订,然后进行修订。这个过程是迭代的,AI在这一过程中不断“思考”和修正,通常能够得到更好的结果。
我自己在使用这种代理工作流程时,对其效果感到非常惊讶。我们团队对一系列编程问题进行了分析,使用名为“人类评估基准”的编码基准测试,发现通过代理工作流程,即使是早期版本的GPT模型,也能在某些情况下超越更高版本的模型。
我想强调的几种设计模式包括:自我反思、工具使用、规划和多代理合作。自我反思让AI能够自我评估和修正错误;规划允许AI在执行任务前做出计划;而多代理合作则是让不同的AI代理共同工作,解决更复杂的问题。
我相信,通过利用这些设计模式,我们可以显著提高生产力。例如,通过自我反思,一个编程代理能够发现自己代码的错误并提出改进方案;通过规划和多代理合作,我们可以解决更为复杂的问题,实现更高效的工作流程。
我期待未来的AI模型能够进一步扩展AI能做的事情范围。特别是,我认为代理工作流程是向着更智能的AI系统迈进的关键一步。我们可能需要适应不是立即得到响应的工作模式,而是将任务委托给AI代理,耐心等待结果的方式。通过代理工作流程,我相信我们可以在这场通往通用人工智能(AGI)的漫长旅途中,迈出一小步。
谢谢大家,我期待着看到我们所有人如何利用这些先进的AI代理技术来推动我们的工作和研究。
-----------我是分割线------------
接下来文章内容,我将会更加细致地整理和分享Andrew在《Andrew’s Letter》(deepLearning.ai其中的一个栏目)上所披露的相关介绍。这些内容与上面的主题分享视频本质上是一回事,只是在不同场合下的分享。
下文的AI 代理=AI Agent,AI代理工作流=AI agentic workflows。
01
—
代理设计模式概述
我认为,AI代理工作流程将在今年推动巨大的人工智能进步——甚至可能超过下一代基础模型。这是一个重要趋势,我敦促所有在AI领域工作的人关注它。
目前,我们主要在零次学习模式下使用大型语言模型(LLMs),提示模型逐个生成最终输出的Tokens,而不对其工作进行修订。这就像要求某人从头到尾一气呵成地撰写一篇文章,直接输入,不允许使用退格键,同时期望得到高质量的结果。尽管任务困难,但大型语言模型在这一任务上做得惊人得好!
然而,通过代理工作流程,我们可以要求LLM多次迭代一个文档。例如,它可能会执行如下一系列步骤:
- 规划大纲。
- 决定是否需要进行网络搜索以收集更多信息。
- 写下初稿。
- 复查初稿,找出不合理的论点或多余的信息。
- 考虑发现的任何弱点进行修订。
- ……
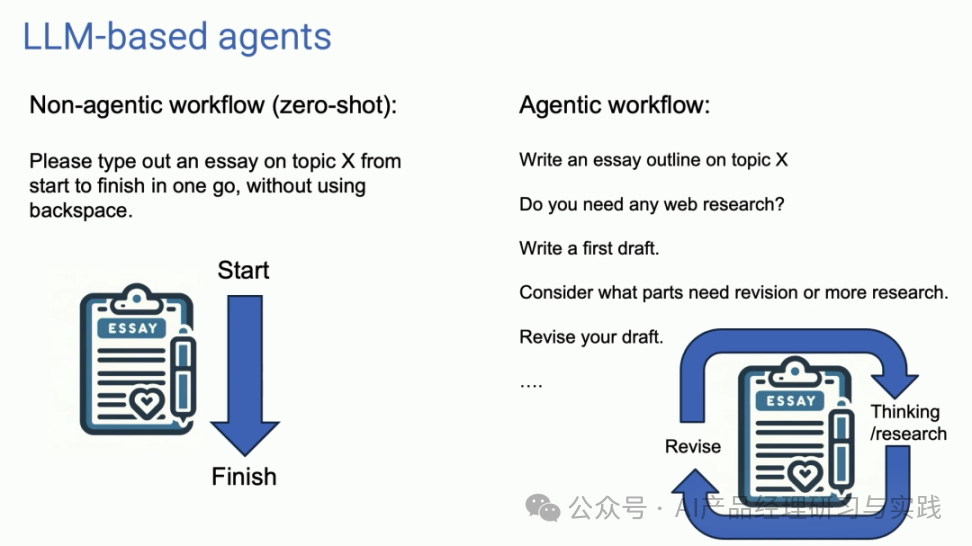
这种迭代过程对大多数人来说是撰写好文本的关键。对AI而言,这样的迭代工作流程比单次写作产生的结果要好得多。
Devin的引人注目的演示最近在社交媒体上引起了大量关注。我的团队一直密切关注编写代码的AI的发展。我们分析了许多研究团队的结果,重点关注算法在广泛使用的HumanEval编码基准测试上的表现。你可以在下面的图表中看到我们的发现。
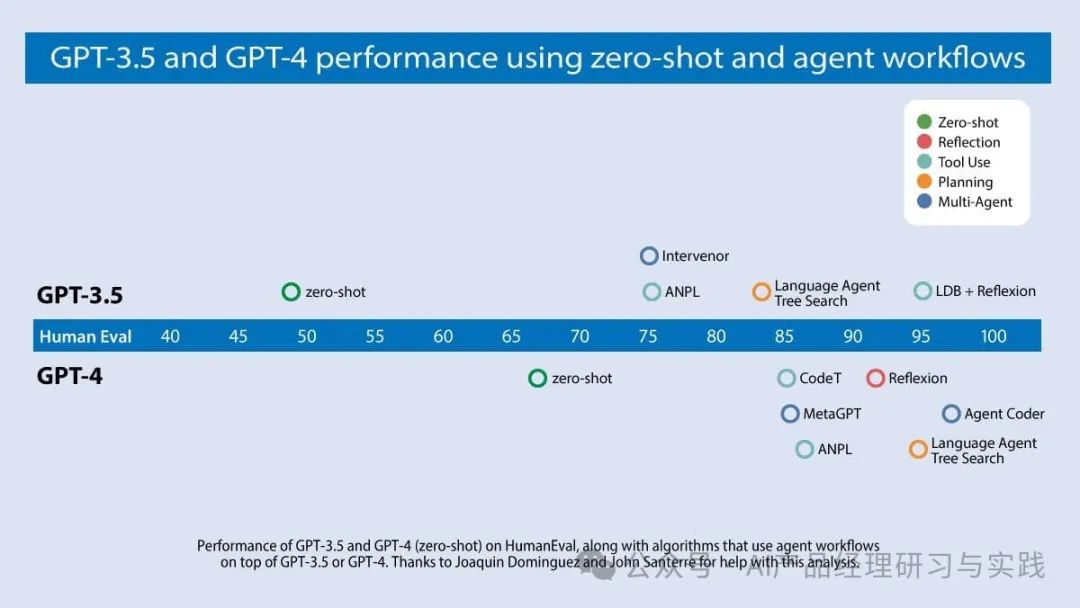
GPT-3.5(零次尝试)的正确率为48.1%。GPT-4(零次尝试)表现更好,达到67.0%。然而,从GPT-3.5到GPT-4的提升,被纳入迭代代理工作流程的提升所淹没。事实上,被代理循环包裹的GPT-3.5达到了高达95.1%的成绩。
开源代理工具和关于代理的学术文献正在迅速增长,这使得现在是一个令人兴奋但也令人困惑的时期。为了帮助大家更好地理解这项工作,我想分享一个用于构建代理的设计模式分类框架。我的团队AI Fund在许多应用中成功使用了这些模式,我希望你们也会发现它们有用。
- 反思:LLM检查自己的工作,提出改进方法。
- 工具使用:给予LLM如网络搜索、代码执行或任何其他功能的工具,帮助它收集信息、采取行动或处理数据。
- 规划:LLM提出并执行多步骤计划以实现目标(例如,为一篇文章写大纲,然后进行在线研究,接着写草稿,等等)。
- 多代理合作:多个AI代理一起工作,分配任务并讨论和辩论观点,以产生比单个代理更好的解决方案。
02
—
模式1:反思
通过反思自己的行为,大型语言模型可以成为更有效的代理。作为一个相对容易实现的设计模式,我已经看到它带来了惊人的性能提升。
你可能有过这样的经验:提示ChatGPT/Claude/Gemini,收到不满意的输出,提供关键反馈帮助LLM改进其回应,然后得到更好的回应。如果你自动化提供关键反馈的步骤,让模型自动批评其自己的输出并改进其回应呢?这就是反思的核心。
以要求LLM编写代码的任务为例。我们可以提示它直接生成所需的代码来执行某个任务X。之后,我们可以提示它反思自己的输出,可能如下:
这是为任务X准备的代码:[之前生成的代码] 仔细检查代码的正确性、风格和效率,并给出如何改进它的建设性批评。
有时这会导致LLM发现问题并提出建设性建议。接下来,我们可以给LLM提供包括
(i)之前生成的代码和建设性反馈以及
(ii)要求它使用反馈重写代码的上下文。
这可以导致更好的回应。重复批评/重写过程可能会带来进一步的改进。这个自我反思过程允许LLM发现差距并改进其在包括产生代码、撰写文本和回答问题等多种任务上的输出。
我们可以通过给LLM提供帮助评估其输出的工具来超越自我反思。例如,通过一些单元测试运行其代码,检查是否在测试用例上生成正确的结果,或搜索网络以双重检查文本输出。然后它可以反思它发现的任何错误并想出改进的想法。
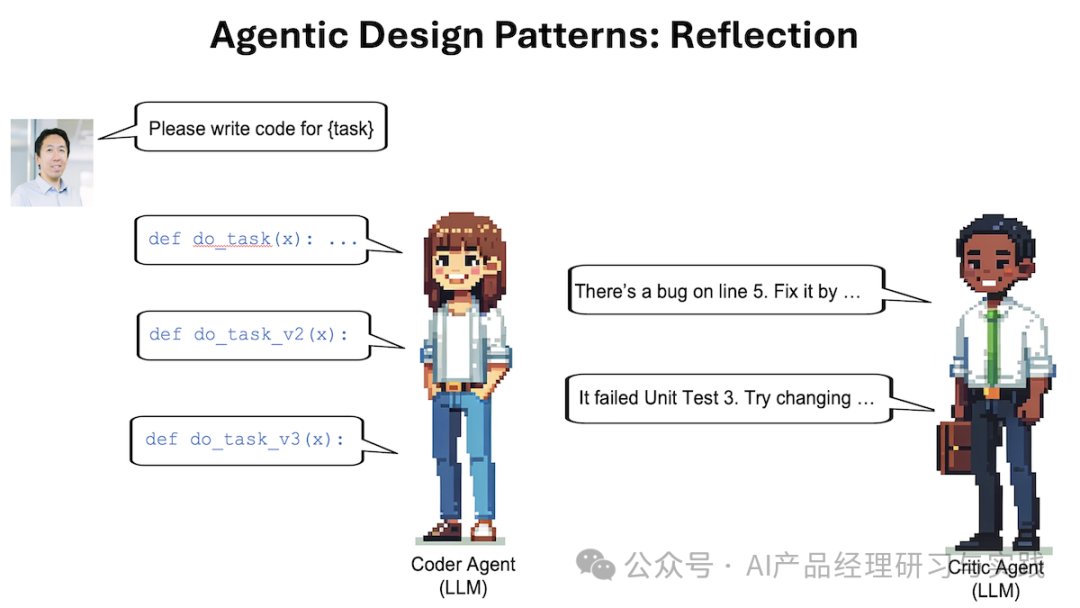
此外,我们可以使用多代理框架实现反思。我发现创建两个不同的代理很方便,一个被提示生成好的输出,另一个被提示对第一个代理的输出给出建设性批评。两个代理之间的讨论导致了改进的回应。
反思是一种相对基础的代理工作流程类型,但我对它在一些情况下改善了我的应用程序的结果感到非常高兴。我希望你能在自己的工作中尝试它。如果你对学习更多关于反思感兴趣,我推荐这些论文:
- “Self-Refine: Iterative Refinement with Self-Feedback,” Madaan et al. (2023)
- “Reflexion: Language Agents with Verbal Reinforcement Learning,” Shinn et al. (2023)
- “CRITIC: Large Language Models Can Self-Correct with Tool-Interactive Critiquing,” Gou et al. (2024)
03
—
模式2:工具使用
大型语言模型如何通过利用外部工具进行搜索、代码执行、提高生产力等行为来充当代理?
工具使用,即给予大型语言模型(LLM)一些它可以请求调用的功能,以收集信息、采取行动或操作数据,是AI代理工作流程的关键设计模式之一。你可能熟悉基于LLM的系统,它们能够执行网络搜索或执行代码。实际上,一些面向消费者的大型LLM已经整合了这些功能。但工具使用的范围远不止这些例子。
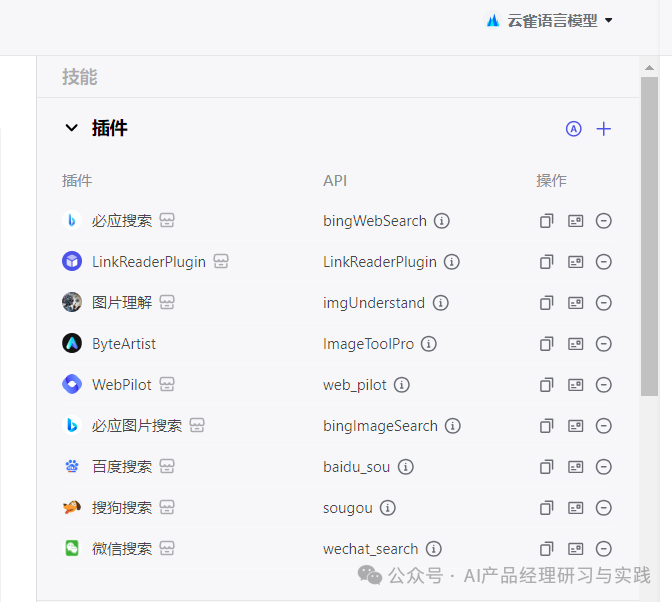
如果你提示一个基于LLM的在线聊天系统,“根据评论,最好的咖啡机是什么?”它可能决定进行网络搜索并下载一个或多个网页以获取上下文。早期,LLM开发者意识到,仅依赖预训练的Transformer来生成输出Tokens是有限制的,而给LLM一个进行网络搜索的工具,可以让它做更多的事情。有了这样的工具,LLM要么被微调,要么被提示(可能是通过少量示例提示)生成一个特殊的字符串,如{tool: web-search, query: “coffee maker reviews”}来请求调用搜索引擎。(字符串的确切格式取决于实现。)然后,后处理步骤会寻找这样的字符串,找到一个时用相关参数调用网络搜索功能,并将结果作为额外的输入上下文传回LLM进行进一步处理。
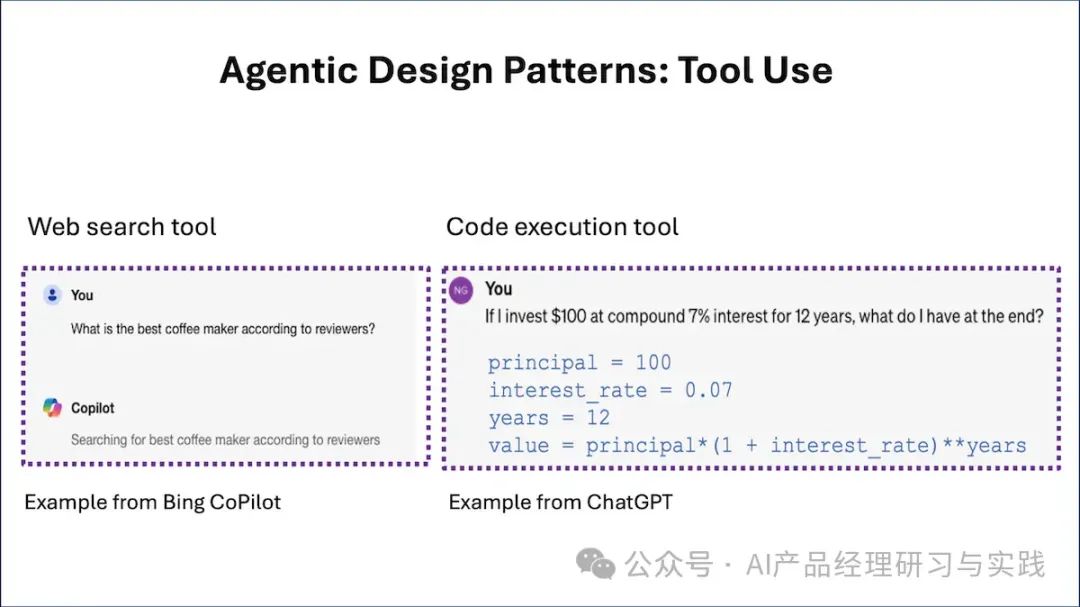
同样地,如果你问,“如果我以7%的复合利率投资100美元,12年后我会得到什么?”而不是尝试直接使用Transformer神经网络生成答案——这不太可能得到正确的答案——LLM可能使用代码执行工具运行Python命令计算100 * (1+0.07)**12来得到正确的答案。LLM可能生成这样一个字符串:{tool: python-interpreter, code: “100 * (1+0.07)**12”}。
但现在,代理工作流程中的工具使用已经更进一步。开发者正在使用functions搜索不同的来源(网络、维基百科、arXiv等)、与生产力工具交互(发送邮件、读写日历条目等)、生成或解释图像等等。我们可以使用给出许多函数详细描述的上下文来提示LLM。这些描述可能包括函数的文本描述以及函数期望的参数的细节。我们期望LLM能自动选择调用正确的函数来完成任务。此外,正在构建的系统中,LLM可以访问数百个工具。在这样的设置中,你可能有太多的函数可供使用,无法将它们全部放入LLM的上下文中,所以你可能会使用启发式方法选择最相关的子集包含在当前处理步骤的LLM上下文中。这种技术,如下面引用的Gorilla论文所述,让人想起如果有太多文本要作为上下文包含,检索增强生成(RAG)系统提供的选择包含文本子集的启发式方法。
在LLMs的历史早期,还没有大型多模态模型(LMMs)如LLaVa、GPT-4V和Gemini的广泛可用之前,LLMs无法直接处理图像,因此计算机视觉社区进行了大量关于工具使用的工作。那时,基于LLM的系统操纵图像的唯一方式是调用函数,比如进行对象识别或其他功能。从那以后,工具使用的做法急剧增加。GPT-4在去年中发布的function call能力,是通用工具使用的一个重要步骤。从那时起,越来越多的LLM被开发出来,同样擅长于工具使用。
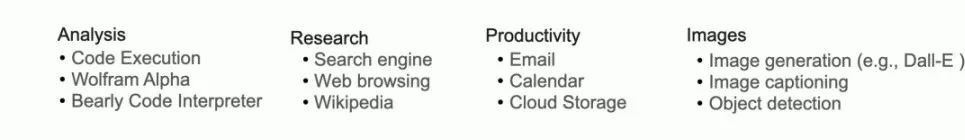
如果你有兴趣了解更多关于工具使用的信息,我推荐:
- “Gorilla: Large Language Model Connected with Massive APIs,” Patil et al. (2023)
- “MM-REACT: Prompting ChatGPT for Multimodal Reasoning and Action,” Yang et al. (2023)
- “Efficient Tool Use with Chain-of-Abstraction Reasoning,” Gao et al. (2024)
工具使用和反思,是我在应用程序上能够相对可靠地运行的设计模式——这两个能力都值得学习。
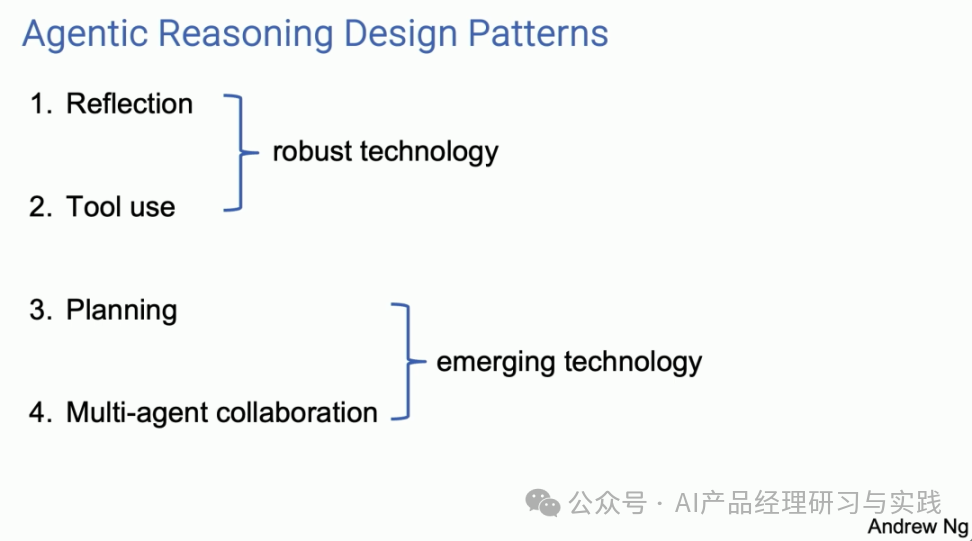
接下来要描述的规划和多代理合作设计模式,它们允许AI代理做更多的事情,但是这些技术不够成熟,不够可预测——尽管非常令人兴奋。
04
—
模式3:规划
如果你让它们在行动之前规划好必要的步骤,大型语言模型就会成为执行复杂任务的强大代理。
规划是AI代理设计的关键模式之一,在这种模式中,我们使用大型语言模型(LLM)自主决定执行哪一系列步骤来完成更大的任务。例如,如果我们要求一个代理在给定主题上进行在线研究,我们可能会使用LLM将目标分解为更小的子任务,比如研究特定的子主题、综合发现并编写报告。
许多人在ChatGPT发布后不久就经历了一个“ChatGPT时刻”,当他们使用它时,惊讶地发现它的表现远远超出了他们对AI能做的事情的预期。如果你还没有经历类似的“AI代理时刻”,我希望你很快就会。几个月前,我有这样一个时刻,当时我在现场演示了我实现的一个研究代理,它可以访问各种在线搜索工具。
我之前已经多次私下测试了这个代理,在这些测试中,它一直使用网络搜索工具来收集信息并撰写总结。然而,在现场演示时,网络搜索API意外地返回了一个速率限制错误。我以为我的演示就要公开失败了,我害怕接下来会发生什么。令我惊讶的是,代理灵活地转向了我忘记给它的维基百科搜索工具,并使用维基百科而不是网络搜索完成了任务。
这对我来说是一个AI代理惊喜的时刻。我认为,许多还没有经历过这样时刻的人,在未来几个月内会经历。当你看到一个代理自主决定以你没有预料到的方式行动,并因此成功时,那是一件美妙的事情!
许多任务不能通过单一步骤或单一工具调用完成,但代理可以决定采取什么步骤。例如,简化《HuggingGPT》论文(下文引用)中的一个例子,如果你想让一个代理考虑一个男孩的照片,并画出一个相同姿势的女孩的画,任务可能被分解为两个不同的步骤:
(i)检测男孩照片中的姿势和
(ii)用检测到的姿势渲染一个女孩的图片。
LLM可能被微调或提示(通过少数示例提示)来指定一个计划,输出一个字符串,如"{tool: pose-detection, input: image.jpg, output: temp1 } {tool: pose-to-image, input: temp1, output: final.jpg}"。
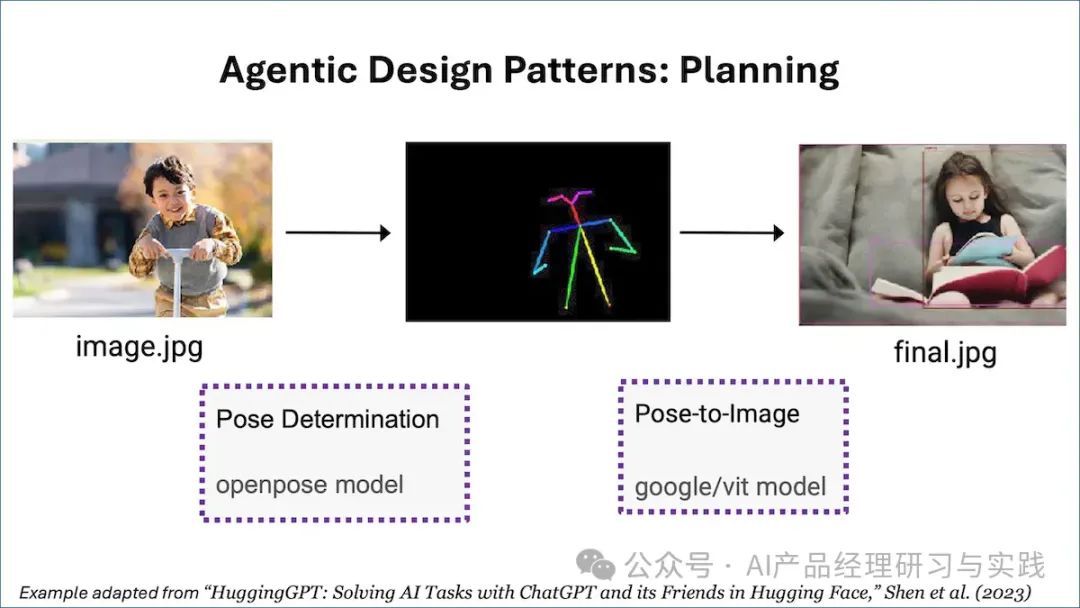
这种结构化输出,指定了要采取的两个步骤,然后触发软件调用姿势检测工具,接着是姿势到图像的工具来完成任务。(这个例子仅用于说明目的;HuggingGPT使用不同的格式。)
诚然,许多代理工作流程不需要规划。例如,你可能让一个代理固定次数地反思并改进其输出。在这种情况下,代理采取的步骤序列是固定和确定的。但对于那些你无法提前指定任务分解为一组步骤的复杂任务,规划允许代理动态决定采取什么步骤。
一方面,规划是一个非常强大的能力;另一方面,它导致结果不太可预测。根据我的经验,虽然我可以让反思和工具使用这两种代理设计模式可靠地工作并提升我的应用程序的性能,但规划是一项不够成熟的技术,我发现很难预先预测它会做什么。但这个领域继续快速发展,我相信规划能力会迅速提高。
如果你有兴趣了解更多关于LLMs的规划,我推荐:
- “Chain-of-Thought Prompting Elicits Reasoning in Large Language Models,” Wei et al. (2022)
- “HuggingGPT: Solving AI Tasks with ChatGPT and its Friends in Hugging Face,” Shen et al. (2023)
- “Understanding the planning of LLM agents: A survey,” by Huang et al. (2024)
05
—
模式4:多代理合作
提示一个LLM在复杂任务的不同部分扮演不同角色,可以召唤一个能更有效完成工作的AI代理团队。
面对像编写软件这样的复杂任务,多代理方法会将任务分解为由不同角色执行的子任务——比如软件工程师、产品经理、设计师、质量保证(QA)工程师等,并让不同的代理完成不同的子任务。
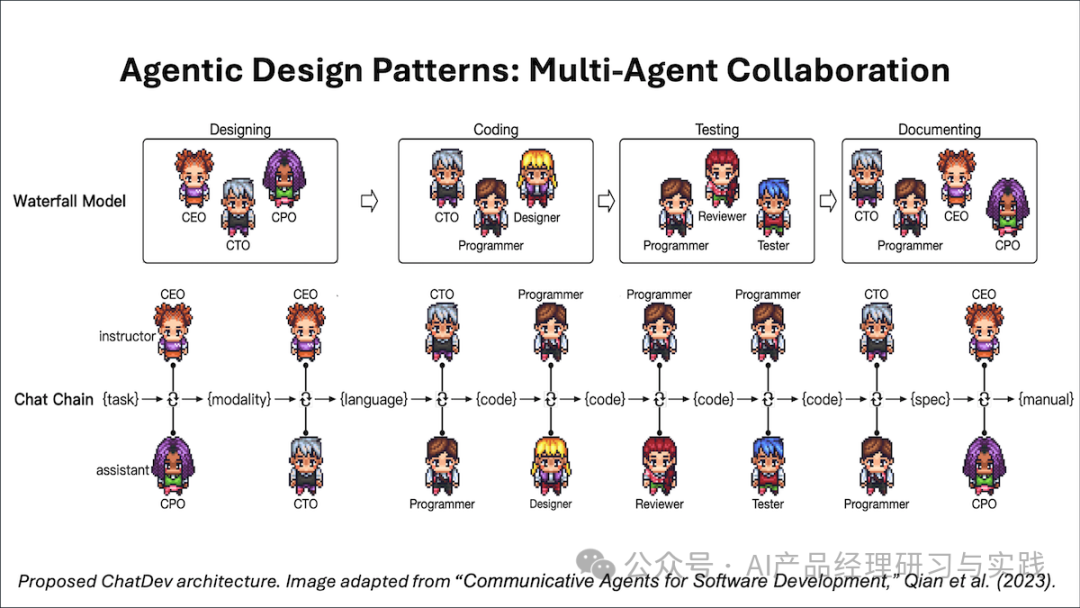
不同的代理可能是通过提示一个LLM(或者,如果你愿意,多个LLM)来执行不同的任务来构建的。例如,为了构建一个软件工程师代理,我们可能会提示LLM:“你是编写清晰、高效代码的专家。编写代码来执行任务……”
"Programmer": [
    "{chatdev_prompt}",
    "You are Programmer. we are both working at ChatDev. We share a common interest in collaborating to successfully complete a task assigned by a new customer.",
    "You can write/create computer software or applications by providing a specific programming language to the computer. You have extensive computing and coding experience in many varieties of programming languages and platforms, such as Python, Java, C, C++, HTML, CSS, JavaScript, XML, SQL, PHP, etc,.",
    "Here is a new customer's task: {task}.",
    "To complete the task, you must write a response that appropriately solves the requested instruction based on your expertise and customer's needs."
"Coding": {
    "assistant_role_name": "Programmer",
    "user_role_name": "Chief Technology Officer",
    "phase_prompt": [
      "According to the new user's task and our software designs listed below: ",
      "Task: \"{task}\".",
      "Task description: \"{description}\".",
      "Modality: \"{modality}\".",
      "Programming Language: \"{language}\"",
      "Ideas:\"{ideas}\"",
      "We have decided to complete the task through a executable software with multiple files implemented via {language}. As the {assistant_role}, to satisfy the new user's demands, you should write one or multiple files and make sure that every detail of the architecture is, in the end, implemented as code. {gui}",
      "Think step by step and reason yourself to the right decisions to make sure we get it right.",
      "You will first lay out the names of the core classes, functions, methods that will be necessary, as well as a quick comment on their purpose.",
      "Then you will output the content of each file including complete code. Each file must strictly follow a markdown code block format, where the following tokens must be replaced such that \"FILENAME\" is the lowercase file name including the file extension, \"LANGUAGE\" in the programming language, \"DOCSTRING\" is a string literal specified in source code that is used to document a specific segment of code, and \"CODE\" is the original code:",
      "FILENAME",
      "```LANGUAGE",
      "'''",
      "DOCSTRING",
      "'''",
      "CODE",
       "```",
       "You will start with the \"main\" file, then go to the ones that are imported by that file, and so on.",
       "Please note that the code should be fully functional. Ensure to implement all functions. No placeholders (such as 'pass' in Python)."
     ]
   }
可能看起来违反直觉,尽管我们多次调用同一个LLM,我们应用了使用多个代理的程序抽象。我想提供几个理由:
- 它有效!许多团队使用这种方法取得了良好的结果,没有什么比结果更有说服力的了!此外,消融研究(例如下面引用的AutoGen论文)显示,多个代理的表现优于单个代理。
- 尽管今天的一些LLM可以接受非常长的输入上下文(例如,Gemini 1.5 Pro接受100万个Tokens),但它们真正理解长的、复杂的输入的能力是参差不齐的。在代理工作流中,提示LLM一次专注于一件事可以获得更好的表现。通过告诉它何时应该扮演软件工程师,我们还可以指定那个角色子任务中的重要内容。例如,前面的prompt强调了清晰、高效的代码,而不是可扩展和高安全性的代码。通过将总体任务分解为子任务,我们可以更好地优化子任务。
- 或许最重要的是,多代理设计模式为我们提供了一个框架,用于将复杂任务分解为子任务。当我们在单个CPU上编写代码运行时,我们经常将程序分解为不同的进程或线程。这是一个有用的抽象,让我们能够将任务(如实现一个网络浏览器)分解为更容易编写的子任务。我发现通过多代理角色进行思考也是一个有用的抽象。
在许多公司中,经理们经常决定要雇佣什么角色,然后如何将复杂的项目——如编写大型软件或准备研究报告——分解为分配给不同专业的员工的较小任务。使用多个代理是类似的。每个代理实现其自己的工作流,拥有自己的记忆(这是代理技术中一个迅速发展的领域:代理如何记住足够的过去互动来在即将到来的任务中表现得更好?),并可能请求其他代理的帮助。代理还可以参与规划和工具使用。这会导致LLM调用和代理之间的信息传递的嘈杂声,从而产生非常复杂的工作流。
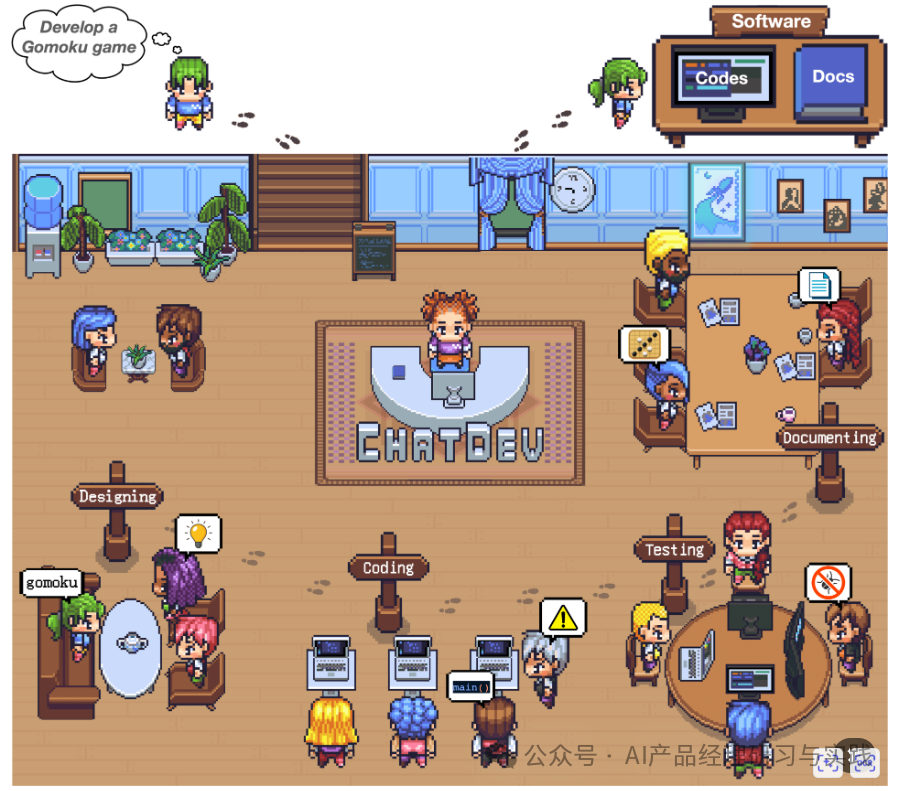
虽然管理人员很困难,但这是一个我们足够熟悉的概念,它为我们提供了如何“雇佣”并分配任务给我们的AI代理的心理框架。幸运的是,管理不善AI代理造成的损害远低于管理不善人类!
像AutoGen、Crew AI和LangGraph这样的新兴框架,提供了构建多代理解决方案的丰富方式。如果你有兴趣尝试一个有趣的多代理系统,也可以查看ChatDev(补充:和Andrew不同,笔者本人更推荐查看、尝试MetaGPT和ModelScope),一个运行虚拟软件公司的代理集的开源实现。我鼓励你查看他们的GitHub仓库,也许克隆该仓库并自己运行系统。虽然它可能不总是产生你想要的结果,但你可能会惊讶于它做得有多好。
就像规划的设计模式一样,我发现多代理合作的输出质量很难预测,特别是当允许代理自由互动并为它们提供多个工具时。更成熟的反思和工具使用模式更可靠。我希望你喜欢玩这些代理设计模式,并希望它们为你带来惊人的结果!
如果你有兴趣了解更多,我推荐:
- “Communicative Agents for Software Development,” Qian et al. (2023) (the ChatDev paper)
- “AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversation,” Wu et al. (2023)
- “MetaGPT: Meta Programming for a Multi-Agent Collaborative Framework,” Hong et al. (2023)
06
—
总结与延伸
这四种代理设计模式为AI产品的设计和开发提供了新的思路和方法。作为AI产品经理,我们需要深入理解这些模式的原理和应用,以便将它们融入产品创新中,不仅解决用户的现有问题,也为用户探索未来可能的需求。同时,通过这些模式,我们还可以更好地理解人工智能的潜力和局限,制定出更合理的产品规划和发展战略。
反思模式让AI能够自我评估和改进,这对于构建更智能、更自适应的产品至关重要。作为AI产品经理,我们可以利用这一模式设计出能够在收到用户反馈后自我优化的系统,从而减少持续监督的需要,并提升产品随时间的改进速度。
工具使用模式拓展了AI的能力边界,使其能够执行网络搜索、代码执行等操作,从而处理更复杂的任务。这种模式的应用使得我们的AI产品不再局限于事先编码的知识,而是可以动态地访问和利用外部资源,以解决用户面临的实时问题。
规划模式为AI系统提供了制定和执行多步计划的能力,这对于那些需要执行复杂任务或决策过程的产品来说,是一个巨大的进步。通过这种模式,AI不仅能够更有效地完成任务,还能为用户提供更加连贯、逻辑性更强的互动体验。
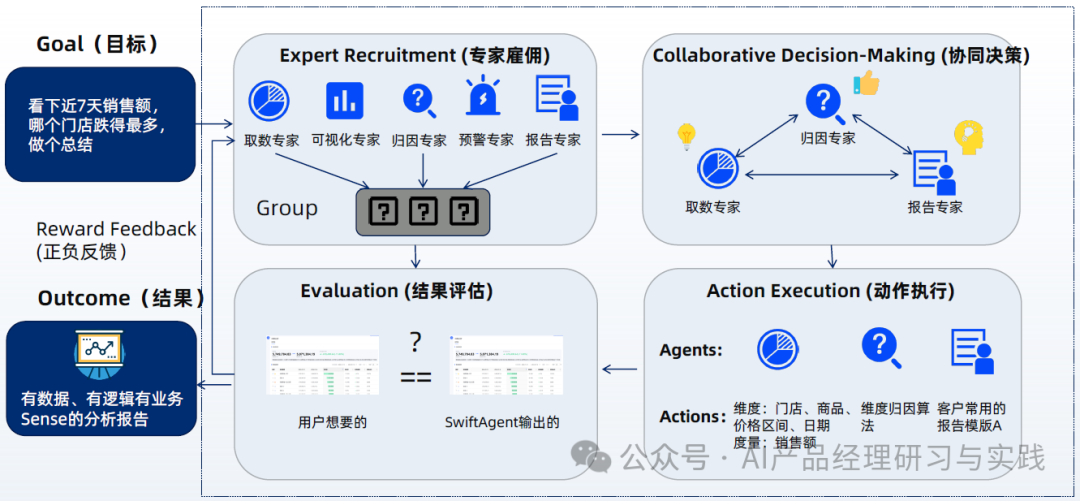
多代理合作模式则开辟了AI技术合作的新领域。通过让不同的AI代理协同工作,我们可以解决单一代理无法处理的复杂问题,或是在创造性任务中产生更多创新的解决方案。作为产品经理,利用这一模式可以开发出团队协作工具、创意生成平台等多种产品,极大地扩展了AI的应用场景。
说到这,我又忍不住说说之前看到关于AI+BI,也采用了多代理合作模式的一个设计,深得我心:
不过,我们也必须认识到实施这些先进技术时所面临的挑战和风险:
反思模式:虽然反思模式使AI能够自我评估和改进,提升了模型的自适应性,但这也带来了新的挑战。例如,AI可能会在不恰当的反馈循环中陷入过度优化,导致过拟合或失去对原始任务的关注。此外,自我反思的过程可能会引入意料之外的偏差,特别是当评估标准不完全明确或与人类价值观不一致时。
工具使用模式:它极大地扩展了AI的能力,但同时也增加了系统的复杂性。集成外部工具和服务需要精确的控制和错误处理机制,以防AI执行不当的操作或获取不准确的信息。此外,对外部资源的依赖也可能带来隐私和安全方面的风险,需要产品经理仔细考量数据处理和用户信息保护的合规性问题。
规划模式:尽管它为AI提供了制定和执行复杂策略的能力,但在动态或不确定的环境中,制定有效的多步骤计划仍然是一个挑战。AI的规划能力可能因缺乏对环境变化的适应性或理解不足而受限。此外,过度依赖预先规划的路径可能导致缺乏灵活性,无法应对突发情况。
多代理合作:虽然多代理合作模式提供了解决复杂问题和促进创新的潜力,但代理间的有效协调和沟通是一大挑战。不同代理的目标、策略和优先级可能不一致,导致效率低下或冲突。此外,设计一个能够公平、有效分配任务并评估各代理贡献的系统,也是一项非常复杂的任务。
不过,我始终坚信,道路是曲折的,前途是光明的!
如何学习AI大模型?
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
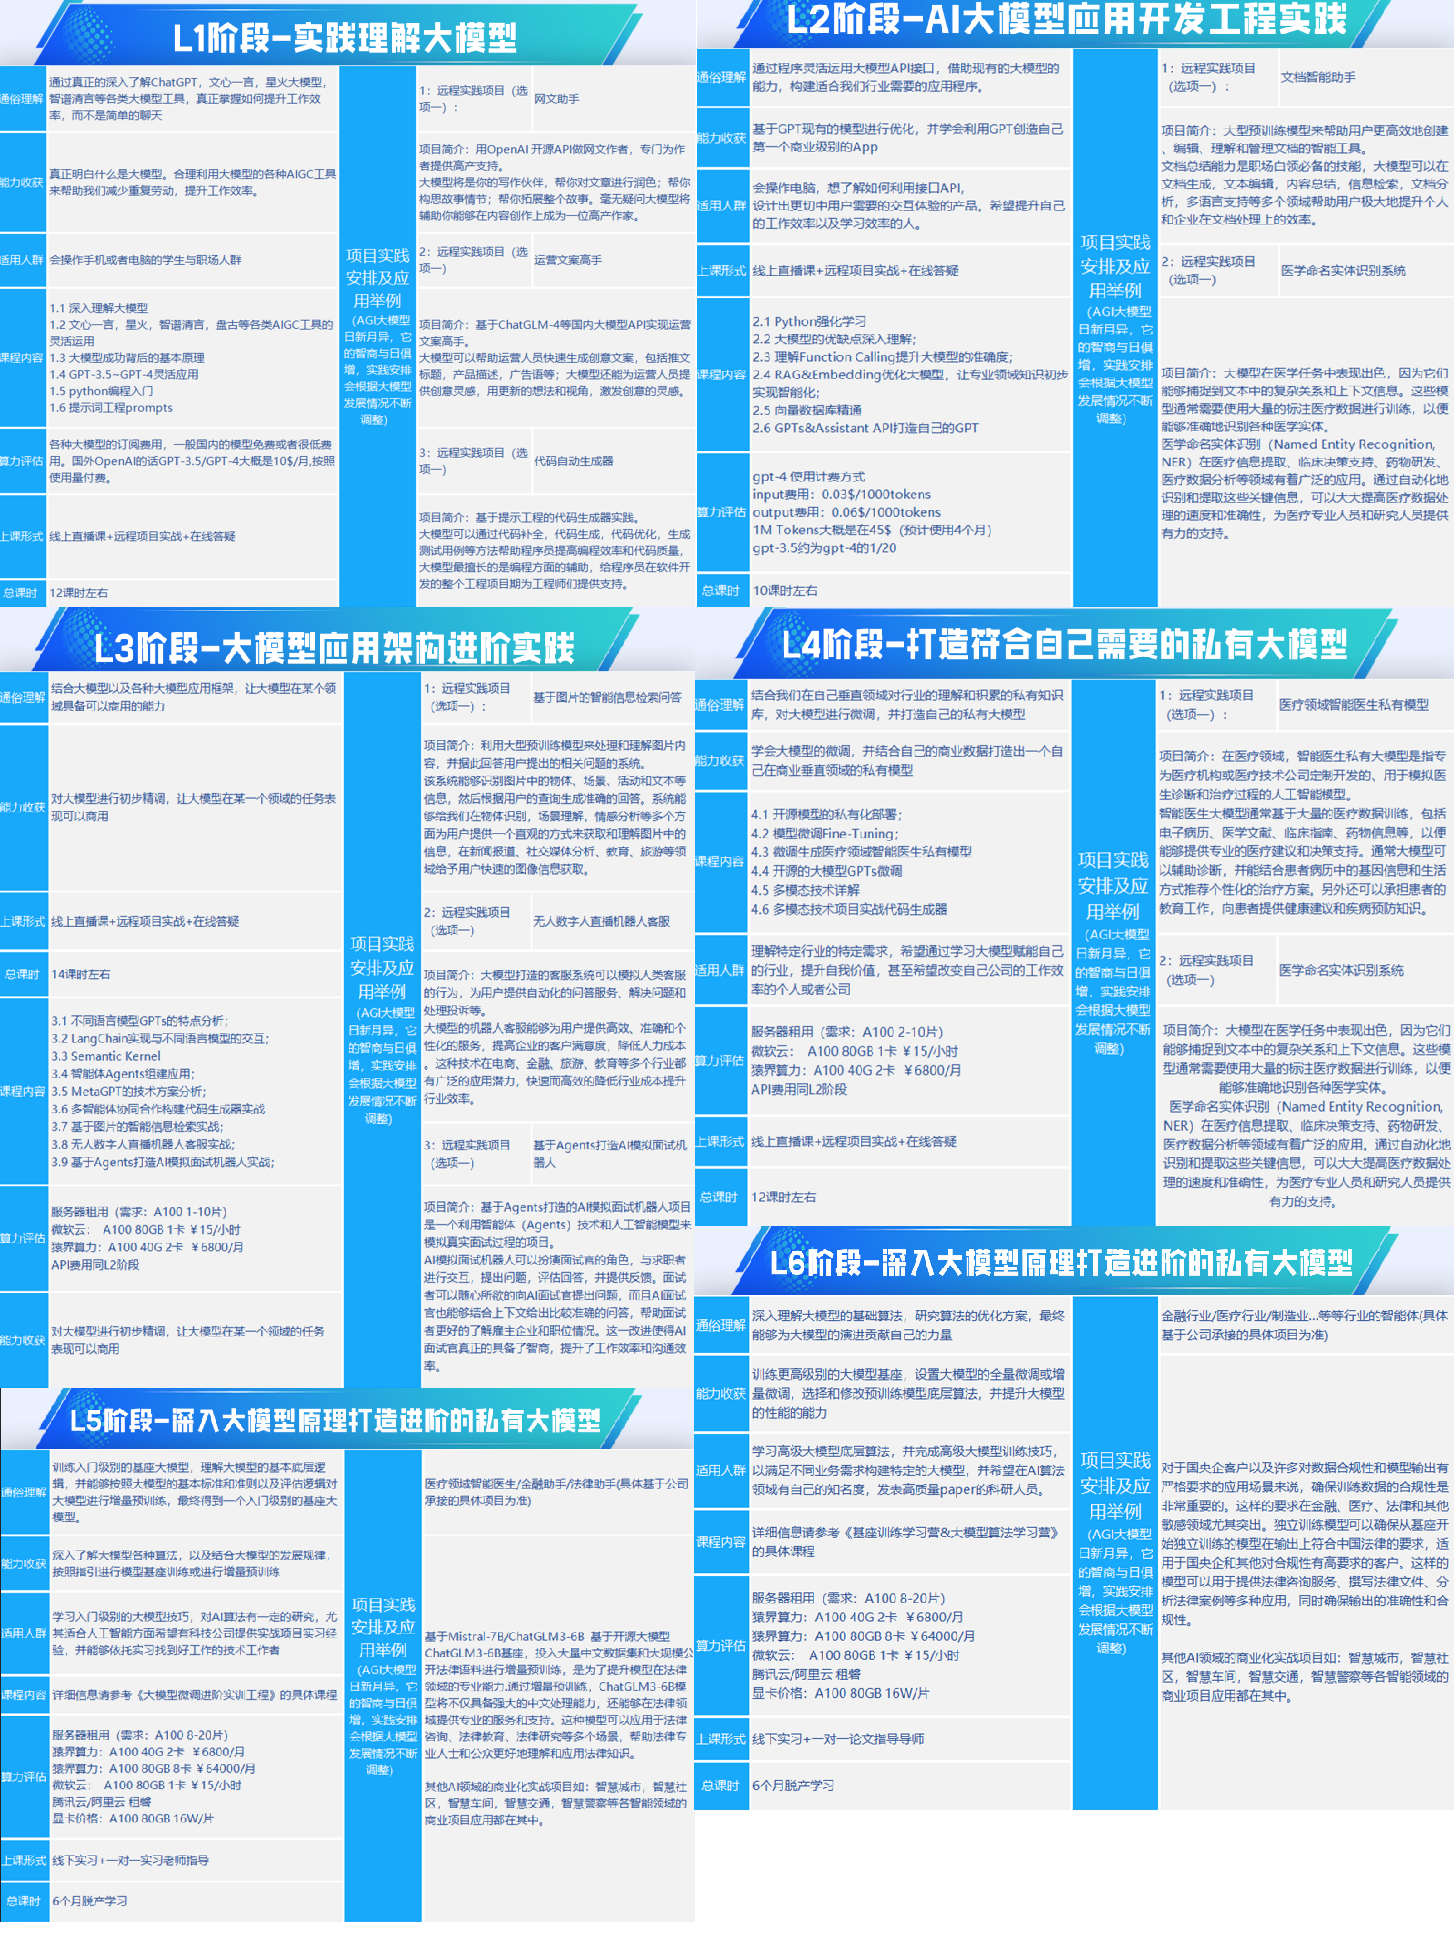
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
四、AI大模型商业化落地方案

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 449


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


