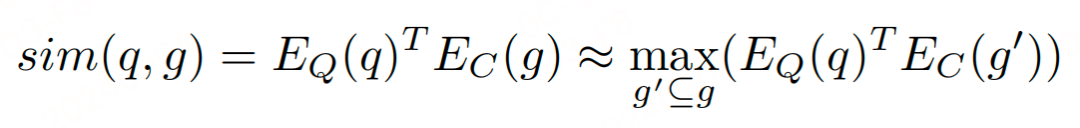【RAG】LongRAG:利用长上下文LLMs增强检索增强生成

FFT去除频率分量的完整流程与数学分析 重叠与窗口:确保块间无缝过渡,避免幅度跳变;实时缓冲:处理速度需快于数据输入速度,避免断流;DAC的平滑角色:通过数模转换和滤波,将离散样点还原为连续波形。通过这种分段处理+重叠拼接的方法,即使FFT本身处理的是离散数据块,最终DAC输出仍能保持信号的时间连续性。以下是完整的数学分析过程和代码逻辑,演示如何通过FFT去除特定频率成分,并通过去窗技术恢复信号。信号加窗。 阅读详情

前言

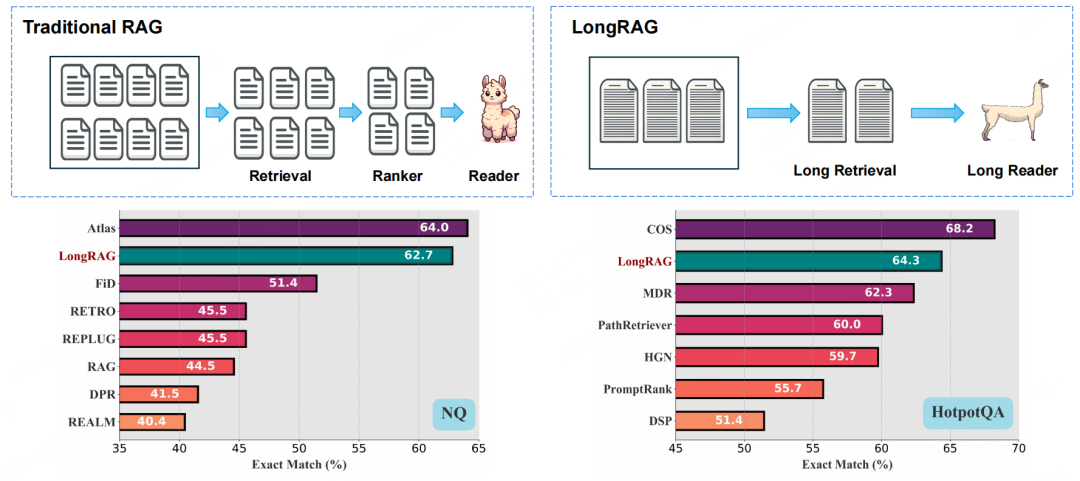
现有的RAG框架通常使用100词的短段落作为检索单元,这种设计使得检索器需要在大量语料库中搜索,增加了工作负担,并且容易引入难负样本,影响性能。LongRAG框架为了解决这一问题,该框架使用长检索单元(最多4K词),显著减少了语料库的大小(从22M减少到600K),从而减轻了检索器的负担,并提高了检索性能。
图片

一、方法

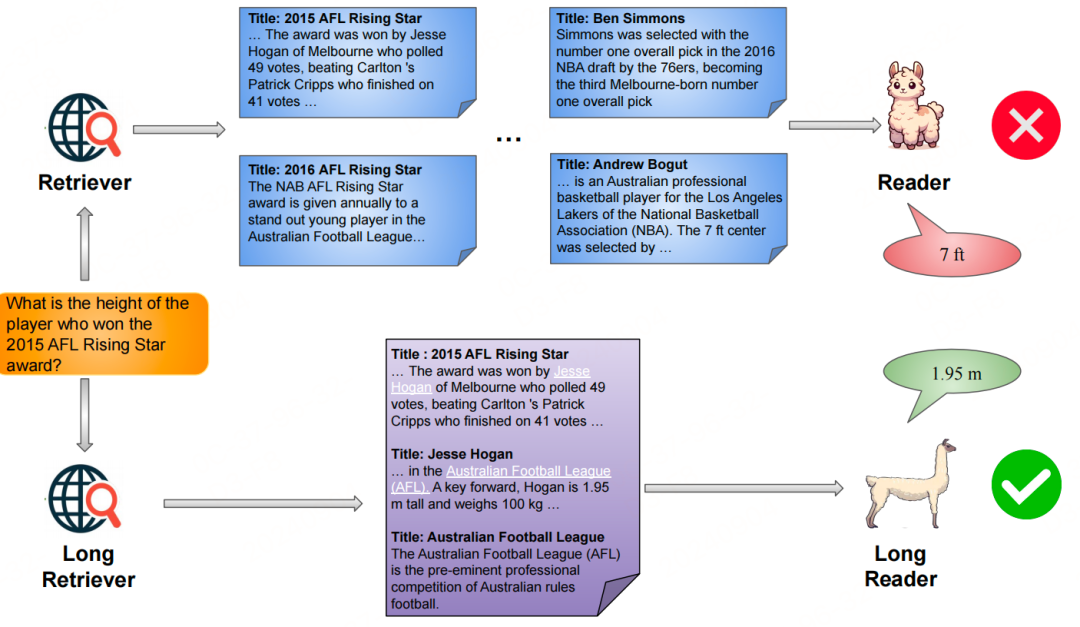
LongRAG框架由两个主要组件构成:长检索器(Long Retriever)和长阅读器(Long Reader)。LongRAG框架的目标是通过使用长检索单元来平衡检索器和阅读器之间的工作负载,并利用长上下文语言模型的能力。
图片

  1. 长检索单元:LongRAG框架通过组合整个文档或相关文档组来形成长检索单元,这些单元的长度超过4K个token。如果原始文档已经很长(例如超过4K个令牌),则将其视为一个单一的检索单元。对于较短的文档,则通过相关文档分组来形成单个检索单元。

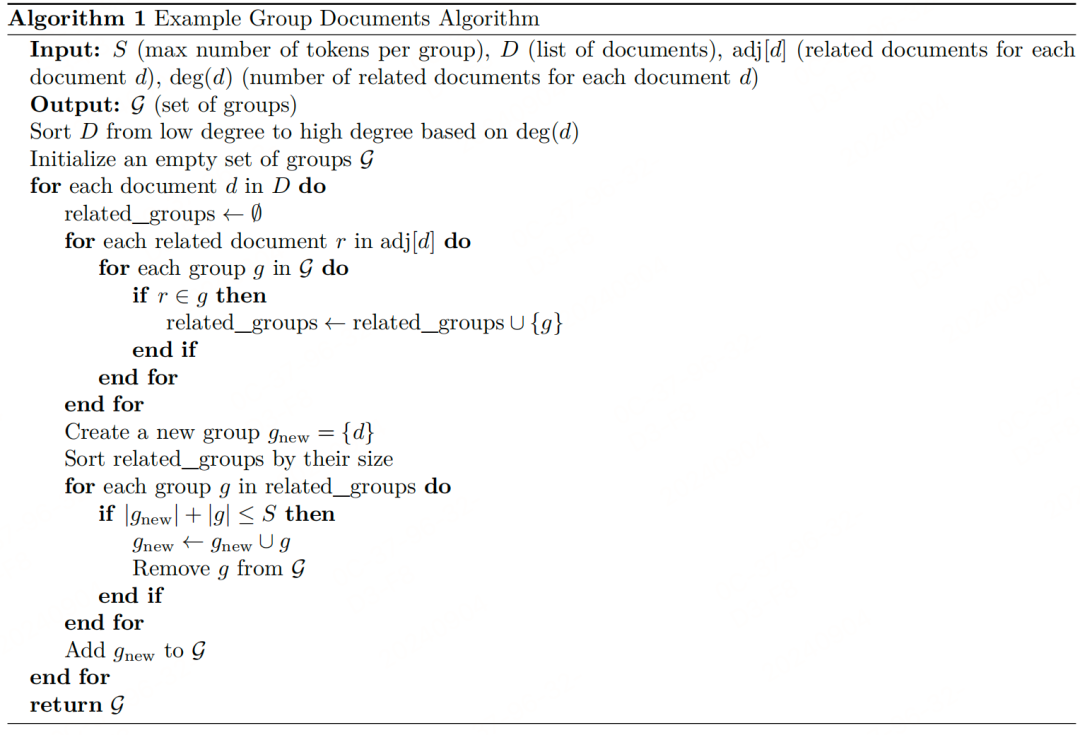
    下面是一种用于将多个短文档分组以形成长检索单元的算法:
    图片

    算法的核心思想是根据文档之间的相关性将它们分组,以便在长检索单元中保留更多的上下文信息。

  2. 长检索器:长检索器的任务是在整个语料库中搜索相关的上下文信息,而不是寻找精确的细粒度短上下文。检索过程分为三个步骤:形成长检索单元、相似性搜索和聚合检索结果。相似性搜索使用编码器将查询和检索单元映射到向量空间,并通过点积计算它们之间的相似性。聚合检索结果时,将前K个最相似的检索单元连接起来作为长上下文。

    • 相似性搜索:使用编码器EQ(·)将输入问题映射到d维向量,使用另一个编码器EC(·)将检索单元映射到d维向量。定义问题和检索单元之间的相似性为向量的点积:

      图片由于g的长度较长,采用近似方法(通过最大化检索单元内所有片段的得分来近似):

      图片

    • 聚合检索结果:将前k个检索单元连接成长上下文作为检索结果:

      图片

  3. 长阅读器:长阅读器将检索到的结果(约30K词)输入现有的长上下文LLM中进行零样本答案生成。不需要任何训练,流程如下:

    提示设计:为了有效地从长上下文中提取答案,长阅读器采用了两步提示法:

    图片提示词模版

    • 第一步提示:将问题和长检索结果拼接后输入到长语言模型中,不使用任何上下文示例。长语言模型生成一个较长的初步答案。
    • 第二步提示:使用8个上下文示例来引导长语言模型从长答案中提取最终的简短答案。
    1. 输入:将相关指令、问题和长检索结果输入到长语言模型中。
    2. 初始答案生成:长语言模型首先生成一个较长的答案,这个答案通常包含几句话。
    3. 答案精炼:通过进一步的提示,长语言模型从初始的长答案中提取出最终的简短答案。

二、实验

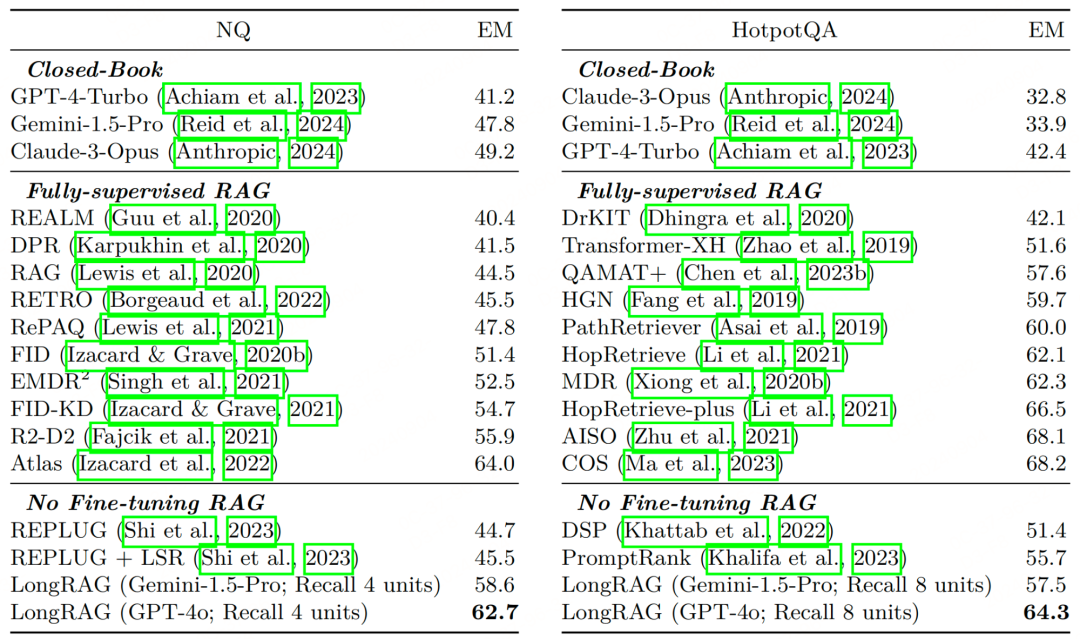
在基于维基百科的数据集上,LongRAG框架在不进行任何训练的情况下,达到了与最先进的全训练RAG模型相当的性能。在非基于维基百科的数据集上,LongRAG框架也表现出色,显著优于传统的RAG框架。
图片

图片

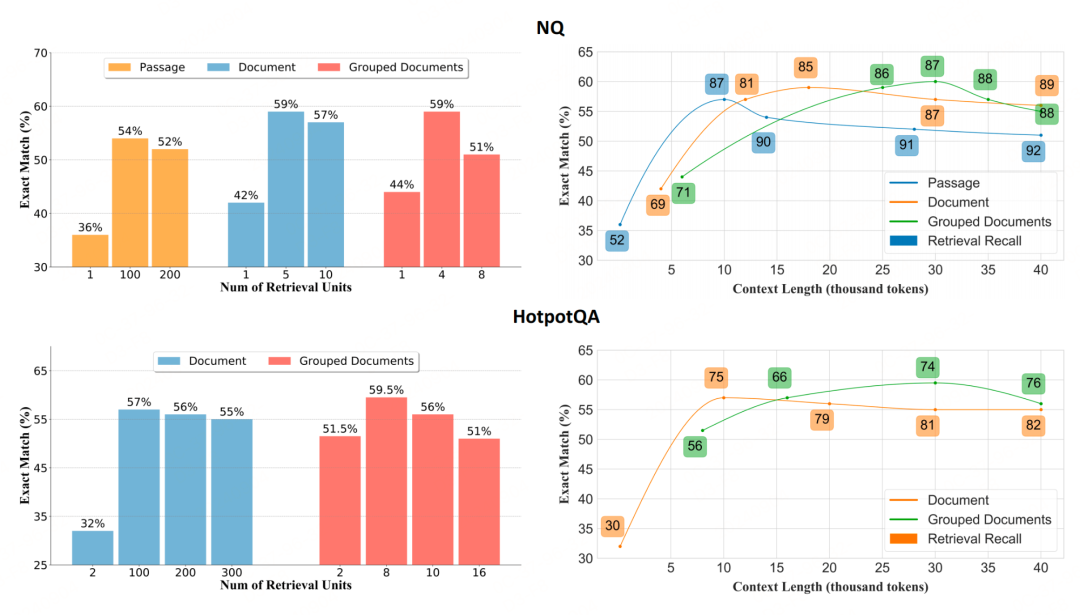
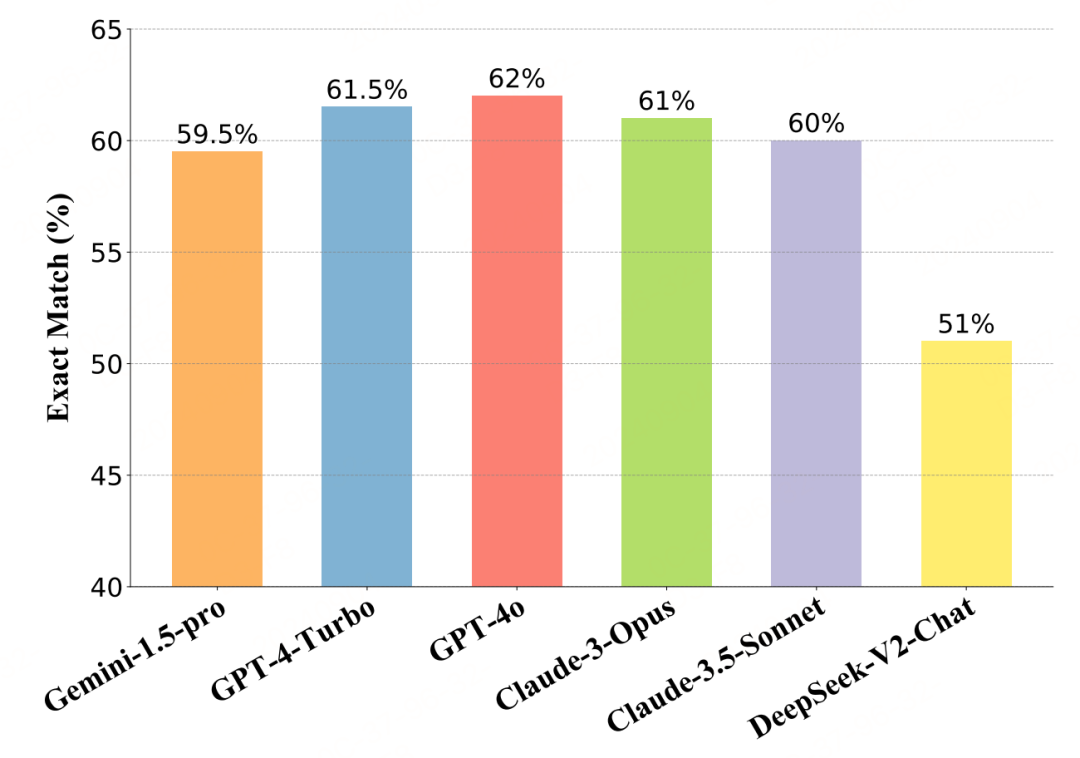
消融实验,验证了长检索单元和长阅读器在提高性能方面的有效性。发现检索单元大小和阅读器变体对性能有显著影响。图片
总结

LongRAG框架通过引入长检索器和长阅读器,减轻了检索器的负担,提高了检索质量和全文问答性能。该框架在不进行任何训练的情况下,达到了与最先进的全训练RAG模型相当的性能。总的来说,LongRAG是一种检索和生成平衡的方法,供参考。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
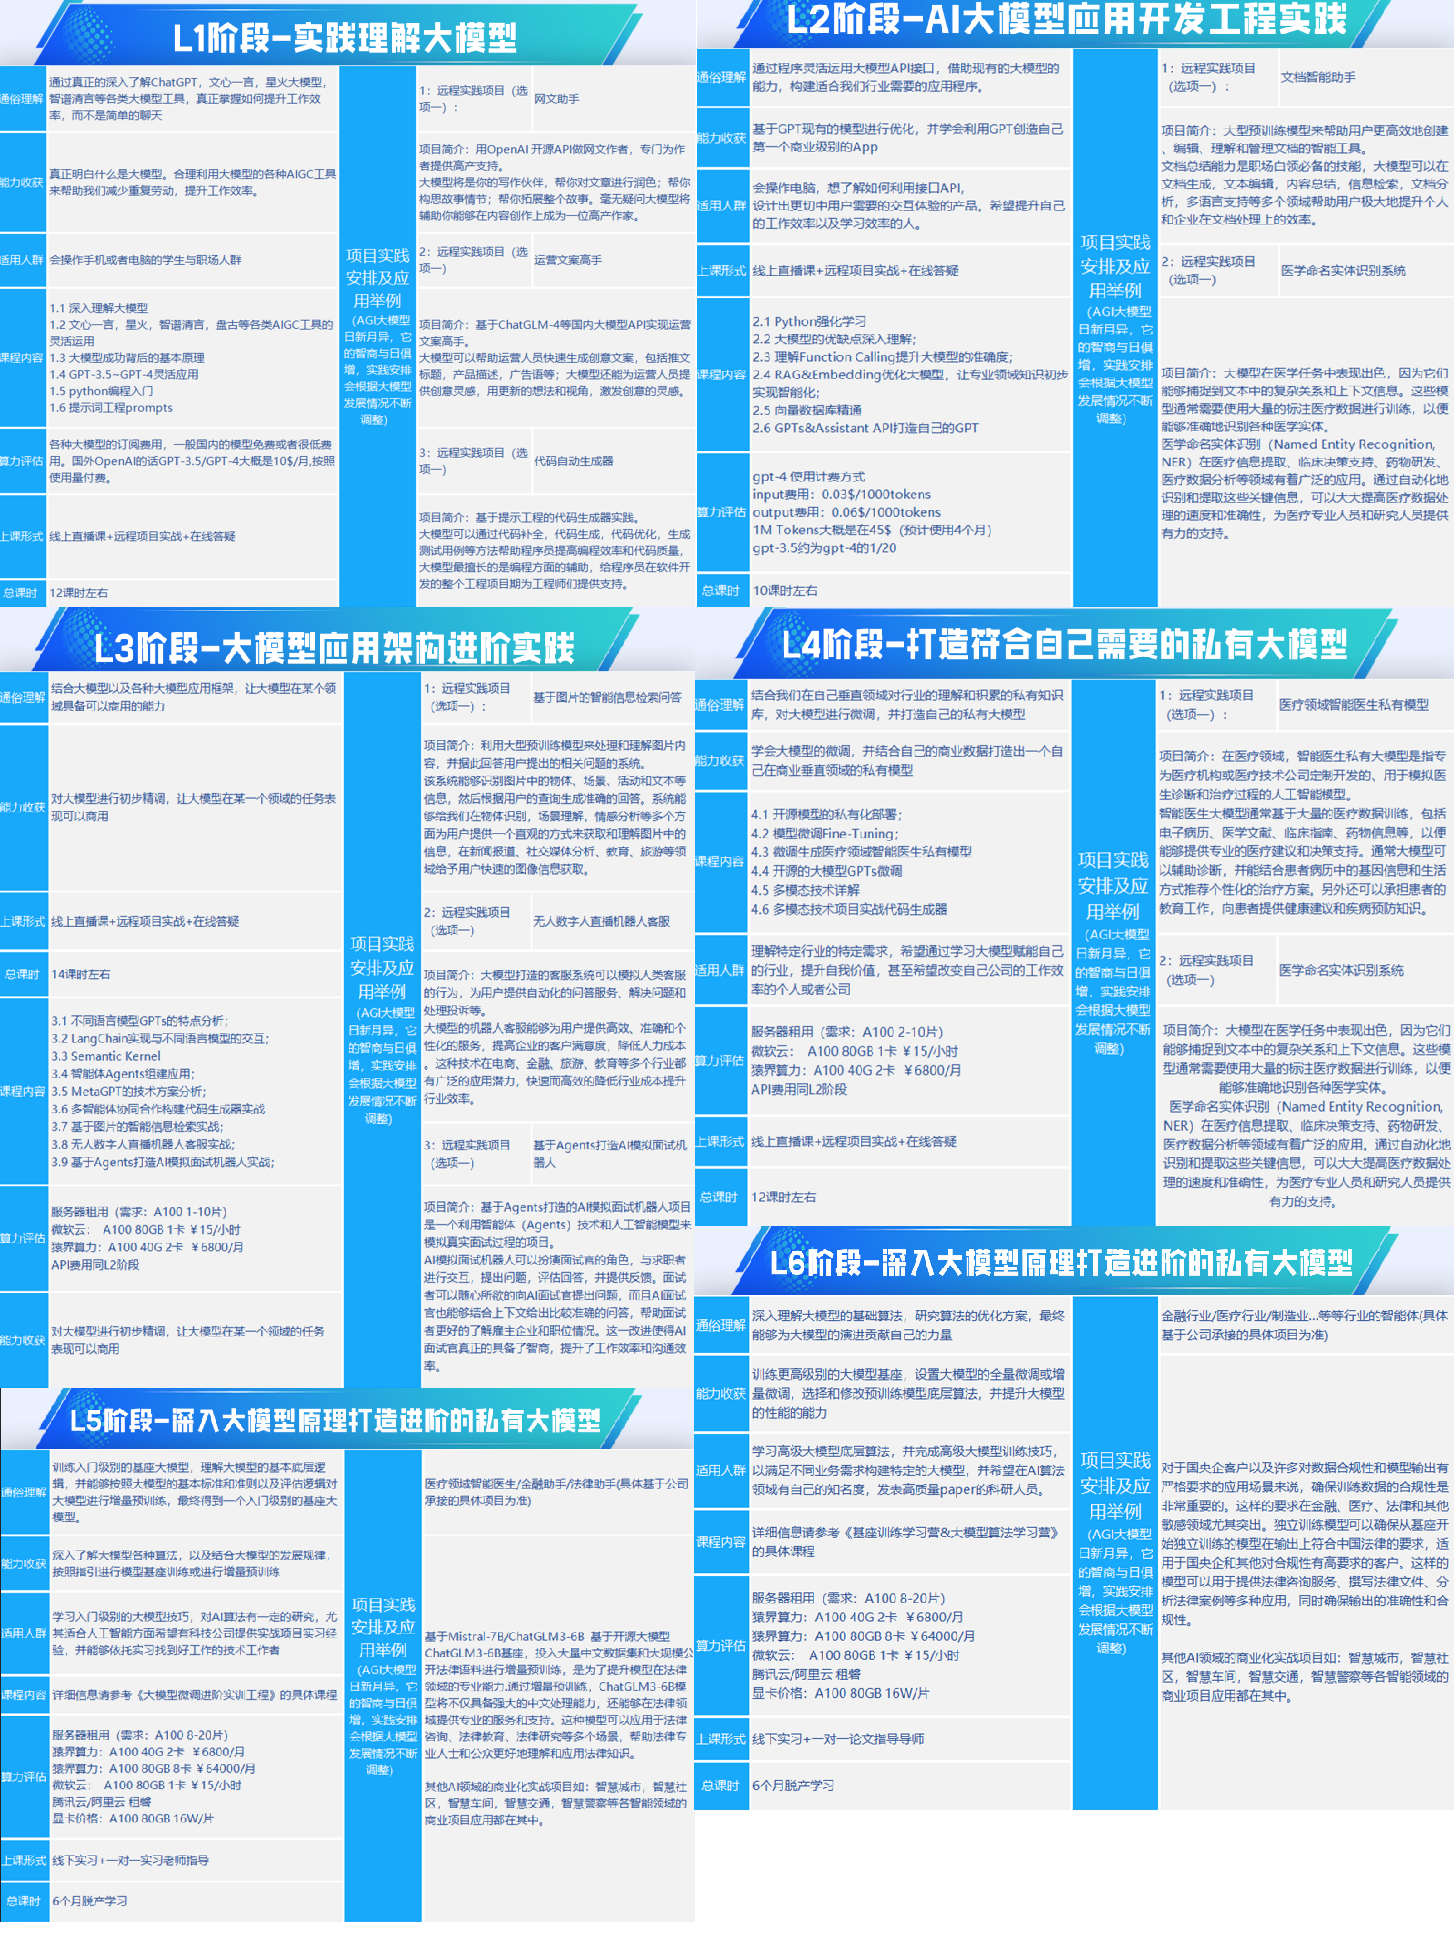
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
img

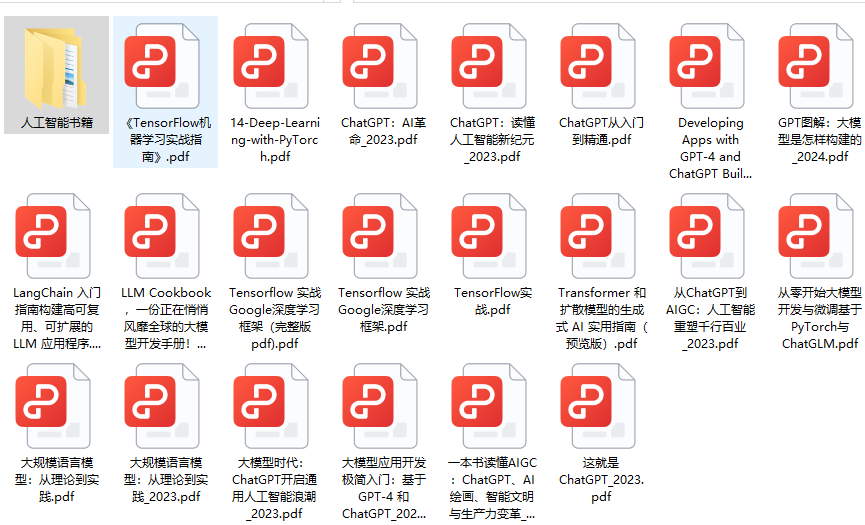
三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

【云原生之Docker实战】使用docker部署Monica个人开源CRM系统 阅读详情

相关推荐

EPLAN Electric P8 2025安装避坑指南:硬件、.NET 6与VM配置全解析

EPLAN Electric P8 是面向工业自动化电气设计的工程级CAD平台,其核心依赖于.NET运行时、DirectX硬件加速与本地许可证验证机制。随着2025版升级至.NET 6.0 Runtime、DirectX 12渲染引擎及双模授权校验,安装失败率显著上升——尤其在显卡驱动陈旧、虚拟机环境或企业离线场景下。技术价值在于保障PLC柜体布局、端子排自动生成、电缆清册输出等产线级功能稳定运行;典型应用场景包括高校电赛控制系统设计、包装线电控图纸交付及集成商多版本协同部署。本文聚焦EPLAN 2025安

weixin_30897079的博客 566

LongRAG:利用长上下文大语言模型提升检索生成效果

LongRAG 框架创新性地解决了传统检索增强生成(RAG)框架中检索器负担过重的问题,通过引入“长检索单元”、“长检索器”和“长阅读器”,将完整的维基百科文章处理成 4K Token 的单元,将语料库大小缩减了 97% 以上,从而显著提升了检索效率和整体性能。LongRAG 的优势主要体现在:在 NQ 和 HotpotQA 数据集上,LongRAG 无需复杂排序机制即可分别实现 71% 的 Recall@1 和 72% 的 Recall@2,远超传统的短文本检索方法。

FrenzyTechAI的博客 3117

利用makehumancommunity导入人体模型到COMSOL里(需要solidwork)

#makehumancommunity #solidwork #COMSOL

qq_41227634的博客 2162

长语境RAG突破:LongRAG如何颠覆传统问答,开启智能检索新篇章?

在传统的RAG框架中,基本的检索单元通常是短的。像DPR这样的常见检索器通常使用100个词的维基百科段落。这样的设计迫使检索器在大型语料库中搜索“针”单元。相比之下,阅读器只需要从这些短的检索单元中提取答案。这种不平衡的“重”检索器和“轻”阅读器设计可能导致次优性能。为了缓解这种不平衡,我们提出了一个新的框架LongRAG,由一个“长检索器”和一个“长阅读器”组成。LongRAG将整个维基百科处理成4K个词的单元,比以前长30倍。通过增加单元大小,我们将总单元数从2200万减少到60万。

m0_59235699的博客 1033

OpenCV函数用法之calibrateCamera

参考链接:opencv中标定函数calibrateCamera_ychl87的专栏-优快云博客 世界坐标系的三维点投影到成像坐标系中的二维点的投影公式如下: 其中(X,Y,Z)为世界坐标系中的三维点; (u,v)为成像面坐标系中的二维点; A为相机的内参数矩阵:(cx,cy)为主光轴点,一般为图像的中心;fx和fy为焦距; [R|t]为相机的外参数矩阵:R为旋转矩阵,t为位移矩阵; 上述公式的简单推理过程如下 考虑到镜头畸变 其中,k1,k2,k3,k4,k5和k6为径向畸变,p1和.

tiger&sheep的博客 3万+

Cesium中GLB模型加载

Cesium中GLB模型加载全解析:Primitive与Entities方法详解

m0_72030584的博客 3474

强强联合!当RAG遇到长上下文,滑铁卢大学发布LongRAG,效果领先GPT-4 Turbo 50%

LongRAG框架的核心优势在于:"长上下文检索器"就像带着重点笔记进考场,能快速定位相关信息,"长阅读器"则像学霸,能准确从长文本中提取关键答案。两者配合,让AI在回答复杂问题时更高效准确。虽然LongRAG表现不错,但仍有提升空间:检索器处理超长文本的能力可以进一步增强。阅读器对长文本的理解还需优化。总的来说,LongRAG为AI问答系统开辟了新方向。随着技术进步,它有望在处理复杂问题方面发挥更大作用。

夕小瑶科技说 728

别再只会用串口助手了!手把手教你用手机App调试HC-05蓝牙模块(STM32F103实战)

本文详细介绍了如何利用手机App调试HC-05蓝牙模块与STM32F103的无线连接,突破传统串口助手的限制。通过实战指南,开发者可以掌握移动性测试、实时监控和快速验证等高效调试技巧,优化蓝牙透传的稳定性和性能。

weixin_33670786的博客 429

GLM-4-Long加持的RAG:更准,更简,更全!

一直以来,“RAG派”与“长上下文派”之间争论不休,然而二者各有优劣,如何选择?最佳答案来了:拒绝选择,全都要。今天实操一种加持的新方法(金融领域研报数据),旨在实现更简洁架构,更精准、更全面的问题解答。加持的(参考LongRAG)GLM-4-Long加持的RAG框架通过简化设计,显著提升了效率。:使用整个文档库或将多个相关文档组合成长检索单元,例如32K个token:负责从大量文本中检索出与问题粗略相关的长文本单元,数量不用太多:处理检索到的长文本,提取和生成答案,最大支持),大约相当于2本红楼梦或者。

2401_85379281的博客 1029

1.14、基于NARX神经网络的磁悬浮建模(matlab)

数据准备:首先,需要准备用于训练和测试的磁悬浮系统的输入和输出数据,包括磁力、电流、位置、速度等信息。数据可以被保存在MATLAB的数据文件中,并加载到工作空间中。使用MATLAB的神经网络工具箱,创建一个NARX神经网络。需要定义网络的层次结构、节点数、激活函数等参数。通常,NARX网络包括自回归层和外部输入层。数据预处理:对加载的数据进行预处理,包括去除噪声、归一化处理等操作,以确保数据质量和网络训练的稳定性。使用MATLAB的训练函数,如trainlm或者trainbr,对NARX神经网络进行训练。

XU157303764的博客 2001

我的世界1.20.1forge模组开发(8)——自定义实体、AI

Overridethis,true,// 仅排除雪傀儡和同类e ->!这段代码是一个实体类的注册行为,通过重写方法来设定实体在游戏中的行为目标。在这段代码中,为一个名为SnowMonster的实体注册了多个行为目标。:设定SnowMonster实体在20 ticks内以5.0的力量进行远程攻击的行为目标。PanicGoal:设定SnowMonster实体在受到惊吓时会进行惊慌行为的目标。:设定SnowMonster实体会避开强大目标的行为目标。

qq_24992377的博客 2082

RankRAG:基于排序增强的单一LLM问答生成框架

Retrieval-augmented generation (RAG) 已成为增强大型语言模型 (LLM) 的一项关键技术,使其能够处理专业知识、提供当前信息并适应特定领域,而无需改变模型权重。然而,当前的 RAG 流程面临着重大挑战。LLM 难以有效地处理大量分块的上下文,通常在较小的、高度相关的上下文集中表现更好。此外,在有限数量的检索到的上下文中确保相关内容的高召回率也带来了挑战。虽然单独的排序模型可以改进上下文选择,但与通用的 LLM 相比,它们的零样本泛化能力通常有限。

m0_59164520的博客 1195

DBT关键切片重建算法

DBT通过有限角度(通常15°~50°)扫描,获取一系列低剂量投影图,重建出三维断层图像。传统FBP在稀疏角度下会产生严重的“伪影拖尾”和层间干扰。临床诊断中,放射科医生往往只关注几层关键切片(即病灶所在层),其余层仅作参考。

AI的内部世界的博客 90

LongRAG:增强长上下文大语言模型的检索增强生成

在传统的RAG框架中,检索单元通常较短,如100字的维基百科段落。检索器需要在庞大的语料库中搜索,这增加了检索负担。为了减轻这种负担,作者提出了LongRAG框架,包括“长检索器”和“长阅读器”,将整个维基百科处理成4K-token的单位,使检索单元减少至60万,大大减轻了检索器的负担,显著提高了检索性能。在不需要训练的情况下,LongRAG在NQ和HotpotQA(全维基)上达到了62.7%和64.3%的EM(精确匹配)率,与最先进的模型相当。

程序员石磊 1596

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

LongRAG:增强检索增强生成,实现长上下文LLM的高效利用

LongRAG:增强检索增强生成,实现长上下文LLM的高效利用 项目介绍 LongRAG 是一个开源项目,旨在通过结合长上下文的语言模型(LLM)来提升检索增强生成(RAG)的性能。在传统的 RAG 框架中,检索单元通常较短,导致检索器需要在大量语料库中寻找“针尖”般的单元,而阅读器仅需要从短小的检索单元中提取答案。这种设计使得检索器负担过重而阅读器过轻,可能导致性能不理想。LongRAG 提出了...

gitblog_00911的博客 1078

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

LongRAG:一种用于长上下文问答的双视角检索增强生成范式

结果表明,信息提取器和CoT引导过滤器的联合策略(E&F)在所有数据集上均表现最佳,显著提高了系统的性能。这篇论文提出了LongRAG,一种通用的、双视角的、鲁棒的基于LLMs的RAG系统范式,用于解决LCQA任务中的全局信息和事实细节识别问题。:E&F组件在不同数据集上的迁移性分析表明,使用低成本本地模型(如ChatGLM3-6B-32k)替代昂贵的在线API资源,仍能取得优异的性能。其中,Ig表示全局信息,Id​表示事实细节,LLM表示LLM模型,promptg表示生成器的提示模板。

qq_59084968的博客 975

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

LongRAG:通过长上下文大型语言模型增强检索增强生成

LongRAG旨在解决传统检索增强生成(RAG)系统的限制,这些系统通常使用较短的检索单元。在传统配置中,这些短单元导致检索器负担沉重,而阅读器的任务相对较轻,常常导致性能不佳。LongRAG提议使用长达4K个token的更长检索单元,减少所需的总单元数量,并显著减轻检索器的任务。这种方法显著提高了检索得分,与以前的方法相比,召回率大幅提高。

xx_nm98的博客 769

RAG前沿之RAG–知识图谱构建框架Graphusion:兼看LongRAG双视角检索增强生成范式

本文主要围绕RAG,介绍了2个工作,一个是RAG与知识图谱结合:全局视角的知识图谱构建RAG框架Graphusion,重点看看其使用RAG做推理补全;一个是长文本RAG:LongRAG双视角检索增强生成范式,可以看看其分阶段的思路。这两个工作都是prompt-based的,现在看来看去,都是prompt在驱动,没啥太大新意。但跟进前沿,也不错哦。因为这个行业不同于其他行业,知识体系实在是过于庞大,知识更新也非常快。

Android23333的博客 806

RAG前沿 | 知识图谱构建框架Graphusion:兼看LongRAG双视角检索增强生成范式

本文主要围绕RAG,介绍了2个工作,一个是RAG与知识图谱结合:全局视角的知识图谱构建RAG框架Graphusion,重点看看其使用RAG做推理补全;另一个是长文本RAG:LongRAG双视角检索增强生成范式,可以看看其分阶段的思路。这两个工作都是prompt-based的,现在看来看去,都是prompt在驱动,没啥太大新意。但跟进前沿,也不错哦。参考文献AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。

Androiddddd的博客 1077

技术动态 | RAG前沿之RAG–知识图谱构建框架Graphusion:兼看LongRAG双视角检索增强生成范式

本文主要围绕RAG,介绍了2个工作,一个是RAG与知识图谱结合:全局视角的知识图谱构建RAG框架Graphusion,重点看看其使用RAG做推理补全;另一个是长文本RAG:LongRAG双视角检索增强生成范式,可以看看其分阶段的思路。

Python_cocola的博客 552

Graphusion框架革新RAG领域:构建知识图谱新架构,探讨LongRAG双视角检索增强生成新范式

除了合并和解决冲突外,Graphusion还可以从。

Everly_的博客 766

大模型RAG:大模型如何利用长上下文打造前沿RAGLLMs(一)

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

m0_56255097的博客 1003

技术动态 | RAG前沿之RAG–知识图谱构建框架Graphusion:兼看LongRAG双视角检索增强生成范式...

转载公众号 |老刘说NLP本文继续看RAG前沿进展,围绕RAG,介绍2个工作,一个是RAG与知识图谱结合:全局视角的知识图谱构建RAG框架Graphusion,重点看看其使用RAG做推理补全;一个是长文本RAG:LongRAG双视角检索增强生成范式,可以看看其分阶段的思路和prompt的设计。一、RAG与知识图谱结合:全局视角的知识图谱构建RAG框架Graphusion大模型已被用于知识图谱构建...

开放知识图谱 267

超越“迷失中间”:如何让长上下文问题回答更智能——探索LongRAG的创新

更重要的是,LongRAG系统可以在不依赖昂贵的API(如GPT-3.5)的情况下,通过本地部署的小型LLMs实现相似的性能表现,显著降低了使用成本。通过双视角的设计,它有效地克服了传统RAG系统在处理长文档时的局限性,让模型能够在复杂的长文档中找到核心信息。例如,在回答一个关于物理学家爱因斯坦的问题时,如果他的重要成就分散在多个段落中,信息提取器会将这些段落重新组合,确保模型能够捕捉到所有相关的全球背景信息。文档块的切割策略给RAG系统带来了挑战,尤其是当一个文档的关键信息分散在不同的块中时。

步子哥的博客 876
上一篇: HRGraph: 利用大型语言模型(LLMs)构建基于信息传播的HR数据知识图谱与职位推荐
下一篇: 先到先得!字节内传380页《从零开始大模型开发与微调基于PyTorch与ChatGLM》学习笔记
冻感糕人~
博客等级 码龄3年 8926粉丝 2399原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值