


简介: 在本文中我们将探讨使用开源大型语言多模态模型(Large Language Multi-Modal)构建检索增强生成(RAG)系统。本文的重点是在不依赖LangChain或LLlama index的情况下实现这一目标,这样可以避免更多的框架依赖。
什么是RAG
在人工智能领域,检索增强生成(retrieve - augmented Generation, RAG)作为一种变革性技术改进了大型语言模型(Large Language Models)的能力。从本质上讲,RAG通过允许模型从外部源动态检索实时信息来增强AI响应的特异性。
该体系结构将生成能力与动态检索过程无缝结合,使人工智能能够适应不同领域中不断变化的信息。与微调和再训练不同,RAG提供了一种经济高效的解决方案,允许人工智能在不改变整个模型的情况下能够得到最新和相关的信息。
RAG的作用
1、提高准确性和可靠性:
通过将大型语言模型(llm)重定向到权威的知识来源来解决它们的不可预测性。降低了提供虚假或过时信息的风险,确保更准确和可靠的反应。
2、增加透明度和信任:
像LLM这样的生成式人工智能模型往往缺乏透明度,这使得人们很难相信它们的输出。RAG通过允许组织对生成的文本输出有更大的控制,解决了对偏差、可靠性和遵从性的关注。
3、减轻幻觉:
LLM容易产生幻觉反应——连贯但不准确或捏造的信息。RAG通过确保响应以权威来源为基础,减少关键部门误导性建议的风险。
4、具有成本效益的适应性:
RAG提供了一种经济有效的方法来提高AI输出,而不需要广泛的再训练/微调。可以通过根据需要动态获取特定细节来保持最新和相关的信息,确保人工智能对不断变化的信息的适应性。
多模式模态模型
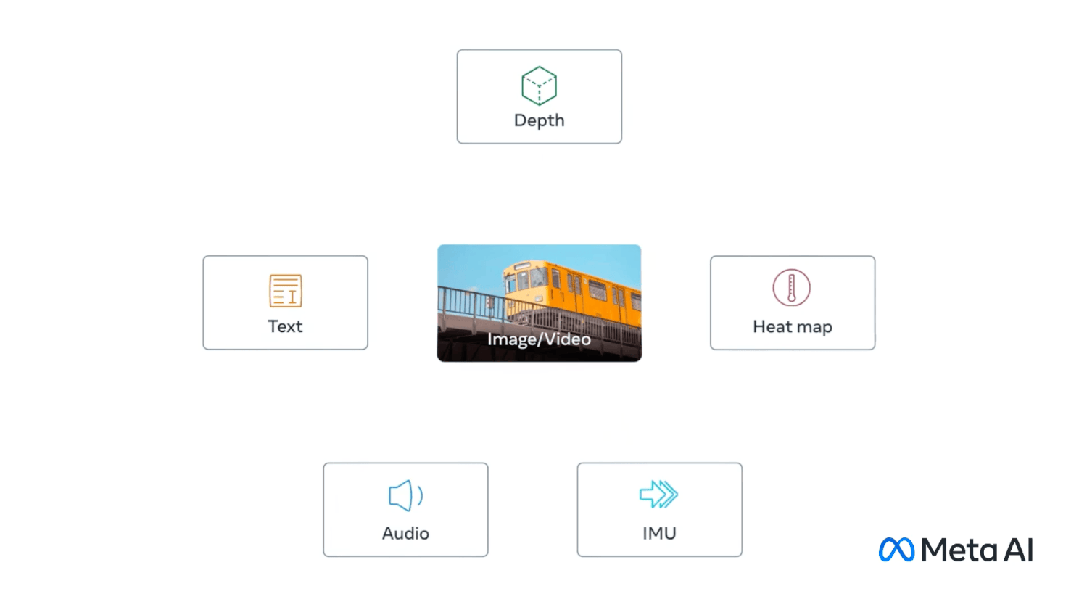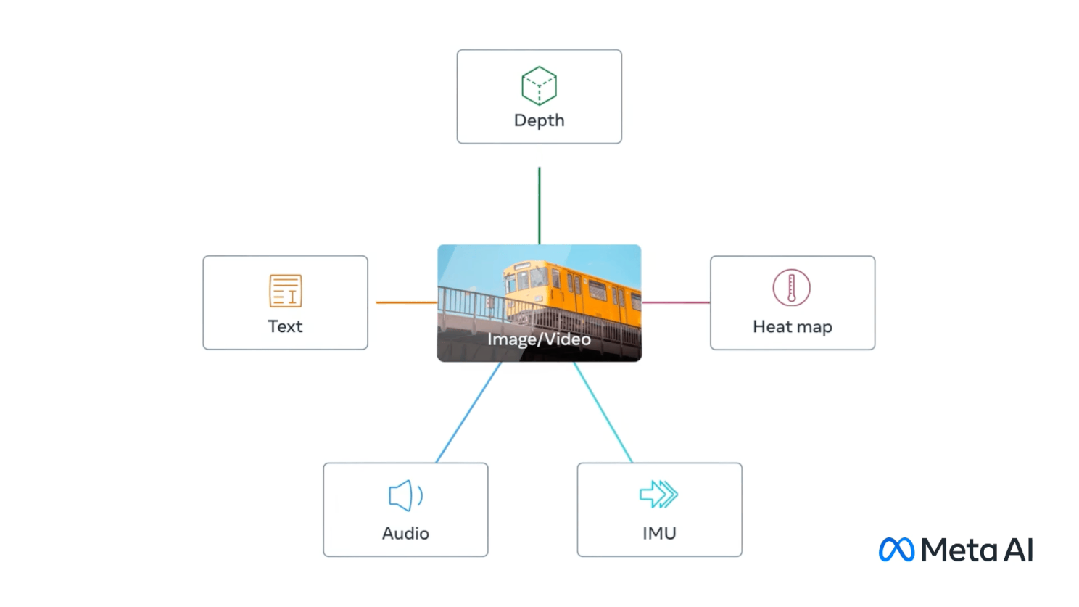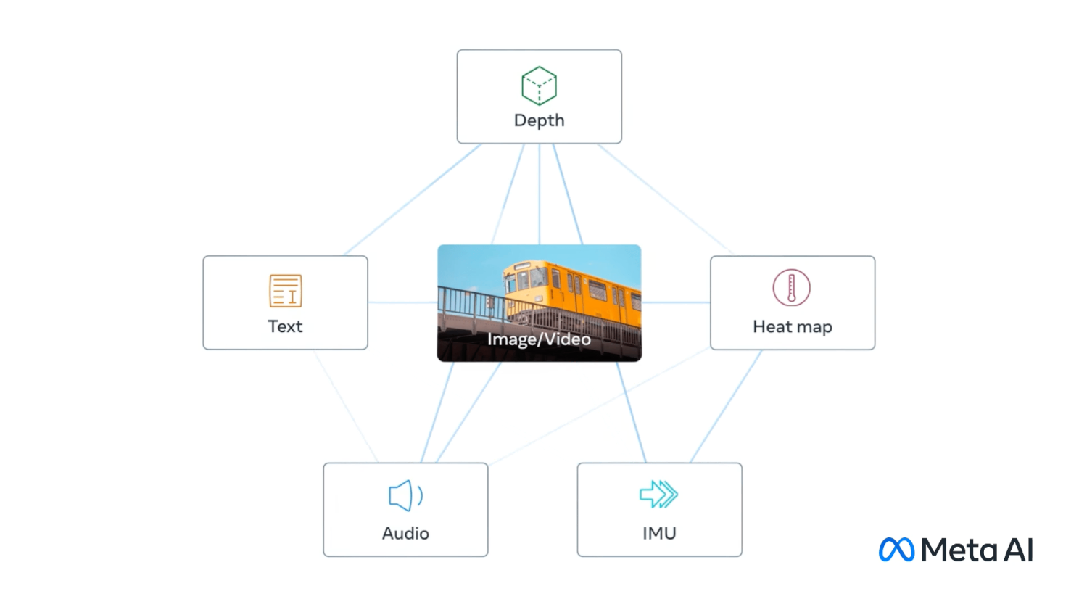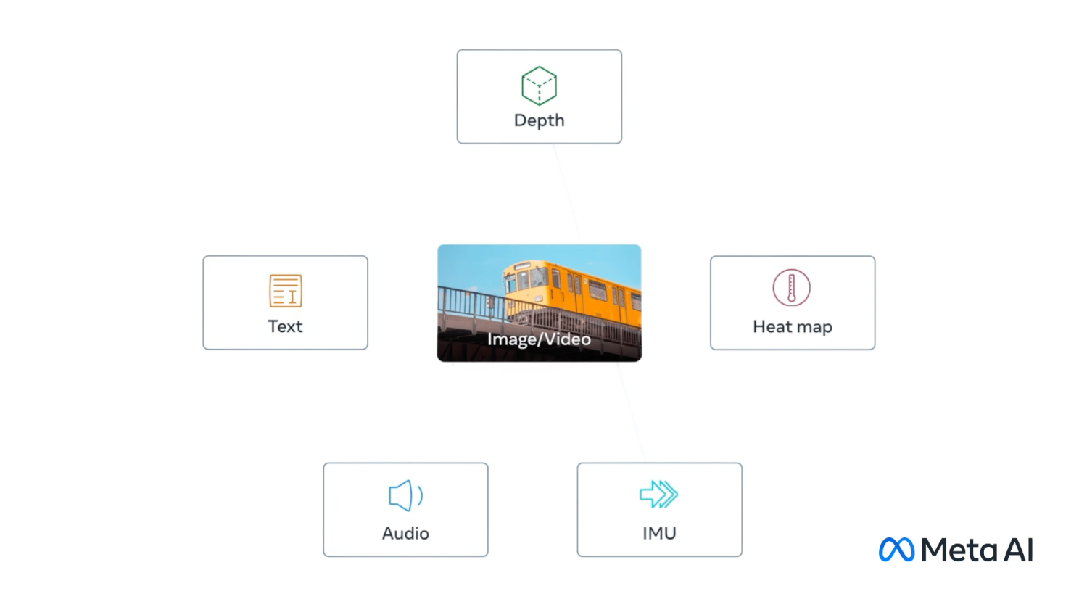
多模态涉及有多个输入,并将其结合成单个输出,以CLIP为例:CLIP的训练数据是文本-图像对,通过对比学习,模型能够学习到文本-图像对的匹配关系。
该模型为表示相同事物的不同输入生成相同(非常相似)的嵌入向量。
多模
态大型语言(multi-modal large language)
GPT4v和Gemini vision就是探索集成了各种数据类型(包括图像、文本、语言、音频等)的多模态语言模型(MLLM)。虽然像GPT-3、BERT和RoBERTa这样的大型语言模型(llm)在基于文本的任务中表现出色,但它们在理解和处理其他数据类型方面面临挑战。为了解决这一限制,多模态模型结合了不同的模态,从而能够更全面地理解不同的数据。
多模态大语言模型它超越了传统的基于文本的方法。以GPT-4为例,这些模型可以无缝地处理各种数据类型,包括图像和文本,从而更全面地理解信息。
与RAG相结合
这里我们将使用Clip嵌入图像和文本,将这些嵌入存储在ChromDB矢量数据库中。然后将利用大模型根据检索到的信息参与用户聊天会话。
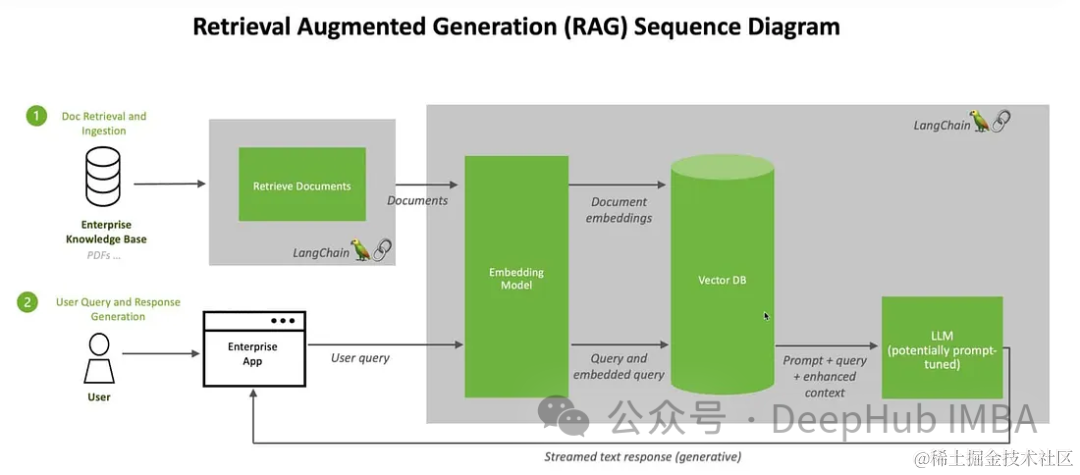
我们将使用来自Kaggle的图片和维基百科的信息来创建一个花卉专家聊天机器人
首先我们安装软件包:
 ! pip install -q timm einops wikipedia chromadb open_clip_torch
 !pip install -q transformers==4.36.0
 !pip install -q bitsandbytes==0.41.3 accelerate==0.25.0
预处理数据的步骤很简单只是把图像和文本放在一个文件夹里
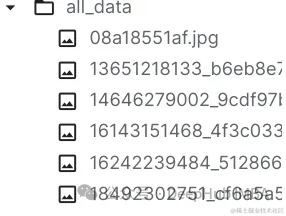
可以随意使用任何矢量数据库,这里我们使用ChromaDB。
 import chromadb

 from chromadb.utils.embedding_functions import OpenCLIPEmbeddingFunction
 from chromadb.utils.data_loaders import ImageLoader
 from chromadb.config import Settings


 client = chromadb.PersistentClient(path="DB")

 embedding_function = OpenCLIPEmbeddingFunction()
 image_loader = ImageLoader() # must be if you reads from URIs
ChromaDB需要自定义嵌入函数
 from chromadb import Documents, EmbeddingFunction, Embeddings

 class MyEmbeddingFunction(EmbeddingFunction):
     def __call__(self, input: Documents) -> Embeddings:
         # embed the documents somehow or images
         return embeddings
这里将创建2个集合,一个用于文本,另一个用于图像
 collection_images = client.create_collection(
     name='multimodal_collection_images',
     embedding_function=embedding_function,
     data_loader=image_loader)

 collection_text = client.create_collection(
     name='multimodal_collection_text',
     embedding_function=embedding_function,
     )

 # Get the Images
 IMAGE_FOLDER = '/kaggle/working/all_data'


 image_uris = sorted([os.path.join(IMAGE_FOLDER, image_name) for image_name in os.listdir(IMAGE_FOLDER) if not image_name.endswith('.txt')])
 ids = [str(i) for i in range(len(image_uris))]

 collection_images.add(ids=ids, uris=image_uris) #now we have the images collection
对于Clip,我们可以像这样使用文本检索图像
 from matplotlib import pyplot as plt

 retrieved = collection_images.query(query_texts=["tulip"], include=['data'], n_results=3)
 for img in retrieved['data'][0]:
     plt.imshow(img)
     plt.axis("off")
     plt.show()
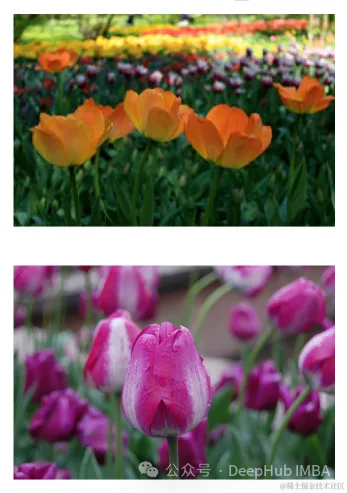
也可以使用图像检索相关的图像
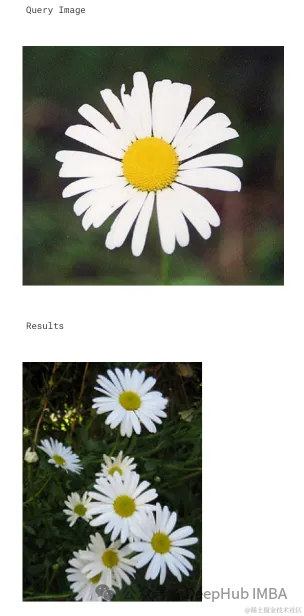
文本集合如下所示
 # now the text DB
 from chromadb.utils import embedding_functions
 default_ef = embedding_functions.DefaultEmbeddingFunction()

 text_pth = sorted([os.path.join(IMAGE_FOLDER, image_name) for image_name in os.listdir(IMAGE_FOLDER) if image_name.endswith('.txt')])

 list_of_text = []
 for text in text_pth:
     with open(text, 'r') as f:
         text = f.read()
         list_of_text.append(text)

 ids_txt_list = ['id'+str(i) for i in range(len(list_of_text))]
 ids_txt_list

 collection_text.add(
     documents = list_of_text,
     ids =ids_txt_list
 )
然后使用上面的文本集合获取嵌入
 results = collection_text.query(
     query_texts=["What is the bellflower?"],
     n_results=1
 )

 results
结果如下:
 {'ids': [['id0']],
  'distances': [[0.6072186183744086]],
  'metadatas': [[None]],
  'embeddings': None,
  'documents': [['Campanula () is the type genus of the Campanulaceae family of flowering plants. Campanula are commonly known as bellflowers and take both their common and scientific names from the bell-shaped flowers—campanula is Latin for "little bell".\nThe genus includes over 500 species and several subspecies, distributed across the temperate and subtropical regions of the Northern Hemisphere, with centers of diversity in the Mediterranean region, Balkans, Caucasus and mountains of western Asia. The range also extends into mountains in tropical regions of Asia and Africa.\nThe species include annual, biennial and perennial plants, and vary in habit from dwarf arctic and alpine species under 5 cm high, to large temperate grassland and woodland species growing to 2 metres (6 ft 7 in) tall.']],
  'uris': None,
  'data': None}
或使用图片获取文本
 query_image = '/kaggle/input/flowers/flowers/rose/00f6e89a2f949f8165d5222955a5a37d.jpg'
 raw_image = Image.open(query_image)

 doc = collection_text.query(
     query_embeddings=embedding_function(query_image),

     n_results=1,

 )['documents'][0][0]

上图的结果如下:
A rose is either a woody perennial flowering plant of the genus Rosa (), in the family Rosaceae (), or the flower it bears. There are over three hundred species and tens of thousands of cultivars. They form a group of plants that can be erect shrubs, climbing, or trailing, with stems that are often armed with sharp prickles. Their flowers vary in size and shape and are usually large and showy, in colours ranging from white through yellows and reds. Most species are native to Asia, with smaller numbers native to Europe, North America, and northwestern Africa. Species, cultivars and hybrids are all widely grown for their beauty and often are fragrant. Roses have acquired cultural significance in many societies. Rose plants range in size from compact, miniature roses, to climbers that can reach seven meters in height. Different species hybridize easily, and this has been used in the development of the wide range of garden roses.
这样我们就完成了文本和图像的匹配工作,其实这里都是CLIP的工作,下面我们开始加入LLM。
 from huggingface_hub import hf_hub_download

 hf_hub_download(repo_id="visheratin/LLaVA-3b", filename="configuration_llava.py", local_dir="./", force_download=True)
 hf_hub_download(repo_id="visheratin/LLaVA-3b", filename="configuration_phi.py", local_dir="./", force_download=True)
 hf_hub_download(repo_id="visheratin/LLaVA-3b", filename="modeling_llava.py", local_dir="./", force_download=True)
 hf_hub_download(repo_id="visheratin/LLaVA-3b", filename="modeling_phi.py", local_dir="./", force_download=True)
 hf_hub_download(repo_id="visheratin/LLaVA-3b", filename="processing_llava.py", local_dir="./", force_download=True)
我们是用visheratin/LLaVA-3b
 from modeling_llava import LlavaForConditionalGeneration
 import torch

 model = LlavaForConditionalGeneration.from_pretrained("visheratin/LLaVA-3b")
 model = model.to("cuda")
加载tokenizer
 from transformers import AutoTokenizer

 tokenizer = AutoTokenizer.from_pretrained("visheratin/LLaVA-3b")
然后定义处理器,方便我们以后调用
 from processing_llava import LlavaProcessor, OpenCLIPImageProcessor

 image_processor = OpenCLIPImageProcessor(model.config.preprocess_config)
 processor = LlavaProcessor(image_processor, tokenizer)
下面就可以直接使用了
 question = 'Answer with organized answers: What type of rose is in the picture? Mention some of its characteristics and how to take care of it ?'

 query_image = '/kaggle/input/flowers/flowers/rose/00f6e89a2f949f8165d5222955a5a37d.jpg'
 raw_image = Image.open(query_image)

 doc = collection_text.query(
     query_embeddings=embedding_function(query_image),

     n_results=1,

 )['documents'][0][0]

 plt.imshow(raw_image)
 plt.show()
 imgs = collection_images.query(query_uris=query_image, include=['data'], n_results=3)
 for img in imgs['data'][0][1:]:
     plt.imshow(img)
     plt.axis("off")
     plt.show()
得到的结果如下:
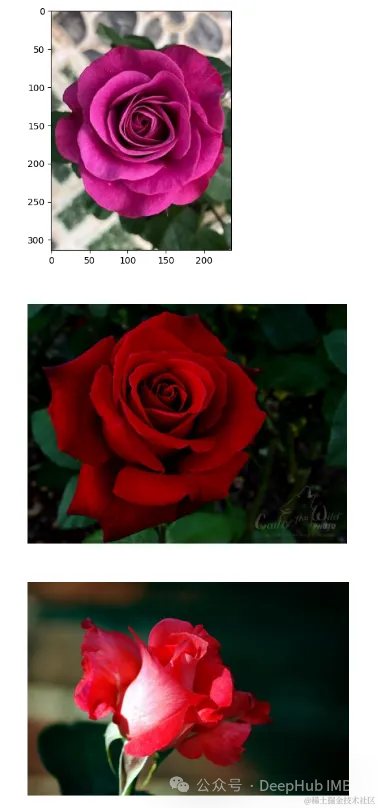
结果还包含了我们需要的大部分信息
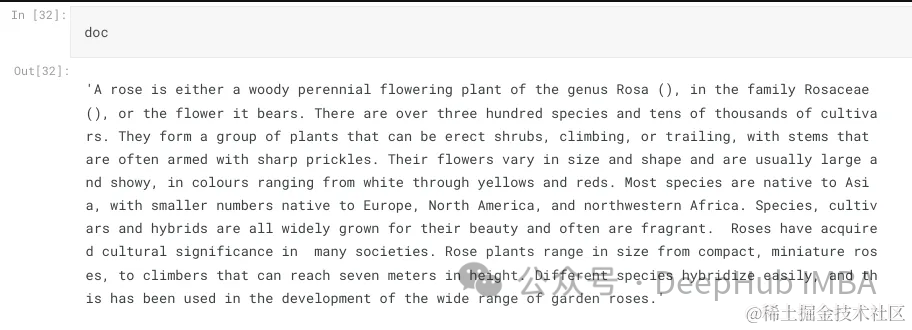
这样我们整合就完成了,最后就是创建聊天模板,
 prompt = """<|im_start|>system
 A chat between a curious human and an artificial intelligence assistant.
 The assistant is an exprt in flowers , and gives helpful, detailed, and polite answers to the human's questions.
 The assistant does not hallucinate and pays very close attention to the details.<|im_end|>
 <|im_start|>user
 <image>
 {question} Use the following article as an answer source. Do not write outside its scope unless you find your answer better {article} if you thin your answer is better add it after document.<|im_end|>
 <|im_start|>assistant
 """.format(question='question', article=doc)
如何创建聊天过程我们这里就不详细介绍了,完整代码在这里:
https://avoid.overfit.cn/post/c2d8059cc5c145a48acb5ecb8890dc0e
如何学习大模型
现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。
作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。
我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。

一、AGI大模型系统学习路线
很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

二、AI大模型视频教程

三、AI大模型各大学习书籍

四、AI大模型各大场景实战案例

五、结束语
学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。
再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。
因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。
 5391


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


