


一、转型优势与认知重塑:为什么后端程序员是AI时代的最佳转型者?
1.1 工程能力的降维打击
后端程序员固有的系统架构设计、高并发处理及运维部署经验可直接迁移至AI应用开发:
-
大模型服务的API化本质与微服务架构高度契合(如模型推理的异步队列设计)
-
分布式系统经验可直接应用于模型训练集群管理(GPU资源调度、故障转移)
-
容器化技术栈(Docker/K8s)无缝衔接大模型部署场景

1.2 工具链的快速适配
后端开发者的技术栈与大模型开发工具链存在天然交集:
-
Python生态主导地位:FastAPI构建模型服务接口 vs Flask/Django后端开发经验
-
数据库技能迁移:关系型数据库优化 → 向量数据库(Chroma/Qdrant)索引设计
-
Git协作流程可直接复用至模型版本管理(MLflow/W&B)
1.3 业务抽象能力的复用
后端业务逻辑设计经验可转化为AI场景定义能力:
-
用户需求分析 → Prompt设计范式(角色+任务+约束)
-
工单系统流程 → Agent任务编排(ReAct框架)
-
支付风控规则 → 大模型输出安全过滤机制(敏感词正则+规则引擎)
关键认知转变:从“造模型”转向“用模型”,聚焦工程落地最后一公里问题。
二、基础能力筑基阶段(1-2个月):从Python强化到模型API化
2.1 Python生态深度强化
| 学习重点 | 实战案例 | 资源推荐 |
|---|---|---|
| 异步编程(async/await) | 构建流式大模型响应接口 | 《Effective Python》第7章 |
| 数据处理(Pandas) | 医疗对话数据清洗(MedDialog) | Kaggle医疗文本分析竞赛数据集 |
| 类型提示(Type Hints) | 增强Prompt工程函数可读性 | Python官方typing文档 |
2.2 开发框架速成路径
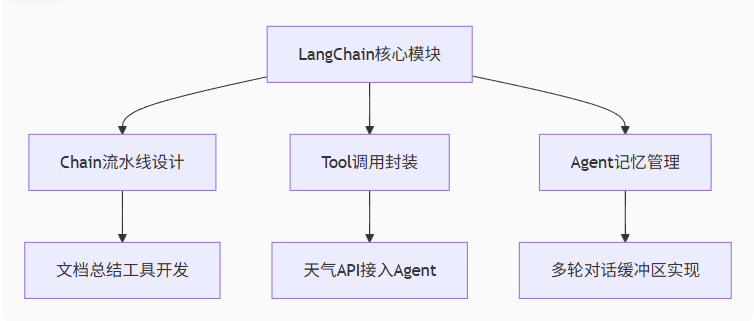
2.3 API工程化实战
-
主流API调用:OpenAI流式响应处理 + 通义千问计费策略优化
-
高可用设计:
# 模型API服务降级方案 def model_inference(prompt): try: return openai.ChatCompletion.create(model="gpt-4", messages=prompt) except RateLimitError: return local_llm.inference(prompt) # 切换到本地开源模型 -
成本监控:Token消耗实时分析仪表盘(Prometheus+Grafana)
三、核心技能突破阶段(2-3个月):RAG、Agent与提示工程
3.1 RAG系统开发黄金法则
文档处理三阶优化:
-
切分策略:滑动窗口算法(128 token窗口+32 token重叠)
-
向量化方案:text2vec-large-chinese嵌入模型 + Qdrant聚类索引
-
混合检索:BM25关键词召回 + 余弦相似度排序
3.2 Agent开发实战框架
1. **工具层设计**
   - 天气查询:WorldWeatherOnline API封装
   - 邮件发送:SMTP协议+附件解析
   - 业务系统接入:企业ERP API鉴权

2. **推理引擎实现**
   ```python
   # ReAct框架伪代码
   def react_agent(question):
       thought = "我需要查询北京天气"
       tool = WeatherTool(query="北京")
       observation = tool.execute()
       return f"{thought} 结果:{observation}"
-
记忆管理
-
短期记忆:ConversationBufferWindow
-
长期记忆:Redis向量存储用户历史
-
**3.3 提示工程工业级实践**
- **结构化模板**:
  ```text
  [角色]资深法律顾问
  [任务]生成合同审查报告
  [约束]引用《民法典》第500条|禁用专业术语缩写|输出Markdown表格
-
少样本学习:医疗诊断Prompt注入示例:
输入:患者男,45岁,持续咳嗽2周,体温37.8℃
输出:<诊断建议>支气管炎可能性大,建议胸片检查</诊断建议>
四、高阶能力拓展阶段(3-6个月):微调部署与领域定制
4.1 低成本微调技术栈
| 工具 | 适用场景 | 硬件要求 |
|---|---|---|
| LlamaFactory | 多任务指令微调 | 单卡RTX 4090 |
| Unsloth | 训练速度提升40% | 云实例T4 GPU |
| GPT-4合成数据 | 解决标注数据匮乏 | 无GPU要求 |
4.2 垂直领域适配策略
-
法律行业:裁判文书Prompt优化(法条引用+严谨性约束)
-
医疗场景:
# 药品说明生成安全过滤器
def medical_filter(text):
    if "剂量" in text and not contains_number(text):
        return "【警告】未检测到明确剂量信息"
    return text
五、工程化实战:从原型到企业级应用
5.1 项目架构设计范式
1. **流量治理层**
   - API网关:鉴权+限流(200 QPS/租户)
   - 降级策略:CPU>80%时关闭长文本生成

2. **模型服务层**
   - 动态加载器:HuggingFace模型热切换
   - 缓存机制:Redis存储重复Query结果

3. **业务适配层**
   - 规则引擎:合规性检查(金融敏感词过滤)
   - 日志审计:Token消耗追踪+用户行为分析:cite[3]:cite[8]
5.2 典型项目闭环开发
-
智能客服系统:
-
知识库:企业PDF手册向量化(LangChain + Chroma)
-
工单对接:自动创建ServiceNow工单
-
-
金融报表生成:
-
数据层:SQL查询 → 向量检索 → 图表生成
-
审核流:GPT-4生成 → 风控规则过滤 → 人工复核
-
六、持续学习与职业发展
6.1 技术演进追踪矩阵
| 领域 | 2025关键技术 | 学习资源 |
|---|---|---|
| 多模态 | LLaVA-v2视觉问答 | arXiv:2304.08485 |
| 推理优化 | FlashAttention-3 | NVIDIA技术博客 |
| 轻量化 | MobileLLM 2B | Hugging Face模型库 |
6.2 职业跃迁路径
1. **岗位选择优先级**
   - ✅ AI应用开发工程师(年薪50W+)
   - ✅ 大模型产品经理(技术+场景双背景)
   - ⚠️ 慎选算法研究员(需PhD学历+顶会论文):cite[2]

2. **简历黄金项目描述**
   > “搭建医疗政策问答系统:
   > - 实现RAG召回率92%+(HyDE优化)
   > - 通过微调降低幻觉率37%
   > - 承载三甲医院日均3000+查询”:cite[6]
结语:工程师转型的终极法则
“用已有的工程化能力解决AI落地最后一公里问题,而非重复造轮子” —— 深耕场景而非模型26
大模型全套学习资料领取
这里我整理了一份AI大模型入门到进阶全套学习包,包含学习路线+实战案例+视频+书籍PDF+面试题+DeepSeek部署包和技巧,需要的小伙伴文在下方免费领取哦,真诚无偿分享!!!
vx扫描下方二维码即可

部分资料展示
一、 AI大模型学习路线图
这份路线图以“阶段性目标+重点突破方向”为核心,从基础认知(AI大模型核心概念)到技能进阶(模型应用开发),再到实战落地(行业解决方案),每一步都标注了学习周期和核心资源,帮你清晰规划成长路径。

二、 全套AI大模型应用开发视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。

三、 大模型学习书籍&文档
收录《从零做大模型》《动手做AI Agent》等经典著作,搭配阿里云、腾讯云官方技术白皮书,帮你夯实理论基础。

四、大模型大厂面试真题
整理了百度、阿里、字节等企业近三年的AI大模型岗位面试题,涵盖基础理论、技术实操、项目经验等维度,每道题都配有详细解析和答题思路,帮你针对性提升面试竞争力。
适用人群

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 2万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


