


本文介绍"12-Factor Agents"方法论,指导构建可靠AI Agent。核心是将LLM视为无状态函数,Agent应设计为"确定性代码+LLM"组合,而非完全依赖LLM自循环。提出12个工程原则,包括管理上下文、统一状态、实现暂停/恢复API、小而专注设计等。强调"最小必要Agent化"理念,只在必要场景使用LLM,保持大部分逻辑为确定性代码,通过渐进式框架实现系统可演进性,解决生产中的可靠性、可测试性和可维护性问题。
前言
前阵子,Context Engineering 这个概念很火。

于是我就去溯源,把「12-Factor Agents」和 Dex Horthy 在 AI Enginer 上的演讲看了,「12-Factor Agents」是 Dex 结合自己为数百位 Founders、工程师提供顾问的经验,总结出的方法论:把 LLM 视作 stateless functions,把 Agent 看成普通软件中的一段循环和若干 switch 分支,并通过 12 条工程原则在可靠性、可维护性与扩展性之间取得平衡。
核心结论是:即便 LLM 的能力持续指数级增长,真正投入生产的 Agent 依旧应当是 “mostly deterministic code with LLM sprinkled in just right places”,而不是“让 LLM 盲目自循环直至完成任务”的神秘黑盒。
Dex 强调:
不管你是菜鸟还是老油条,把你对 AI agent 的大多数既有假设丢掉,退一步按第一性原理重做一遍。
他还点名 OpenAI 的 Responses ————把越多 Agents 逻辑塞到 API/后端并不是正确的出路。
起点:为什么需要“12-Factor Agents”?
Dex 一上台就抛出了一个常见痛点:市面大多数自称“AI Agent”的产品,在真正上线面对真实用户时往往止步于 70–80 %的质量线——它们要么是对第三方框架的浅封装,要么在遇到复杂场景时被迫手动写 Prompt 或穿透框架去调底层逻辑,最后结果往往是“七层调用栈里找 Prompt,找不到就重写一遍”。
Dex 把这种痛苦归因于两个误判。第一,把 Tool Use 当成某种“外星智慧操纵环境”的玄学,而忽视了工具调用本质上只是“LLM 输出一段 JSON → 交给确定性代码 → 返回结果”。第二,把“全自动多轮自反思”当成 Agent 的唯一正确姿势,却忽略了长上下文窗口、错误收敛、状态管理这些工程层面的限制。
为此,他回溯了软件工程历史:从 Heroku 时代的「12-Factor App」到今天的云原生,每一次范式转移都需要一套可复用的工程原则来约束复杂性。“12-Factor Agents”正是面向 LLM 时代的等价物——它并不是反对框架,而是给未来框架开一张“功能需求清单”,帮助团队在 可观测性、可测试性、可维护性 这三大维度上早早建立护城河。
从传统软件到 LLM Agents:核心转折与工程落点
在传统的 ETL、CI/CD 流水线里,工程师早已熟练使用 DAG 调度器(例如 Airflow、Prefect)来拆分任务依赖、控制重试次数、追踪状态。一旦把 LLM 引入这些流程,我们直觉上想做的事情只有一件:让模型“自己决定下一步”。然而 Dex 展示了一个最朴素的 Agent 循环:
- 事件进入(用户请求 / 系统告警)。
- 拼装 Prompt(包含上下文窗口、历史记录、知识检索 RAG 结果等)。
- LLM 生成下一步 JSON(声明要调用哪个工具、需传入哪些参数)。
- 确定性代码执行(API 调用或子流程)。
- 将执行结果压回上下文。
- 判断是否结束,否则进入下一轮。
initial_event = {"message": "..."}
context = [initial_event]
while True:
  next_step = await llm.determine_next_step(context)
  context.append(next_step)

if (next_step.intent === "done"):
return next_step.final_answer

  result = await execute_step(next_step)
  context.append(result)
我们的初始上下文仅仅是起始事件(可能是用户消息,可能是 cron 触发,可能是 webhook 等),我们要求 LLM 选择下一步(工具)或确定我们已经完成。
在真实实践的复杂场景中,可能是这样的一个多步骤:

物化的 DAG(已计算生成的有向无环图)看起来会像这样:

问题在于:当上下文窗口无限膨胀或错误堆叠时,这个循环很容易“旋转失控”,性能和稳定性都难以保证。Dex 因此将“Own Your Control Flow”列为核心原则之一:让人类或确定性代码,而不是 LLM 本身,主导中断、总结、回滚、重试的时机。
他进一步指出,真正落地的生产系统往往采用“Micro-Agents”的模式:业务主流程仍然是可测试、可回放的确定性 DAG,只有在“顺序不确定”或“需要语义判断”的极窄场景里,才把控制权交给 LLM 驱动的三到十步小循环。例如 HumanLayer 内部的部署机器人:在 CI 阶段完全走常规流水线,只有当需要按自然语言“先部署后端还是前端”时才短暂召唤 Agent,待部署完成又立即回到确定性代码继续执行端到端测试。
通过这种“最小必要 Agent 化”策略,团队既保留了 LLM 带来的灵活性,也避免了把所有业务逻辑写进 Prompt 的失控风险。更重要的是,每一次 LLM 能力的进化,都可以渐进替换 DAG 中的节点,而不必重写整条流水线。这为未来“2M上下文窗口 + 高可靠长链调用”时代预留了升级路径。
12 个关键因素深度拆解
下面根据 Dex Horthy 的 GitHub 文档与演讲内容,按逻辑将 12 个因素展开叙述(由于篇幅限制,这里不完全按原顺序排列,但保证每一点均被覆盖)。
Factor 1 Natural Language → Tool Calls
LLM 最神奇之处在于把一句自然语言准确转成结构化 JSON。如果你实现了这一步,你已经迈出了构建 Agent 的关键第一步。
你能为 Terri 创建一个 750 美元的付款链接,用于赞助二月 AI 创客聚会吗?
将其转换为描述 Stripe API 调用的结构化对象,例如:
{
"function": {
"name": "create_payment_link",
"parameters": {
"amount": 750,
"customer": "cust_128934ddasf9",
"product": "prod_8675309",
"price": "prc_09874329fds",
"quantity": 1,
"memo": "Hey Jeff - see below for the payment link for the february ai tinkerers meetup"
    }
  }
}
确定性代码可以获取有效 payload 并对其进行处理,最终返回类似:
我已成功为 Terri 创建了一个 750 美元的支付链接,用于赞助 2 月份的 AI 开发者聚会。这是链接:https://buy.stripe.com/test_1234567890
Factor 4 Tools Are Just Structured Outputs
Dex 甚至引用了“goto considered harmful”的类比来提醒大家:把“工具调用”神话只会带来额外心智负担。本质上工具调用不过是 JSON + Code ;别把它当魔法,把它当“switch case”就行。
Factor 8 Own Your Control Flow
如果你把“是否结束循环”交给 LLM,长链调用几乎必挂。解决方案是在外层代码显式设置 break 条件、最大步数、摘要策略,让模型只负责“下一个动作”而非“终局判断”。也就是如果你能掌控控制流,你就可以:
- Break
- Swicth
- Summarize
- Judge
这就直接引出了如何管理 Agents 的执行状态和业务状态
Factor 5 Unify Execution State and Business State
即使在 AI 领域之外,许多 Infra 系统也试图将“执行状态”与“业务状态”分离。对于 AI apps,这可能涉及复杂的抽象来跟踪当前步骤、下一步、等待状态、重试次数等。这种分离会产生复杂性,这可能是有价值的,但对于你的用例来说可能过于复杂。
更明确地说:
- 执行状态:当前步骤、下一步骤、等待状态、重试次数等。
- 业务状态:代理工作流到目前为止发生了什么(例如,OpenAI messages、tool calls 和结果列表等)。
Dex 的做法是把两者合并到同一数据库记录里,以便随时序列化 / 反序列化上下文,支持 Launch / Pause / Resume。

好处显而易见:
- **简单性:**所有状态的一个单一事实来源
- **序列化:**线程可以轻易地序列化/反序列化
- **Debugging:**整个历史记录可以在一个地方查看
- **灵活性:**只需添加新的事件类型即可轻松添加新的状态
- **恢复:**只需加载线程即可从任何点恢复
- **分支:**可以在任何时间点通过复制线程的一部分到新的上下文/状态 ID 来分支线程
- **人类接口和可观察性:**将线程转换为人类可读的 markdown 或丰富的 Web 应用 UI 非常简单
Factor 6 Launch/Pause/Resume with Simple APIs
既然 Agent 本质上是 loop + switch,就应该像普通微服务一样被 REST 或 gRPC 端点包裹。这样才能在长耗时任务中安全挂起,待异步回调后继续。

这里可以去思考一个问题。通常 AI 编排器会允许暂停和继续执行,但为什么在工具选择和工具执行的时刻之间不允许?
Factor 2 Own Your Prompts
 一些框架提供这种“黑盒”方法,但它通常很难调整或逆向工程,相反,要拥有自己的提示并将其视为一等代码。
Dex 强调“一定会走到手写每个 token 的地步”。原因在于:

Prompt 越长越脆弱,不同模型间迁移性差。手写能让你完全可控地 A/B test 每一段指令(可以去使用如 BAML 这样的 prompt engineering tool,也可以手动模版化),持续压榨模型天花板。
Factor 3 Own Your Context Window
与其把所有历史消息一条条地塞进 messages 数组,不如把“事件状态”序列化为你自定义的数据结构,再一次性放入 Prompt(也就是content字段)中;这样你才能精准控制 token 密度并减少“语义漂移”。
毕竟 LLM 本质上是无状态函数,将输入转换为输出。为了获得最佳输出,你需要提供最佳输入。良好的 context 意味着:

- 给模型的 Prompt 和 Instructions
- 检索到的任何文档或外部数据
- 任何过去的状态、工具调用、结果或其他历史记录
- 来自相关但独立的记录/对话(记忆)中的任何过去消息或事件
- 关于输出何种结构化数据的说明
先把对话历史抽象成严格的 Event 数据结构,再用自定义的序列化函数提取关键字段并压缩为高密度表示(可用 XML/YAML/其他),最后把这一整块结果放进 content 发给 LLM。
信息密度到底是什么意思?—— 同一信息,更少的 token be like:

Factor 9 Compact Errors into Context Window
好的 LLM 可以读取错误消息或堆栈跟踪,并在随后的工具调用中弄清楚要更改什么。但把栈追踪原样塞回 Prompt 只会淹没关键信息。正确做法是:
- 捕获错误 → 压缩为一两句自然语言摘要 → 追加到 context
- 一旦下一步成功,立即清空历史错误,避免旧错误影响后续推理。
大多数框架都实现了 Factor 9,这里不多讲,可以留意的是:
触发连续错误阈值可能是升级到人工处理的绝佳时机,无论是通过模型决策还是通过确定性接管控制流。
Factor 7 Contact Humans with Tool Calls
Dex 观察到很多团队在设计 JSON schema 时,将“向人类发消息”与“调用机器接口”放在同一决策分支里,这会让模型难以决定优先级。
LLM 在生成第一个 token 时就要决定它接下来究竟是
- 输出给人类阅读的自然语言
- 输出给机器执行的结构化调用(JSON)
(LLM API 依赖于一个基本的 HIGH-STAKES 令牌选择)
如果这两种路径混在同一个 JSON schema 分支里,模型在采样首个 token 时就会陷入“我要说话还是要调用接口?”的高风险抉择。一旦首 token 选错,后续内容往往全盘出错。Dex 的建议是把“需要人类参与”的意图显式拆出来,让模型总是先生成一个统一格式的 JSON,并用诸如 request_human_input、done_for_now 等自然语言标记来声明其意图:
- 暂停,等待人类(澄清、批准、确认),还是
- 继续自动化(调用后续工具)。
这样一来,“寻求澄清 / 需要批准 / 结束对话”这些场景都被前置成了首 token 的确定性决策,而不是与业务工具调用混为一谈。结果就是:
- 降低首 token 风险:模型不用在自然语言与工具调用之间犹豫。
- 控制流更清晰:下游框架收到
intent:"request_human_input"就知道要打断循环,通知人类,然后等待回调。 - 上下文可追踪:同一 JSON 结构持续累积事件,方便日志、回放与多方协作。
具体实现如下:
定义面向人类的“工具”
class Options:
    urgency: Literal["low", "medium", "high"]
    format:  Literal["free_text", "yes_no", "multiple_choice"]
    choices: List[str]

class RequestHumanInput:
    intent:   "request_human_input"
    question: str          # 要问人类的话
    context:  str          # 额外背景
    options:  Options      # 期望的回答形式
这段等价于为“请人类介入”做了一个 专用工具。当 LLM 决定自己需要澄清或征得批准时,就输出符合这个 schema 的 JSON,对下游来说语义非常明确:这里必须暂停等待人类。
Agent 主循环里的分支判断
if nextStep.intent == "request_human_input":
    thread.events.append({
"type": "human_input_requested",
"data": nextStep          # 上面那段 JSON
    })
    thread_id = await save_state(thread)  # 把执行现场序列化
    await notify_human(nextStep, thread_id)  # 比如发 Slack / 邮件
return# 退出循环,等待回调
else:
    ...  # 继续调用其他工具
- 判 intent → 暂停 只要看到
request_human_input,循环立即停止,把当前 thread 状态保存,并把问题发到 Slack、邮件或别的渠道。 - 保存状态 → 可恢复
save_state将执行栈、上下文窗口等都序列化,形成thread_id,保证代理可以“掉电续跑”。 - 通知人类 → 等待回调 真正的人机交互发生在外部:用户在 Slack 点了 “Yes”,第三方系统会把结果 POST 回
/webhook。
Webhook 收到回复后的恢复逻辑
@app.post("/webhook")
async def webhook(req: Request):
    thread_id = req.body.threadId
    thread = await load_state(thread_id)     # 恢复现场
    thread.events.append({
"type": "response_from_human",
"data": req.body                     # 用户回答
    })
    next_step = await determine_next_step(thread_to_prompt(thread))
    thread.events.append(next_step)
    result = await handle_next_step(thread, next_step)
return {"status": "ok"}
Webhook 把人类回复追加为事件,然后重新调用determine_next_step,等同于把对话“接回”代理循环,之后可以继续自动化(例如deploy_backend)。这一整套流程正是“前置人类意图”在代码中的落地:
- 首 token 已经确定分支,不存在“误选自然语言 vs JSON”带来的随机偏差;
- 状态持久化 + 事件日志 让整个工作流可回放、可审计;
- 外部触发(cron、webhook、事件流)得以轻松接入,实现“Outer-Loop Agents”。
顺着往下想,Dex 提到过更宏观的第三代 Agent 形态——Outer-Loop Agents:它们由软件或人类一次性触发,却可能连续运行 分钟、小时乃至数天,期间会自主“召唤”人类来获取批准、补充信息、重定向策略。核心挑战就是长生命周期里的 “Agent→Human 接口”——必须让代理随时可靠地联系到正确的人,并在人类响应后继续执行。

Factor 7 与 Factor 11 配合使用效果更佳,如果你能够快速地让各种人类参与进来,你可以给 Agent 访问高风险操作的机会,例如发送外部邮件、更新生产数据等。
Factor 11 Trigger from Anywhere, Meet Users Where They Are
真正的 Agent 不应局限于“又一个聊天窗口”。电子邮件、Slack、Discord、HTTP Webhook……只要用户已经在的渠道,都应该成为触发入口。

Factor 10 Small, Focused Agents
与“万能大循环”相对,这条原则主张用极窄责任范围的 micro-agent 替换一长串动作,让每个子 Agent 只处理 3–10 步。
因为任务越大、越复杂,所需的步骤就越多,这意味着更长的上下文窗口。随着上下文的增长,LLM 更有可能迷失方向或失去焦点。
小而精的 agent 的做法既减少了上下文窗口,也 方便插入人工检查点。
Factor 12 Make Your Agent a Stateless Reducer

Dex 借用函数式编程的 Reducer 概念:Agent 应当不持久化任何内部状态,而是把需要记住的东西交给外部存储。
为什么叫 “Stateless Reducer”?
- Reducer 概念源于函数式编程里的
fold/reduce: • 输入:累积值 (accumulator) + 当前元素 • 输出:新的累积值 - 我们可以把 context window 当成累积值,把 LLM DetermineNextStep + switch dispatcher 当成 reducer 函数。每轮循环:
new_context = Reducer(old_context, latest_event)
- “Stateless” 意味着这段 reducer 本身不持久化任何内部数据;它只是纯粹计算
new_context,然后马上交还给外部存储(数据库、缓存、对象存储等)保存。
**Agent 只是一个“语义层的 Map-Reduce”,而你的业务可靠性来源于外部持久化与纯函数式迭代。**一旦抓住“状态外置 + 纯 Reducer”这条主线,其余优化(RAG、长链、多人协作)都能在同一框架下渐进融入。
这样你才能随时水平扩容、A/B 切流,或在高可用集群里自由迁移。
总结
1. “Agent = Loop + Switch” 思维模型
抛开营销包装,绝大多数生产级 Agent 都可以被拆解成四个同步执行的部件:
- Prompt / Context Builder:决定给 LLM 看的 token;
- LLM Call:纯函数,输入 token 序列,输出 token 序列;
- Switch Dispatcher:把 LLM 输出映射到确定性工具;
- Loop Controller:决定何时 break、何时 summarize、何时 pause。
当你把 Agent 还原成这个最小闭环,团队就能像优化普通后端服务一样对其进行单元测试、负载监控、自动回归,而不再被“黑盒大模型不可控”所束缚。更重要的是,这种分层让你可以独立演进任意一环:换模型、换向量检索、换数据库,都不会牵一发动全身。
- “最小必要 Agent 化” 渐进式演进框架
Dex 用 HumanLayer 内部部署机器人的案例证明,一条成熟的业务流水线应当:
- 第一阶段:保持 100 % 确定性代码,先把“可回放、可监控、可断点”打牢。
- 第二阶段:识别“高语义判断”瓶颈(例如部署优先级决策),用 3–10 步的 micro-agent 替换。
- 第三阶段:当 LLM 能力升级、上下文窗口扩容时,把更多节点渐进式迁移到 Agent,但每一步都要走可观测、可回滚的流程,而非一次性重写。
此框架背后的心智模型是:LLM 不是魔法,而是一款逐年升级的加速卡。你无需押注它一次性解决所有问题;相反,保持代码架构的“可替换性”才是长期竞争力。
- “Prompt 与 Token 密度” 的工程思维
提示词工程不是艺术创作,而是一场信息压缩与信噪比预算的游戏:
- 压缩:每多放一个无关 token,都是对上下文窗口与推理梯度的浪费;
- 信号:保留的每个关键词都应对输出有可测量的正向影响;
- 预算:窗口越小、成本越低、可复用性越高。
因此,团队需要像优化 SQL 查询那样持续 Profile & Refine Prompt:记录每次修改对评测指标的影响;对 Prompt 片段做单元测试;把 RAG、Memory、System Message 看成独立模块,分别调优。最后,你会把 Prompt 打造成一种“可编排资源”,而不再是拷贝粘贴的长文本。
Q & A
为什么“把所有 Agent 逻辑塞进 API/后端”不可取?
高可靠的 LLM 应用=确定性代码 + 极窄职责的 micro-agent,而不是把一切业务流程都交给“大循环 Agent”去“自我决策”。原因主要有四个层面:
- 可测试性与可观测性丢失 当你把流程拆成 DAG(Airflow、Prefect 那样) + 若干三到十步的微循环,任意节点都能单元测试、审计日志、做回放。若整条链路都封在一次 LLM 调用或长循环里,外部只能看见“输入 / 一坨黑盒 / 输出”,问题定位几乎不可能。
- 状态管理失控 API 层级的长生命周期 Agent 往往混淆“执行元数据”(当前步骤、重试次数)与“业务状态”(已发送的消息、待审批 Task)。Factor 5 与 Factor 6 主张把两者写进外置数据库,Agent 本体保持“stateless reducer”,否则一旦服务重启就难以恢复。
- 上下文窗口与成本瓶颈 Dex 示范了最朴素的“事件→prompt→LLM→工具→追加上下文→下一轮”循环,指出只要链路一长就卡在 token 限制与推理噪声。“最佳实践”是让 Agent 只处理当下 3-10 步,把长尾任务继续交回确定性代码;这样既压缩窗口,也便于按需摘要、裁剪历史。
- 人机协作与弹性演进 业务往往需要“随时插人工”——审批、澄清、修改参数。如果逻辑全塞进后台 Agent,开发者只能硬插异步回调或重写 prompt,非常脆弱。Dex 的做法是把“向人类请求帮助”与“调用机器工具”并列成同层级的 switch case,让外层调度自由暂停/恢复。未来 LLM 能力提升时,只需把 DAG 节点逐步替换为更大窗口模型,而非重写后端服务。
为什么在工具选择和工具执行的时刻之间不允许 AI 编排器暂停/继续执行?
在多数 AI Agent 编排器(orchestrator)的实现里,Tool Selection 与 Tool Execution 被视为一个不可分割的原子步骤,其背后有几条常见的工程与安全考量:
- **保持决策确定性。**Agent 在推理阶段会根据当前上下文输出下一步的计划。如果让用户在「已选定工具但尚未执行」此时插入暂停,重新恢复后再让模型继续思考,就会出现“同一上下文被二次推理”的可能性。为了保证日志重放、审计与 Debug 时的可复现性,编排器往往把「选择➜执行」封装成一次不可拆分的事务。
- **避免部分完成造成的副作用不一致。**许多工具调用会产生不可逆或对外部系统可见的副作用(写数据库、发邮件、触发部署)。如果允许在「已经决定要执行,但尚未执行」时暂停,恢复后外部世界的状态可能已改变,导致工具调用的前提条件不再成立,引入竞态及一致性风险。
- **降低实现复杂度,简化状态机。**编排器通常只维护两类状态:
- 推理中:等待模型返回 structured output
- 等待外部事件:工具执行或人类反馈完成 若再细分出「等待执行确定」等中间态,需要额外的持久化字段与恢复逻辑,显著增加状态机复杂度。12-Factor Agents 的建议是“先把长耗时或高风险操作外包给工具,再配合 Factor 6 的 Pause/Resume API 在工具层面挂起”。
- **最小暴露窗口,强化安全审计。**把“模型输出的 JSON + 工具调用结果”作为一条完整的审计事件,比拆成两步更易于在日志里定位与回溯;同时也减少了恶意篡改或注入的攻击面。
总的来说,限制「工具选择」与「工具执行」中途暂停,更多是出于确定性、一致性与实现简单的权衡。想要“可暂停的长任务”,推荐把耗时操作放进工具本身,并利用 Factor 6 与 Factor 7 的模式,在工具或外部触发层面处理暂停逻辑。这样既能满足业务需求,又不会破坏编排器的原子性设计。
Reference
[1] https://github.com/humanlayer/12-factor-agents
[2] https://www.youtube.com/watch?v=8kMaTybvDUw
e API 在工具层面挂起”。
- **最小暴露窗口,强化安全审计。**把“模型输出的 JSON + 工具调用结果”作为一条完整的审计事件,比拆成两步更易于在日志里定位与回溯;同时也减少了恶意篡改或注入的攻击面。
总的来说,限制「工具选择」与「工具执行」中途暂停,更多是出于确定性、一致性与实现简单的权衡。想要“可暂停的长任务”,推荐把耗时操作放进工具本身,并利用 Factor 6 与 Factor 7 的模式,在工具或外部触发层面处理暂停逻辑。这样既能满足业务需求,又不会破坏编排器的原子性设计。
Reference
[1] https://github.com/humanlayer/12-factor-agents
[2] https://www.youtube.com/watch?v=8kMaTybvDUw
[3] https://theouterloop.substack.com/p/openais-realtime-api-is-a-step-towards
零基础如何高效学习大模型?
你是否懂 AI,是否具备利用大模型去开发应用能力,是否能够对大模型进行调优,将会是决定自己职业前景的重要参数。
为了帮助大家打破壁垒,快速了解大模型核心技术原理,学习相关大模型技术。从原理出发真正入局大模型。在这里我和鲁为民博士系统梳理大模型学习脉络,这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码免费领取🆓**⬇️⬇️⬇️

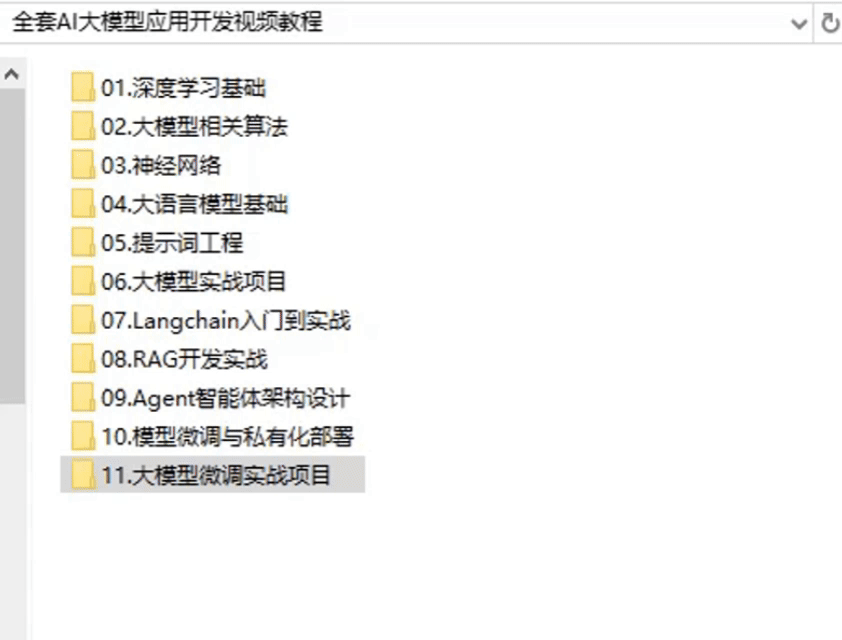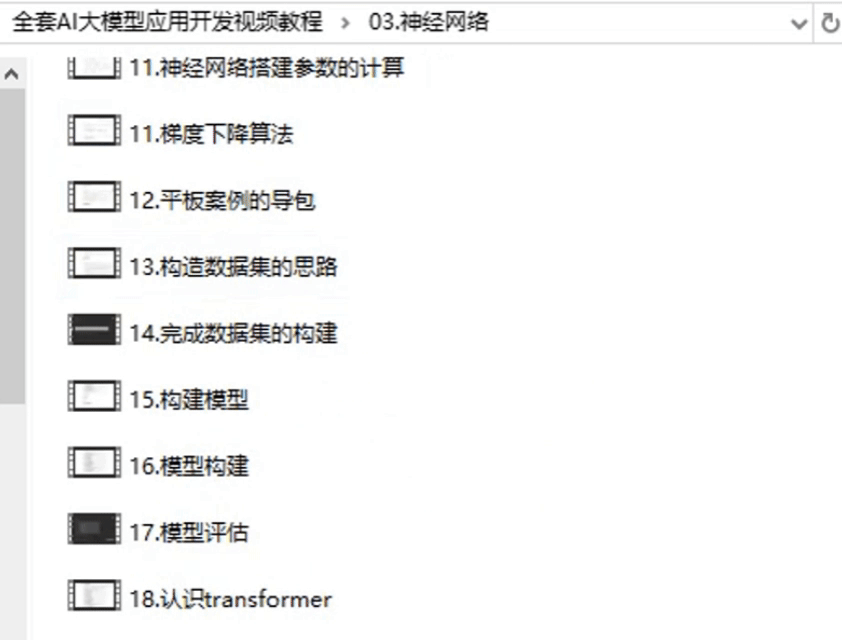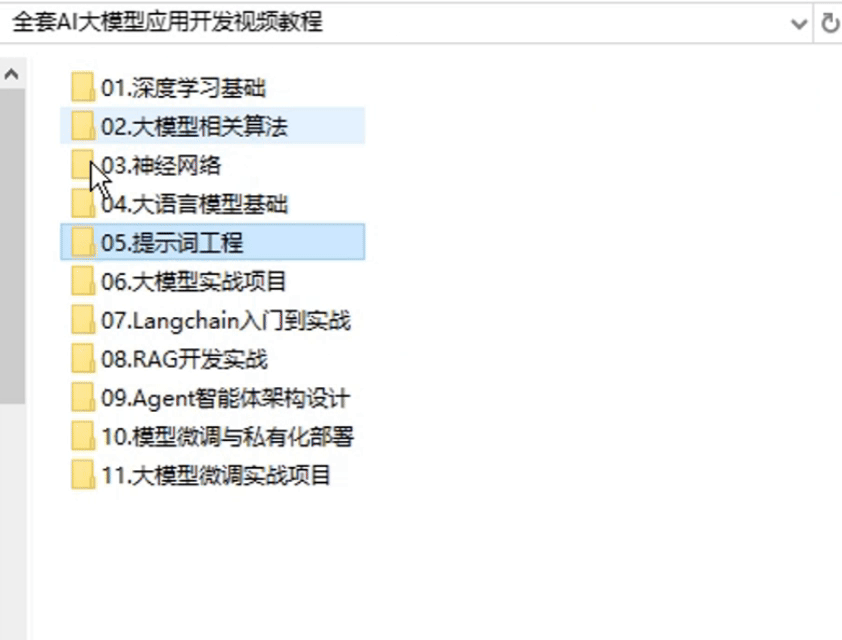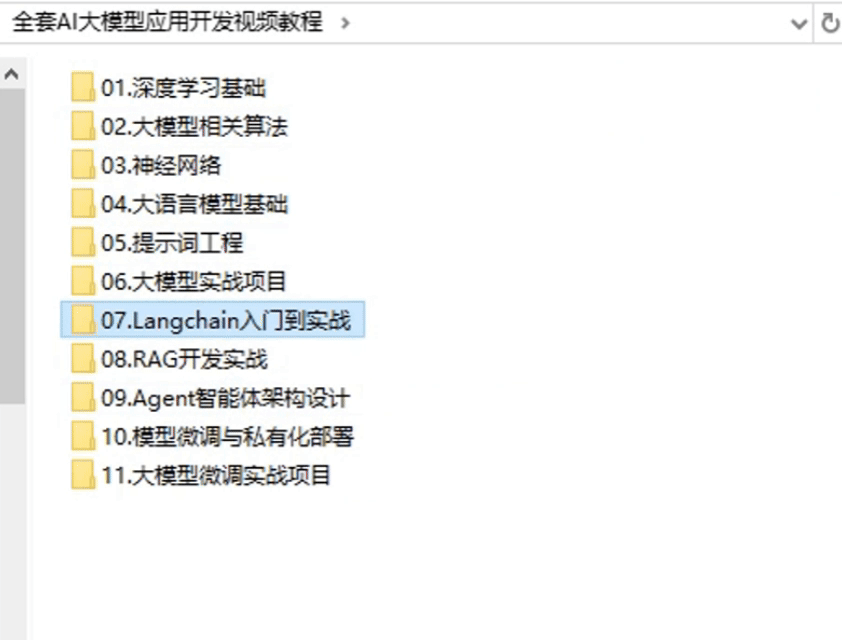
【大模型全套视频教程】
教程从当下的市场现状和趋势出发,分析各个岗位人才需求,带你充分了解自身情况,get 到适合自己的 AI 大模型入门学习路线。
从基础的 prompt 工程入手,逐步深入到 Agents,其中更是详细介绍了 LLM 最重要的编程框架 LangChain。最后把微调与预训练进行了对比介绍与分析。
同时课程详细介绍了AI大模型技能图谱知识树,规划属于你自己的大模型学习路线,并且专门提前收集了大家对大模型常见的疑问,集中解答所有疑惑!
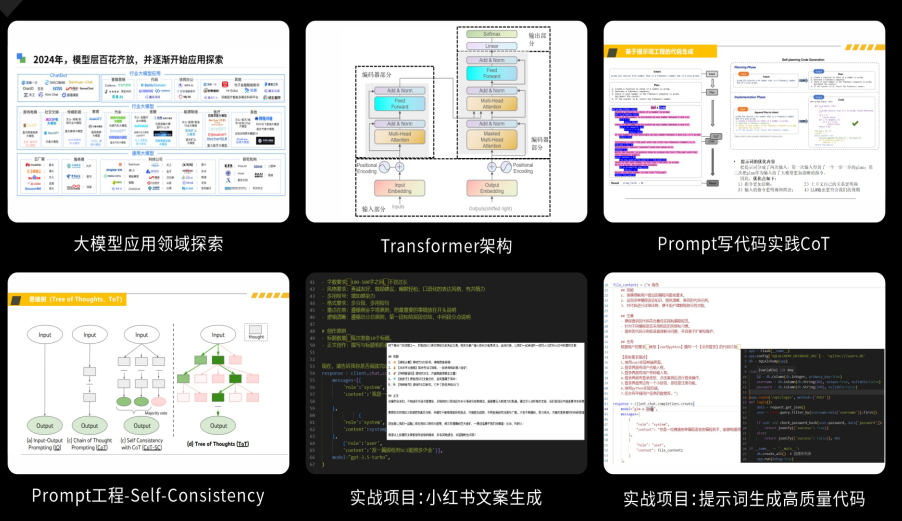
深耕 AI 领域技术专家带你快速入门大模型
跟着行业技术专家免费学习的机会非常难得,相信跟着学习下来能够对大模型有更加深刻的认知和理解,也能真正利用起大模型,从而“弯道超车”,实现职业跃迁!
【精选AI大模型权威PDF书籍/教程】
精心筛选的经典与前沿并重的电子书和教程合集,包含《深度学习》等一百多本书籍和讲义精要等材料。绝对是深入理解理论、夯实基础的不二之选。
【AI 大模型面试题 】
除了 AI 入门课程,我还给大家准备了非常全面的**「AI 大模型面试题」,**包括字节、腾讯等一线大厂的 AI 岗面经分享、LLMs、Transformer、RAG 面试真题等,帮你在面试大模型工作中更快一步。
【大厂 AI 岗位面经分享(92份)】
【AI 大模型面试真题(102 道)】
【LLMs 面试真题(97 道)】
【640套 AI 大模型行业研究报告】
【AI大模型完整版学习路线图(2025版)】
明确学习方向,2025年 AI 要学什么,这一张图就够了!
👇👇点击下方卡片链接免费领取全部内容👇👇
抓住AI浪潮,重塑职业未来!
科技行业正处于深刻变革之中。英特尔等巨头近期进行结构性调整,缩减部分传统岗位,同时AI相关技术岗位(尤其是大模型方向)需求激增,已成为不争的事实。具备相关技能的人才在就业市场上正变得炙手可热。
行业趋势洞察:
- 转型加速: 传统IT岗位面临转型压力,拥抱AI技术成为关键。
- 人才争夺战: 拥有3-5年经验、扎实AI技术功底和真实项目经验的工程师,在头部大厂及明星AI企业中的薪资竞争力显著提升(部分核心岗位可达较高水平)。
- 门槛提高: “具备AI项目实操经验”正迅速成为简历筛选的重要标准,预计未来1-2年将成为普遍门槛。
与其观望,不如行动!
面对变革,主动学习、提升技能才是应对之道。掌握AI大模型核心原理、主流应用技术与项目实战经验,是抓住时代机遇、实现职业跃迁的关键一步。
01 为什么分享这份学习资料?
当前,我国在AI大模型领域的高质量人才供给仍显不足,行业亟需更多有志于此的专业力量加入。
因此,我们决定将这份精心整理的AI大模型学习资料,无偿分享给每一位真心渴望进入这个领域、愿意投入学习的伙伴!
我们希望能为你的学习之路提供一份助力。如果在学习过程中遇到技术问题,也欢迎交流探讨,我们乐于分享所知。
*02 这份资料的价值在哪里?*
专业背书,系统构建:
-
本资料由我与鲁为民博士共同整理。鲁博士拥有清华大学学士和美国加州理工学院博士学位,在人工智能领域造诣深厚:
-
- 在IEEE Transactions等顶级学术期刊及国际会议发表论文超过50篇。
- 拥有多项中美发明专利。
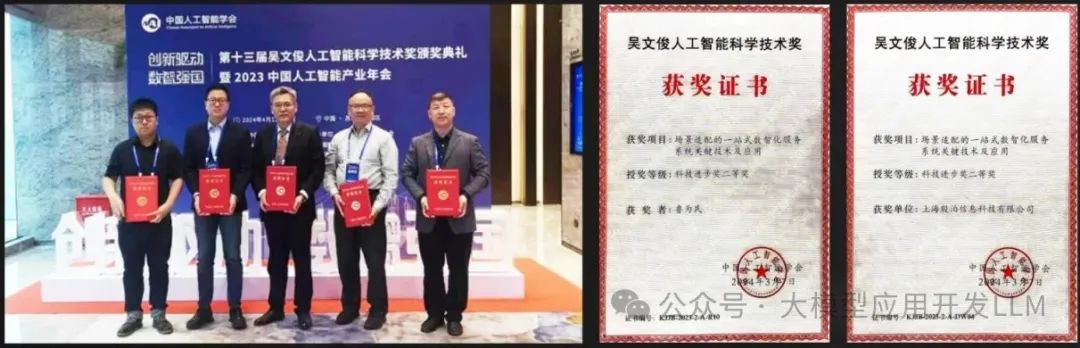
- 荣获吴文俊人工智能科学技术奖(中国人工智能领域重要奖项)。
-
目前,我有幸与鲁博士共同进行人工智能相关研究。
内容实用,循序渐进:
-
资料体系化覆盖了从基础概念入门到核心技术进阶的知识点。
-
包含丰富的视频教程与实战项目案例,强调动手实践能力。
-
无论你是初探AI领域的新手,还是已有一定技术基础希望深入大模型的学习者,这份资料都能为你提供系统性的学习路径和宝贵的实践参考,助力你提升技术能力,向大模型相关岗位转型发展。
抓住机遇,开启你的AI学习之旅!
 330


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


