LLMs在股票投资组合崩溃中的时间关系推理

时间关系推理:利用大型语言模型检测股票投资组合崩溃 本文介绍了一种名为“时间关系推理”(TRR)的新算法框架,该框架旨在模仿人类解决复杂问题的认知过程。研究结果表明,TRR在预测投资组合崩盘方面表现得比当前其他方案更为出色,并且通过一系列消融实验明确了各个组成部分的重要性。 阅读详情

图片

LLMs在股票投资组合崩溃中的时间关系推理

1. 引言

想象一下,你是一位投资经理,管理着一个多元化的股票投资组合。突然,一场前所未有的全球性事件发生了,比如2007年的金融危机或2020年的新冠疫情,这可能会对你的投资组合造成重大影响。传统的投资组合崩溃检测方法依赖于历史数据,但这些方法在面对前所未有的事件时往往无能为力。幸运的是,大型语言模型(LLMs)的出现为解决这一问题提供了新的思路。
图片

LLMs具有零样本推理能力,能够将训练数据中学习到的知识泛化到新的事件上,从而在没有特定训练数据的情况下检测潜在的投资组合崩溃事件。然而,检测投资组合崩溃是一个复杂的问题,需要超越基本推理能力。投资者需要动态处理新闻文章中发现的每条新信息的影响,分析新闻事件和投资组合股票之间影响的关系网络,以及理解不同时间步之间影响的时间上下文,以获得对目标投资组合的整体聚合效应。

2. 相关工作

2.1 关系型股票预测

在股票市场中,关系型信息预测是一个重要的研究领域。早期的研究使用关系元组(例如(行动者,动作,对象,时间戳))来学习嵌入,以便相似事件或相似股票实体具有相似的代表性向量。后来的研究使用基于图的方法,通过在知识图谱中学习嵌入来表示股票实体。然而,这些模型主要依赖于从中心数据库检索到的静态关系信息,并未考虑新闻事件可能引起的股票之间连接性的变化。

最近的研究使用LLMs从新闻标题中推断股票之间的关系,从而获得更具动态性的关系数据。这些信息随后用于生成股票嵌入,用于训练深度学习模型进行股票预测。

2.2 大型语言模型的推理框架

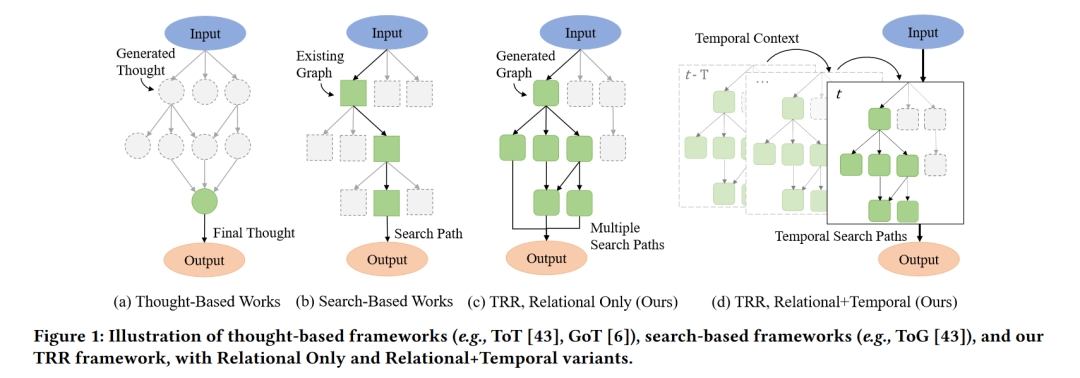
LLMs以其零样本推理能力而闻名,这主要归功于其能够将其在训练数据中学到的知识泛化到新的数据上。为了增强这种能力,研究人员提出了各种推理框架,例如思维树(ToT)和思维图(GoT)。这些框架旨在模拟人类的推理过程,通过搜索组合问题空间来找到任务解决方案。

另一类研究则通过使用包含外部信息的知识图谱来增强LLMs的可靠性,例如StructGPT和Think-on-Graph(ToG)。这些研究的一个关键观察结果是LLMs能够对知识图谱输入进行推理,这些输入以知识元组的形式提供。
图片

3. 时间关系推理

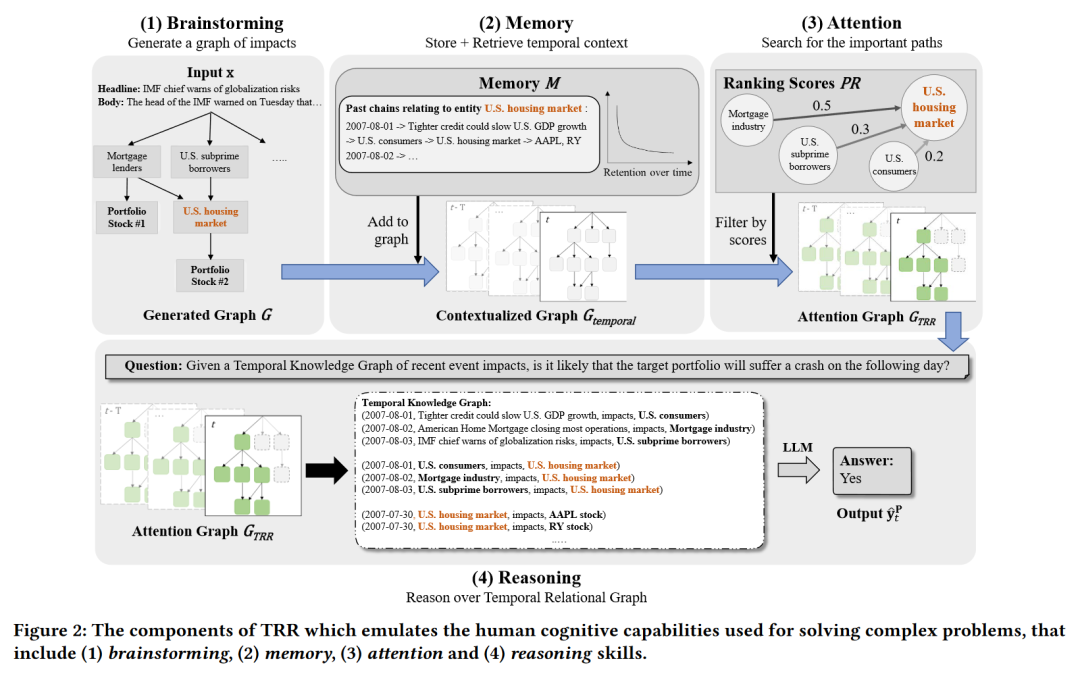
本文提出的TRR框架旨在模拟人类在解决复杂问题时使用的认知能力,包括头脑风暴、记忆、注意力和推理能力。

3.1 头脑风暴

为了获得每个新闻事件对选定投资组合的总体影响,TRR首先头脑风暴所有可能的子影响链,这些子影响链会导致其组成股票受到影响。该过程被建模为一个有向图G = (Z, A)。顶点集Z = {x1, …, xJ, e1, …, eH, s1, …, sN},从每个新闻文章xj开始,通过所有受影响的子实体en(其中h ≤ H),并以投资组合股票sn结束。边集A简单地表示顶点之间的影响力方向。

为了生成图的新顶点,TRR迭代地提示LLM根据每个新闻文章或先前受影响的子实体生成可能受影响的实体。因此,对于迭代i中的所有顶点zi ∈ Z,我们有zi → brainstorm(zi, k),其中k是生成的新顶点数量。这个过程迭代进行,直到影响链到达投资组合股票sn,或者达到最大迭代次数I。

3.2 记忆

为了理解新闻事件的时间上下文,TRR配备了一个记忆模块,该模块存储所有先前提到的受影响子实体。我们用M = {M0, M1, …}表示记忆模块,其中Men是包含实体eh的所有先前影响链Cen的集合。通过记忆模块,我们可以执行检索和存储功能:

  • 每天,对于LLM生成的每个受影响实体,我们搜索记忆模块以查找其先前的提及,并将其添加到我们的每日图G中,从而得到一个新的时间上下文图Gtemporal。我们可以得到:Gtemporal = ∪ven∈Z (G ∪ Men)。
  • 在每天结束时,我们用每日的影响链更新记忆模块,即Men = ∪ven∈Z (Men ∪ Cen),这为未来的时期存储了时间上下文。

此外,人类对新闻事件的集体记忆往往会随着时间的推移而逐渐淡忘,这会减少其对市场的影响。先前的研究使用指数衰减来模拟记忆的这种时间衰减。

3.3 注意力

总体上下文图Gtemporal太大,无法在LLMs中使用,因为它们的标记限制。虽然其他工作通过合并思想或找到单一回答路径来解决这个问题,但TRR希望保持信息的关系图,以向LLM提供市场概况。

Gtemporal包含一个影响链网络,对目标投资组合的影响强度不同。为了获得此网络上的最重要信息,TRR借鉴了PageRank算法,为每个实体分配排名分数。这是通过迭代地根据影响方向将分数传递给实体来完成的,直到分数收敛。此外,分数根据其在上一阶段的记忆中保留的权重进行加权。

使用排名分数PR(en),TRR过滤出包含得分最高的前q个实体的所有影响链C,其中q将被定义。这些用于形成一个新的子图GTRR,代表投资者每天关注的最重要信息。

3.4 推理

最后,为了确定是否会发生投资组合崩溃,TRR对生成的时间关系图GTRR进行推理。这模拟了投资者的推理过程,他们将通过考虑最相关的新闻影响以及组成股票之间的相互关联性来评估其投资组合风险。

4. 实验

4.1 数据集和评估指标

本文使用路透社金融新闻数据集,并将其扩展到2020年以涵盖选定的时间段。数据集包含来自路透社的一般金融新闻,这些新闻没有经过任何股票或国家的过滤。这允许LLM自行决定每篇文章是否与目标投资组合相关。图片
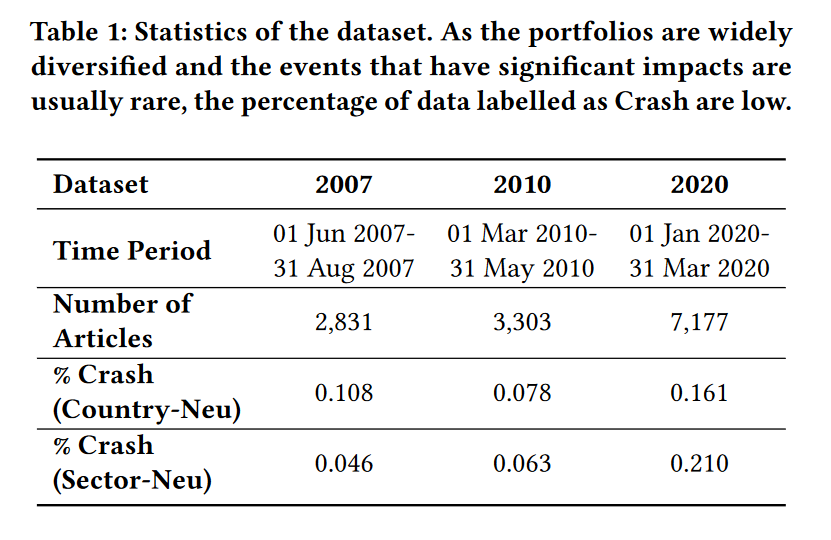
为了生成投资组合崩溃的标签,本文首先从雅虎财经检索每个组成股票的价格数据,并计算其每日百分比回报率。接下来,我们对这些数据进行平均,以获得每天的投资组合回报率。为了找到投资组合崩溃,本文设置了一个阈值来捕捉价值的急剧下降。我们将回报率≤ -2.0%标记为崩溃,这代表了整体回报率系列的第95百分位数。

由于这些崩溃的发生率很低,因此数据集在很大程度上是不平衡的,预测所有假(即没有崩溃)的模型将产生高准确率分数。本文使用接收者操作特征曲线下面积(AUROC)作为指标,该指标可以捕捉所有阈值下真阳性与假阳性的权衡。
图片

4.2 基线

由于检测投资组合崩溃的任务目前尚未得到广泛探索,本文将其与多个零样本LLM框架进行比较,例如标准IO提示、思维链(CoT)、思维图(GoT)和基于图的思维(ToG)。此外,本文还与一个非零样本深度学习模型(BiGRU + Attention)进行了比较,该模型已在相同数据集的过去路透社新闻数据上进行了训练。

4.3 参数设置

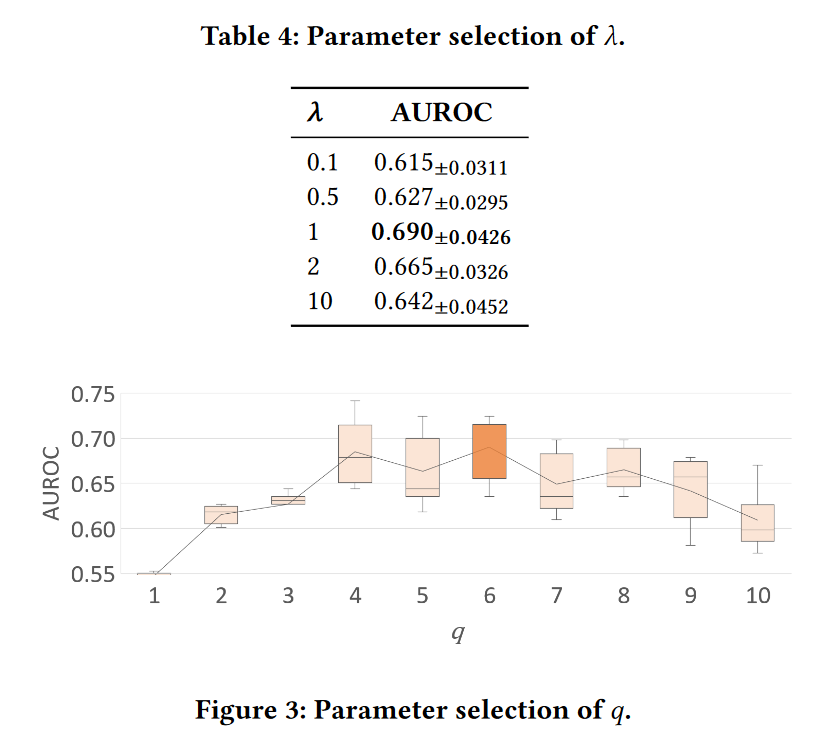
对于所有LLM实验,本文使用OpenAI GPT-3.5-turbo生成响应,温度设置为0.0。对于最后一个推理阶段,每个模型重复预测提示5次,并报告平均AUROC和标准差。对于主要实验,本文将γ设置为1,将q设置为6。

5. 结果

5.1 主要结果

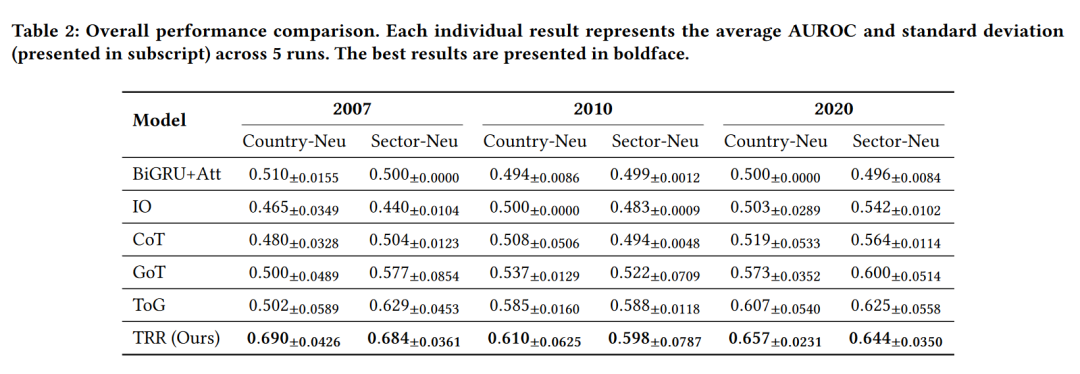
从表2可以看出,深度学习模型BiGRU + Attention的结果接近0.5。这是因为该模型主要预测假(注意,全真或全假预测的AUROC为0.5)。投资组合崩溃通常是罕见的,这会导致模型训练时对假预测产生很大的偏差。此外,该模型很可能无法处理训练集中以前未见过的事件,导致其对前所未有的崩溃事件预测假。

在基于思维的框架(即IO、CoT和GoT)中,我们可以看到AUROC指标的明显上升趋势。这表明将预测投资组合崩溃的任务分解为较小的思维过程是有益的。进一步观察,我们发现基于搜索的ToG能够胜过这些模型。由于输入数据集未经过手动过滤,因此可能存在许多包含与指定投资组合无关的噪声信息的新闻文章。通过首先从文章中搜索到投资组合的影响路径,ToG能够找到最相关的信息,以帮助其决定是否可能发生潜在的投资组合崩溃。
图片

最后,TRR框架能够胜过所有模型,平均比最强的基线(ToG)高出10.6%。通过考虑与投资组合相关的多个影响路径以及这些路径之间的关系,TRR能够更全面地了解各种市场力量对投资组合的影响,从而更准确地检测潜在的崩溃。

5.2 消融研究

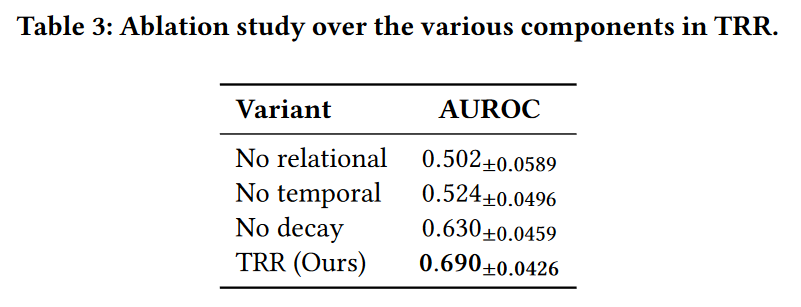
消融研究的结果表明,TRR的每个组件都有助于提高模型的整体性能。关系和时间组件在推理阶段为LLM提供了额外的图路径,而不会降低性能,这表明从图中提取了有用的信息,而不是噪声数据。这些路径有助于提供有关每个新闻影响的额外上下文信息,从而使LLM能够更好地确定是否会发生崩溃。
图片

5.3 参数选择

通过消融研究,本文将γ设置为1,将q设置为6。

5.4 图分析

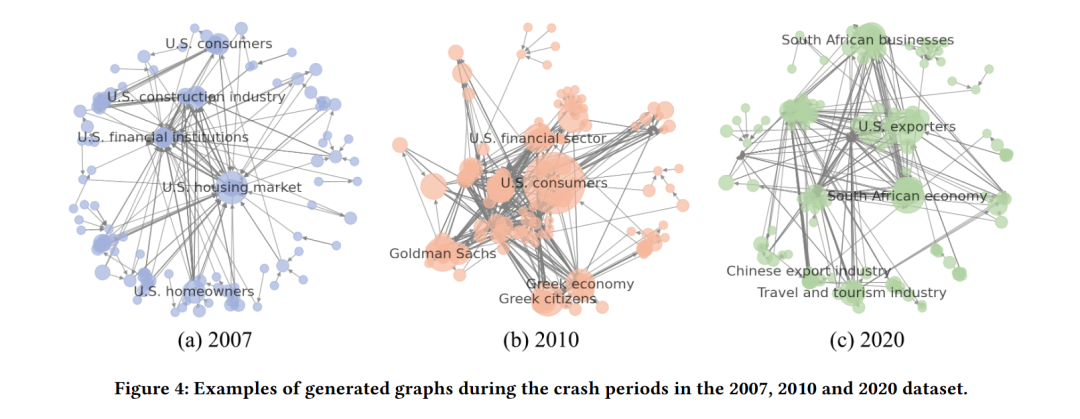
本文还通过可视化每个数据集在崩溃期间的示例来探索生成的图。从图中可以看出,TRR能够突出显示在现实生活中导致投资组合崩溃的最重要信息。
图片

5.5 额外实验

为了探索TRR对宏观经济中相关任务的泛化能力,本文将其应用于全球危机事件的检测。通过将全球经济视为区域经济网络,本文利用TRR追踪每个区域经济的影响,然后对这些影响进行推理,以检测可能的全球金融危机。
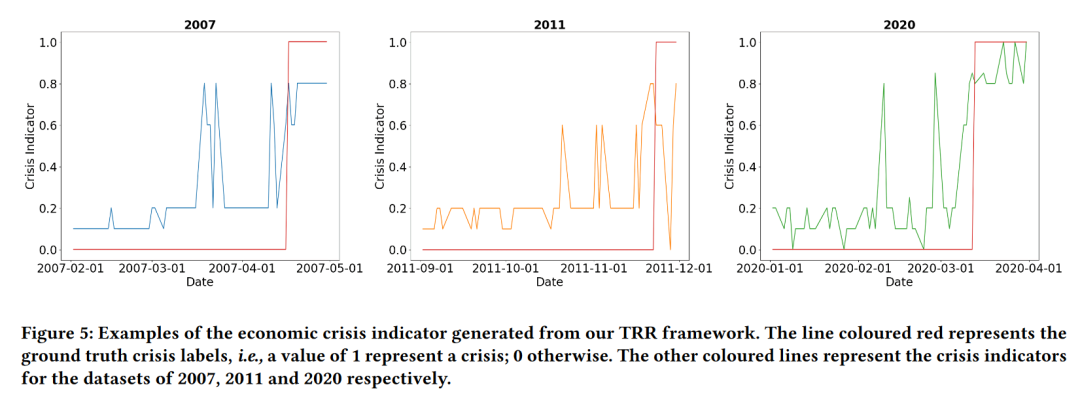
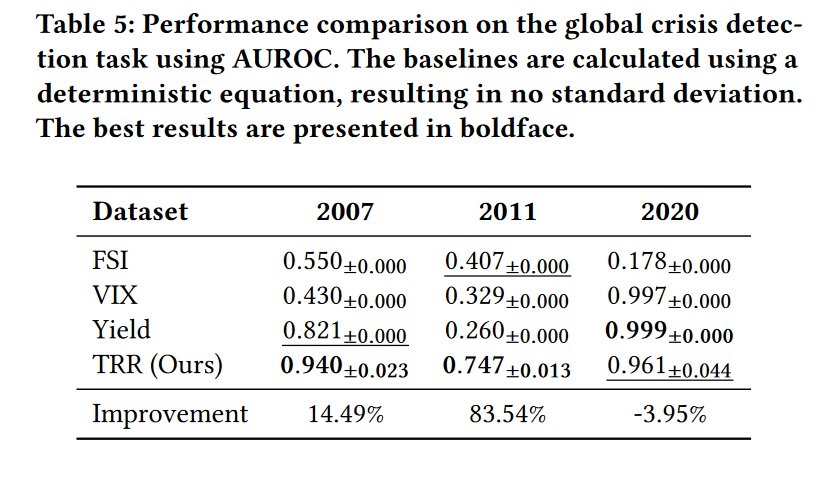
图片

图片

6. 结论与未来工作

本文探讨了投资组合崩溃检测的主要任务,这是在LLMs出现之前难以解决的问题,因为崩溃相关事件的前所未有性。本文提出了TRR框架,该框架能够通过一组人类认知能力对关系和时间信息进行零样本推理。通过广泛的实验,本文证明了TRR在检测投资组合崩溃方面优于最先进的框架。此外,本文还通过将其用于宏观经济中的危机预警指标,探索了TRR的泛化能力。

这项工作的结果为未来的研究开辟了一些可能的方向。首先,TRR中的每个单独组件都可以通过更专业的技术进行扩展。其次,对于危机检测任务,可以研究更多的基线,例如政府债务、对外贸易流动等。这些统计指标也可以与TRR方法一起用于集成系统,以帮助提高预警指标的预测能力。

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

深度学习之QLoRA原理详解及Pytorch实现 【代码】深度学习之QLoRA原理详解及Pytorch实现。 阅读详情

相关推荐

PyTorch、CPU、GPU 与 CUDA 深度解析:一次张量加法背后的四层世界

本文厘清PyTorch、CPU、GPU与CUDA的层级关系:PyTorch是编程接口,CPU负责控制与调度,CUDA是让CPU指挥GPU的并行编程平台,GPU则是实际执行计算的加速器。四者非并列,而是分层协作。以x + y为例,从Python前端到算子分发、CUDA运行时,最终在GPU硬件上执行。关键认知包括:GPU并非万能加速器,小任务因开销大反而更慢;.to('cuda')仅搬运数据,不改变代码逻辑;算子性能受算术强度与内存带宽制约。理解此链路是优化深度学习性能的前提。

reset2021的博客 263

使用大语言模型进行股票投资组合崩溃检测

股票投资组合面临罕见事件的风险(如2007年金融危机、2020年COVID-19股市崩盘),历史数据不足以学习。大语言模型(LLMs)可通过广泛的训练数据进行零-shot推理,帮助检测潜在的投资组合崩盘事件。检测崩盘需要动态处理新闻信息的影响,分析事件与股票之间的关系,以及理解时间上下文。本文提出了一种名为“时间关系推理”(TRR)的算法框架,模拟人类复杂问题解决的认知能力。实验表明,TRR在检测股票投资组合崩盘方面优于现有解决方案,且通过消融研究展示了各组件的贡献。

m0_59235699的博客 1284

pi0-代码解析-scripts/train_pytorch-7

pytorch推理。

智能机器人产学研基地 31

Pytorch【7】Dataset与DataLoader数据集加载

上一节我们学会了损失函数、优化器和基础训练循环。但是之前示例是手写少量tensor数据,真实项目图片成千上万,需要一套规范的数据加载方案。数据集抽象类,定义怎么拿单条样本(索引取数据)加载器,对Dataset包装,实现batch、shuffle、多进程读取数据流水线:原始数据 → Dataset读取单样本 → Transform预处理 → DataLoader打包成batch送入网络__len__:返回数据集总样本数量,调用:按下标取一个样本,调用。

Beforthing的博客 226

PRPD图谱分析从入门到精通:5种典型放电模式的识别手册

本文详细解析PRPD图谱分析技术,重点介绍电晕放电、悬浮放电等5种典型放电模式的识别方法。通过37组真实案例对比,提供关键识别区和诊断流程图模板,帮助工程师快速掌握变电站设备状态监测的核心技能,提升绝缘缺陷诊断准确率。

weixin_29214199的博客 467

主流双目相机技术参数横向评测:从ZED到INDEMIND的深度解析

本文对主流双目相机进行了深度横向评测,涵盖ZED、Bumblebee、Leap Motion、DUO 3D及INDEMIND等国内外产品。文章详细解析了分辨率、帧率、视场角、基线等核心参数,并结合科研、机器人导航、无人机、工业检测等典型应用场景,提供了实战选型指南,帮助读者根据具体需求挑选最合适的双目视觉解决方案。

weixin_29212867的博客 640

机器学习教程,从入门到精通,深度学习入门语法知识点完全指南(PyTorch 版)(12)

本文为零基础读者量身定制的PyTorch深度学习入门指南,系统讲解深度学习核心原理与实战语法。从神经元、激活函数、损失函数等基础概念入手,结合Sigmoid、ReLU、MSE、CrossEntropy等关键知识点,辅以可运行的PyTorch代码示例,逐行注释详解。涵盖线性回归、CNN、GAN、ResNet等八大典型应用,揭示其在推荐系统、自动驾驶、医疗影像等企业场景中的实际价值,帮助读者快速掌握“原理—框架—应用”全链路技能。

qq_45746668的博客 366

LangChain学习及应用(超详细)

Model I/O 部分是与语言模型进行交互的核心组件,包括输入提示(Prompt Template)、调用模型(Model)、输出解析(Output Parser)。简单来说,就是输入、处理、输出这三个步骤。LLM 因其具有海量参数,需要花费相当的物力与时间成本进行预训练和微调,同时商用 LLM 还需要进行各种安全测试与风险评估等。因此 LLM 会存在知识滞后的问题。在专有领域,LLM 无法学习到所有的专业知识细节,因此在面向专业领域知识的提问时,无法给出可靠准确的回答。

weixin_39764056的博客 4257

Pytorch 【5】神经网络基础(nn.Module、卷积层、池化层、线性层)

前面我们学习了张量Tensor、自动求导Autograd,这两个是Pytorch最底层的基石。在真实项目中,我们不会手动去写大量求导逻辑,torch.nn模块封装好了神经网络各类层、损失函数,让我们快速搭建网络。本篇重点讲解nn.Module以及常用网络层:卷积Conv、池化Pool、全连接Linear。,和opencv、PIL的HWC相反!卷积之后进全连接,一定要flatten展平,否则维度对不上padding的作用:控制特征图尺寸不变,same padding池化层不改变通道数,只缩小高宽。

Beforthing的博客 177

从TL431光耦到集成隔离器:3种反激电源反馈方案全对比,你的项目到底该选哪个?

本文深入对比了反激电源设计中TL431光耦、集成隔离器和原边反馈三种主流反馈方案的优缺点,帮助开发者在电源设计中选择最适合的方案。从精度、成本、隔离等级等多维度分析,为反激式(Flyback)拓扑的应用提供实用选型指南。

weixin_30536513的博客 399

详解AUTOSAR:什么是AUTOSAR?(理论篇—1)

AUTOSAR是由全球各大汽车整车厂、汽车零部件供应商、汽车电子软件系统公司联合建立的一套标准协议,是对汽车技术开发一百多年来的经验总结。

不脱发的程序猿 1万+

第22章 实现一个完整的 RAG 系统(PyTorch) (终章)

本章构建了一个完整的本地RAG系统,集成BGE嵌入、Chroma向量库、BM25与RRF混合检索、BGE重排序器及Qwen2.5-7B-Instruct生成模型。通过结构化分块、增量索引、带引用的Prompt设计与拒答机制,实现精准问答。基于Recall@K与MRR量化评估各组件贡献,实测在RTX 4090上完成端到端推理,兼顾性能与可解释性,具备生产可用性。

AI服务生活 357

SAP 发票凭证反向冲销

发票凭证反向冲销: 业务模拟: MIRO发票校验后,生成发票凭证号: 事务代码MR8M,输入凭证号码,反向冲销(类似于MIGO入库后的反向冲销): 此时进入MIRO查看,发现冲销成功,可以再次做MIRO发票校验: ...

willieyuan的博客 7708

【AI 开发从入门到进阶 · 04】PyTorch 第一课:Tensor、自动求导与那套万能的「五步训练循环」

本文系统介绍PyTorch入门核心内容:为何选择PyTorch(动态图、生态优势)、Tensor的自动求导机制、构建神经网络的四大组件(nn.Module、Loss、Optimizer、DataLoader),并通过MNIST手写数字识别实战演示“五步训练循环”——前向传播、计算损失、反向传播、清零梯度、参数更新。强调zero_grad()、no_grad()、CrossEntropyLoss不加Softmax等关键细节,附可视化分析与排错清单。下篇将深入CNN卷积网络,提升图像分类性能。

信息安全领域优质创作者|操作系统领域专家 144

新能源汽车电机交流电流测量系统精度全链路分析

通过全链路误差建模与瓶颈分析,结合硬件选型优化与软件算法补偿,可将系统精度从4.2%提升至≤1% FS。本文所述方法论已应用于某800V电驱平台开发,实测电流控制精度达±0.8%,为高性能电机控制奠定基础。为例,深入剖析从互感器采集到CAN报文解析的全链路信号处理流程,揭示各环节误差来源及对最终精度的影响,为研发测试提供理论支撑。:±0.1%(电阻温漂与运放开环增益限制):运放增益带宽积(GBW)不足导致高频衰减。:±0.02%/℃(铁氧体材料温敏特性):±0.5%读数(磁芯饱和效应)

优快云-新能源汽车研发测试专业博主 1493

达摩院高清人像美肤模型ABPN的深入解析及编程实现

本文深入解析了达摩院高清人像美肤模型ABPN的原理,并提供了相应的源代码实现。ABPN模型通过自适应的反投影网络,有效地实现了人像图像的美肤处理。通过进一步的研究和优化,ABPN模型有望在人像美肤领域发挥更大的作用。低频特征提取器用于提取输入图像的低频信息,而反投影网络则负责将低频信息与原始图像结合,生成美肤后的输出图像。通过将输入图像送入ABPN模型,即可得到经过美肤处理后的输出图像。通过对输入图像进行美肤处理,可以有效地去除皮肤上的瑕疵和噪点,提升图像质量和美感。

TechPulseZ的博客 711

pytorch源码编译

【代码】pytorch源码编译。

lalading6543的博客 46

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

注意力机制详解:大模型理解上下文的核心原理与PyTorch实现

学习目标:掌握注意力机制的核心逻辑、Transformer中的注意力模块设计、动手实现基础注意力机制,理解其在大模型中的作用。① 计算Q与所有K的点积(相似度);全文依次讲解学习目标与重点、为什么需要注意力机制?、注意力机制的核心公式:Scaled Dot-Product Attention、自注意力(Self-Attention):关注自身序列等内容。

2602_96795563的博客 174

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

深入理解 PyTorch FlexAttention:从 Score Mod 到 Mask Mod 的稀疏加速之道

score_mod:对分数做数值变换# 这里演示一个简单的"按 query 位置缩放"的变换# score: 当前 (b, h, q_idx, kv_idx) 位置的分数标量# 返回变换后的分数return score * 1.0 # 恒等变换,实际可替换为任意数值操作# mask_mod:返回布尔值,True 表示该位置参与计算score_mod和mask_mod的签名都是,区别在于score_mod额外接收当前分数score并返回新分数,而mask_mod只返回布尔值。

Maxwell_Newton的博客 476

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

PyTorch显存剩余6GB仍报OOM:降batch无效,根因是碎片化

训练报 CUDA OOM 但显存充足,矛盾常误导排查方向。根因是 caching allocator 碎片化,空闲块够但不连续。适用边界是降 batch 无效且非外进程占用的偶发 OOM。

昨日种种,皆成今我。今日种种,皆成新我。 350

Pytorch【8】模型保存与加载(断点续训、GPU/CPU兼容踩坑)

前面我们已经掌握:张量、自动求导、网络搭建、损失优化、Dataset+DataLoader数据流水线。模型训练好之后,我们需要把成果存下来;训练中途中断,也需要从上次位置继续训练。只保存权重✅【工业界推荐,体积小、灵活】直接保存整个模型❌【简单但不推荐,兼容性差】state_dict是一个字典,key是参数名,value是权重张量,只存参数,不存代码结构。

Beforthing的博客 199

python pytorch 梯度下降

使用MSE,ASE等评估算法对(pre,y)进行评估,得到Loss函数,对Loss函数进行求导数或偏导数,然后修正k,b重新训练,直至评估通过。以线性回归为例,y=kx+b,给定训练集(x,y),模型训练完后,给定测试集得到测试结果(x,pre)沿损失函数的负梯度方向(函数值下降最快的方向)反复更新参数,直到收敛到极小值点。其中求导数或者偏导数的方法就是梯度下降方法,本质就是一点点靠近直至最优值。

frt的博客 232

Pytorch【10】卷积神经网络CNN实战|卷积、池化、padding、stride,CNN训练MNIST

上一篇我们用全连接层完成MNIST分类。把28×28二维图像直接Flatten成一维向量,丢失像素之间空间位置关系参数数量巨大,容易过拟合卷积层Conv、池化层Pool、激活函数卷积:滑动卷积核提取局部特征;池化:降采样、压缩特征图,减少计算量。局部感受野:卷积核只看一小块区域,符合图像特征局部相关性权值共享:一张图共用同一套卷积核,大幅减少参数量平移不变性:同一个特征,在图里左右移动依然可以被识别。

Beforthing的博客 100

PyTorch导出ONNX后argmax翻转:差异跳变指向tracing而非精度

模型导出 ONNX 后输出与 PyTorch 不一致,个别输入会导致预测类别翻转。本文用语义链路查控制流固化、数值链路查浮点差异的双线排查定位根因。

昨日种种,皆成今我。今日种种,皆成新我。 199
上一篇: AI | 中国人工智能开源软件发展白皮书 | 166页PDF免费下载
下一篇: 利用LLMs自动寻找量化投资策略
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


