为什么程序员都要了解GPT,学会构建AI大模型?

gpt人工智能详细介绍 OpenAI ChatGPT不是一款普通的软件,它是由OpenAI开发的一款基于人工智能技术的自然语言生成器。因此,它并不需要像普通软件一样下载和安装在您的计算机上。作为一个云端服务,OpenAI ChatGPT可以通过您的浏览器直接访问和使用。对于普通用户来说,最简单的方法是访问OpenAI官网 https://openai.com/,并使用“GPT Explorer”测试ChatGPT。您只需要在浏览器中输入您要生成的文本,ChatGPT会自动根据您的输入生成相应的自然语言文本。 阅读详情

说起 GPT-4,小异想用一个词来形容:恐怖。

这个人工智能模型的强大,甚至让图灵奖获得者约书亚·本希奥(Yoshua Bengio)和特斯拉 CEO 埃隆·马斯克(Elon Musk)等人都感到恐惧。他们在一封公开信中联名呼吁所有AI实验室停止开发比GPT-4更强大的模型。就连ChatGPT的创始人萨姆·阿尔特曼(Sam Altman)也表示自己对GPT-4仍未完全理解,只能通过不断向它提问,并根据它的回答猜测其“思路”。

大模型时代,火爆出圈的ChatGPT让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗不保了?”等问题热议不断。

事实上,抢你饭碗的不是AI,而是会利用AI的人。

为此,黄佳总结自己在NLP 预训练大模型应用领域的经验,编写了**《GPT图解大模型是怎样构建的》**一书。旨在帮助程序员理解GPT大模型的发展和应用、在AI浪潮中抓住机遇并构建自己的大模型,以及利用ChatGPT API开发出令人惊叹的应用产品。

[图片
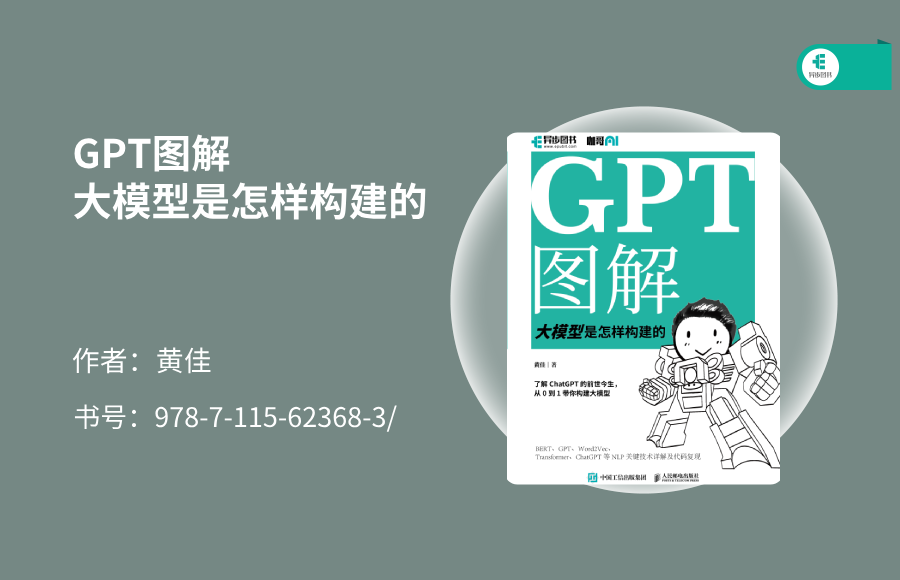
那么,从0到1构建大模型,总共需要几步呢?我结合这本书的重点之处,分享作者如何引导读者入门,希望能对大家有所启发。

1

从0到1,梳理生成式语言模型的发展脉络

自然语言处理(NLP)技术从最初的N-Gram和词袋模型,发展到强大的神经网络模型,最终演化为现代的预训练语言模型,如BERT和GPT。

在书中,作者巧妙地对这些技术一一进行解码,厘清了它们的传承关系。读者可以跟着本书追本溯源,在掌握语言模型的经典和主流算法的同时,还能够看到这些技术是如何发展起来的。这也正是本书的可贵之处,它能引导读者思考自然语言处理技术是怎么从0到1一步一步走到今天的。

■ N-Gram 和 Bag-of-Words:都是早期用于处理文本的方法,关注词频和局部词序列。

■ Word2Vec:实现了词嵌入方法的突破,能从词频和局部词序列中捕捉词汇的语义信息。

■ NPLM:基于神经网络的语言模型,从此人类开始利用神经网络处理词序列。

■ RNN:具有更强大的长距离依赖关系捕捉能力的神经网络模型。

■ Seq2Seq:基于 RNN 的编码器-解码器架构,将输入序列映射到输出序列,是Transformer 架构的基础。

■ Attention Mechanism:使 Seq2Seq 模型在生成输出时更关注输入序列的特定部分。

■ Transformer:摒弃了 RNN,提出全面基于自注意力的架构,实现高效并行计算。

■ BERT:基于 Transformer 的双向预训练语言模型,具有强大的迁移学习能力。

■ 初代GPT:基于 Transformer 的单向预训练语言模型,采用生成式方法进行预训练。

■ ChatGPT:从 GPT-3 开始,通过任务设计和微调策略的优化,尤其是基于人类反馈的强化学习,实现强大的文本生成和对话能力。

■ GPT-4:仍基于 Transformer 架构,使用前所未有的大规模计算参数和数据进行训练,展现出比以前的 AI 模型更普遍的智能,不仅精通语言处理,还可以解决涉及数学、编码、视觉、医学、法律、心理学等各领域的难题,被誉为“通用人工智能的星星之火”(Sparks of Artificial General Intelligence)。

2

从0到1,拆解大语言模型基石 Transformer 架构

语言模型算法爆发式迭代,不断推动自然语言处理的发展。本书的案例将精选早期的N-gram以及基于浅层神经网络的NPLM来详细讲解这一演变脉络,并逐步过渡到基于深层网络的语言模型(生成式语言模型GPT)。与以往不同的是,GPT模型中深层网络不再使用传统的CNN、RNN或LSTM结构,而是采用了表达能力更强大的Transformer。其核心思想是通过Transformer模型对海量文本进行无监督学习,以最大化语句序列的出现概率。

Transformer 是几乎所有预训练模型的核心底层架构,也是本书的核心内容。因此在讲解GPT模型时会细致讲解“Transformer的思想是什么,其核心组件有哪些,为什么其表达能力更强”。

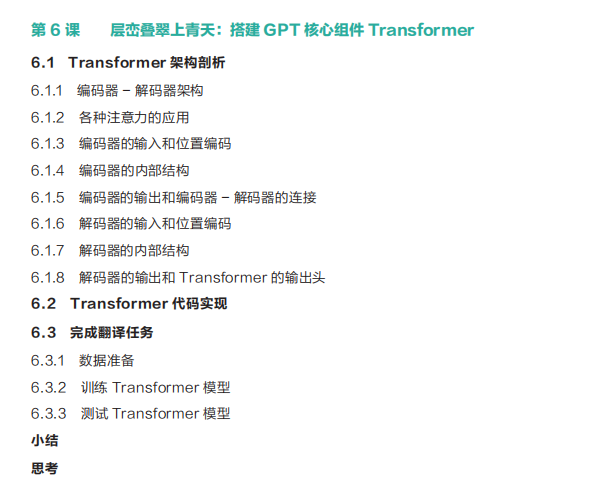
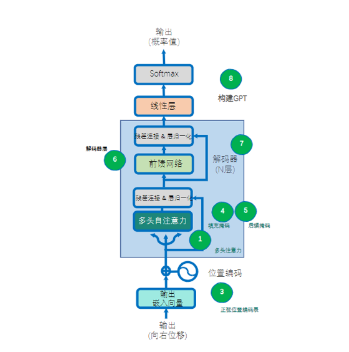
在第6课中,作者就提到从0到1逐个组件拆解大语言模型基石——Transformer架构,通过将Transformer架构拆解成多头自注意力、逐位置前馈网络、正弦位置编码表、填充位置掩码、编码器层、编码器、后续位置掩码、解码器层以及解码器,最终搭建自实现的Transformer,从而完成机器翻译任务。
图片

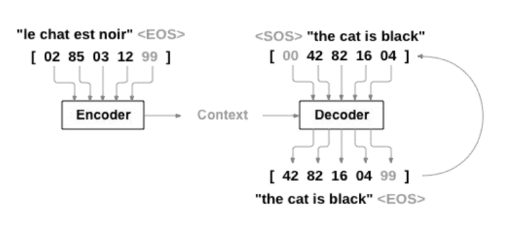
除此之外,作者还提前在第4、5课中分别介绍了Transformer基础架构(Seq2Seq架构)和Transformer核心机制(注意力),提前帮大家打好基础。

Seq2Seq架构在一个拥有8万个中英翻译的真实平行语料库中,利用不同的时序模型以及框架完成机器翻译任务,并且利用BLUE指标进行评价。
图片

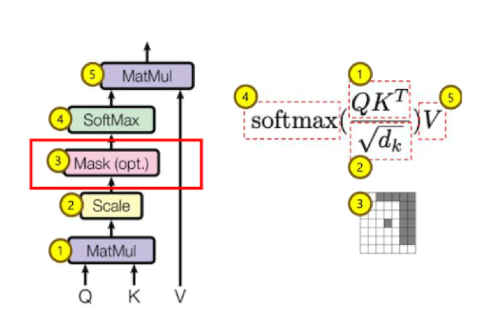
Transformer核心机制从点积注意力入手,了解注意力以及自注意力中的QKV的区别,逐步实现多头缩放点积自注意力机制,加入注意力掩码,从而对Seq2Seq架构进行重构,实现多头自注意力的编解码器结构。
图片

3

从0到1,训练出你的简版生成式GPT

这本书系统地梳理了自然语言处理从诞生初期到进入深度学习时代的发展历程,深入解析了Transformer架构以及GPT模型家族的独特之处,尤其是ChatGPT基于人类反馈的强化学习训练原理。书中还通过几个简单的实战案例,让读者充分体验了预训练大模型的魅力。

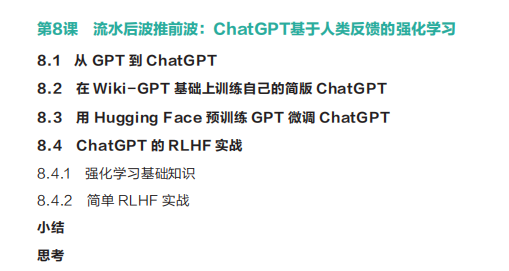
最后,在第8课中,黄佳老师将带领你从0到1训练你的简版生成式GPT,这将是一次绝佳的学习机会,不容错过!
图片

实战1: 结合第7课的WikiGPT,加入Movie Dialog语料库对WikiGPT进行微调,使得其获得对话能力从而得到minichatGPT 。
图片

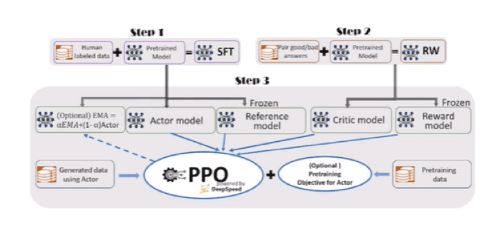
实战2: 利用DeepSpeed框架训练一个开源的1.3Bchatgpt模型,深入了解GPT3 - GPT3.5 的训练机制改变,了解SFT(Supervised Fine Tuning)、奖励模型微调(RW)、 PPO(Proximal Policy Optimization)算法以及RLHF(Reinforcement Learning Human Feedback)。
图片

可以说,这是一本干货满满、诚意十足的书籍,特别适合NLP领域的学生、研究人员,以及任何对ChatGPT和生成式模型有兴趣的人阅读,也适合基础不深但是想入门AI的初学者学习。

通过这本书:

· 你将获得现代NLP技术的关键内核和完整脉络(摒弃一切已经不需要过多了解的过时东西)!

· 你将掌握NLP领域编程基本功和PyTorch主要内容!

· 你将搭建起一个属于自己的简版ChatGPT(生成式语言模型)!

· 你将掌握注意力机制和Transformer架构的核心思想以及代码实现!

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
从零开始了解人工智能:核心概念、GPT及 DeepSeek 探索 人工智能(Artificial Intelligence)是让机器拥有类似人类思考和学习能力的一门学科。它的核心目标在于模拟与扩展人类智力,在图像识别、语音交互、自然语言处理(NLP)、自动驾驶等领域都能看到 AI 的身影。从专业角度来讲,人工智能结合了统计学、计算机科学及神经科学等多学科理论,通过算法与数据的驱动来让计算机不断迭代优化,甚至可以衍生出自主学习的能力。通过本篇文章,你已经对人工智能(AI)的基础概念和发展历程有了大致了解,也初步见识了大语言模型 GPT。 阅读详情

相关推荐

GPT-4大模型硬核解读!看完成半个专家.pdf

GPT-4大模型硬核解读!看完成半个专家.pdf

GPT图解:大模型是怎样构建的 经典书籍

今天又来给大家推荐一本大模型方面的书籍本书将以生动活泼的笔触,将枯燥的技术细节化作轻松幽默的故事和缤纷多彩的图画,引领读者穿梭于不同技术的时空,见证自然语言处理技术的传承、演进与蜕变。

AAI666666的博客 2469

激光可燃气体传感器:核心技术环节分析

激光可燃气体传感器核心技术涵盖七个维度:1)TDLAS光谱吸收与调制技术(检测下限ppm级);2)DFB激光器与双闭环温控系统(波长稳定性±0.0036nm);3)微弱信号处理技术(信噪比提升60dB);4)环境补偿算法(温压补偿误差<±1%);5)本质安全防爆设计(ExiaIICT4Ga等级);6)智能边缘计算(STM32L476芯片);7)多重性能验证(响应时间<1秒)。通过微型化、多气体检测等创新,该技术已在工业安全等领域替代传统方案,实现高精度检测。(149字)

上市公司前技术负责人,20 年软硬件深耕 + 百人研发团队管理经验,名校理工科背景加持。从技术攻坚到团队掌舵,沉淀海量项目实战与管理心得,专注分享软硬件干货、疑难问题解决方案,既是靠谱知识传播者,也盼链接优质项目共成长。 1042

《GPT图解—大模型是怎样构建的》学习(第三天)

词向量通常也叫词嵌入,是一种寻找词和词之间相似性的NLP技术,它把词汇各个维度上的特征用数值向量进行表示,利用这些维度上特征的相似程度可以判断哪些词和哪些词语义更接近。在实际运用中,词向量和词嵌入两个重要术语其实可以互换使用,都表示将词汇表中单词映射到固定大小的连续向量空间的过程。但是在默写情况下也可能有细微的差别:词向量:通常用于描述具体的向量表示,即一个词对应的实际数值向量。例如我们可以说“‘cat’这个词的词向量是一个300维的向量”。词嵌入:通常用于描述将词映射到向量空间的过程或者表示方法。

qq_68194416的博客 2690

QtWebApp的使用【在Qt中搭建HTTP服务器】(一)

用Qt和QtWebApp能够实现在C++中开发HTTP Web服务器应用程序。 首先,需要先安装Qt的软件开发工具包。点此下载 其次,下载最新的QtWebApp库。点此下载 下载并解压缩QtWebApp ZIP文件。你将会看到: 如何使用QtWebApp 1)将QtWebApp.zip文件解压到文件夹中,并创建一个名为“ MyFirstWebApp”的新Qt控制台项目。然后,建立如下文件结构: 2)将以下行添加到MyFirstWebApp项目的项目文件中: QT += network include(

饭的笔记本 2万+

麒麟V10系统命令实战指南:从入门到精通

本文为麒麟V10操作系统用户提供了一份从入门到精通的命令行实战指南。内容涵盖文件管理、进程监控、网络诊断、文本处理及系统管理等核心场景,旨在帮助用户转变思维,掌握高效解决实际问题的系统命令技巧,从而提升在麒麟V10环境下的运维与工作效率。

sat99的博客 594

GPT-3: 最强的人工智能?

当未来有一天,只要我们头脑中有个想法,不需要懂得编程,也不需要聘请开发人员,更不需要等待短则几个星期,长则几年的交付,通过人工智能可以快速帮把我们的想法变成代码,并发布到云平台上。一个APP或者一个游戏,从一个想法到上线运行 只需要一个人几天时间就可以全部搞定,这是不是听起来太点天方夜谭?在2017年的时候,一些研究人员的预测,最快在2040年我们或许会开发出一个能进行自动编程的AI系统。可是时间刚刚过了3年多,到了2020年7月,GPT-3就横空出世。它可以根据简短的描述生成可执行的代码,不仅可以生成前.

fribbler的博客 9370

vue3 - element-plus表格组件el-table实现鼠标拖曳排序功能,vue3 Table表格拖拽排序,表格每行使用鼠标拖动进行排序功能,表格拖拽排序实现(详细示例代码,一键复制开箱即用

vue3,elementPlus,el-table,typescript,表格组件,Table表格,表格拖动排序,表格拖曳排序,鼠标拖拽表格进行排序功能,elementplus表格如何实现拖动每行进行排序操作,表格拖动改变顺序,鼠标拖曳,表格内的数据项拖拽排序,vue3如何实现element-Plus表格组件进行表格内的数据项拖拽排序,列表拖拽排序效果,实现table动态拖拽,鼠标拖着排序,vue3 element Plus 表格拖曳拖动拖拽 排序,el-table拖拽排序实现,表格内容拖拽重新排序,树形表

✅ 精选推荐文章 1万+

为什么程序员都要了解GPT,学会构建AI大模型?了解GPT大模型,读这本书就够了!

■ GPT-4:仍基于 Transformer 架构,使用前所未有的大规模计算参数和数据进行训练,展现出比以前的 AI 模型更普遍的智能,不仅精通语言处理,还可以解决涉及数学、编码、视觉、医学、法律、心理学等各领域的难题,被誉为“通用人工智能的星星之火”(Sparks of Artificial General Intelligence)。自然语言处理(NLP)技术从最初的N-Gram和词袋模型,发展到强大的神经网络模型,最终演化为现代的预训练语言模型,如BERT和GPT。”“谁的饭碗不保了?

python12222_的博客 2021

基于逆向工程的中国裁判文书网爬虫技术深度解析:从反爬破解到合规抓取

最近承接了一个法律大数据分析的项目,需要获取某类合同纠纷的裁判文书数据,用于分析不同地区的判决规律、法官的裁判倾向以及法条适用情况。原本以为用常规的Python爬虫就能搞定,结果刚对着中国裁判文书网发了几个请求,就遭遇了“滑铁卢”:要么请求直接返回403 Forbidden,要么触发滑块验证码,甚至连IP都被临时封禁了。普通的requests+BeautifulSoup组合在裁判文书网面前完全失效,这也让我意识到,想要获取这里的数据,必须先通过逆向工程拆解网站的请求逻辑和反爬机制。经过一周的摸索,从抓包分析

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 3172

【WorkBuddy专栏53】我的WB为什么变聪明了——SOUL与USER配置管理实战(上)

【WorkBuddy专栏53】我的WB为什么变聪明了——SOUL与USER配置管理实战(上)

AI人人懂 245

【好书推荐】为什么程序员都要了解GPT,学会构建AI大模型?

说起 GPT-4,小异想用一个词来形容:恐怖。这个人工智能模型的强大,甚至让图灵奖获得者约书亚·本希奥(Yoshua Bengio)和特斯拉 CEO 埃隆·马斯克(Elon Musk)等人都感到恐惧。他们在一封公开信中联名呼吁所有AI实验室停止开发比GPT-4更强大的模型。就连ChatGPT的创始人萨姆·阿尔特曼(Sam Altman)也表示自己对GPT-4仍未完全理解,大模型时代,火爆出圈的ChatGPT让程序员们开始重新评估自己的本领。“AI会取代那些行业?”“谁的饭碗不保了?”等问题热议不断。

2401_85325726的博客 765

Ardupilot chibios IO固件,IO与FMU通信,固件下载(3)

目录 文章目录目录摘要 摘要 本节主要记录自己学习IO与FMU通信

陌城烟雨 2801

GPT图解大模型是怎样构建的

GPT图解大模型是怎样构建的

小虚竹的专栏 5221

【CUDA编程部署教程】第一章:GPU架构与CUDA编程核心 1

我们将剖析现代GPU的计算心脏——流式多处理器(SM),理解其独特的Warp执行模型,探索Tensor Core带来的革命性矩阵运算加速,并深入探讨决定性能命脉的内存体系。当必须访问全局内存时,则必须遵循**合并访问(Coalesced Access)**的原则,即让一个Warp内的32个线程访问连续的内存地址,从而让硬件将多次访问合并为一次高效的内存事务,以充分利用带宽。SM的调度器以Warp为单位分派指令,在一个Warp内,所有32个线程在同一时刻执行完全相同的指令,但处理的数据不同,这种模型被称为。

VectorShift的博客 221

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

程序员为什么要学习AI大模型?

在科技浪潮的推动下,人工智能(AI)技术已经成为推动软件行业发展的核心动力。而在AI技术的众多分支中,AI大模型以其巨大的潜力和广泛的应用场景,逐渐成为了程序员们关注的焦点。本文将从程序员的角度出发,探讨AI大模型的定义、应用,以及为何程序员需要深入了解大模型的相关知识。

2401_84495872的博客 3800

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

人工智能这么厉害,比如GPT-4,为什么没有看到程序员大量失业?

其实关于人工智能的定义,在不同的地方有不同的定义,下面看一下百度百科的解释:人工智能是研究使用计算机来模拟人的某些思维过程和智能行为(如学习、推理、思考、规划等)的学科,主要包括计算机实现智能的原理、制造类似于人脑智能的计算机,使计算机能实现更高层次的应用。其实也可以用下面的一张图说明一下:那看完上面这个内容,我们基本上也可以看得到,人工智能在我们生活中的应用是不是也挺多了呢?比如说淘宝的拍一拍,通过照片能够识别要购买的同款商品,微信的扫一扫也能;

zz12345600354的博客 793

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

人工智能大模型会替代程序员吗?

当今社会正日新月异的快速发展,新的技术、新的产品、新的行业、新的工作和生活方式不断出现,传统行业不断的被新技术重塑甚至颠覆,就业方式和机会也在不断的改变,在高三学子填报高考志愿时,怎样才能选好方向,为自己未来的工作打好基础少走弯路,是高中生都会认真思考和关注的一个问题。人工智能特别是人工智能大模型,已经在自然语言处理领域取得了显著的成就,甚至可以按照人们都要求帮助写程序代码,这引发了人们对程序员未来角色的广泛讨论。程序员会被替代吗?以后会不会有大量程序员失业?

DAMOXINGHAITAI的博客 1002

大模型时代:为什么建议程序员要去学习AI大模型?

在科技浪潮的推动下,人工智能(AI)技术已经成为推动软件行业发展的核心动力。而在AI技术的众多分支中,AI大模型以其巨大的潜力和广泛的应用场景,逐渐成为了程序员们关注的焦点。本文将从程序员的角度出发,探讨AI大模型的定义、应用,以及为何程序员需要深入了解大模型的相关知识。

qingkahui24689的博客 1718

了解GPT大模型,读这本书就够了(GPT图解)

最近发现,当国外的权力的游戏反转再反转的时候,国内的AI创业者们除了吃瓜之外也没闲着。

DEVELOPERAA的博客 1105
上一篇: 今年读过最绝的大模型神书,看完直接脱胎换骨
下一篇: 一文彻底搞懂大模型 - Fine-tuning三种微调方式
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值