RAG要被颠覆了?亚马逊最新研究:仅用关键词搜索+Agent,就能达到传统RAG 90%性能,还不用向量数据库 >

通用大模型如何重塑医疗AI:GPT-4、AMIE与工程化落地实践 大语言模型(LLM)正从文本生成工具演进为具备专业推理能力的智能体,其核心在于零样本泛化、上下文对齐与混合架构设计。GPT-4在医学考试中无需提示即超越医学生,印证了世界知识压缩带来的跨域迁移能力;AMIE则通过in-context critics和自博弈训练,实现可解释、可验证的对话式对齐。这类技术突破不仅重构临床决策支持系统(CDSS)的设计范式,更推动医疗AI走向‘通用底座+专科增强’的工程化路径——在知识更新快、容错率高的患者教育场景首选API调用,在影像识别、手术规划等高精度任务中坚持专用模型。本 阅读详情

在大模型应用落地中,检索增强生成(RAG) 早已成为解决幻觉、接入私有知识库的标配方案。而提到RAG,大家的第一反应就是向量数据库、嵌入模型、分块策略——似乎这套复杂的链路,是实现高质量知识库问答的必经之路。

但亚马逊AWS的最新研究,直接打破了这个行业共识。在题为《Keyword search is all you need》的论文中,亚马逊团队提出了一个颠覆性结论:基于智能体(Agent)的关键词搜索,无需任何向量数据库和语义检索,就能达到传统RAG系统90%以上的性能表现,在复杂金融文档场景中甚至能反超RAG。

这篇论文不仅用详实的实验击穿了“向量检索是RAG核心”的固有认知,更为轻量化、低成本的大模型知识库落地,提供了一套全新的范式。

一、行业痛点:传统RAG,困在“向量数据库”的枷锁里


自从2020年RAG架构被提出以来,它就成了大模型落地的“事实标准”。通过将文档分块、向量化存入向量数据库,用户查询时先做语义检索匹配相关片段,再交给大模型生成答案,这套流程完美解决了大模型幻觉、知识更新滞后的问题。

但随着行业应用的深入,传统RAG的短板也暴露无遗:

  1. 1. 集成与维护成本极高:一套完整的RAG系统需要搭配嵌入模型、向量数据库、分块策略调优,开发链路复杂;知识库每次更新,都需要重新执行分块、嵌入、索引入库的全流程,对于高频更新的场景极不友好。

  2. 2. 检索质量强依赖人工调优:分块大小、重叠率、检索条数、嵌入模型选型,都会直接影响最终效果,很多时候RAG效果差,本质是人工调优没做到位。

  3. 3. 复杂文档处理能力拉胯:面对带表格、长段落、复杂结构的PDF文档(如上市公司财报、技术白皮书),固定分块策略很容易把完整信息拆碎,导致语义检索根本找不到正确的上下文。

正是这些痛点,让研究者开始思考:语义检索和向量数据库,真的是RAG不可缺少的部分吗?有没有更简单、更低成本的方案?

二、破局方案:Agent+关键词搜索,扔掉向量数据库也能打


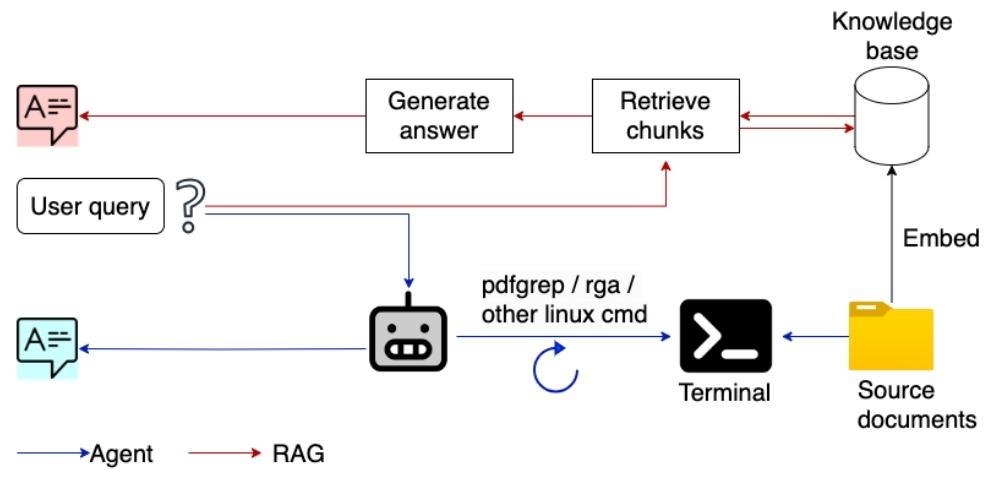
亚马逊团队给出的答案,是一套基于工具增强的Agentic关键词搜索框架。它的核心逻辑极其简单:不用分块、不用嵌入、不用向量数据库,直接让大模型通过ReAct推理框架,自主调用Linux命令行工具,在原始文档中做关键词/正则搜索,迭代获取上下文,最终生成答案。

两种方案的核心流程对比如下图所示:
图片

图1:RAG与Agent-based QnA管线对比,红色为传统RAG流程,蓝色为本文提出的Agent搜索流程*

整个Agent的工作流,被封装成了一套可迭代的搜索算法,核心步骤如下:

  1. 1. 初始阶段,Agent先执行脚本读取目标文件夹内所有文档的元数据,先搞清楚“有哪些文档、分别是什么主题”;

  2. 2. 基于用户查询,Agent自主生成rga/pdfgrep等Linux搜索命令,在Shell中执行,获取关键词匹配的原文上下文;

  3. 3. 根据搜索结果,判断是否需要补充搜索、调整关键词/正则,还是已经获取了足够的信息生成答案;

  4. 4. 迭代执行搜索-判断流程,直到达到最大迭代次数,或找到完整答案后停止搜索,输出最终结果。

这套方案最惊艳的地方,是它把“信息检索”的决策权完全交给了大模型的推理能力,而非固定的语义检索算法。Agent可以根据查询的复杂程度,自主决定做宽泛搜索还是精准定位,甚至可以通过多轮搜索补全上下文,彻底摆脱了传统RAG固定分块的限制。

三、核心实验:90%性能追平RAG,复杂场景直接反超


为了验证这套方案的有效性,亚马逊团队做了全面的对照实验,用标准RAG系统作为基线,在6个覆盖不同领域、不同难度的数据集上做了横向对比,最终用RAGAS框架做了全维度评估。

实验设置

  • 基线RAG方案:亚马逊Bedrock平台,Titan Text V2嵌入模型(1024维),300token分块+20%重叠,OpenSearch无服务向量索引,Anthropic Claude 3 Sonnet生成答案。
  • Agent搜索方案:同样基于Claude 3 Sonnet模型,LangChain ReAct框架,可调用pdfmetadata、rga、pdfgrep三款Shell工具,温度设置为0.001保证结果稳定。
  • 评估指标:忠实度(Faithfulness)、上下文召回率(Context Recall)、答案正确率(Answer Correctness),均为RAG领域的核心评估标准。

核心结果:全维度追平传统RAG

实验结果如下表所示,其中Attainment(达成率)代表Agent方案达到传统RAG基线的性能百分比:

数据集名称忠实度上下文召回率答案正确率
AgentRAG达成率(%)AgentRAG达成率(%)AgentRAG达成率(%)
PaulGrahamEssay0.86620.905695.650.75270.858387.700.58080.726879.91
Llama2Paper0.72520.819988.450.61480.871370.560.58230.666187.42
HistoryOfAlexnet0.72800.765795.080.69680.833083.650.64060.707390.57
BlockchainSolana0.81220.862794.150.74220.745099.620.58700.587299.97
LLM Survey paper0.80610.812199.260.63550.643898.710.51230.514899.51
平均94.5288.0591.48

表1:Agent与RAG在各数据集上的指标对比,平均达成率超90%

从结果可以看到,这套无向量数据库的Agent方案,实现了极其亮眼的表现:

  • 平均忠实度达到RAG的94.52%,保证了生成答案的事实一致性,有效抑制幻觉;
  • 平均上下文召回率达到88.05%,在技术文档场景中几乎与RAG持平;
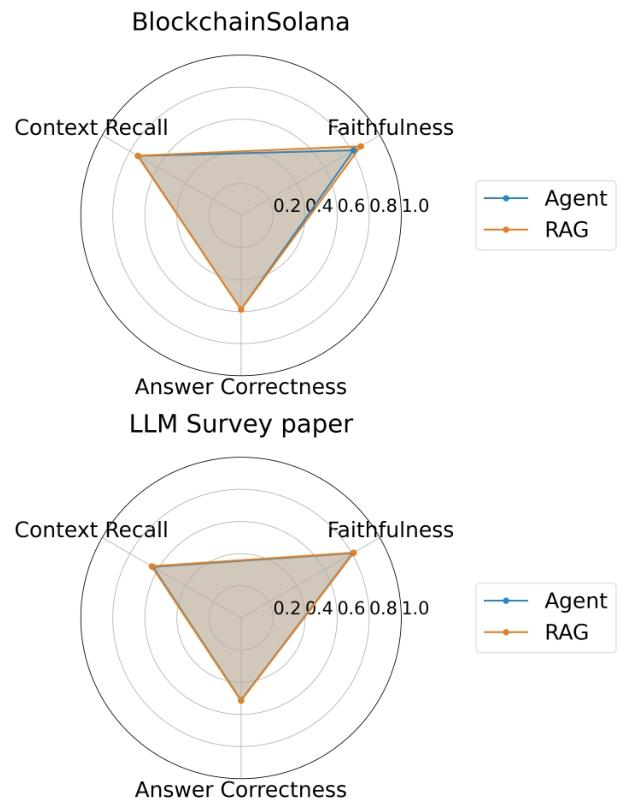
  • 平均答案正确率达到91.48%,其中Solana区块链、LLM综述两个数据集,正确率达成率分别达到99.97%和99.51%,与传统RAG几乎没有差距。

下图直观展示了这两个核心数据集上,Agent与RAG的指标覆盖度对比,二者的柱子几乎完全重合:
图片

图2:BlockchainSolana与LLM Survey Paper数据集上,Agent与RAG的指标覆盖对比*

炸裂发现:复杂金融文档,Agent反超RAG6个百分点

如果说常规数据集上Agent是“追平RAG”,那在高难度的FinanceBench金融财报数据集上,Agent方案实现了对传统RAG的全面反超。

这个数据集包含上市公司10-K、10-Q财报、业绩公告等,充斥着大量表格、交叉引用和专业术语,是传统RAG的“老大难”场景。实验结果如下表所示:

系统配置答案正确率(%)
传统RAG24.24
Agent(3轮平均)32.71
Agent(第4轮)39.64

表2:FinanceBench数据集上,Agent与RAG的答案正确率对比

传统RAG的正确率仅为24.24%,而Agent方案平均正确率达到32.71%,最高达到39.64%,相对提升超60%,绝对提升近16个百分点。

背后的核心原因,是传统RAG的固定分块会把财报中的表格、跨页数据拆得支离破碎,语义检索根本无法获取完整的上下文;而Agent可以通过关键词精准定位到相关表格和段落,自主获取完整的上下文信息,完美解决了复杂结构文档的检索难题。

四、方案优势与局限:什么时候该扔掉向量数据库?


核心优势

  1. 1. 极致的低成本与易用性:无需维护向量数据库,省去嵌入模型调用、分块调优、索引更新的所有成本,新增文档直接丢入文件夹即可,零成本更新知识库。

  2. 2. 复杂文档处理能力更强:对于带表格、跨页引用、复杂结构的PDF文档,效果远超固定分块的传统RAG。

  3. 3. 极高的可复现性:纯命令行工具实现,无需复杂的环境配置,比Claude Computer Use等GUI操作方案更稳定、更易复现。

  4. 4. 完美适配高频更新场景:对于政策、财报、新闻等需要频繁更新知识库的场景,彻底摆脱了传统RAG“更新一次就要重跑一次全流程”的痛点。

客观局限

论文中也明确提到了这套方案的短板:在长文档、模糊语义查询、跨段落多跳推理的场景中,性能会有明显下降;对于需要深度语义理解的议论文、散文类文本,效果不如传统RAG;同时也受限于大模型的上下文窗口,无法处理超大规模文档。

五、写在最后


这篇论文的价值,从来不是“彻底干掉RAG和向量数据库”,而是给整个行业提供了一个全新的思路:RAG的核心是“检索增强生成”,而不是“向量检索增强生成”。

在很多实际落地场景中,开发者们过度神化了向量数据库和语义检索,把RAG系统做得越来越复杂,却忽略了“让大模型找到正确信息”这个最本质的目标。而亚马逊的这项研究证明,很多时候,一个简单的Agent+关键词搜索,就足以满足绝大多数场景的需求,还能省去90%的开发和维护成本。

对于行业而言,这篇论文也预示着RAG的发展方向:未来的检索增强,一定是“大模型推理主导、检索工具为辅”的Agentic RAG范式,让大模型自主决定“找什么、去哪找、怎么找”,而非被固定的检索算法束缚住手脚。

https://arxiv.org/pdf/2602.23368

这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

1. 成长路线图&学习规划

要学习一门新的技术,作为新手一定要先学习成长路线图,方向不对,努力白费。

这里,我们为新手和想要进一步提升的专业人士准备了一份详细的学习成长路线图和规划。可以说是最科学最系统的学习成长路线。
在这里插入图片描述

2. 大模型经典PDF书籍

书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)

在这里插入图片描述

3. 大模型视频教程

对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。

在这里插入图片描述

4. 2026行业报告

行业分析主要包括对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

5. 大模型项目实战

学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。

在这里插入图片描述

6. 大模型面试题

面试不仅是技术的较量,更需要充分的准备。

在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。

在这里插入图片描述

7. 资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

Qwen3上架AWS Bedrock:开发者可直接调用的生产级代码大模型 大语言模型(LLM)正从研究实验走向工程落地,其核心挑战在于如何降低集成门槛、保障推理稳定性并控制使用成本。基于混合专家(MoE)架构的480B参数模型,通过动态激活约35B参数实现高性能与低延迟平衡;结合Instruct指令微调范式,显著提升代码生成的确定性与结构化输出能力。依托亚马逊云科技Bedrock平台,该模型提供标准化API、细粒度Token计费、IAM权限管控及自动扩缩容等企业级能力,使开发者无需自建GPU集群或维护CUDA环境,即可在CI/CD、ComfyUI工作流或Python应用中快速集成 阅读详情

相关推荐

停止阅读AI通讯,开始构建最小可行产出(MVP Output)

在AI技术快速迭代的今天,‘信息过载’正演变为工程师的隐性生产力税。理解AI Newsletter疲劳的本质,关键在于识别其背后消耗的是深度认知带宽而非时间;而构建型思维的核心,是将模糊洞察转化为可验证、可交付、零配置使用的最小可行产出(MVP Output)。这种从消费到生产的范式切换,不仅降低技术债感知阈值,更直接提升业务响应效率——例如将决策包生成从63小时压缩至11分钟。它适用于需要快速验证AI价值的产品经理、被周报困住的技术管理者,以及渴望重拾动手能力的资深开发者。本文即围绕MVP Output这

weixin_34056162的博客 435

颠覆传统RAG!Corrective-RAG引入自我反思与自我评估,让文档检索更智能更精准!

大型语言模型(LLMs)在生成文本时不可避免地会出现幻觉现象,因为其生成内容的准确性无法单靠模型参数中的知识来保证。尽管检索增强生成(RAG)是 LLMs 的一种实用补充,但其效果在很大程度上取决于检索到的文档的相关性,这也引发了人们对检索出错时模型表现的担忧。为此,有学者提出了一种名为 Corrective Retrieval Augmented Generation(CRAG)的策略,以提升生成的鲁棒性。

2401_85378759的博客 1139

SpringBoot+Vue+MySQL 高校学科竞赛平台 完整可运行版(源码+文档)

本项目基于SpringBoot+Vue+MySQL构建高校学科竞赛管理平台,覆盖学生、教师、领队教师、管理员四大角色,实现竞赛发布、报名、刷题、评分、公示等全流程闭环管理。系统架构清晰,技术主流,配套完整源码、数据库脚本、万字论文、开题报告、答辩PPT及部署文档,支持一键运行,适用于毕业设计、课程设计及院系二次开发,真正实现“开箱即用”。

招风的黑耳优快云 295

AI智能体深度解析:架构原理+平台对比+实战案例,程序员必学!

本文深入解析AI智能体(Agent)的架构、特点及主流平台,强调其作为"数字员工"能自主思考决策执行,区别于传统AI的聊天机器人。AI智能体=大模型(大脑)+记忆+工具+规划+反思,形成闭环系统实现自主进化。文章对比了AgentOne、Palantir等主流平台,指出AI智能体正推动AI从"对话"走向"行动",提升效率并实现复杂任务自动化,是AI产品经理必须掌握的核心技术。

Androiddddd的博客 998

XR Interaction Toolkit实战:为HTC Vive Cosmos打造抓取、投掷与UI交互(Unity 2023教程)

本文详细介绍了如何使用Unity 2023和XR Interaction Toolkit为HTC Vive Cosmos开发抓取、投掷与UI交互系统。通过实战案例'VR投掷训练室',从基础配置到高级功能实现,涵盖物理抓取、精准投掷机制和VR UI交互设计,帮助开发者提升VR交互开发技能。

weixin_30562507的博客 257

Enterprise Architect 中文经典教程

本文使用到的EA工程文件下载 一、Enterprise Architect简介 Enterprise Architect是一个对于软件系统开发有着极好支持的CASE软件(Computer Aided Software Engineering)。EA不同于普通的UML画图工具(如VISIO),它将支撑系统开发的全过程。在需求分析阶段,系统分析与设计阶段,系统开发及部署等方面有着强大的支持,...

2万+

RAG要被颠覆了?亚马逊最新研究:仅用关键词搜索+Agent,就能达到传统RAG 90%性能,还不用向量数据库

在大模型应用落地中,**检索增强生成(RAG)** 早已成为解决幻觉、接入私有知识库的标配方案。而提到RAG,大家的第一反应就是向量数据库、嵌入模型、分块策略——似乎这套复杂的链路,是实现高质量知识库问答的必经之路。

m0_59235945的博客 449

Antlr4入门(二)基本概念解析

在上一章中(Antlr4入门(一)IDEA中Antlr的安装与使用),我们安装了Antlr,并编写运行了第一个程序“Hello world”。而在本章中,我们将学习语言类应用程序相关的重要过程、术语和数据结构。 一. 术语 语言(language)是由一系列有意义的语句组成,语句(sentence)由词组组成,词组(phrase)是由更小的子词组(subphrase)和词汇符号(vocabulary symbols)组成。 举个例子,英语就是一种语言,“Keep on going never gi.

qq_37771475的博客 5209

亚马逊新研究:关键词搜索+Agent竟能达到传统RAG 90%性能,还不用向量数据库!

亚马逊AWS最新研究颠覆传统RAG方案,提出基于Agent的关键词搜索框架,无需向量数据库即可实现90%以上的RAG性能。该方案通过大模型自主调用命令行工具进行关键词搜索,在复杂金融文档场景中甚至反超传统RAG16个百分点。研究揭示了传统RAG的三大痛点:高维护成本、强依赖人工调优和复杂文档处理能力差。新方案优势包括低成本、易用性强、处理复杂文档能力突出,尤其适合高频更新场景。虽然存在长文档和模糊查询的局限,但为行业提供了"检索增强生成"的新思路,预示未来RAG将向"大模型主导

2401_85375151的博客 442

超级详细的H3C模拟器HCL的交换机Telnet服务配置过程(图文)

VC++2017 MFC关于一个电话机房配线架进线出线节点数据库管理的程序 机房数据库原来是一个EXCEL表,查询,输入数据不方便。现用access数据库ODBC访问。平常没编过程序,编个程序练练手。记录一下学习中的问题,和解决方法,供大家分享,讨论,以便共同进步。希望多提宝贵意见,携手提高代码水平。 程序写的很不规范,代码冗余,显得程序臃肿,代码重用性差。发表这篇博客的目的也是为了改进这个程序。CListCtrl 单元格可以编辑,有Combo Box下拉列表功能。使用PreTranslateMe

techcai的博客 1万+

逆变器专题(6)-正负序分离(二阶广义积分器DSOGI)

相应仿真原件请移步资源下载DSOGI作为一种常用的正负序分离方法,其可以在电压三相不平衡的状态下实现较为精准的锁相环。

cyc19980105的博客 8808

关键词搜索+Agent就能达到90%RAG性能?收藏这份轻量化大模型知识库落地指南!

这篇论文的价值,从来不是“彻底干掉RAG和向量数据库”,而是给整个行业提供了一个全新的思路:RAG的核心是“检索增强生成”,而不是“向量检索增强生成”。在很多实际落地场景中,开发者们过度神化了向量数据库和语义检索,把RAG系统做得越来越复杂,却忽略了“让大模型找到正确信息”这个最本质的目标。而亚马逊的这项研究证明,很多时候,一个简单的Agent+关键词搜索,就足以满足绝大多数场景的需求,还能省去90%的开发和维护成本。

youmaob的博客 205

CMM软件:PC-DMIS汽车制造二次开发

PC-DMIS 是一种广泛应用于坐标测量机(CMM)的测量软件,它不仅提供了强大的测量功能,还支持用户通过二次开发来扩展其功能。二次开发可以显著提升测量效率,满足特定的测量需求,减少重复性工作,提高数据处理和分析的准确性。本节将介绍 PC-DMIS 二次开发的基本概念、开发环境的搭建以及开发中常用的工具和方法。PC-DMIS 二次开发为用户提供了强大的工具,可以显著提升测量效率、减少重复性工作并提高数据处理和分析的准确性。

kkchenjj的博客 1816

Docker Compose:搭建本地多服务开发环境

从一个 Java API、PostgreSQL 和 Redis 开始,配置服务名、端口、环境变量、健康检查、数据卷和依赖关系。理解 Compose 文件如何被解析、项目如何隔离,以及哪些数据不能依赖“重建容器”保留,能够把个人开发环境整理成团队可复用的启动入口。

m0_62221377的博客 476

AI上推荐 之 NeuralCF与PNN模型(改变特征交叉方式)

1. 前言 随着信息技术和互联网的发展, 我们已经步入了一个信息过载的时代,这个时代,无论是信息消费者还是信息生产者都遇到了很大的挑战: 信息消费者:如何从大量的信息中找到自己感兴趣的信息? 信息生产者:如何让自己生产的信息脱颖而出, 受到广大用户的关注? 为了解决这个矛盾, 推荐系统应时而生, 并飞速前进,在用户和信息之间架起了一道桥梁,一方面帮助用户发现对自己有价值的信息, 一方面让信息能够展现在对它感兴趣的用户前面。 推荐系统近几年有了深度学习的助推发展之势迅猛, 从前深度学习的传统推荐模型(协

Miracle8070 1万+

用Excel或WPS做两独立样本的T检验

一般情况下收集数据时常用的是Excel或者WPS,但统计时却用SPSS等软件进行统计学分析,经常很多人找不到SPSS的安装包,或者苦于正版激活或忘记教程,其实Excel或WPS自带函数就足够了,均数、标准差以及统计检验都是一个函数而已。解释:先做F检验,如果F>0.05就做T检验,Ttset里的数据为两组的数据的比较,结果如下。A组的均数计算 =AVERAGE(B2:B6)A组的标准差计算 =STDEV(B2:B6)B组的标准差计算=STDEV(B7:B19)分组 数值 A组均数 A组标准差 p值。

Mrrunsen的博客 6754

AI全栈实战 | 3.9-01 爬虫入门:requests 加 BeautifulSoup 三分钟跑通,但 90% 的人栽在这 4 个“礼貌“问题上

⚠️:本文内容仅用于。请遵守目标站点的服务条款与相关法律法规,不得对目标服务造成负担,不得采集、传播个人隐私数据。技术是中性的,边界在你手里。爬虫的入门技术(requests 发请求 + BeautifulSoup 解析)三分钟就能学会。真正区分"会用爬虫"和"会做爬虫的人"的,是这篇我们跑通"请求→解析→存储"的最小闭环,然后重点把"合规与礼貌"这根弦给你绷上。

源码获取 | 运行部署 | 定制二开修改,如果回复不及时请耐心等待,请见谅。 432

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

【基于 WebSocket 的多用户网页五子棋】—— 数据管理模块

但行好事,莫问前程

qq_42996461的博客 250

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

C++算法(七)

C++ stack算法题和一些客观题

2503_94479566的博客 378

OpenClaw 深度调查:把 AI 助手做成你自己的控制平面

对 openclaw/openclaw 的完整技术尽调:Gateway 架构、Agent 运行时、工具与沙箱、30 个消息通道、181 个插件、安全信任边界、工程代价与采用建议。17 章 / 10 张图,全部数字标注口径,数据截至 2026-10-31。

厚积薄发 294

IDEA 简介:从零认识 IntelliJ IDEA

IDEA 全称,是由 JetBrains 公司开发的一款主流 Java 集成开发环境(IDE)。它集代码编辑、编译、调试、测试、版本控制、构建管理等功能于一体,被大量 Java 开发者视为日常开发的首选工具。所谓 IDE(Integrated Development Environment,集成开发环境),就是把写代码所需的各类工具整合到同一个界面中。相比只用文本编辑器加命令行编译,IDE 能显著减少重复操作,让开发者把精力集中在业务逻辑上。

ztI10的博客 176

TransactionInactiveError:await 之后事务已经不活跃了

TransactionInactiveError 出现于 IndexedDB 事务已结束(非 active 状态)时调用 put、get 等操作。常见于 await 后或 setTimeout 中执行请求,因任务已完成,事务已提交或进入 finished 状态。请求必须在创建事务的同一任务中挂起,否则无效。解决方法:在 onsuccess 回调内同步发起后续操作,或提前将所有请求挂入事务。避免在异步上下文中使用事务操作,确保请求在事务活跃期内完成。

qq_40822000的博客 159

云计算课程小组PPT汇报任务书

36人分为6组,每组6人;形式:生活案例调研 + 理论解读;汇报时长7‑9min;PPT建议10‑14页。

Michelle8023的博客 207

大表 ALTER TABLE 怎么做?NineData OnlineDDL 配置与执行实践

介绍NineData OnlineDDL大表变更实践,涵盖执行策略、切表控制、拷贝批次与可视化进度追踪。

dbasenewbie的博客 295

软件项目交付时,源代码之外还应该交付哪些技术资料?

软件项目交付时,除可运行程序外,还应核对源代码、数据库结构、接口文档、部署运维、测试验收和账号资产。本文从实际交付环节拆解完整资料清单,并说明合同如何约定交付范围、知识产权与维护边界。

chengduyoushu的博客 305

Axum 初步入门学习笔记

)自定义错误实现后,可以直接作为Result的ErrAxum 是一个构建在 Tokio、Tower、Hyper 之上的 Rust Web 框架,核心能力是:Router 路由、Extractor 提取器、Tower 中间件、IntoResponse 响应机制、State 共享状态。那张分层架构图是“地图”不是“说明书”:它帮你建立全局观,但 Service、Repository、数据库、Redis、MQ 都是你自己在 Handler 内部调用的业务/基础设施层,不是 Axum 自带的。

weixin_43219667的博客 177
上一篇: 把推理放进索引:IndexRAG一个让效率翻倍的疯狂想法
下一篇: Qwen3.5 微调指南:Unsloth 实现极速低显存训练
AI_小站
博客等级 码龄3年 6255粉丝 1154原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值