大模型浪潮下的搜广推革命:快手如何重构万亿流量?

视频教程-Ps教程之神奇的Photoshop自动化技术-Photoshop Ps教程之神奇的Photoshop自动化技术 10年以上IT行业工作经验、三... 阅读详情

对于很多普通用户来说,也许 ChatGPT、DeepSeek 这样的大语言模型是他们第一次真切地体会到 AI 的能力。

但实际上,AI 早已渗透得无处不在。在大模型还未出现之前,算法工程师们就已经凭借「搜索、广告、推荐」三驾马车,深刻地影响了每个人获取信息的方式——我们在手机上看什么、买什么,背后都有一套复杂的推荐系统在工作。

这些看似传统的「搜广推」算法,每天都在处理着万亿级流量。可以说,搜广推是所有互联网公司的核心业务,支撑着最为关键的用户留存和营收转化。

然而,在过去很长一段时间里,搜广推的底层架构没有发生根本性变化,甚至陷入了某种瓶颈。

来到大模型时代,一个很直接的想法是:我们如何借助生成式 AI 重塑搜广推业务?但提出想法很简单,落地很难。据我了解,很多团队都在做尝试,但用到生产环境里极少。

最近,快手举办了了一场题为「生成式推荐系统新范式」的技术沙龙,展示他们如何运用生成式 AI 对搜广推系统进行端到端的彻底重构。其中分享的都是一线工程师宝贵的实战经验,而且在快手的生产环境得到了验证,非常有价值,我听完感觉收获很多。
传统级联漏斗的四大瓶颈

要理解生成式 AI 为什么能带来新的范式,首先要明白旧范式的问题在哪里。

传统的推荐系统,普遍采用一种 「级联漏斗」 式的架构,简单来说就是把数据层层过筛子,最终留下展示给用户的信息:
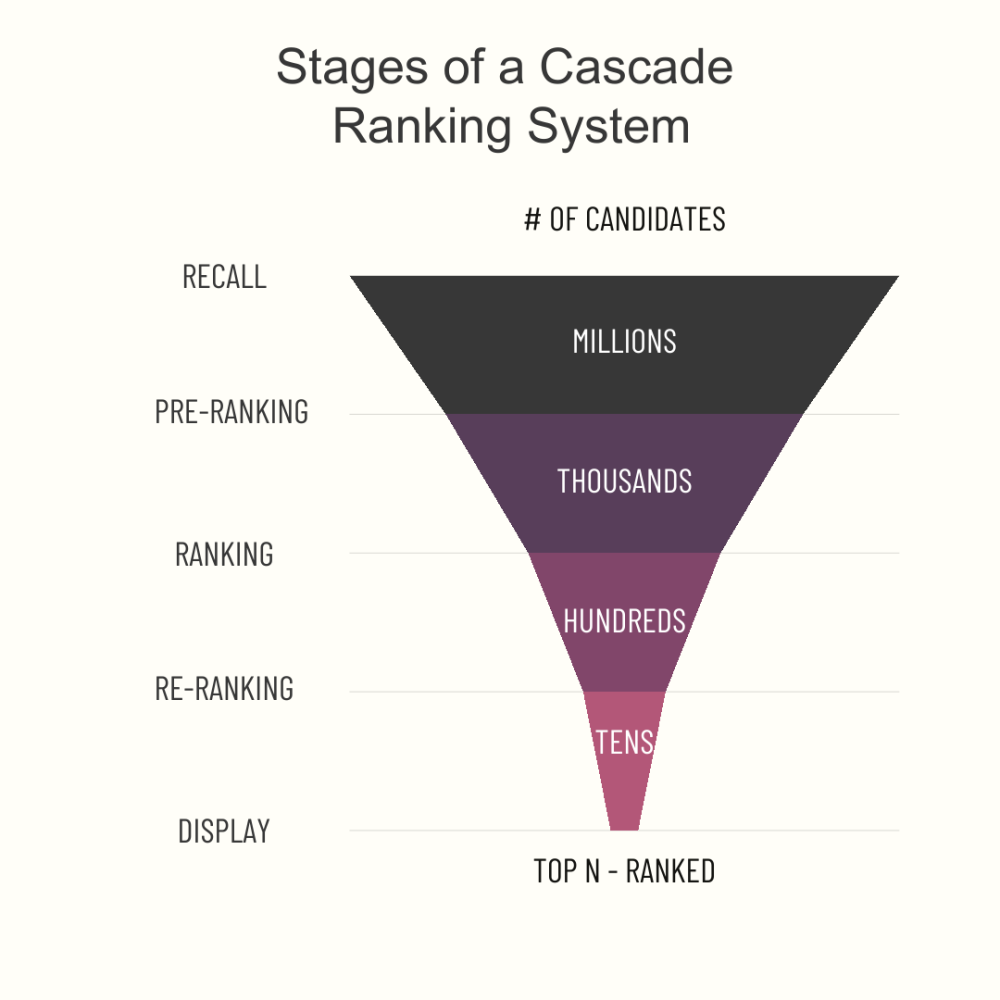
    1. 召回(Recall):从亿万级别的物料库中,快速筛选出几千个可能相关的候选项。
    1. 粗排(Pre-ranking):用一个相对简单的模型,对这几千个候选项进行初步排序,筛选出几百个。
    1. 精排(Ranking):用一个非常复杂的模型,对这几百个候选项进行精准排序。
    1. 重排(Re-ranking):考虑具体的业务规则,对精排结果进行微调,最终呈现给用户。

这是过去十年非常成熟的做法,在实践中也很有效。但放在当前来看,也存在出许多问题:
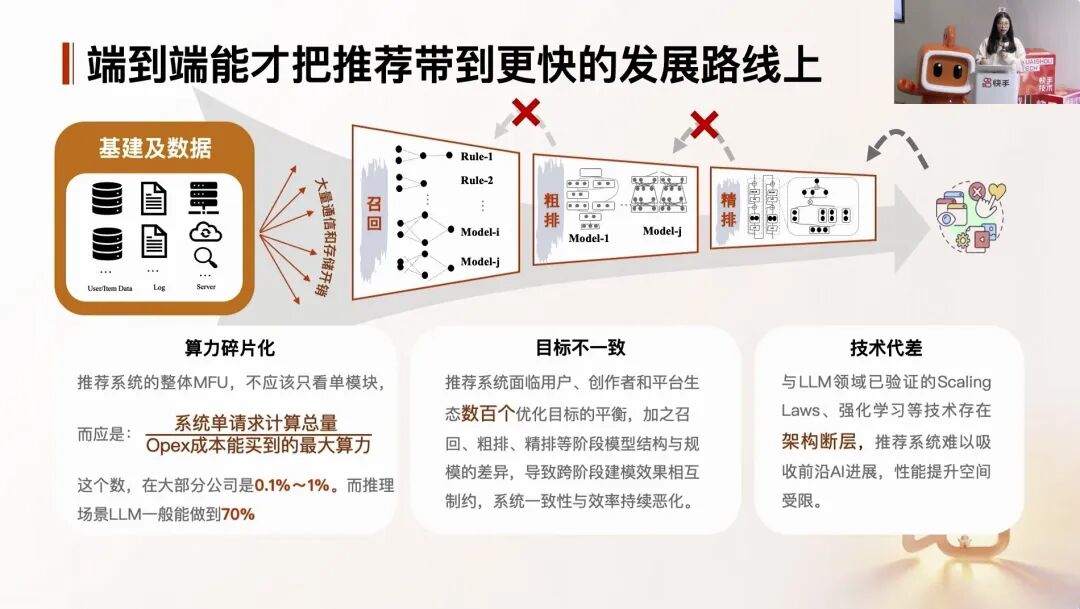
    1. 算力碎片化:推荐链路被拆分成多个模块,每个模块部署着众多小模型。算力被严重分散,导致每个模型能分配到的资源都很少,使得整个系统的硬件利用率极低。比如快手推荐大模型资深算法专家王诗瑶在分享中提到,推荐系统的 MFU(Model FLOPs Utilization,模型浮点运算利用率)甚至不到 1%。
    1. 目标不一致:级联架构的每一层都有自己独立的优化目标。召回模型的目标是「找全」,精排模型的目标是「排准」。各模块各自为政,很容易出现目标冲突,导致全局最优解难以达成。
    1. 误差累积:前一阶段的错误会直接影响后一阶段。如果召回阶段漏掉了一个用户可能喜欢的视频,那么无论后续的排序模型多么强大,也没办法把这个视频捞出来。
    1. 技术迭代难:一些先进的技术范式,比如强化学习,在这种架构下很难应用。强化学习需要环境的实时反馈,但用户的真实反馈发生在最终的曝光阶段。这个信号很难有效地传递回最前端的召回模块。

总之,这套诞生于十年前算力背景下的工程产物,已经限制了推荐系统的进一步发展。快手的判断是:是时候放弃这种结构,转向真正的 端到端(End-to-End) 范式了。

OneRec:从「筛选」到「生成」,用一个模型重构推荐全链路

推荐系统的本质,是预测「用户下一个会感兴趣的内容是什么」。传统方法是「判别式」的,即对每个候选内容打分,然后排序。生成式推荐的做法则完全不同,它试图直接「生成」用户会喜欢的内容。

快手提出的解决方案是 OneRec,一个端到端的生成式推荐系统。它的核心思想是:用一个统一的生成式大模型,将推荐问题转化为一个类似语言模型的 「序列生成」 问题。
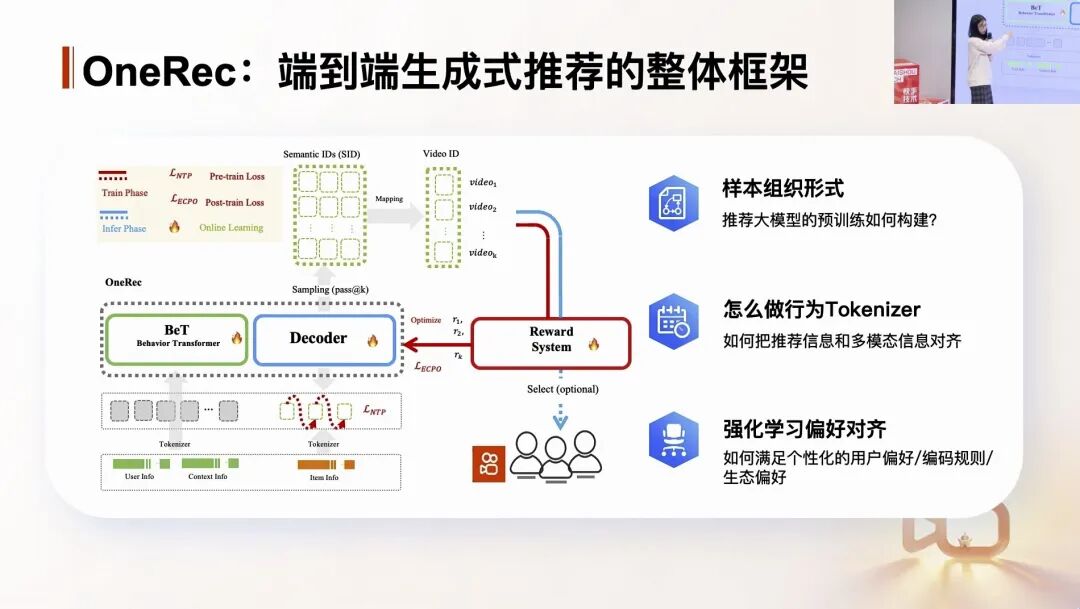
这套系统目前已在快手主站、极速版等多个核心场景全量上线,带来了显著的业务提升。

OneRec 的第一个版本采用 Encoder-Decoder 架构,基本流程如下:

    1. 用一个多模态大模型将每个视频编码成一组语义 ID(Semantic ID,简称 SID),可以理解为视频的「身份证号码」。
    1. Encoder 部分负责理解用户,将用户的历史行为序列进行编码。
    1. Decoder 部分基于用户的编码信息,自回归地(token by token)生成下一个最有可能被喜欢的视频的 SID。
    1. 最后,通过一个 Reward System 对生成结果进行偏好对齐和微调。

OneRec V1 验证了范式可行性,但很快也遇到了瓶颈:模型规模扩展到 3B 参数以上时,性能和效果都上不去了。
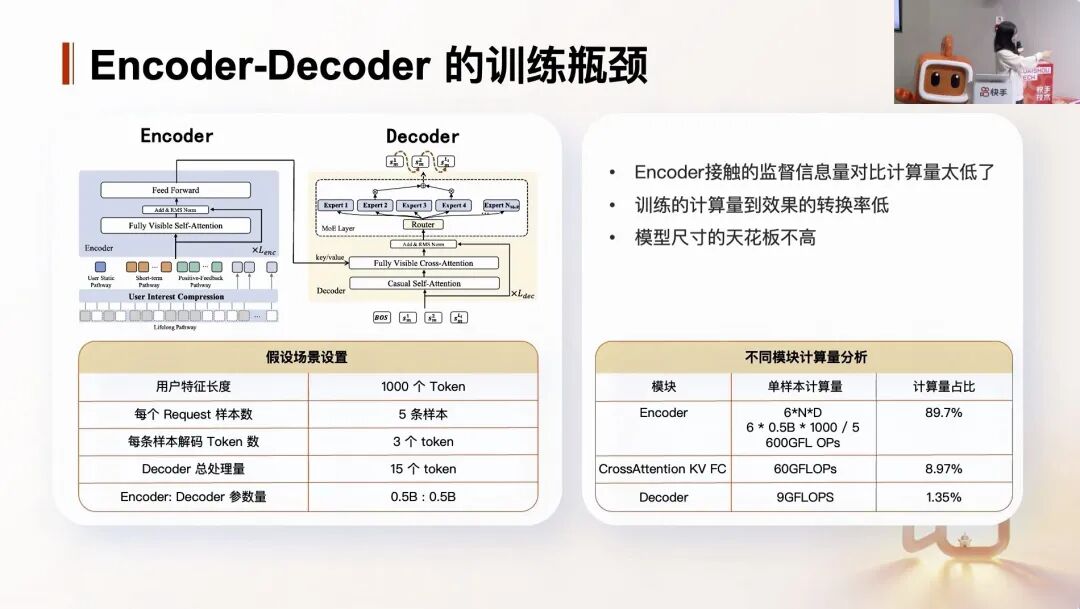
团队复盘后发现,V1 超过 90% 的计算量都消耗在 Encoder 部分(处理用户历史序列),而真正进行决策、接触 Loss 的 Decoder 部分只占了不到 10% 的算力。

王诗瑶打了一个比方:「你准备了一桌满汉全席,最后只吃了一盘拍黄瓜。」这种算力分配不合理,导致投入再多算力,效果提升也十分有限。

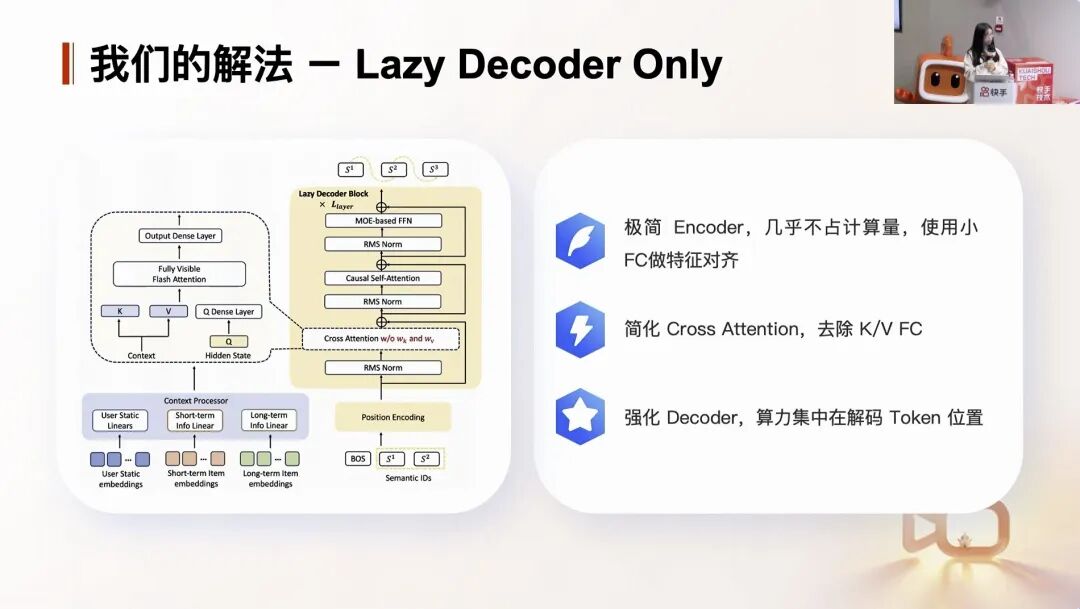
因此,OneRec V2 版本设计了 Lazy Decoder-Only 架构。它将 Encoder 的计算压缩到极致,只保留最基础的特征映射,将几乎所有的计算资源都堆给 Decoder。
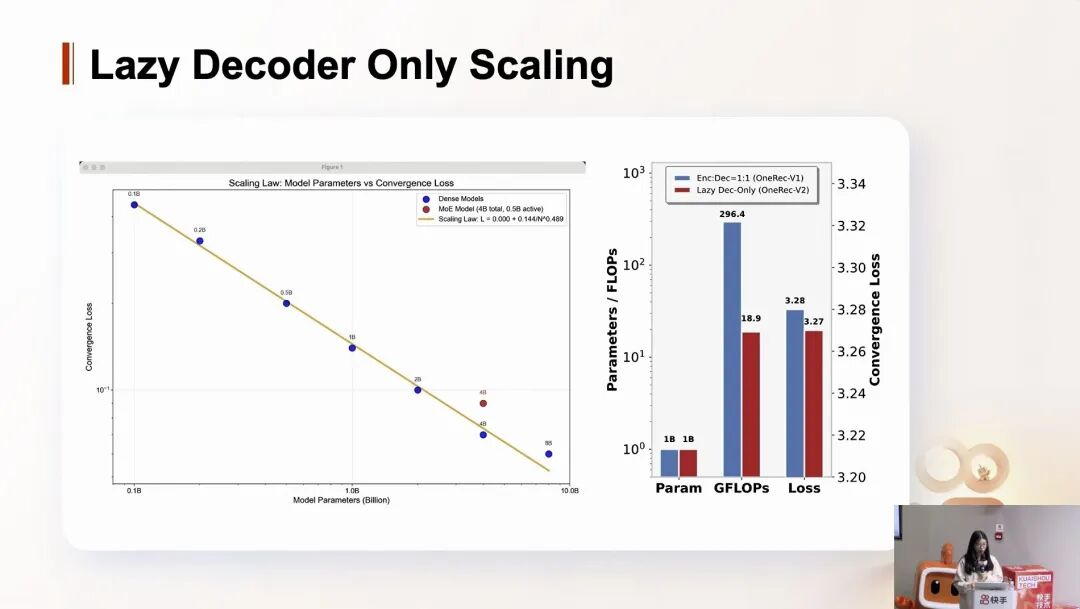
同样参数量的模型,V2 的 FLOPs 只有 V1 的 6%。这意味着,在同等算力预算下,V2 可以训练更大规模的模型。通过这个架构,OneRec 成功将模型从 3B 扩展到了 8B,并且其 Loss 下降曲线完美符合大模型领域的 Scaling Law。
如果说 OneRec V2 解决了效率和扩展性问题,那么最新的 OneRec-Think 则是在探索推荐系统的「智能边界」。它引入了大型语言模型中的 「思维链」 能力,让推荐系统不仅能给出结果,还能解释「为什么」。

OneRec Think 将用户的行为日志和自然语言进行对齐,构造了大量的图文交错样本,让模型学会在一个统一的语义空间里理解这两种模态。
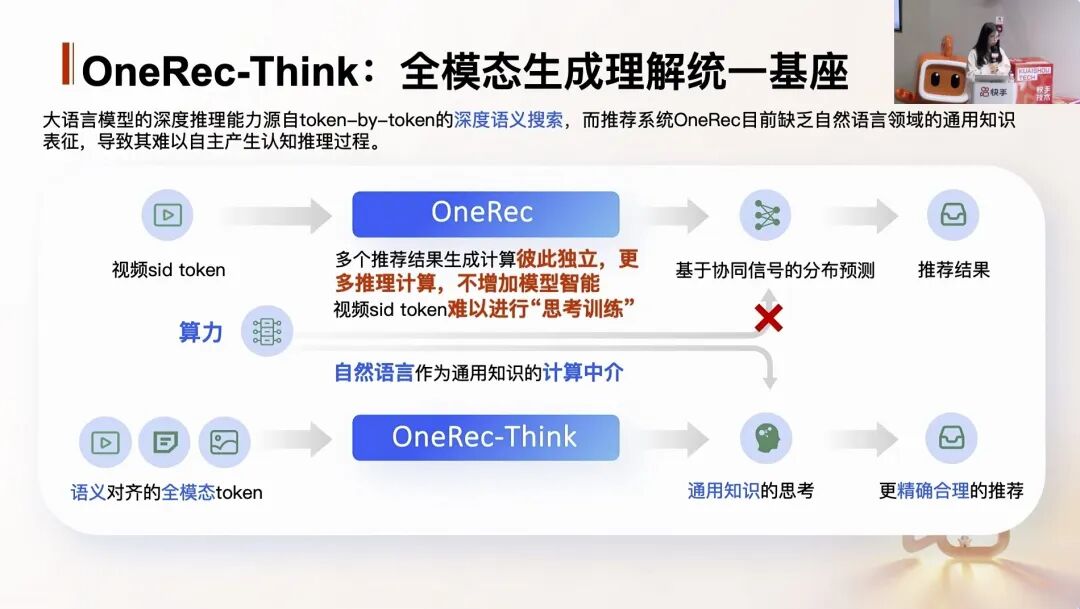
团队还分享了 OneRec Think 的训练方法:

    1. 从用户全量行为中,找出与目标视频最相似的几个历史视频。
    1. 将这些提纯后的视频(包含 SID 和标题)和目标视频一起,喂给第一阶段对齐好的模型,让它生成一个「推荐理由」。
    1. 最后,将「原始行为序列 + 推荐理由 + 目标视频」构造成一条 CoT 样本,对模型进行 SFT 微调。

经过这样训练的模型,在进行推荐时,会先生成一段「思考过程」,分析用户的历史偏好,然后再给出推荐结果。
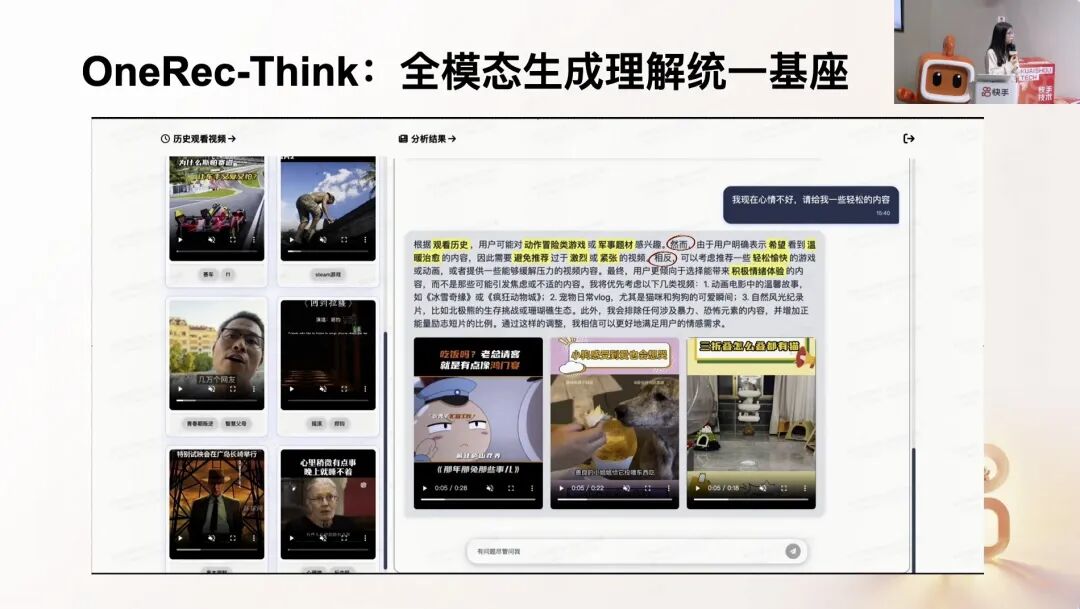
具备思考能力后,OneRec 甚至可以进行交互式推荐,能够更好地理解用户的意图,结合长期偏好动态调整推荐的结果。

OneRec 的演进之路表明,生成式推荐不仅可行,而且正在从一个简单的「生成器」,进化为一个具备规模化扩展能力、甚至拥有初步推理能力的「智能体」。

下一代推荐排序:从「人工规则」到「端到端融合」

在传统推荐漏斗中,精排之后的 「重排」 或 「排序机制」 环节非常依赖算法工程师手写的大量规则和公式,这种方式个性化能力有限,难以处理复杂的目标冲突。
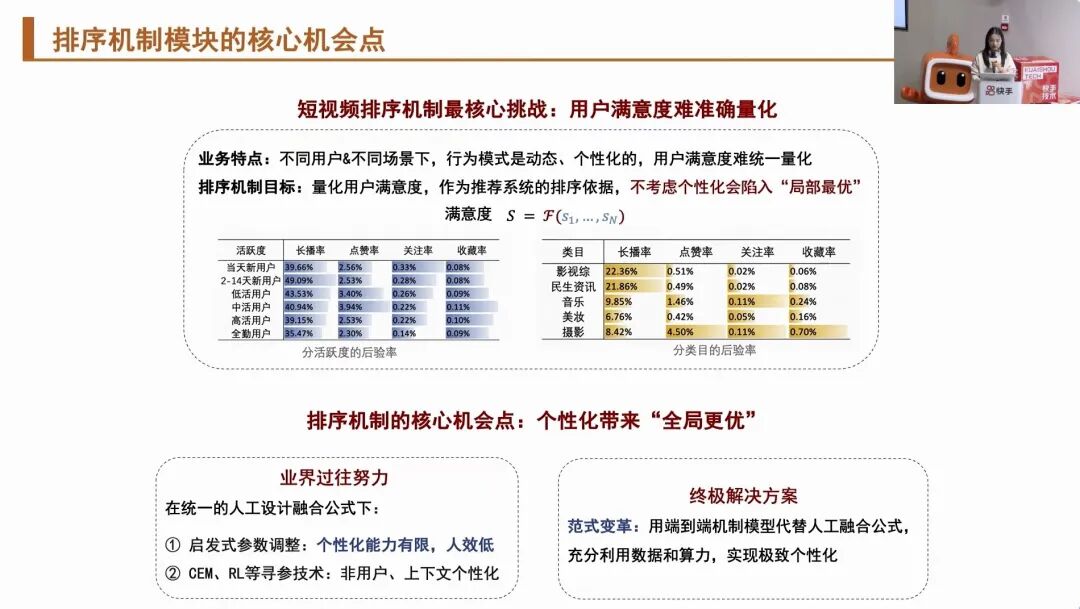
快手短视频推荐算法链路机制策略技术负责人徐晓晓分享了他们如何将这一环节 「模型化」,实现端到端的多目标融合。
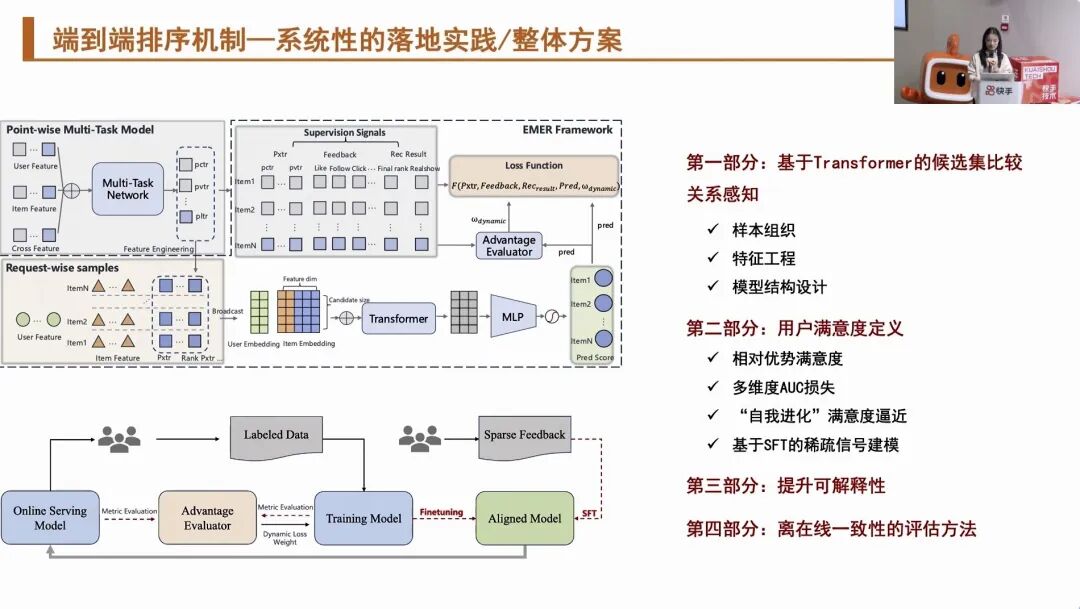
解决方案包括四部分:

    1. 用 Transformer 结构来建模视频之间的相互关系,实现候选集内的比较关系感知。
    1. 通过多种方案,定义用户满意度作为学习目标;
    1. 提升算法可解释性,平衡多个优化目标之间的冲突;
    1. 重新定义优化目标为 「互动效率」,消除混淆因子,解决离在线指标不一致问题。

这个工作将过去依赖人工经验的「调参」环节,变成了一个可数据驱动、自适应优化的模型,是推荐系统走向完全端到端的重要一步。

OneSearch:为电商搜索打造的生成式框架

搜索场景下有明确的用户意图(Query),所以对 「相关性」 要求更高。同时,电商场景的商品标题又充斥着大量为了 SEO 而堆砌的噪声词语。
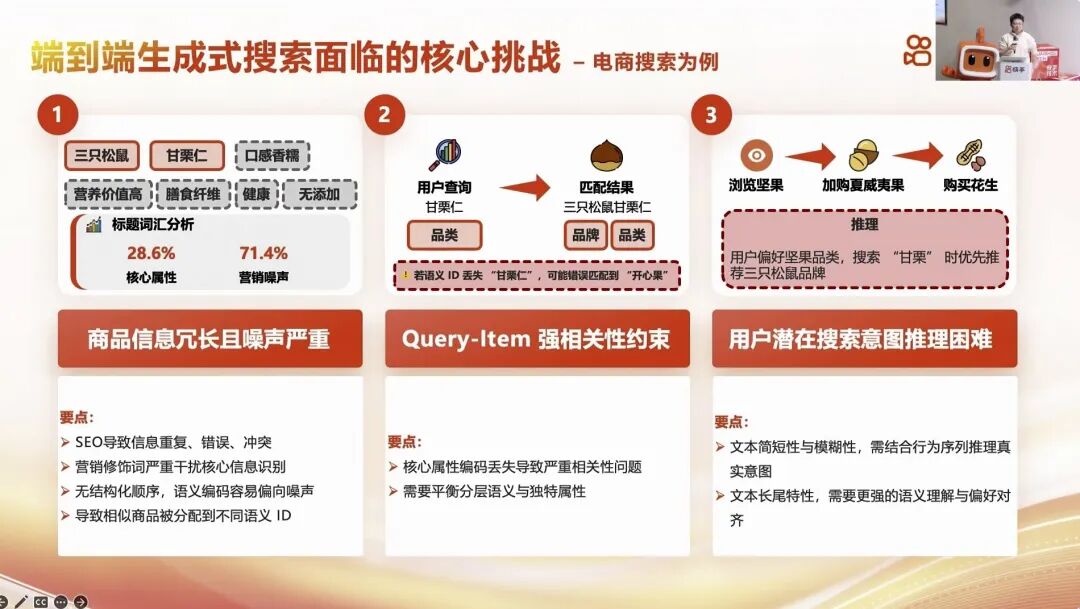
快手货架电商搜索与推荐算法负责人杨一帆分享了他们如何构建业界首个工业级部署的电商搜索端到端生成式框架 OneSearch。
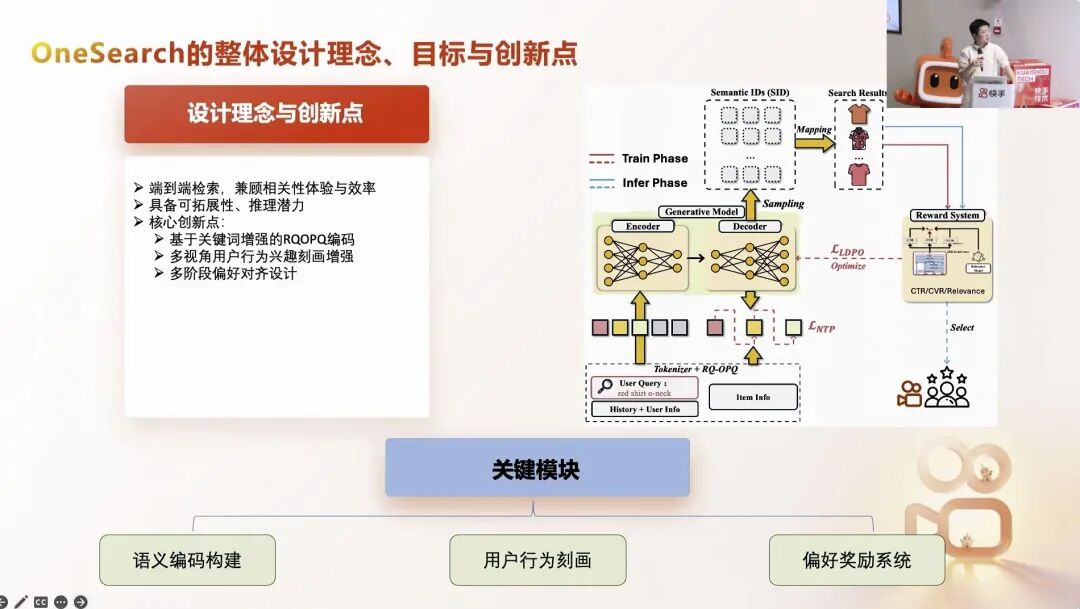
OneSearch 的核心挑战同样在于「编码」,即如何为充满噪声的商品信息,生成一个既能表达核心属性又方便模型生成的高质量 SID。

团队提出了RQ-OPQ 编码,在 RQ-KMeans 之后,用一个平行的 OPQ 编码器专门对残差进行编码,把独立编码率从 68% 提升到了 92% 以上。

这意味着模型能更精确地分辨每一个独立的 SKU,为后续的精准生成奠定了基础。
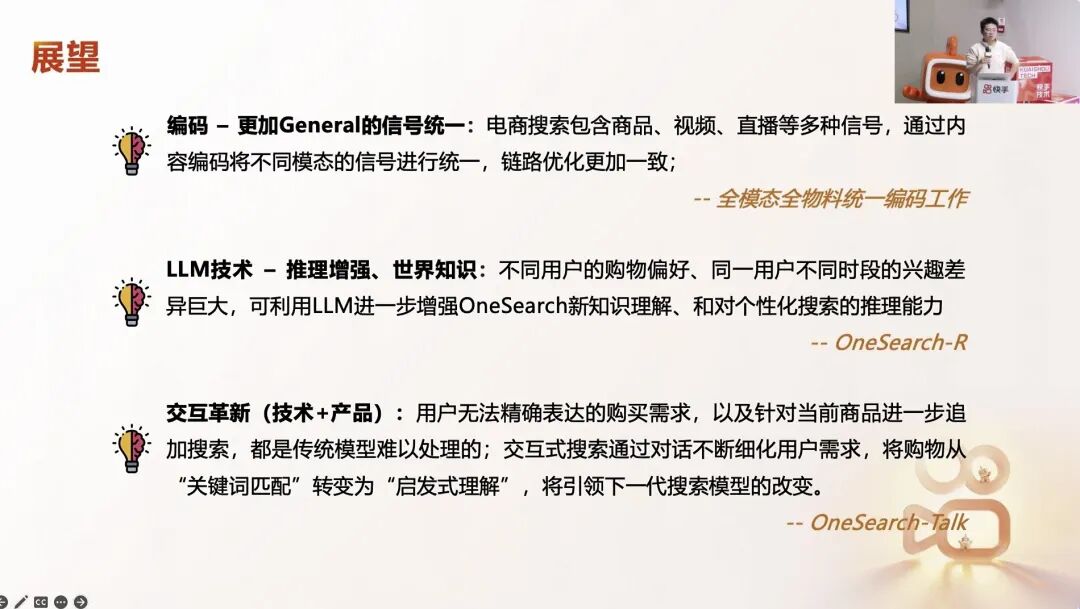
OneSearch 的实践证明,只要把编码这一基础环节进行极致优化,生成式框架完全有能力应对电商搜索这种高难度、强约束的复杂场景。

G4RL:生成模型+强化学习解决出价问题

在投放场景下,广告出价本质上是一个序列决策问题:广告主有一个总预算,系统需要在一天内进行成千上万次竞价,动态调整出价,以在满足成本约束的前提下,最大化转化效果。

快手商业化算法部客户机制中台中心负责人蔡庆芃介绍了他们提出的 G4RL(Generative-model FOR Reinforcement Learning) 范式,将生成模型的序列建模能力与强化学习的价值优化能力相结合。
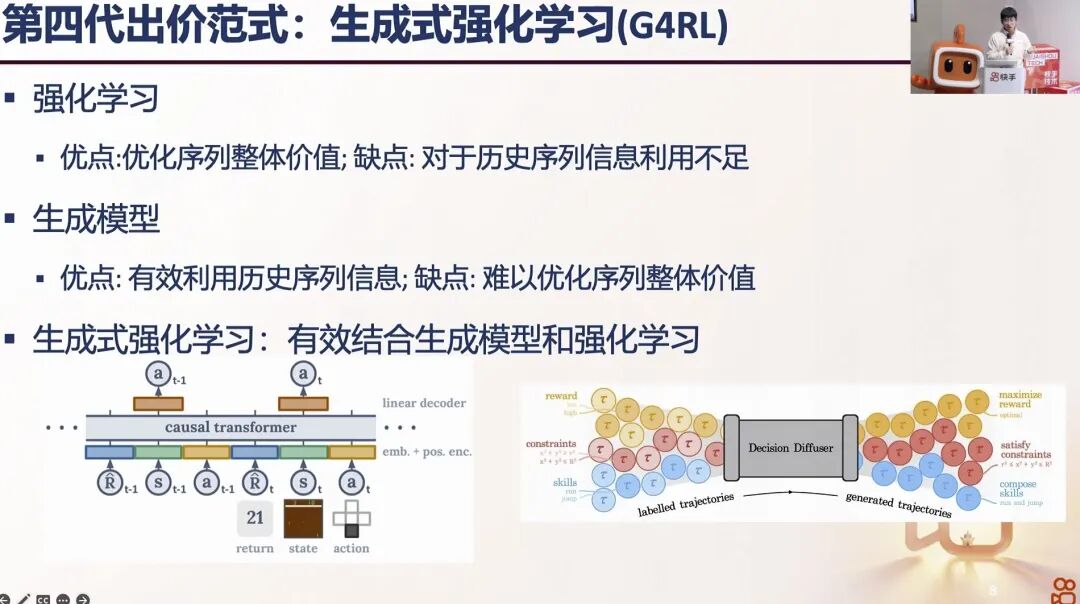
说实话,这块我还真没接触过,不过从团队分享的实际效果上看,G4RL 已经为快手广告收入带来了超过 3% 的提升。

这也再次证明,生成式技术不仅是一种模型结构的变化,更是一种强大的、能够优化长期价值的决策引擎。

生成式搜广推的范式、成本与未来

技术沙龙的最后还有个圆桌环节,里面也有很多信息量很高的观点,我也认真做了笔记。
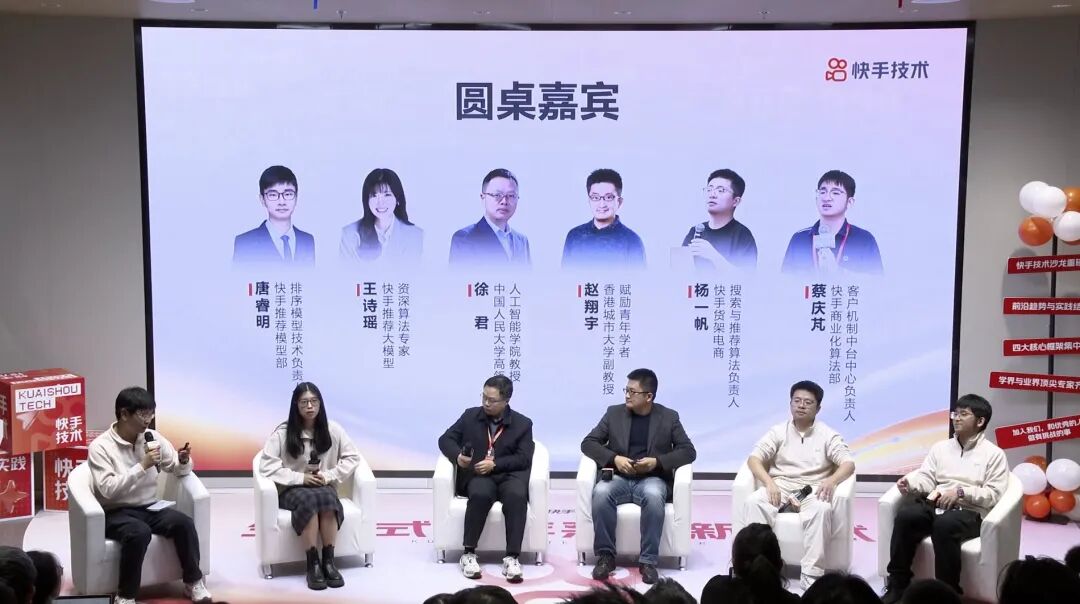
生成式 AI 绝非伪范式,而是一次深刻的技术跃迁

生成式 AI 的新范式将搜广推从传统的「相关性预测」问题,提升到了「用户意图理解与推理」的新高度。

未来的交互形态(如对话式推荐)必然需要生成式 AI 的能力。端到端的框架,为强化学习(RL)这类先进技术在业务中的应用创造了必要条件,使得优化全局、长期价值成为可能。

无需过度焦虑成本,技术突破带来的价值远超投入

大模型意味着更高的算力成本,是否会成为落地的阻碍?

技术专家认为,硬件成本在摩尔定律下持续下降,而新范式带来的商业价值是持续增长的。而且,工业界有大量手段可以用于优化 ROI。

比如,通过分析模型的 Scaling Law 找到最佳性价比的尺寸,或使用模型蒸馏等技术,在不显著损失效果的前提下降低推理成本。广告出价等场景的 ROI 尤其高,一次性的技术投入可以带来持续的收入增长。

搜广推的未来将有无限可能

随着生成式 AI 的发展,未来搜广推的界限将彻底模糊,演化为无处不在的 「个人信息助理」,交互方式将不再是单向的「信息流列表」,而是直接满足用户需求的智能体。

未来的推荐系统可能不再是从内容库里挑选,而是直接为用户生成他想看的内容。

Agent 的能力也将全面应用于广告等领域,为广告主提供从素材生成到投放优化的全流程自动化服务。

结语

回到最初的问题:生成式 AI 是搜广推的未来,还是昙花一现的伪范式?

听完快手技术团队的正常分享后,我觉得答案已经很清晰了:生成式 AI 让搜广推从「筛选信息」走向「理解意图并直接生成答案」,这显然是颠覆性的范式转变。

这种新范式最大的价值,在于它真正打通了算力、算法和业务目标,为系统注入了规模化扩展(Scaling)和推理(Reasoning)的能力,让搜广推第一次有了进化出「智能」的可能。

快手展示的 OneRec、OneSearch 和 G4RL,已经不再是传统级联漏斗上的工程优化,而是用一个统一的、端到端的生成式框架,对推荐、搜索、广告进行系统性的重构。

这些都是来自生产一线的宝贵分享,推荐大家多多了解相关的工作进展,一定会对大模型落地业务有新的思考和帮助。

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇

​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书

在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:


三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

图解电动汽车:电动汽车主要参数 动力性指标 汽车的动力性指标主要有最高车速、加速时间、最大爬坡等,体现了汽车在行驶过程中能达到的极限运动水平。对于电动汽车,其动力性由搭载的驱动电动机决定,主要的参数包括最大扭矩、额定功率、最大功率、最大转速等。 功率是指物体在单位时间内所做的功的多少,是描述做功快慢的物理量,单位是 kW。 扭矩是指机械元件转动的力矩,也称转矩,表示转动力量的大小,单位是 N·m。 转速是指发动机/电动机的转速,的单位是 rpm,即转每分钟。额定转速是指在额定功率下电动机的转速,最大转速则是在最大功率下电动机的转速。 阅读详情

相关推荐

Matlab激活失败?手把手教你解决License checkout failed问题(附详细截图)

本文针对Matlab激活后出现“License checkout failed”错误的常见问题,提供了详细的解决方案。核心在于精准定位并正确填写Windows系统用户名,而非计算机名或账户全名。文章通过分步截图和命令指引,手把手教你使用`whoami`命令获取正确信息,并重新运行激活程序,从根本上解决因用户名填写错误导致的许可检查失败问题。

weixin_29062823的博客 581

智能推荐新纪元:快手生成式技术对系统边界的消融与重建

老周这次受邀作为嘉宾参加了AICon全球人工智能开发与应用大会,本文将基于快手科技副总裁、基础大模型及推荐模型负责人周国睿老师在AICon大会的演讲内容,基于我自己的思考总结分享给大家。

riemann_的博客 1388

STM32H7+LAN8720A之ETH与LWIP配置问题(End)

开篇介绍 由于项目中需要使用到STM32H7系列的芯片,且该系列无法移植ST的标准库,只能使用ST的HAL库,通过STM32Cube生成HAL库的基本代码。在项目开发中需要使用到STM32板载的ETH口,在简化的四层模型中充当着数据链路层的角色,我们只需添加PHY并配置好IP,即可实现基本的TCP主从机通信、UDP通信等等。 一、激光雷达3i-T1 由于使用了一款只具有网口通信的单线激光雷达,其具有TCP和UDP方式的通信方式,为了避免进行TCP中的socket报文解析和繁琐的通信握手过程,我们首先将雷达配

weixin_42024702的博客 1万+

ONEREC-THINK

OneRec-Think,一个将对话、推理与个性化推荐无缝融合的统一框架。OneRec 严重缺乏显式且可控的推理能力为什么生成式模型需要具有推理能力?生成与用户复杂目标不一致的结果难以解释为何推荐某个物品无法处理用户的复杂、多跳、多因素偏好推理是让模型在开放生成空间中“自我约束”的关键。

2301_79601111的博客 1260

软考29-上午题-【数据结构】-排序

数据结构7种排序

qq_31532983的博客 1580

【FPGA教程案例37】通信案例7——基于FPGA的FFT,IFFT傅里叶变换和逆变换

关于FFT和IFFT的相关描述,在上一课程我们已经有所了解,本课程不再重复。在上一课程,我们初步掌握了如何通过FFT对输入信号进行频谱分析,在本课程,我们将学习如何通过FPGA实现FFT和IFFT得到初始信号的过程。关于FFT的IP核配置,和上一课程相同。下面直接介绍其verilog调用过程。我们可以看到,IFFT的配置非常简单,在FFT的基础上,只需要将该参数的最后一位改为0,就可以实现IFFT变化。下面我们通过testbench文件,同时调用FFT和IFFT实现信号的傅里叶变换和逆变换。......

FPGA/MATLAB学习教程/源码/项目合作开发 4518

【大模型推荐系统】快手OneRec-Think 提升+0.76%转发量

快手OneRec-Think,利用大模型发掘用户兴趣,提升+0.76%转发量

weixin_37763484的博客 1506

Qt C++ + Qt 3D 的数字孪生工厂

以下是一个基于 **Qt C++ + Qt 3D** 的数字孪生工厂完整源码示例,集成了 **Qt 3D** 产线建模和 **WebSocket** 实时数据交互。ui->qualifiedProductsLabel->setText(QString("合格产品: %1").arg(data.qualifiedProducts));ui->totalProductsLabel->setText(QString("总产量: %1").arg(data.totalProducts));

寒寒豆豆软件公司的博客 149

End-To-End之于推荐-快手OneRec系列三(OneRec-Think)

快手OneRec系列引入大语言模型推理能力,通过COT(Chain of Thought)技术提升推荐效果。该框架包含三个核心模块:Itemic Alignment使LLM理解Item语义;Reasoning Activation让模型先思考再推荐;Reasoning Enhancement捕获用户偏好多样性。实验使用1.29%流量测试,APP停留时长提升0.159%。关键技术包括多任务预训练实现ID与文本对齐、基于上下文的推理激活等,使推荐系统具备可解释性。该方法将推荐从黑盒预测转变为可推理过程,在保持大

清风徐来 1357

基于V7-690T FPGA纯逻辑实现NVMe SSD盘的读写(不使用软核)

a.NVMe的Admin CQ与Admin SQ命令放在Host内存中;因此SQ的64B要用FPGA的DDR或开一个bram空间存放,同理NVME写到HOST的CQ命令也需要存放在FPGA的DDR或一个bram空间,host收到NVME传来的MSI/MSI-X中断后,去CQ存放空间取CQ指令;b. 发送identify命令后,需要发送tial doorbell通知NVME;(发送CNS01h获取4096字节的固件信息等;发送CNS02h获取1024字节的namaspace list)

宝沐熙的博客 836

把 ABAP 选择屏幕 Selection Screen 打造成可维护的交互面板:常用屏幕元素与动态控制全解析

本文详细介绍了ABAP报表中Selection Screen的设计技巧,包括空行(SKIP)、横线(ULINE)、注释(COMMENT)等基础元素的使用方法,以及如何通过MODIF ID实现动态界面调整。重点讲解了行内布局(BEGIN OF LINE)、按钮(PUSHBUTTON)和区块(BLOCK)等高级功能,帮助开发者将选择屏幕从"能用"提升到"好用、易扩展、可维护"的水平。文章还分享了项目实践中的命名规范和分组策略,特别适合需要优化ABAP报表用户体验的开发人员

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 333

【推荐系统】快手OneSearch 提升3.2%订单量

结合用户行为的文本特征,商品CTR提升1.67%、订单量提升3.22%、买家数提升2.40%

weixin_37763484的博客 1万+

ComfyUI整合包V8中文版最新版介绍

和普通AI绘图网页不同,它把图像生成的每一个步骤拆分成一个个"节点",用连线把它们串起来,形成工作流。里面包含ComfyUI内核、Python运行环境、常用插件、部分预置模型,还有一个叫"绘世启动器"的图形界面管理工具。网上的对比数据显示,WebUI最低需要4G显存,ComfyUI最低3G显存就能运行。可以在里面管理插件、切换模型路径、设置显存模式、查看日志报错,还有"疑难解答"功能,遇到报错可以先扫描一下看是不是已知问题。原版ComfyUI的界面是英文的,右键菜单、节点名称全是英文。

欢迎来到鸾姝淡月博客,专为程序员和编程爱好者打造的技术博客。我们分享编程语言趋势、开发工具、编程哲学、职业发展等,助你掌握新技术,优化技能,激发编程热情。 5231

盘点下2024年工业界大模型在搜广推上的实战落地型工作

从传统sequential recommender问题出发,探讨GRs如何改造传统建模范式。传统的序列推荐,通常只使用用户交互过的正样本item来构造序列。这里面包含两层含义,仅使用itemID来表征item、仅使用正反馈来构造序列。前者会忽略item的各类category语义信息、后者无法捕捉一些真实后验行为(如ctr)。GR通过两方面来分别解决这两个问题。a. 通过引入辅助信息并合并到主序列实现对稀疏类别特征的建模。

大模型工程师老蓝的博客 1793

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

从一到无穷大 #108:Meta 的 AI 存储架构——BLOB 重构与跨地域数据加载

在 Meta 的旧 BLOB 服务里,数据已经放到闪存上,一次请求中的多层元数据查询仍可能耗费数百毫秒,部分请求还要跨地域。底层介质变快以后,上层存储服务的查找和转发开销开始直接影响 GPU 利用率。[1]另一种等待发生在训练之前。GPU 分散在不同地域,研究者要先找到有算力的地方,再把训练数据搬过去。一次小规模实验也可能先花几个小时导入数据,调整数据后再等一轮。Meta 保留了底层 Tectonic,改造了它上面的 BLOB 访问路径。

李兆龙的博客 502

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

PHP 源码仓库速查手册:从“能跑”到“能协作”的五个重构动作

你的 PHP 代码本地能跑,一进多人仓库就互相踩踏?😵 这份手册用五段式拆解,带你完成从输入收敛、预处理查询到目录分层的五个重构动作,附可复制模板和提交前检查清单。30 秒定位问题,让代码从“能跑”升级到“能协作”,面试官追问作品集时你也不心虚。💪

2601_94912102的博客 301

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

CPO重构光互联,传统可插拔光模块厂商重新定位产业分工

AI集群网络功耗制约数据中心发展,推动光互联技术加速演进。CPO通过将光引擎集成至芯片旁,大幅降低电路径功耗,单比特功耗可降至6pJ/bit。尽管形态变化,光引擎功能未消失,仍由光模块厂主导供应,产品转向NPO与CPO。平台主导权上移至芯片厂商,认证周期长、黏性强,价值量向硅光、激光器等上游器件集中。2027年起订单放量,关键瓶颈在光器件产能与良率,客户认证与外置光源量产成产业化核心指标。

张星河的博客 485

重构 ArkUI 渲染管线,鸿蒙复杂列表嵌套与局部刷新优化

上个月做电商大促的会场页面,因为场景极度复杂(包含轮播、楼层导航、瀑布流商品卡),测试同学跑过来直接骂街:“这页面滑起来像在放幻灯片,稍微滑快一点直接白块,甚至闪退!当组件池里存在可用实例时,框架会直接把它拿出来,调用这个方法更新数据,然后直接上屏。用 Profiler 再次测试,布局计算的耗时直接下降了 70%,滑动时那种生涩感瞬间消失了。拦截重复创建,保住节点结构的稳定性,最后配上正确的唯一 Key。一旦组件树的层级过深,每一次滑动触发的重新测量,都会让 CPU 陷入无休止的数学计算中。

2502_91284977的博客 211

【字节拥抱开源】Cola2:用连续隐变量重构语言模型,346B Token 跑出 60.10 八任务均分

Cola2 是一款基于连续隐变量的自适应语言模型,通过动态语义压缩与块因果扩散 Transformer(DiT)实现高效生成。它在346.03B token上训练,八项评测平均得分60.10,性能超越部分更大规模模型。其核心创新在于联合优化隐变量压缩与离散解码,支持受控扩展与稳定推理。项目提供完整权重、工具链及评测数据,适用于研究与应用。

weixin_41446370的博客 322

视觉Transformer的“第二次革命”:ViT³如何用测试时训练重构注意力范式

ViT³提出视觉Transformer的“第二次革命”,通过测试时训练(TTT)重构注意力范式,以线性复杂度实现高精度建模。其核心思想是将注意力视为用上下文构建内部模型,而非简单加权求和。研究总结六条设计原则,如采用MSE损失、全Batch单轮训练、卷积内部结构等,构建纯TTT架构,在1248×1248图像上显存降低90.3%,速度提升4.6倍,性能超越线性注意力与Mamba,推动高效高分辨率视觉计算发展。

weixin_46846685的博客 360

序位顺序归位:人机互助时代跨文化研究的基础重构 --融智学视域下的三智双融框架

本文提出融智学序位本体论,重构跨文化研究范式,主张从“内容搬运”转向“序位对齐”。针对大模型“流利但失序”的困境,构建三智双融框架:哲学智慧立道、人类智力悟序、人工智能执行,通过孪生图灵机实现P侧与Z侧联动审计,以道偏差函数量化文化序位偏离。案例验证表明,该框架可有效诊断并修复文化符号在人机互助时代中的序位错位,推动跨文化研究迈向“顺序归位”的新阶段。

geneculture的专栏 170

在线重构,实时同步:视频动态三维重建打造 “常更常新” 的数字底座

方案采用异构架构,兼容不同品牌、不同协议的视频采集设备,同时接入传感器、门禁、巡检、报警、PLC等多类业务数据,完成视频融合与数字融合。厂区改扩建、设备移位、管线调整、现场临时作业场景变化,数字模型很难同步更新,久而久之,数字场景和真实现场脱节,数字孪生慢慢变成“一次性沙盘”,难以支撑常态化安全管控、巡检、应急指挥等业务。当现场发生变动,比如新增设备、管线改造、物料堆放变化、临时作业区域调整,系统可以依托持续传入的视频信号,自动完成局部区域的动态重建,迭代更新三维场景,不需要再次组织测绘、二次建模。

238

Gemini批量导出没有PDF模式?AI导出鸭用“格式网关”重构文档流转逻辑

AI导出鸭重构AI对话内容导出逻辑,突破浏览器"打印为PDF"的局限性。其核心技术在于建立语义映射编译管线,而非简单截屏:通过DOM抓取获取结构化数据,将LaTeX公式、Mermaid图表等编译为PDF原生对象,实现文字可编辑、体积缩减60%的效果。批量导出采用双线程设计,支持失败自动重试和格式预检,解决内存溢出和界面卡顿问题。实测显示,相比浏览器打印方案,其生成的PDF保持跨设备版式一致,完美保留代码高亮、数学公式和复杂表格结构。该工具现已支持Gemini、DeepSeek等主流AI平台,实现从对话到专业

rteertreerte的博客 460

数据中心PUE优化:从1.5到1.2的工程路径——基于制冷重构与供配电深度改造的落地实践

本文提出从1.5降至1.2以下PUE的系统性路径:通过间接蒸发冷却与EC风机变频改造,将制冷负载系数(CLF)由0.38压至0.12;结合高压直流供电、智能小母线及变压器智能投切,使供配电损耗因子(PLF)从0.12降至0.07。实证显示,该组合方案可实现PUE≈1.21~1.26,投资回收期3-4年,具备强可复制性,适用于存量风冷数据中心能效升级。

2601_96690100的博客 321

Flutter学习day13--Provider实战重构套路

写 Flutter 的头几周,setState几乎能解决所有问题:数据变了,调一下,界面就刷新了。这些问题有一个共同的名字——。Provider 就是 Flutter 官方推荐的基础状态管理方案,它不引入复杂的响应式系统,只是把「状态」从组件树里拎出来,放在一个所有组件都能访问的位置,并用的机制精确通知依赖它的组件。。

qq_63223749的博客 336

跨境出海:AI 选购如何重构外贸获客路径

海外 B2C 消费者的决策路径,正越来越多地被 AI 选购(AI-assisted Shopping)接管。本文用一个跨境女装案例拆解 GEO 在外贸获客中的落地方式:如何围绕消费者真实问题组织信息、让品牌在 AI 答案中被准确呈现,并建立可归因的复盘闭环。

2601_96888293的博客 190
上一篇: 大模型时代,如何打造专为 AI Agent 服务的搜索引擎?
下一篇: Agentic AI实践指南|秘籍一:Agent开发与落地
AI_小站
博客等级 码龄3年 6255粉丝 1154原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值