地表最简洁!3分钟彻底搞懂LLM注意力机制

Mythos门控释放:大模型能力即服务的工程实践 大模型能力正从静态性能指标转向动态可配置的服务范式。‘能力即服务’(Capability-as-a-Service)强调将推理深度、知识时效、跨模态映射等核心能力封装为可审计、可策略化、可硬件级管控的数字资产,而非简单发布模型权重。其技术基础涵盖因果注意力机制、动态知识图谱编织与多模态概念锚定,价值在于满足AI安全合规刚性要求的同时,支撑医疗诊断推演、金融穿透式风控、科研假说生成等高置信度垂直场景。Mythos作为典型代表,通过硬件熔丝、运行时策略引擎与契约化API三层门控,实现能力的精确释放与全生命周期治 阅读详情

如果你听说过 ChatGPT 或大模型(LLM),那你一定听说过 Transformer 架构。而 Transformer 的心脏,就是大名鼎鼎的 Attention(注意力)机制。

甚至有一篇改变 AI 历史的论文题目就叫《Attention Is All You Need》(你只需要注意力)。

但“注意力”到底是个什么鬼?为什么它是让机器读懂人类语言的关键?今天,我们不堆砌复杂的公式,用地表最简洁的方式,带你 3 分钟彻底搞懂它!🚀


  1. 什么是注意力?(从直觉开始)

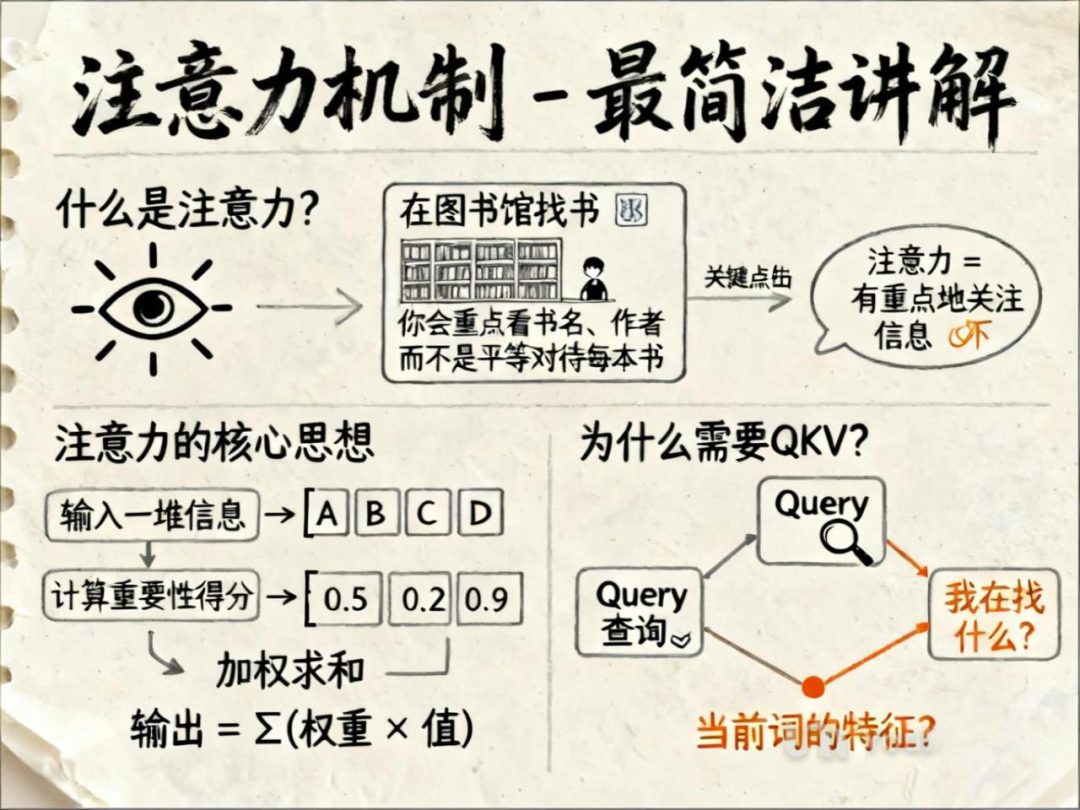
想象一下,你正在图书馆里找一本关于“Python编程”的书。📚

面对浩如烟海的书架,你会怎么做?

  1. 你会平等地把每一本书都拿下来仔细读一遍吗?显然不会。
  2. 你会快速扫描书脊,寻找“Python”、“编程”、“代码”这些关键词。
  3. 当你发现一本相关的书,你会投入更多关注;而对于旁边的“烹饪指南”,你会直接忽略。

这就是注意力机制的核心直觉:在处理大量信息时,不是平等对待每一个部分,而是有重点地关注对当前任务最关键的信息。

在数学上,这被称为**“加权求和”**。有些信息权重高(关注度 0.9),有些权重低(关注度 0.01)。
  1. 为什么需要 Q、K、V?(购物的比喻)

在 Attention 的公式里,你总会看到三个字母:Q、K、V。这往往是劝退新手的门槛。

其实,用一个淘宝购物的例子就能秒懂:

  • Q (Query) = 你的购物需求 🔍
  • 比如你在搜索框输入:“透气 跑步鞋”。这是你在找的东西。
  • K (Key) = 商品的标签/标题 🏷️
  • 淘宝后台有无数商品,每个商品都有标签:“耐克/透气/跑鞋”、“高跟/红色/真皮”。
  • V (Value) = 商品本身 📦
  • 这是你最终买回家的东西(实物)。

注意力计算的过程,就是一次完美的购物匹配:

  1. 匹配 (Match):拿你的 Q(需求)去和所有商品的 K(标签)做对比。
  • “透气跑步鞋” vs “高跟鞋” 匹配度低(0分)
  • “透气跑步鞋” vs “专业跑鞋” 匹配度高(90分)
  1. 计算权重 (Softmax):把匹配分数转化成概率(权重)。
  • 90分 0.9 的关注度
  • 0分 0.0 的关注度
  1. 提取结果 (Weighted Sum):根据权重把 V(商品内容)拿出来。
  • 最终你得到的信息,主要就是那双你最想要的跑鞋。

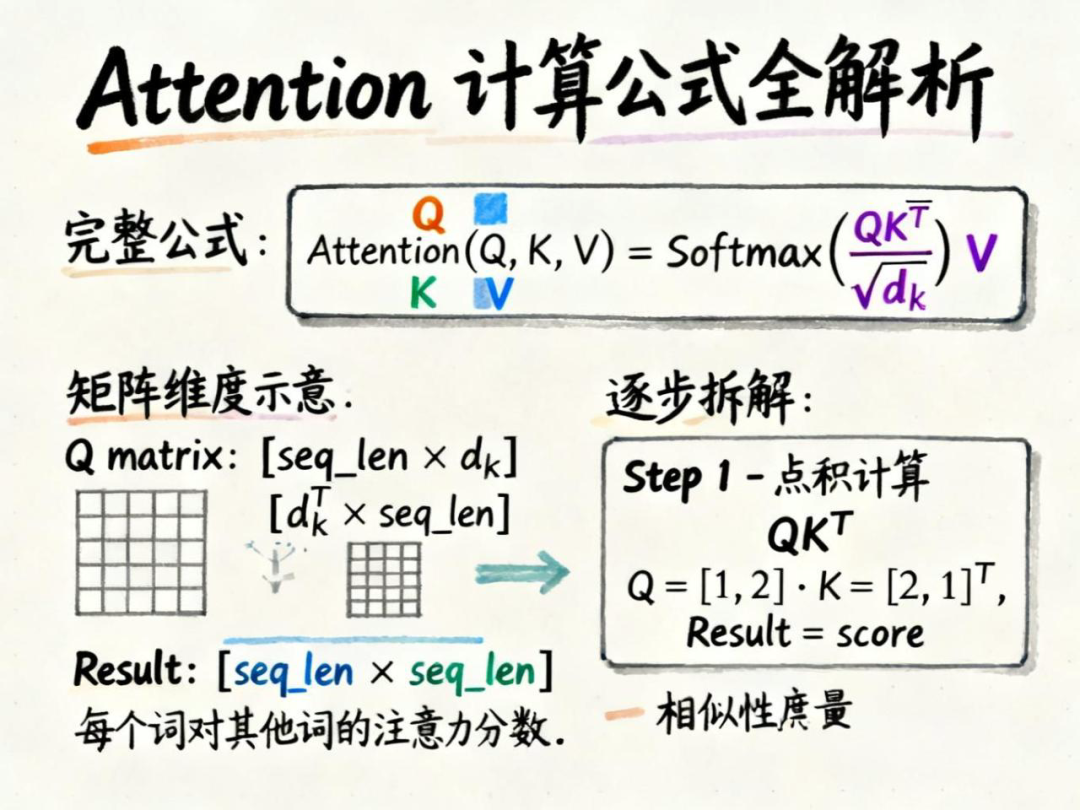
数学公式虽然看起来吓人:

但它的本质就是三步走:

  1. QK相乘:算相似度(打分)。
  2. Softmax:归一化(变成百分比)。
  3. 乘V:根据百分比提取信息(加权打包)。

  1. 实战演练:猫坐在垫子上

知道了原理,我们来看一个经典的句子,看看大模型在处理它时发生了什么。

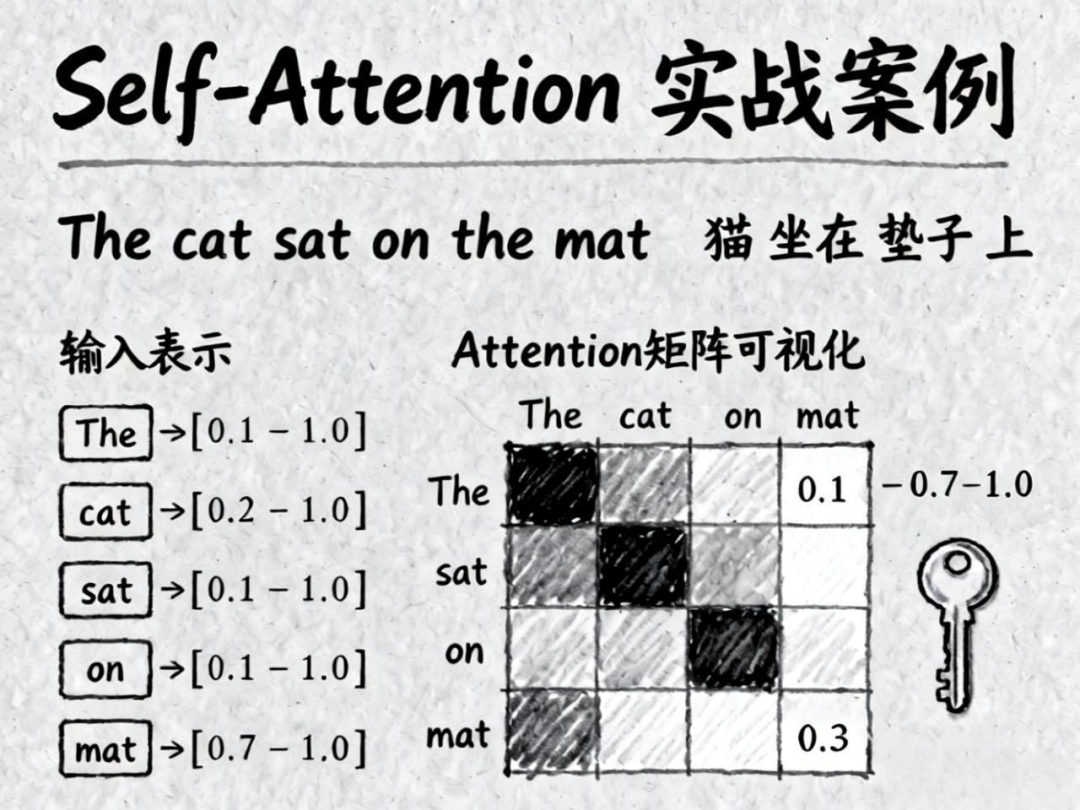
句子:“The cat sat on the mat”(猫坐在垫子上)。

当我们想理解 “sat”(坐) 这个词时,Attention 机制会怎么做?它是Self-Attention(自注意力),意味着它会去询问句子里的每一个词。

  • Q: 我是 “sat”(动作),我想知道是谁做的?在哪做的?
  • K: 句子里所有词的特征。

计算结果(注意力分布):

  • “The”: 关注度 0.1(不太重要)
  • “cat”: 关注度 0.7(非常重要!因为是猫坐的)
  • “sat”: 关注度 0.1(自己)
  • “on”: 关注度 0.05(介词)
  • “mat”: 关注度 0.6(重要!因为是坐在垫子上)

通过这种机制,“sat” 这个词的向量表示,就不再仅仅是一个孤立的“坐”字,而是融合了“猫”和“垫子”信息的**“猫-坐-在-垫子上”**的丰富向量。

这就是为什么大模型能理解上下文,能读懂指代关系(比如知道“它”指的是前面的“猫”),能像人一样“思考”。


💡 总结一下

  1. Attention 的本质:是加权求和。不再胡子眉毛一把抓,而是给重要的信息高权重。
  2. QKV 的含义:就像搜索(Query)匹配标签(Key),最后获取内容(Value)。
  3. Self-Attention:让句子里的每个词都能“看见”其他词,从而理解复杂的上下文关系。

这就是 Attention 机制的全部秘密!看似简单的数学操作,却支撑起了如今 ChatGPT 惊人的智能表现。是不是比想象中简单多了?✨

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇
​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书
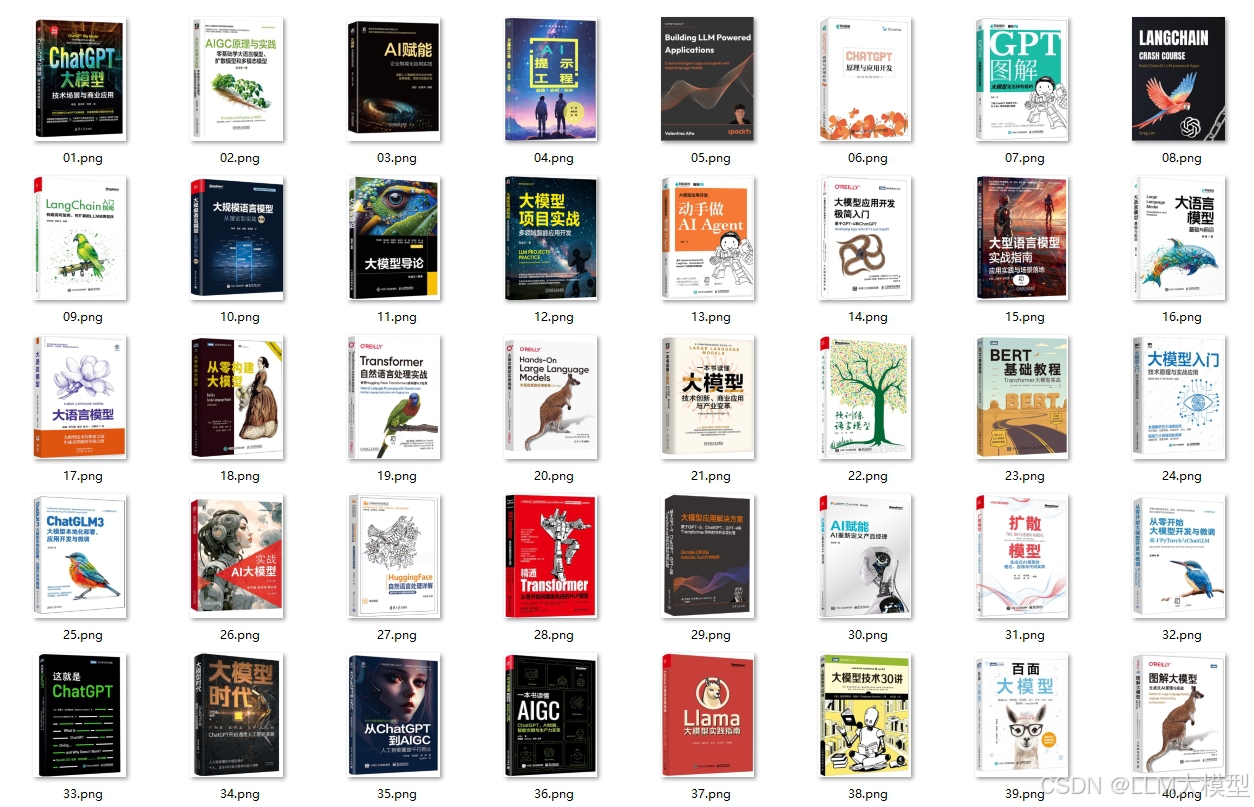
在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:
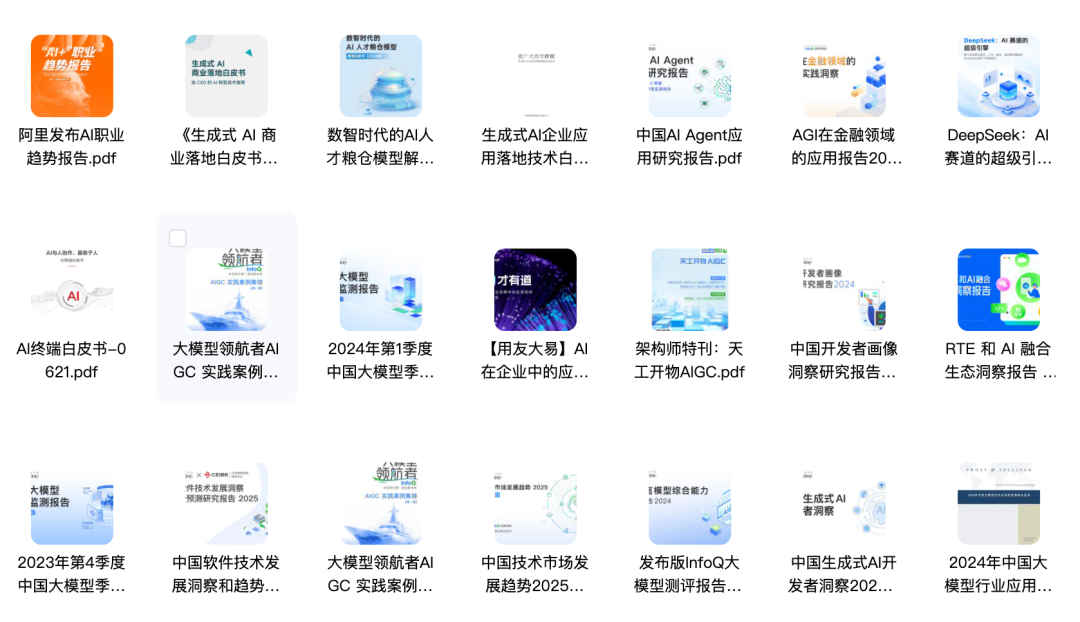
  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

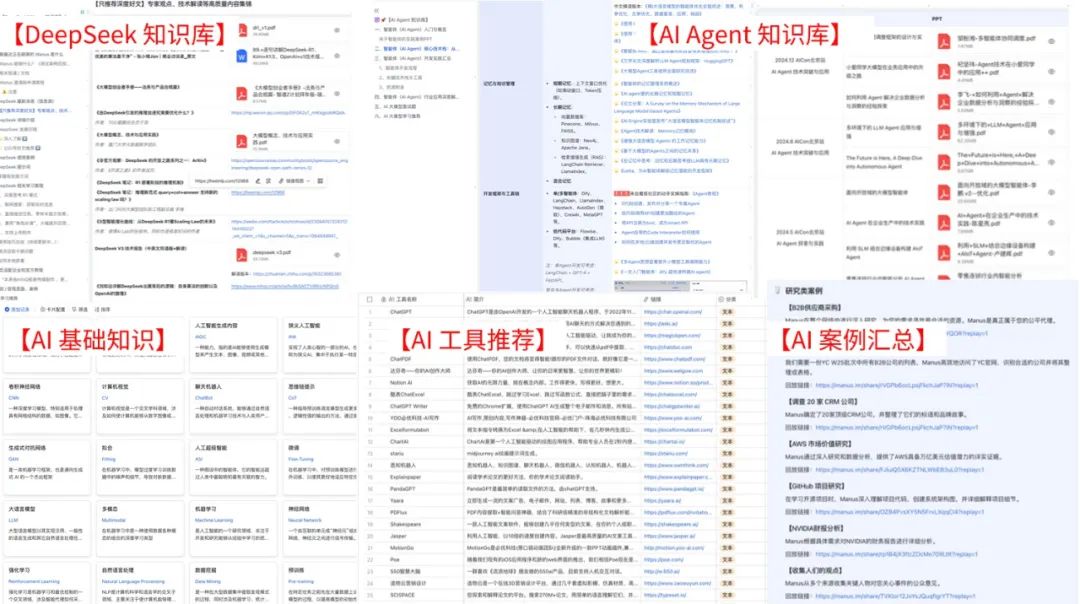
3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!
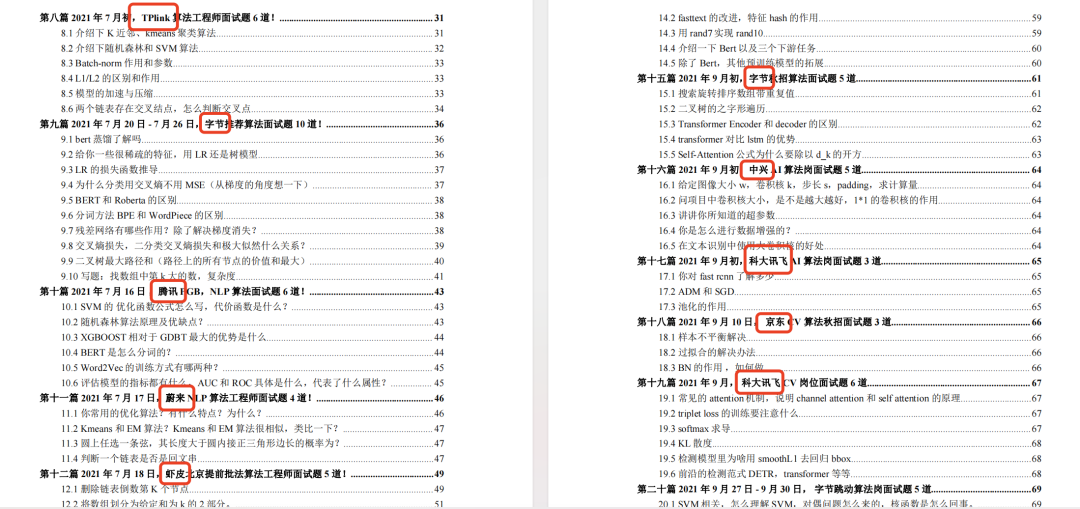
1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:
2. 102 道 AI 大模型真题:直击大模型核心考点

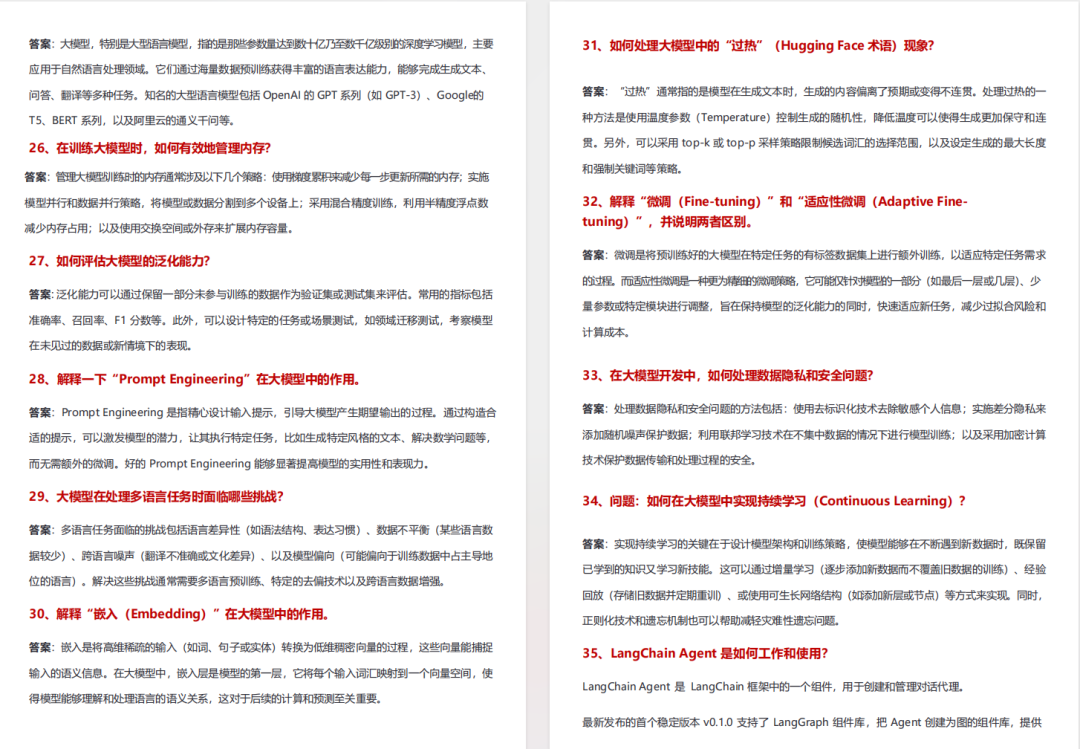
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:
3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

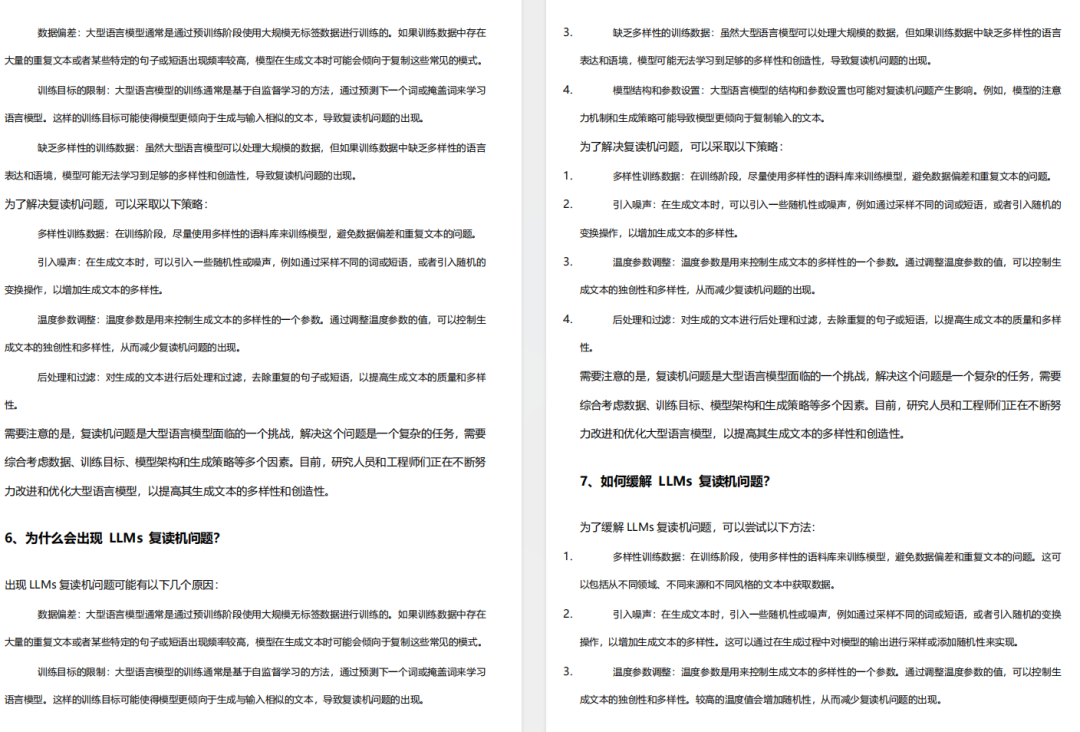
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:

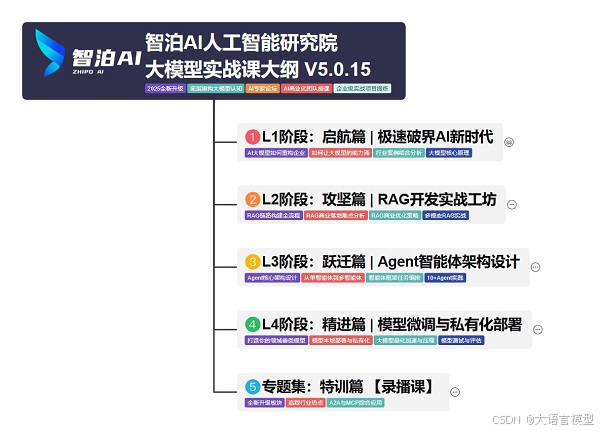
三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!
在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。
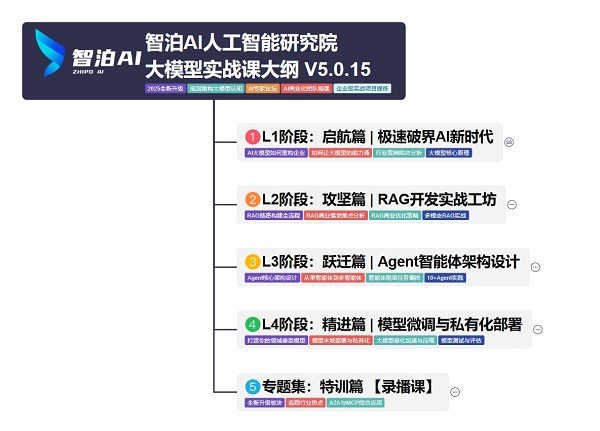
img

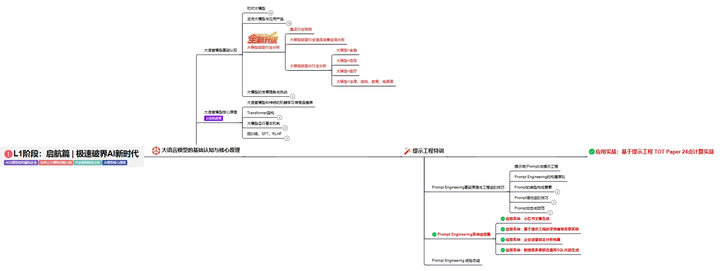
L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
img

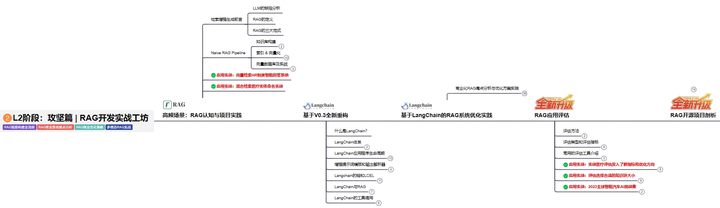
L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
img

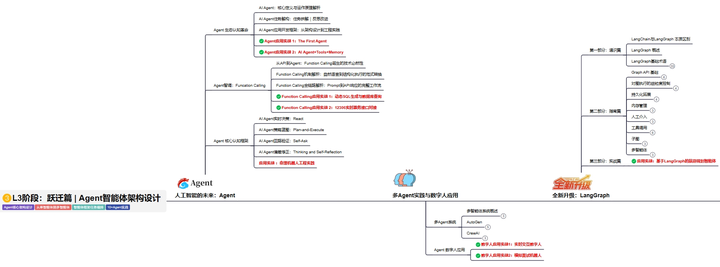
L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
img

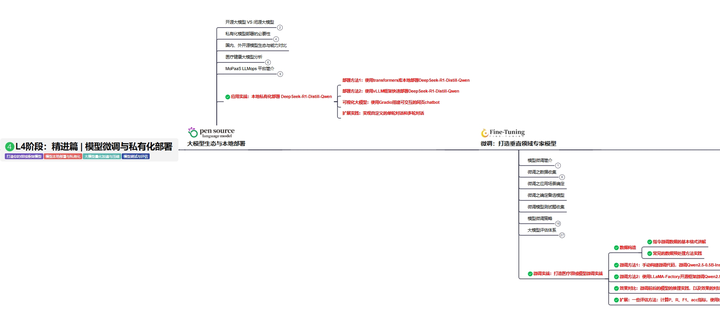
L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

【信息科学与工程学】【物理/化学和工程技术】第一百七十三篇 电力系统设计01 2. 图注意力层:计算注意力系数 αij​=∑k∈N(i)​exp(LeakyReLU(aT[Whi​∥Whk​]))exp(LeakyReLU(aT[Whi​∥Whj​]))​,更新节点特征 hi′​=σ(∑j∈N(i)​αij​Whj​)。我们被要求继续补充表格,按照之前给定的格式,每个字段包含逐步推理的数学表达式。3. 对比损失(NT-Xent):L=−log∑j=i​exp(sim(zi​,zj​)/τ)exp(sim(zi​,zi+​)/τ)​,其中 sim(u,v)=uTv/∥u∥∥v∥。 阅读详情

相关推荐

【信息科学与工程学】【通信工程】第七十三篇 分组网络中服务质量保障的算法 16

编号类别领域模型配方模块跨区域算法与数学过程(含对比、方程、参数优化、QoS配置,结合SRv6 URPSF切片+FlexE切片)A238​央企:国家电网/南方电网 — 配电线路智能断路器储能弹簧状态监测(前端)关键基础设施弹簧位移传感器/电流传感器 → 边缘终端 → 配电云 → 储能弹簧疲劳/断裂预警(跨省,多Region双AZ)接入/边缘/骨干各智能断路器 ⇄ 边缘终端(5G‑A/LoRa)⇄ 省配电中心 ⇄ 国网/南网配电云(双Region双AZ)三种弹簧状态评估对比(人工机械检查 / 分合闸时间变化

weixin_49199313的博客 200

【建议收藏】一文读懂大语言模型(LLM)的内部工作机制:分词、嵌入与注意力详解

本文详细解析了大语言模型从文本输入到预测输出的工作原理,包括文本分词、词嵌入映射、注意力机制计算等核心步骤。通过这些机制,LLM能够理解上下文并生成连贯响应。同时指出模型规模扩大能带来质的飞跃,涌现出更多高级能力。

优快云_430422的博客 577

「文智助手」全场景办公AI助理AI+OPC全流程实践方案(大赛作品)

「文智助手」全场景办公AI助理AI+OPC全流程实践方案(大赛作品)

jks212454的博客 505

LLM工程师必备的10个高信噪比信息源实战指南

大语言模型(LLM)技术迭代迅猛,工程师面临信息过载、概念抽象、落地脱节等典型困境。理解其核心原理需穿透数学符号与论文表述,而真正实现工程价值则依赖可复现的代码、精准的硬件约束和结构化的问题诊断能力。当前主流技术如vLLM推理优化、RAG系统性故障排查、LoRA微调实践等,已远超理论介绍层面,进入参数级调优与生产级校准阶段。高质量信息源的核心价值,在于将顶会创新转化为可部署方案,把模糊经验沉淀为可验证的命令行、配置项与监控指标。本文聚焦真实场景中高频使用的10个经过三阶过滤(作者可信度、技术颗粒度、时间衰减

weixin_30596735的博客 483

BEMD二维经验模态分解原理与MATLAB实战指南

二维经验模态分解(BEMD)是一种面向非平稳、非线性图像信号的自适应时频分析方法,其核心原理是基于局部极值构建包络面,通过双线性插值与迭代筛分提取物理意义明确的本征模态函数(IMF)。相比傅里叶变换和小波变换,BEMD无需预设基函数,具备强自适应性与可解释性,特别适用于医学影像、遥感图像和工业振动图谱等场景的多尺度结构分离。在人工智能任务中,BEMD常作为可解释特征预处理器,与CNN、LSTM等模型协同提升分类精度与故障溯源能力。本文聚焦BEMD在MATLAB环境下的实现逻辑、参数调优、常见报错(如erro

weixin_33919950的博客 551

【Cadence】 ADS Dynamic Link使用教程

在Cadence617上使用ADS Dynamic Link

乾巽的博客 6084

Qwen3-8B创意写作示例:小说开头生成

Qwen3-8B作为通义千问新一代轻量级大模型,凭借80亿参数实现高效本地推理,支持32K上下文与原生中文生成,可在RTX 3090等消费级显卡流畅运行。其在小说创作、多风格文本生成和本地化部署方面表现突出,显著降低AI内容创作门槛,推动人机协作创作新时代。

weixin_27645199的博客 622

云架构师进阶【SAP迁移方案设计】手把手教您玩转SAP上云

一,项目背景介绍 今天又接到了北京某制造企业SAP迁移的场景,先简单说明一下,好好的SAP在运行着为什么要做迁移这类大动作呢?众所周知SAP的ERP是企业的绝对核心系统,尤其对于制造业更是核心的系统,这样一套核心系统还是生产环境在迁移的过程中必然要面临比较大的挑战,如果有任何问题的话,都会对企业的绩效产生很大的影响。 经过跟客户沟通才得知,客户的SAP原来的系统是托管在运营商机房里,近期感染了勒索病毒,导致业务宕机,SAP应用服务器无法启动,仅有的数据库服务器可以运行。基于上述情况公司领导当机立断决定迅

bdsh818的博客 4224

AGI环境预测精度达98.6%?:揭秘中科院空天院联合DeepMind训练的Geo-LLM模型训练链与实测误差分析

Geo-LLM模型显著提升AGI的环境监测与保护应用效能,融合多源遥感与气象数据,实现98.6%高精度环境预测。适用于生态退化预警、污染扩散模拟等场景,采用时空自适应微调与不确定性校准技术。实测误差较传统模型降低42%,值得收藏。

DeepNest的博客 265

网易 广州 梦幻西游端游 客户端社招笔试题 2024

4道算法题,时间2小时,牛客网笔试注:采用OJ模式,需要自己处理输入、输出。

z2014z的博客 1824

从‘静态拍照’到‘动态录像’:用Malmquist指数讲好你的效率变化故事(附Stata/R代码)

本文深入探讨了如何利用Malmquist指数构建动态效率分析框架,从静态数据到动态叙事的转变。通过分解技术效率变化(EC)和技术进步(TC),结合Stata/R代码实现四种动态可视化方法,帮助研究者更直观地展示效率变化的动态特征。文章还提供了诊断性叙事结构和比较叙事技巧,助力决策者理解效率提升的来源与趋势。

weixin_32678995的博客 605

如何用NotebookLM 30分钟完成IPCC AR6数据智能对齐?——国家级环评团队内部培训首曝

30分钟高效完成IPCC AR6数据智能对齐!面向国家级环评团队,基于NotebookLM环境科学研究实践,利用语义理解与文档自动关联技术,精准匹配报告原文、图表与政策条款。提升环评报告编制效率与科学性,值得收藏。

DevPath的博客 158

光伏储能交直流微电网Matlab/Simulink仿真模型

首先是光伏储能交直流微电网,这个也是我还是之前在硕士期间在做光伏扶贫项目时候搭建的仿真,仿真由光伏、蓄电池及负载组成的独立直流微电网,提出电压和电流分段式协同控制策略。接下来我将主要更新关于光伏、风电、储能微电网系统相关的内容,包括具体建模和控制。

2401_89292556的博客 786

GPT-4o原生图像生成:大模型多模态推理范式革命

大模型图像生成已从独立文生图工具(如DALL·E)迈入LLM原生多模态推理新阶段。其核心原理是将视觉生成深度耦合进语言模型统一架构,通过语义锚定、空间解构与像素合成三层协同,在单次Transformer推理中完成理解、构图与生成。这一技术路径显著提升上下文感知能力与编辑精度,带来低延迟(3.7秒)、高可控性(支持JSON结构化输出)和强对话连续性等工程价值。典型应用场景涵盖UI/UX实时设计迭代、教育动态教具生成、工业图纸自动可视化及营销内容意图直出。GPT-4o图像生成标志着AIGC工作流从‘调用API’

weixin_34348174的博客 387

VirtualBox虚拟机上ubuntu系统安装问题记:显示画面太小、启动就异常退出等

报错:Failed to load R0 module D:/VMMR0.r0: The path is not clean of leading double slashes: ‘D:/VMMR0.r0’ (VERR_SUPLIB_PATH_NOT_CLEAN).解决方法特别简单,就是安装VIrtualBox的时候不要安装在CDE等盘根目录下。首先VirtualBox的下载安装过程是比较简单的,此处就不赘述了。然后E盘下新建个目录,安装到这个目录下就可解决。

qq_42595610的博客 2827

FPGA 学习笔记:Vitis IDE launch failed 的解决方法

FPGA 学习笔记:Vitis IDE launch failed 的解决方法

坚韧与专注 1万+

NeurIPS 2024 | 经典GNNs是强有力的节点分类基线模型

来源:深度图学习与大模型LLM 本文5600字,建议阅读11分钟 本文简要介绍了经典图神经网络 (GNNs) 的基准分析研究,发表在 NeurIPS 2024。论文题目:Classic GNNs are Strong Baselines: Reassessing GNNs for Node Classification作者:罗元凯,时磊,吴晓明单位:北京航空航天大学、香港理工大学日期:2024...

数据派THU 203

手把手教你学Simulink--Simulink智能驾驶场景挑战:高速公路入口匝道汇入仿真

高速公路入口匝道汇入在智能驾驶中的作用是当车辆从入口匝道进入主干道时,系统能够自主决策并执行汇入操作,确保安全和高效。目标识别与跟踪:如检测前方障碍物、识别车道线。路径规划:如计算最优汇入路径。动态控制:如调整速度、转向等以完成汇入动作。本示例将展示如何使用Simulink构建一个用于智能车辆高速公路入口匝道汇入的仿真模型,并进行验证。通过本指南,我们介绍了如何基于Simulink搭建一个用于智能车辆高速公路入口匝道汇入的仿真模型,并进行仿真和性能评估。背景介绍。

MHD0815的博客 264

Gemini原生多模态架构解析:从跨模态对齐到工作流落地

原生多模态(Native Multimodality)是大模型理解真实世界的关键范式,它超越传统‘图文拼接’或‘适配器桥接’,通过统一token空间与联合掩码建模,实现文本、图像、音频等模态在Transformer主干中的语义共融。其核心原理在于模态标识符与高精度位置编码的协同作用,支撑跨模态指代消解、异步信息融合、模态缺失鲁棒性及零样本跨模态生成四大技术能力。该架构显著提升长上下文多模态保持率与多跳推理稳定性,已在科研图表解读、工业远程诊断、教育课件生成等工程场景中验证实效。本文聚焦Gemini系列模型的

weixin_33704591的博客 302

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

贝叶斯统计 [韦来生编]

贝叶斯(Bayes)统计是近几十年来迅速发展起来的数理统计的一个重要分支。贝叶斯方法与经典统计方法的主要不同之处是进行统计推断时除了利用样本信息外,还要利用参数的先验信息,因此可以提高统计推断或统计决策的效果。它在经济、金融、生物、医学、自然科学和社会科学等许多领域具有广泛的应用。贝叶斯方法的研究已渗透到了统计学的几乎所有领域。作者在给中国科学技术大学概率论与数理统计专业本科生开设的“数理统计”课程中有一章专门讲授“贝叶斯方法和统计决策理论”,近十年来也给中国科学技术大学概率统计专业研究生开设过几次“贝叶斯分析”课。本书是在对过去讲稿的内容作了适当的增减和调整的基础上完成的。  本书共分六章。第1章是绪论,介绍了贝叶斯统计的若干基本概念,同时对必要的数理统计的基础知识有重点地作了回顾。第二章介绍了确定先验分布的若干可供选择的方法。第三章介绍了几类常见统计模型参数的后验分布的主要结果和计算方法。第四章和第五章分别介绍了“贝叶斯统计推断”和“贝叶斯统计决策”的内容。第六章介绍了贝叶斯统计计算的若干方法,包括蒙特卡洛方法和马尔可夫链蒙特卡洛(MCMC)方法以及相关统计软件的简介。本书的每一章附右大量的例题和习题,书末附有常用的几个表格和部分习题解答供读者查用。  大约可在54学时内讲授本书的第1章至第六章的主要内容,教师可根据学时需要选讲本书第1章至第六章的部分内容。书中标“*”号的章节可略去不讲,留给读者作为阅读材料。第六章例题中的R代码和部分例题的数据文件等可从作者个人主页下载。  作者在编写本书的过程中参考了J.O.Berger教授的《统计决策论及贝叶斯分析》和茆诗松教授编写的《贝叶斯统计》等书中的一些内容,以及《贝叶斯分析》一书中由张伟平博士编写的有关贝叶斯统计计算的一些内容。在此表示衷心感谢。  本书编写准备过程中,中国科学技术大学统计与金融系的几个研究生帮助完成了本书部分中文的录入和排版,作者对他们的辛勤工作表示真诚的感谢。高等教育出版社为本书的出版给予了大力支持。在此一并致谢。

5.x大模型技术解析:代码生成、API集成与生产环境实践指南

大语言模型作为人工智能领域的核心技术,通过Transformer架构实现了对自然语言的深度理解与生成。其原理基于注意力机制,能够捕捉文本中的长距离依赖关系,从而在代码生成、文本理解等任务中表现出色。从技术价值角度看,大模型显著提升了开发效率,降低了编程门槛,使得复杂的软件开发任务能够通过自然语言指令完成。在实际应用场景中,大模型广泛应用于代码自动补全、bug修复、文档生成等开发环节,特别是在5.x版本模型中,代码生成质量和推理能力得到了显著提升。本文聚焦于5.x大模型的实际集成与应用,通过完整的API配置、

chengyixian7877的博客 330

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

AI 写的测试测的是它自己:断言锁死输出,功能改错它也测不出来

AI 生成的测试跑得勤、全绿、上线前不报错,但三个月后维护时发现它已经"测的是自己"——断言用实现逻辑生成期望值,功能改错了测试还是绿的。这篇用一组沙箱演练量"可测性":同一个实现、同一批订单、两版测试(AI 风格·字面量锁死 vs 人写规范·业务谓词),走三组对照。结论反直觉:需求不变时两版测试都绿;需求一演进,A 版测试先误报(锁死输入结构,代码没 bug 却红),"修"完就变成测自己,之后功能改错它照样绿;B 版测试不误报、改错就红。跑得绿不等于测得住。

四六的六专栏 272

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

AI 问数真的能替代 BI 报表吗?

AI问数赋能自然语言查询,提升临时分析效率,但无法替代传统报表。报表适用于稳定输出与持续监控,AI则擅长探索性提问。企业用好AI问数,关键在于夯实数据模型、统一指标口径、健全权限体系与结果校验机制。合理组合报表、仪表板与AI,才能实现高效、准确的业务洞察。

葡萄城技术团队博客 363

ChatGPT、Perplexity、Gemini 与 AI Overviews 引用对比:谁的引用更可信

AI 引擎的引用机制差异很大:ChatGPT 以行内引用加 Sources 列表呈现来源,Perplexity 几乎逐句可溯源,Gemini 在回答中内嵌相关来源链接,AI Overviews 则把多源聚合答案与来源列表一起放在搜索结果顶部。本文从引用透明度、来源偏好、可干预性 3 个维度对比这 4 个引擎,并给出 GEO 的 3 点启示,帮企业在多引擎环境下提升被引用的概率。

淡然一笑 的专栏 303

【从零理解 Spring AI · 12】MCP 的两种角色:做客户端还是做服务端

上一篇讲了 MCP 的概念:标准协议、三大角色、M+N 替代 M×N。

nice_lcj520的博客 624

抽象主义人工智能和生命体AI的内在联系

彭军辉提出“抽象主义人工智能”作为第四大AI范式,批判符号主义、连接主义、行为主义剥离生命本体的误区,确立“智能是现象,生命是本体”的核心公理。主张原生智能必须依附具备存续诉求的生命本体,提出“生命体AI理论”,构建七层演化阶梯与自闭环工程框架,强调智能不可跳过底层存续机制直接模拟语言。该体系为生成式AI提供科学边界,推动从“仿真表象”向“原生智能”的范式跃迁,开辟硅基人工生命新赛道。

抽象主义人工智能和生命体AI 215

OpenAI Control Room 架构拆解:给企业 AI Agent 加一套可审计的急停系统

OpenAI 公开了用于追踪和停止研究模型工作负载的 Control Room。本文拆解 job_id、推理前鉴权、35 秒撤销窗口与 Fail Closed 设计,并给出企业 AI Agent 急停控制面的数据模型、FastAPI 参考实现、缓存撤销策略和故障演练清单。

jerry764的博客 349
上一篇: 小白学大模型:从零实现 LLM语言模型
下一篇: Streamlit+LangChain+GLM构建你的聊天机器人
AI_小站
博客等级 码龄3年 6255粉丝 1158原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值