


在当今人工智能领域,大型语言模型(LLM)的开发已经成为一个热门话题。这些模型通过学习大量的文本数据,能够生成自然语言文本,完成各种复杂的任务,如写作、翻译、问答等。
https://github.com/FareedKhan-dev/train-llm-from-scratch
本文将为你提供一个简单直接的方法,从下载数据到生成文本,带你一步步构建大院模型。
步骤1:GPU设备
在开始训练语言模型之前,你需要对面向对象编程(OOP)、神经网络(NN)和 PyTorch 有基本的了解。
训练语言模型需要强大的计算资源,尤其是 GPU。不同的 GPU 在内存容量和计算能力上有所不同,适合不同规模的模型训练。以下是一个详细的 GPU 对比表,帮助你选择合适的硬件。
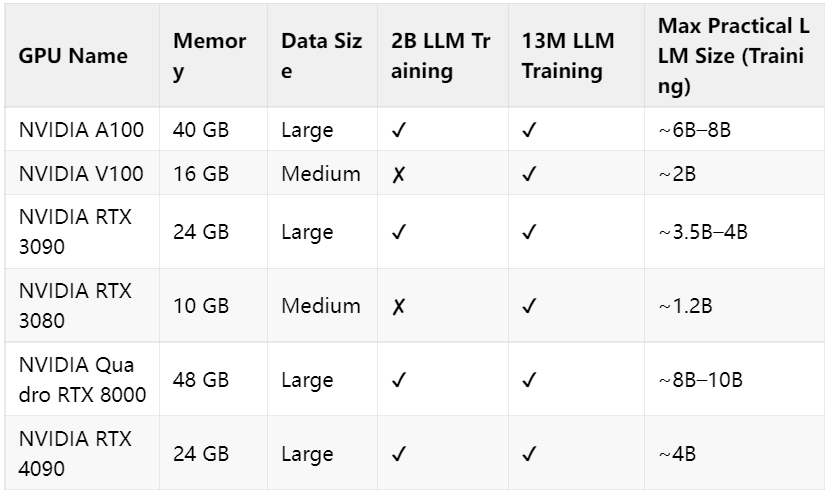
13M LLM 训练
- 参数规模:1300 万参数。
- 应用场景:适合初学者和小型项目,例如简单的文本生成、情感分析或语言理解任务。
- 硬件需求:相对较低。大多数中高端 GPU(如 NVIDIA RTX 3060 或更高)都可以胜任。
- 特点:训练速度快,资源消耗低,适合快速迭代和实验。
2B LLM 训练
- 参数规模:20 亿参数。
- 应用场景:适合更复杂的任务,如高质量的文本生成、多语言翻译或更高级的语言理解任务。
- 硬件需求:较高。需要至少 16GB 内存的 GPU,如 NVIDIA RTX 3090 或更高配置。
- 特点:能够生成更流畅、更自然的文本,但训练时间长,资源消耗大。
步骤2:导入环境
在开始之前,我们需要导入一些必要的 Python 库。这些库将帮助我们处理数据、构建模型以及训练模型。
# PyTorch for deep learning functions and tensorsimport torchimport torch.nn as nnimport torch.nn.functional as F# Numerical operations and arrays handlingimport numpy as np# Handling HDF5 filesimport h5py# Operating system and file managementimport os# Command-line argument parsingimport argparse# HTTP requests and interactionsimport requests# Progress bar for loopsfrom tqdm import tqdm# JSON handlingimport json# Zstandard compression libraryimport zstandard as zstd# Tokenization library for large language modelsimport tiktoken# Math operations (used for advanced math functions)import math
步骤3:加载数据集
The Pile 数据集是一个大规模、多样化的开源数据集,专为语言模型训练设计。它由 22 个子数据集组成,涵盖了书籍、文章、维基百科、代码、新闻等多种类型的文本。
# Download validation dataset!wget https://huggingface.co/datasets/monology/pile-uncopyrighted/resolve/main/val.jsonl.zst# Download the first part of the training dataset!wget https://huggingface.co/datasets/monology/pile-uncopyrighted/resolve/main/train/00.jsonl.zst# Download the second part of the training dataset!wget https://huggingface.co/datasets/monology/pile-uncopyrighted/resolve/main/train/01.jsonl.zst# Download the third part of the training dataset!wget https://huggingface.co/datasets/monology/pile-uncopyrighted/resolve/main/train/02.jsonl.zst
最终处理好的数据集格式如下:
#### OUTPUT ####Line: 0 {"text": "Effect of sleep quality ... epilepsy.","meta": { "pile_set_name": "PubMed Abstracts" }}Line: 1{"text": "LLMops a new GitHub Repository ...","meta": { "pile_set_name": "Github" }}
步骤4:Transformer 架构
Transformer 通过将文本分解成更小的单元,称为“标记”(token),并预测序列中的下一个标记来工作。Transformer 由多个层组成,这些层被称为 Transformer 块,它们一层叠一层,最后通过一个最终层来进行预测。
每个 Transformer 块包含两个主要组件:
- 自注意力头(Self-Attention Heads)
自注意力头的作用是确定输入中哪些部分对模型来说最为重要。例如,在处理一个句子时,自注意力头可以突出显示单词之间的关系,比如代词与其所指代的名词之间的关系。通过这种方式,模型能够更好地理解句子的结构和语义。
- 多层感知器(MLP,Multi-Layer Perceptron)
多层感知器是一个简单的前馈神经网络。它接收自注意力头强调的信息,并进一步处理这些信息。MLP 包含:
- 输入层:接收来自自注意力头的数据。
- 隐藏层:为处理过程增加复杂性。
- 输出层:将处理结果传递给下一个 Transformer 块。
- 输入嵌入与位置编码 :输入的文本被分解为标记(tokens),然后转换为嵌入向量(embeddings)。同时,加入位置编码(position embeddings)以提供标记的位置信息。
- Transformer 块堆叠 :模型由多个(例如 64 个)相同的 Transformer 块组成,这些块依次对数据进行处理。
- 多头注意力机制 :每个 Transformer 块首先通过多头注意力机制(例如 16 个头)分析标记之间的关系,捕捉不同类型的关联。
- MLP 处理 :注意力机制处理后的数据通过一个 MLP(多层感知器)进行进一步处理,先扩展到更大维度(例如 4 倍),再压缩回原始维度。
- 残差连接与层归一化 :每个 Transformer 块中使用残差连接(residual connections)和层归一化(layer normalization),以帮助信息流动并稳定训练。
- 最终预测 :理后的数据通过最终层,转换为词汇表大小的预测结果,生成下一个最有可能的标记。
- 文本生成 :模型通过反复预测下一个标记,逐步生成完整的文本序列。
步骤5:多层感知器(MLP)
多层感知器(MLP)是 Transformer 架构中前馈神经网络(Feed-Forward Network, FFN)的核心组成部分。它的主要作用是引入非线性特性,并学习嵌入表示中的复杂关系。在定义 MLP 模块时,一个重要的参数是 n_embed,它定义了输入嵌入的维度。
MLP 的整个序列转换过程使得它能够对注意力机制学习到的表示进行进一步的精细化处理。具体来说:
- 引入非线性:通过 ReLU 激活函数,MLP 能够捕捉到嵌入表示中的复杂非线性关系。
- 特征增强:隐藏层的扩展操作为模型提供了更大的空间来学习更丰富的特征。
- 维度一致性:投影线性层确保 MLP 的输出维度与输入维度一致,便于后续的 Transformer 块继续处理。
# --- MLP (Multi-Layer Perceptron) Class ---class MLP(nn.Module): """ A simple Multi-Layer Perceptron with one hidden layer. This module is used within the Transformer block for feed-forward processing. It expands the input embedding size, applies a ReLU activation, and then projects it back to the original embedding size. """ def __init__(self, n_embed): super().__init__() self.hidden = nn.Linear(n_embed, 4 * n_embed) # Linear layer to expand embedding size self.relu = nn.ReLU() # ReLU activation function self.proj = nn.Linear(4 * n_embed, n_embed) # Linear layer to project back to original size def forward(self, x): """ Forward pass through the MLP. Args: x (torch.Tensor): Input tensor of shape (B, T, C), where B is batch size, T is sequence length, and C is embedding size. Returns: torch.Tensor: Output tensor of the same shape as the input. """ x = self.forward_embedding(x) x = self.project_embedding(x) return x def forward_embedding(self, x): """ Applies the hidden linear layer followed by ReLU activation. Args: x (torch.Tensor): Input tensor. Returns: torch.Tensor: Output after the hidden layer and ReLU. """ x = self.relu(self.hidden(x)) return x def project_embedding(self, x): """ Applies the projection linear layer. Args: x (torch.Tensor): Input tensor. Returns: torch.Tensor: Output after the projection layer. """ x = self.proj(x) return x
步骤6:Single Head Attention
注意力头(Attention Head)是 Transformer 模型的核心部分,其主要作用是让模型能够专注于输入序列中与当前任务最相关的部分。在定义注意力头模块时,有几个重要的参数:
head_size:决定了键(key)、查询(query)和值(value)投影的维度,从而影响注意力机制的表达能力。n_embed:输入嵌入的维度,定义了这些投影层的输入大小。context_length:用于创建因果掩码(causal mask),确保模型只能关注前面的标记,从而实现自回归(autoregressive)特性。
在注意力头内部,我们初始化了三个无偏置的线性层(nn.Linear),分别用于键、查询和值的投影。此外,我们注册了一个大小为 context_length x context_length 的下三角矩阵(tril)作为缓冲区(buffer),以实现因果掩码,防止注意力机制关注未来的标记。
# --- Attention Head Class ---class Head(nn.Module): def __init__(self, head_size, n_embed, context_length): super().__init__() self.key = nn.Linear(n_embed, head_size, bias=False) # Key projection self.query = nn.Linear(n_embed, head_size, bias=False) # Query projection self.value = nn.Linear(n_embed, head_size, bias=False) # Value projection # Lower triangular matrix for causal masking self.register_buffer('tril', torch.tril(torch.ones(context_length, context_length))) def forward(self, x): B, T, C = x.shape k = self.key(x) # (B, T, head_size) q = self.query(x) # (B, T, head_size) scale_factor = 1 / math.sqrt(C) # Calculate attention weights: (B, T, head_size) @ (B, head_size, T) -> (B, T, T) attn_weights = q @ k.transpose(-2, -1) * scale_factor # Apply causal masking attn_weights = attn_weights.masked_fill(self.tril[:T, :T] == 0, float('-inf')) attn_weights = F.softmax(attn_weights, dim=-1) v = self.value(x) # (B, T, head_size) # Apply attention weights to values out = attn_weights @ v # (B, T, T) @ (B, T, head_size) -> (B, T, head_size) return out
步骤7:Multi Head Attention
多头注意力(Multi-Head Attention)是 Transformer 架构中的关键机制,用于捕捉输入序列中多样化的关联关系。通过将多个独立的注意力头(attention heads)并行运行,模型能够同时关注输入的不同方面,从而更全面地理解序列信息。
n_head:决定了并行运行的注意力头的数量。每个注意力头独立处理输入数据,从而让模型能够从多个角度捕捉输入序列中的关系。- 上下文长度
context_length定义了输入序列的长度,用于创建因果掩码(causal mask),确保模型只能关注前面的标记,从而实现自回归特性。
class MultiHeadAttention(nn.Module): """ Multi-Head Attention module. This module combines multiple attention heads in parallel. The outputs of each head are concatenated to form the final output. """ def __init__(self, n_head, n_embed, context_length): super().__init__() self.heads = nn.ModuleList([Head(n_embed // n_head, n_embed, context_length) for _ in range(n_head)]) def forward(self, x): """ Forward pass through the multi-head attention. Args: x (torch.Tensor): Input tensor of shape (B, T, C). Returns: torch.Tensor: Output tensor after concatenating the outputs of all heads. """ # Concatenate the output of each head along the last dimension (C) x = torch.cat([h(x) for h in self.heads], dim=-1) return x
步骤8:Transformer 块
Transformer 块是 Transformer 架构的核心单元,它通过组合多头注意力机制和前馈网络(MLP),并应用层归一化(Layer Normalization)以及残差连接(Residual Connections),来处理输入并学习复杂的模式。
n_head:多头注意力中并行注意力头的数量。n_embed:输入嵌入的维度,也是层归一化的参数维度。context_length:上下文长度,用于定义序列的长度,并创建因果掩码。
每个 Transformer 块包含以下部分:
- 多头注意力层(Multi-Head Attention):负责捕捉输入序列中不同位置之间的关系。
- 前馈网络(MLP):用于进一步处理多头注意力层的输出,引入非线性特性。
- 层归一化(Layer Normalization):在每个子层之前应用,有助于稳定训练。
- 残差连接(Residual Connections):在每个子层之后应用,帮助信息流动并缓解深层网络训练中的梯度消失问题。
class Block(nn.Module): def __init__(self, n_head, n_embed, context_length): super().__init__() self.ln1 = nn.LayerNorm(n_embed) self.attn = MultiHeadAttention(n_head, n_embed, context_length) self.ln2 = nn.LayerNorm(n_embed) self.mlp = MLP(n_embed) def forward(self, x): # Apply multi-head attention with residual connection x = x + self.attn(self.ln1(x)) # Apply MLP with residual connection x = x + self.mlp(self.ln2(x)) return x def forward_embedding(self, x): res = x + self.attn(self.ln1(x)) x = self.mlp.forward_embedding(self.ln2(res)) return x, res
步骤9:完整模型结构
到目前为止,我们已经编写了 Transformer 模型的一些小部件,如多头注意力(Multi-Head Attention)和 MLP(多层感知器)。接下来,我们需要将这些部件整合起来,构建一个完整的 Transformer 模型,用于执行序列到序列的任务。为此,我们需要定义几个关键参数:n_head、n_embed、context_length、vocab_size 和 N_BLOCKS。
# --- Transformer Model Class ---class Transformer(nn.Module): """ The main Transformer model. This class combines token and position embeddings with a sequence of Transformer blocks and a final linear layer for language modeling. """ def __init__(self, n_head, n_embed, context_length, vocab_size, N_BLOCKS): super().__init__() self.context_length = context_length self.N_BLOCKS = N_BLOCKS self.token_embed = nn.Embedding(vocab_size, n_embed) self.position_embed = nn.Embedding(context_length, n_embed) self.attn_blocks = nn.ModuleList([Block(n_head, n_embed, context_length) for _ in range(N_BLOCKS)]) self.layer_norm = nn.LayerNorm(n_embed) self.lm_head = nn.Linear(n_embed, vocab_size) self.register_buffer('pos_idxs', torch.arange(context_length)) def _pre_attn_pass(self, idx): B, T = idx.shape tok_embedding = self.token_embed(idx) pos_embedding = self.position_embed(self.pos_idxs[:T]) return tok_embedding + pos_embedding def forward(self, idx, targets=None): x = self._pre_attn_pass(idx) for block in self.attn_blocks: x = block(x) x = self.layer_norm(x) logits = self.lm_head(x) loss = None if targets is not None: B, T, C = logits.shape flat_logits = logits.view(B * T, C) targets = targets.view(B * T).long() loss = F.cross_entropy(flat_logits, targets) return logits, loss def forward_embedding(self, idx): x = self._pre_attn_pass(idx) residual = x for block in self.attn_blocks: x, residual = block.forward_embedding(x) return x, residual def generate(self, idx, max_new_tokens): for _ in range(max_new_tokens): idx_cond = idx[:, -self.context_length:] logits, _ = self(idx_cond) logits = logits[:, -1, :] probs = F.softmax(logits, dim=-1) idx_next = torch.multinomial(probs, num_samples=1) idx = torch.cat((idx, idx_next), dim=1) return idx
步骤10:训练参数配置
现在我们已经完成了模型的编码工作,接下来需要定义训练参数,包括注意力头的数量、Transformer 块的数量等,以及数据路径等相关配置。
VOCAB_SIZE:词汇表大小,表示词汇表中唯一标记的数量。CONTEXT_LENGTH:模型能够处理的最大序列长度。N_EMBED:嵌入空间的维度,决定了标记嵌入和位置嵌入的大小。N_HEAD:每个 Transformer 块中的注意力头数量。N_BLOCKS:模型中 Transformer 块的数量,决定了模型的深度。T_BATCH_SIZE:训练时每个批次的样本数量。T_CONTEXT_LENGTH:训练批次的上下文长度。T_TRAIN_STEPS:总训练步数。
步骤11:模型训练
我们使用 AdamW 优化器,这是一种改进版的 Adam 优化器,适用于深度学习任务。
- 高初始损失:20 亿参数模型在训练初期的损失值通常非常高。这是因为模型的参数量巨大,初始权重随机分布,导致模型在开始时对数据的理解非常有限。
- 剧烈波动:在训练的前几轮,损失值可能会出现剧烈波动。这是因为模型需要在庞大的参数空间中寻找合适的权重组合,而初始的学习率可能过高,导致优化过程不稳定。
- 快速下降:尽管初始损失很高,但随着训练的进行,损失值通常会迅速下降。这是因为模型逐渐开始学习数据中的模式和结构。
- 波动调整:在快速下降之后,损失值可能会出现一些波动。这是因为模型在调整权重时,可能会在不同的局部最优解之间徘徊。这种波动表明模型在寻找更稳定的全局最优解。
步骤12:生成文本
接下来,我们将创建一个函数 generate_text,用于从保存的模型中生成文本。该函数接受保存的模型路径和输入文本作为输入,并返回生成的文本。我们还将比较数百万参数模型和数十亿参数模型在生成文本时的表现。
def generate_text(model_path, input_text, max_length=512, device="gpu"): # Load the model checkpoint checkpoint = torch.load(model_path) # Initialize the model (you should ensure that the Transformer class is defined elsewhere) model = Transformer().to(device) # Load the model's state dictionary model.load_state_dict(checkpoint['model_state_dict']) # Load the tokenizer for the GPT model (we use 'r50k_base' for GPT models) enc = tiktoken.get_encoding('r50k_base') # Encode the input text along with the end-of-text token input_ids = torch.tensor( enc.encode(input_text, allowed_special={'<|endoftext|>'}), dtype=torch.long )[None, :].to(device) # Add batch dimension and move to the specified device # Generate text with the model using the encoded input with torch.no_grad(): # Generate up to 'max_length' tokens of text generated_output = model.generate(input_ids, max_length) # Decode the generated tokens back into text generated_text = enc.decode(generated_output[0].tolist()) return generated_text
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
1. 100+本大模型方向电子书

2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:

三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

L5阶段:专题集丨特训篇 【录播课】

四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!
 6万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


