GraphRAG的原理及代码实战(1)基本原理介绍(上)

GraphRAG原理详解 如上图所示,GraphRAG包括两个处理阶段,分别是:索引阶段和查询阶段。索引阶段利用LLM来自动化构建知识图谱,提取出对应的节点(如实体)、边(如关系)和协变量(如主张,claim),然后利用社区发现技术(如Leiden算法)对整个知识图谱进行子图划分,然后自底而上对子图利用LLM进行摘要、总结。针对特定查询,“全局答案(Global Search)”汇总所有与之相关的社区摘要最后汇总生成答案。通过LLM对文档中的实体、关系、主张进行提取,本质上是对文档的一种抽象式摘要。 阅读详情

1、基本介绍

GraphRAG通过利用大模型从原始文本数据中提取知识图谱来满足跨上下文检索的需求。该知识图将信息表示为互连实体和关系的网络,与简单的文本片段相比,提供了更丰富的数据表示。这种结构化表示使 GraphRAG 能够擅长回答需要推理和连接不同信息的复杂问题。

具体来看,GraphRAG 定义了一个标准化数据模型,整体框架由几个关键组件组成,分别用于表示文档、TextUnit、实体、关系和社区报告等实体。像传统RAG一样,GraphRAG 过程也涉及两个主要阶段:索引和查询。我们依次展开来进行讨论。

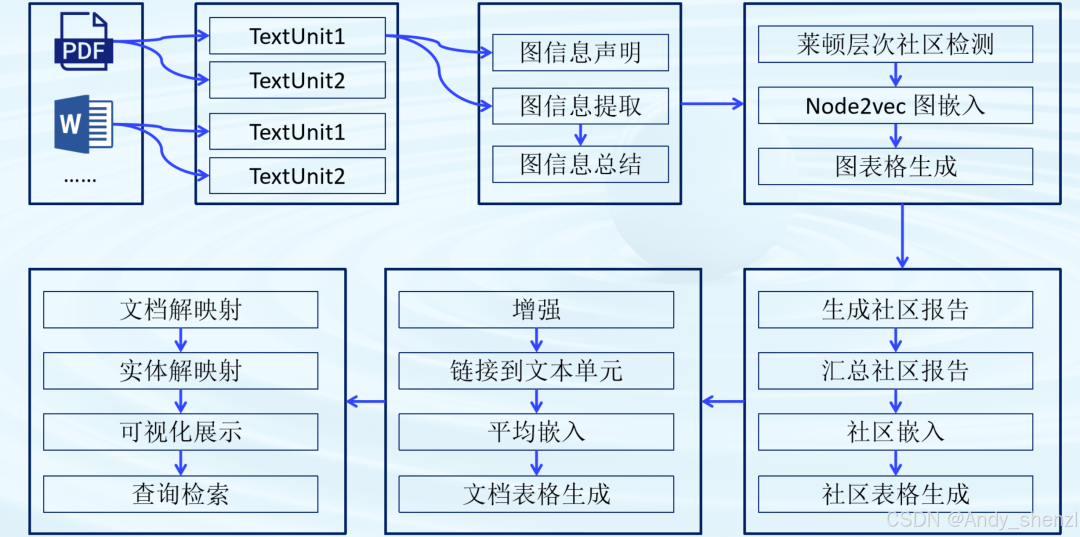
在索引(Indexing)过程中,输入的文本被分为可管理的块,称为TextUnits 。然后大模型从这些文本单元中提取实体、关系和声明,形成知识图。完整的Indexing流程如下图所示:
在这里插入图片描述

2、流程及原理解析

Step 1. 文本切分(Text Unit Splitting)

  • GraphRAG 需要处理的是一大篇文档或语料库。首先,它会将这些文档切分为 Text Units(文本单元),这些 Text Units 是对输入文档的细分,通常是按照段落、句子或固定长度的文本块来进行切分。
  • 这样做的目的是为了便于对文本内容进行分析,尤其是当需要进行 实体识别 和 关系抽取 时,能够精准地关联到文档中的具体上下文。

Step 2. 实体识别(Entity Extraction)

  • 在文本切分之后,GraphRAG 会使用 大模型(如 OpenAI GPT 或其他 LLM) 对每个 Text Unit 进行处理,提取其中的 实体。这些实体通常是指文档中出现的人物、地点、组织、概念等信息。
  • 实体识别的目的是构建 实体图谱(Entity Graph),将所有实体提取出来并为后续的关系挖掘和查询做准备。

Step 3. 关系挖掘(Relationship Extraction)

  • 关系挖掘是从文本中识别出实体之间的 关系,例如:谁与谁有关联、某个实体与另一个实体之间的关系是“属于”、“合作”、“对立”等。
  • 通过这种关系提取,GraphRAG 可以构建 关系图谱(Relationship Graph),这些关系将有助于后续的 查询引擎 理解和推理。

Step 4. 文本嵌入(Text Embedding)

  • 在识别了文本中的实体和关系之后,GraphRAG 会利用 嵌入模型(如 OpenAI 的 Embedding 模型)将文本和实体表示为向量(vectors)。这些向量不仅包括了文本的语义信息,还能为后续的检索和查询提供高效的表示。
  • 这些嵌入向量将存储在 向量数据库(如 LanceDB)中,为查询时提供快速的相似度搜索。

Step 5. 构建社区和层级结构(Community and Hierarchical Clustering)

  • 通过使用 图谱聚类算法(如 Leiden 算法),GraphRAG 会将不同的实体和关系分组,形成多个 社区(Community)。这些社区是根据实体之间的相似度或关系的密切程度进行划分的。
  • 这种分组帮助 GraphRAG 更好地理解不同知识领域的结构,为查询时提供更具层次性的上下文信息。

Step 6. 生成索引文件(Indexing)

  • 完成上述步骤后,所有的 实体、关系、社区报告、文本单元等信息都会存储在磁盘上的 Parquet 文件中。
  • 这些索引文件实际上就是构建好的 知识图谱,包括了文本内容、文本中涉及的实体和关系的结构化表示,并且这些文件是为后续的查询引擎和推理过程提供基础。

总的来说GraphRAG 的 索引阶段 是一个 多步骤 的过程,基本流程是:

  1. 文本切分(Text Units)
  2. 实体识别(Entity Extraction)
  3. 关系挖掘(Relationship Extraction)
  4. 文本嵌入(Text Embedding)
  5. 社区划分和层级结构(Clustering)
  6. 生成索引文件(Indexing)

整个过程的目的是将文档中的原始文本转化为可以进行检索和推理的结构化知识图谱。而 实体识别 和 关系挖掘 通常是在文本切分之后进行的,因为需要先确保文本已经切分成足够小的单元才能进行更精细的分析和抽取。

3、本地实现

3.1 使用pip安装graphrag

ounter(line
pip install graphrag

测试的graphrag版本为1.1.0

ounter(lineounter(lineounter(lineounter(lineounter(lineounter(lineounter(lineounter(lineounter(lineounter(lineounter(lineounter(line
(graphrag) [root@local- graphrag]# pip show graphrag
Name: graphrag
Version: 1.1.0
Summary: GraphRAG: A graph-based retrieval-augmented generation (RAG) system.
Home-page:
Author: Alonso Guevara Fernández
Author-email: alonsog@microsoft.com
License: MIT
Location: /root/anaconda3/envs/graphrag/lib/python3.11/site-packages
Requires: aiofiles, azure-cosmos, azure-identity, azure-search-documents, azure-storage-blob, devtools, environs, fnllm, future, graspologic, httpx, json-repair, lancedb, matplotlib, networkx, nltk, numpy, openai, pandas, pyaml-env, pyarrow, pydantic, python-dotenv, pyyaml, rich, tenacity, tiktoken, tqdm, typer, typing-extensions, umap-learn
Required-by:

3.2 创建检索项目文件夹

ounter(line
mkdir -p ./sushi/input

在input文件夹中上传一个txt文件,该文件为需要创建知识图谱问答的文本文件。 这里以苏轼的百度百科的介绍内容为例,创建图谱问答。

3.3 初始化项目文件

ounter(lineounter(line
(graphrag) [root@local-7 graphrag]# graphrag init --root ./sushi
Initializing project at /root/szl/project/graphrag/sushi

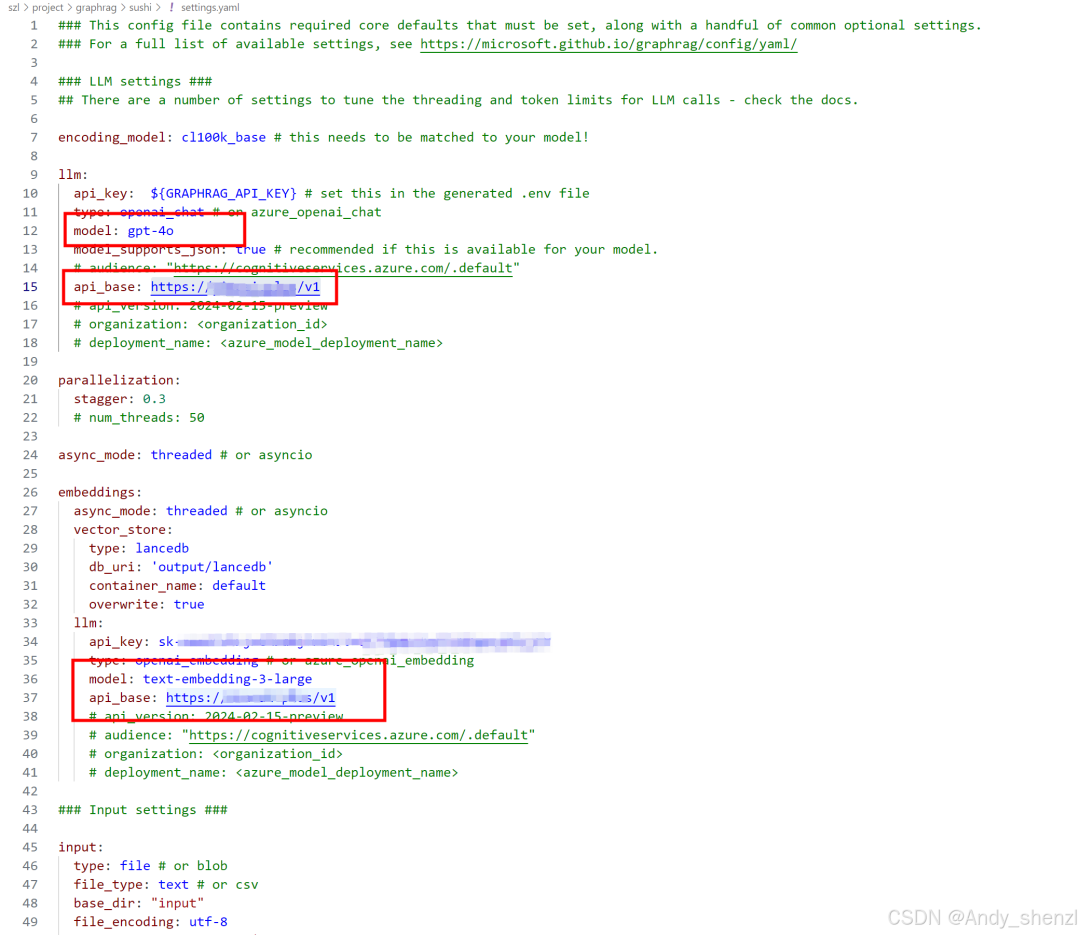
初始化后,会在创建的检索项目文件夹下出现两个文件,一个是.env文件,和一个settings.yaml文件,是环境变量的设置文件:

  • 打开.env文件,填写openai API-KEY
  • 打开setting.yaml文件,填写模型名称和反向代理地址

3.4 GraphRAG索引Indexing过程执行

ounter(line
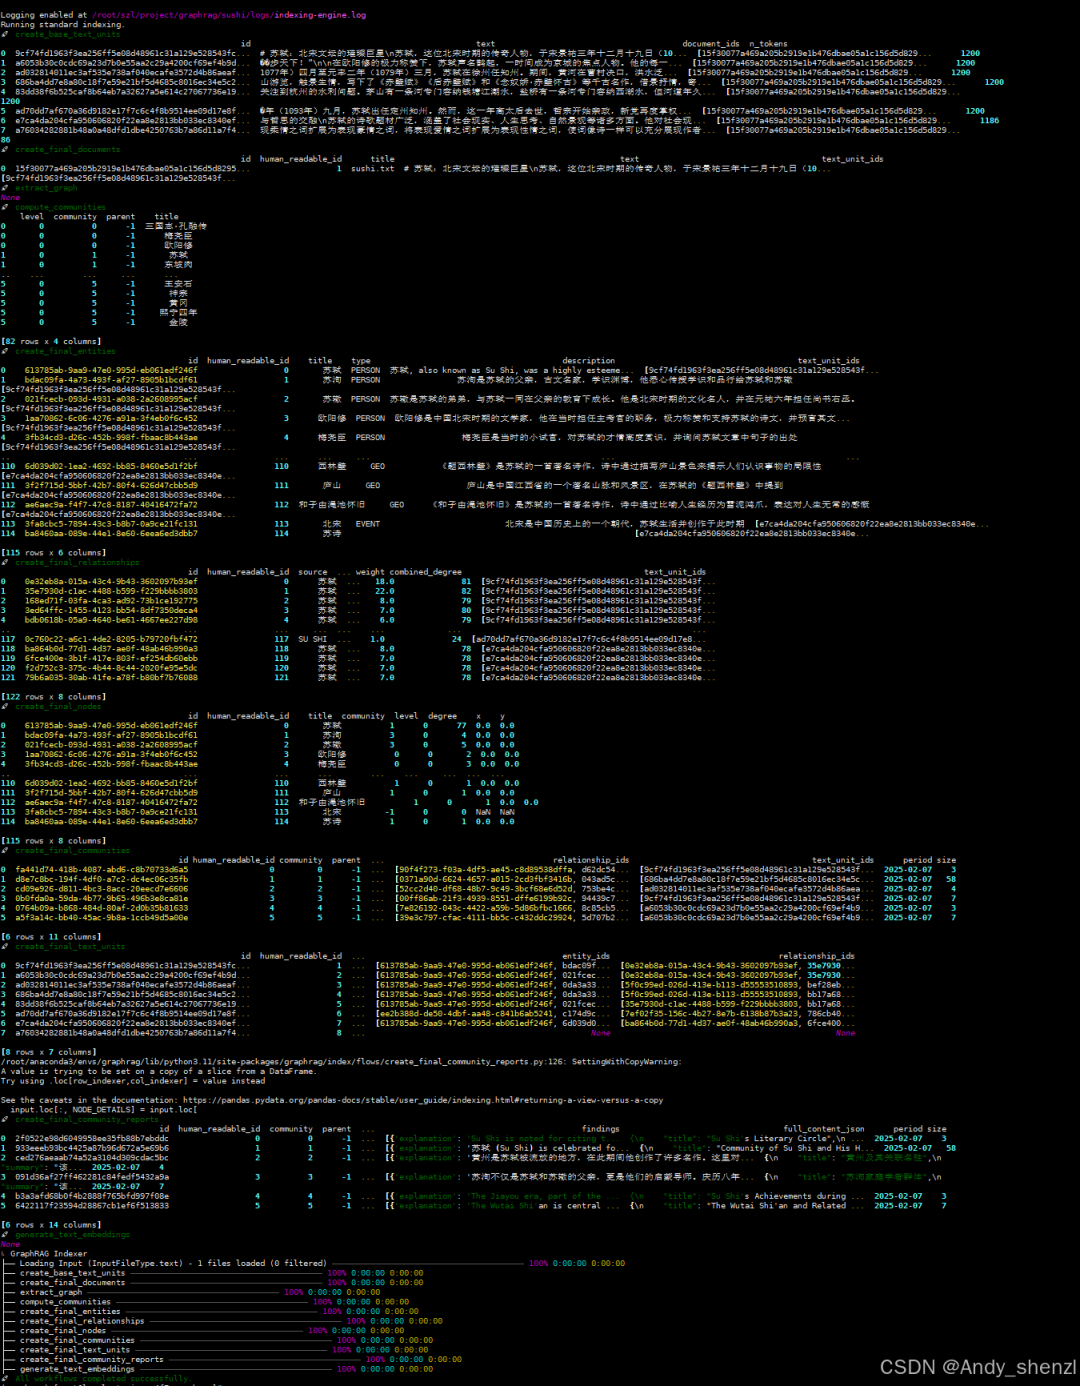
(graphrag) [root@local-7 graphrag]# graphrag index --root ./sushi

运行过程如下整个过程会比较长,与input里面的文件大小有关 输出:
ounter(line
All workflows completed successfully.

表示创建完成

3.5 输出结果信息

GraphRAG在索引阶段构建的知识图谱的确是以 Parquet 格式保存的!索引阶段的输出文件中,Parquet 文件存储了知识图谱的各个核心组成部分,例如实体、关系、社区信息以及文本单元等。这些文件共同组成了一个完整的知识图谱。索引阶段的主要输出内容如下:
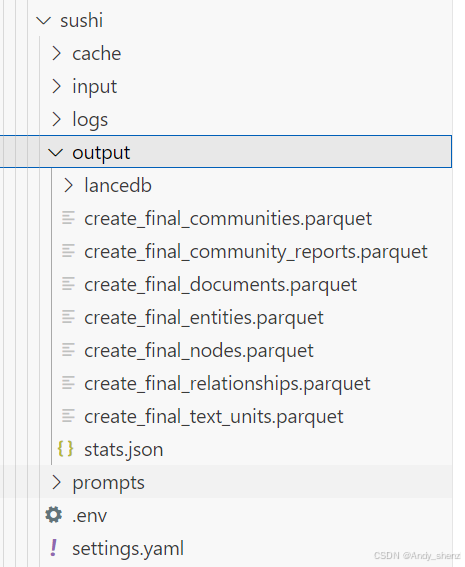
  1. 实体表(Nodes Table)
  • 文件名:create_final_nodes.parquet
  • 内容:知识图谱中的实体节点(例如:人、地点、组织)。
  • 包含信息:
  • 实体的名称(如 “John Doe”)。
  • 实体的类别(如 “PERSON”, “ORGANIZATION”, “LOCATION”)。
  • 与社区相关的信息(如实体所属的社区)。
  • 实体的度数(degree),表示该实体在图谱中的连接数。
  1. 关系表(Relationships Table)
  • 文件名:create_final_relationships.parquet
  • 内容:知识图谱中实体之间的关系(即图谱的边)。
  • 包含信息:
  • 两个实体之间的关系描述(例如 “works for”, “lives in”)。
  • 关系的强度(数值化,用于衡量关系的显著性或重要性)。
  1. 嵌入向量表(Entity Embedding Table)
  • 文件名:create_final_entities.parquet
  • 内容:实体的语义嵌入,用于表示实体的语义信息。
  • 用途:支持语义搜索(通过嵌入计算实体之间的相似性)。
  1. 社区报告表(Community Reports Table)
  • 文件名:create_final_community_reports.parquet
  • 内容:社区的摘要信息。
  • 用途:支持全局搜索(通过社区信息回答关于数据集整体的问题)。
  1. 文本单元表(Text Units Table)
  • 文件名:create_final_text_units.parquet
  • 内容:被切分的原始文本单元(TextUnits)。
  • 用途:将知识图谱和原始文本结合,为 LLM 提供上下文支持。
  1. 社区表(Community Table)
  • 文件名:create_final_Communities.parquet
  • 内容:每个社区基本情况。
  1. 文件表(Documents Table)
  • 文件名:create_final_documents.parquet
  • 内容:用于记录所有参与知识图谱构建的文件情况。

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇

​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书

在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:


三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

GraphRAG:一种新型的RAG技术 微软前几天发布的 GraphRAG 架构非常厉害,但是具体的原理和内容可能不太好理解。Neo4j 的 CTO 写了一篇详细的文章《GraphRAG 宣言:为 GenAI 增加知识》,通俗易懂的介绍了 GraphRAG 的原理、与传统 RAG 的区别、GraphRAG的优势、知识图谱的创建和利用知识图谱工作。 阅读详情

相关推荐

20、graphRAG的原理及代码实战(1)基本原理介绍(上)

GraphRAG通过利用大模型从原始文本数据中提取知识图谱来满足跨上下文检索的需求。该知识图将信息表示为互连实体和关系的网络,与简单的文本片段相比,提供了更丰富的数据表示。这种结构化表示使 GraphRAG 能够擅长回答需要推理和连接不同信息的复杂问题。具体来看,GraphRAG 定义了一个标准化数据模型,整体框架由几个关键组件组成,分别用于表示文档、TextUnit、实体、关系和社区报告等实体。像传统RAG一样,GraphRAG 过程也涉及两个主要阶段:索引和查询。我们依次展开来进行讨论。

Andy_shenzl的博客 1738

【LLM大模型】GraphRAG入门学习流程

GraphRAG 是一种基于图的检索增强方法,由微软开发并开源。它通过结合LLM和图机器学习的技术,从非结构化的文本中提取结构化的数据,构建知识图谱,以支持问答、摘要等多种应用场景。GraphRAG的特色在于利用图机器学习算法进行语意聚合和层次化分析,从而能够回答一些高层次的抽象或总结性问题,这是常规RAG系统的短板。

Langchain的博客 1850

21、graphRAG的原理及代码实战(2)基本原理介绍(中)

前文中,graphRAG项目index索引建立完成后,会生成7个parquet文件。为什么用 Parquet 格式保存知识图谱?高效存储:知识图谱中的数据通常是结构化的,包含大量的实体、关系、嵌入等。Parquet 的列式存储能够显著减少磁盘占用,同时提高读取效率。快速读取:查询阶段需要快速加载实体、关系、嵌入等数据到内存中。Parquet 支持按需加载所需的列,避免了不必要的数据读取。

Andy_shenzl的博客 1568

微软GraphRAG框架源码解读(LLMs)

这几天微软开源了一个新的基于知识图谱构建的检索增强生成(RAG)系统:GraphRAG。该框架旨在利用大型语言模型(LLMs)从非结构化文本中提取结构化数据,构建具有标签的知识图谱,以支持数据集问题生成、摘要问答等多种应用场景。GraphRAG的一大特色是利用图机器学习算法针对数据集进行语义聚合和层次化分析,因而可以回答一些相对高层级的抽象或总结性问题,这一点恰好是常规RAG系统的短板。 说实话之前一直有在关注这个框架,所以这两天花了点时间研究了一下源码,结合之前的一些技术文档,本文主要是记录GraphRA

瓦罗兰特顶级C位的博客 2411

22、graphRAG的原理及代码实战(3)基本原理介绍(下)

在GraphRAG的查询阶段,核心任务是基于构建好的知识图谱来检索相关信息并生成回答。具体来说,查询阶段会利用之前在 索引阶段 构建的所有实体、关系和社区报告等信息,结合用户的查询请求,自动选择最相关的上下文,并通过大语言模型(如GPT等)生成智能化的回答。GraphRAG检索方式有两种,本地搜索和全局搜索本地搜索:主要聚焦于回答与特定实体相关的问题,适用于需要理解输入文档中提到的特定实体细节的场景,比如查询 “洋甘菊的治疗特性是什么”,旨在从文档中提取与该特定实体紧密相关的信息。

Andy_shenzl的博客 1585

【Unity人物动画】SALSA With RandomEyes (语音生成嘴型/人物说话) 使用

SALSA使用探索 之前做项目时想做人物说话的嘴部动作,因为我们的语音是AI合成的,语音片段很多,如果能根据语音生成嘴部动画,那将极大便利我们的工作。后面是找到了SALSA的这款插件,并摸索出使用方法。 1 插件介绍 官方网站:https://crazyminnowstudio.com/ 一个能做2D纸片人和3D人物模型嘴部和眼睛动画的插件,由两人组成的独立工作室(疯狂米诺工作室)开发。 插件全名为SALSA With RandomEyes,2014年上架Asset Store,目前是已下架,替换为新版本

里约热内驴的博客 1万+

GraphRAG-入门到实战:1-原理解析-过程详解

GraphRAG是一种基于知识图谱的检索增强生成系统,通过构建结构化知识图谱来提升RAG性能。其核心特点包括:1)使用节点和关系表示实体间的复杂关联;2)支持多种数据源转换;3)采用Parquet格式高效存储知识图谱数据(包括实体表、关系表、嵌入向量等)。系统提供索引和查询两阶段处理,支持全局和局部两种搜索模式,能有效结合LLM能力与结构化知识,适用于企业级知识管理场景。相比传统RAG,GraphRAG更具语义表达力和查询效率。

863

【Unity报错】Unity导入海康SDK 报错 DllNotFoundException: PlayCtrl assembly

2.尝试按网上其他的办法(包括使用depengs查看dll依赖等)1.先检查Plugins文件夹中是否存在PlayCtrl文件。3.如果网上查阅的办法都不能解决,请继续往下看。更换低版本的SDK库文件。

weixin_42968584的博客 1127

GraphRAG原理及部署实战

RAG在大模型时代,被寄予了厚望,但在近一年多各大小公司的实施过程中,其效果远没有抖音中宣传的那么振奋人心,其原因是多方面的。

Langchain的博客 2324

ChatIE:基于ChatGPT的零样本信息抽取实战指南

信息抽取是自然语言处理中的核心任务,旨在从非结构化文本中自动识别并结构化关键信息,如实体、关系及事件。传统方法依赖大量标注数据训练专用模型,流程复杂且成本高昂。随着大语言模型的发展,通过提示工程引导模型理解任务,实现了无需训练数据的零样本抽取能力,极大降低了技术门槛与应用成本。这种范式将信息抽取重构为多轮对话问题,通过分阶段提问引导模型逐步输出结构化结果,在快速原型验证、领域适配及小规模数据探索中展现出显著技术价值。本文以ChatIE项目为例,深入解析如何利用ChatGPT API,通过精心设计的提示词与两

weixin_30540691的博客 405

IEC 62056协议栈深度拆解:从物理层握手到应用层AARQ,一次完整的DLMS通讯抓包分析

本文深入解析IEC 62056协议栈(DLMS/COSEM)的全流程通信机制,从物理层握手到应用层AARQ建立,提供详细的抓包分析和实战指南。涵盖RS-485配置、HDLC帧解析、OBIS编码解读等核心内容,并附有常见故障排查技巧,助力开发者高效实现电能表数据采集。

weixin_29182481的博客 313

GraphRAG的原理及代码实战(2)基本原理介绍(中)

前文中,graphRAG项目index索引建立完成后,会生成7个parquet文件。 为什么用 Parquet 格式保存知识图谱?

python1234567_的博客 552

Plant Simulation新手入门:从零开始搭建工厂布局仿真模型(附完整代码)

本文为Plant Simulation新手提供了一个从零开始搭建工厂布局仿真模型的完整实战教程。通过一个玩具工厂车间布局优化的具体案例,详细讲解了从数据准备、模型构建、核心逻辑编程到连接遗传算法进行自动优化的全流程,并附有完整代码示例,帮助读者快速掌握这一工业仿真软件的核心应用。

metal的博客 554

GraphRAG原理及部署实战(GraphRAG系列第一篇)

RAG在大模型时代,被寄予了厚望,但在近一年多各大小公司的实施过程中,其效果远没有抖音中宣传的那么振奋人心,其原因是多方面的。

2401_82469710的博客 775

Unreal5从入门到精通之如何实现移动端触屏滑动手势

随着移动设备的普及,越来越多的游戏和应用选择在移动平台上发布。Unreal Engine 5(UE5)作为一款强大的游戏引擎,提供了丰富的工具和功能,帮助开发者打造出色的移动体验。UE5不仅提升了图形质量,还大幅简化了开发流程,使得开发者能够更专注于游戏设计和用户体验。在移动游戏中,触屏滑动手势是用户与应用互动的主要方式之一。然而,许多开发者在实现这些功能时常常遇到困难。为了填补这一知识空白,本篇文章将详细介绍如何在UE5中实现移动端触屏滑动手势,帮助你从入门到精通,提升你的开发技能。

TxNet 1138

程序化广告ADX系统架构设计与实现

摘要: 本文详细介绍了程序化广告交易平台(ADX)的系统架构设计与实现。ADX作为连接广告主与媒体的核心平台,采用基于腾讯云和阿里云的微服务架构,包含网络基础设施、负载均衡、消息处理、核心业务服务和多级数据存储等层次。重点解析了Kafka消息队列处理高并发广告请求、Redis实时统计关键指标等核心技术实现,并提供了Java代码示例展示广告请求处理、竞价流程等核心功能。该系统通过分层设计和分布式组件,实现了高性能、高可用的程序化广告交易能力。

私聊前往站内信:https://i.youkuaiyun.com/#/msg/chat/weixin_44976692 770

GraphRAG原理及部署实战,大模型入门到精通,收藏这篇就足够了!

RAG在大模型时代,被寄予了厚望,但在近一年多各大小公司的实施过程中,其效果远没有抖音中宣传的那么振奋人心,其原因是多方面的。这篇文章就RAG中的一个弱项–局部性来展开讨论。

瓦罗兰特顶级C位的博客 907

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

GraphRAG的原理及代码实战(3)基本原理介绍(下)

具体来说,查询阶段会利用之前在 索引阶段 构建的所有实体、关系和社区报告等信息,结合用户的查询请求,自动选择最相关的上下文,并通过大语言模型(如GPT等)生成智能化的回答。

python1234567_的博客 426

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

微软GraphRAG原理介绍(附带部分源码)

这篇文章主要介绍了微软开源的GraphRAG的数据构建原理和查询检索原理

luxinfeng的博客 6614

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

【入门教程】GraphRAG 结构化检索增强生成 :从原理到实战

GraphRAG是一种基于知识图谱的检索增强生成方法,相比传统RAG具有显著优势。它通过将文本转化为知识图谱,利用实体和关系进行结构化检索,能够处理跨文档、多跳推理等复杂问题。GraphRAG流程分为索引和查询两阶段:先构建知识图谱并检测社区,再通过全局和局部检索生成连贯答案。这种方法特别适合需要深度推理的场景,如跨文档问答、知识管理等。虽然计算成本较高,但能提供更精准、更具逻辑性的回答。微软已开源GraphRAG实现,用户可通过准备数据、构建索引、运行查询等步骤进行实践应用。

哒哒哒哒 哒哒 1044

【大模型系列篇】最强检索增强技术GraphRAG基本原理详解

GraphRAG技术的核心原理在于将知识图谱与图机器学习相结合,通过结构化的知识表示和高效的图算法,提升大型语言模型在处理复杂数据时的理解和推理能力。具体来说,GraphRAG首先将非结构化的文本数据转换为结构化的图谱形式,其中文本中的实体和概念被视为图中的节点,而它们之间的关系则构成节点之间的边。最后,由于GraphRAG需要处理大量外部数据,包括敏感的个人信息或商业机密,如何在确保模型性能的同时保护隐私和遵循道德规范,是其未来发展需要考虑的重要问题。

木亦汐丫 2587

【大模型:知识图谱】--GraphRAG基本原理+实战

本文介绍了基于知识图谱的检索增强生成技术GraphRAG,这是一种解决大模型幻觉问题、提升输出可靠性的创新方案。文章首先阐述了GraphRAG的技术原理,包括知识图谱构建(实体关系抽取、社区检测等)和智能检索(全局搜索与局部搜索)两个核心阶段。接着详细说明了从文本到知识图谱的完整流程,包括索引构建和查询处理。最后通过西游记文本的实战案例,展示了GraphRAG的具体应用,包括环境部署、知识图谱构建和可视化呈现。该技术通过结构化知识表示和推理能力,显著提升了复杂知识场景下的问答质量。

我是个好人呀,O(∩_∩)O 1361

GraphRAG原理

向量和图谱是两种重要的知识载体,当然大模型时代参数可能是更重要的载体,但是目前来讲太大了,暂时还没有端侧的有效模型可用。向量的神奇之处在于它们各自以编码形式捕获了其对应文本的本质,向量的价值更多体现在相似度计算上,也就是你需要确定一段文本与另一段文本的相似度时。但是,如果你想理解向量内部的含义、了解文本中表示的事物、洞察其与更大规模语境的关系,那使用向量表示法就无能为力了。

大模型研究中心 1124

一文带你解读GraphRAG:什么是GraphRAG?GraphRAG 的应用场景、工作原理,GraphRAG的实现示例

GraphRAG 是检索增强生成领域的一个重要进展。GraphRAG 不使用非结构化的文本,而是利用知识图谱的力量ーー实体的结构化表示、属性以及它们之间的关系。通过以这种结构化的格式表达,GraphRAG 可以克服传统 RAG 方法的局限性。知识图谱可以更精确和全面地检索相关信息,使模型能够产生不仅事实准确而且与上下文相关并涵盖查询所需方面的答复。社区摘要: 对于知识图谱中检测到的每个社区,使用 LLM 生成自然语言摘要。这些摘要描述了每个社区中的关键实体、关系和主题。

m0_56255097的博客 5651
上一篇: 如何在零项目经验的前提下准备LLM和Agent方面的经验
下一篇: GraphRAG的原理及代码实战(2)基本原理介绍(中)
AI_小站
博客等级 码龄3年 6255粉丝 1154原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值