Transformer+Mamba黄金组合!长文推理性能飙升3倍,性能还更强

Jamba混合架构解析:Mamba+Transformer+MoE工程实践 大语言模型面临长上下文建模、局部精度保障与计算成本控制的三重挑战。状态空间模型(SSM)以线性复杂度突破注意力瓶颈,Transformer 仍不可替代地承担高保真局部交互任务,而稀疏化专家系统(MoE)则提供可扩展的算力调控能力。Jamba 并非简单拼接三者,而是通过分层协同设计——前置 Mamba 处理长程依赖、中段 Transformer 精细建模、后置 MoE 动态调度计算资源——在真实硬件约束下实现性能与效率的再平衡。本文聚焦该混合架构的代码级实现逻辑、微调避坑要点及推理部署实操,覆盖 Huggin 阅读详情
【导读】Nemotron-H模型混合了Transformer和Mamba架构,使长文本推理速度提升3倍,同时还能保持高性能,开源版本包括8B和56B尺寸。训练过程采用FP8训练和压缩技术,进一步提高了20%推理速度

过去几年,Transformer虽稳坐AI架构「铁王座」,但其二次方复杂度带来的算力消耗和长序列处理瓶颈,限制了大模型在推理阶段处理长文本。

Mamba凭借「线性复杂度」异军突起,非常适合长序列任务,有望成为Transformer架构的替代品,但在处理全局关系上偏弱。

Mamba+Transformer混合架构可以将二者的优势互补,实现「效率」和「性能」的双丰收。

最近英伟达发布了Nemotron-H系列模型,模型尺寸为8B和56B(蒸馏版本47B),用Mamba-2层替换了Transformer中的自注意力层,关键创新在于对Transformer和Mamba的平衡,实现了高效处理长上下文的同时,还不牺牲模型性能,显著提高了推理速度,并且内存占用更少。
在这里插入图片描述

论文链接:https://arxiv.org/pdf/2504.03624

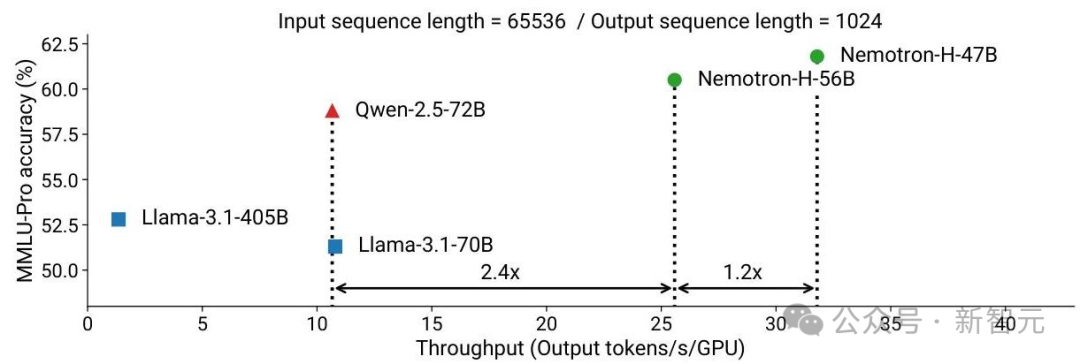
实验结果表明,Nemotron-H模型在准确度上优于同尺寸的开源Transformer模型(例如Qwen-2.5-7B/72B和Llama-3.1-8B/70B),同时在推理速度上提速3倍。
图片

为了进一步提高推理速度并降低推理时所需的内存量,研究人员使用一种剪枝和蒸馏压缩技术MiniPuzzle,将56B尺寸的模型蒸馏为NemotronH-47B-Base,在基准的准确率上与56B模型相当,同时推理速度提升20%

论文中还提出了一种基于FP8的训练方案,使56B模型实现了与BF16训练相当的性能。

Nemotron-H架构

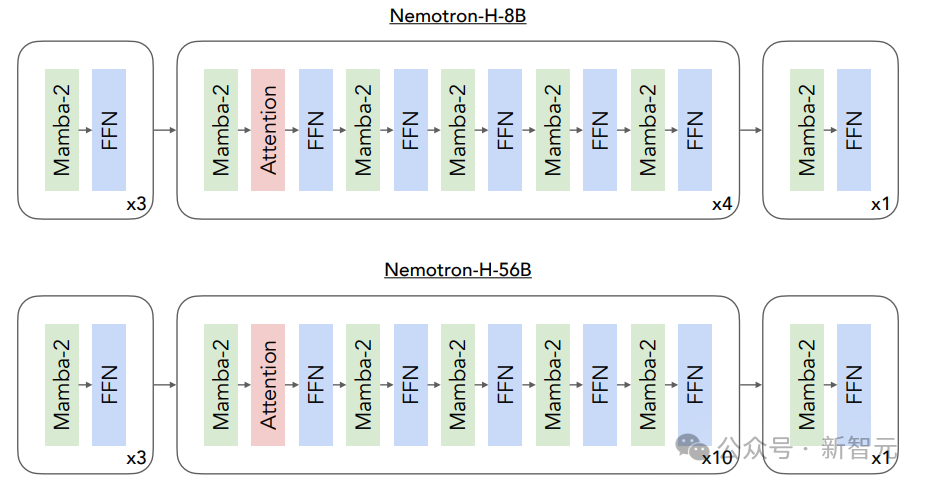
Nemotron-H模型由Mamba-2、自注意力层和前馈神经网络(FFN)层组成,其中总层数的8%为自注意力层,均匀分布在模型中。
图片

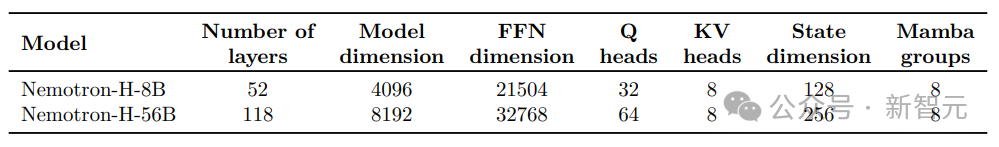
即,Nemotron-H-8B模型包含52层,其中4层为注意力层;Nemotron-H-56B模型包含118层,其中10层为注意力层,其余层平均分配为FFN层和Mamba-2层。

为了与标准Transformer模块的结构一致,研究人员提出三条设计准则:模型的第一层必须是Mamba-2层,最后一层必须是FFN层,并且自注意力层总是位于FFN层之前。
图片

模型的具体参数

需要注意的是,8B和56B模型在FFN隐藏维度、注意力查询头和状态维度设置上存在差异;

  • 对于Mamba-2层,保持默认的头维度(64)、扩展因子(2)和卷机窗口(4);

  • 使用RMSNorm进行归一化;

  • 不适用位置嵌入;

  • 模型的嵌入层和输出层使用了独立的权重,没有使用线性层的偏置权重,也没有使用dropout;

  • 在每个Mamba-2层、自注意力层和FFN层周围都加入了残差跳跃连接。

训练过程

数据准备

训练数据从来源上大体上可以分为多语言、网络爬取、学术、代码、维基百科和数学数据,这种数据组合可以全面覆盖通用知识,同时在编程和数学等领域培养强大的专业能力。

其中多语言数据涵盖了九种语言:德语、西班牙语、法语、意大利语、葡萄牙语、中文、日语、韩语和俄语。

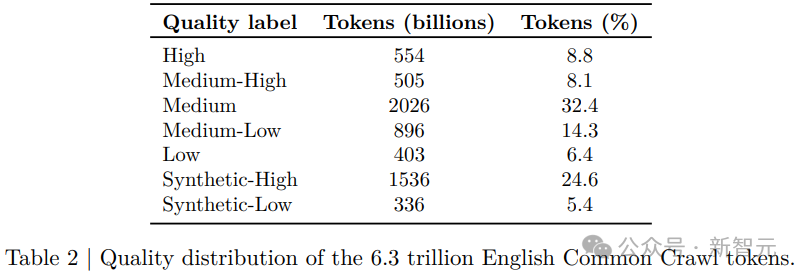
研究人员设计数据组合时,确保所有相同质量的数据源权重相似,而高质量的数据源权重会高于低质量的数据源。
图片

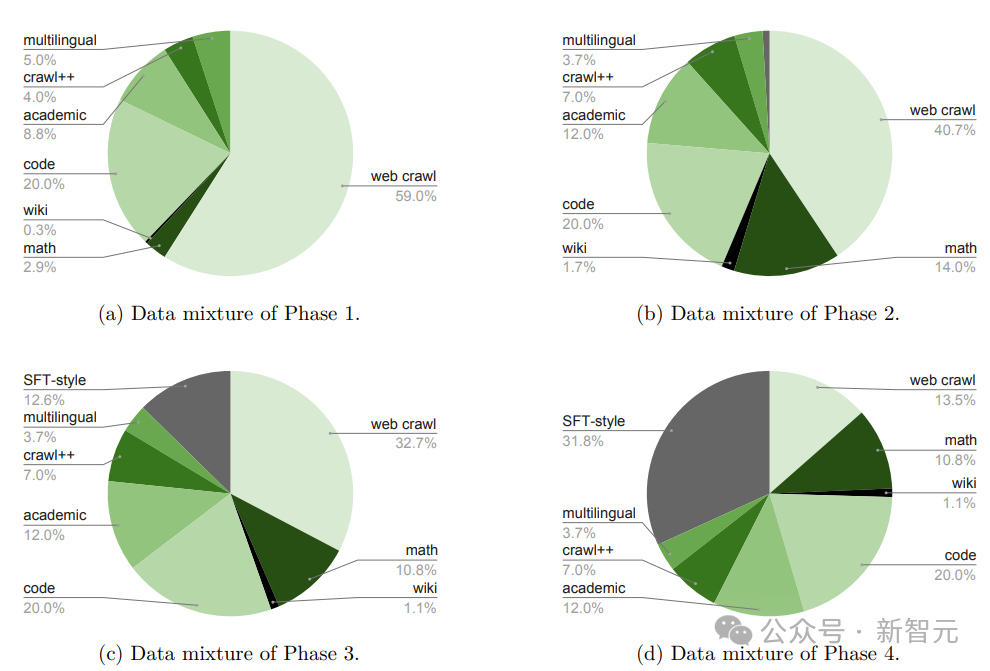
在训练56B尺寸的模型时,使用了大约20万亿个token的数据,其中,网页爬取数据占比最大,达到了59%,其次是代码数据,占20%,学术内容占8.8%
图片

在预训练Nemotron-H基础模型时,研究人员采用了分阶段的数据混合方法:

第一阶段,使用一种促进数据多样性的数据组合;在第二和第三阶段,主要使用高质量的数据集(例如维基百科),其中第二阶段为训练进度达到60%时,第三阶段为训练进度达到80%时;第四阶段则使用最后3800亿个训练token

在后训练阶段,研究人员调整了数据的分布,更加注重有监督的微调(SFT)样本。

FP8训练策略

Nemotron-H训练的一个创新在于使用8位浮点数(FP8),在降低内存需求和计算成本的同时,还能保持模型的质量,主要包括以下关键点:

采用逐张量(per-tensor)的当前缩放技术,以提高训练的稳定性。

将模型中最初的四个和最后四个矩阵乘法(GEMM)操作保持在BF16精度,以确保关键部分的高精度处理;

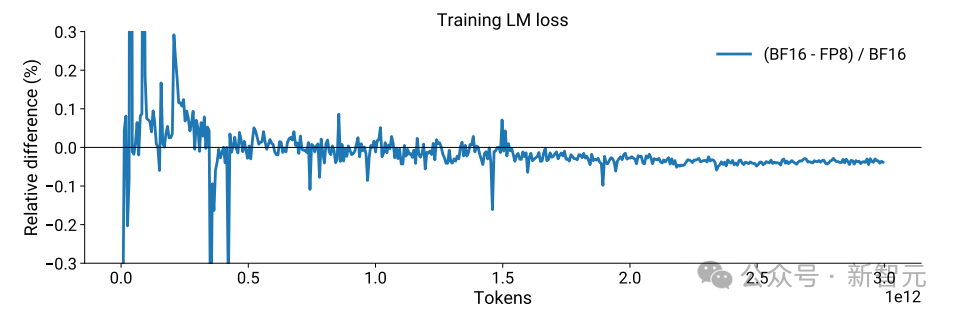
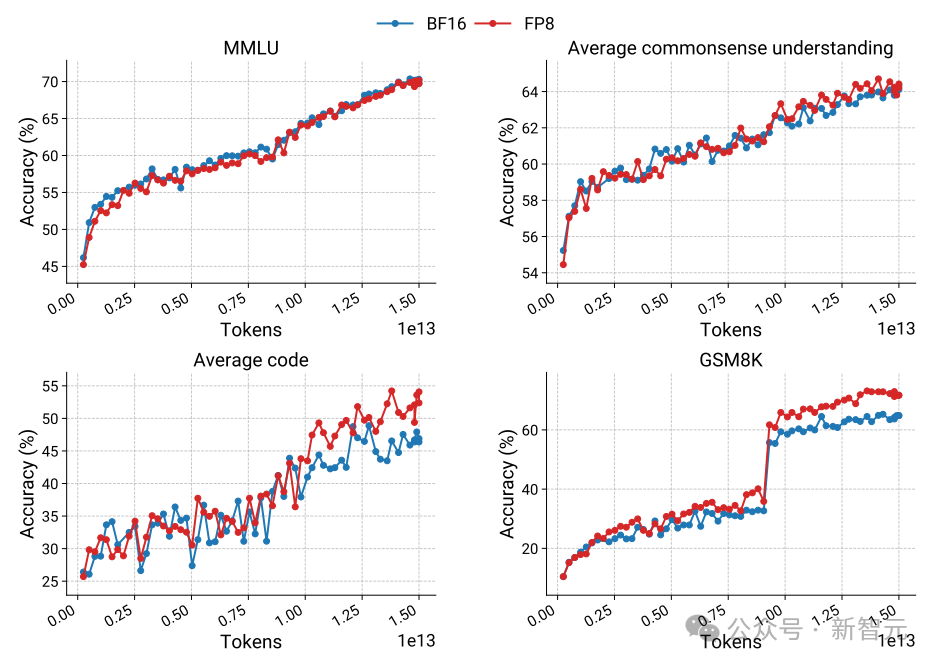
在训练过程中,FP8训练逐渐与BF16训练收敛,最终达到类似的性能水平。
图片

实验结果表明,FP8训练在多种基准测试中能够达到或超过BF16训练的性能,不仅提高了训练效率,还通过在MMLU、常识理解、代码生成和GSM8K等基准测试中的表现,证明了其在保持或提升模型质量方面的有效性
图片

模型压缩

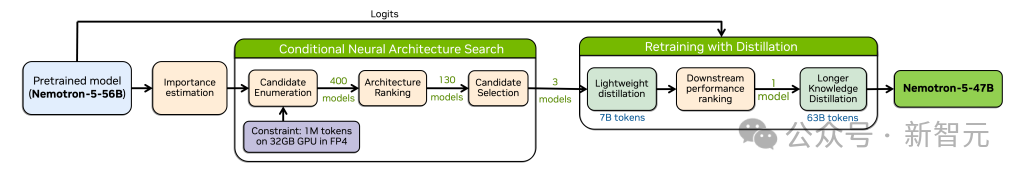
为了进一步提高模型部署的效率,研究人员开发了一种新型压缩框架MiniPuzzle的,结合了剪枝、神经架构搜索和知识蒸馏技术。

MiniPuzzle压缩框架的工作流程如下图所示,展示了从预训练模型到压缩模型的转变过程,包括重要性评估、神经架构搜索和蒸馏等步骤。
图片

MiniPuzzle方法包含五个阶段:

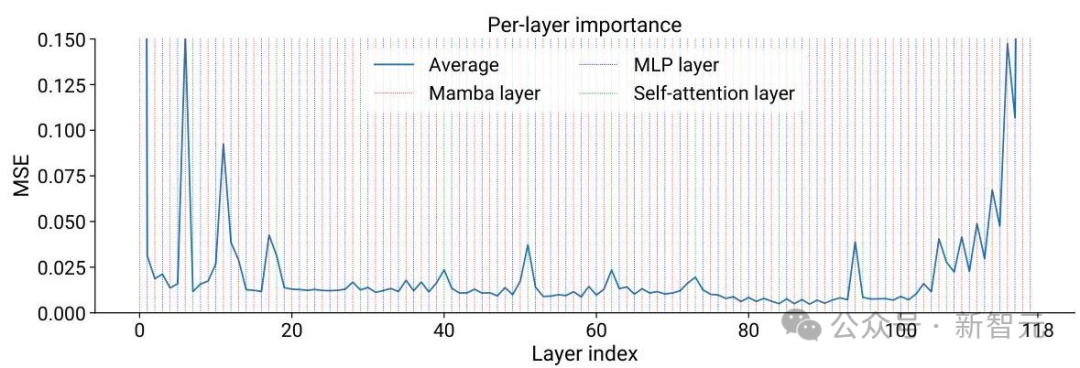
1. 重要度估计: 分析每一层对模型性能的贡献。
在这里插入图片描述

2. 层重要度分析: 研究人员需要分析出哪些层对模型性能的贡献最大。

图片

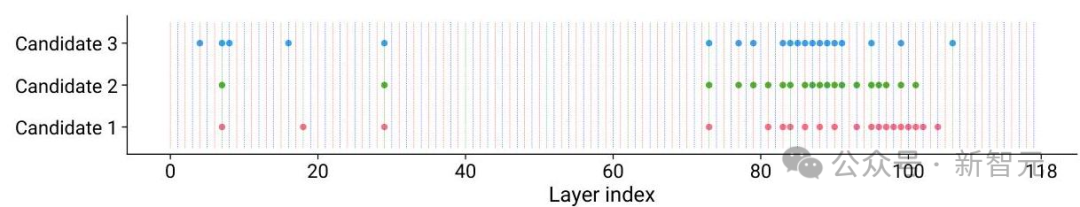
3. 条件神经架构搜索: 探索不同压缩架构方案,在每个候选压缩模型中保留不同的层。
图片

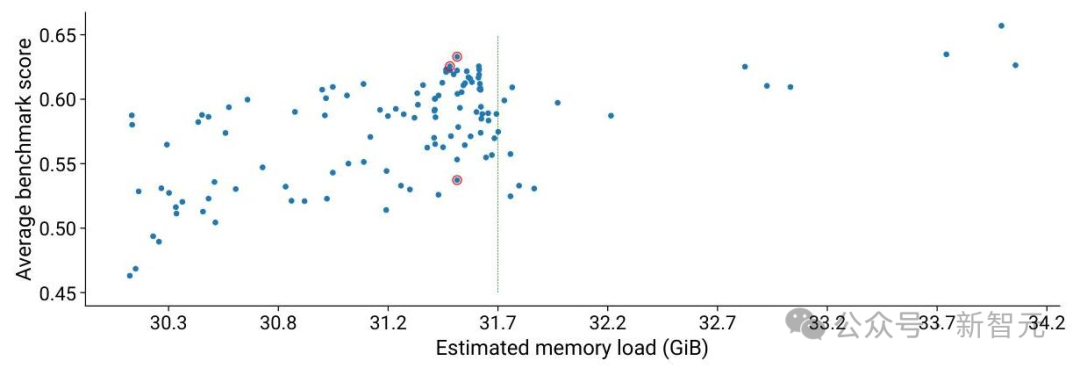
4. 内存与性能权衡: 根据内存使用量和准确度对模型进行评估,对候选架构的内存负载与基准性能进行权衡。
图片

5. 知识蒸馏: 通过训练,使压缩后的模型能够匹配甚至超越原始模型的能力。

通过这一过程,Nemotron-H-56B模型成功被压缩为Nemotron-H-47B模型,参数减少了16%,同时保持了相当的准确度,并将推理吞吐量提高了20%。

实验结果

Nemotron-H模型在性能和效率方面相较于其他基于Transformer的模型取得了显著进步。

推理吞吐量

混合架构使得推理速度大幅提升,尤其是在处理长序列时:

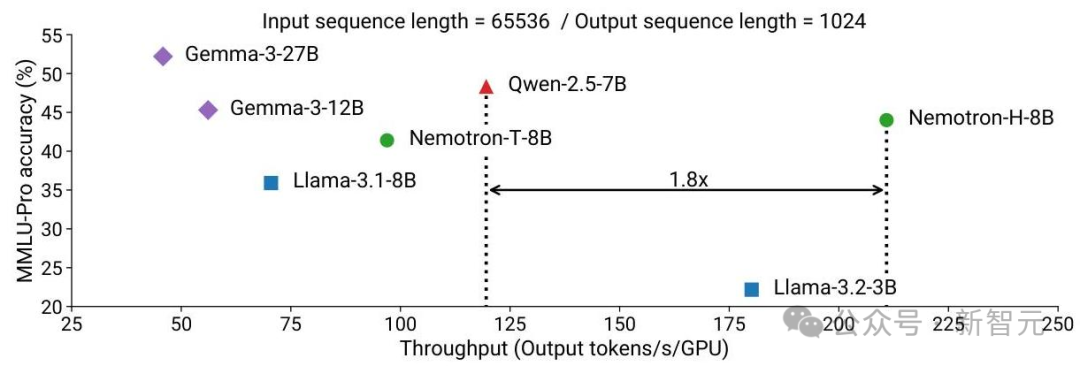
  • Nemotron-H-56B的推理吞吐量比Qwen-2.5-72B和Llama-3.1-70B高出多达3倍。
  • Nemotron-H-8B在类似准确度水平下,比Qwen-2.5-7B的吞吐量高出1.8倍。
图片

效率提升在处理长序列(例如65,536个token)时尤为明显,突显了Mamba层在输出token时计算复杂度固定的优势。

多基准测试中的准确度

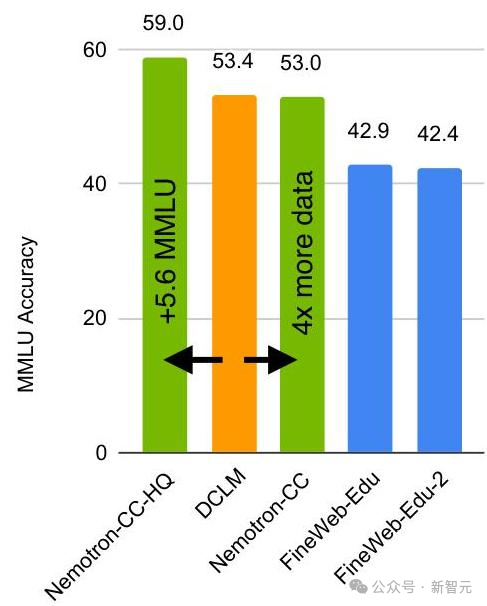
尽管架构发生了变化,但Nemotron-H模型在广泛的基准测试中仍保持了强劲的性能表现。

在评估的17项任务中,Nemotron-H-56B在16项任务中的表现优于Llama-3.1-70B,在数学推理任务上表现尤为出色。
图片

应用与多功能性

Nemotron-H模型可以进行扩展,以适应各种应用场景。

  • 视觉-语言能力: 基础模型通过NVLM-D架构扩展,创建了视觉-语言模型(VLM),在VQAv2、GQA和VizWiz等基准测试中表现出色,显示出混合架构对多模态任务的适应性。

  • 代码生成: 模型在与代码相关的任务上表现尤为出色。训练数据中包含大量代码数据(占比20%),使得模型能够理解和生成多种编程语言的高质量代码。

  • 长文本处理: 混合架构的一个显著优势是能够高效处理长文本。Nemotron-H-8B模型经过专门的长文本处理能力微调,在RULER基准测试和其他长文本评估任务中表现出色。

  • 针对不同能力的数据分布: 研究人员针对不同的训练阶段精心调整了数据分布,以培养特定的能力,通过调整不同数据类型(网页爬取、代码、数学、学术等)的比例,可以在不需要架构变更的情况下增强模型的特定能力。比如针对STEM能力优化时,训练数据增加了数学和代码内容的比重。

Mamba架构简介
图片

原版Mamba架构

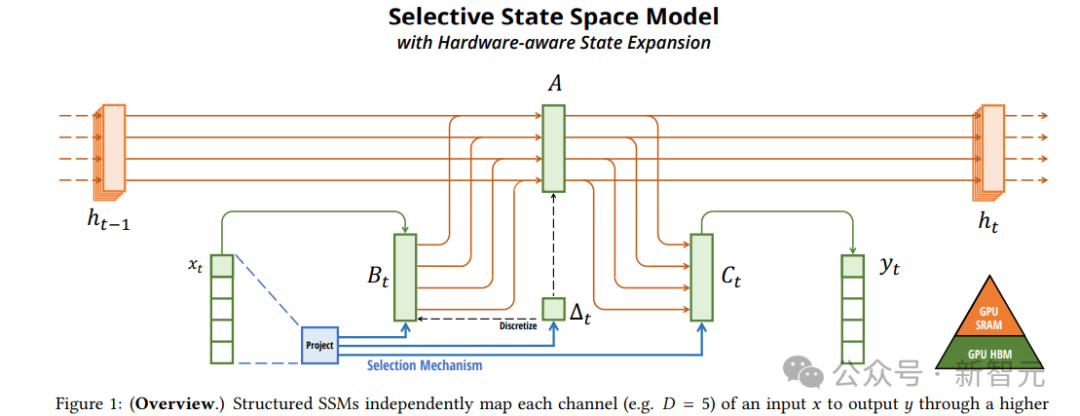
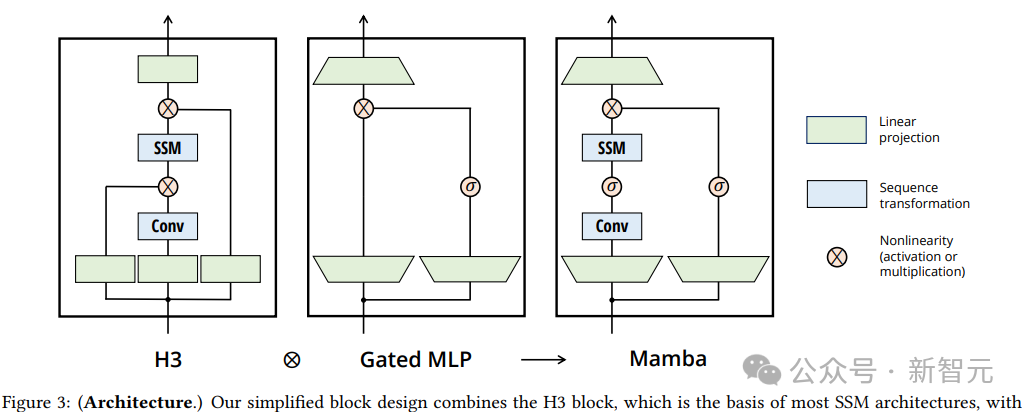
Mamba是一种新型的序列建模架构,通过选择性状态空间模型(Selective State Space Model, SSM)和硬件优化算法,将计算复杂度降低到线性级别O(L),能够高效处理长达百万级的序列长度,推理速度比Transformer快5倍,在短序列任务中也实现了超越Transformer的性能。
图片

图片

选择性SSM的思路是,通过让模型参数依赖于输入内容,实现对信息的选择性传播和遗忘,过滤无关信息,从而提高对密集模态(如语言和基因组)的建模能力。

Mamba中的硬件感知并行算法,可以避免显式存储扩展状态,利用GPU的内存层次结构优化计算过程,实现线性时间复杂度,并显著提升推理速度。
图片

论文链接:https://arxiv.org/pdf/2312.00752

Mamba-2架构

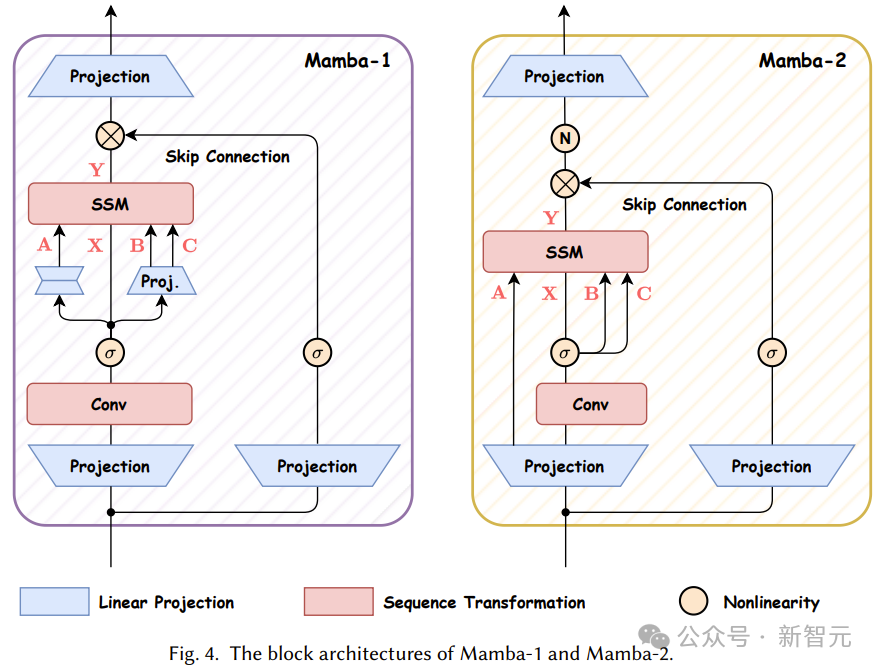
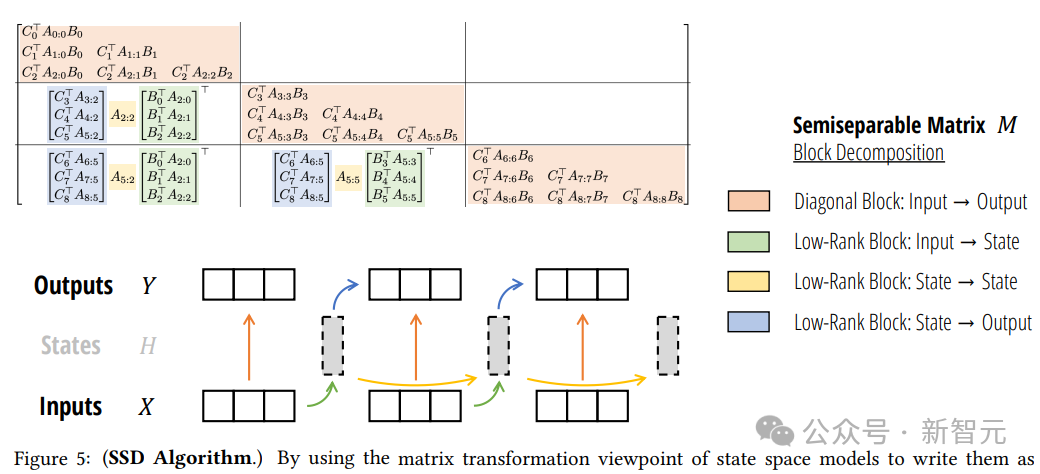
Mamba-2结合了状态空间模型(SSMs)和注意力机制,基于State Space Duality (SSD) 框架,通过结构化矩阵的分解和优化算法,实现了线性扩展的训练效率。

与Mamba相比,Mamba-2对核心层进行了优化,简化了状态转移矩阵的结构,并引入了更大的头维度,从而显著提高了训练效率,速度提高了2-8倍;还引入了多头结构和张量并行等技术,进一步增强了模型的表达能力和并行计算效率,在大规模训练和推理中更加高效。
图片

在实验中,Mamba-2在语言建模和多查询关联回忆任务上均优于Mamba和基于注意力的模型。
图片

论文链接:https://arxiv.org/abs/2405.21060

参考资料:

https://arxiv.org/pdf/2504.03624

如何零基础入门 / 学习AI大模型?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高

那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

全套AGI大模型学习大纲+路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

read-normal-img

640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

在这里插入图片描述
在这里插入图片描述

在这里插入图片描述
在这里插入图片描述

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

img

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

推理速度暴增,Mamba终结Transformer的统治 !! 在这篇关于 Mamba 的文章中,我们来探索这个创新的状态空间模型(state-space model,SSM)如何在序列建模领域带来革命性的变革。Mamba 是由 Albert Gu 和 Tri Dao开发的,因其在语言处理、基因组学、音频分析等领域的复杂序列时表现出色而受到关注。Mamba 采用线性时间序列建模和选择性状态空间,因此在这些不同的应用领域都展现出了卓越的性能。本文,我们将深入了解 Mamba 是如何解决传统 Transformer 在处理长序列时遇到的计算挑战的。 阅读详情

相关推荐

【Mamba和Transformer的关系】

Mamba 和 Transformer 都是深度学习模型架构,用于处理序列数据(如自然语言、时间序列等),但它们的核心机制和计算方式有所不同。KV 缓存(Key-Value Cache):为了优化推理时的计算量,Transformer 会缓存已计算的 key 和 value,但仍然受到存储和计算限制。计算复杂度 O(N²):注意力机制的计算量随着序列长度 N 的增加呈二次增长,因此在处理超长序列时成本高昂。Mamba 不是 Transformer 的直接替代,而是对长序列任务的一种更高效的架构选择。

zzzyyy8的博客 1294

一文通透想颠覆Transformer的Mamba:从SSM、HiPPO、S4到Mamba(被誉为Mamba最佳解读)

如本文开头所说,mamba论文的一作Albert Gu多年来一直在推动SSM的发展他在SSM的基础上,通过此篇论文《》首次提出了结构化状态空间S4(这里有关于S4的更多论文),但这篇论文的可读性比较差当然,作者在YouTube上有一个关于这篇S4论文的精彩解读,比S4论文的可读性提高很多,且本文中也应用了其中的部分PPT截图,但还可以更加通俗易懂。

结构之法 算法之道 44万+

AI Transformer:最新进展及其应用场景解析

作者:禅与计算机程序设计艺术 1.简介 随着人工智能(AI)技术的飞速发展,深度学习(DL)和Transformer模型已经成为最具代表性的两个研究方向。近年来,两者在自然语言处理、图像识别、文本生成等领域均取得重大突破,在各行各业产生了广泛影响。本文将从最新研究成果和相关应用角度出发,综合介绍下Tra

AI天才研究院 3265

挑战Transformer:全新架构Mamba详解!

作者|绝密伏击 编辑|汽车人原文链接:https://zhuanlan.zhihu.com/p/684231320点击下方卡片,关注“自动驾驶之心”公众号戳我-> 领取自动驾驶近15个方向学习路线>>点击进入→自动驾驶之心『Mamba』技术交流群本文只做学术分享,如有侵权,联系删文背景“屹立不倒的 Transformer 迎来了一个强劲竞争者。自 2017 年被提出以来...

CV_Autobot的博客 8186

WebRTC音频传输实战:从采集到播放的完整链路解析(附RTP包处理细节)

本文深入解析了WebRTC音频传输的完整链路,从麦克风采集、音频处理与编码,到RTP打包、网络发送,再到接收端的NetEQ抗抖动处理与最终播放。文章以Linux PulseAudio为例,详细剖析了线程模型、缓冲区管理及RTP包处理等关键细节,旨在帮助开发者优化实时音频应用的延迟、卡顿与回声问题。

tea88的博客 853

ESP32语音交互实战:离线唤醒与DeepSeek大模型集成

本文详细介绍了如何将ESP32-S3开发板与天问ASRPRO语音模块结合,实现离线语音唤醒并集成DeepSeek大模型的智能交互系统。通过串口通信与API调用,系统可处理本地指令及复杂语义请求,适用于低成本、高隐私保护的AIoT语音交互场景。

rust6ferris的博客 869

【AI大模型】Transformer+Mamba黄金组合!长文推理性能飙升3倍,性能还更强

过去几年,Transformer虽稳坐AI架构「铁王座」,但其二次方复杂度带来的算力消耗和长序列处理瓶颈,限制了大模型在推理阶段处理长文本。 Mamba凭借「线性复杂度」异军突起,非常适合长序列任务,有望成为Transformer架构的替代品,但在处理全局关系上偏弱。 Mamba+Transformer混合架构可以将二者的优势互补,实现「效率」和「性能」的双丰收。

嘴巴吃糖了 1213

机械臂 关节电机选型计算

电机 机械臂

hisen92的专栏 8983

DeepSeek V4百万token长上下文工程原理与实战

长上下文大模型的核心挑战在于KV缓存爆炸与注意力计算复杂度激增,传统方案受限于O(n²)注意力机制和线性增长的显存需求。DeepSeek V4通过分块注意力、动态KV压缩与零拷贝流式解码三大技术,将百万token推理从理论可能变为工程现实。其本质是融合信息论剪枝、硬件亲和调度与语义感知计算的系统级优化,显著降低显存占用与端到端延迟。该范式已广泛应用于RAG增强、代码库全局理解、法律合规审查等需高保真长程记忆的真实场景,为构建真正具备‘文档级认知’能力的大模型系统提供可复用的技术路径。

weixin_34192816的博客 587

Fastjson2升级指南:如何平滑迁移并避免兼容性问题

本文详细介绍了Fastjson2的升级指南,涵盖兼容性检查、性能调优及零停机迁移方案。通过实战案例展示如何避免常见问题,如日期格式严格校验和字段映射策略变化,并分享高性能配置技巧如JSONB二进制协议和内存池化。帮助开发者平滑迁移至Fastjson2,提升JSON处理效率。

weixin_29016865的博客 411

免费大容量国外网盘测评:冷数据归档与rclone加密接入

云存储的本质,是通过对象存储、冗余编码和分层缓存,把本地磁盘容量问题转化为网络访问与数据管理问题。免费大容量国外网盘常以空间换用户规模或付费转化,容量政策、传输策略、协议支持和退出成本,往往比标称容量更决定长期可用性。支持 WebDAV、S3 兼容和命令行工具的服务,可接入 rclone 等自动化流程,再配合客户端加密与冷热分层,用于冷数据归档、老项目备份和家庭影像保存。理解带宽换算、单文件上限、保活机制与传输一致性后,评估话题型大容量网盘与专业向协议网盘,就能把免费空间纳入可靠存储层。围绕免费大容量国外网

weixin_31292729的博客 213

DeepSeek V4深度解析:MoE架构与200K长上下文的工程落地

大语言模型的稀疏混合专家(MoE)架构正从理论走向规模化部署,其核心价值在于以动态计算分配提升推理效率与显存利用率;长上下文支持则突破传统注意力机制的O(L²)复杂度瓶颈,依赖块感知、滑动窗口等底层重构实现200K级稳定处理。DeepSeek V4作为开源MoE模型代表,将动态专家门控(DEG)与Block-Aware Sliding Window Attention(BASWA)深度融合,在单卡RTX 4090上实现实测32K上下文显存降低38%、首token延迟412ms,为法律审查、代码理解、教育知识

aiqixiao2017的博客 517

10、X射线聚焦与光学元件技术解析

本文深入解析了X射线聚焦与光学元件技术,重点讨论了椭圆镜的聚焦原理及局限性,多层镜的设计优化及其突破性应用,以及X射线波导的基础理论和模式求解方法。文章还总结了这些技术的优势、局限及其在材料科学、生物学和医学等领域的广泛应用前景。通过理论推导与技术改进,这些光学元件为X射线成像技术的发展提供了重要支撑。

pz890123的博客 121

M2.7开源模型实现合成数据闭环自训练实战指南

合成数据闭环是当前大模型低成本持续进化的核心范式,其本质是通过模型自我生成、评估与迭代训练,替代高成本人工标注。该技术依托自训练(Self-Training)、指令微调(Instruction Tuning)与能力探针(Capability Probe)三大支柱,在保障数据质量前提下显著提升模型在垂类任务中的泛化性与鲁棒性。典型应用场景包括金融客服响应优化、法律条款精准解读、电商大促突发query应对等需快速适应数据漂移的工程实践。MiniMax-M2.7作为首个将合成数据闭环深度集成至官方训练管线的开源主

dichengyan0013的博客 432

CesiumForUnreal实现鹰眼地图(MiniMap)效果

CesiumForUnreal实现鹰眼地图(MiniMap)效果

专注GIS开发 3951

Allegro如何进行四层板板层设计

板层的设计

weixin_42499230的博客 3189

极市平台 | 首个Mamba+Transformer混合架构多模态大模型来了,实现单卡千图推理

LongLLaVA(长上下文大型语言和视觉助手)这一创新性混合架构模型,在长上下文多模态理解方面表现出色。该模型集成了 Mamba 和 Transformer 模块,利用多个图像之间的时空依赖性构建数据,并采用渐进式训练策略。

csdn_xmj的博客 2050

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

Mamba+Transformer,可实现超Transformer5倍吞吐量!

Mamba-Transformer专家模型:提出了一个多尺度混合Mamba-Transformer专家模型(SST),通过结合Mamba和Local Window Transformer(LWT)来分别处理长时序的全局模式和短时序的局部变化。综合性能提升:在多个领域和任务中,SSMs展现出与Transformer竞争的性能,特别是在语言领域任务中,SSMs在标准回归上下文学习(ICL)任务中表现出色,与Transformer相比,在稀疏奇偶性学习任务中表现更优。

2401_88556812的博客 2423

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

Transformer、RNN和Mamba的联系!

本文深入探讨了Transformer、循环神经网络(RNN)和状态空间模型(SSM)之间的潜在联系。文章首通过这些分析,展示了看似不同的模型架构之间存在深层联系,为未来模型设计和跨架构思想交流提供了新的视角和可能性。​。

xxue345678的博客 1022

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

2025年,Mamba 与 Transformer “联姻”,视觉领域迎来了大动作!

【AI架构革新:Mamba与Transformer融合引领2025新趋势】计算机视觉与自然语言处理领域迎来重大突破:英伟达团队提出的MambaVision混合架构入选CVPR2025,通过CNN与改进型Mamba-Transformer的层级组合,在保持高精度的同时提升处理速度;腾讯Hunyuan-TurboS成为首款结合两种架构的MoE模型,突破长序列处理瓶颈。Dimba等创新模型采用交替堆叠设计,实现线性复杂度与全局注意力的优势互补。研究显示,混合架构在图像生成(FID指标)和语义理解(T2I-Comp

2501_91624122的博客 1550

PhysMamba:利用双流交叉注意力SSD进行远程生理测量

此外,本文还引入了交叉注意力状态空间对偶(CASSD)模块,以提高在远程生理测量任务中的性能。与实验室环境不同,在真实环境下通常存在运动伪影和噪声等因素,这会影响现有方法的性能表现。该模型集成了最先进的Mamba-2模型,并利用双流架构来学习不同的rPPG特征,从而增强其在嘈杂条件下的稳健性能。通过使用PURE、UBFC-rPPG和MMPD进行验证实验,结果显示PhysMamba在各种场景下都达到了最先进水平,并尤其在复杂环境中展示出其在实际远程心率监测应用中潜力巨大。

u014546828的博客 1002

Mamba+Transformer混合架构多模态大模型

多模态大语言模型(MLLMs)的快速进步展示了它们在各个应用领域中的显著能力。然而,多图像理解场景仍然是一个重要但尚未充分探索的方面。特别是,将 MLLMs 的应用场景扩展到理解更长的视频、更高分辨率的图像以及基于更多历史信息的决策,对于提升用户体验和进一步拓展 MLLMs 的应用范围至关重要。然而,将 MLLM 的上下文长度扩展以提高其可用性,面临着处理更多图像时性能下降和计算成本高昂的挑战。一些研究专注于构造包含多个图像的长上下文训练数据,以增强性能。其他研究探索了创新性的训练策略,以减轻性能下降。

2401_84205765的博客 1264

开源AI新协议!AI Agent与前端交互的轻量级协议,轻松构建交互式AI应用!

AI Agent 的兴起让前端交互需求激增,但传统开发中,连接Agent后端与前端需大量定制代码,效率低下。 在 MCP(模型上下文协议)、A2A(Agent-to-Agent 通信协议)之后,AI Agent 的生态正在走向一个更完整的方向:AG-UI 协议横空出世,专为 Agent 与前端应用的通信交互而设计。

bugyinyin的博客 2053

Mamba介绍,和Transformer对比

之后,又进一步提出了 Mamba-2,其中的结构化空间状态对偶(SSD/Structured Space-State Duality)构建了一个将结构化 SSM 与多种形式的注意力连接起来的稳健的理论框架,可将原本为 Transformer 开发的算法和系统优化技术迁移用于 SSM。表 1 分类总结了相关研究。然而,正如每枚硬币都有其两面,Transformer的注意力机制在赋予其卓越性能的同时,也带来了计算复杂度的显著上升,特别是当面对超长文本序列时,这种二次增长的计算需求成为了制约其应用的一大瓶颈。

u014546828的博客 4903

太能打了!Mamba+Transformer,仅用一半时间准确率提升12%!

CVPR'2025谷歌DeepMind提出的分层协同混合架构创新性地结合Transformer与Mamba优势,突破长序列处理瓶颈:在256K文本分析中实现3倍吞吐提升,1024×1024卫星图像分割速度提高8倍,工业视频异常检测耗时缩减83%且准确率提升12%。同时,跨模态领域涌现新突破——MHAFF方法通过多头注意力融合CNN与Transformer特征,将牛只识别准确率推至99.88%;水稻病害检测研究则证实ResNet50结合迁移学习优于ViT和传统方法。这些进展为工业质检、农业智能

m0_73122726的博客 555

Mamba详细介绍和RNN、Transformer的架构可视化对比

看完这篇文章,我希望你能对Mamba 和状态空间模型有一定的了解,最后我们以作者的发现为结尾:作者发现模型与相同尺寸的Transformer模型的性能相当,有时甚至超过了它们!作者:Maarten Grootendorst。

deephub 1万+
上一篇: [特殊字符] 你真的了解大模型怎么“调”?四种主流LLM微调方法详解!
下一篇: 读过唯二好的优质大模型书籍,同时得到吴恩达和Josh Starmer两位大佬的推荐和好评
AI_小站
博客等级 码龄3年 6255粉丝 1152原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值