初学者如何对大模型进行微调?

【AI】大模型训练的常用图像数据集 关于数据集的获取,常见的数据集。 阅读详情

粗略地说,大模型训练有四个主要阶段:预训练、有监督微调、奖励建模、强化学习。

预训练消耗的时间占据了整个训练pipeline的99%,其他三个阶段是微调阶段,更多地遵循少量 GPU 和数小时或数天的路线。预训练对于算力和数据的要求非常高,对于普通开发者来说基本上不用考虑了。

对于开发者来说,如果你有几块GPU显卡,那么就可以尝试微调了。不过在微调之前,我们要弄明白为什么要微调,大模型为什么不能直接用?

一、为什么要微调?

大语言模型的预训练的目标很简单:文字接龙,通过前面的词语预测下一个字也就是预测token序列的下一个token。

预训练基于大规模无监督数据集训练,得到的大语言模型可以保存很多知识,但是可能无法充分利用这些知识来回答问题。

我的理解是预训练就是一个班上学习很好的学霸,不过只会死记硬背,脑袋里记忆了很多知识,但是不会灵活应用这些知识。一般预训练的数据格式如下所示:

在这里插入图片描述

如果将“中国的首都是”输入大模型,大模型做文字接龙,可以很轻松的补全“北京”作为回答。但是如果问题的形式是“中国的首都是哪个城市?”这种疑问句形式的时候,虽然只进行了预训练的大模型大概率也能回答这个简单问题,比如采用Few-shot prompt等方法。

但这种形式的问题如果内容更复杂一些,大模型可能无法很好的作答(尽管预训练语料中可能包含了问题的答案)。这时我们就需要指令微调来挖掘大语言模型的潜力。让大模型不仅仅满足于文字接龙,而是要真正具备逻辑推理、文案总结等能力。

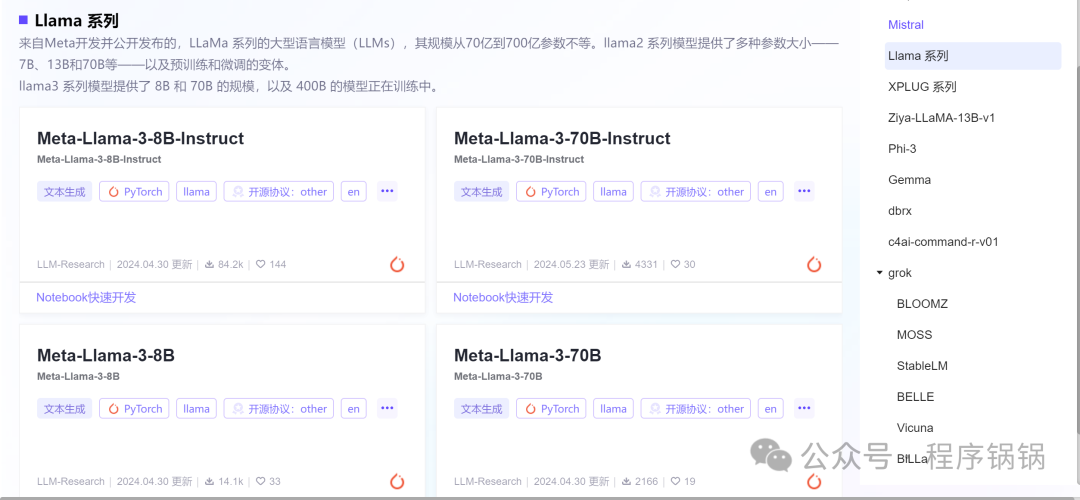
一般来说我们可以在modelscope中搜索最新的大模型,以Llama系列为例子。其中
图片

  • Meta-Llama-3-8B不包含Instruct关键词,说明它只有预训练,未经过指令微调。
  • Meta-Llama-3-8B-Instruct包含Instruct关键词,经过预训练、指令微调。

二、初学者如何微调?

对于初学者来说,我们不需要指令微调来挖掘大语言模型的潜力,虽然这个时候的指令微调相比预训练资源消耗小很多,但是对于初学者来说还是很困难的,在微调过程中会碰到灾难性遗忘、复读机等问题。

我建议初学者做微调是在指令微调模型的基础加入特定领域的数据,比如法律文档、医疗诊断等领域,模型需要调整其参数以更好地理解和执行这些特定任务的要求,微调允许大语言模型在特定任务的数据集上进一步学习,从而提高其在该领域的准确性和表现。

比如我在Qwen1.5-7B-Chat的基础上(Qwen1.5-7B-Chat是一个预训练、指令微调后的大模型),准备训练数据集45366条,测试数据集5032条,再微调大模型来实现商品评论情感分析,准确率高达91.70****%,具体实现方法如下:

微调大模型来实现商品评论情感分析

学习微调最好的办法就是自己亲身实践一遍。在去年的时候微调大模型还是一件比较困难的事情。微调工具链不太成熟,碰到了问题只能一个接一个去提issue,费时费力效果还一般。

不过随着大厂在大模型领域真金白银的投入,适合大模型微调的工具链组件快速发展,从初学者入门的角度出发。我推荐使用LLaMA-Factory统一微调框架,它能够支持数百种大模型的微调,并且集成了大量训练加速算法,比很多大模型repo主页训练方法还要快。下面我们来看一看如何使用它。

1.依赖下载

在这里插入图片描述

如果依赖有问题,可以。

2.大模型下载

这里以Baichuan2-13B-Chat为例。

在这里插入图片描述

默认模型会下载到~/.cache/modelscope/hub中,如果需要修改下载目录,可以手动指定环境变量:MODELSCOPE_CACHE,modelscope会将模型和数据集下载到该环境变量指定的目录中

比如更改默认位置:

export MODELSCOPE_CACHE=/home/test/models

3.数据集构建

(1)使用开源数据集

llama_factory中的 data文件夹提供了大量整理好的开源数据集

(2)构建自己的数据集 比如我我按照alpaca 格式准备数据集,包括 instruction, input, output,history 4条内容,其中instruction、 input 为输入,output 为输出标注,数据文件存储格式一般为json。

在这里插入图片描述

例子如下:

在这里插入图片描述

(3)引入自己的数据集

构建自己的数据集后,需更新 data/dataset_info.json 文件,并将数据集放置data文件夹。

比如我构建了一个数据集test.json,需更新data/dataset_info.json 文件,并将test.json放置于data文件夹。

在这里插入图片描述

4.微调

建议初学者采用web可视化页面微调,启动命令如下:

CUDA_VISIBLE_DEVICES=0 llamafactory-cli webui

其中:CUDA_VISIBLE_DEVICES 指定使用哪块显卡

启动后,微调就更简单了。llamafactory集成了多种微调算法,比如

  • Lora
  • QLora
  • LoRA+
  • Mixture-of-Depths
  • GaLore

等等微调算法,在这里我不想深究它们的具体原理。我建议初学者首先使用Lora微调的方式,只需配置3个参数即可开始微调。

在这里插入图片描述

5.推理

由于采用的是Lora微调,我们需要将原有大模型的权重与自己训练出来的权重合并。

llamafactory也内置了推理模块,只需调1个参数,即可推理,如下图所示:

在这里插入图片描述

下面这张图,是我基于llamafactory做的商品评论情感预测,其中1代表好评,0代表差评。可以看到大模型输出1,代表它认为这条评论是好评。

在这里插入图片描述

三、最后

现在大模型微调的门槛越来越低,市场上有大量开源微调框架。只要你会部署、有机器就能出个结果,赶紧动手玩起来吧!

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。

一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

大模型常用的预训练数据集 此外,该数据集针对不同需求,发布了多个子版本:en(英文数据,806G),en.noclean(未清洗的原始数据,6T),realnewslike(仅包含 Real News 涉及的领域的内容,36G),webtextlike(仅包含来自 Open WebText 中URLs 的内容,17G)和 multilingual (多语言数据,38T)。值得注意的是,该数据集内部充斥着大量的噪声和低质量数据,在使用前必须进行有效的数据清洗,以确保数据质量和准确性,常用的自动清洗工具有 CCNet 等。 阅读详情

相关推荐

大语言模型的指令微调(Instruction Tuning)最全综述:从数据集到技术全解析

此前,我们已经介绍了大模型的三类微调技术(实际案例说明AI时代大语言模型三种微调技术的区别——Prompt-Tuning、Instruction-Tuning和Chain-of-Thought:https://www.datalearner.com/blog/1051681306547159)。但实际上,大模型的微调还可以分成很多种。从微调的参数规模来说,可以简单分为全参数微调和高效参数微调。前者一般是用预训练模型作为初始化权重,在特定数据集上继续训练,全部参数都更新的方法。

具身机器人和通用AI 3万+

收藏丨30个大语言模型训练相关的数据集分享

更多数据集,请访问OpenDataLab官网

OpenDataLab的博客 8549

如何选择StandardScaler、MinMaxScaler和RobustScaler做标准化的对比解释和示例代码

选择合适的标准化方法取决于数据的特点和需求。如果数据分布接近正态分布且无异常值,可以使用。如果需要将数据映射到特定范围内并保持相对关系,可以使用。如果数据中存在异常值或离群点,可以使用进行鲁棒标准化。在分类、聚类算法中,需要使用距离来度量相似性的时候、或者使用PCA技术进行降维的时候,StandardScaler表现更好(避免不同量纲对方差、协方差计算的影响);在不涉及距离度量、协方差、数据不符合正态分布、异常值较少的时候,可使用MinMaxScaler。

qq_36001281的博客 4940

初学者如何对大模型进行微调?微调数据集需要多少?

现在大模型微调的门槛越来越低,市场上有大量开源微调框架。只要你会部署、有机器就能出个结果,赶紧动手玩起来吧!读者福利:如果大家对大模型感兴趣,这套大模型学习资料一定对你有用如果你是零基础小白,想快速入门大模型是可以考虑的。一方面是学习时间相对较短,学习内容更全面更集中。二方面是可以根据这些资料规划好学习计划和方向。包括:大模型学习线路汇总、学习阶段,大模型实战案例,大模型学习视频,人工智能、机器学习、大模型书籍PDF。带你从零基础系统性的学好大模型!😝有需要的小伙伴,可以保存图片到。

2401_84494441的博客 1287

Unity动态创建Avatar骨骼映射

Unity Avatar骨骼映射动态创建,适配Unity通用动画,无需经过第三方建模软件,可运行时创建

Nbin_Newby的博客 1万+

ArcGIS基础:CAD数据转换为GIS数据(符号化显示、数据转换、线转面、空间连接)

1、符号化显示: CAD数据加载进来有很多列表,包含了点【point】、线【polyline】、面【polygon】、标注数据【Annotation】等数据,本次实验我们需要用到的是面数据,也就是.dwgPolygong格式的数据。如下图所示: 把数据加载进来,然后在2处打开属性表,查看CAD数据的属性表,打开后可以发现【layer】图层表示就是地块的用地性质,它就是符号化显示的依据。 我们在数据上右键【属性】,打开图层属性,找到【符号系统】,选择类别中的【唯一值】,然后在【值字段】下拉选择【layer】,

yuanYW7556的博客 2万+

初学者如何对大模型进行微调?看完这一篇你就懂了!

现在大模型微调的门槛越来越低,市场上有大量开源微调框架。只要你会部署、有机器就能出个结果,赶紧动手玩起来吧!大模型很多技术干货,都可以共享给你们,如果你肯花时间沉下心去学习,它们一定能帮到你!

2401_85325726的博客 1005

大模型——Ollama简明教程

在这篇文章中,我们将了解如何使用 Ollama、如何在 Ollama 中创建自己的模型 以及如何使用 Ollama 构建聊天机器人。这是深入研究 Ollama 的第一部分,以及我所学到的有关本地 LLM 的知识以及如何将它们用于基于推理的应用程序。在这篇文章中,你将了解——

1691

大模型初学者必看大模型微调指南:Unsloth官方微调技巧大公开!

本篇分享我们基于Unsloth官方文档结合工作种微调经验,为大家提供了合适的参数选择范围,帮助大家从成百上千种参数组合中快速定位到最优组合,加速微调过程,让初学者也能简单快速上手大模型微调。还在等什么,赶紧按照分享建议的方案去微调属于你的专业领域大模型吧!

python123456_的博客 2587

贝叶斯(Bayes)决策理论

在博文【模式识别PR和模式的概念】介绍了相关的模式识别与模式的概念。在本节描述所要讨论的问题之前,再提一下对于待识别的物理对象的描述问题。假设一个待识别的物理对象用其d个属性观察值描述,称之为d个特征,这组成一个d维的特征向量,而这d维待征所有可能的取值范围则组成了一个d维的特征空间。一般地,机器实现自动分类有两大类方法:一种是模板匹配方法,另一种是对特征空间划分为子空间(每类的势力范围)的方法。

松子茶的专栏 3万+

Codex 100个真实案例 - 用AI做英语单词计划学习工具(记忆曲线+测验)

背单词是英语学习的基本功,但市面上的背单词 APP 要么收费、要么广告太多。本案例用 Codex 从零打造一个 **英语单词计划学习工具**,实现 SM-2 间隔重复算法(Anki 的核心算法)、单词本增删改查、多种测验模式(选择题/拼写/听写)、TTS 发音播放,以及学习数据的可视化统计图表。全程用自然语言驱动 Codex,用 Python 写后端逻辑 + 终端 UI,打造你的私人背单词助手!

yueyeguzhuo的专栏 201
上一篇: 私有化部署 Llama3 大模型, 支持 API 访问
下一篇: AI照妖镜一眼判真假:网页图像视频都能鉴,边播边识别,清华独角兽成果
AI_小站
博客等级 码龄3年 6255粉丝 1152原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值