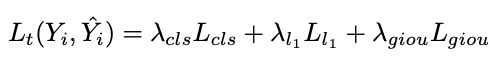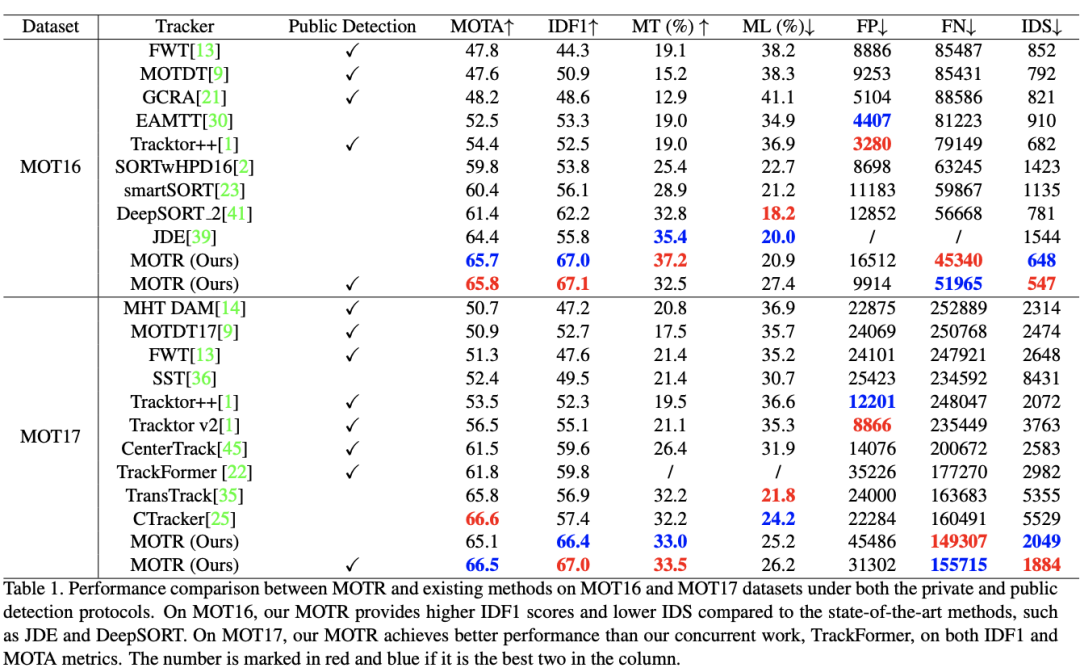
利用Transformer进行端到端的目标检测及跟踪(附源代码)

目标检测算法-transformer系列-YOLOS(附论文和源码) 阅读详情

图片

现存的用检测跟踪的方法采用简单的heuristics,如空间或外观相似性。这些方法,尽管其共性,但过于简单,不足以建模复杂的变化,如通过遮挡跟踪。

1、简要

多目标跟踪(MOT)任务的关键挑战是跟踪目标下的时间建模。现存的用检测跟踪的方法采用简单的heuristics,如空间或外观相似性。这些方法,尽管其共性,但过于简单,不足以建模复杂的变化,如通过遮挡跟踪。所以现有的方法缺乏从数据中学习时间变化的能力。
图片

在今天分享中,研究者提出了第一个完全端到端多目标跟踪框架MOTR。它学习了模拟目标的长距离时间变化。它隐式地执行时间关联,并避免了以前的显式启发式方法。MOTR建立在TRansformer和DETR之上,引入了“跟踪查询”的概念。每个跟踪查询都会模拟一个目标的整个跟踪。逐帧传输和更新,以无缝地执行目标检测和跟踪。提出了时间聚合网络(Temporal aggregation network)结合多框架训练来建模长期时间关系。实验结果表明,MOTR达到了最先进的性能。

2、简单背景

多目标跟踪(MOT)是一种视觉目标检测,其任务不仅是定位每一帧中的所有目标,而且还可以预测这些目标在整个视频序列中的运动轨迹。这个问题具有挑战性,因为每一帧中的目标可能会在pool environment中被遮挡,而开发的跟踪器可能会受到长期和低速率跟踪的影响。这些复杂而多样的跟踪方案在设计MOT解决方案时带来了重大挑战。
图片

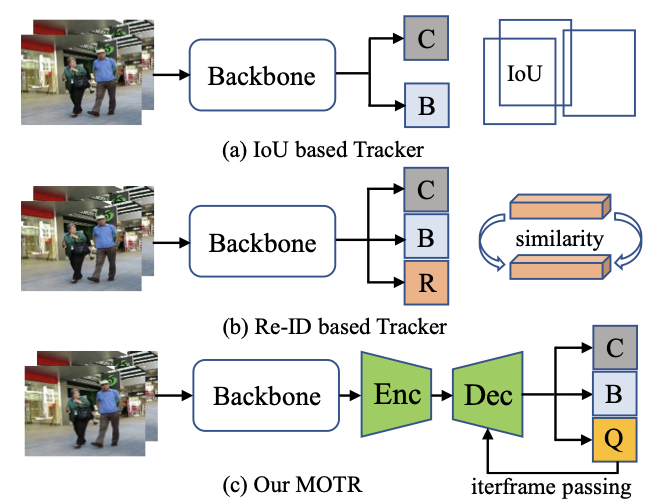
对于基于IoU的方法,计算从两个相邻帧检测到的检测框的IoU矩阵,重叠高于给定阈值的边界框与相同的身份相关联(见上图(a))。类似地,基于Re-ID的方法计算相邻帧的特征相似性,并将目标对与高相似性相关起来。此外,最近的一些工作还尝试了目标检测和重识别特征学习的联合训练(见上图(b))。

由于DETR的巨大成功,这项工作将“目标查询”的概念扩展到目标跟踪模型,在新框架中被称为跟踪查询。每个跟踪查询都负责预测一个目标的整个跟踪。如上图©,与分类和框回归分支并行,MOTR预测每一帧的跟踪查询集。

3、新框架分析

最近,DETR通过采用TRansformer成功地进行了目标检测。在DETR中,目标查询,一个固定数量的学习位置嵌入,表示一些可能的实例的建议。一个目标查询只对应于一个使用bipartite matching的对象。考虑到DETR中存在的高复杂性和慢收敛问题,Deformable DETR用多尺度deformable attention取代了self-attention。为了展示目标查询如何通过解码器与特征交互,研究者重新制定了Deformable DETR的解码器。
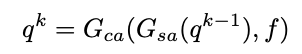
图片

MOTR

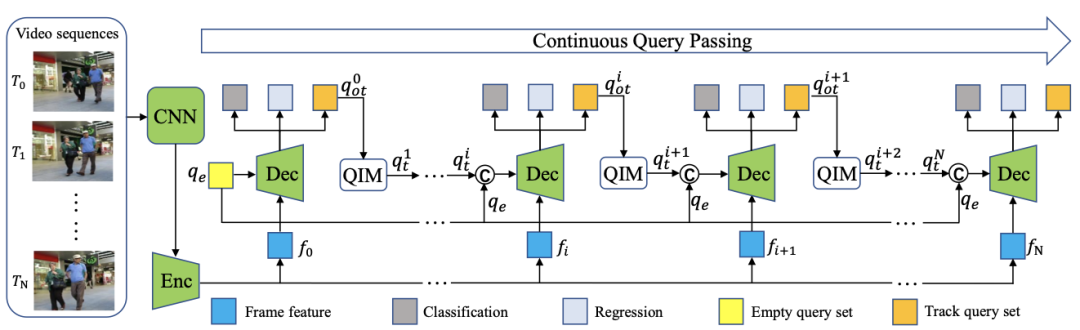
在MOTR中,研究者引入了跟踪查询和连续查询传递,以完全端到端的方式执行跟踪预测。进一步提出了时间聚合网络来增强多帧的时间信息。
图片

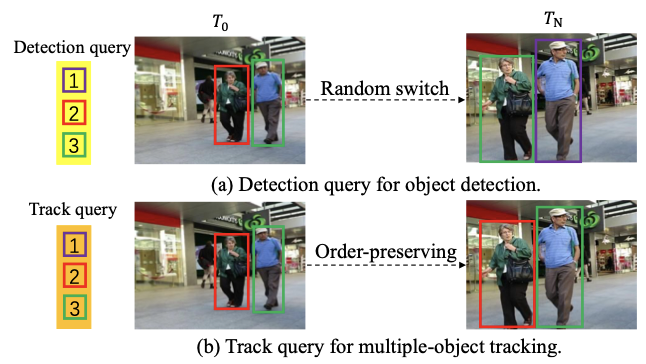
DETR中引入的目标(检测)查询不负责对特定目标的预测。因此,一个目标查询可以随着输入图像的变化而预测不同的目标。当在MOT数据集的示例上使用DETR检测器时,如上图(a),相同检测查询(绿色目标查询)预测两个不同帧预测两个不同的目标。因此,很难通过目标查询的身份来将检测预测作为跟踪值联系起来。作为一种补救措施,研究者将目标查询扩展到目标跟踪模型,即跟踪查询。在新的设计中,每个轨迹查询都负责预测一个目标的整个轨迹。一旦跟踪查询与帧中的一个目标匹配,它总是预测目标,直到目标消失(见上图(b))。
图片

Overall architecture of the proposed MOTR

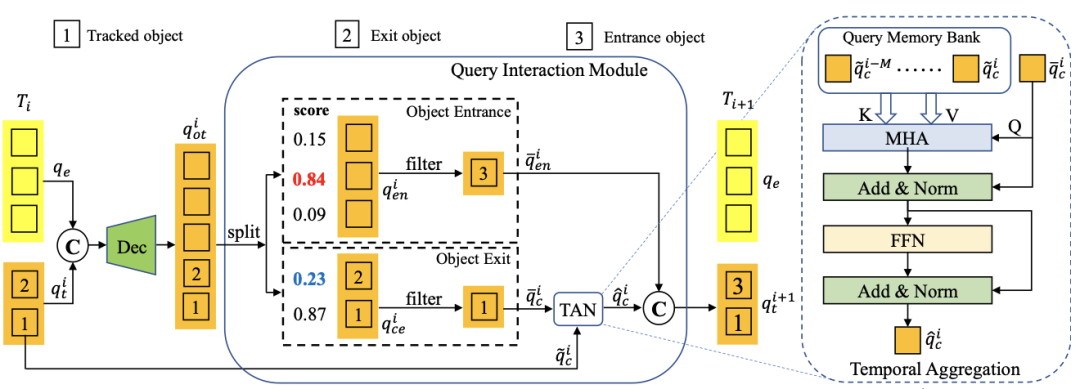
Query Interaction Module

在训练阶段,可以基于对bipartite matching的GTs的监督来实现跟踪查询的学习。而对于推断,研究者使用预测的轨迹分数来确定轨道何时出现和消失。
图片

Overall Optimization

我们详细描述下MOTR的训练过程。给定一个视频序列作为输入,训练损失,即track loss,是逐帧计算和逐帧生成的预测。总track loss是由训练样本上的所有GT的数量归一化的所有帧的track loss的总和:
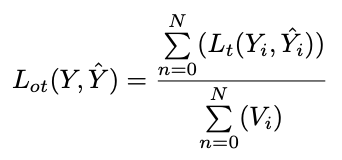
图片

单帧图像Lt的track loss可表示为:

图片

4、实验

图片

Implementation Details

All the experiments are conducted on PyTorch with 8 Tesla V100 GPUs. We use the Deformable-DETR with ResNet50 as our basic network. The basic network is pretrained on the COCO detection dataset. We train our model with the AdamW optimizer for total 200 epochs with the initial learning rate of 2.0 · 10−4. The learning rate decays to 2.0 · 10−5 at 150 epochs. The batch size is set to 1 and each batch contains 5 frames.
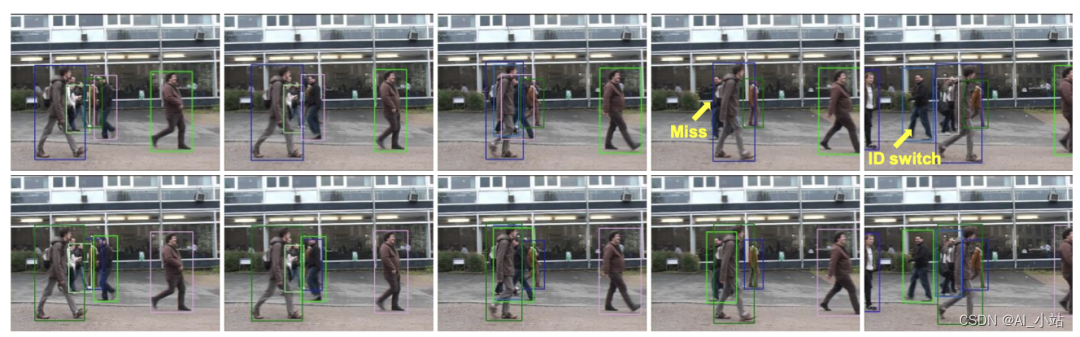
在这里插入图片描述

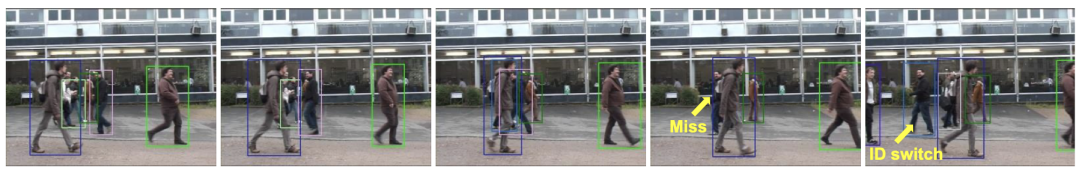
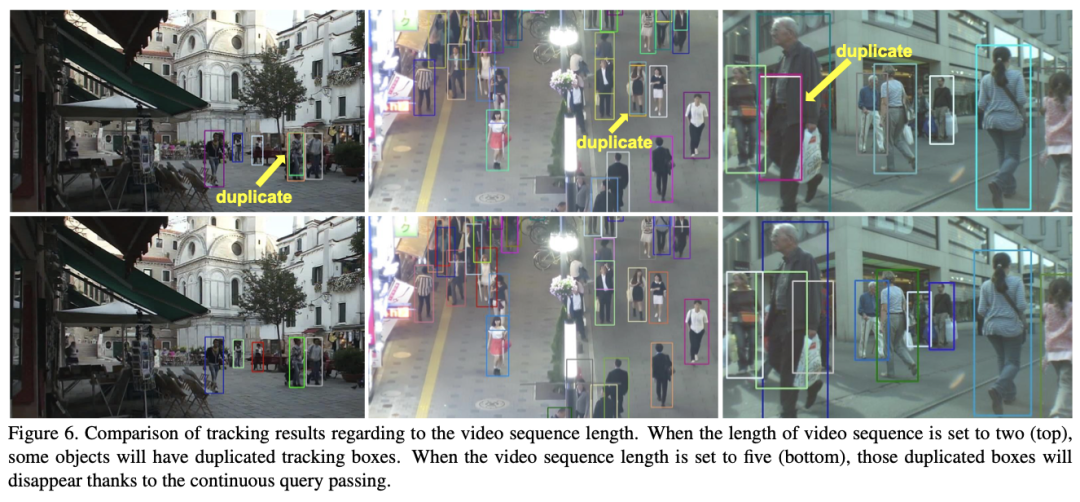
The effect of multi-frame continuous query passing on solving ID switch problem. When the length of video sequence is set to two (top), the objects that are occluded will miss and switch the identity. When improving the video sequence length from two to five (bottom), the track will not occur the ID switch problem with the help of enhanced temporal relation.
图片

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

目标检测算法-transformer系列-DETR论文解析(附论文与源码) 阅读详情

相关推荐

DETR系列 | 端到端Transformer目标检测算法汇总!

自从VIT横空出世以来,Transformer在CV界掀起了一场革新,各个上下游任务都得到了长足的进步,今天就带大家盘点一下基于Transformer的端到端目标检测算法!

sinat_41942180的博客 1347

计算机视觉算法——基于Transformer的目标检测(DETR / Deformable DETR / Dynamic DETR / DETR 3D)

DETR是DEtection TRansformer的缩写,该方法发表于2020年ECCV,原论文名为《End-to-End Object Detection with Transformers》。传统的目标检测是基于Proposal、Anchor或者None Anchor的方法,并且至少需要非极大值抑制来对网络输出的结果进行后处理,涉及到复杂的调参过程。而DETR使用了Transformer Encoder-Decoder的结构,并且通过集合预测损失实现了真正意义上的端到端的目标检测方法。...

weixin_44580210的博客 1万+

基于JDE的目标跟踪算法前沿研究跟进

目录一级目录一. FairMOT二.CSTrack总结三. CStrackV2总结四. TransTrack五. CenterTrack传统跟踪方法(Tracking-by-detection)两个缺点:CenterTrack的好处训练处理细节 一级目录 一. FairMOT 这篇论文的立意是两部分,一个是类似于CenterTrack的基于CenterNet的联合检测和跟踪的框架,一个是类似于JDE,但是却又不同的,探讨了检测框架与ReID特征任务的集成问题。 作者称这类框架为one-shot MOT框架,

m0_46339652的博客 2166

使用Transformer来做物体检测

点击上方“AI公园”,关注公众号,选择加“星标“或“置顶”因公众号更改了推送规则,记得读完点“在看”~下次AI公园的新文章就能及时出现在您的订阅列表中作者:Jacob Briones编译:...

AI公园 3499

如何用Transformer实现实时目标跟踪?STARK架构实战解析(附代码)

本文深入解析了如何利用Transformer架构实现实时目标跟踪,重点介绍了STARK(Spatio-Temporal Transformer for Visual Tracking)模型。该模型摒弃了传统跟踪器的复杂流程,通过端到端的时空Transformer直接预测目标边界框,在保持高精度的同时实现了30-40 FPS的实时性能。文章结合代码实战,详细阐述了其核心设计、动态模板更新机制及优化部署经验。

zz67890的博客 911

Spark入门:从零到能跑的实战教程

Spark 的强大在于它统一了大数据处理的多种场景,从批处理到流处理,从 SQL 到机器学习。对于初学者来说,理解 Spark 的核心理念——内存计算和分布式抽象,是最重要的一步。接着,学会用 PySpark 搭建环境,能读数据、能写 SQL,基本上就入门了。剩下的路,就是通过实战去加深理解。写到这里,相信你对 Spark 已经有了一个比较完整的认识。下一步,不妨自己动手写几个 PySpark 脚本,跑一跑日志数据,或者尝试用 Spark SQL 做一个统计。

Morpheon的博客 1369

利用TRansformer进行端到端的目标检测及跟踪(附源代码)

计算机视觉研究院专栏作者:Edison_G现存的用检测跟踪的方法采用简单的heuristics,如空间或外观相似性。这些方法,尽管其共性,但过于简单,不足以建模复杂的变化,如通过遮挡跟踪。...

gzq0723的博客 2920

MATLAB随机生成m个三维坐标点,且各个坐标点之间的距离不小于n

randi函数 randi(max,m,n); %生成均匀分布的随机整数,max生成的随机整数最大值,生成m行n列的矩阵 编写函数sampling function [x,y,z]=sampling(lowx,upx,lowy,upy,lowz,upz,m,n) %该函数用来产生不重复的随机整数矩阵 %low—随机整数下界;up—随机整数上界;m—坐标点个数;n—各个坐标点之间的最小距离 %编...

qq_45384561的博客 9436

利用 Transformer 进行端到端的多目标检测及跟踪(附源代码)

现存的用检测跟踪的方法采用简单的heuristics,如空间或外观相似性。这些方法,尽管其共性,但过于简单,不足以建模复杂的变化,如通过遮挡跟踪。01摘要多目标跟踪(MOT)任务的关键挑战是跟踪目标下的时间建模。现存的用检测跟踪的方法采用简单的heuristics,如空间或外观相似性。这些方法,尽管其共性,但过于简单,不足以建模复杂的变化,如通过遮挡跟踪。所以现有的方法缺乏从数据中学习时间变化的能力。在今天分享中,研究者提出了第一个完全端到端多目标跟踪框架MOTR。它学习了模拟目标的长距离时间变化。它隐式地

机器学习社区 1907

(53页PPT)新型智慧病房整体解决方案(附下载方式)

当前医疗场景存在三大核心矛盾:院内感染风险(如输液异常发现滞后)、信息孤岛现象(11类业务系统数据割裂)、管理效能不足(30%护理时间耗费在机械性工作)。实际案例显示,整体运营效率提升40%,患者满意度提高28个百分点,真正实现了"让技术有温度,让数据会说话"的价值理念。本文将从需求分析、技术架构、应用场景三个维度,深度剖析这份53页解决方案的创新价值与实践路径。床旁智能终端整合12项功能:包括体征自动采集(误差率<1%)、医嘱执行核对(100%条码校验)、智能床垫离床报警(响应时间3秒)等。

AI_data_cloud的博客 716

CSR mascon产品深度解析

GRACE数据产品 mascon产品 质量变化 地球重力场

weixin_43047707的博客 4434

RT-DETR:端到端的实时Transformer检测模型(目标检测+跟踪)

博主一直一来做的都是基于的目标检测领域,相较于基于卷积的目标检测方法,如YOLO等,其检测速度一直为人诟病。终于,RT-DETR横空出世,在取得高精度的同时,检测速度也大幅提升。那么RT-DETR是如何做到的呢?在研究RT-DETR的改进前,我们先来了解下DETR类目标检测方法的发展历程吧DETRNMSDAB-DETRDETR100DETRDAB-DETRH-DETR然而,上述方法尽管已经大幅提升了检测精度,降低了计算复杂度,但其受本身高计算复杂度的制约,DETR。

pengxiang1998的博客 1万+

基于深度强化学习技术优化无线网络中的资源分配(一)DQN部分代码

这是一个GitHub上的开源项目,链接:https://github.com/alexis-anzaldo/Deep-Reinforcement-Learning-for-resource-allocation-in-wireless-networks该项目旨在通过深度强化学习DQL技术优化无线网络中的资源分配,特别关注小型蜂窝和超密集无线蜂窝网络中的功率控制问题,主要目标是提高DRL模型的学习效率和网络吞吐量。

m0_46292040的博客 1538

Trackformer:基于Transformer的端到端多目标跟踪完整指南

Trackformer是一个革命性的多目标跟踪项目,它利用Transformer架构实现了端到端的视频目标追踪解决方案。这个创新的方法将目标检测和跟踪任务统一在一个框架中,为计算机视觉领域带来了全新的突破。 ## 🎯 Trackformer的核心优势 Trackformer通过Transformer的注意力机制,能够同时处理多个目标在不同帧间的关联问题。相比传统的多目标跟踪方法,它具有以下显

gitblog_00931的博客 1064

常见卫星图源下载教程

上面列出的8个常见的亚米级别数据源都可以通过xyz协议或者wmts/wms协议进行下载。这些协议是什么?地理信息数据为了方便网络传输,制定了一系列的地理数据传输标准(wms/wmts/xyz等)。协议特点优点缺点栅格数据支持矢量数据支持WMS通过HTTP请求获取GIS数据,服务器会将数据渲染成图像高度定制的地图;交互性强服务器渲染图像,响应时间较长支持有限支持WMTS提供预渲染的地图瓦片速度快,因为地图瓦片可以预先生成并在请求时快速提供瓦片的内容是预先确定的,无法进行定制支持。

锐多宝的地理空间 1万+

VCS HVP与验证计划planner:数字IC验证环境搭建与收敛实践

在数字IC验证中,VCS 是广泛使用的编译型仿真器,HVP 通常指面向硬件验证平台的高性能编译选项集,用于开启 SystemVerilog 类、随机约束和 NTB 等能力;planner 则指验证计划管理,核心是把功能点与测试用例、覆盖点建立映射。理解 VCS 先编译后仿真的原理,有助于优化增量编译、调试访问和覆盖率采集,提升回归收敛效率。规划驱动让激励不再散落,设计改版时能快速定位受影响用例,交接和覆盖率收敛更有依据。无论是 UVM 环境搭建、编译参数选择,还是验证计划表维护,都需要把工具选项与规划方法结

weixin_42543046的博客 338

【有啥问啥】探索DETR:基于Transformer的目标检测框架

DETR,全称Detection Transformer,是Facebook AI研究团队提出的一种基于Transformer的端到端目标检测网络。DETR是第一篇将Transformer成功整合到目标检测流程中的算法,它摒弃了传统的基于锚框(anchor-based)的检测方法,以及非极大值抑制(NMS)等手工设计的后处理步骤,实现了更加简洁和高效的目标检测。传送门链接:大语言模型系列-Transformer介绍。

Chauvin的博客 2331

SAP 针对不同行业(制造业、零售业、金融业)推出了专属的云解决方案,以下是各行业的核心方案与特点

SAP推出行业专属云解决方案:制造业(SAP Digital Manufacturing Cloud)提供AI排产与质量预警,降低缺陷率;零售业(S/4HANA Cloud零售版)实现AI预测补货与全渠道库存同步,减少浪费;金融业(Business ByDesign)支持合规自动化与实时风控,降低审计成本。各方案均采用云原生架构,典型案例显示实施效果显著。

金牌架构师 492

多目标跟踪新星:基于Transformer的端到端MOTR框架

在当今视觉追踪技术的迅速发展中,一款名为MOTR(Multiple-Object Tracking with Transformer)的开源项目正以变革者的姿态脱颖而出。MOTR不仅代表了多目标跟踪领域的最新研究进展,而且通过其独特的设计,为开发者和研究人员提供了一种全新的视角来处理复杂的视频对象跟踪问题。 #### 项目介绍 MOTR是一个基于Transformer的全端到端多目标跟踪解决方

gitblog_00427的博客 1033

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

MOTR: End-to-End Multiple-Object Tracking with Transformer——使用 Transformer 进行端到端多对象跟踪

之前常用的是启发式的算法来进行跟踪。提出了 MOTR,引入了的概念。track query对整个视频中的跟踪实例进行建模。track query逐帧传输和更新,以随着时间的推移执行迭代预测。是一种隐式的关联方法提出了轨迹感知标签分配来训练轨迹查询和新生对象查询。我们进一步提出时间聚合网络和集体平均损失来增强时间关系建模。取得了良好的效果。这些方法需要基于相似性的后处理匹配,这成为跨帧时间信息流的瓶颈。介绍一个完全端到端的 MOT 框架,具有关联运动和外观建模功能。

xiaoxu的博客 1407

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

【亲测免费】 MOTR:基于Transformer的端到端多目标跟踪

**MOTR**([ECCV2022])是一个全端到端的多对象跟踪框架,利用Transformer技术直接在视频序列中输出跟踪结果,无需任何显式的关联步骤。它通过引入“轨迹查询”的概念,每个查询代表一个对象的完整轨迹,并在帧与帧之间传递及更新,实现迭代预测。此外,通过“追踪片段感知的标签分配”和“时序聚合网络”,MOTR增强了长程时间关系的学习能力,提供了一个强大的Transformer基础模型,

gitblog_00748的博客 1415

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

【亲测免费】 Trackformer:基于Transformer的端到端多目标跟踪

--- ## 项目介绍 Trackformer 是一个开源项目,由 [timmeinhardt](https://github.com/timmeinhardt) 创建并维护,它实现了基于 Transformer 架构的多目标跟踪。这个项目突破了传统基于卷积神经网络(CNN)的方法,利用 Transformer 的强大表示能力来处理时空域内的目标跟踪问题,从而提供了高效且强大的目标追踪解决方案...

gitblog_00502的博客 1415

【第二十八周】文献阅读:基于Transformer的端到端目标检测

本周主要阅读了 DETR 算法的原始论文。DETR 是将 Transformer 应用到计算机视觉领域的代表性算法,其不需要传统目标检测的 NMS 或 anchor 机制,而是直接将目标检测任务视为一个集合预测任务去输出预测集合。DETR 首先将输入图像通过一个 CNN 来提取特征并进行序列化,序列化之后的向量再输入到 encoder 中进行编码并产生包含上下文信息的向量。

qq_30043925的博客 1140

SparseEnd2End:端到端的障碍物3D检测与跟踪架构

SparseEnd2End:端到端的障碍物3D检测与跟踪架构 项目介绍 SparseEnd2End是一个基于视觉Transformer的端到端障碍物3D检测与跟踪架构。它采用稀疏Transformer进行感知,能够有效地感知3D障碍物,适用于自动驾驶领域。该项目由ThomasVonWu创建,旨在提供一个简单实用的部署仓库,基于TensorRT,无需复杂依赖即可实现训练、推理和部署。 项目技术分析 ...

gitblog_00496的博客 970

【亲测免费】 MOTR:基于Transformer的端到端多目标跟踪框架

**MOTR**(Multiple-Object Tracking with TRansformer)是一个基于Transformer的端到端多目标跟踪框架。与传统的跟踪-检测方法不同,MOTR直接输出视频序列中的跟踪轨迹,无需任何关联过程。这一创新性的方法通过引入“跟踪查询”(track query)概念,每个跟踪查询模型化一个对象的整个轨迹,并在帧与帧之间传递和更新,从而实现无缝的迭代预测。M

gitblog_00169的博客 1084
上一篇: 为什么看了那么多资料还是无法理解Transformer啊???
下一篇: 使用Transformer进行抄袭检测
AI_小站
博客等级 码龄3年 6255粉丝 1152原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值