聊聊大模型:开源LLaMA背后的底层逻辑与赚钱之道?大模型的发展瓶颈?如何一键部署LLaMA3?

DeepSeek介绍及使用ollama本地化部署DeepSeek-R1大模型 Ollama 是一个开源项目,它提供了一个框架和工具,用于在本地环境中运行、部署和管理大型语言模型(LLMs)。Ollama 旨在简化 LLMs 的使用,使得开发者和研究人员能够更容易地在自己的硬件上运行这些模型,而不需要依赖云服务或高性能计算资源。 阅读详情

如果我们相信未来比今天更好,坚信自己生活在一个好地方,所要做的便是认识到未来时代的特征和规律。把握住一些不变的道理,使用正确的方法,做那些能够不断让自己获得可叠加式进步的事情,这样便能立于不败之地。—吴军

最近关注两个方向,也是公司重点发展和投资的两个方向,一是数据资产入表,二是大模型及应用。前段时间写数据资产入表相关内容更多一些,利用假期,把最近一些大模型相关的信息做一个整理,给大家做一个分享。

一、为什么开源LLama?*背后的商业逻辑与赚钱之道*

近日,Meta公司发布了迄今为止功能最强大的公开可用的语言大模型(LLM)——LLaMA3。

这一版本在庞大的15万亿个Token数据上进行预训练,提供了8B和70B两种参数规模,以满足不同用户场景的广泛需求。LLaMA3在各种行业基准测试中均取得了最先进的性能。

值得一提的是,除了现有的8B和70B参数规模的模型外,LLaMA3还有一个更为庞大的400B参数模型正在训练中。这预示着LLaMA3在未来将拥有更加强大的能力和更广泛的应用前景。

首先,我们来看看Meta为什么要花如此巨大的资源来开发并开源LLaMA3。

据悉,Meta为了这个项目动用了16000颗GPU,加上长期的测试准备、电力耗费及人员储备,整体投入高达每月上亿。但为何扎克伯格愿意投入如此之多?这背后与Meta的战略布局密不可分。

Meta的核心商业模式是广告,无论是Facebook、Instagram还是WhatsApp,都依赖于用户的粘性。

然而,随着技术的不断进步,新型创新公司有可能通过技术的爆发,改变用户的粘性。如果这种粘性转移到了另一家公司,那对Meta来说无疑是巨大的威胁。OpenAI的ChatGPT就是一个潜在的竞争者,它的出现已经引发了业界的广泛关注。

为了应对这种潜在的威胁,Meta选择了开源LLaMA3这一策略。通过开源,Meta不仅能够在市场推广中获得极大助力,还能吸引更多的开发者、初创企业加入到他们的技术路线中来,共同构建一个庞大的AI生态。
图片

开源Llama3后,Meta如何赚钱呢?

首先,让我们回顾一下开源的历史。以安卓为例,谷歌通过开源这一策略,吸引了全球无数开发者和手机厂商加入其生态系统。

在这个过程中,谷歌通过广告收入(AdSense和AdWords)、应用商店收入(Google Play)、服务和应用销售(Gmail、Google Maps)、硬件销售以及生态合作伙伴等方式,实现了巨大的商业收益。可以说,掌握着整个生态系统的底座,就是躺赚的开始。

那么,Meta又是如何打算的呢?他们表示,“我们的策略是构建并开放源代码通用基础设施,同时保留我们的具体产品实现为专有技术。”

这句话透露出两层含义:一是Meta愿意开放其大模型的源代码,吸引更多开发者和企业加入其生态系统;二是Meta将保留其核心技术和产品实现,确保自己的竞争优势不被削弱。

这里,我们不妨回顾一下OpenAI的历程。OpenAI之所以名为“OpenAI”,是因为其早期模型GPT-1、GPT-2都是开源的。然而,随着GPT-3的发布,OpenAI却选择了闭源。

这一举动引起了业界的广泛讨论,**甚至有人戏称OpenAI应当改名*为“CloseAI”。*但无论如何,OpenAI的开源闭源策略都证明了开源和闭源并非水火不容,而是可以根据商业布局策略进行灵活调整。

那么,开源会不会削弱Meta的核心竞争力呢?答案是否定的。Meta在开源的同时,对开源的环节、流程和各种限制条件进行了精心设计。这些限制条件确保了Meta的核心技术和产品实现不会被轻易复制或模仿,从而保障了其竞争优势。

当然,这也引发了一些专业人士的质疑和嘲讽,认为Meta的做法“违返开源精神”。但商业世界从来都不是纯粹的道德世界,竞争和利益才是永恒的主题。

那么,Meta通过开源大模型能赚到哪些钱呢?

首先,通过吸引更多开发者和企业加入其生态系统,Meta可以进一步扩大其用户基数和市场份额。这将为其带来更多的广告收入和商业合作机会。

其次,Meta可以通过提供高级版或定制版的大模型服务,向企业收取一定的费用。这些服务将基于Meta的核心技术和产品实现,确保其竞争优势的持续性。

最后,Meta还可以利用其在AI领域的技术积累和生态优势,开展更多与AI相关的业务和合作,实现多元化收益。

总之,Meta开源大模型的背后隐藏着深刻的商业逻辑和赚钱之道。通过开源策略吸引更多开发者和企业加入其生态系统,同时保留核心技术和产品实现为专有技术,Meta在保障自己竞争优势的同时也为未来的发展奠定了坚实的基础。

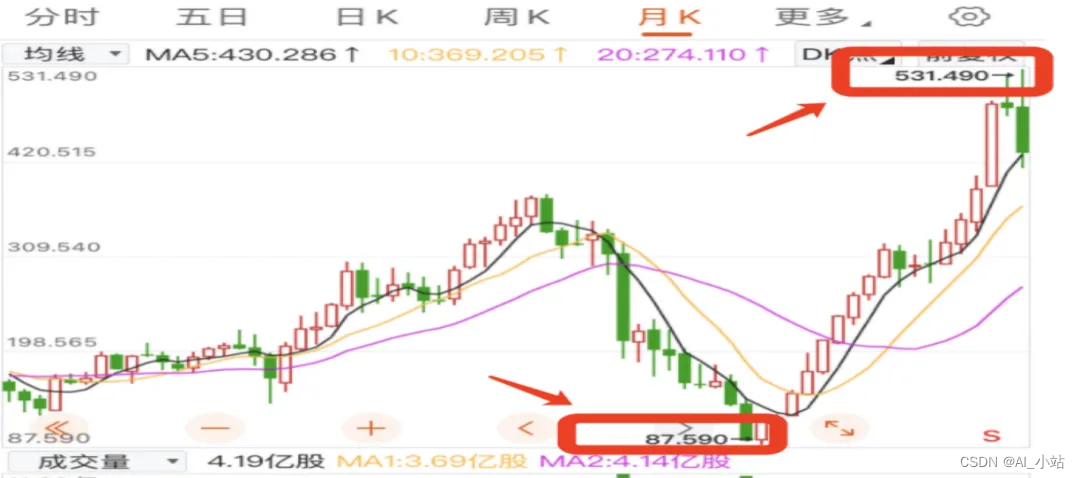
自从Meta全力投入元宇宙领域以来,小扎终于通过开源Llama3走出了困境,这个大坑爬的确实刺激。
在这里插入图片描述

二、大模型的发展瓶颈

大模型技术的飞速发展正不断刷新着我们的认知。然而,随着技术的深入,大模型未来的发展瓶颈也逐渐显现。
图片

关于这一点,个人还是很赞同张俊林的观点。

目前AIGC高速发展本质上还是吃的数据红利,如果GPT5达不到AGI,同时合成数据也没有技术突破,那么大模型能否通向AGI就存在很大疑问。

到了明年(2025年)下半年,可能用来训练大语言模型的高质量新数据就没有了,靠线性新增数据支持指数速度发展的模型能力是不够的。如果“合成数据”在未来两年不能取得突破性进展,大模型发展速度会骤然下降,无法维持目前这种高速发展的局面。

总体而言,“合成数据”是个新兴研究方向,还很不成熟,目前尚未能看到能主导未来技术方向的主流方法,探索性和不确定性比较强。

目前能看到的“合成数据”应用的最好的产品应该是DALLE-3,以及Sora,就是里面的图像和视频Re-caption模型,本质上这就是机器产生的“合成数据”。

“合成数据”目前应该投入大量资源来做,这是未雨绸缪,也能形成核心竞争力。

寄希望于多模态数据来大幅增强大模型的关键能力,比如逻辑推理能力,目前看只是很多人的愿望,目前并无明确的数据或实验能支持这一点。我个人认为这条路走不通。所以不应该把进一步提升AGI能力的希望寄托在多模态数据上。

未来如何,取决于我们在“合成数据”上的进展,有两种不同的未来图景。

一种是,长时间内合成数据无法大规模实用化。如果这样,未来会出现如下现象:大模型能力基本到顶,各种质疑目前AGI技术路线的声音会逐步放大,而开源和闭源模型能力会持平。

这对于很多闭源模型公司来说是灭顶之灾(尽管我们可以继续通过放大模型规模来进一步提升模型能力,但是模型能力增长曲线会比现在平缓很多,即模型能力“加速度差”减小,开源模型较为容易赶上闭源模型)。

另外一种,是在未来两年内要么我们在“合成数据”方面取得大进展,要么即使没有新数据,但是我们有突破性的技术,可以在数据量不变情况下,极大提升大模型的数据利用效率(相同数据量,相同模型大小,如果模型效果更好,则说明模型的数据利用率更高。当然这块目前也未看到可以主导未来发展的主流技术)。

那么,我们会继续按照Scaling law往后发展,就是继续增加新数据,推大模型规模,来持续增强模型能力。

如果这样,AGI是可能通过大模型技术路线达到的,而在这种情况下,意味着需要相比目前数以十倍、百倍的资源投入,基本是个天文数字了,而在如此巨量投入的情况下,Meta等公司是否还会这样大力度支持开源就是有疑问的,此时开源模型是有可能越来越落后于闭源模型的。

三、一键部署LLaMA3

Ollama是一款由Meta公司开源的本地化管理大模型工具包,它支持多个大模型的本地化部署、管理以及运行,使得我们能够方便地将大模型下载至本地,并进行快速的调试操作。

跑8B版本,个人电脑配置基本够用,本人笔记本是6核CPU,16G内存。

  1. 安装Ollama

安装地址:ollama.com

进入网站后,点击“DownLoad”,选择电脑对应的系统。
在这里插入图片描述

下载之后,点击Next以及Install安装ollama到命令行。安装完成后界面上会提示ollama run llama2,不需要执行这条命令,因为我们要安装llama3。

2.下载Llama3

打开新的终端/命令行窗口,执行以下命令:

ollama run llama3

程序会自动下载LLaMA3的模型文件,默认是8B,也就80亿参数版本,个人电脑完全可以运行。

成功下载模型后,我们可以直接在终端和Llama3进行对话,比如提问Who are you?,基本可以实现即时回复。

vbnet
➜  Projects ollama run llama3
>>> who are you?
I'm LLaMA, a large language model trained by a team of researcher at Meta 
AI. I'm here to chat with you and answer any questions you may have.

I've been trained on a massive dataset of text from the internet and can 
generate human-like responses to a wide range of topics and questions. My 
training data includes but is not limited to:

* Web pages
* Books
* Articles
* Research papers
* Conversations

* I'm constantly learning and improving my responses based on the 
* conversations I have with users like you.

* So, what's on your mind? Do you have a question or topic you'd like to 
* discuss?

至此,我们已经成功运行LLaMA3。当然可以继续安装WebUI,可以通过Web页面交互,后续会进行相关分享。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

AI初识—LLM、Ollama、Llama都是些个啥? LLM指的是大语言模型(Large Language Model),是一种基于深度学习的模型,能够理解和生成自然语言。它通过大量文本数据进行训练,具备了理解上下文、生成连贯文本和回答问题的能力。著名的LLM包括OpenAI的GPT系列和Google的BERT。在AI技术快速发展的背景下,LLM、Ollama和Llama代表了现代自然语言处理的不同方面。LLM为我们提供了强大的语言理解能力,Ollama为模型的部署和管理提供了便利,而Llama则在效率和多样性上不断推进。 阅读详情

相关推荐

部署AI平台-Ollama

介绍 llama:LLaMA(Large Language Model Meta AI)是由 Meta(原Facebook公司)发布的一系列大型语言模型。这些模型旨在处理和生成自然语言文本,能够执行多种任务,如文本摘要、翻译、问答、文本生成等。LLaMA 模型因其高效的性能和较小的模型尺寸而受到关注,这使得它们能够在资源有限的环境中运行,例如个人计算机或移动设备。 Ollama:是一个开源的大...

大AI时代,人性化的信息更加难得可贵 3231

用Ollama轻松打造属于你的AI大模型助手

去年,大模型技术快速发展,今年已广泛应用于各行业。作为IT程序员,如何快速在本地构建并训练大模型?马老师推荐使用开源框架Ollama,在本地电脑上创建和微调语言模型,使之具备类似ChatGPT的功能。使用Ollama对硬件要求较高,建议配置24G内存的NTX40显卡、i7第10代及以上CPU和32G内存。如设备不满足,可租用腾讯云等服务商的AI计算服务器,按小时计费,灵活高效。在服务器上创建模型时,通过Ollama命令运行模型(如“ollama run llama2-chinese”)即可体验。

xx_nm98的博客 1万+

本地部署LLM(Ollama和Open-WebUI)

LLM(大语言模型)因为对设备的性能要求比较高,一般是部署在云端,通过网络远程访问。那么想在本地部署(玩一玩)能不能做到呢?Ollama就是实现这个目的的工具。Ollama是一个由Facebook AI Research开发的开源、轻量级且高效的大型语言模型(LLM)框架。它旨在使研究人员和开发人员能够更轻松地在自己的硬件上部署和运行LLM,而无需专门的云计算资源。Ollama提供了一个简单直观的界面,用于加载、运行和评估LLM。它还支持各种自定义选项,允许用户根据特定需求定制LLM。

Morejay的博客 5533

AI初识--LLM、ollama、llama都是些个啥?

Ollama是一个开源的 LLM(大型语言模型)服务工具,用于简化在本地运行大语言模型,降低使用大语言模型的门槛,使得大模型的开发者、研究人员和爱好者能够在本地环境快速实验、管理和部署最新大语言模型,包括如Llama 3、Phi 3、Mistral、Gemma等开源的大型语言模型。library因此,Ollama与LlamaLlama是大语言模型,而Ollama是大语言模型(不限于Llama模型)便捷的管理和运维工具。

weixin_66196770的博客 4万+

编程语言的未来走向:趋势、挑战与机遇

同时,鼓励他们接触和掌握一些专业领域的开发工具和技术框架,比如Web开发中的JavaScript、React.js,数据分析的Python(Pandas, NumPy, Matplotlib等),以及人工智能和机器学习领域的TensorFlow、PyTorch等。当前,全球范围内正积极推动编程教育的普及化,从儿童启蒙阶段到高等教育阶段,乃至终身学习的过程中,如何优化编程语言的教学方法、提高教学质量,并将其广泛应用于不同领域,是教育者与政策制定者面临的重大课题。未来,编程语言的多样化和包容性将会继续加强。

zrc_xiaoguo的博客 1830

黑群晖二合一已损毁_手动修复黑群晖已损毁磁盘空间

lz的用法是这样的,一个中古级mac mini 2011上装有vmware esxi 7.6, 然后上面挂载了lz的华芸Asustor Nas的iscsi空间,lz用的是basic volume,然后esxi上面有虚拟的黑群晖6.2.2-24922,黑群晖的docker里跑着不可描述软件,但是发现下载速度过快时,比如有好几个文件同时下载,总速度超过60MB/s以后storage manager里很...

weixin_39669629的博客 1万+

最强英文开源模型LLaMA架构探秘,从原理到源码

LLaMA架构,三个关键点及对应原理,一些实现源码

Steve Wang's blog 4409

LabVIEW与MySQL的连接:软件下载与安装至UDL文件创建全过程

依据个人经验编辑的十分完备的使用教程

tiaowudexiaoyu的博客 5575

大模型必学——Ollama是什么?

Ollama 是一个强大的本地推理大模型平台,旨在简化模型的本地部署、管理和推理工作流。它允许用户在本地机器上拉取、管理、运行大模型,并提供多种访问方式,包括本地 CLI、HTTP 接口以及通过 OpenAI 客户端的集成。这篇文章将详细介绍 Ollama 的功能,如何使用 Ollama 拉取模型、运行模型,并通过多种方式访问推理服务。前排提示,文末有大模型AGI-优快云独家资料包哦!

大模型工程师老蓝的博客 1万+

区域法(zonal method)重构波前

目的:实现区域法的Matlab代码 1.理论介绍 区域法波前重构即从波前探测器测得的波前斜率中恢复出波前的相位值,其分为:休晋模型(Hudgin)[90]、绍契威尔模型(Southwell)[40]和弗雷德模型(Fried)[48]。 1.1 Fried模型,对于N×N微透镜阵列构成的网格: 以3*3的子透镜为例,解释上式,对其展开 改写为矩阵形式: 记作:S=AΦ,A根据N而确定。S是波前探测器测得的斜率,Φ是重构矩阵的相位值。 1.2 而Southwel...

EyRe1的博客 8200

基于 YOLO + SAM 的自动图像标注实战

摘要: 本文提出一种基于YOLO检测和SAM分割的自动化数据标注流水线方案,通过YOLO定位目标并生成检测框,再以检测框为提示驱动SAM完成精细分割,最终输出YOLO格式的标注文件。该方案将人工标注升级为半自动流程,显著提升标注效率,尤其适用于多类别、大规模图像的实例级标注需求。代码模块化设计支持模型灵活替换,并集成异常处理与进度可视化功能。虽依赖YOLO检测质量且对小目标存在局限,但作为工程落地方案,可有效降低私有数据集构建成本,适用于工业检测、遥感等场景的冷启动标注。

qq_64366203的博客 1151

区分LLaMA、llama.cpp和Ollama

大模型本地部署和运行中,经常遇到这三个概念,llama,ollama,llama.cpp。刚开始接触时,的确有些傻傻分不清楚。这里简单区分理解下,方便快速上手。简单来讲,llama 是一个Meta公司开源的预训练大型语言模型,llama.cpp用于加载和运行 LLaMA 语言模型。ollama是大模型运行框架,它利用了 llama.cpp 提供的底层功能。

月流霜的专栏 5160

DDR5 JEDEC标准简析:一次读懂DDR5的核心规范!

JEDEC,全称是,中文名称是「电子元件工程联合委员会」,它是全球权威的存储接口标准制定机构。我们常见的 DDR2、DDR3、DDR4、DDR5 都是它搞出来的。📌 JEDEC 就像存储接口界的“裁判+编剧”——规定谁该怎么跑,怎么演,怎么配合。

weixin_43199439的博客 2576

零基础入门AI:一键本地运行各种开源大语言模型 - Ollama

Ollama 是一个可以在本地部署和管理开源大语言模型的框架,由于它极大的简化了开源大语言模型的安装和配置细节,一经推出就广受好评,目前已在github上获得了46k star。 不管是著名的羊驼系列,还是最新的AI新贵Mistral,等等各种开源大语言模型,都可以用Ollama实现一键安装并运行,支持的更多模型的列表可以查看Ollama官网。

datian1234的博客 3025

记录Rancher集群中coredns问题导致的服务DNS解析超时

coredns问题处理

1360

【实战篇导读】四足机器人运动控制导读

认知有限,望大家多多包涵,有什么问题也希望能够与大家多交流,共同成长!本文先对四足机器人运动运动控制系统及相关算法做个简单的介绍,具体内容后续再更,其他模块可以参考去我其他文章主要介绍了波士顿spot机器人的发展历史、四足机器人的硬件系统及电机执行器组成包括硬件系统、关节电机执行器,机载传感器机处理器及电气连接等。概述了四足机器人规划控制、感知、定位及局部地图的相关算法方向。

qq_35635374的博客 679

llama和ollama的区别

它不是一个具体的语言模型,而是集成了多个大语言模型,并提供了额外的功能和服务,如对话管理、知识库集成等。LLaMA 和 Ollama 是两个不同的概念,尽管它们的名字听起来相似,但它们在开发背景、功能定位和技术实现上有显著的区别。:Ollama平台集成了多个大语言模型(如LLaMA、GPT等),并提供了额外的功能和服务,如对话管理、知识库集成、多渠道支持等。:Ollama并不是一个具体的语言模型,而是一个AI平台,旨在帮助企业构建和部署定制化的对话系统和客户服务机器人。可能是一个更好的选择。

odin2005的博客 5598

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

AI多模态模型架构之LLM主干(3):Llama系列

初期,小模型的损失下降较快,但随着训练的深入,小模型的性能逐渐饱和,下降速度减缓,而大模型的下降速度则超过了小模型。根据传统Scaling Law的建议,对于10B模型,应使用2000亿token进行训练,但Meta发现,即使是7B模型,使用1万亿token后,性能仍能持续提升。在后续的Llama系列中,Llama-1全部采用了公开渠道可以获取的数据,使用了2017至2020年的CommonCrawl数据,以及来自书籍和维基百科的文本,并且进行了去重,去掉了非英文数据,用线性模型对文本质量进行了分类。

AIGCmagic的博客 3296

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

Ollama是什么?一篇文章让你搞懂,大模型必学

Ollama 是一个强大的本地推理大模型平台,旨在简化模型的本地部署、管理和推理工作流。它允许用户在本地机器上拉取、管理、运行大模型,并提供多种访问方式,包括本地 CLI、HTTP 接口以及通过 OpenAI 客户端的集成。这篇文章将详细介绍 Ollama 的功能,如何使用 Ollama 拉取模型、运行模型,并通过多种方式访问推理服务。前排提示,文末有大模型AGI-优快云独家资料包哦!

m0_63171455的博客 8802

还有人没骑过羊驼?最强开源大语言模型LLaMA解析

2024年4月18日,Meta发布了LLaMA-3,在开源大模型领域又一次引发了震动。Open AI虽然凭借GPT、DALL·E和SORA获得了巨大的成功,但这些模型都没有开源,只提供云端服务,Open AI也因此被调侃为Closed AI。而开源对于垂直领域研究和数据安全等方向都起到举足轻重的作用,因此本期借着LLaMA-3的发布,浅析。在计算机领域,任何问题都有解决方法,但要在限定算力,限定时间的情况下解决一个问题是相当困难的。

python12345_的博客 1546

Ollama是什么

Ollama是一个开源的、可以在本地运行大型语言模型的工具。它允许用户在自己的设备上部署和运行语言模型,而不必完全依赖云端服务。这在数据隐私等方面有诸多优势,比如用户担心数据发送到云端会产生安全风险,使用Ollama就可以在本地处理数据。

RisunJan的博客 5311

AI 本地部署中的 ollama 是什么?一文带你搞懂!!!

Ollama 是一个开源工具,专为在本地计算机上高效运行大型语言模型(LLM,如 deepseek-r1、qwen2.5 等)而设计。它简化了模型的下载、部署和管理流程,让用户无需复杂配置即可在本地体验和开发基于大语言模型的应用。 从 ollama 的网站上可以查看所有的模型信息:

嘴巴吃糖了 4288

AI概念扫盲篇之大模型中的Ollama 是什么东东

Ollama 是一款开源的本地化大型语言模型(LLM)运行框架,旨在简化模型的下载、部署和管理流程,支持用户在不依赖云端服务的情况下高效运行和定制模型。以下是对其核心功能、应用场景、安全风险及使用方法的详细介绍:

liwenxiang629的博客 2274

迄今为止性能最强大的开源大模型 Llama 3.1 (4050亿参数)--深度分析 2024

•。7月24日报道,美国科技巨头Meta推出迄今为止性能最强大的开源大模型——Llama 3.1 405B(4050亿参数),同时发布了全新升级的Llama 3.1 70B和8B模型版本;**Meta评估了超150个基准数据集的性能,Llama 3.1 405B在代码生成和评估、数学推理、长上下文处理、工具使用和多语言支持等一系列任务中,可与GPT-4o、Claude 3.5 Sonnet和Gemini Ultra相媲美;

m0_59164520的博客 1975
上一篇: 大模型之战:你降你的,赢家却是Ta?
下一篇: Langchain的一些问题和替代选择
AI_小站
博客等级 码龄3年 6255粉丝 1154原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
