RAG 实践-Ollama+AnythingLLM 搭建本地知识库

如何使用 Langchain、Ollama 和 Streamlit 构建 RAG 在本博客完成中,我们将指导您创建可在本地运行的 RAG 的过程。这个过程不仅会加深您对尖端语言如何计算机工作的理解,还将使您能够在自己的项目中实施它们无论您是希望将 RAG 集成到现有应用程序中,还是只是探索 NLP 的前沿领域,本教程都是您的入门之选。 阅读详情

什么是 RAG

RAG,即检索增强生成(Retrieval-Augmented Generation),是一种先进的自然语言处理技术架构,它旨在克服传统大型语言模型(LLMs)在处理开放域问题时的信息容量限制和时效性不足。RAG的核心机制融合了信息检索系统的精确性和语言模型的强大生成能力,为基于自然语言的任务提供了更为灵活和精准的解决方案。
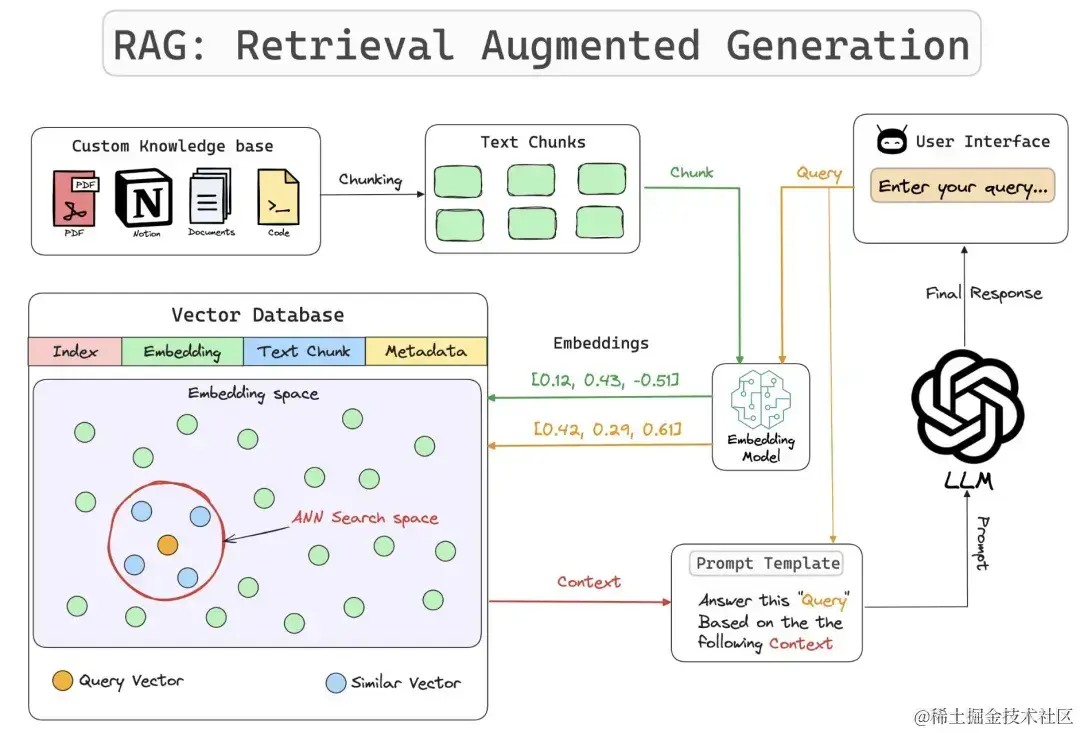
RAG与LLM的关系

RAG不是对LLM的替代,而是对其能力的扩展与升级。传统LLM受限于训练数据的边界,对于未见信息或快速变化的知识难以有效处理。RAG通过动态接入外部资源,使LLM得以即时访问和利用广泛且不断更新的知识库,进而提升模型在问答、对话、文本生成等任务中的表现。此外,RAG框架强调了模型的灵活性和适应性,允许开发者针对不同应用场景定制知识库,从而满足特定领域的需求。

下图是 RAG 的一个大致流程:
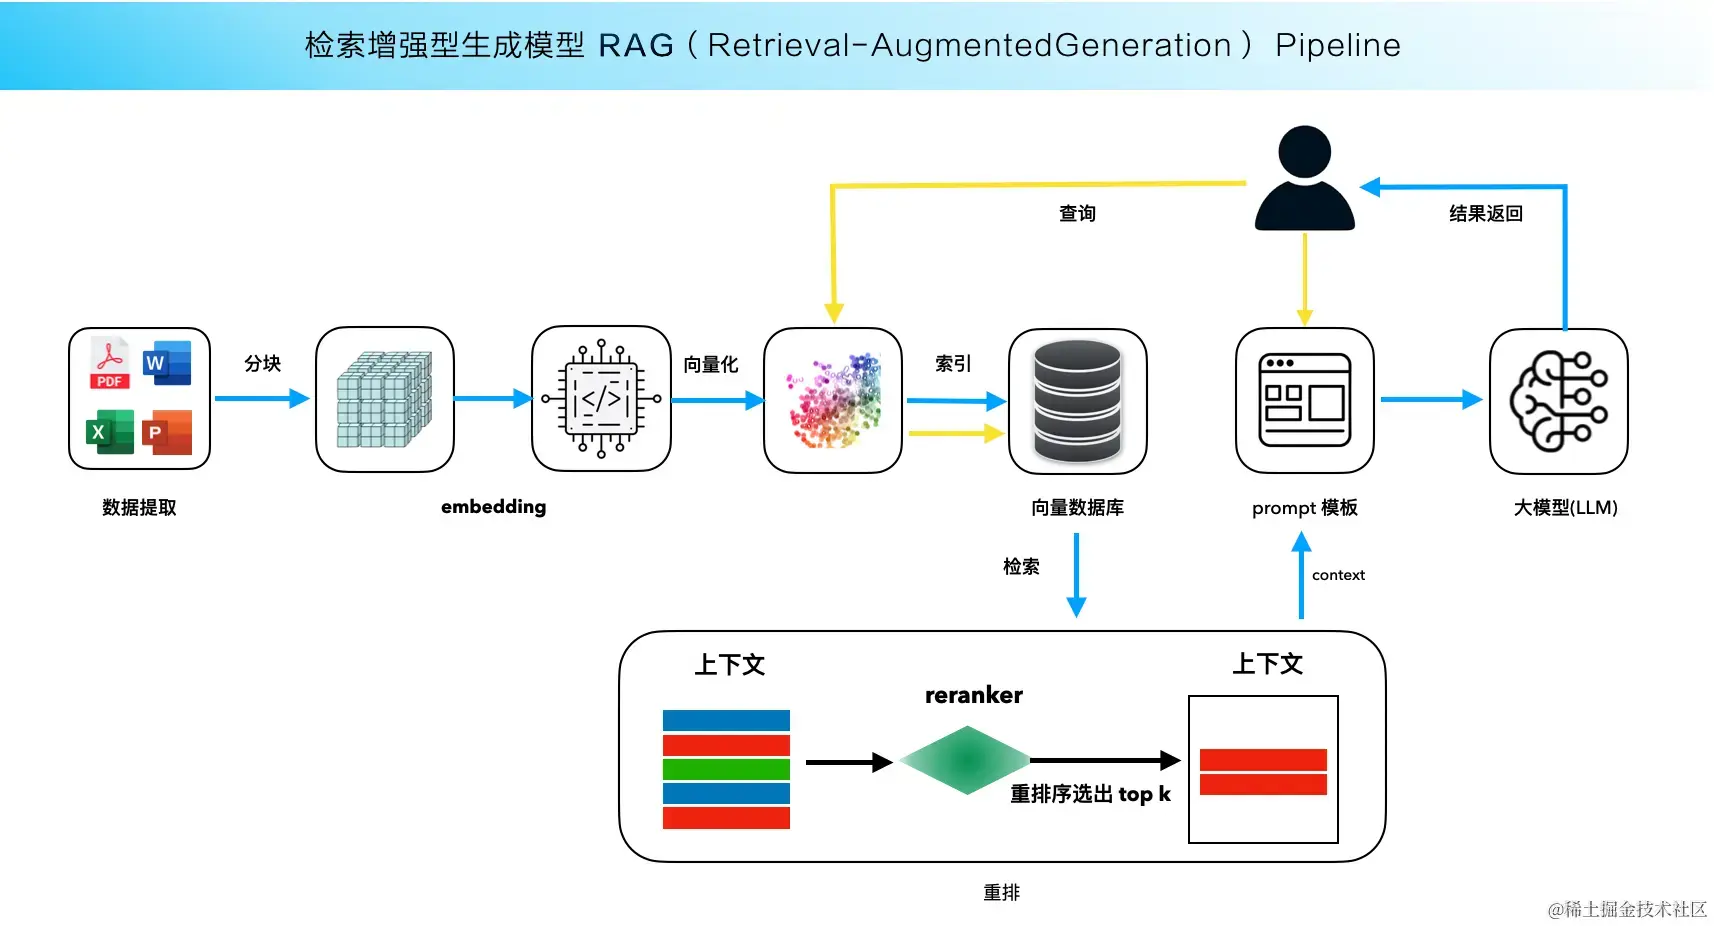
RAG就像是为大型语言模型(LLM)配备了一个即时查询的“超级知识库”。这个“外挂”不仅扩大了模型的知识覆盖范围,还提高了其回答特定领域问题的准确性和时效性。

想象一下,传统的LLM像是一个博学多才但记忆力有限的学者,它依赖于训练时吸收的信息来回答问题。而RAG,则是这位学者随时可以连线的庞大图书馆和实时资讯网络。当面临复杂或最新的查询时,RAG能让模型即时搜索并引用这些外部资源,就像学者翻阅最新的研究资料或在线数据库一样,从而提供更加精准、全面和最新的答案。这种设计尤其适用于需要高度专业化或快速更新信息的场景,比如医学咨询、法律意见、新闻摘要等。

基于此,RAG 技术特别适合用来做个人或企业的本地知识库应用,利用现有知识库资料结合 LLM 的能力,针对特定领域知识的问题能够提供自然语言对话交互,且答案比单纯用 LLM 准确性要高得多。

实践

现成方案

现成的方案有很多

本文将采用 Ollama + Qwen2.5 +AnythingLLM 来实现本地知识库

Ollama 大法

Ollama 与 LLM 的关系可以这样理解:Ollama 本身不是 LLM,而是一个服务于 LLM 的工具。它提供了一个平台和环境,使得开发者和研究人员能够在本地机器上轻松地运行、测试和部署各种大型语言模型

github:github.com/ollama/olla…

下载安装 Ollama 和大模型

下载地址:www.ollama.com/download ,支持 Windows、Mac、Linux。

当然你也可能用 Docker 安装镜像,官方镜像 hub.docker.com/r/ollama/ol…更多细节请参考 github 的 Readme:github.com/ollama/olla…

当你运行 ollama --version 命令成功查询到版本时,表示 Ollama 的安装已经顺利完成。

接下来便可以用 pull 命令从在线模型库下载模型,比如:

bash
复制代码
ollama pull llama2

还有更简单的方法直接使用 run 命令,它会在 运行之前自动检查模型是否下载,如果没有会自动下载

bash
复制代码
ollama run llama3

但是我想搭建的是本地知识库,当然是以中文为主,所以需要对中文支持最好的模型,但是:

Ollama官方提供的模型,对中文支持好的不多,比较好的有:

  • Llama2-Chinese:基于Llama2微调。搜“Chinese”关键词就能找到。
  • Qwen 1.5:阿里的通义千问。一共有6个尺寸,默认是4b。所有尺寸的模型都支持32K的上下文长度。多语言支持。

本想用 智谱的 GLM( huggingface.co/THUDM/chatg… ),奈何不兼容 Ollama,也没有 GGUF 格式文件,于是作罢。巧的是阿里的 通义Qwen2模型刚刚开源,正好可以试一下。

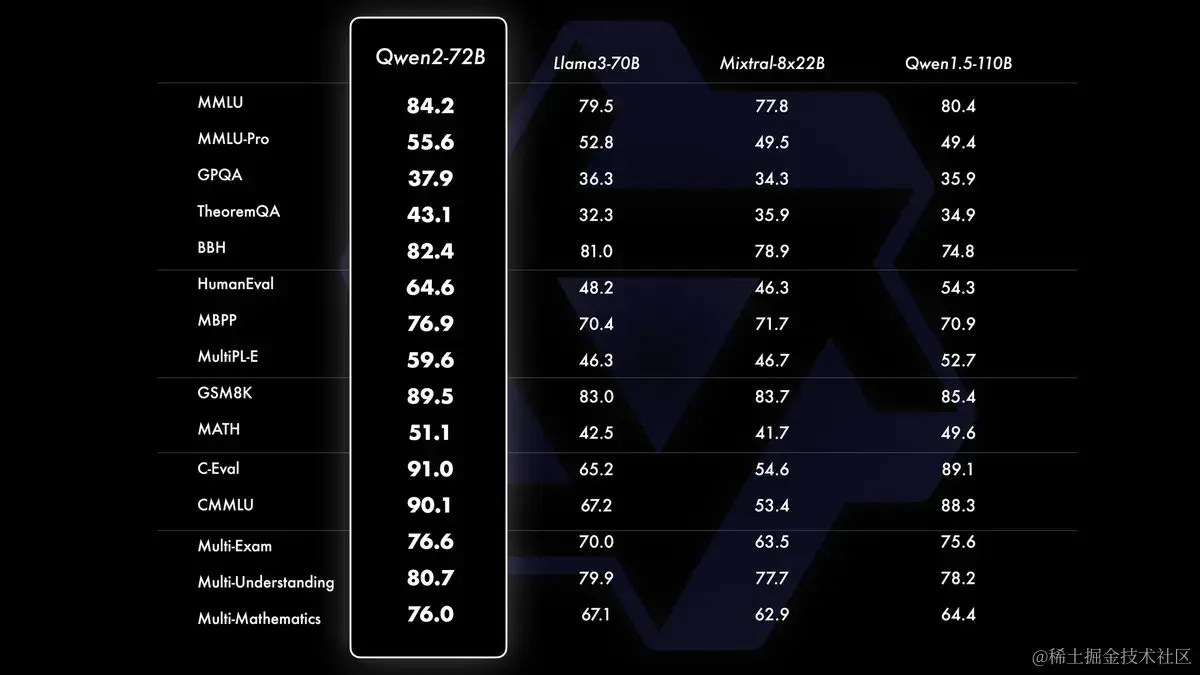
阿里开源了通义Qwen2模型,可以说是现阶段这个规模最强的开源模型。发布后直接在 Huggingface LLM 开源模型榜单获得第一名,超过了刚发布的 Llama3 和一众开源模型。Qwen2在代表推理能力的代码和数学以及长文本表现尤其突出。推理相关测试及大海捞针测试都取得了很好的成绩。

模型概览:Qwen 2 模型组成包括 Qwen2-0.5B、Qwen2-1.5B、Qwen2-7B、Qwen2-57B-A14B和Qwen2-72B。其中Qwen2-57B-A14B为 MoE 模型。

模型在中文、英文语料基础上,训练数据中增加了27种语言相关的高质量数据;增大了上下文长度支持,最高达到128K tokens(Qwen2-72B-Instruct)。多个评测基准上的领先表现;代码和数学能力显著提升。
顺序介绍一下中文大模型,可能通过这个仓库了解:github.com/HqWu-HITCS/…

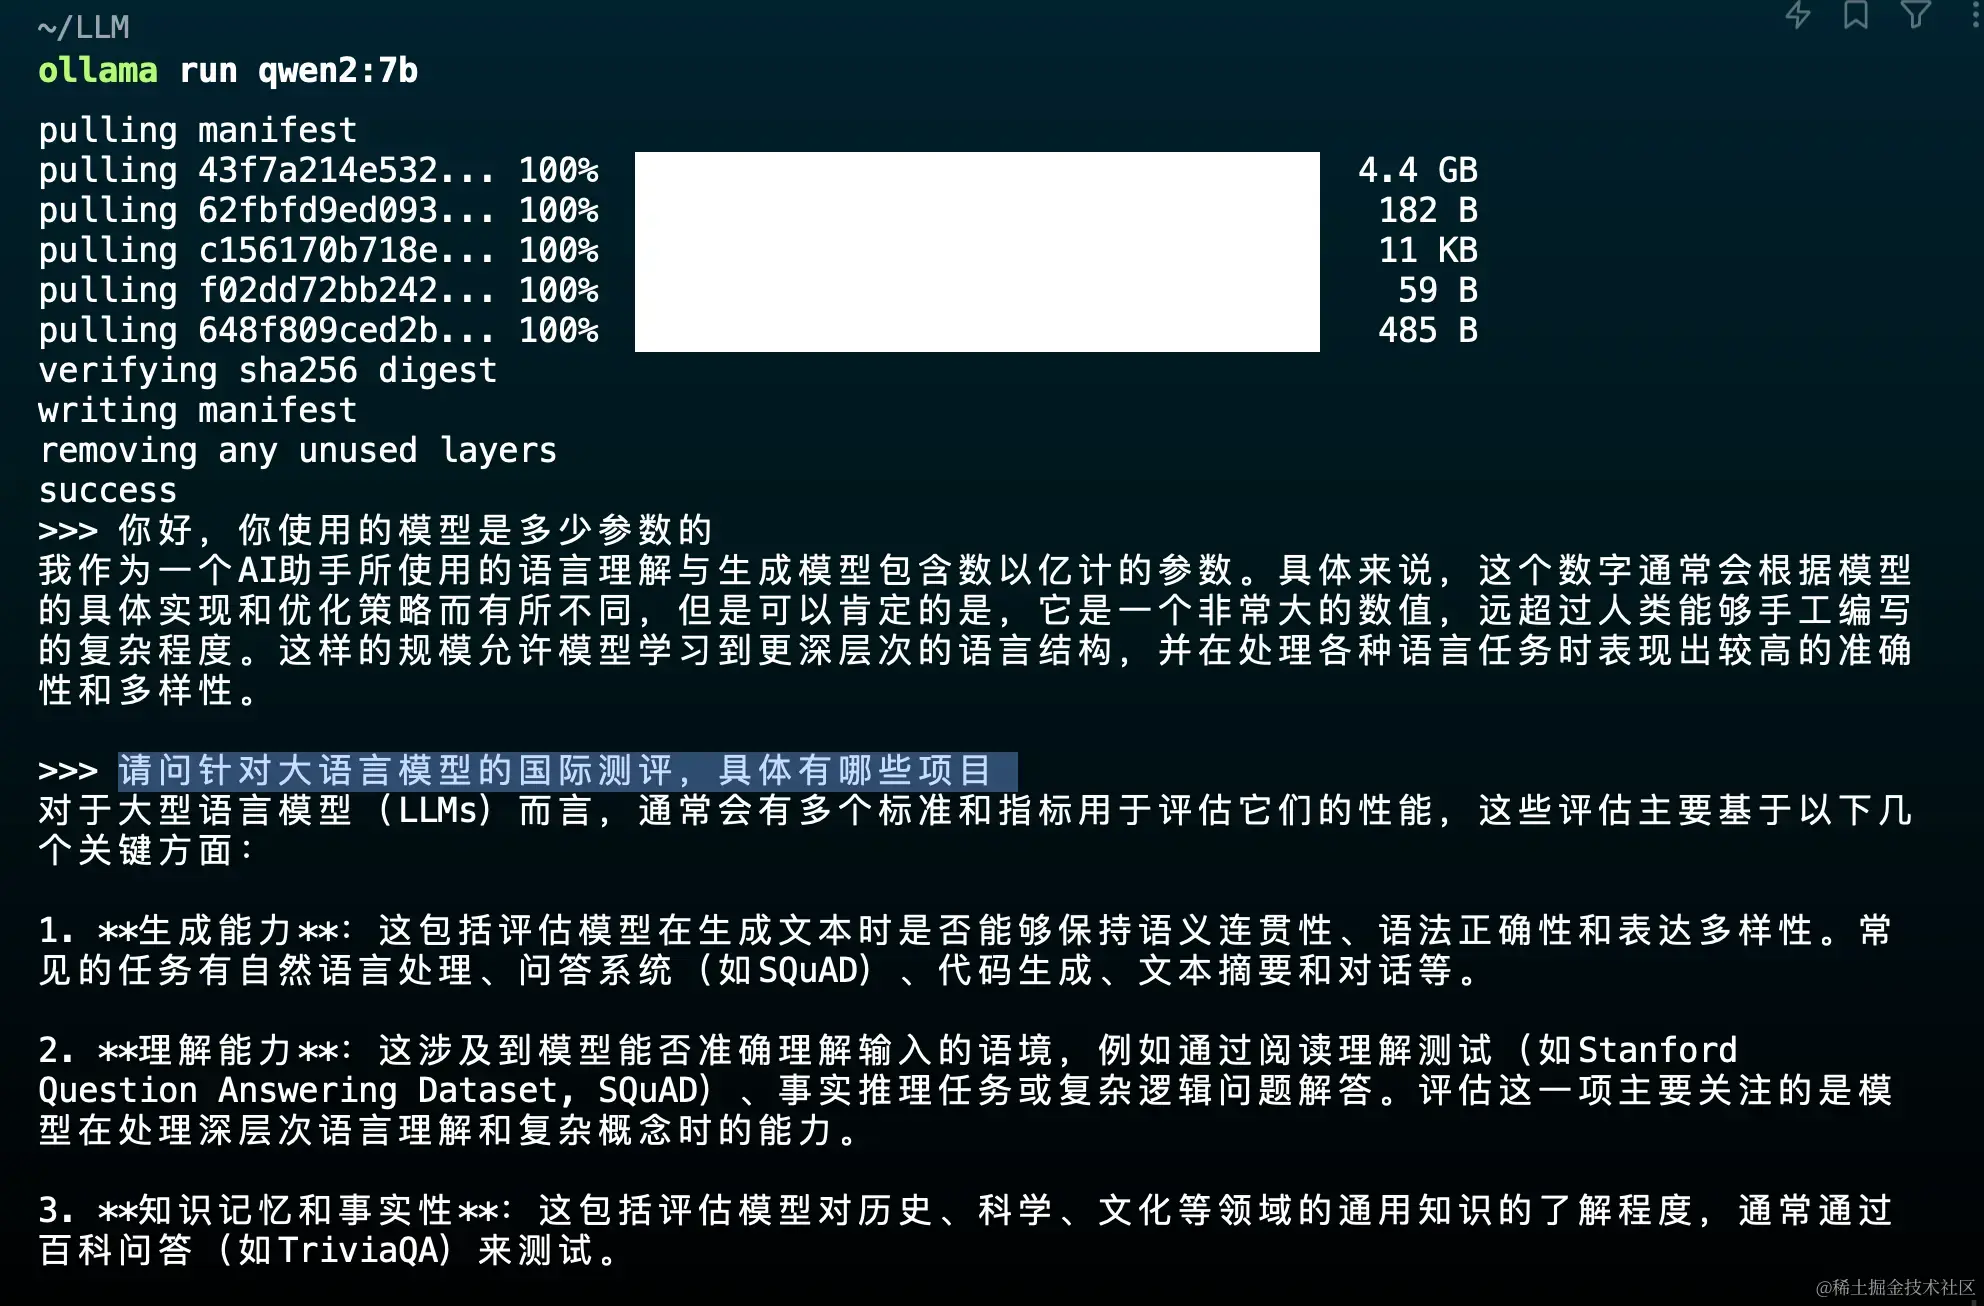
安装并运行 Qwen2 模型,注意这里由于我笔记本配置问题,所以选用的是 7B 参数的模型

bash
复制代码
ollama run qwen2:7b

模型下载的默认路径是:/Users/${home}/.ollama/models

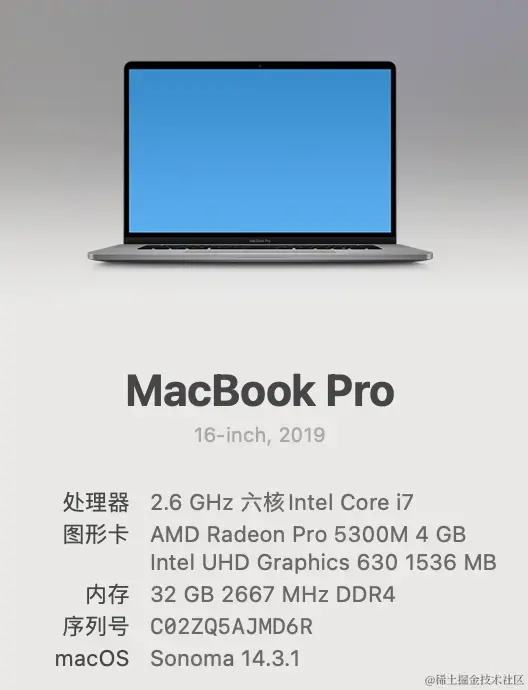
以下是我机器的配置,mac intel芯片
安装完成后就可以对话了:
open web UI

通过命令行交互的方式不算太友好,所以我们需要一个好看好用的 UI 界面来与模型进行交互。

Open Web UI 就是这样一个软件 github.com/open-webui/… ,它通过Docker 可以非常容易的进行部署
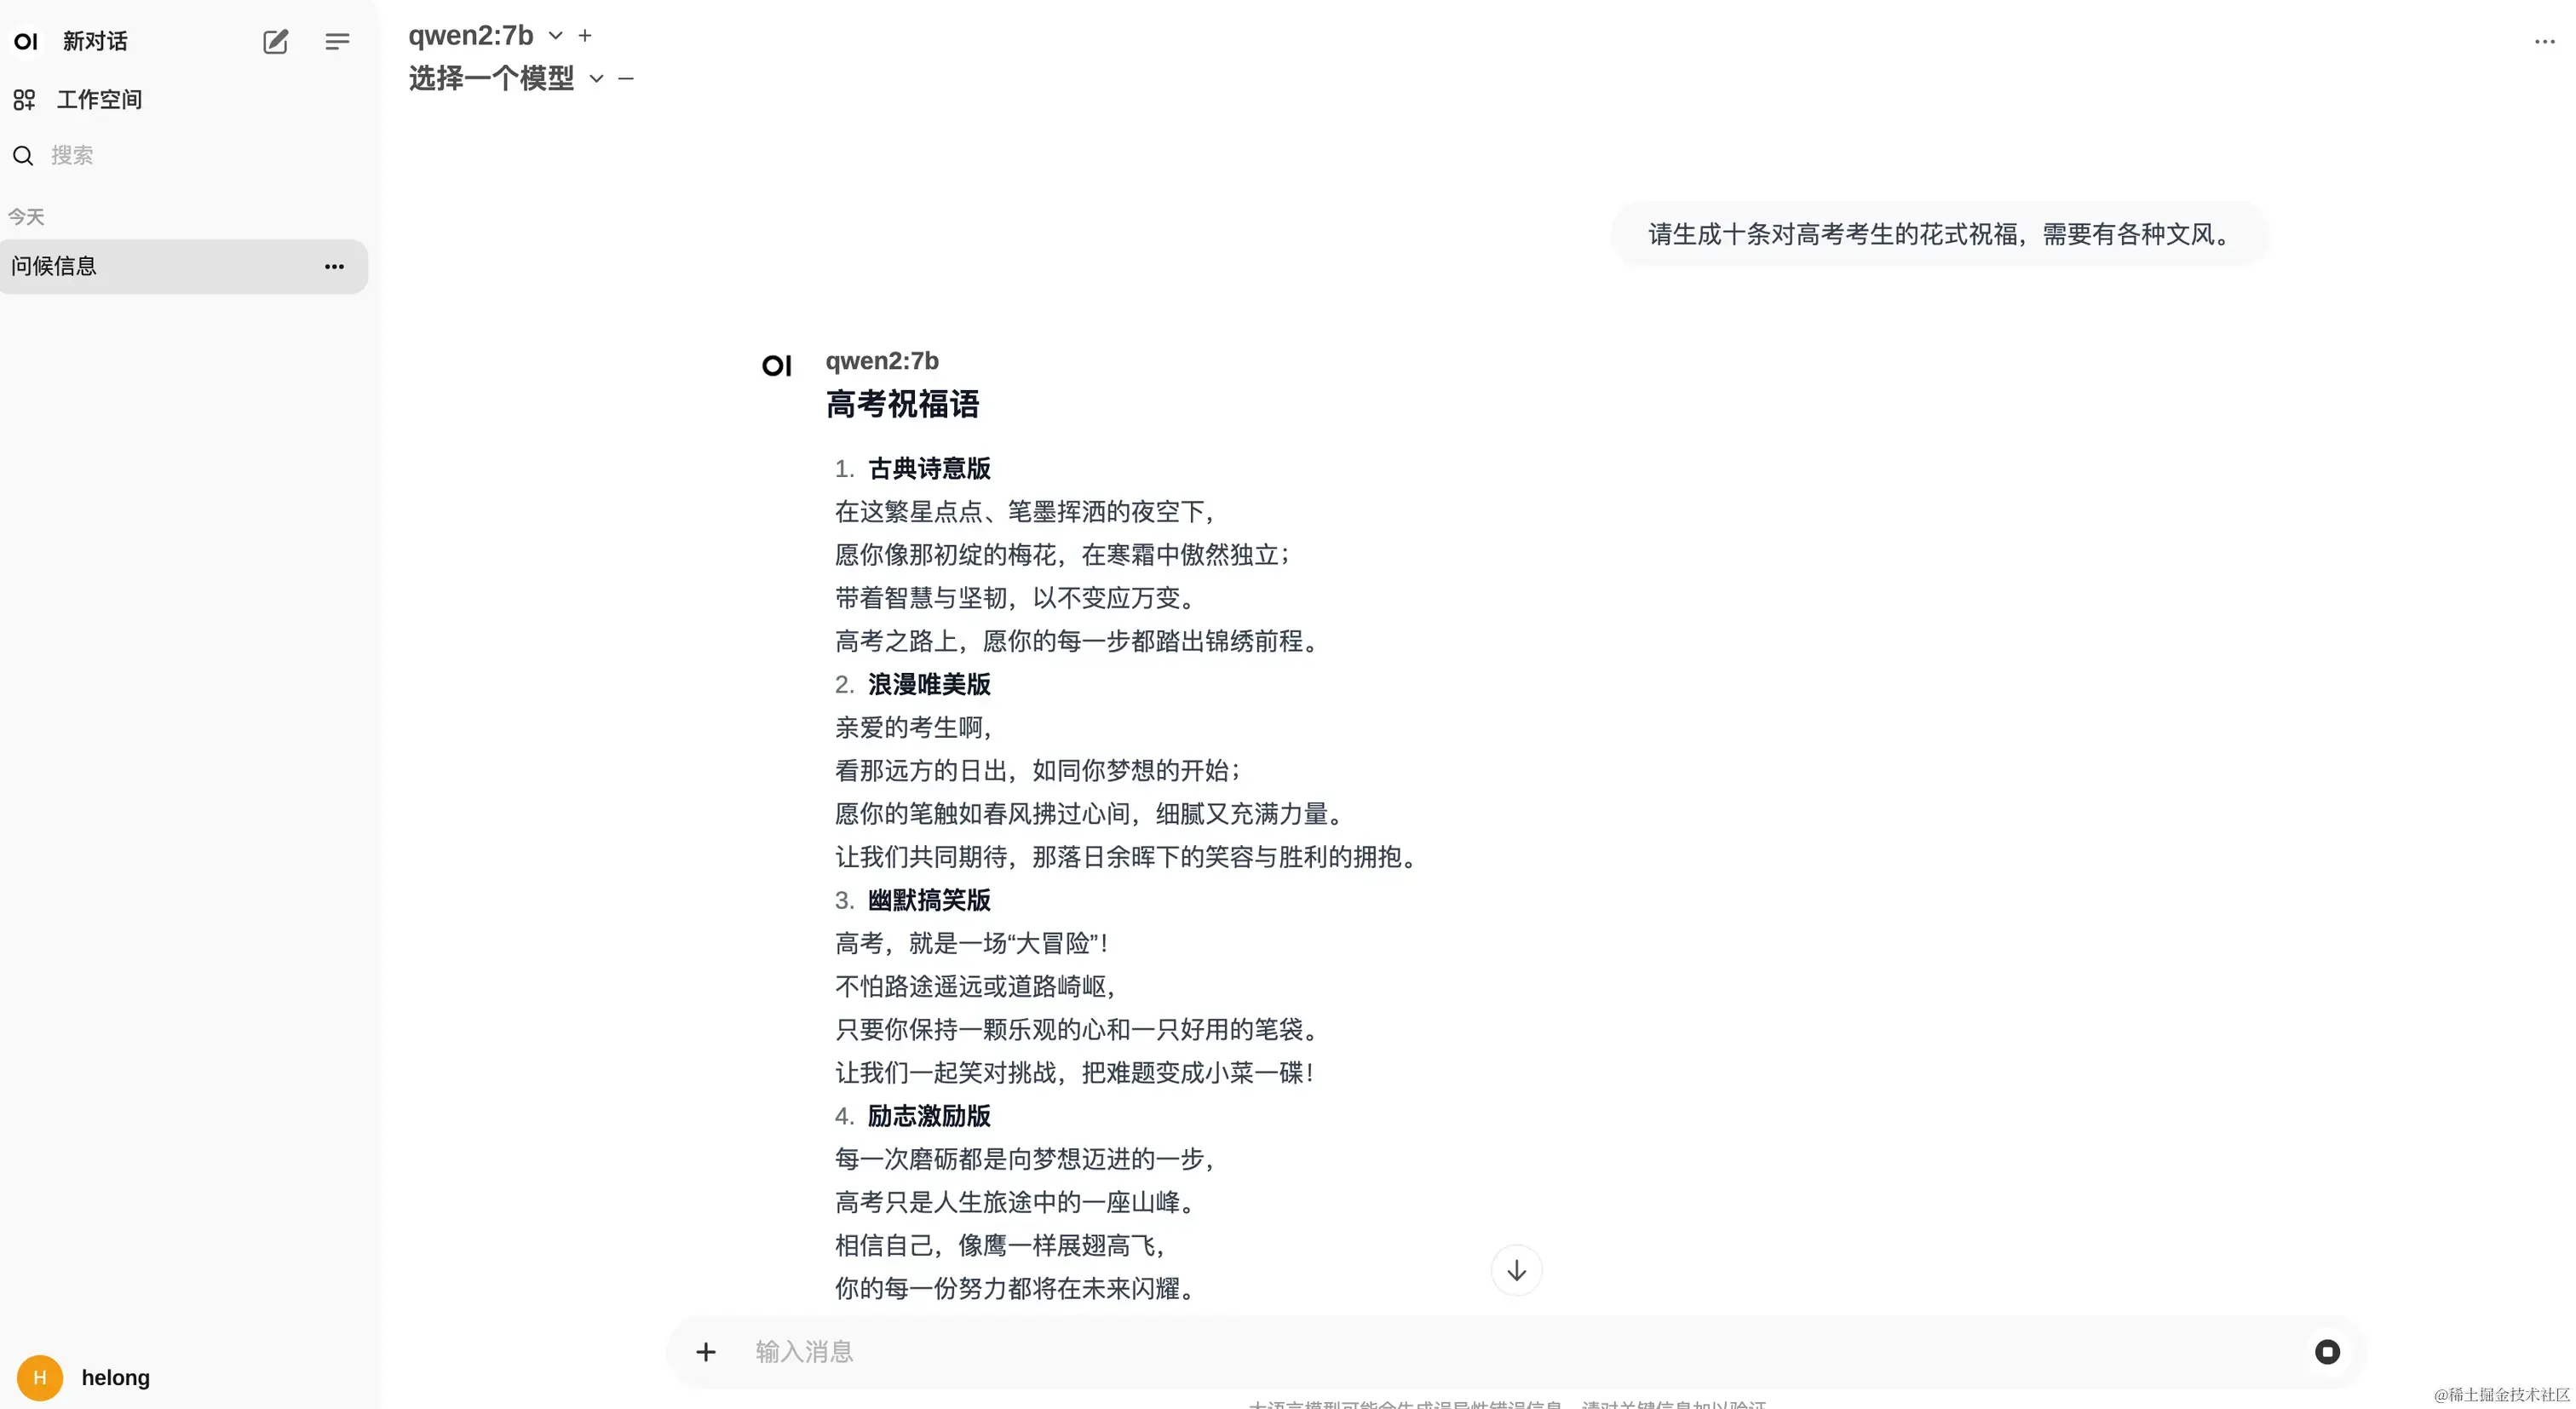
部署完成后,这样使用是不是就友好多了?

但由于我们是要搭建一个个人本地知识库,需要对知识库有更多的掌控,Open Web UI 有些不满足需要,所以我们要用另一个软件。

AnythingLLM

我们先下载安装 AnythingLLM :useanything.com/download

完成安装后大概长这个样子:
然后我们就要开始选择模型了
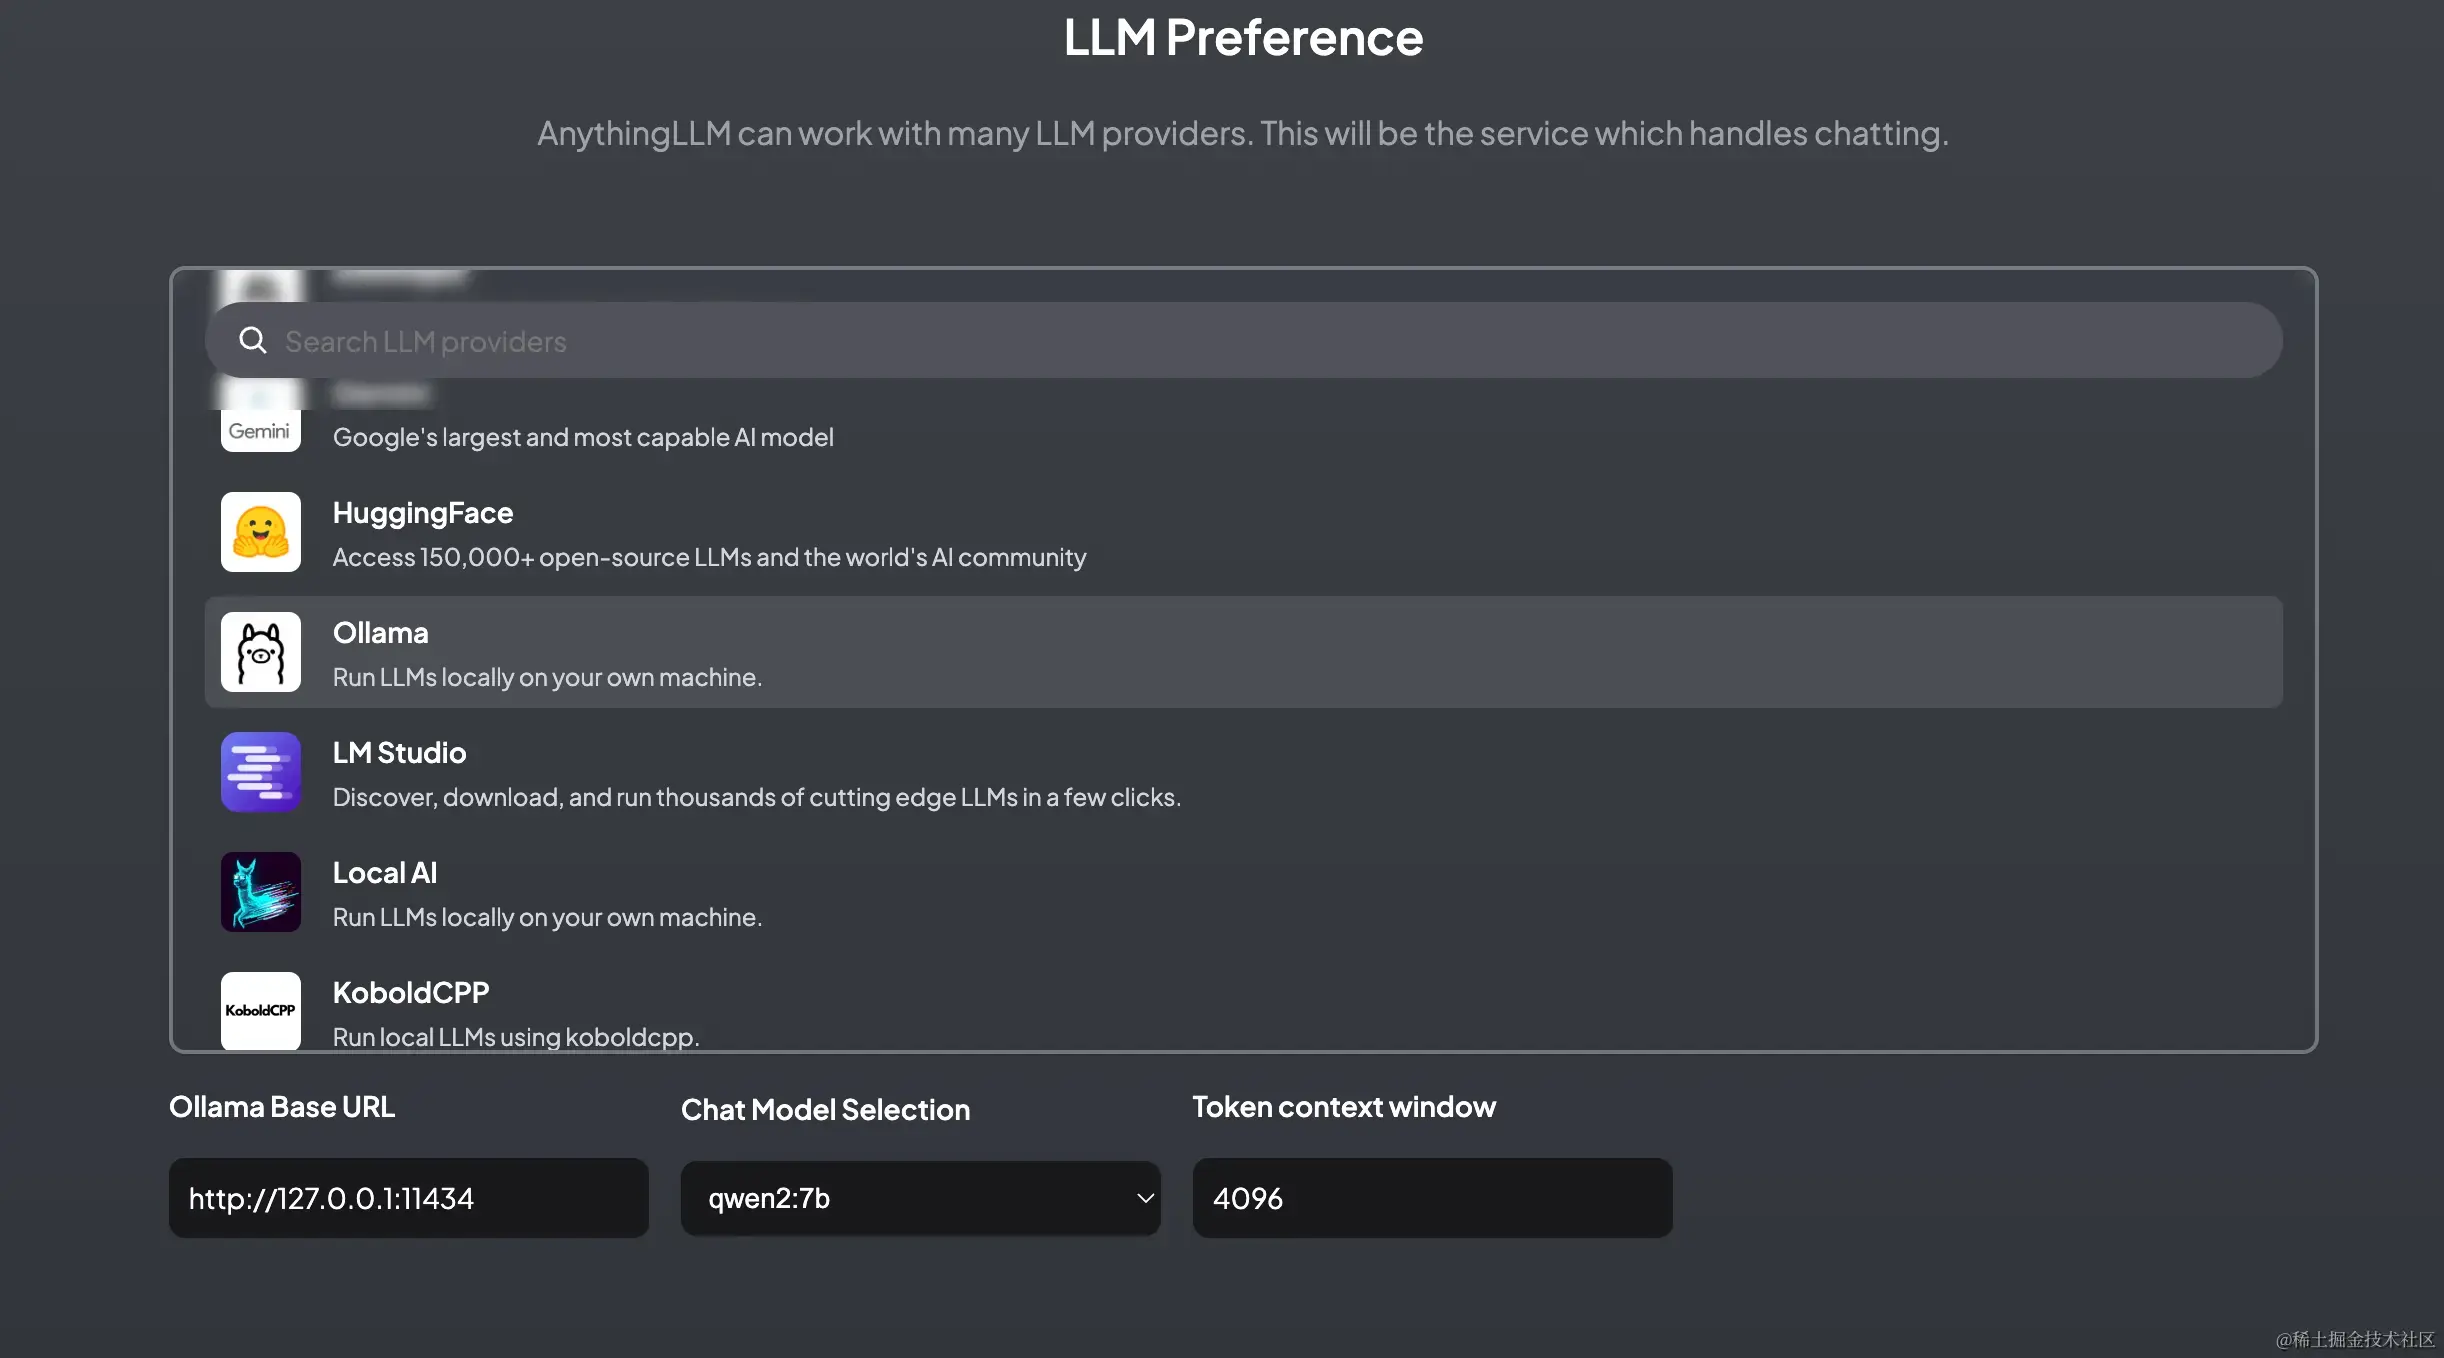
这里注意,我们要用服务器模式启动 Ollama,Ollama其实有两种模式:

  1. 聊天模式
  2. 服务器模式

所谓服务器模式,你可以简单理解为,Ollama在后端运行大模型,然后开放一个端口给到别的软件,让那些软件可以调用大模型的能力。要开启服务器模式非常简单。在终端里输入:ollama serve

用服务器模式启动 Ollama 后:

  • 在AnythingLLM界面中选择 Ollama
  • 然后在 Base URL中填:http://127.0.0.1:11434
  • 模型选择之前下载的 Qwen2.5 7b
  • Token context window 可以先用默认的 4096

完成以上设置后来到下一步
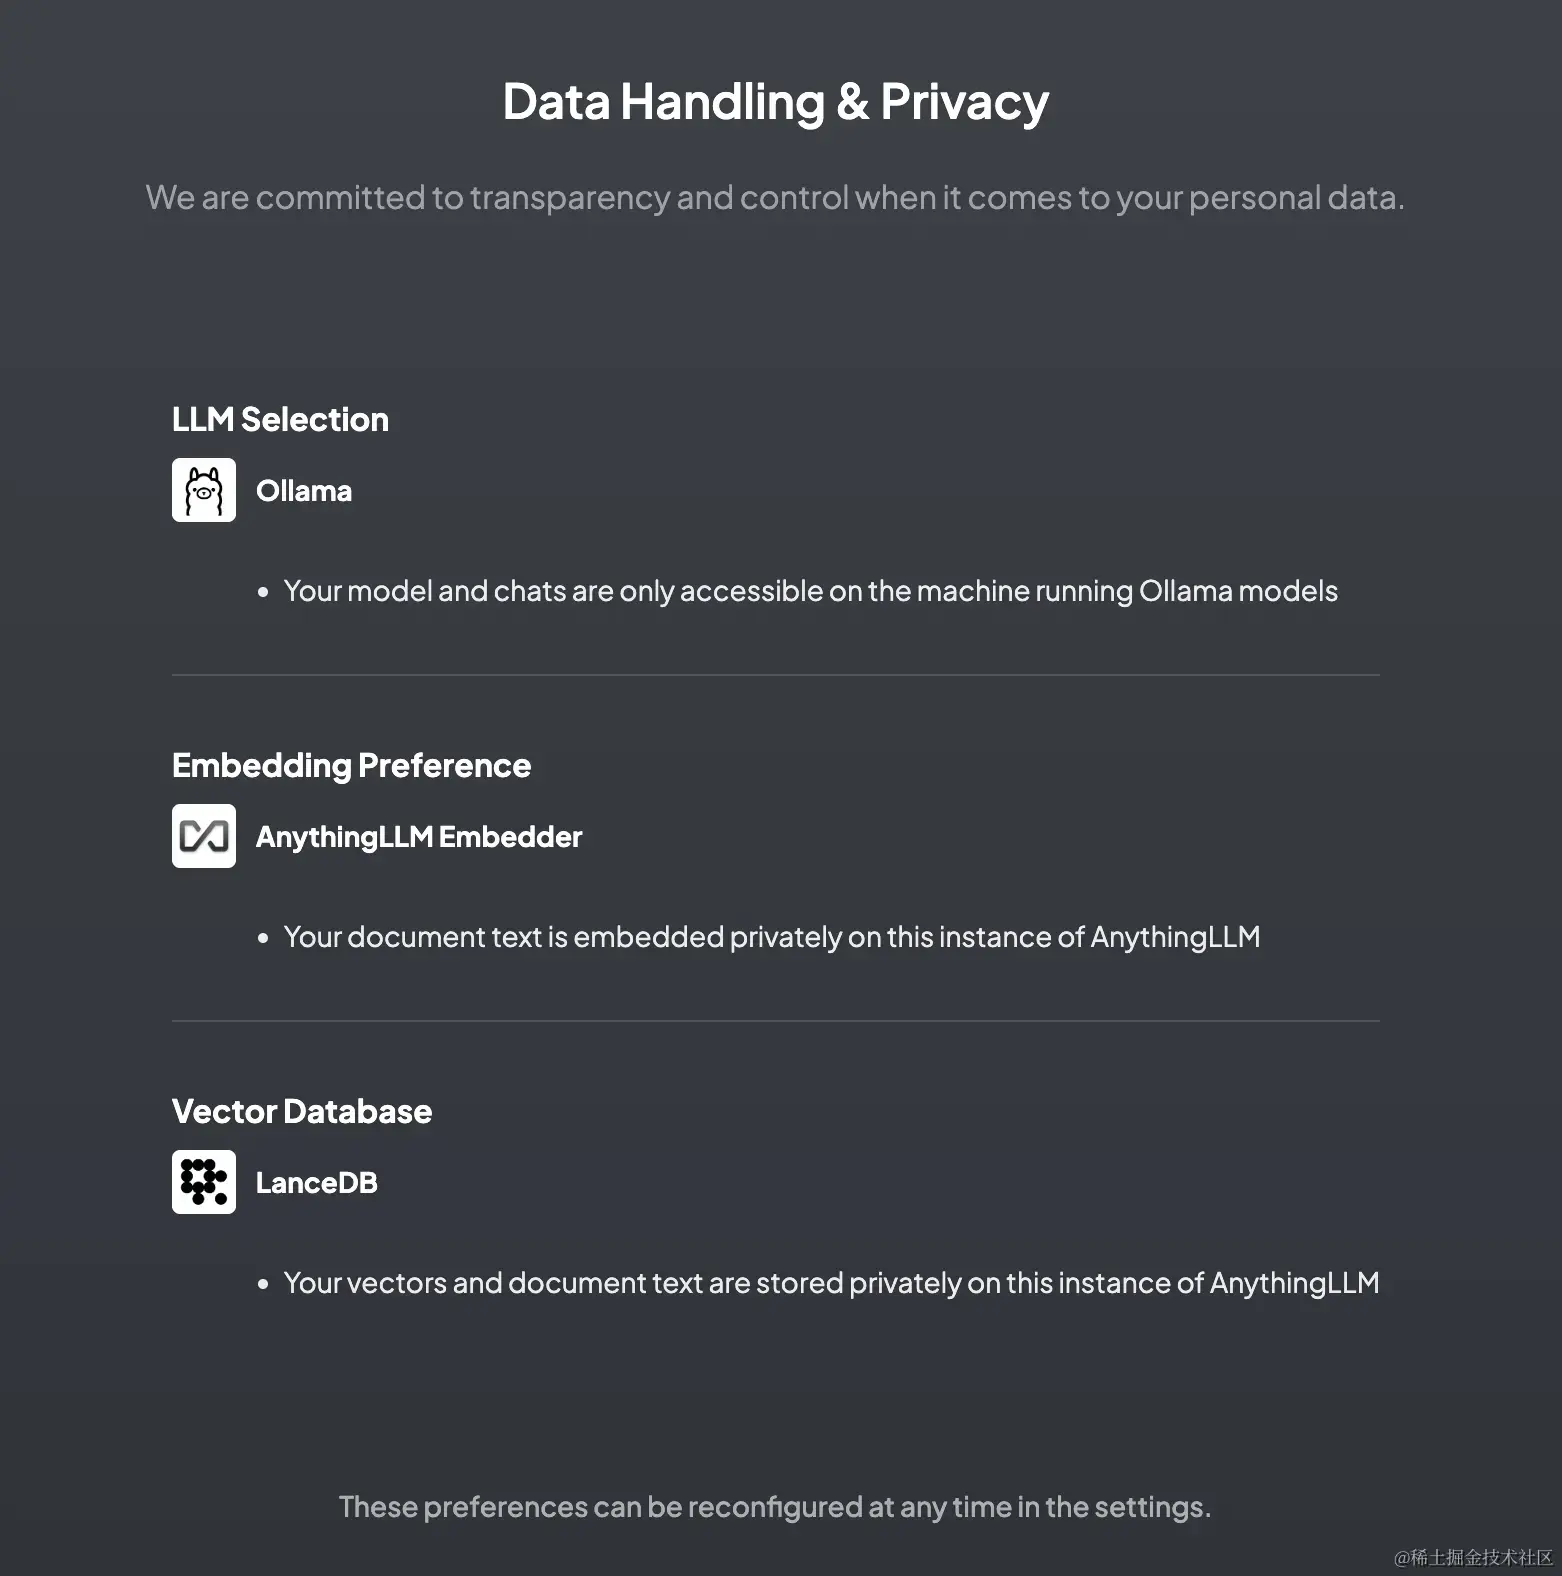
搭建一个知识库,会涉及到另外两个关键:

  1. Embedding Model,嵌入模型。它负责把高维度的数据转化为低维度的嵌入空间。这个数据处理过程在RAG中非常重要。
  2. Vector Store,向量数据库,专门用来高效处理大规模向量数据。

上图中就是默认的嵌入模型以及向量数据库,我们先使用默认的。

  • 然后往下走,下一步是填写个人信息,这步我就省略了。
  • 再下一步是给你的 workspace 起名,我也省略

接着你就可以在建好的 workspace 中上传你的个人知识库的内容了
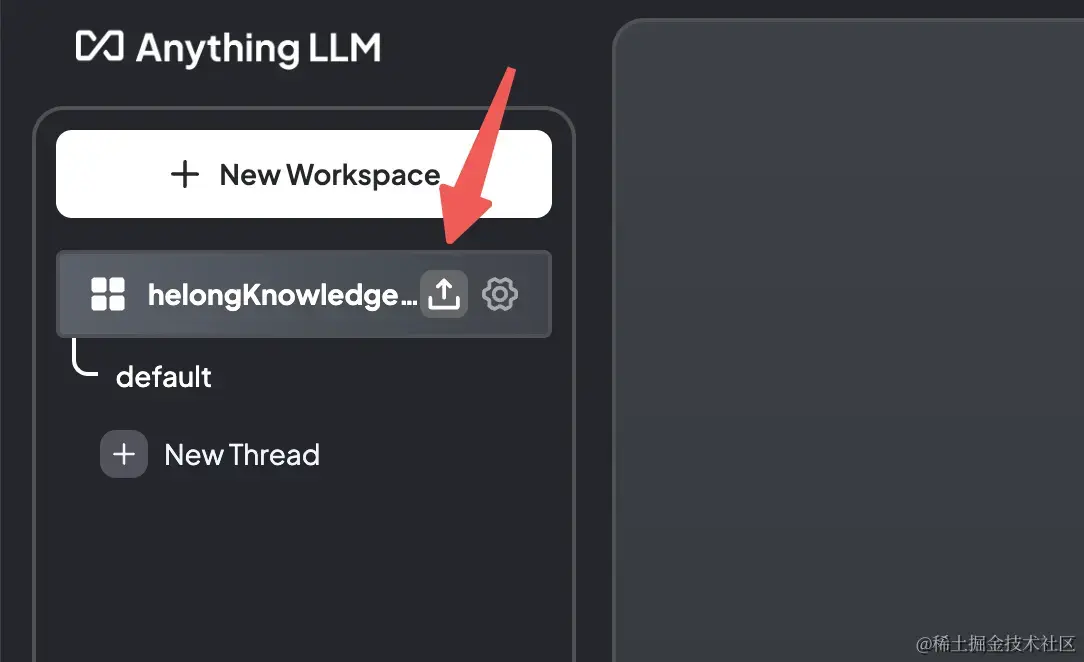
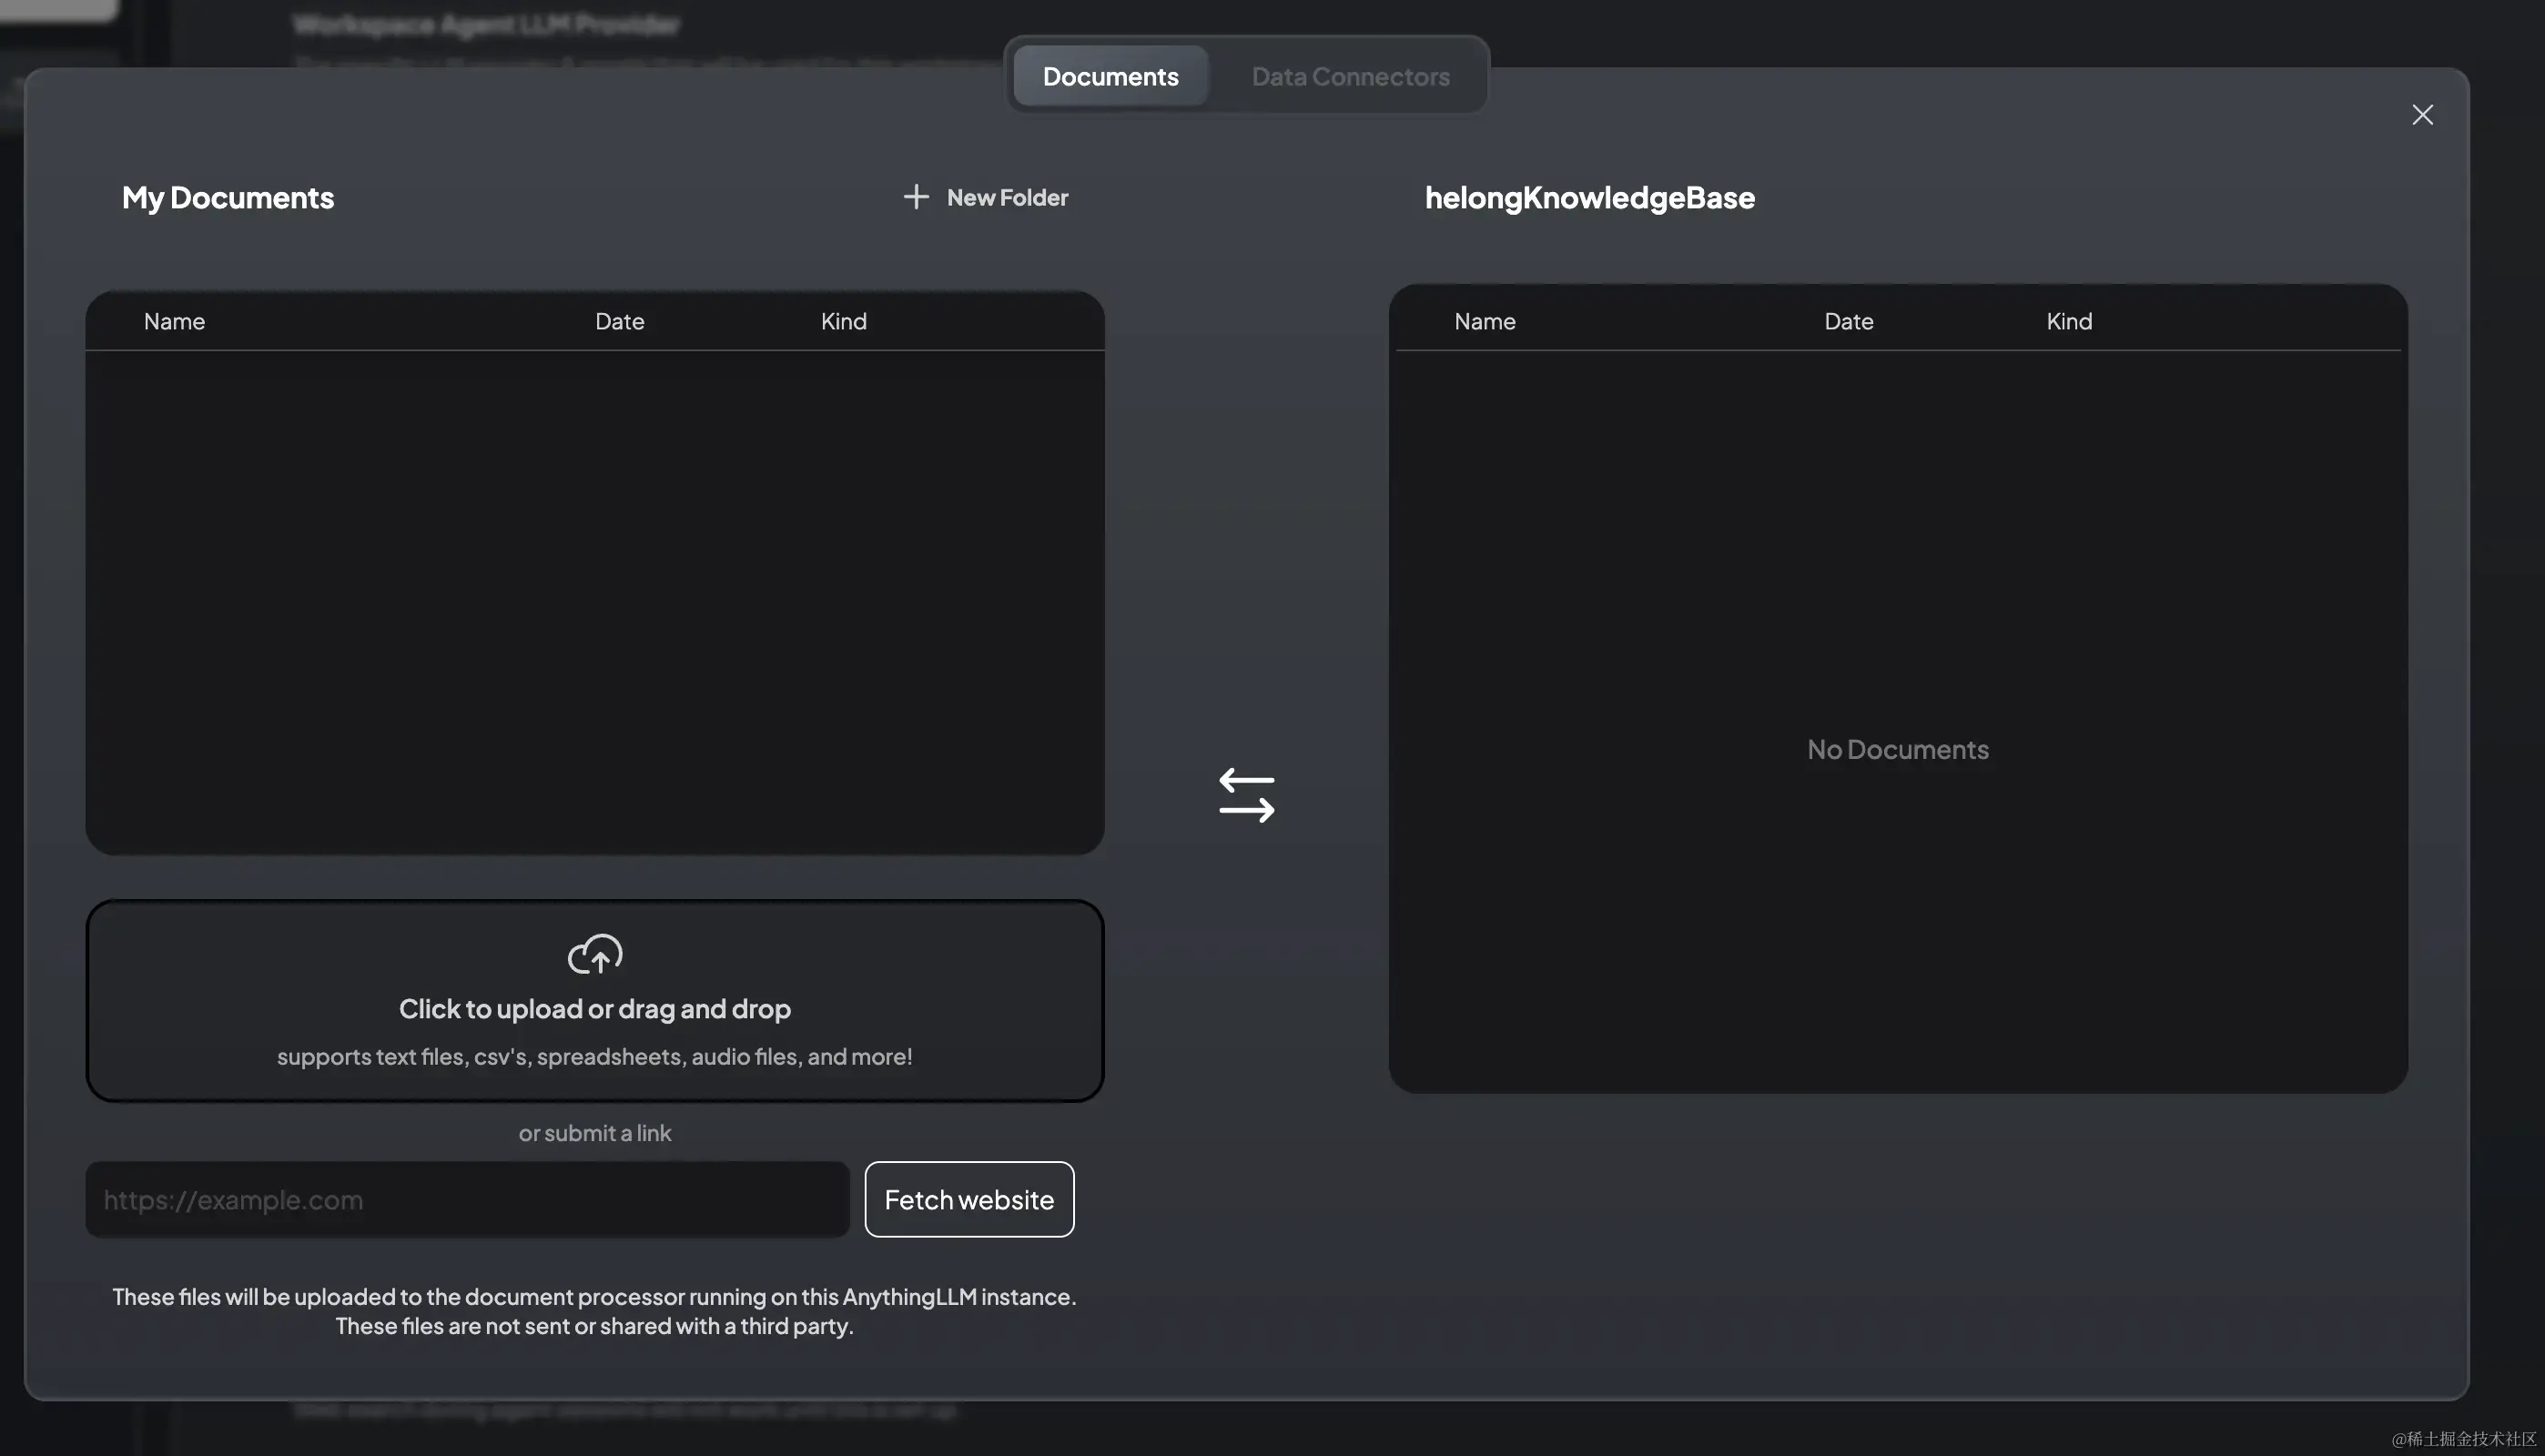
你可以上传文件(支持多种格式 pdf word…),甚至是一个外部的网站链接,不太好的是它不能上传一个文件夹,如果你的文件夹是包含多级目录的,那么它无法识别,你需要把所有文件平铺放在同一级目录中再全选上传。
数据源也可以是其他知识网站:
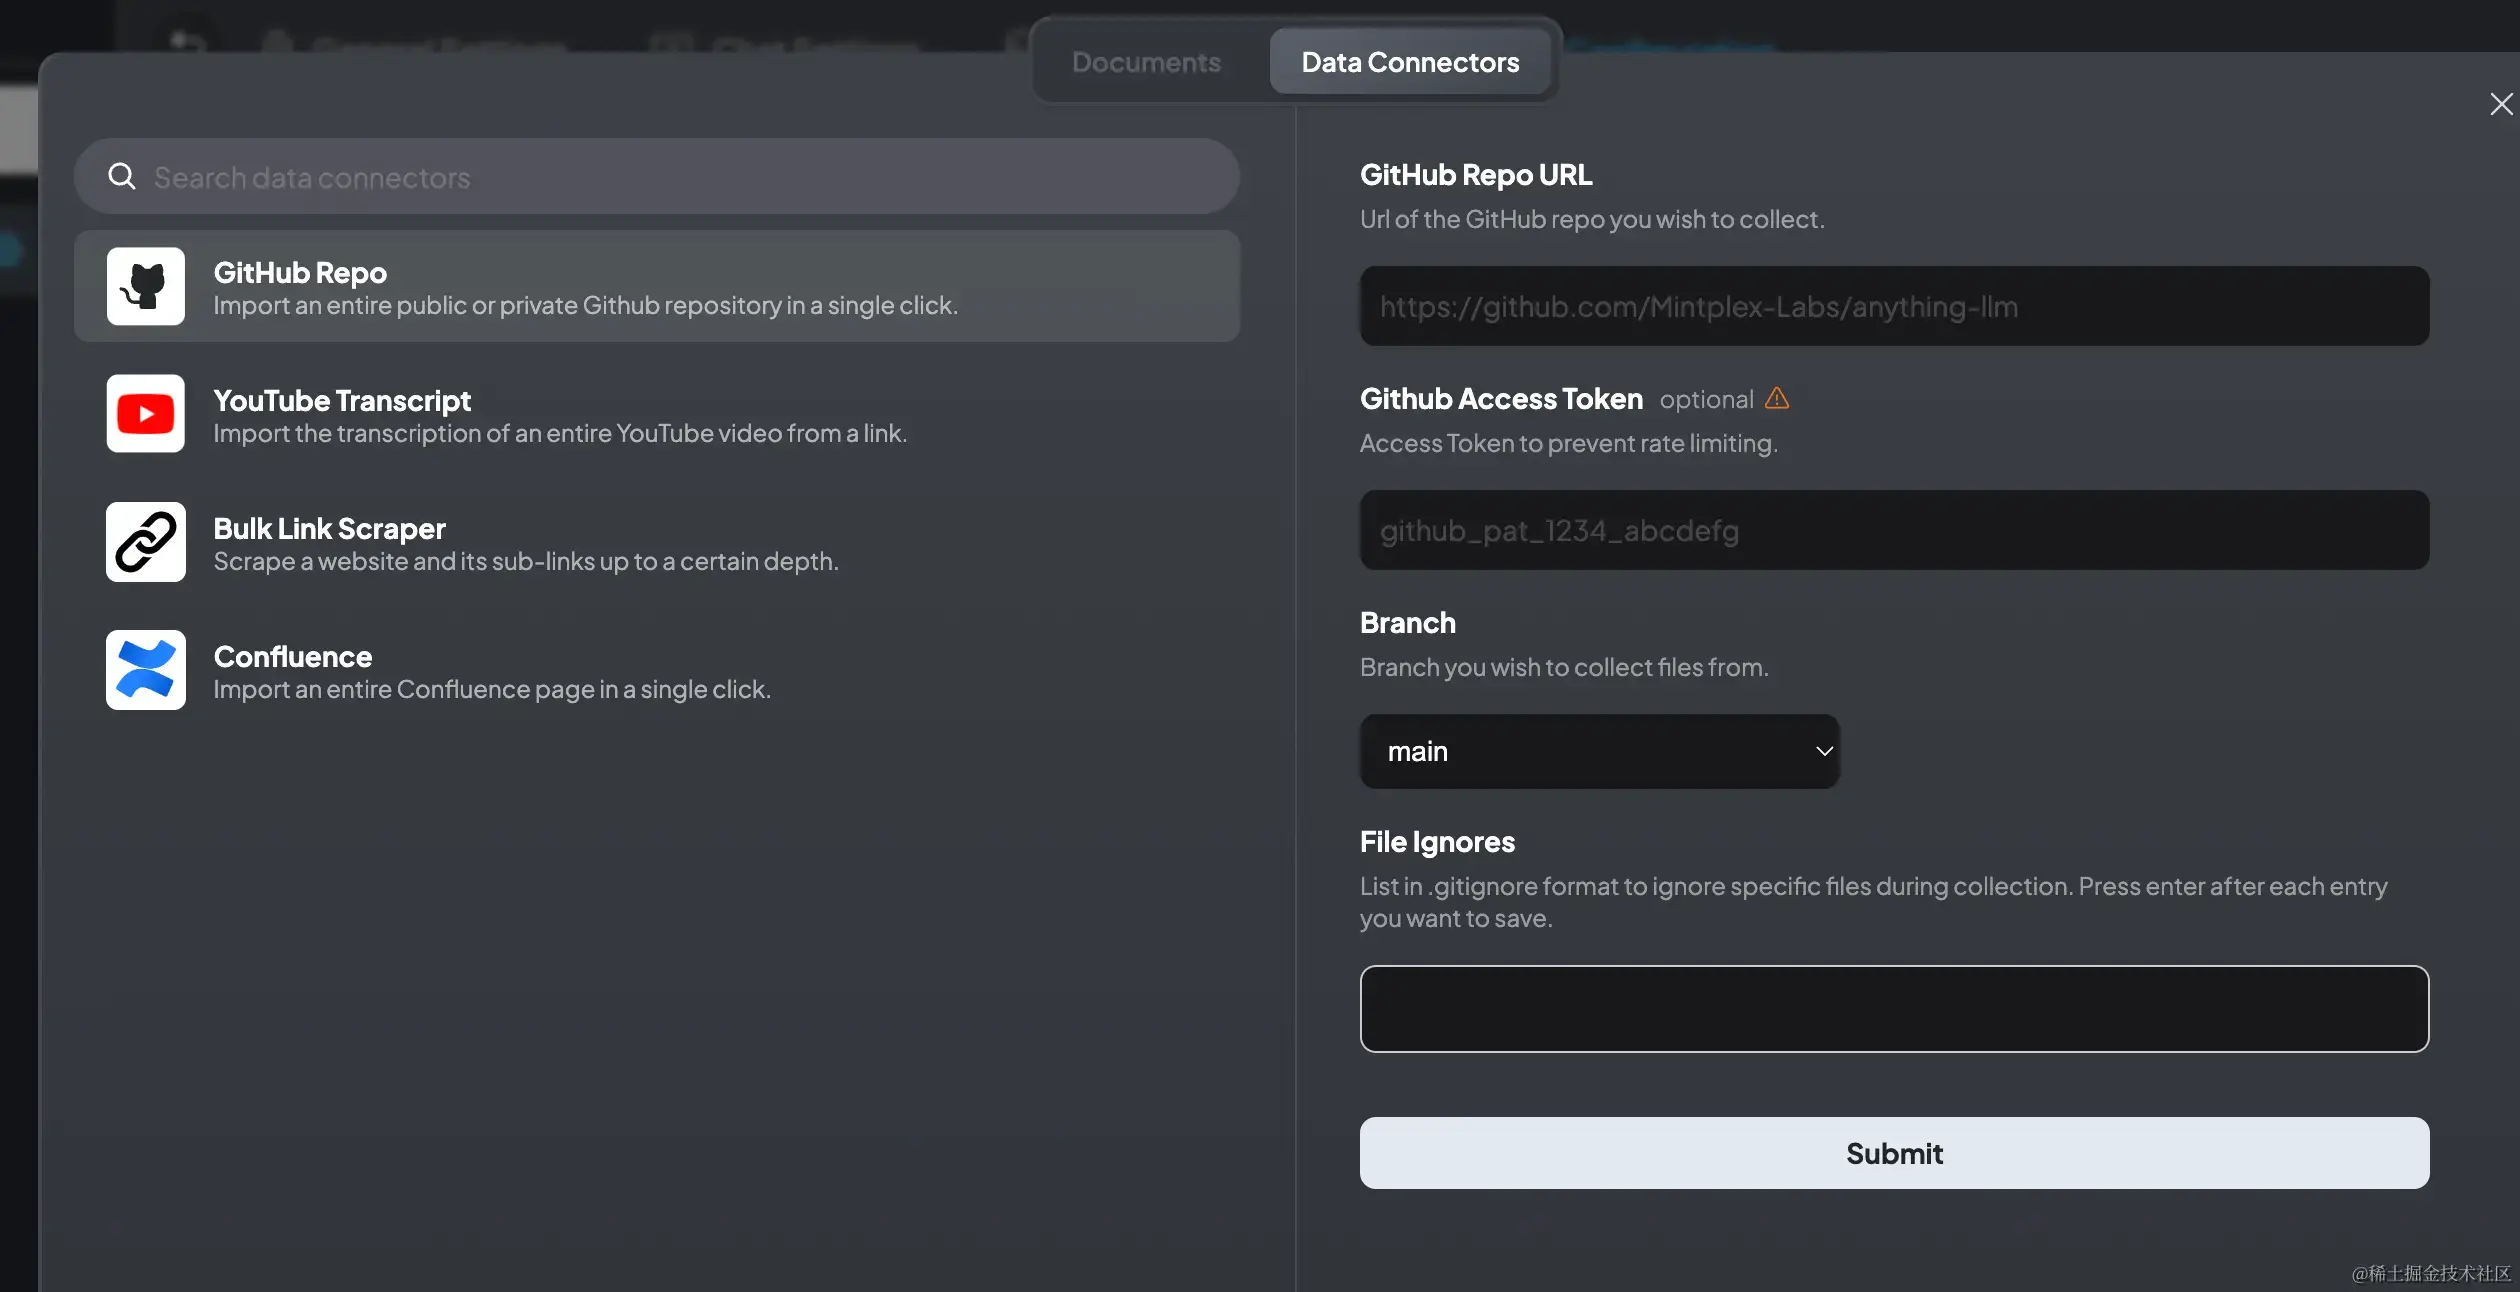
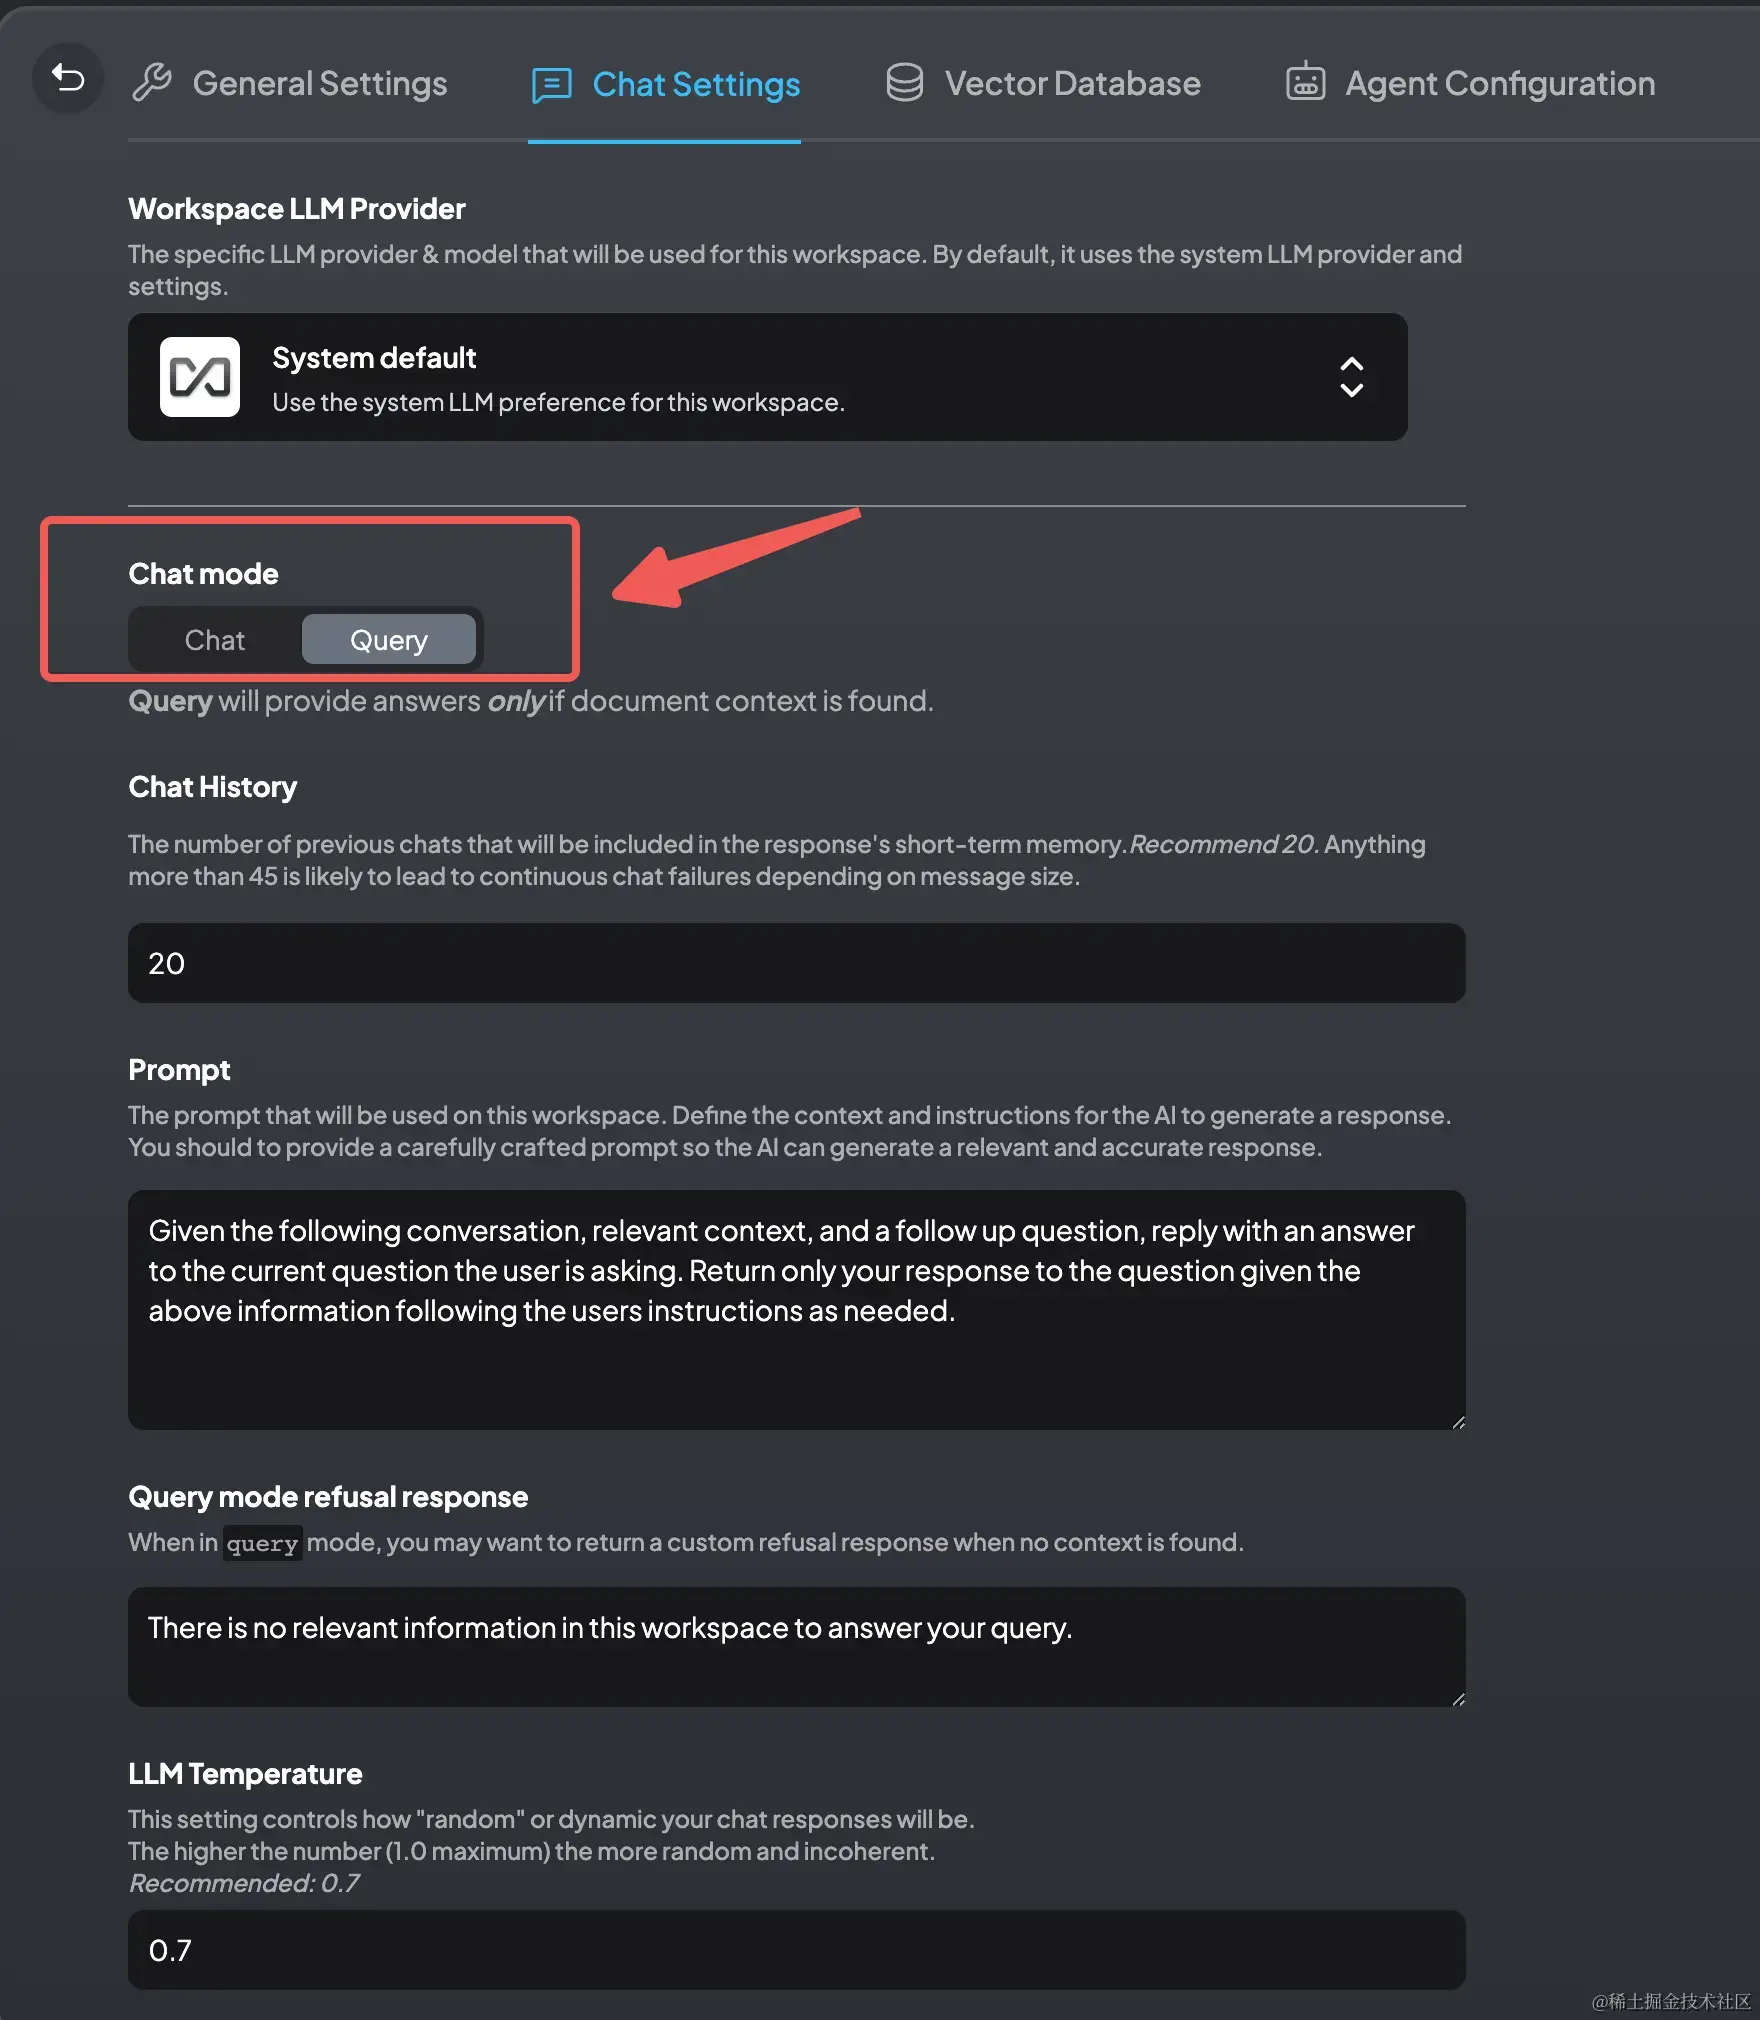
你可以根据项目来创建Workspace,一个项目建一个。然后,把关于这个项目的所有文档、所有网页都导入Workspace。 聊天模式还有两种可以设置:

  1. 对话模式:大模型会根据你给的文档,以及它本来就有的知识储备,综合起来回答。
  2. 查询模式:大模型只是简单地针对文档进行回答。

比如我随便上传了一个 《劳动合同法》 的 pdf 文件,用查询模式进行对话:
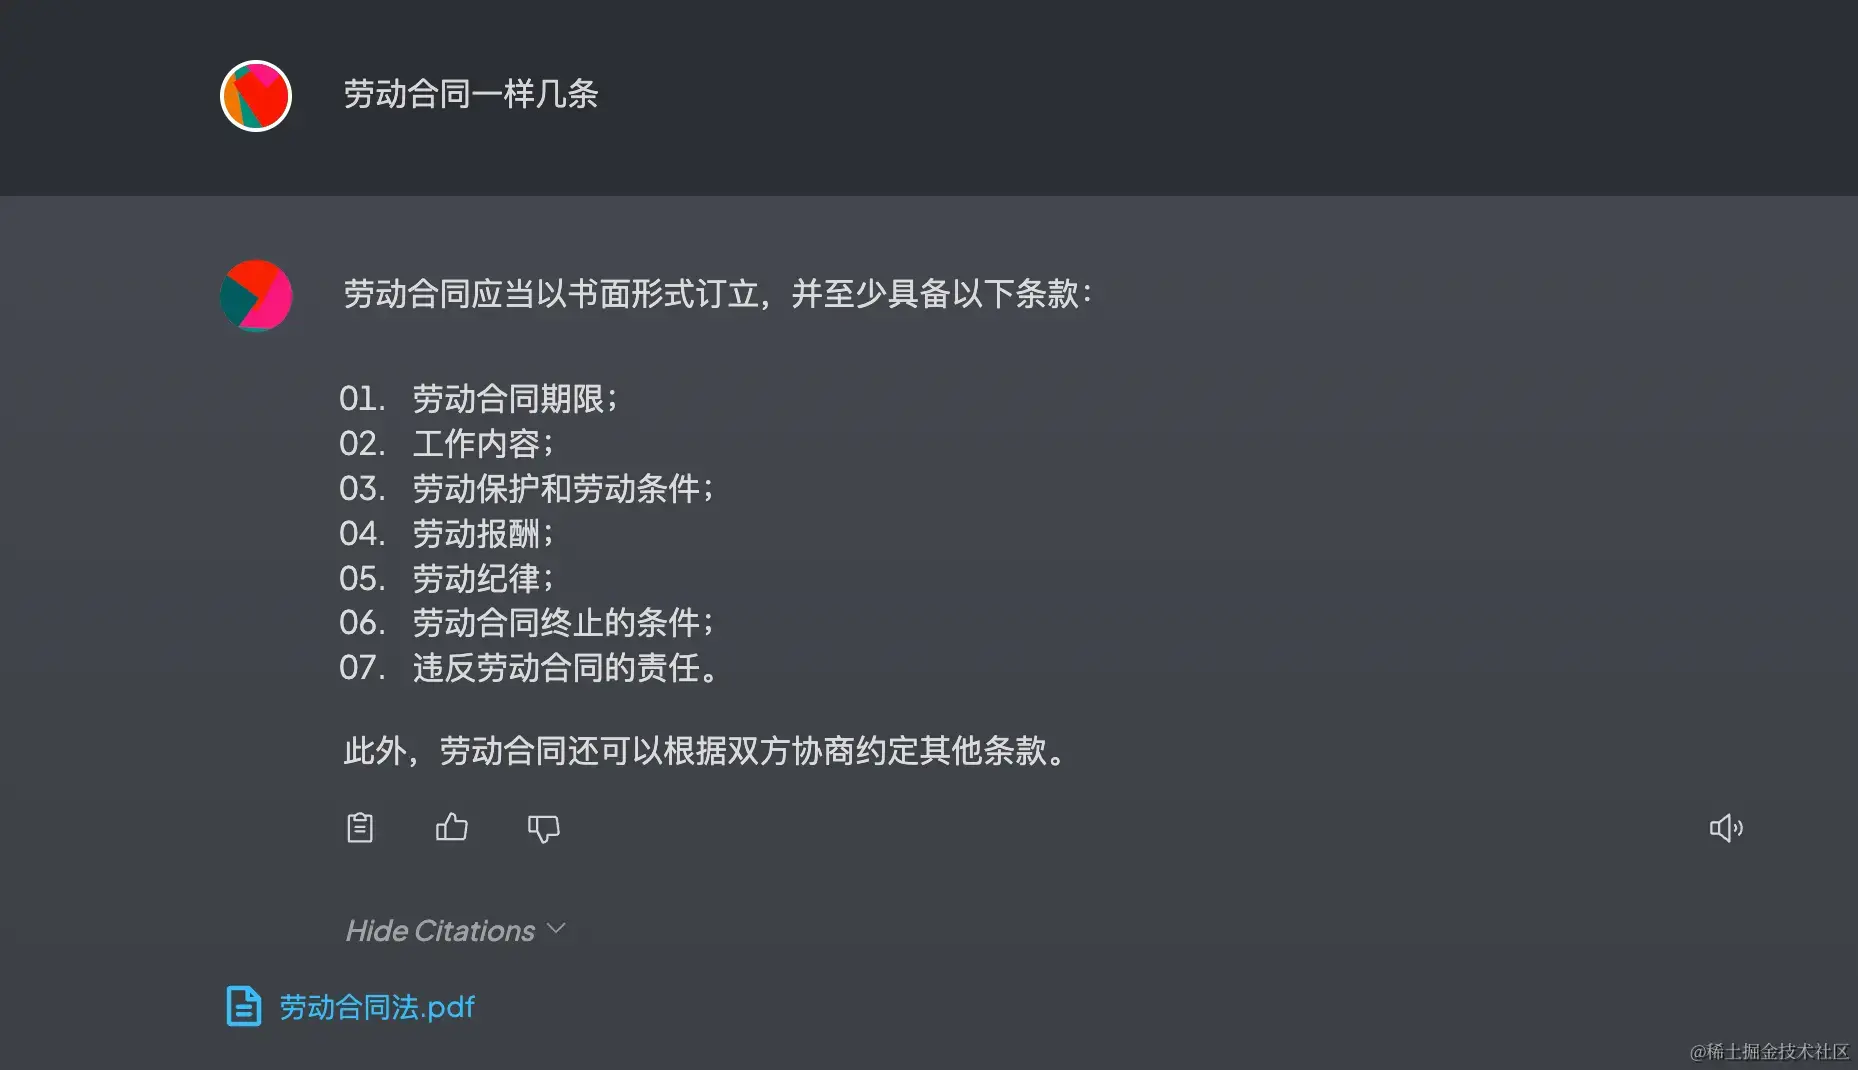
虽然不太对,但内容是从我上传的文件里找到的,还可以点击查看源文件。

我将笔记本中的很多计算机相关的 markdown 文件作为“知识” 上传后,进行问答:
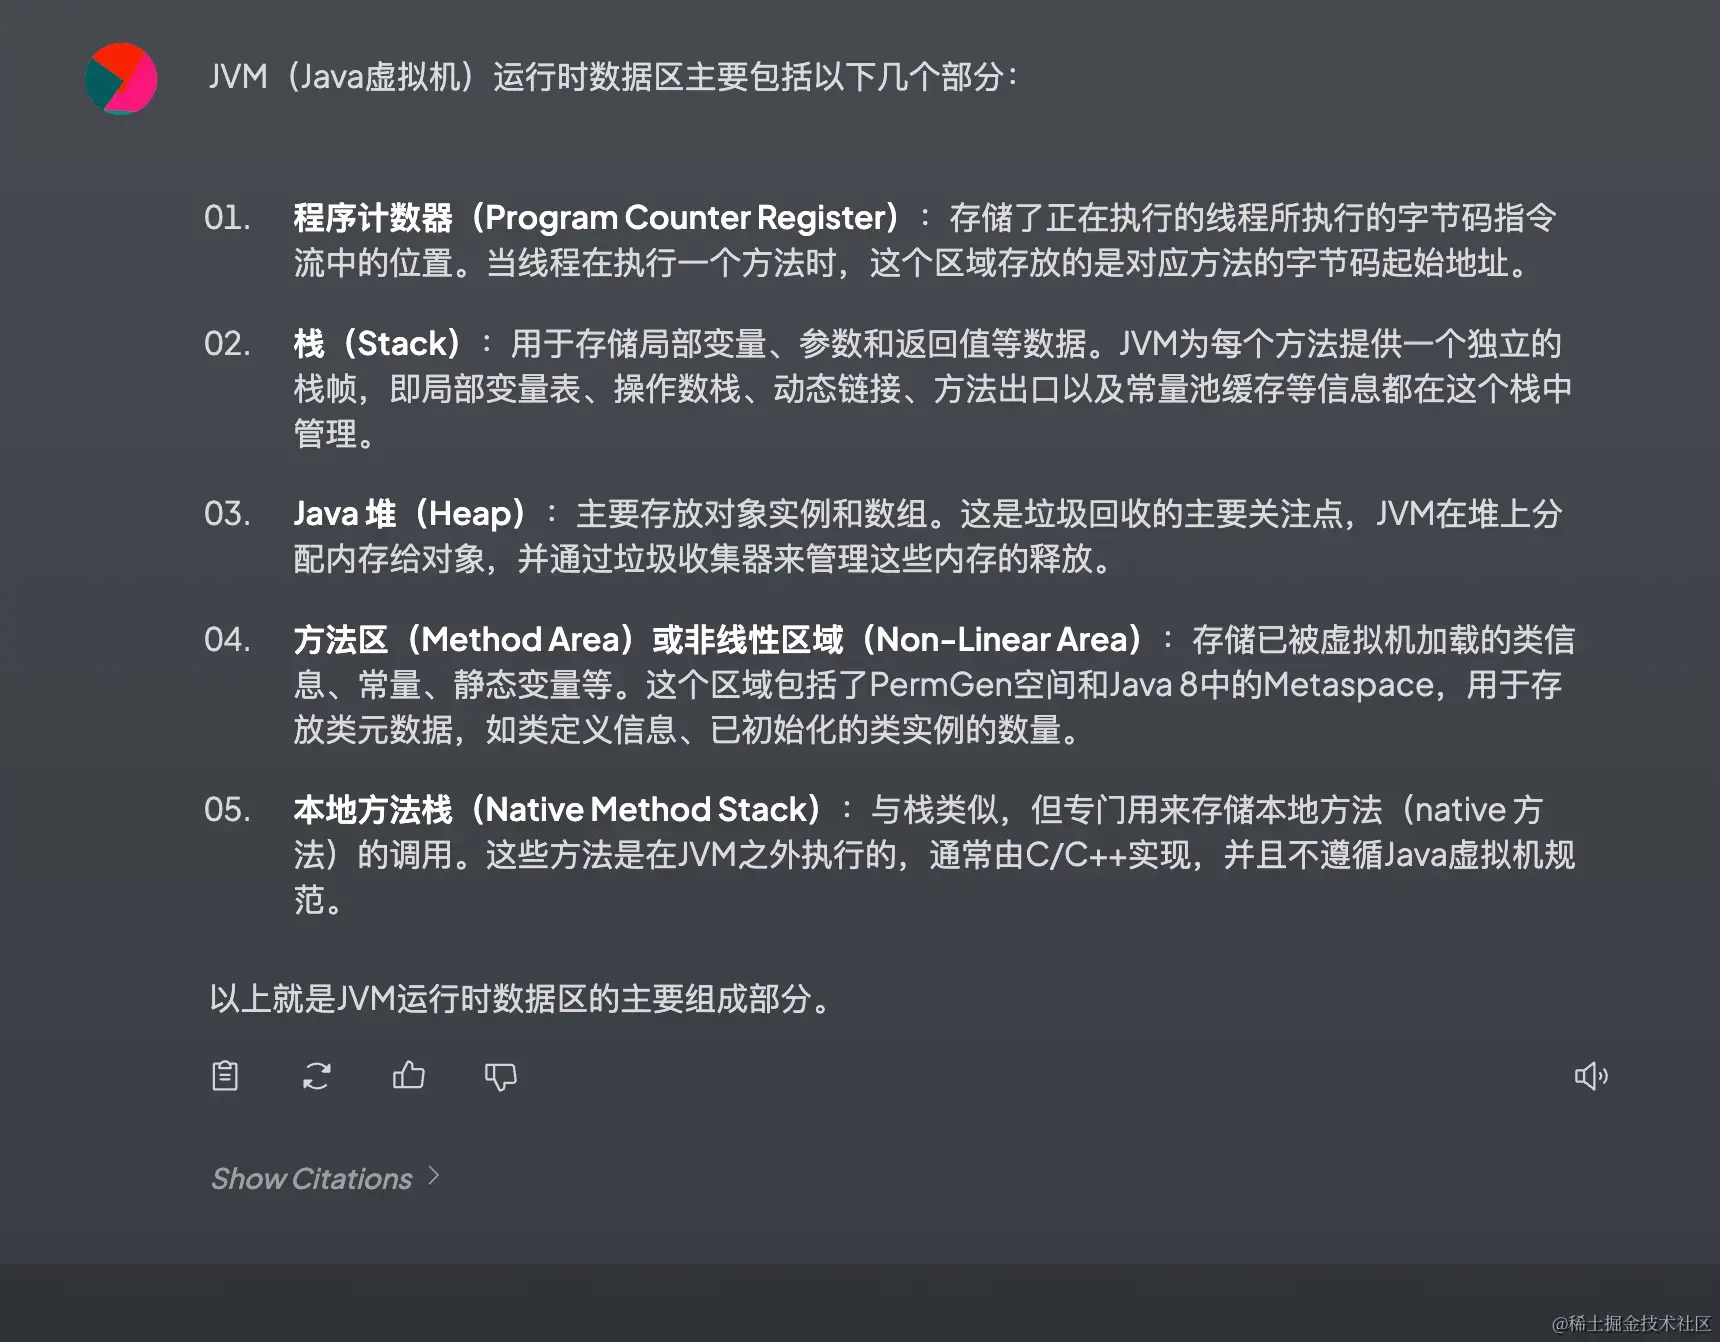
至此,我的本地个人知识库就搭建完成了!

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。

一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

QAnything+Ollama搭建本地知识库 基于QAnything和Ollama搭建本地知识库 阅读详情

相关推荐

Ollama本地私有化部署通义千问大模型Qwen2.5

Qwen是阿里巴巴集团Qwen团队的大型语言模型和大型多模态模型系列。现在大型语言模型已经升级到Qwen2.5。语言模型和多模态模型都是在大规模多语言和多模态数据上进行预训练的,并在符合人类偏好的高质量数据上进行后训练。Qwen具有自然语言理解、文本生成、视觉理解、音频理解、工具使用、角色扮演、人工智能代理等功能。在Qwen2发布的过去三个月里,许多开发人员在Qwen2语言模型上构建了新的模型,向我们提供了宝贵的反馈。在此期间,我们专注于创建更智能、知识更丰富的语言模型。

L 6286

一文带你速通RAG、知识库和LLM!

定制知识库是指一系列紧密关联且始终保持更新的知识集合,它构成了 RAG 的核心基础。这个知识库可以表现为一个结构化的数据库形态(比如:MySQL),也可以表现为一套非结构化的文档体系(比如:文件、图图片、音频、视频等),甚至可能是两者兼具的综合形式。

youmaob的博客 6314

opencode完整使用指南:从安装配置到Agent式编程实战

AI编程工具正从辅助补全向智能体协作演进。编程智能体不仅理解项目全局,还能自主执行原子级重构、测试验证等工程任务,显著提升研发效能。以opencode为代表的开源终端AI编程工具,凭本地优先和灵活模型接入成为技术团队新宠。本文围绕opencode的完整使用链路展开,从Node.js环境准备、npm全局安装,到解决Windows环境变量配置问题,再到接入OpenAI、Anthropic或多模型管理平台,梳理一套标准化接入方案。同时演示VSCode插件调用、LSP语义分析及Playwright驱动的浏览器自动化

weixin_28837817的博客 319

Qwen2.5 全链路模型体验、下载、推理、微调、部署实战!

进行微调。在这里,我们将展示可直接运行的demo。

xxue345678的博客 2万+

AI辅助专利撰写实战:30分钟高效产出发明专利初稿

在技术创新的浪潮中,专利撰写常常是开发者将创意转化为知识产权保护壁垒的关键一步,但这个过程往往耗时费力,需要兼顾技术深度与法律文书规范。近期,借助AI辅助工具来提升专利撰写效率已成为一个热门探索方向。本文将围绕如何利用AI工具,在30分钟内高效完成一篇具备授权潜力的发明专利初稿,进行一场从0到1的实战演练。无论你是独立开发者、初创团队的技术负责人,还是希望保护自己研究成果的学生,这套方法都能帮助你快速梳理技术方案,形成结构严谨、逻辑清晰的专利申请文档。 1. 背景与核心概念:AI辅助专利撰写的价值与边界 在

weixin_34253126的博客 495

深入解读ATPG Pattern类型:除了Basic Scan,Clock PO和RAM Sequential模式怎么用?

本文深入解析ATPG高级Pattern类型,包括Clock PO和RAM Sequential模式的应用策略。通过Mentor DFT工具链中的Tessent平台,详细介绍了这些模式的工作原理、配置命令及实战案例,帮助提升芯片测试的故障覆盖率和效率。特别适用于处理时钟域交叉和嵌入式存储器的复杂电路测试需求。

weixin_27697385的博客 490

RAG 实践-Ollama+AnythingLLM 搭建本地知识库(附教程)

RAG的核心机制融合了信息检索系统的精确性和语言模型的强大生成能力,为基于自然语言的任务提供了更为灵活和精准的解决方案。

Y525698136的博客 2002

EtherCAT应用层协议选型指南:CoE、SoE、EoE、FoE、AoE到底怎么选?看完这篇就懂了

本文深入解析EtherCAT应用层协议(CoE、SoE、EoE、FoE、AoE)的选型策略,从实时性、数据吞吐量和功能完整性三大核心指标出发,提供工业场景下的实战决策框架。通过技术特性对比、混合协议架构设计和常见故障规避指南,帮助工程师优化自动化设备通信性能。

weixin_28718793的博客 496

RAG实践指南:利用Ollama+AnythingLLM搭建本地知识库

RAG,即检索增强生成(Retrieval-Augmented Generation),是一种先进的自然语言处理技术架构,它旨在克服传统大型语言模型(LLMs)在处理开放域问题时的信息容量限制和时效性不足。RAG的核心机制融合了信息检索系统的精确性和语言模型的强大生成能力,为基于自然语言的任务提供了更为灵活和精准的解决方案。

2401_85343303的博客 1824

【微信读书】数据内容接口逆向解析实战:从请求捕获到文本提取

本文详细解析了微信读书网页版数据内容接口的逆向工程实战过程。通过浏览器开发者工具捕获网络请求,定位关键API接口,并深入JavaScript代码分析数据解析逻辑,最终实现从请求模拟到文本提取的完整流程。文章旨在技术学习,探讨Web应用数据交互原理,帮助开发者理解现代前端数据流与编码机制。

game4的博客 421

MATLAB 控制 E4438C 信号源的研究

通过 MATLAB,我们可以实现对 E4438C 的远程控制,从而实现更高的自动化和可编程性。总结起来,通过使用 MATLAB 和 Instrument Control Toolbox,我们可以轻松地控制 E4438C 信号源并生成各种类型的信号。需要注意的是,以上代码仅为示例,实际应用中可能需要根据具体情况进行更详细的配置和错误处理。此外,MATLAB 还提供了一系列函数和命令,可用于控制 E4438C 信号源的其他功能,如频率调谐、功率设置、调制设置等。您可以根据自己的需求进行相应的配置和控制。

RswtPerl的博客 1015

RAG 实践-Ollama+AnythingLLM ,零基础也能轻松搭建本地知识库

RAG 技术特别适合用来做个人或企业的本地知识库应用,利用现有知识库资料结合 LLM 的能力,针对特定领域知识的问题能够提供自然语言对话交互,且答案比单纯用 LLM 准确性要高得多。

huang9604的博客 1648

YOLOv8 改进:添加 LSK 注意力机制

通过添加 LSK 注意力机制,YOLOv8 能够更有效地捕捉特征图上的重要信息,提高检测性能,尤其是在复杂场景下展现出色的表现。这种方法不仅适用于资源受限的设备,还能在丰富多样的实际应用中提供强劲支持。

走向CTO的路上... 1223

RAG实践教程:Ollama+AnythingLLM 搭建本地知识库(附教程)

RAG的核心机制融合了信息检索系统的精确性和语言模型的强大生成能力,为基于自然语言的任务提供了更为灵活和精准的解决方案。

2301_81940605的博客 852

保姆级教程:ABAP 通过 HTTP POST 调用 OData 服务创建业务数据的具体例子

笔者之前的文章发布之后,有朋友在评论区留言,询问 ABAP 除了 Web Service 之外,是否也支持 HTTP 呢?ABAP 这么强大的语言,支持 HTTP 当然不在话下。网上有很多在 ABAP 系统基于 CL_HTTP_CLIENT 工具类,通过 HTTP 协议和第三方系统交互的代码例子。本文介绍笔者项目中一个实际例子,实现的是在 ABAP 系统 A 通过 HTTP 调用 OData 服务,在 ABAP 系统 B 创建业务数据的需求。下面我们按照这个套路来一步步实现。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 706

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

RAG实践 - 搭建本地知识库 - Ollama + AnythingLLM

RAG,即检索增强生成(Retrieval-Augmented Generation),是一种先进的自然语言处理技术架构,旨在克服传统大型语言模型(LLM)在处理开放域问题时的信息容量限制和时效性不足。RAG通过融合信息检索系统的精确性和语言模型的强大生成能力,为基于自然语言的任务提供了更灵活和精准的解决方案。

sagima_sdu的博客 4016

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

上一篇: RAG流程优化(微调)的4个基本策略
下一篇: [大语言模型:基础与前沿] 首位AI程序员上线,关于LLM的好机会都写在了这本书里!
AI大模型_学习君
博客等级 码龄3年 6138粉丝 551原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值