Transformer 能代替图神经网络吗?

Transformers与图神经网络的关系,我们能从transformer学习到什么? 1、导读 这个观点的目的是构建Transformer结构背后的NLP上的直觉,以及与图神经网络的联系。 图深度学习”听起来很厉害,但有什么大的商业成功的故事吗?它有没有被部署在实际app中? 除了Pinterest、阿里巴巴和Twitter的推荐系统外,一个非常小的成功就是Transformer结构,这个结构带来了NLP的风暴。 通过这篇文章,我想在Graph Neural Networks (GNNs)和transformer之间建立联系。我会讨论NLP和GNN社区中,模型架构背后的直觉,使用方程和图把这 阅读详情

图片当Transformer模型发布时,它彻底革新了机器翻译领域。虽然最初是为特定任务设计的,但这种革命性的架构显示出它可以轻松适应不同的任务。随后成为了Transformer一个标准,甚至用于它最初设计之外的数据(如图像和其他序列数据)。

然后人们也开始优化和寻找替代方案,主要是为了减少计算成本(自注意力机制的二次方成本)。关于哪种架构在计算成本方面更优的讨论一直在进行,但是对于Transformer来说,它的成功之处在于模型能够展示出强大的推理能力。


如何分析神经网络的推理能力?

最常用的方法之一是研究利用架构内部表示能执行哪些算法。有一个完整的领域致力于这项任务:Neural algorithmic reasoning。Transformer是否能进行泛化,或者通过扩展是否能解决一些问题,这些问题仍然悬而未决,并且这方面的研究也十分活跃。

有些人认为Transformer具有普适推理能力,而其他人认为它是引领我们走向人工通用智能的架构(假设我们能够足够扩展它),但是目前看Transformer能够在不同的领域,NLP,时间序列,甚至CV中取得良好的成绩但是测试其极限也非常重要。我们不仅需要测试它的极限,还需要与其他架构进行比较,并在未来建立基准。

在最近的一项研究中,研究人员决定深入研究一个特定的领域:图神经网络。

今天介绍的这篇论文叫“Understanding Transformer Reasoning Capabilities via Graph Algorithms”

图片

这可能听起来有些奇怪,但近来Transformer(以及大型语言模型)与图(Graphs)之间的关系越来越密切。首先,自注意力可以被视为一种图的形式。其次,图(尤其是知识图谱)可以用来扩展Transformer。第三,图是复杂推理的理想抽象。思维链条和其他技术也可以被视为图的一种抽象。另外许多图问题可以通过简单的架构解决,而其他问题则需要复杂的推理和先进的图神经网络(GNNs)。

图片

图计算已经成为过去几十年计算和人工智能中几个成功设计的基础之一,例如用于蛋白质预测的AlphaFold。许多推理任务可以表达为关于图的推理(这就是为什么像Tree of Thoughts或Graph of Thoughts这样的技术显示出成功)。所以这似乎是测试Transformer能力的最佳选择。

尽管有不同的理论前提,但是进行严格分析并不容易:

图推理任务可以被归类到已知的计算类别中。但是当我们想要评估一个神经网络解决这些任务的能力时,情况就不同了。在Transformer的情况下,我们也感兴趣的不仅仅是固定深度的情况,还有通过改变层数从而学习更简单或更复杂的表征时的变化。并且Transformer也可以在宽度上增长,这在考虑到对上下文长度的重新关注时尤其相关。

作者总结了三类任务,它们的难度逐步增加,只能通过越来越复杂的模型来解决:

1. 检索任务。 节点计数、边计数、边存在检查和节点度数是只需要一次查找的任务,因此只需要一个Transformer层和一个小型嵌入。

2. 可并行化任务。 连通性、连接节点和循环检查(以及更复杂的任务如二分性和平面性)可以用对数深度的Transformer解决。

3. 搜索任务。 最短路径和其他需要更多推理的任务需要模型的扩展。

图片

论文中进行了几项理论分析,展示了Transformer如何解决这些任务以及解决这些任务所需的维度要求。另一个有趣的点是,作者还分析了“pause tokens”的影响。


结果

在对Transformer的推理能力进行了实证分析后。他们选择使用从头开始训练的模型(最多60M参数),对预训练的Transformer(T5,带11B参数)进行微调,测试提示技术,并将其与图神经网络(GNNs)进行比较。使用GraphQA基准任务进行了实验。

图片

图推理算法可以分为局部和全局两种。前者在局部聚合信息(节点及其邻居),而后者模拟节点之间可能是长距离的全局连接。论文主要专注于全局任务,如评估连通性或计算最短路径(这些任务需要分析图的全局结构)。在少数示例情况下,图神经网络(GNNs)在这些任务中更为高效,但通过增加示例数量,Transformer的表现更好(Transformer仍然具有弱归纳偏见,需要许多示例才能最好地学习)。对Transformer进行微调也对预训练的Transformer有积极影响。

图片

以前的研究已经表明,对于图神经网络(GNN)来说,以参数效率的方式解决连通性存在限制。微调后的模型似乎对连通性和最短路径都更有效。虽然Transformer在解决全局任务方面更有效,但GNN在分析局部推理的任务中似乎更为高效:

表明GNN对于学习可以通过专门关注局部启发式解决的图推理任务具有有益的归纳偏见。(论文原文翻译)

在GNN中的消息传递框架便于节点与其邻居之间的信息传递(每增加一层相当于图中的一次跳跃)。相比之下,注意力机制计算每对标记之间的关系,因此它通过全局任务来促进,但在数据量较低的情况下,识别重要的局部关系更为困难。
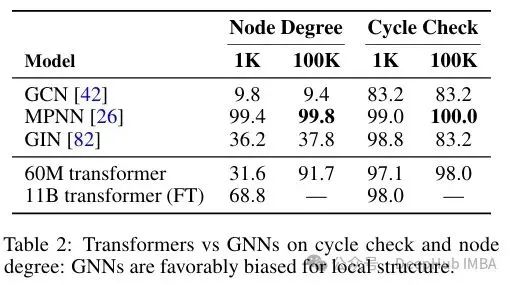
图片

作者还测试了使用大型语言模型(LLM)的情况,对表现优异的Transformer进行微调优于使用提示方法。尽管在训练过程中,LLM会在语料库中看到图数据,因此并不是完全没有接触过此类数据。但这表明在特定任务的情况下专业的小模型还是要更好,并且微调要比直接使用提示的方式好。

图片

总结

这篇论文详细展示了Transformer在图推理方面的能力,并且涵盖了不同的参数缩放模式。许多问题可以被重新表述为图问题,所以这篇论文还是值得阅读。并且论文还显示,一些能力的展示需要一定的网络深度,以便让Transformer解决问题。例如在需要全局推理的任务中,Transformer超过了图神经网络(GNN),这得益于自注意力机制,它允许长距离依赖关系被高效评估。这些发现为使用Transformer处理具有复杂全局依赖性的图推理任务提供了理论和实证支持。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

transformer架构_原来Transformer就是一种图神经网络,这个概念你清楚吗? Transformer和GNN有什么关系?一开始可能并不明显。但是通过这篇文章,你会从GNN的角度看待Transformer的架构,对于原理有更清楚的认知。选自NTU Graph Deep Learning Lab,作者:Chaitanya Joshi,机器之心编译,参与:一鸣、杜伟、Jamin。有的工程师会问这个问题:图深度学习听起来不错,但是有没有商业上的成功案例?它是否已经在实际应用中使用过... 阅读详情

相关推荐

Transformer 作为图神经网络

Transformer 作为图神经网络:叶子豪、周金晶、郭启鹏、甘泉、张政警告本教程旨在通过代码作为解释手段,深入了解本文。因此,该实现并未针对运行效率进行优化。推荐实现请参考。在本教程中,您将了解 Transformer 模型的简化实现。您可以看到最重要的设计点的亮点。例如,只有单头注意力。找到。中的结构类似。Transformer 模型作为序列建模的 CNN/RNN 架构的替代品,在研究论文《中被介绍。它提高了机器翻译和自然语言推理任务()的技术水平。最近使用大规模语料库(

具身机器人和通用AI 1622

论文 | TransGNN:Transformer和GNN可以互相帮助吗?

具体来说,我们在GNN层的消息传递过程中,对每个中心节点的邻居节点的注意力样本进行聚合。注意力采样:给定输入图 G 及其相似度矩阵 S,对于图中的节点 𝑣𝑖,我们将其注意力样本定义为集合 Smp(𝑣𝑖) = {𝑣𝑗 |𝑣𝑗 ∈ 𝑉 和 𝑆(𝑖, 𝑗) ∈ top-k (𝑆(𝑖, :))} 其中𝑆(𝑖, :) 表示 S 的第 𝑖 行,𝑘 作为超参数,决定应该关注多少个节点。在图数据中,不需要计算每个节点对整个图的关注,只要考虑最相关的节点就足够了,这不仅降低了复杂性,而且还过滤掉了噪声节点的信息。

人工智能讲师分享前沿技术 2253

【Graph Transformer:图神经网络与Transformer①】GNN+Transformer(研究进展)| 开源图神经网络算法平台:OpenHGNN | 深入讲解Transformer

众所周知,网络或图是描述复杂系统的通用语言,因此就产生了网络表示学习。网络表示学习进一步挖掘,产生了图神经网络何为Transformer?它是 《Attention Is All You Need》这篇论文提出的一个模型。附,点击下载模型的结构如下图所示:该模型最大的特点是没有使用RNN以及CNN,而是全部使用了注意力机制。为什么要学习Transformer?(我们问一下ChatGPT)学习Transformer有以下几个重要原因:1.革命性的神经网络架构。

追光者♂:记录、分享、总结、提升,现象级专栏《Python从入门到人工智能》作者,无惧黑暗,坚信曙光 971

Transformer 能代替图神经网络吗?

这篇论文详细展示了Transformer在图推理方面的能力,并且涵盖了不同的参数缩放模式。许多问题可以被重新表述为图问题,所以这篇论文还是值得阅读。并且论文还显示,一些能力的展示需要一定的网络深度,以便让Transformer解决问题。例如在需要全局推理的任务中,Transformer超过了图神经网络(GNN),这得益于自注意力机制,它允许长距离依赖关系被高效评估。这些发现为使用Transformer处理具有复杂全局依赖性的图推理任务提供了理论和实证支持。作者:Salvatore Raieli。

deephub 4383

Transformer与图神经网络的融合与应用

近年来,深度学习技术在各个领域取得了显著的进展。其中,Transformer模型和图神经网络(Graph Neural Networks, GNNs)是两个备受关注的研究方向。Transformer最初应用于自然语言处理领域,通过自注意力机制实现了并行计算和长距离依赖建模,取得了显著的性能提升。而图神经网络则专注于处理图结构数据,通过对节点信息的聚合和传播,实现了高效的图表示学习和下游任务求解。

AI天才研究院 1293

Blazor Session设置

微软官方封装了一些浏览器的操作,其中就有Session的操作的封装ProtectedSessionStorage 微软文档因为我们知道,依赖注入的生命周期是Singleton程序Scoped网页:刷新,url直接跳转都会重置。Transient路由C# Blazor 学习笔记(10):依赖注入但是没有一个和浏览器绑定的生命周期。即浏览器关闭才会退出。这个是后端无法获取的,因为后端根本不知道浏览器何时关闭。这个只能用浏览器自带的缓存。

qq_44695769的博客 1788

GNN-Transformer新突破!全局与局部的完美融合

图神经网络(GNN)和Transformer的结合是近年来的研究热点。这类结合不仅能够让两者发挥各自的优势,还能推动模型的创新,提高处理图数据的效率和性能。具体点讲,通过利用Transformer,我们可以扩展GNN的感受野,包括那些距离中心节点较远的相关节点。相对的,GNN也可以帮助Transformer捕捉复杂的图拓扑信息,并从相邻区域高效地聚合相关节点。

学姐带你玩AI的博客 6812

ORCAD原理图关联封装时出现ERROR(ORCIS-6245)、ERROR(ORCIS-6013)问题

1、当你进行如下操作时: 系统先是提示你出现ERROR(ORCIS-6245)然后再确定后再出现ERROR(ORCIS-6013)问题 是由于你的数据库的路径不对。 具体操作方法如下:1、先找到你的CAPTURE.INI文件。 2、用记事本打开CAPTURE.INI。找到下图路径 3、在你的Orcad capture CIS原理图软件中点击 Options------>CIS con...

weixin_42304393的博客 2万+

原来Transformer就是一种图神经网络,这个概念你清楚吗?

点击上方 "程序员小乐"关注,星标或置顶一起成长每天凌晨00点00分,第一时间与你相约每日英文The more you know who you are, a...

程序员小乐 2993

点云数据增强及预处理

数据增强: 1. random world flip:沿着x或者y轴,翻转点云 点云的x或者y,要翻转 3d box中心的x或者y,要翻转 3d box的朝向要翻转 point segmentation label,点云的相对顺序没有发生变化 2. random_world_rotation:沿着点云原点,旋转点云 点,x,y,绕z轴旋转 3d box,绕z轴旋转,中心和朝向都要变化 point segmentation label,点云的相对顺序没有发生变化 3. random_world_scaling

huang_victor的博客 4011

不止于使能:用汇川PLC功能块封装,实现伺服轴状态管理与安全逻辑

本文深入探讨了汇川PLC功能块封装在伺服轴控中的应用,详细介绍了如何通过高级封装技术实现伺服轴的状态管理与安全逻辑。文章涵盖了从基础使能到全生命周期监控的进化,多轴协同的实例化管理策略,以及安全逻辑的防御性编程技巧,为工业自动化领域的工程师提供了实用的解决方案和最佳实践。

weixin_28684825的博客 272

为什么说Transformer就是图神经网络?

作者 |Chaitanya Joshi译者 |Kolen出品 |AI科技大本营(ID:rgznai100)前言有些工程师朋友经常问我这样一个问题:“图深度学习听起来很棒,但是现在是...

AI科技大本营 8719

【大数据技术干货】(还不懂数仓,数据中心?看这一篇就够了!)在实际的开发生产中,让你了解企业级数据中心整体架构(DB+ETL+ODS+DW+DM)的各个层次的过程详解,数据联系及功能区分

一 企业级数据中心架构 数据仓库的整体架构,各个系统的元数据通过ETL同步到操作性数据仓库ODS中,对ODS数据进行面向主题域建模形成DW(数据仓库),DM是针对某一个业务领域建立模型,具体用户(决策层)查看DM生成的报表。 二 DB 三 ETL(Extract-Transform-Load) ETL是将业务系统的数据经过抽取、清洗转换之后加载到数据仓库的过程,目的是将企业中的分散、零乱、标准不统一的数据整合到一起,为企业的决策提供分析依据。 ETL是BI项目重要的一个环节。 通常情况下,在BI项目中ET

liuchunhang的博客 1289

为什么说 Transformer 就是图神经网络?

作者 |Chaitanya Joshi译者 |Kolen出品 |AI科技大本营(ID:rgznai100)前言有些工程师朋友经常问我这样一个问题:“图深度学习听起来很棒,但是现在是...

优快云资讯 3108

【机器视觉】基于深度学习的托盘PCB识别与计数(有无、正反)

工业机器视觉是指在制造业和工业环境中使用计算机视觉技术来执行检测、测量、识别和控制任务。它结合了硬件(如相机、镜头、光源)与软件(图像处理算法)来自动完成传统上需要人工视觉的任务,从而提高生产效率、产品质量以及工作安全性。工业机器视觉系统通常具有高精度、高速度和高可靠性,能够适应恶劣的工作环境。

专注上位机开发、机器视觉、机器学习、嵌入式软硬件开发 1万+

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

图神经网络(6)-续 GNN与CNN,TRANSFORMER的关系

这篇文章是接上篇文章的,主要说明一下,GNN与其他网络模型的一下关系。 图神经网络(GNN)与卷积神经网络(CNN)的联系 卷积神经网络的卷积操作也可以看作图神经网络的信息传递和聚集过程。CNN的卷积核(也就是下面公式中的Wl)就对应着GNN中的信息传递处理操作。对于聚集操作,CNN中可以看作是采取的求和(GNN采取的是求和取平均)。对图片中的一个像素点而言,它的邻居节点就是周围的八个像素节点。 可以看到,GNN与CNN的公式可以化成同一种模式。区别就是,卷积神经网络中,像素点的邻居是固定的(..

qq_44689178的博客 3209

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

图神经网络

图神经网络

青少年趣味编程 1153

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

上一篇: NoteLLM: 大语言模型在小红书推荐系统的落地应用
下一篇: 魔改Transformer!9种提速又提效的模型优化方案
AI大模型_学习君
博客等级 码龄3年 6137粉丝 551原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
