魔改Transformer!9种提速又提效的模型优化方案

Transformer常见结构及改进方法 SWin-TR是一种改进的Transformer架构,它提出了基于窗口的注意力机制来处理图像。例如,可以在多个图像的尺度维度进行检测,解决视觉实体的规模尺度大小不同的问题。总的来说,针对Vision Transformer的改进方法可以从多个角度进行探索,包括改变分块方式等方面。Vision Transformer是一种基于Transformer的深度学习模型,主要用于图像分类、目标检测、语义分割等计算机视觉任务。Transformer是一种基于注意力机制的深度学习模型,由编码器和解码器组成。 阅读详情
AI摘要

本文深入探讨了Transformer模型在效率方面的九项改进工作,涵盖稀疏注意力机制、长文本处理、运行提效及卷积Attention四个方向。通过引入新技术,如Longformer、LogSparseTransformer、Reformer等,有效解决了计算成本高、内存瓶颈等问题,实现了模型在长序列上的高效运行。

Transformer目前已经成为人工智能领域的主流模型,应用非常广泛。然而Transformer中注意力机制计算代价较高,随着序列长度的增加,这个计算量还会持续上升。

为了解决这个问题,业内出现了许多Transformer的魔改工作,以优化Transformer的运行效率。我这次就给大家分享9篇对Transformer模型进行效率优化的改进文章,以方便大家更高效地使用模型,寻找论文创新点。

文章主要涉及4个方向:稀疏注意力机制、Transformer处理长文本、Transformer运行提效以及卷积Attention,原文及源码都已整理

一、稀疏注意力机制

1.1 Longformer: The Long-Document Transformer

长文档Transformer

「方法简述:」Transformer-based models处理长序列时存在困难,因为它们的自注意力操作与序列长度呈二次方关系。Longformer通过引入一个与序列长度呈线性关系的注意力机制解决了这个问题,使其能够轻松处理数千个标记或更长的文档。 Longformer在字符级语言建模方面表现优秀,并在各种下游任务上取得了最先进的结果。此外,Longformer还支持长文档生成序列到序列任务,并在arXiv摘要生成数据集上展示了其有效性。

图片

1.2 Enhancing the Locality and Breaking the Memory Bottleneck of Transformer on Time Series Forecasting

增强局部性并打破Transformer在时间序列预测中的内存瓶颈

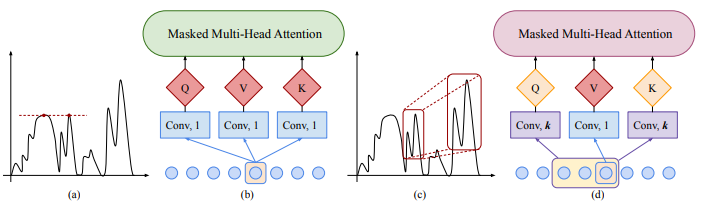
「方法简述:」时间序列预测是许多领域中的重要问题,包括太阳能发电厂能源输出、电力消耗和交通拥堵情况的预测。本文提出了使用Transformer来解决这种预测问题的方法。虽然初步研究表明其性能令人印象深刻,但作者发现它有两个主要缺点:局部性不敏感和内存瓶颈。为了解决这两个问题,作者提出了卷积自注意力和LogSparse Transformer,它们能够更好地处理局部上下文并降低内存成本。实验表明,这些方法在时间序列预测方面具有优势。
图片

1.3 Adaptive Attention Span in Transformers

Transformers中的自适应注意力跨度

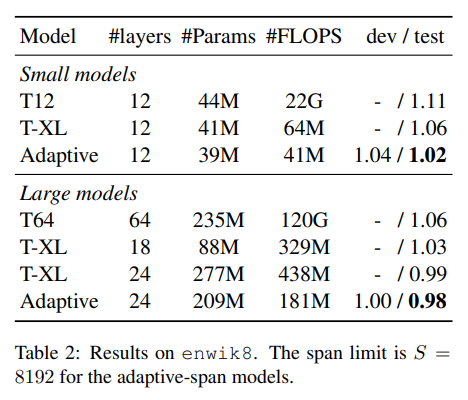
「方法简述:」论文提出了一种新的自注意力机制,可以学习其最优的注意力跨度。这使得我们可以显著扩展Transformer中使用的最大上下文大小,同时保持对内存占用和计算时间的掌控。作者在字符级语言建模任务上展示了该方法的有效性,在该任务中,作者使用最大8k个字符的上下文实现了在text8和enwiki8上最先进的性能。
图片

二、Transformer处理长文本

2.1 Transformer-XL: Attentive Language Models Beyond a Fixed-Length Context

超越固定长度上下文的注意语言模型

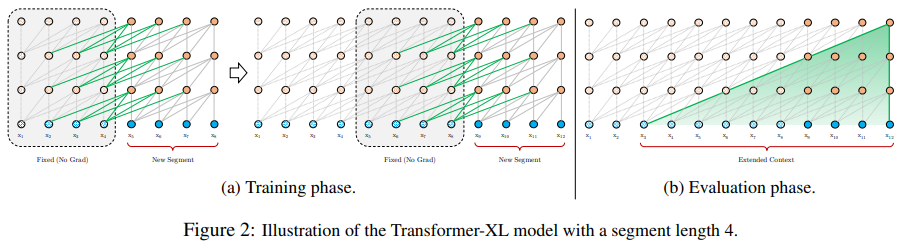
「方法简述:」Transformers在语言建模中受到固定长度上下文的限制,作者提出了一种新的神经网络架构Transformer-XL,可以学习超过固定长度的依赖关系。它由一个段级别循环机制和一个新的位置编码方案组成,能够捕捉更长的依赖关系并解决上下文碎片化问题。该方法不仅在短序列和长序列上都取得了更好的性能,而且在评估期间比普通的Transformers快1,800+倍。
图片

三、Transformer运行提效

3.1 REFORMER: THE EFFICIENT TRANSFORMER

高效的Transformer

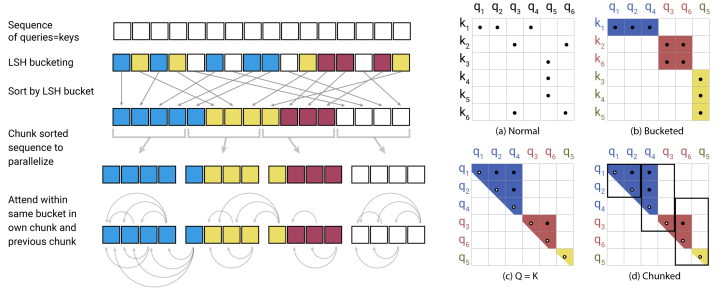
「方法简述:」大型Transformer模型训练成本高,尤其是在长序列上。论文提出了两种技术来提高效率:使用局部敏感哈希替换点积注意力,将复杂度从O(L^2)降低到O(L log L);使用可逆残差层代替标准残差,允许只存储一次激活。由此产生的Reformer模型在长序列上表现相当,但更内存高效和更快。
图片

3.2 RETHINKING ATTENTION WITH PERFORMERS

重新思考注意力机制:Performer模型

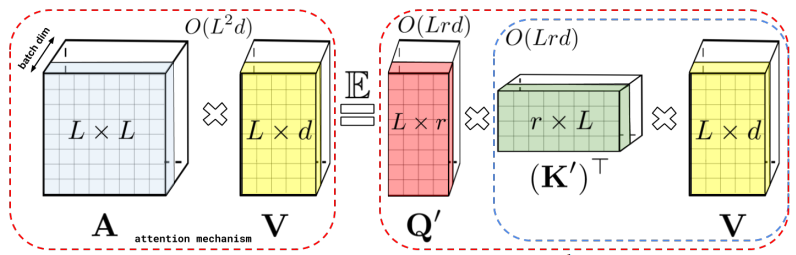
「方法简述:」论文介绍了Performers,一种Transformer架构,可以以可证明的准确性估计常规(softmax)全秩注意力Transformers,但仅使用线性空间和时间复杂度。为了近似softmax注意力核,Performers使用了一种新颖的快速注意通过正交随机特征方法(FAVOR+),并可以用于高效地建模可核化的注意力机制。
图片

3.3 Linformer: Self-Attention with Linear Complexity

具有线性复杂度的自注意力机制

「方法简述:」大型Transformer模型在自然语言处理应用中表现出色,但长序列的训练和部署成本很高。本文提出一种新自注意力机制,将复杂度从O(n^2)降低到O(n),同时保持性能不变。由此产生的Linformer比标准的Transformer更节省时间和内存。

图片

四、卷积Attention

4.1 Conformer: Convolution-augmented Transformer for Speech Recognition

用于语音识别的卷积增强Transformer

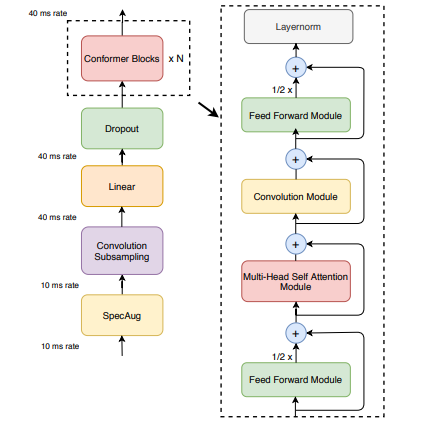
「方法简述:」Conformer是一种结合了卷积神经网络和Transformer的模型,用于语音识别。它能够同时捕捉音频序列的局部和全局依赖关系,并实现了最先进的准确率。在LibriSpeech基准测试中,Conformer在不使用语言模型的情况下实现了2.1%/4.3%的WER,在使用外部语言模型的情况下实现了1.9%/3.9%的WER。此外,它还具有竞争力的小模型,只有10M参数。
图片

4.2 LITE TRANSFORMER WITH LONG-SHORT RANGE ATTENTION

具有长短范围注意力的轻量级Transformer

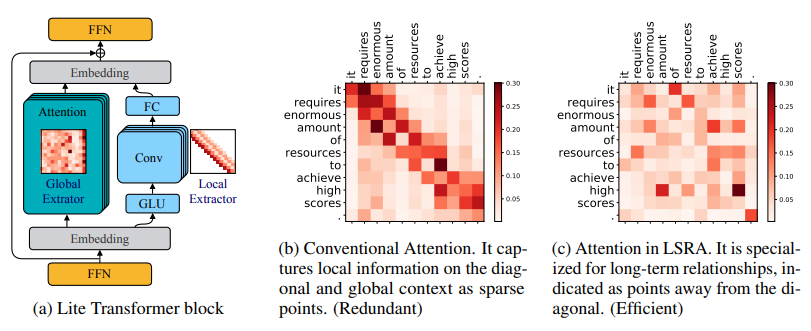
「方法简述:」本文提出了一种高效的移动自然语言处理架构Lite Transformer,它使用长短范围注意力(LSRA)来提高性能。LSRA将一组头专门用于局部上下文建模(通过卷积),另一组头则专门用于长距离关系建模(通过注意力)。在三个语言任务上,Lite Transformer始终优于普通的Transformer。在受限资源下,Lite Transformer比Transformer在WMT’14英法翻译任务上高出1.2/1.7 BLEU分数。
图片

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

Transformer的改进 Transformer的改进Transformer简介Efficient Transformer简介Fixed PatternsCombination of PatternsLearnable PatternsMemoryLow-RankKernelsRecurrence性能比较 Transformer简介 Transformer的核心是self-attention,通过计算输入序列中元素与其他所有元素的相关性来获取加权得分。但是这一步骤需要 O(n2)O(n^2)O(n2)的时间和空间复杂度,因为需要两个 阅读详情

相关推荐

Transformer热门魔改方案汇总!大大提升模型速度与效果!

随着序列长度的增加,Transformer中注意力机制的计算量会持续上升,导致计算代价较高。不过为了解决这个问题,业内也出现了许多针对Transformer的魔改,这里给大家整理了Transformer魔改的方案论文,大家可以学习一下。Longformer:长文档转换器本文中提出了Longformer,一种具有线性扩展注意力机制的模型,能够高效处理超长序列,它将局部窗口注意力与全局注意力相结合,可作为标准自注意力的替代。

2401_82426425的博客 1874

Transformer 的结构改进与替代方案

自从 Transformer 结构被提出以来,以 BERT 为代表的 Encoder 模型,以 GPT 为代表的 Decoder 模型,以 ViT 为代表的 CV 模型,都烜赫一时。时至今日,几乎所有的 LLM 也都是 Transformer 结构,尽管不时也会有新的结构被提出来,但 Transformer 的江湖地位仍然无可撼动。希望通过以上问题的思考和讨论,能够帮助我们更好地使用Transformer、理解Transformer、优化Transformer和改进Transformer。

hellozhxy的博客 4715

COMSOL仿真避坑指南:列管反应器模拟中多孔介质与化学反应设置的5个常见错误

本文详细解析了COMSOL仿真中列管反应器模拟的5个常见错误,包括多孔介质模型选择、化学反应接口配置、对流扩散方程处理、薄层热阻设置及网格独立性验证。特别针对多孔介质与化学反应设置的误区,提供了实用的判断标准和修正方法,帮助工程师避免计算偏差,提升仿真精度。

weixin_29597551的博客 323

深度学习 Transformer机制

Transformer

Fantastic 6701

支付漏洞防护绕过的一种方式

放完包后就到了提交订单的地方,可以发现,金额确实小了很多,合理的搭配的话还可以更低,再次前进可以发现,金额确实是这么多,后面就不支付了,到此就结束了。也就是说数量可以为负数,但是金额不能为0或者0以下,有什么方法可以绕过这个限制吗,其实并不难,既然可以为负数,只是对金额不能为0或者负数做了限制。我们可以尝试拼接法,利用负数加上正数让他的值变得很低,但是又大于0就可以了,这里利用购物车的结算方法,随机加一些在购物车里。这里为了方便查看数据包,我这边商品的数量选择3,点击立即购买并抓包。

2301_80115097的博客 1529

MuMu模拟器过检测实战:从硬件伪装到API欺骗的完整避坑指南

本文详细介绍了MuMu模拟器过检测的实战技术,从硬件伪装到API欺骗的全方位解决方案。通过修改CPU/GPU信息、内存分布、系统属性和行为模拟等关键技术,帮助用户有效绕过现代应用的模拟器检测机制,提升模拟器的隐蔽性和稳定性。

xxx12的博客 1393

魔改Transformer!9种提速又提效的模型优化方案分享!

Transformer目前已经成为人工智能领域的主流模型,应用非常广泛。然而Transformer中注意力机制计算代价较高,随着序列长度的增加,这个计算量还会持续上升。为了解决这个问题,业内出现了许多Transformer的魔改工作,以优化Transformer的运行效率。我这次就给大家分享,以方便大家更高效地使用模型,寻找论文创新点。

2401_84495872的博客 989

Android 17为什么会重写MessageQueue

DeliQueue 通过消除 MessageQueue 中的锁,提升了系统和应用的性能。合成基准测试: 得益于并发能力的提升(Treiber 栈)和更快的插入速度(最小堆),向繁忙队列进行多线程插入的速度比传统 MessageQueue 快了高达 5000 倍。Perfetto 追踪分析: 在从内部测试人员处获取的 Perfetto 追踪记录中,我们看到应用主线程在锁竞争上消耗的时间减少了 15%。

xiangzhihong8的专栏 270

【计算机视觉 | Transformer】魔改Transformer!9种提速又提效的模型优化方案分享!

【计算机视觉 | Transformer】魔改Transformer!9种提速又提效的模型优化方案分享!

wzk4869的博客 5559

Python 爬虫教程:企业官网基本信息抓取

本文介绍了使用Python爬虫技术抓取企业官网信息的方法,包括公司名称、简介、联系方式、地址、产品及新闻等数据。通过Requests和BeautifulSoup库实现网页请求与解析,并利用Pandas存储数据为CSV文件。同时提供了应对反爬虫机制(如设置User-Agent、代理IP池、延迟请求等)的解决方案,帮助高效获取企业公开数据。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 1859

如何在 SAP BTP 上通过 CDS view 快速创建 Fiori Elements 应用

本文基于 SAP Business Technology Platform 的 ABAP 编程环境进行的开发。 使用 ABAP Development Tool 登录 SAP BTP ABAP 编程环境,新建一个 package,命名为 Z_JERRY_CDS. 右键选中该 package,创建一个新的 Consumption view. 该视图是一个消费视图,它基于业务对象 (BO) 视图 /DMO/I_TRAVEL_U,提供了独立于消费层的给定数据模型。 它包含在其上运行的应用程序所需的所有核心信息。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 2031

【AI大模型】带你解析9种提速又提效的Transformer优化方案!

Transformer目前已经成为人工智能领域的主流模型,应用非常广泛。然而Transformer中注意力机制计算代价较高,随着序列长度的增加,这个计算量还会持续上升。

bugyinyin的博客 647

杰理AC695N芯片跑iic接口的oled驱动分享

本文介绍了一个基于IIC接口的0.96寸OLED显示屏驱动程序,适用于SSD1306控制器。驱动采用软件模拟IIC方式,支持字符、数字、字符串、汉字和图片显示,测试平台为杰理AC695N系列芯片。硬件参数包括128×64分辨率,IIC接口(地址0x78),使用IO_PORTA_02(SDA)和IO_PORTA_03(SCL)引脚。驱动包含OLED主文件(oled.c/h)、软件IIC实现(soft_iic.c/h)和字体/图片数据文件(oledfont.h/bmp.h),可通过修改soft_iic.h中的引

qq_42014563的博客 882

别再魔改Transformer了!这5个拿来即用的高效变体,让你的模型训练快3倍

本文介绍了5个经过实战验证的Transformer高效变体,包括FlashAttention、多查询注意力(MQA)、RMSNorm、GLU变体和ALiBi位置编码,这些变体能够显著提升模型训练速度(部分案例实测提速达3倍),同时保持模型的稳定性和预测质量。这些高效变体避免了常见的魔改陷阱,为深度学习工程师提供了即插即用的解决方案。

weixin_33719619的博客 336

用一组可复现实验讲清 ABAP 内表 Standard / Sorted / Hashed 的性能差异

摘要(150字): SAP项目中性能问题常源于ABAP内表选型不当。标准表(STANDARD TABLE)写入快但查找慢(线性扫描),适合遍历场景;排序表(SORTED TABLE)保持有序,支持二分查找,适合范围查询;哈希表(HASHED TABLE)基于唯一键实现常数级查找,适合高频精确匹配。实验表明:标准表+BINARY SEARCH需预排序,成本可能高于直接使用排序表;哈希表在键匹配时性能最优。Gateway和RAP场景中,内表选型直接影响接口响应,建议根据读写负载(追加/遍历/精确查找)选择对应类

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 202

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

当Transformer遇上魔改鲸鱼:时序预测还能这么玩

GSWOA-Transformer多变量时序预测 Matlab代码 基于改进鲸鱼优化算法(GSWOA)优化Transformer的数据回归预测(可以更换为分类/单变量时序预测/回归,前私我),Matlab代码,可直接运行,适合小白新手程序已经调试好,无需更改代码替换数据集即可运行数据格式为excelTransformer 作为一种创新的神经网络结构,深受欢迎。

ktOCatfo的博客 651

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

Transformer模型训练提速秘籍:TensorFlow-v2.9 + GPU算力组合

通过TensorFlow 2.9与GPU的深度协同,结合混合精度、数据流水线优化和多卡分布式策略,显著提升Transformer模型训练效率。从环境配置到部署落地,整套技术闭环让训练速度从几周缩短至几天,极大改善开发体验与资源利用率。

weixin_33750664的博客 963

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

20倍提速!Swift大模型推理优化:KV缓存与PagedAttention实战指南

你还在为大模型推理速度慢、显存占用高发愁?普通GPU跑不动千亿参数模型?本文详解Swift框架中KV缓存与PagedAttention的核心优化技术,通过3个实战步骤,让你的推理效率提升20倍,显存占用降低50%!读完本文你将掌握: - KV缓存的工作原理及Swift实现方式 - PagedAttention如何解决显存碎片化问题 - 3步完成Swift推理加速部署(附完整代码示例) ## 一、...

gitblog_00276的博客 959

想提速但TensorRT的FP16不得劲?怎么办?在线支招!

问题的开始 前些天尝试使用TensorRT转换一个模型,模型用TensorFlow训练,包含LSTM+Transform+CNN,是一个典型的时序结构模型,包含编码解码结构,暂称为debug.onnx吧。 这个debug.onnx使用tf2onnx导出,导出后tf2onnx会自动对这个onnx做一些优化,例如常量折叠、算子融合等等一些常规操作,一般来说这些操作不会影响网络结构(也会出现影响的情况!之后老潘会说),而且有助于模型的优化。 然后导出来之后使用onnxruntime简单测试一下导出模型是否正确,是

老潘的博客 4509

Transformer模型时间复杂度优化策略与实践

本文深入探讨了Transformer模型在处理长序列时面临的时间复杂度挑战,并提供了两种核心优化策略。通过引入稀疏注意力(如滑动窗口注意力)和分层注意力机制,有效将计算复杂度从O(N²)降低,从而显著提升模型训练与推理效率,使其能够应用于长文档分析等实际场景。

sql99的博客 584

让Attention提速9倍!FlashAttention燃爆显存,Transformer上下文长度史诗级提升

©作者 |编辑部来源 |新智元FlashAttention新升级!斯坦福博士一人重写算法,第二代实现了最高9倍速提升。继超快且省内存的注意力算法FlashAttention爆火后,升级版的2代来了。FlashAttention-2是一种从头编写的算法,可以加快注意力并减少其内存占用,且没有任何近似值。比起第一代,FlashAttention-2速度提升了2倍。甚至,相较于PyTorch的标准注...

Paper weekly 1222

【深度学习】Attention提速9倍!FlashAttention燃爆显存,Transformer上下文长度史诗级提升...

转载自 | 新智元继超快且省内存的注意力算法FlashAttention爆火后,升级版的2代来了。FlashAttention-2是一种从头编写的算法,可以加快注意力并减少其内存占用,且没有任何近似值。比起第一代,FlashAttention-2速度提升了2倍。甚至,相较于PyTorch的标准注意力,其运行速度最高可达9倍。一年前,StanfordAILab博士Tri Dao发布了FlashA...

fengdu78的博客 828
上一篇: Transformer 能代替图神经网络吗?
下一篇: AI: 从零开始训练一个最小化的Transformer聊天机器人
AI大模型_学习君
博客等级 码龄3年 6137粉丝 551原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
