LlamaFactory可视化微调大模型 - 参数详解

Llama-factory详细基础使用说明 对于初入算法的童鞋来说,有的可能还不知道llama-factory是什么,只知道大模型用到了这个框架,这是不行的。LLaMA-Factory 是一个低代码的大规模语言模型(LLM)训练框架,它主要面向研究人员和开发者,旨在简化大型语言模型的微调、评估和部署过程。白话说就是集合了当下LLM领域各种好用的开源或者自研的框架以及工具,进行封装以及优化,简化使用方法,方便大家对大模型进行微调和评估部署等工作,降低了使用难度。包括推理框架vllm等(具体可以看官网哈,下面有地址)易用性 vs. 性能。 阅读详情

LlamaFactory 前言

LLaMA Factory 是一个用于微调大型语言模型的强大工具,特别是针对 LLaMA 系列模型。

可以适应不同的模型架构和大小。

支持多种微调技术,如全参数微调、LoRA( Low-Rank Adaptation )、QLoRA( Quantized LoRA )等。

还给我们提供了简单实用的命令行接口。

支持多 cpu 训练,多任务微调,还有各种内存优化技术,如梯度检查点、梯度累积等。

支持混合精度训练,提高训练效率。

本文不再赘述 LlamaFactory 的安装过程

LlamaFactory参数基本设置

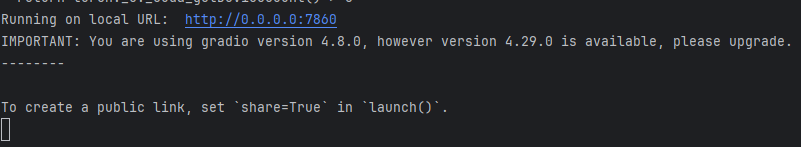
打开我们 LlamaFactory 的 web 运行界面,进入根目录执行下列命令:

llamafactory-cli webui

看到下列界面
图片

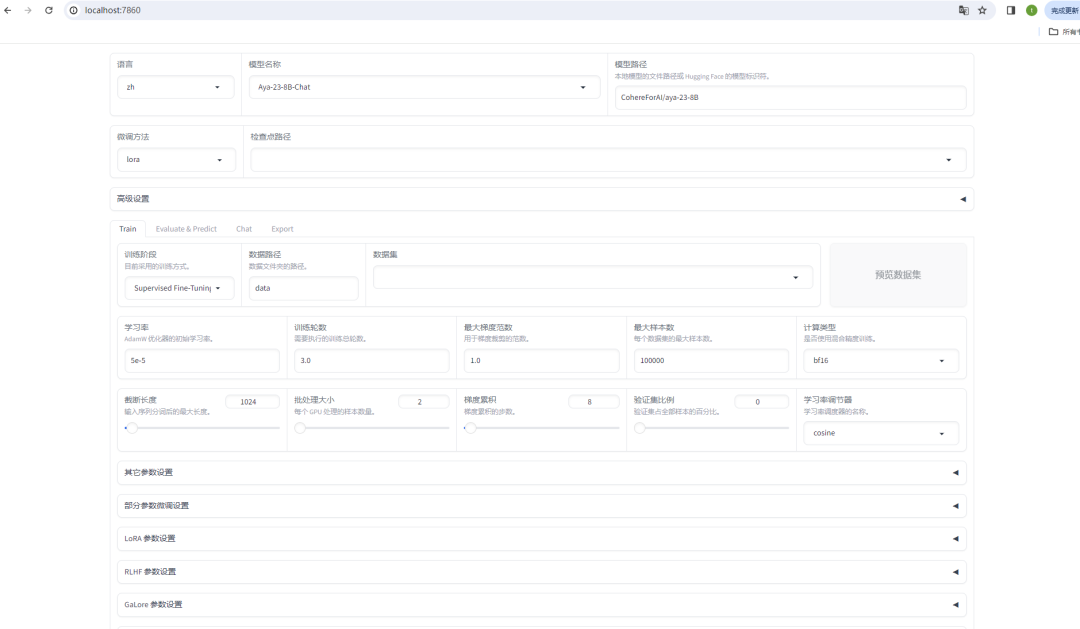
在浏览器打开我们开启的 webui 界面 http://127.0.0.1:7860:
图片

我们依次来解释每个参数的选择:

这里是语言选择

选择 zh 即可。

图片

模型选择选择适合自己的模型,这里都会从 Hugging Face 里面下载,
图片

这一步是自定义路径一般就用选择好的默认路径即可。

图片

微调方法:

这里有三种,full全参数微调, Freeze(冻结部分参数) LoRA(Low-Rank Adaptation),还有 QLoRA 等。

全参数微调可以最大的模型适应性,可以全面调整模型以适应新任务。通常能达到最佳性能。

Freeze 训练速度比全参数微调快,会降低计算资源需求。

LoRA :显著减少了可训练参数数量,降低内存需求,训练速度快,计算效率高。还可以为不同任务保存多个小型适配器,减少了过拟合风险。

QLoRA训练速度跟 LoRA 差不多,基本保持了 LoRa 的优势,会进一步减少内存使用。

综合速度,灵活性考虑 选择 LoRA 或者 QLorRA 。

快速上手!LLaMa-Factory最新微调实践,轻松实现专属大模型 近日,源2.0开源大模型与LLaMA-Factory框架完成全面适配,用户通过LLaMA-Factory,即可快捷、高效地对不同参数规模的源2.0基础模型进行全量微调及高效微调,轻松实现专属大模型。 阅读详情

相关推荐

12 大模型学习——LLaMA-Factory微调

Alpaca 格式由斯坦福大学的研究人员提出,主要用于单轮指令微调任务。针对不同任务,数据集的格式要求不同。应用场景:- 适用于单轮任务,如问答、文本生成、摘要、翻译等。- 结构简洁,任务导向清晰,适合低成本的指令微调。

weixin_54388827的博客 4622

服务器部署LLaMAFactory进行LoRA微调

仓库已经成功克隆下来了。Factory支持的格式。LLaMA-Factory支持多种格式,对于文本分类任务,我们可以使用alpaca格式。包含了所有可用的数据集。使用刚刚自定义三个数据采集数据集,需要在文件中添加数据集描述,并通过修改配置来使用数据集。现在让我们添加我们的三个自定义数据集。数据已经成功转换并保存到了正确的位置。接下来可以开始使用这些数据进行训练了。

qq_60245590的博客 4019

LLamaFactory微调效果与vllm部署效果不一致如何解决

一种是利用现有对话模板,直接配置一个如下的 json 文件使用。model_name 为必填项,可以是 LMDeploy 内置对话模板名(通过 lmdeploy list 可查阅),也可以是新名字。其他字段可选填。当 model_name 是内置对话模板名时,json文件中各非 null字段会覆盖原有对话模板的对应属性。而当 model_name 是新名字时,它会把将BaseChatTemplate 直接注册成新的对话模板。其具体定义可以参考BaseChatTemplate。

weixin_47659945的博客 1410

DrMOS电路仿真

将驱动电路与功率MOS集成化后既是DrMOS。把驱动芯片以及上下桥MOSFET封装在一起,这样每一相供电就有了单独的驱动芯片,并且这种高度整合的MOSFET可以通过更高的电流、发热比传统的MOSFET也小很多且更节能 自举升压同步BUCK高低侧栅驱动电路原理及仿真 ...

Srambler的博客 5039

ViT 实战 万字全攻略:从图像分类到医学影像,Transformer 重塑视觉 AI

摘要:本文深度解析 ViT(Vision Transformer)算法在视觉任务中的原理与实践,涵盖图像分类、目标检测、语义分割及医学影像分析四大领域。从理论出发,详细拆解图像分块、位置编码、Transformer 编码器等核心机制;通过 PyTorch 与 Timm 库实现模型构建、训练与优化,提供 CIFAR-10、Pascal VOC、Cityscapes 及医学数据集的完整代码示例。针对工业级部署,重点介绍模型量化、TensorRT 加速、Flask API 开发及 Docker 容器化方案。

专注于人工智能、软件开发、工控自动化、工厂数字化及智能化等领域,希望和大家共同进步! 1938

YOLOv11改进 - 卷积Conv | PATConv(Partial Attention Convolution)部分注意力卷积,在减少计算量的同时融合卷积与注意力的优势 | AAAI 2026

本文提出部分注意力卷积(PATConv)机制,并将其集成到YOLOv11中。传统神经网络中,卷积计算密集,注意力机制全局计算冗余,此前的“部分卷积”会丢失未计算通道的特征价值。PATConv通过“通道拆分 - 并行处理 - 结果拼接”的逻辑,给不同通道分配“擅长的任务”,兼顾局部与全局特征。基于此,它还衍生出PAT_ch、PAT_sp和PAT_sf三种细分模块。此外,还提出了动态部分卷积(DPConv),并构建了新的混合网络家族PartialNet。我们将PATConv代码集成到YOLOv11中,实验表明,

魔改工程师的博客 1085

手把手教你学veriolg(二十六)-- Verilog CIC 滤波器设计

目录 Verilog CIC 滤波器设计1. CIC 滤波器的基本原理2. Verilog 实现3. 说明4. 测试激励5. 总结 CIC(Cascade-Integrator-Comb)滤波器是一种特殊的数字滤波器,常用于多速率信号处理中,尤其是用于信号的上采样(插值)和下采样(抽取)。CIC 滤波器的特点在于它具有简单的硬件实现、不需要乘法器(仅使用加法器和延迟元件)、且具有线性相位特性。然而,CIC 滤波器的缺点是它会产生较大的量化误差,因此在设计时需要特别注意字长的选择以避免溢出。1. CIC 滤波

MHD0815的博客 890

s8654

The official Snapdragon Ride SX 4.0 development board provides standardized hardware support for the secondary development and functional verification of the s8654 platform.

qq_39257814的博客 6830

基于HetConv与Dual策略的YOLOv8轻量化设计-CSPHet结构的优化与实现

在计算机视觉中,YOLOv8作为目标检测领域的最新版本,通过引入多种改进来提升检测精度和速度。然而,提升精度和保持实时性能往往需要更多参数与计算量。本文提出一种结合Dual思想与HetConv的新型轻量化结构,称为CSPHet。CSPHet能够在保持YOLOv8检测精度的基础上有效减少约70万参数量,实现模型的轻量化和速度的提升。HetConv(Heterogeneous Convolution)是一种混合卷积技术,通过同时使用1x1、3x3等不同大小的卷积核,来捕捉不同尺度的特征。

博客 1324

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

上一篇: 一文解析大语言模型LLM的幻觉问题:消除错觉、提高认知
下一篇: 大模型微调爆火!32种前沿微调方法全面汇总
普通网友
博客等级 码龄3年 4493粉丝 309原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值