


当项目变得越来越大时,有效地管理计算资源是一个不可避免的需求。Python与C或c++等低级语言相比,似乎不够节省内存。
但是其实有许多方法可以显著优化Python程序的内存使用,这些方法可能在实际应用中并没有人注意,所以本文将重点介绍Python的内置机制,掌握它们将大大提高Python编程技能。
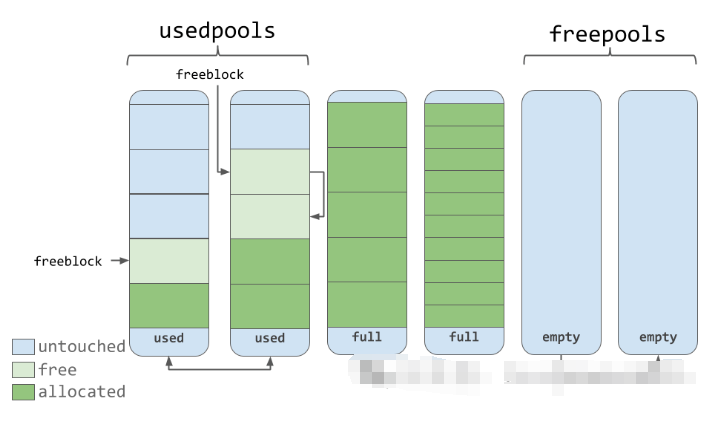
首先在进行内存优化之前,我们首先要查看内存的使用情况
分配了多少内存?
有几种方法可以在Python中获取对象的大小。可以使用sys.getsizeof()来获取对象的确切大小,使用objgraph.show_refs()来可视化对象的结构,或者使用psutil.Process().memory_info()。RSS获取当前分配的所有内存。
 >>> import numpy as np
 >>> import sys
 >>> import objgraph
 >>> import psutil
 >>> import pandas as pd


 >>> ob = np.ones((1024, 1024, 1024, 3), dtype=np.uint8)

 ### Check object 'ob' size
 >>> sys.getsizeof(ob) / (1024 * 1024)
 3072.0001373291016

 ### Check current memory usage of whole process (include ob and installed packages, ...)
 >>> psutil.Process().memory_info().rss / (1024 * 1024)
 3234.19140625

 ### Check structure of 'ob' (Useful for class object)
 >>> objgraph.show_refs([ob], filename='sample-graph.png')

 ### Check memory for pandas.DataFrame
 >>> from sklearn.datasets import load_boston
 >>> data = load_boston()
 >>> data = pd.DataFrame(data['data'])
 >>> print(data.info(verbose=False, memory_usage='deep'))
 <class 'pandas.core.frame.DataFrame'>
 RangeIndex: 506 entries, 0 to 505
 Columns: 13 entries, 0 to 12
 dtypes: float64(13)
 memory usage: 51.5 KB

 ### Check memory for pandas.Series
 >>> data[0].memory_usage(deep=True)   # deep=True to include all the memory used by underlying parts that construct the pd.Series
 4176
这样我们才能根据对象的内存占用来查看实际的优化结果
slots
Python作为一种动态类型语言,在面向对象方面具有更大的灵活性。在运行时可以向Python类添加额外属性和方法的能力。
例如,下面的代码定义了一个名为Author的类。最初它有两个属性name和age。但是我们以后可以很容易地添加一个额外的job:
 class Author:
    def __init__(self, name, age):
        self.name = name
        self.age = age


 me = Author('Yang Zhou', 30)
 me.job = 'Software Engineer'
 print(me.job)
 # Software Engineer
但是这种灵活性在底层浪费了更多内存。
因为Python中每个类的实例都维护一个特殊的字典(dict)来存储实例变量。因为字典的底层基于哈希表的实现所以消耗了大量的内存。
在大多数情况下,我们不需要在运行时更改实例的变量或方法,并且__dict__不会(也不应该)在类定义后更改。所以Python为此提供了一个属性:slots。
它通过指定类的所有有效属性的名称来作为白名单:
 class Author:
    __slots__ = ('name', 'age')

    def __init__(self, name, age):
        self.name = name
        self.age = age


 me = Author('Yang Zhou', 30)
 me.job = 'Software Engineer'
 print(me.job)
 # AttributeError: 'Author' object has no attribute 'job'
白名单只定义了两个有效的属性name和age。由于属性是固定的,Python不需要为它维护字典,只为__slots__中定义的属性分配必要的内存空间。
下面我们做一个简单的比较:
 import sys


 class Author:
    def __init__(self, name, age):
        self.name = name
        self.age = age


 class AuthorWithSlots:
    __slots__ = ['name', 'age']

    def __init__(self, name, age):
        self.name = name
        self.age = age


 # Creating instances
 me = Author('Yang', 30)
 me_with_slots = AuthorWithSlots('Yang', 30)

 # Comparing memory usage
 memory_without_slots = sys.getsizeof(me) + sys.getsizeof(me.__dict__)
 memory_with_slots = sys.getsizeof(me_with_slots) # __slots__ classes don't have __dict__

 print(memory_without_slots, memory_with_slots)
 # 152 48
 print(me.__dict__)
 # {'name': 'Yang', 'age': 30}
 print(me_with_slots.__dict__)
 # AttributeError: 'AuthorWithSlots' object has no attribute '__dict__'
可以看到 152 和 48 明显节省了内存。
Generators
生成器是Python中列表的惰性求值版本。每当调用next()方法时生成一个项,而不是一次计算所有项。所以它们在处理大型数据集时非常节省内存。
 def number_generator():
    for i in range(100):
        yield i

 numbers = number_generator()
 print(numbers)
 # <generator object number_generator at 0x104a57e40>
 print(next(numbers))
 # 0
 print(next(numbers))
 # 1
上面的代码显示了一个编写和使用生成器的基本示例。关键字yield是生成器定义的核心。应用它意味着只有在调用next()方法时才会产生项i。
让我们比较一个生成器和一个列表,看看哪个更节省内存:
 mport sys

 numbers = []
 for i in range(100):
    numbers.append(i)

 def number_generator():
    for i in range(100):
        yield i

 numbers_generator = number_generator()
 print(sys.getsizeof(numbers_generator))
 # 112
 print(sys.getsizeof(numbers))
 # 920
可以看到使用生成器可以显著节省内存使用。如果我们将列表推导式的方括号转换成圆括号,它将成为生成器表达式。这是在Python中定义生成器的更简单的方法:
 import sys

 numbers = [i for i in range(100)]
 numbers_generator = (i for i in range(100))

 print(sys.getsizeof(numbers_generator))
 # 112
 print(sys.getsizeof(numbers))
 # 920
利用内存映射文件支持大文件处理
内存映射文件I/O,简称“mmap”,是一种操作系统级优化。
简单地说,当使用mmap技术对文件进行内存映射时,它直接在当前进程的虚拟内存空间中创建文件的映射,而不是将整个文件加载到内存中,这节省了大量内存。
Python已经提供了用于使用此技术的内置模块,因此我们可以轻松地利用它,而无需考虑操作系统级别的实现。
以下是如何在Python中使用mmap进行文件处理:
 import mmap


 with open('test.txt', "r+b") as f:
    # memory-map the file, size 0 means whole file
    with mmap.mmap(f.fileno(), 0) as mm:
        # read content via standard file methods
        print(mm.read())
        # read content via slice notation
        snippet = mm[0:10]
        print(snippet.decode('utf-8'))
Python使内存映射文件I/O技术的使用变得方便。我们所需要做的只是应用mmap.mmap()方法,然后使用标准文件方法甚至切片符号处理打开的对象。
选择适当的数据类型
开发人员应仔细而精确地选择数据类型。因为在某些情况下,使用一种数据类型比使用另一种数据类型更节省内存。
1、元组比列表更节省内存
元组是不可变的(在创建后不能更改),它允许Python在内存分配方面进行优化。列表是可变的,因此需要额外的空间来容纳潜在的修改。
 import sys

 my_tuple = (1, 2, 3, 4, 5)
 my_list = [1, 2, 3, 4, 5]

 print(sys.getsizeof(my_tuple))
 # 80
 print(sys.getsizeof(my_list))
 # 120
元组my_tuple比列表使用更少的内存,如果创建后不需要更改数据,我们应该选择元组而不是列表。
2、数组比列表更节省内存
Python中的数组要求元素具有相同的数据类型(例如,所有整数或所有浮点数),但列表可以存储不同类型的对象,这不可避免地需要更多的内存。如果列表的元素都是相同类型,使用数组会更节省内存:
 import sys
 import array

 my_list = [i for i in range(1000)]

 my_array = array.array('i', [i for i in range(1000)])

 print(sys.getsizeof(my_list))
 # 8856
 print(sys.getsizeof(my_array))
 # 4064
另外:Python是数据科学的主导语言。有许多强大的第三方模块和工具提供更多的数据类型,如NumPy和Pandas。如果我们只需要一个简单的一维数字数组,而不需要NumPy提供的广泛功能,那么Python的内置数组是一个不错的选择。但当涉及到复杂的矩阵操作时,使用NumPy提供的数组是所有数据科学家的首选,也可能是最佳选择。
字符串驻留
看看下面的代码:
 >>> a = 'Y'*4096
 >>> b = 'Y'*4096
 >>> a is b
 True
 >>> c = 'Y'*4097
 >>> d = 'Y'*4097
 >>> c is d
 False
为什么a是b是真,而c是d是假呢?
这在Python中被称作字符串驻留(string interning).如果有几个值相同的小字符串,它们将被Python隐式地存储并在内存中并引用相同的对象。定义小字符串阈值数字是4096。
由于c和d的长度为4097,因此它们是内存中的两个对象而不是一个对象,不再隐式驻留字符串。所以当执行c = d时,我们得到一个False。
驻留是一种优化内存使用的强大技术。如果我们想要显式地使用它可以使用sys.intern()方法:
 >>> import sys
 >>> c = sys.intern('Y'*4097)
 >>> d = sys.intern('Y'*4097)
 >>> c is d
 True
关于Python学习指南
学好 Python 不论是就业还是做副业赚钱都不错,但要学会 Python 还是要有一个学习规划。最后给大家分享一份全套的 Python 学习资料,给那些想学习 Python 的小伙伴们一点帮助!
包括:Python激活码+安装包、Python web开发,Python爬虫,Python数据分析,人工智能、自动化办公等学习教程。带你从零基础系统性的学好Python!
👉Python所有方向的学习路线👈
Python所有方向路线就是把Python常用的技术点做整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。(全套教程文末领取)

👉Python学习视频600合集👈
观看零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。

温馨提示:篇幅有限,已打包文件夹,获取方式在:文末
👉Python70个实战练手案例&源码👈
光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

👉Python大厂面试资料👈
我们学习Python必然是为了找到高薪的工作,下面这些面试题是来自阿里、腾讯、字节等一线互联网大厂最新的面试资料,并且有阿里大佬给出了权威的解答,刷完这一套面试资料相信大家都能找到满意的工作。


👉Python副业兼职路线&方法👈
学好 Python 不论是就业还是做副业赚钱都不错,但要学会兼职接单还是要有一个学习规划。

👉 这份完整版的Python全套学习资料已经上传,朋友们如果需要可以扫描下方优快云官方认证二维码或者点击链接免费领取【保证100%免费】


 279


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


