


有句非洲谚语很有名:一个人可以走得很快,一群人才能走得更远。
还有句话是:没有人能在所有领域都成为专家,我觉得这两句话说的是一个道理。团队合作,分工明确,大家齐心协力,各尽其职才能把事情做好。
同样的道理,用在 LLM 上也很合适。我们没必要让一个 LLM 去搞定所有复杂的任务。我们可以把不同的 LLM 或者 AI Agent 组合起来,让每个 Agent 都专注于它最擅长的领域。这样,大家各司其职,效率和效果都会更好。
这种方式可以构建出一个更加健壮的系统,生产出来的东西质量也更高,结果也更可靠。
01
系统整体工作流程
在进入编码部分之前,我们先对本文构建的系统的主要组件有一个清晰的理解。
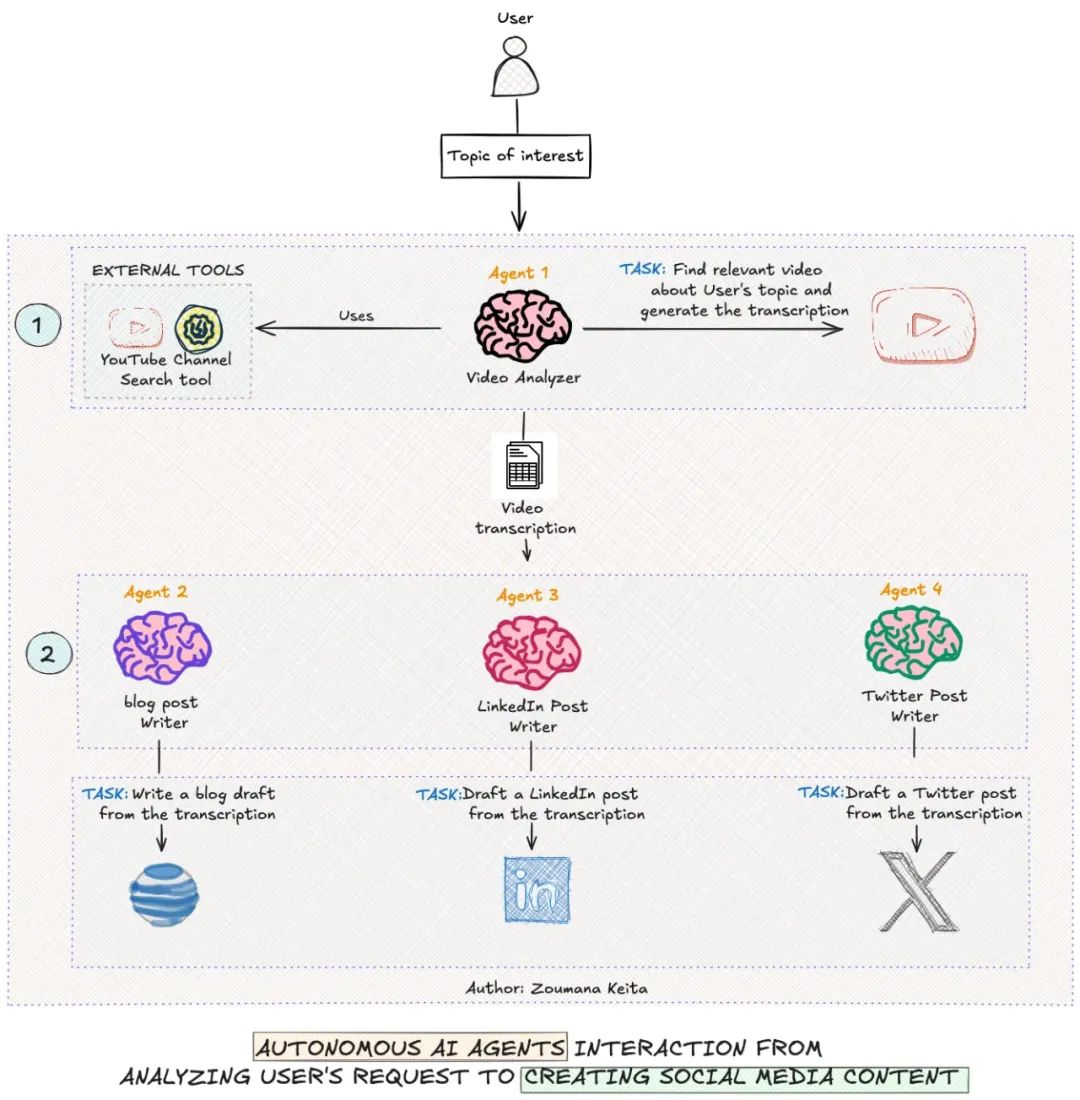
自主 AI Agent 工作流程
这个工作流程包含四个 Agent,每个 Agent 都有专门的技能。
- 首先,用户的请求被提交到系统。
- Agent 1 或视频分析器在互联网上进行深入的研究,使用 YouTube 频道搜索等外部工具查找与用户请求相关的信息。该 Agent 的结果会发送给下一个 Agent 进行进一步处理。
- Agent 2 或博客文章撰写者利用前一个 Agent 的结果撰写一篇全面的博客文章。
- 类似地,Agent 3 和 Agent 4 分别创建吸引人的 LinkedIn 帖子和推文。
- Agent2、Agent3 和 Agent 4 的回应会分别保存到不同的 Markdown 文件中,供最终用户使用。
02
为什么我们要关注 AI Agent 而不是单个 LLM?
我们都知道这儿的任务是指一个整体任务,意味着 LLM 被要求完成一个单一的目标,即数据提取。
这种方法在处理更复杂、多步骤的任务时的局限性变得很明显。下面列举了其中的一些局限性:
-
任务执行的灵活性
-
单个提示的 LLM 需要为每个任务仔细编写提示词,当任务需求发生变化时,更新这些提示可能会变得麻烦。
-
AI Agent 将这些复杂性分解为子任务,能够适应任务变化,而不需要在提示词工程上投入大量精力。
-
任务的连续性和上下文保留
-
单个提示的 LLM 可能会丢失之前互动中的重要上下文。这是因为它们主要在单个对话回合的限制内运行。
-
AI Agent 则具备在不同互动之间保持上下文的能力,每个 Agent 可以参考前一个 Agent 的响应来完成它们预期的任务。
-
专业化和互动
-
单个提示的 LLM 可能在经过大量微调后具备专业领域的知识,但这可能既耗时又昂贵。
-
另一方面,AI Agent 可以设计为由多个专门模型组成的团队,每个模型专注于一个特定任务,例如研究者、博客撰写者、社交媒体专家。
-
互联网访问
-
单个 LLM 依赖于预定义的知识库,这不可能总是最新的,导致产生幻觉或信息访问有限。
-
AI Agent 则可以访问互联网,使它们能够提供更为实时的信息,从而做出更好的决策。
03
构建内容创建工作流程
在本节中,我们将探讨如何利用智能体工作流程来创建一个系统,该系统在对用户主题进行深入研究后,撰写博客文章、LinkedIn 内容、Twitter 帖子。
代码结构如下图所示:
project
   |
   |---Multi_Agents_For_Content_Creation.ipynb
   |
  data
   |
   |---- blog-post.md
   |---- linkedin-post.md
   |---- tweet.md
- project 文件夹是根文件夹,包含 data 文件夹和 notebook。
- data 文件夹目前是空的,但在整个工作流程执行后应该包含以下三个 Markdown 文件:blog-post.md、linkedin-post.md 和 tweet.md。
- 每个 Markdown 文件都包含相应 Agent 完成任务的结果。
04
Agent 的创建及其角色与任务
现在我们已经探讨了每个 Agent 的角色,接下来我们看看如何实际创建它们,以及它们的角色和任务。
在此之前,让我们设置一些前提条件,以便更好地实现这些角色和任务。
前提条件
代码是在 Google Colab notebook 中运行的,我们的用例只需要两个库:openai 和 crewai[tools],可以通过以下方式安装它们。
%%bash
pip -qqq install 'crewai[tools]'
pip -qqq install youtube-transcript-api
pip -qqq install yt_dlp
成功安装库后,下一步是导入以下必要的模块:
import os
from crewai import Agent
from google.colab import userdata
from crewai import Crew, Process
from crewai_tools import YoutubeChannelSearchTool
from crewai import Task
每个 Agent 都利用了 OpenAI 的 GPT-4o 模型,我们需要通过以下方式设置访问模型的权限:
OPENAI_API_KEY = userdata.get('OPEN_AI_KEY')
model_ID = userdata.get('GPT_MODEL')
os.environ["OPENAI_API_KEY"] = OPENAI_API_KEY
os.environ["OPENAI_MODEL_NAME"] = model_ID
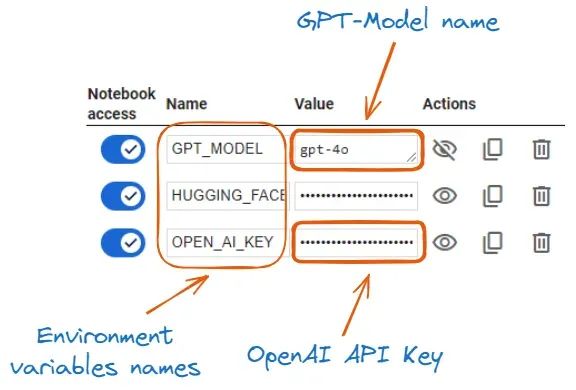
环境变量及其值
- 首先,我们使用内置的 userdata.get 函数从 Google Colab Secrets 中获取 OPEN_AI_KEY 和 GPT_MODEL。
- 然后,我们使用 os.environ 函数设置 OPEN AI KEY 和 GPT-4o 模型。
- 在完成上述两步后,使用该模型创建 Agent 应该不会有任何问题。
Agent 及其角色
通过 Agent 类,我们可以通过提供以下属性来创建一个 Agent:role,goal,backstory 和 memory。
只有 Agent 1 或 Video Analyzer 具有额外的属性:tools 和 allow_delegation。
大多数属性是自解释的,但我们还是来了解它们的具体含义。
- role 类似于职位名称,定义了 Agent 的具体角色。例如,Agent 1 的角色是主题研究员。
- goal 告诉 Agent 其角色的具体目标。
- backstory 进一步详细说明了 Agent 的角色,使其更加具体。
- memory 属性是一个布尔值。设置为 True 时,允许 Agent 记住、推理并从过去的互动中学习。
- tools 是 Agent 执行任务时使用的工具列表。
- allow_delegation 是一个布尔值,表示 Agent 的结果是否必须交给其他 Agent 进一步处理。
现在,让我们开始创建所有 Agent。
但是,在此之前,我们设置需要由第一个 Agent 使用的工具,以探索我的个人 YouTube 频道。
这是通过提供句柄 @techwithzoum 的 YouTubeChannelSearchTool 类实现的。
# The tool used by the topic researcher
youtube_tool = YoutubeChannelSearchTool(youtube_channel_handle='@techwithzoum')
1、Agent1 — 主题研究员
topic_researcher = Agent(
    role='Topic Researcher',
    goal='Search for relevant videos on the topic {topic} from the provided YouTube channel',
    verbose=True,
    memory=True,
    backstory='Expert in finding and analyzing relevant content from YouTube channels, specializing in AI, Data Science, Machine Learning, and Generative AI topics.',
    tools=[youtube_tool],
    allow_delegation=True
)
- 我们首先将该 Agent 的角色定义为 Topic Researcher。
- 然后,我们要求 Agent 使用提供的 {topic} 查找提到该主题的相关视频。
- 最后,我们将第一个 Agent 定义为使用 YouTube 搜索工具查找和分析关于 AI、数据科学、机器学习和生成式 AI 主题的相关内容的专家。
在当前 Agent 定义中,后续 Agent 的定义与此相似,只是属性值有所不同。一旦理解了这一点,后续 Agent 的定义就不再需要解释。
2、Agent 2 — 博客撰写者
blog_writer = Agent(
    role='Blog Writer',
    goal='Write a comprehensive blog post from the transcription provided by the Topic Researcher, covering all necessary sections',
    verbose=True,
    memory=True,
    backstory='Experienced in creating in-depth, well-structured blog posts that explain technical concepts clearly and engage readers from introduction to conclusion.',
    allow_delegation=False
)
3、Agent 3 — LinkedIn 帖子创建者
# LinkedIn Post Agent
linkedin_post_agent = Agent(
    role='LinkedIn Post Creator',
    goal='Create a concise LinkedIn post summary from the transcription provided by the Topic Researcher.',
    verbose=True,
    memory=True,
    backstory='Expert in crafting engaging LinkedIn posts that summarize complex topics and include trending hashtags for maximum visibility.',
    allow_delegation=False
)
4、智能体 4 — Twitter 帖子创建者
twitter_agent = Agent(
    role='Twitter Content Creator',
    goal='Create a short tweet from the transcription provided by the Topic Researcher that capture key points and insights',
    verbose=True,
    memory=True,
    backstory='Specializes in distilling complex information into concise, impactful tweets that resonate with a tech-savvy audience.',
    allow_delegation=False
)
我们注意到最后三个智能体都不再委托任务,这是因为它们的结果不需要被其他 Agent 处理。
完美!现在我们的 Agent 已经准备好了解对它们的期望了,这是通过 Task 类来实现的。
任务
人类在接到任务指示后会执行任务来交付结果。
同样,Agent 也需要执行任务并交付结果,所需的属性如下:
- description 对应需要 Agent 执行的任务的明确描述。描述越清晰,模型的输出就越好。
- expected_output 是对 Agent 预期结果的文本描述。
- agent 是执行特定任务的 Agent 占位符。
- tools 类似于角色定义部分,并非每个 Agent 都使用工具。在我们的用例中,只有主题研究员使用了工具。
- output_file 是文件名及其格式。仅对需要将任务结果保存为文件的 Agent 指定,例如 Markdown 文件,博客撰写者的文件名可以是 blog-post。md。
接下来,我们来看这些任务的 Python 实现。
1、Agent 1 — 主题研究员
research_task = Task(
    description="Identify and analyze videos on the topic {topic} from the specified YouTube channel.",
    expected_output="A complete word by word report on the most relevant video found on the topic {topic}.",
    agent=topic_researcher,
    tools=[youtube_tool]
)
2、Agent 2 — 博客撰写者
blog_writing_task = Task(
    description=""" Write a comprehensive blog post based on the transcription provided by the Topic Researcher.
                    The article must include an introduction , step-by-step guides, and conclusion.
                    The overall content must be about 1200 words long.""",
    expected_output="A markdown-formatted of the blog",
    agent=blog_writer,
    output_file='./data/blog-post.md'
)
3、Agent 3 — LinkedIn 帖子创建者
linkedin_post_task = Task(
    description="Create a LinkedIn post summarizing the key points from the transcription provided by the Topic Researcher, including relevant hashtags.",
    expected_output="A markdown-formatted of the LinkedIn post",
    agent=linkedin_post_agent,
    output_file='./data/linkedin-post.md'
)
4、Agent 4 — Twitter 帖子创建者
twitter_task = Task(
    description="Create a tweet from the transcription provided by the Topic Researcher, including relevant hastags.",
    expected_output="A markdown-formatted of the Twitter post",
    agent=twitter_agent,
    output_file='./data/tweets.md'
)
对于每个 Agent,属性都是自解释的,其结果为:
- 第一个 Agent 生成的结果是供后三个 Agent 使用的原始文本数据。
- 第二个 Agent 的结果是一个名为 blog-post.md 的 Markdown 文件。
- 第三个 Agent 的结果是一个名为 linkedin-post.md 的 Markdown 文件。
- 最后一个 Agent 的结果也是一个名为 tweets.md 的 Markdown 文件。
05
让 Agent 开始工作
最后,我们协调 Agent 团队,按照如下方式执行任务:
my_crew = Crew(
    agents=[topic_researcher, linkedin_post_agent, twitter_agent, blog_writer],
    tasks=[research_task, linkedin_post_task, twitter_task, blog_writing_task],
    verbose=True,
    process=Process.sequential,
    memory=True,
    cache=True,
    max_rpm=100,
    share_crew=True
)
- agents 对应于我们所有 Agent 的列表。
- tasks 是每个 Agent 需要执行的任务列表。
- 我们将 verbose 设置为 True 以查看完整的执行跟踪。
- max_rpm 是我们的团队为避免速率限制而每分钟最多可以执行的请求数。
- 最后,share_crew 表示 Agent 共享资源来执行任务。这对应于第一个 Agent 与其他 Agent 共享其响应。
在协调了 Agent 之后,是时候通过 kickoff 函数触发它们了,该函数接收一个输入字典作为参数。在这里,我们搜索的是我录制的关于 GPT3.5 Turbo 微调与图形界面的一个视频。
topic_of_interest = 'GPT3.5 Turbo Fine-tuning and Graphical Interface'
result = my_crew.kickoff(inputs={'topic': topic_of_interest})
成功执行上述代码将生成我们上面指定的三个 Markdown 文件。
以下是每个文件内容的结果显示。作为录制视频的人,这些内容与教程中涉及的内容完全一致。
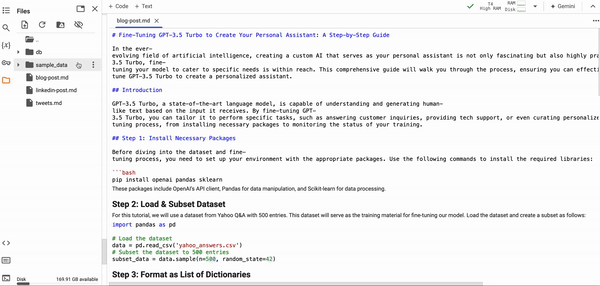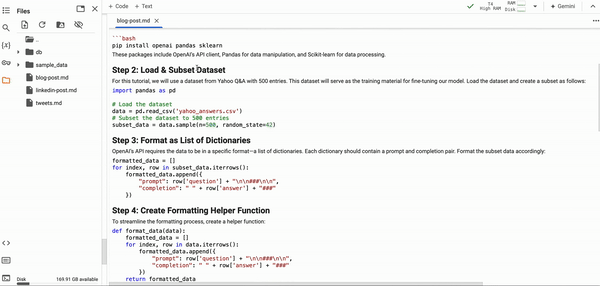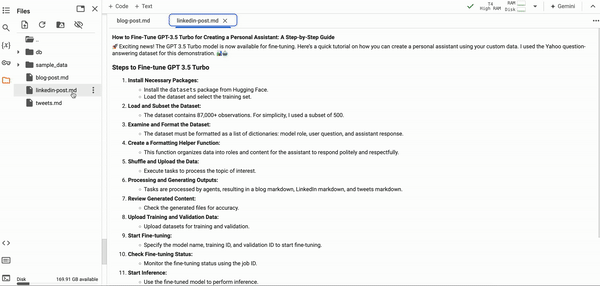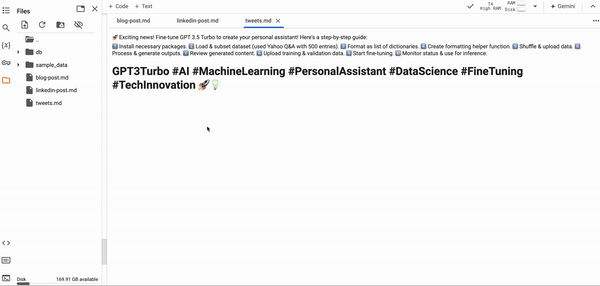
博客 Agent 未能提供百分之百的分步指南,用户在执行代码时可能会遇到问题,但它提供了对教程范围的极好理解。
对于 LinkedIn 和 Twitter 帖子,结果非常出色!
你可以在下面链接中查看所有文件的内容。
https://github.com/keitazoumana/LLMs/tree/main/ai_agents_outputs
06
评估 Agent
我对 Agent 的上述评估基于我对内容的个人熟悉程度。然而,在投产之前,需要更客观且可扩展的评估方法。
以下是一些有效评估这些 AI Agent 的策略。
- 基准测试可以用来评估每个 Agent 在不同任务上的表现,使用已建立的数据集如 GLUE 和 FLASK,可以进行与不同最先进模型的标准化比较。
- 事实准确性测量评估 Agent 在多个领域提供事实性回答的能力。
- 上下文感知相关性评分可以用来量化 Agent 的响应与给定提示词的对齐程度。
可以利用多个框架来执行这些评估,其中包括:
- DeepEval,这是一个开源工具,用于量化 LLM 在不同指标上的性能。
- MMLU(大规模多任务语言理解)是一个测试模型在零样本和单样本设置下的多学科知识的框架。
- OpenAI evals 也是一个用于评估 LLM 或任何基于 LLM 系统的框架。
07
总结
本文简要介绍了如何利用 AI Agent 有效完成高级任务,而不是让一个大语言模型单打独斗。
如何学习AI大模型?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高
那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈
全套AGI大模型学习大纲+路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。


👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 1146


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


