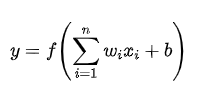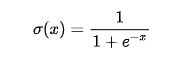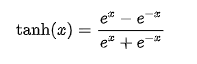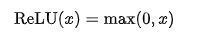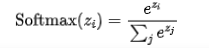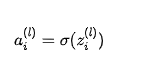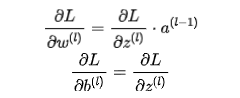终于把神经网络算法搞懂了!!

深度学习的数学-神经网络、输入层、隐藏层、输出层 文章目录前言正文一个例子输入层输出层隐藏层各个层如何向上传递信息神经网络中权重和偏置的作用有监督学习下,如何确认权重总结 排版可能更好一点的永久原文链接:深度学习的数学-神经网络、输入层、隐藏层、输出层 前言 前文中了解到,神经网络由多个神经单元组成,而本篇博客将会了解到深度学习由多个神经网络组成,并且分为 输入层、隐藏层和输出层,隐藏层涉及到的知识点最多,是本文的重点 正文 阶层型的神经网络主要... 阅读详情
AI摘要

本文介绍了神经网络的结构、神经元结构、激活函数及训练过程,包括初始化、前向传播、计算损失、反向传播、参数更新和迭代训练。还给出鸢尾花数据集分类示例代码,同时分享了全套AGI大模型学习大纲、路线及640套AI大模型报告合集等学习资料。

神经网络作为深度学习的基础,广泛应用于图像识别、自然语言处理、语音识别等任务中。
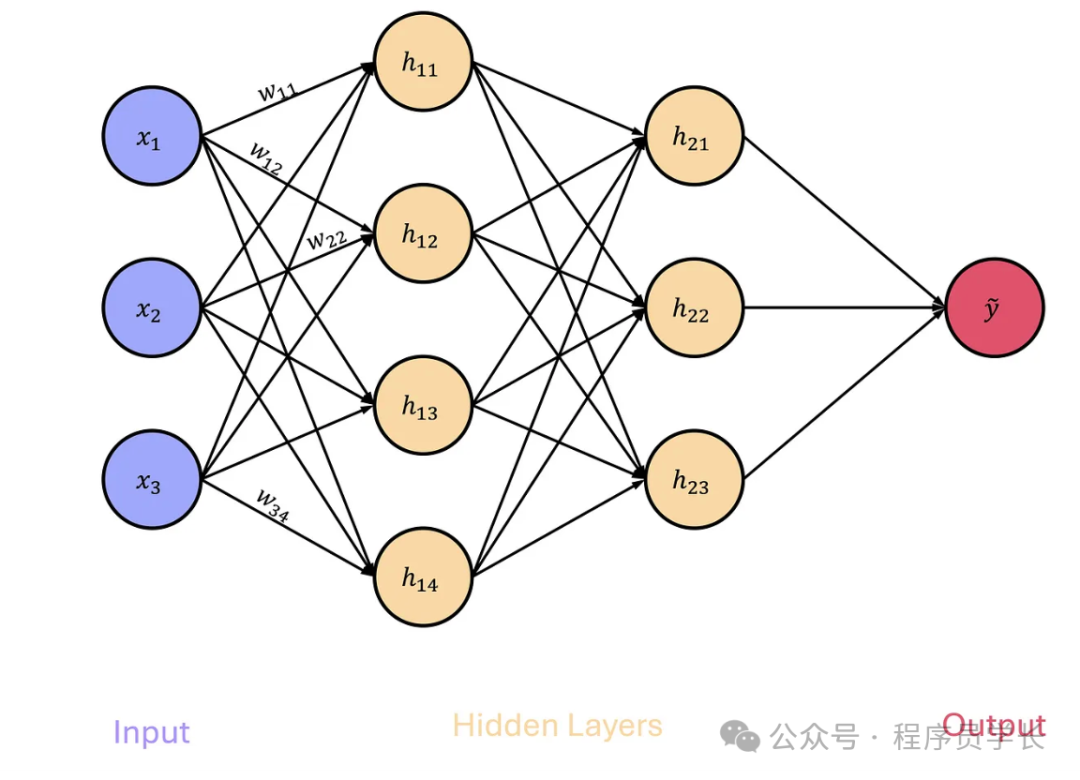
img

神经网络的结构

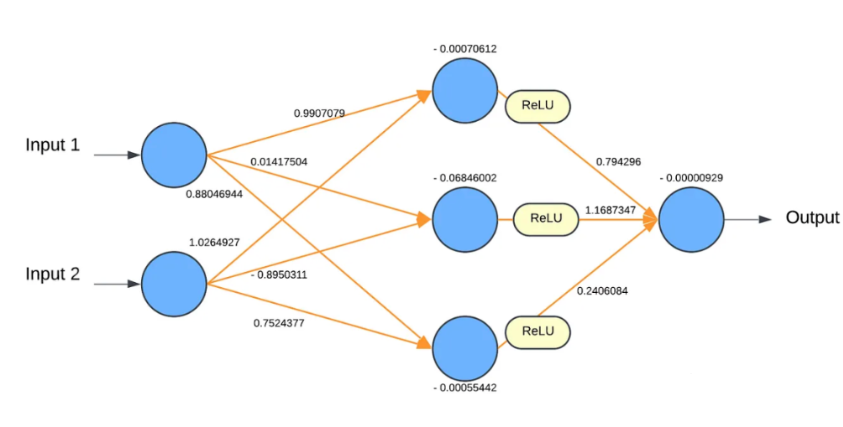
神经网络主要由输入层、隐藏层和输出层组成。

输入层

输入层用于接收输入数据(例如图像、文本),每个输入节点代表一个特征值,输入层的节点数目与输入数据的特征数目一致。

隐藏层

隐藏层位于输入层和输出层之间,通过对输入数据进行非线性变换来提取特征。

神经网络可以有多个隐藏层,每个隐藏层由若干神经元构成。

隐藏层的层数和神经元数量是神经网络设计中的重要超参数。

输出层

输出最终的预测结果或分类标签。

输出层的神经元数量与任务相关,例如分类任务的输出节点数等于类别数,回归任务通常只有一个输出节点。

神经元的结构

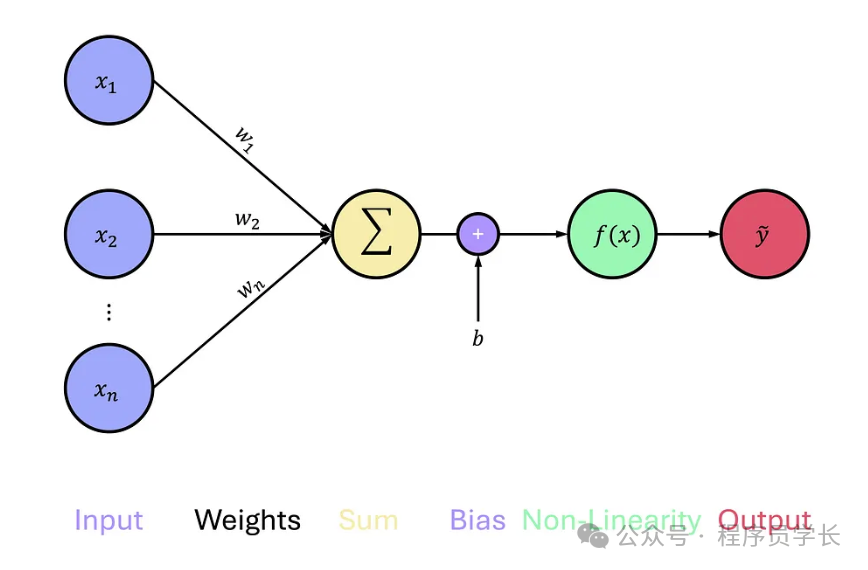
一个神经元的基本功能是将输入数据加权求和并通过激活函数进行处理。
img

具体计算过程为:

在这里插入图片描述

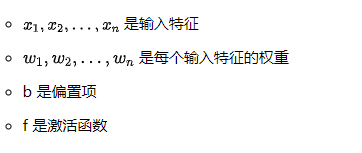
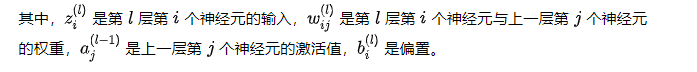
其中:

在这里插入图片描述

常见的激活函数

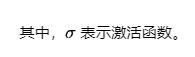
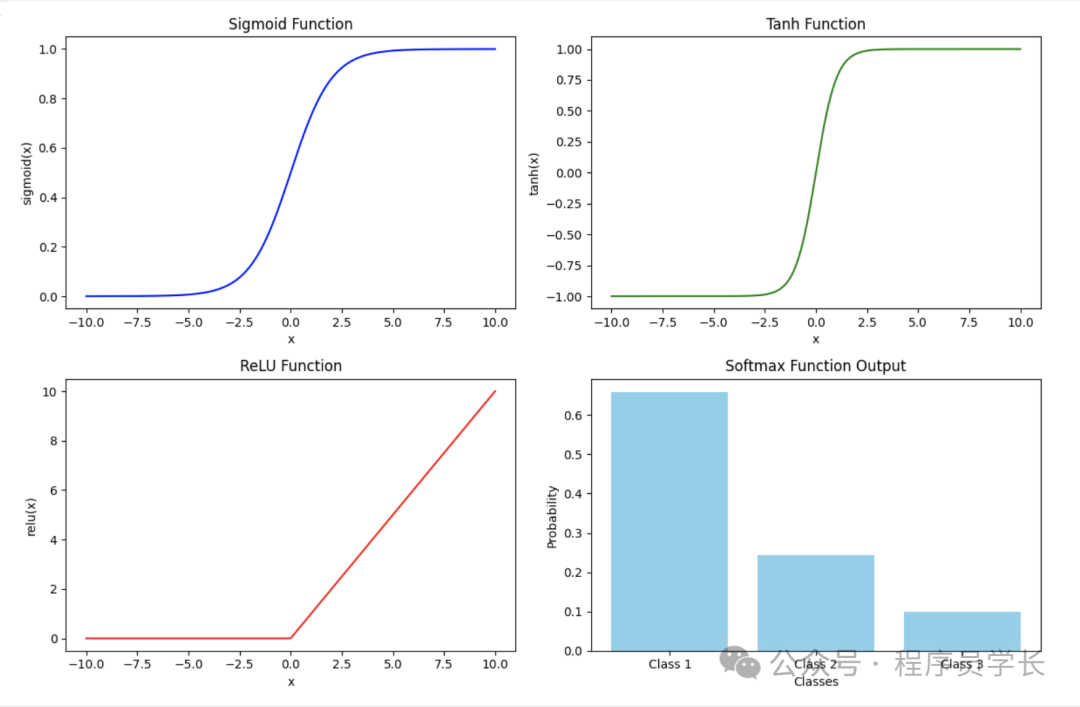
激活函数的作用是为神经网络引入非线性,使得神经网络能够学习和拟合复杂的函数。

常用的激活函数包括:

  • Sigmoid

    输出值在(0, 1)之间,常用于二分类任务的输出层。

    在这里插入图片描述

  • Tanh

    输出值在-1到1之间,适合中心对称的数据。

    在这里插入图片描述

  • ReLU

    ReLU 将所有负值截断为 0,广泛应用于隐藏层。

    在这里插入图片描述

  • Softmax

    用于多分类任务的输出层,输出概率分布。

在这里插入图片描述

import numpy as np
import matplotlib.pyplot as plt

# 激活函数定义

def sigmoid(x):
    return 1 / (1 + np.exp(-x))

def tanh(x):
    return np.tanh(x)

def relu(x):
    return np.maximum(0, x)

def softmax(x):
    e_x = np.exp(x - np.max(x))  # 防止溢出
    return e_x / e_x.sum(axis=0, keepdims=True)

# 数据范围
x = np.linspace(-10, 10, 400)
y_sigmoid = sigmoid(x)
y_tanh = tanh(x)
y_relu = relu(x)

# 绘制图像
plt.figure(figsize=(12, 8))

plt.subplot(2, 2, 1)
plt.plot(x, y_sigmoid, label="Sigmoid", color="blue")
plt.title("Sigmoid Function")
plt.xlabel("x")
plt.ylabel("sigmoid(x)")

plt.subplot(2, 2, 2)
plt.plot(x, y_tanh, label="Tanh", color="green")
plt.title("Tanh Function")
plt.xlabel("x")
plt.ylabel("tanh(x)")

plt.subplot(2, 2, 3)
plt.plot(x, y_relu, label="ReLU", color="red")
plt.title("ReLU Function")
plt.xlabel("x")
plt.ylabel("relu(x)")

x = np.array([2.0, 1.0, 0.1])
softmax_output = softmax(x)
labels = ['Class 1', 'Class 2', 'Class 3']
plt.subplot(2, 2, 4)
plt.bar(labels, softmax_output, color='skyblue')
plt.title('Softmax Function Output')
plt.xlabel('Classes')
plt.ylabel('Probability')
plt.tight_layout()
plt.show()
img

神经网络的训练过程

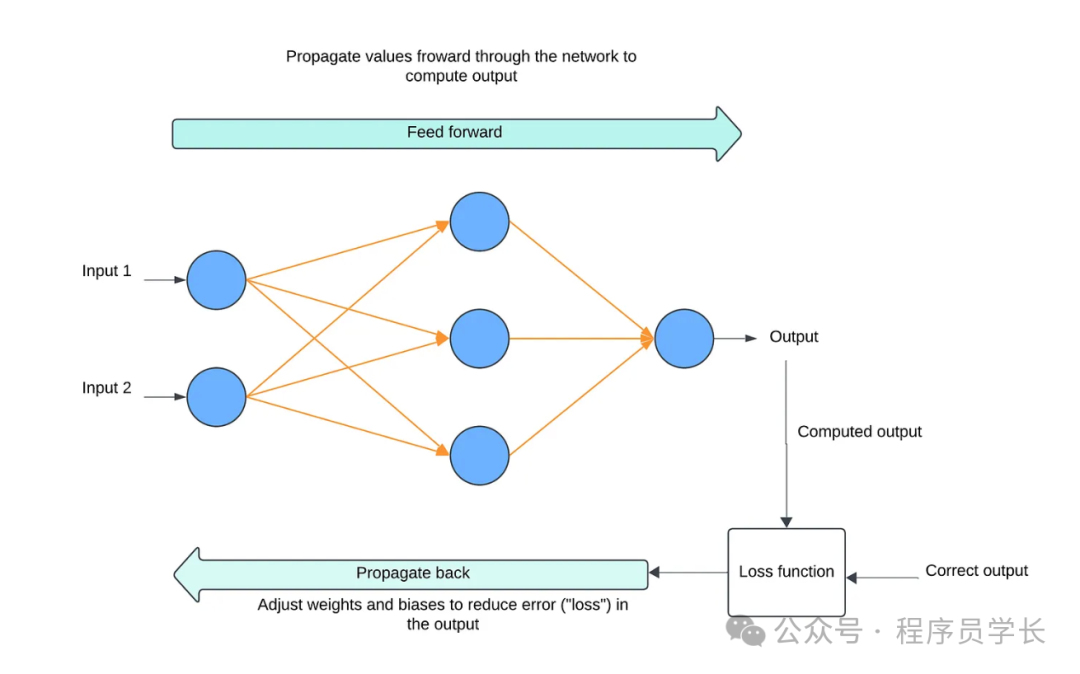
神经网络的训练过程是一个迭代优化的过程,主要目标是调整网络中的参数(权重和偏置),使得神经网络能够在给定任务上表现良好。
img

1. 初始化网络结构

神经网络的结构通常由输入层、隐藏层和输出层组成。

每一层都包含若干个神经元或“节点”,每个节点与上一层和下一层的节点通过“权重”相连。

在网络初始化时,权重通常随机初始化,偏置一般初始化为零或小的常数值。

2. 前向传播 (Forward Propagation)

前向传播是计算网络输出的过程

步骤如下:

  • 输入数据

    从输入层开始,网络接收一个输入样本(例如图像的像素值或文本的特征向量)。

  • 加权求和

    每一层的每个神经元会对来自前一层的输入进行加权求和。

    计算公式如下:
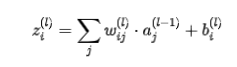
在这里插入图片描述

在这里插入图片描述

  • 激活函数

    加权求和后,通过激活函数计算神经元的输出。

    在这里插入图片描述

在这里插入图片描述

  • 输出层

    最终,经过一系列层的前向传播后,网络会输出预测结果。

在这里插入图片描述

3.计算损失

在每次前向传播后,我们需要计算神经网络的预测值与真实值之间的误差。

损失函数用于量化这种误差,不同的任务需要选择不同的损失函数。

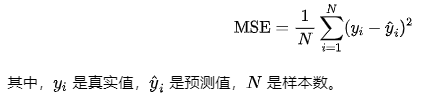
  • 回归任务

在这里插入图片描述

其中, 是真实值, 是预测值, 是样本数。

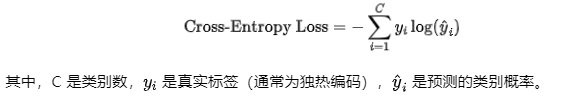
  • 分类任务

在这里插入图片描述

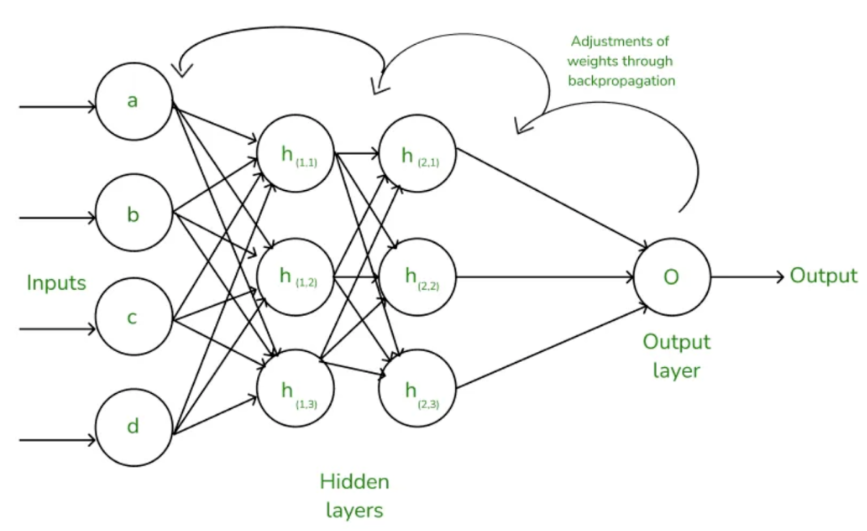
4. 反向传播

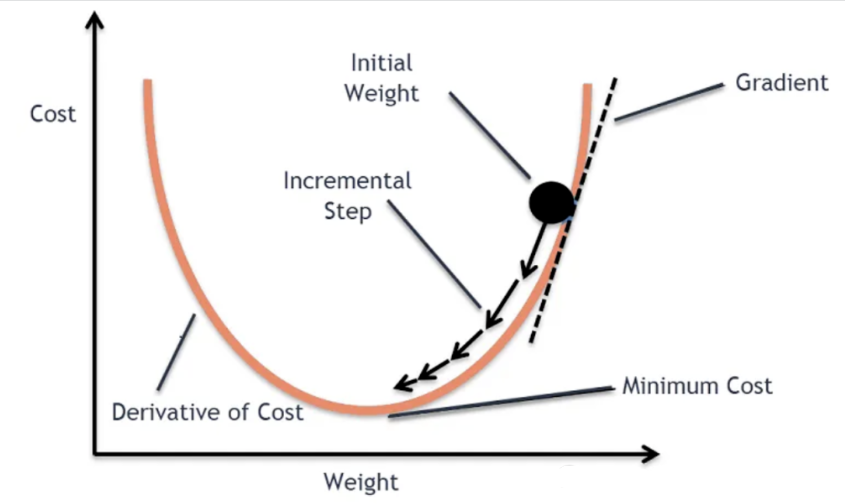
反向传播是训练神经网络的核心,它用于计算损失函数关于每个权重的梯度,并通过梯度下降算法来更新权重。
在这里插入图片描述

反向传播的步骤如下

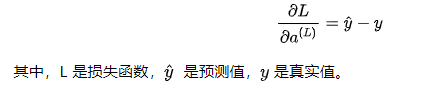
  • 计算损失函数对输出的梯度

    首先,计算损失函数对输出层的梯度(即误差):
    在这里插入图片描述

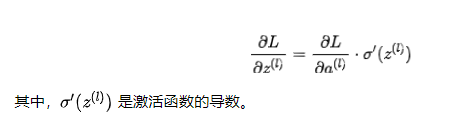
  • 计算每一层的误差

    然后,通过链式法则逐层将误差向后传播,计算每一层的误差

在这里插入图片描述

  • 计算权重和偏置的梯度

    然后,计算每一层的权重和偏置的梯度

    在这里插入图片描述

5. 参数更新

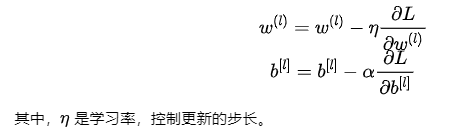
反向传播计算出每个权重和偏置的梯度后,接下来就是更新权重和偏置。

通常使用梯度下降算法来更新网络的权重和偏置。

更新公式如下
在这里插入图片描述

在这里插入图片描述

6. 迭代训练

训练过程通常会进行多次迭代(称为 epochs),每个 epoch 包括了对训练数据的一次完整的前向传播和反向传播。

案例分享

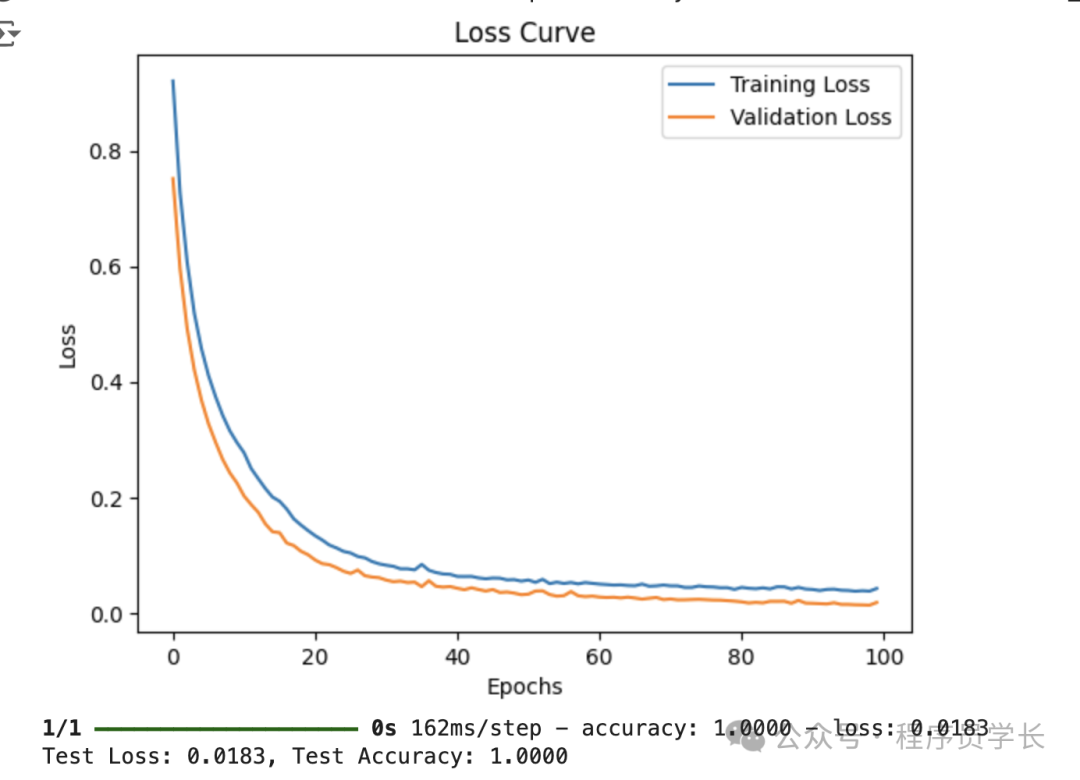
下面是一个使用神经网络对鸢尾花数据集进行分类的示例代码。

import numpy as np
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
import tensorflow as tf
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense
from tensorflow.keras.optimizers import Adam
from tensorflow.keras.utils import to_categorical

#加载鸢尾花数据集
iris = datasets.load_iris()
X = iris.data
y = iris.target

scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
y_one_hot = to_categorical(y, 3)
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y_one_hot, test_size=0.2, random_state=42)

#构建神经网络模型
model = Sequential()
#输入层和第一个隐藏层
model.add(Dense(64, activation='relu', input_dim=X_train.shape[1]))
#第二个隐藏层
model.add(Dense(32, activation='relu'))
#输出层
model.add(Dense(3, activation='softmax'))  # 3类输出

model.compile(loss='categorical_crossentropy', optimizer=Adam(), metrics=['accuracy'])
history = model.fit(X_train, y_train, epochs=100, batch_size=10, validation_data=(X_test, y_test))

#绘制损失曲线
plt.plot(history.history['loss'], label='Training Loss')
plt.plot(history.history['val_loss'], label='Validation Loss')
plt.title('Loss Curve')
plt.xlabel('Epochs')
plt.ylabel('Loss')
plt.legend()
plt.show()

#评估模型
loss, accuracy = model.evaluate(X_test, y_test)
print(f"Test Loss: {loss:.4f}, Test Accuracy: {accuracy:.4f}")
img

如何学习AI大模型?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高

那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

全套AGI大模型学习大纲+路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

在这里插入图片描述
在这里插入图片描述

在这里插入图片描述
在这里插入图片描述

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

img

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

神经网络中的 “隐藏层” 理解 文章目录一、概念理解二、示例理解 一、概念理解 隐藏层的定义:除输入层和输出层以外的其他各层叫做隐藏层。隐藏层不直接接受外界的信号,也不直接向外界发送信号 隐藏层在神经网络中的作用:中间的黑盒子,可以认为是很其他的不同功能层的一个总称 每个图层都可以应用您想要的任何函数到前一层(通常是线性变换,然后是压缩非线性)。 隐藏层的工作是将输入转换为输出层可以使用的东西。 输出层将隐藏层激活转换为您希... 阅读详情

相关推荐

全连接隐藏层(FC Layer)从神经元到深度网络的数学本质

神经网络(Neural Network)是模拟人脑神经元连接模式的计算模型,旨在通过大量简单的计算单元(神经元)之间的连接和互动,解决复杂的计算和模式识别问题。自20世纪中叶提出以来,神经网络已成为机器学习和人工智能领域的重要工具,广泛应用于语音识别、图像分类、自然语言处理等领域。早期的神经网络,如感知机(Perceptron),只能处理线性可分的问题,功能相对有限。为了克服这一限制,研究人员提出了多层神经网络,即在输入层和输出层之间增加一层或多层隐藏层(Hidden Layer)。这些隐藏层使得网络能够学

hello.reader 3933

神经网络算法

每个神经元有一个输出,它可以连接到许多其他神经元,每个神经元输入有多个连接通路,每个连接通路对应一个连接权系数。x1~ xn是从其他神经元传来的输入信号,wij表示表示从神经元j到神经元i的连接权值,θ表示一个阈值(或称为偏置),则神经元i的输出与输入的关系表示为:yi表示神经元i的输出,函数f称为激活函数或转移函数,net称为净激活。

太可惹的博客 6813

<工控><PLC>汇川Easy521系列PLC与汇川SV630N伺服进行EtherCat通讯的相关配置及指令编写

本系列是关于PLC相关的博文,包括PLC编程、PLC与上位机通讯、PLC与下位驱动、仪器仪表等通讯、PLC指令解析等相关内容。PLC品牌包括但不限于西门子、三菱等国外品牌,汇川、信捷等国内品牌。除了PLC为主要内容外,PLC相关元器件如触摸屏(HMI)、交换机等工控产品,如果有值得记录的内容,也会添加进来。

用沸腾的热血,支付我们的人生吧! 2万+

神经网络算法详解

线性模型有一个 n 维权重 ω 和一个标量偏差 b :对于给定的输入 x :线性模型得到的输出 y 等于输入 x 与权重 ω 的加权求和, 再加上偏置 b, 即:向量版本的写法为:线性模型相乘求和的含义是什么?相乘的含义是通过权重对输入信息进行重要程度的重分配;而求和的目的是综合考虑所有信息。例如, 生活中房价。

极光喵的博客 8908

保姆级教程:在Ubuntu 20.04上搞定pybind11,解决‘找不到头文件’的坑

本文提供了一份详细的Ubuntu 20.04下pybind11配置指南,重点解决常见的'找不到头文件'问题。从环境准备、安装策略到三种专业解决方案(修改CMakeLists.txt、环境变量方案、绝对路径包含),帮助开发者高效搭建C++与Python的桥梁。

weixin_28829325的博客 284

从M350 RTK到E-Port:解锁大疆无人机多负载协同与PSDK V3开发新范式

本文深入解析了大疆M350 RTK无人机搭载的E-Port智能接口与全新的PSDK V3开发套件,如何共同实现多负载协同作业的范式转变。E-Port集成了供电与高速数据总线,而PSDK V3通过统一的设备模型与服务机制,大幅降低了第三方负载的开发门槛与集成复杂度,使构建如智能巡检等复杂空中作业系统变得更加高效和标准化。

3c4x5z6v7b的博客 166

终于把卷积神经网络算法搞懂了!!

今天给大家分享一个强大的算法模型,卷积神经网络算法卷积神经网络算法(CNN)是一种深度学习模型,广泛应用于图像处理、计算机视觉和自然语言处理等领域。CNN 通过模拟生物视觉系统的处理方式,能够自动从原始数据中提取特征,从而实现对输入数据的自动学习和分类。相比传统的全连接神经网络,CNN具有更高的效率和较低的计算复杂度。

gu781223的博客 1239

ST MCSDK V6.2.0实战:手把手教你配置HSO-ST观测器,体验500ms收敛的电机无感控制

本文详细介绍了ST MCSDK V6.2.0中HSO-ST观测器的配置方法,实现500ms内电流收敛的无感电机控制。从环境搭建、核心参数解析到无感启动优化,提供实战技巧和性能调优策略,帮助开发者快速掌握高效电机控制技术。

weixin_28720767的博客 580

终于把图神经网络算法搞懂了!!

传统的深度学习主要处理结构化数据,如图像、文本等,而图数据具有复杂的非欧几里得结构,节点和边之间没有固定顺序或连接模式。图神经网络(GNN)通过特定的机制学习和表示图结构数据中的节点、边和全图信息。GNN的核心思想是利用图的拓扑结构,通过节点间的邻接关系传播信息和进行学习。GNN的计算步骤包括信息传递、聚合、更新和迭代,最终根据任务需求从节点特征或图特征中提取有用信息进行分类、回归等任务。

Gupao123的博客 797

SIWAVE+ADS提取PCB走线寄生参数

本文将介绍一种很适合PCB走线提取寄生电感等参数的方法,即是通过SIWAVE将PCB走线的S参数提取出来,再通过ADS将S参数转换成电感、电容值。

sinat_15150363的博客 1765

1、微软 Intune 全面指南:配置、管理与自动化

本文全面介绍了微软 Intune 的配置、管理和自动化操作,涵盖用户与设备管理、安全策略设置、跨平台应用部署、合规性监控及报告分析等内容。通过详细的操作步骤、自动化脚本示例和流程优化建议,帮助技术人员高效掌握 Intune 在混合办公环境中的实际应用,并展望其未来发展趋势。

ii567的博客 361

终于把神经网络算法搞懂了!!非常详细收藏我这一篇就够了

今天给大家分享一个强大的算法模型,神经网络神经网络算法是一种受人类大脑神经结构启发的计算模型,广泛应用于模式识别、分类、回归等任务中。神经网络通过多层神经元的层级结构对数据进行逐层处理,从而从复杂的非线性数据中提取特征和模式。

2401_84204207的博客 4805

基于转录逆转的药物重定向 GPS 模型

GPS是一个基于分子结构预测基因表达扰动的开源平台,由三个模块组成:RCL(在LINCS扰动数据上训练抗噪MLP)、GPS4Drugs(预测新化合物的基因表达谱并进行逆转评分)、MolSearch(基于MCTS的分子优化)。平台使用Morgan指纹和Gene Ontology注释作为特征输入,将基因表达扰动离散为三分类标签。训练数据来自LINCS Phase I的18,746个化合物和978个landmark基因,支持四细胞系独立训练,可用于药物重定向与化合物筛选。

听雨草堂 83

我终于把神经网络算法搞懂了!!

神经网络算法(Neural Network)是受生物神经系统启发而设计的一类机器学习模型,广泛应用于图像识别、自然语言处理、语音识别等领域。它通过构建多层“神经元”结构,对输入数据进行非线性变换,从而实现分类、回归、生成等任务。

2503_90237586的博客 199

【华为OD机试真题】458、堆内存申请 | 机试真题+思路参考+代码解析(CD卷)(C++、Java、Py)

题目描述 >有一个总空间为100字节的堆,现要从中新申请一块内存,内存分配原则为优先紧接着前一块已使用内存分配空间足够且最接近申请大小的空闲内存。

KJ.JK 1万+

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

大模型 | 终于把卷积神经网络算法搞懂了!!

今天给大家分享一个强大的算法模型,卷积神经网络算法卷积神经网络(CNN)是一种专门用于处理具有(如图像)的深度学习模型。CNN 的核心是通过来提取图像中的局部特征,并通过降低数据的维度。卷积神经网络在很多计算机视觉任务中都表现出色,比如图像分类、目标检测和图像生成等。

m0_56255097的博客 1647

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

终于把 LSTM 算法搞懂了!!

LSTM(长短期记忆网络)是一种特殊的循环神经网络,通过门控机制解决传统RNN的梯度消失问题。它包含遗忘门、输入门和输出门,能有效捕捉序列数据的长期依赖关系,广泛应用于自然语言处理和时间序列预测。文章以英伟达股票预测为例,展示了使用Python和TensorFlow构建LSTM模型的完整流程,包括数据获取、归一化处理、模型训练和预测可视化。LSTM模型在保持长期记忆和梯度流动方面具有显著优势。

Q2024107的博客 2859

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

终于把 Transformer 算法搞懂了!!

今天给大家介绍一个超强的算法模型,TransformerTransformer 是一种基于自注意力机制(Self-Attention)的神经网络模型,最早由 Vaswani 等人在论文《Attention is All You Need》中提出,主要用于处理序列到序列的任务,例如自然语言处理(NLP)中的翻译任务。与传统的循环神经网络(RNN)和长短期记忆网络(LSTM)相比,Transformer 通过完全摆脱循环结构,依赖于注意力机制来捕捉序列中的长依赖关系。

2301_82275412的博客 2286
上一篇: 作为AI产品经理,我们到底在优化什么?对于产品经理而言,AI代表是什么?
下一篇: 哦豁!有了这份学习路径,AI大模型小白也能学懂大模型!!
AI程序猿人
博客等级 码龄3年 6517粉丝 561原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值