SparkRA带你读论文 | 如何训练数据高效的 LLMs

【企业知识助手·Agent 实战】如何构建 Agent 运行态可观测体系:从行为基线漂移检测到成本预算治理的深度实战 核心原理:运行态可观测的本质是把"单点阈值"升级为"与基线的分布距离"——埋点回答发生了什么,基线比较回答这是否还正常关键结论:deny 率没有单向好坏语义,必须双边告警 + known-good / known-bad 双哨兵仲裁;成本归因的终点是单位经济与预算三线一位;评测分数入库让质量拥有趋势线。 阅读详情

简介

图片

How to Train Data-Efficient LLMs

论文作者: Noveen Sachdeva, Benjamin Coleman, Wang-Cheng Kang, Jianmo Ni, Lichan Hong Ed H. Chi, James Caverlee, Julian McAuley, Derek Zhiyuan Cheng

论文链接:

https://arxiv.org/pdf/2402.09668.pd

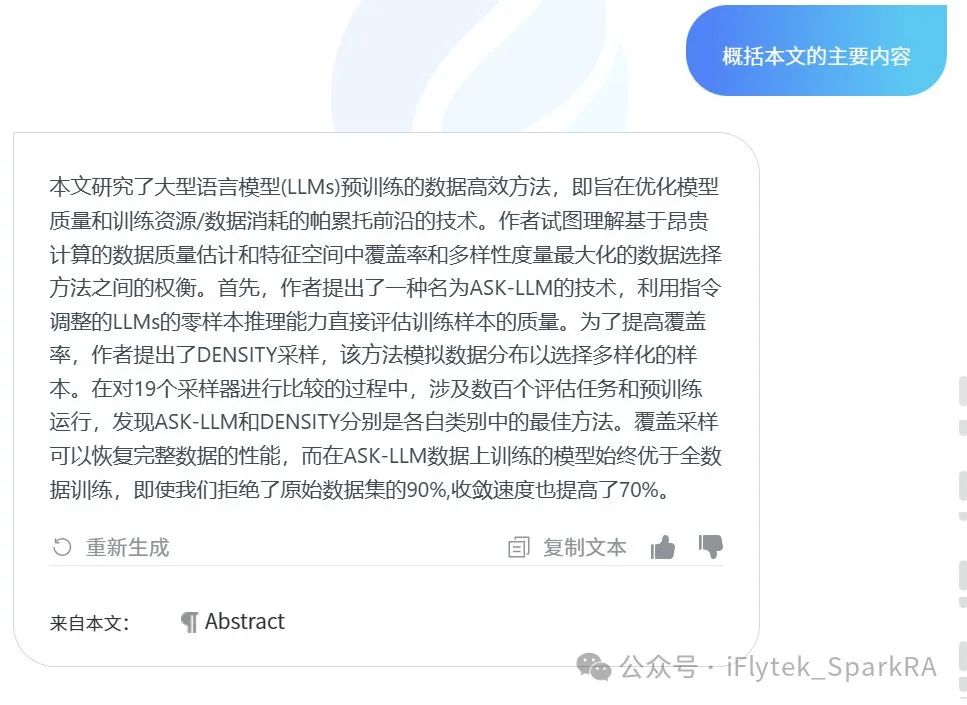
这篇论文于2024年2月发表在arXiv,作者是Noveen Sachdeva, Benjamin Coleman, Wang-Cheng Kang, Jianmo Ni, Lichan Hong Ed H. Chi, James Caverlee, Julian McAuley, Derek Zhiyuan Cheng。本文研究了大型语言模型(LLMs)的训练方法,特别是数据效率的方法。作者们探讨了基于昂贵的数据质量估计和在特征空间中最大化覆盖度和多样性度量的数据选择策略之间的权衡。他们提出了两种技术:ASK-LLM和DENSITY采样,前者利用指令调整的LLMs的零样本学习推理能力直接评估训练样本的质量,后者通过模拟数据分布来选择一个多样化的样本。

论文研读

免责声明:论文研读功能的回复内容完全由人工智能模型生成,如您发现错误可以后台联系我们。

下面通过星火科研助手来研读这篇文章:

Q1: 概括论文的主要内容
图片

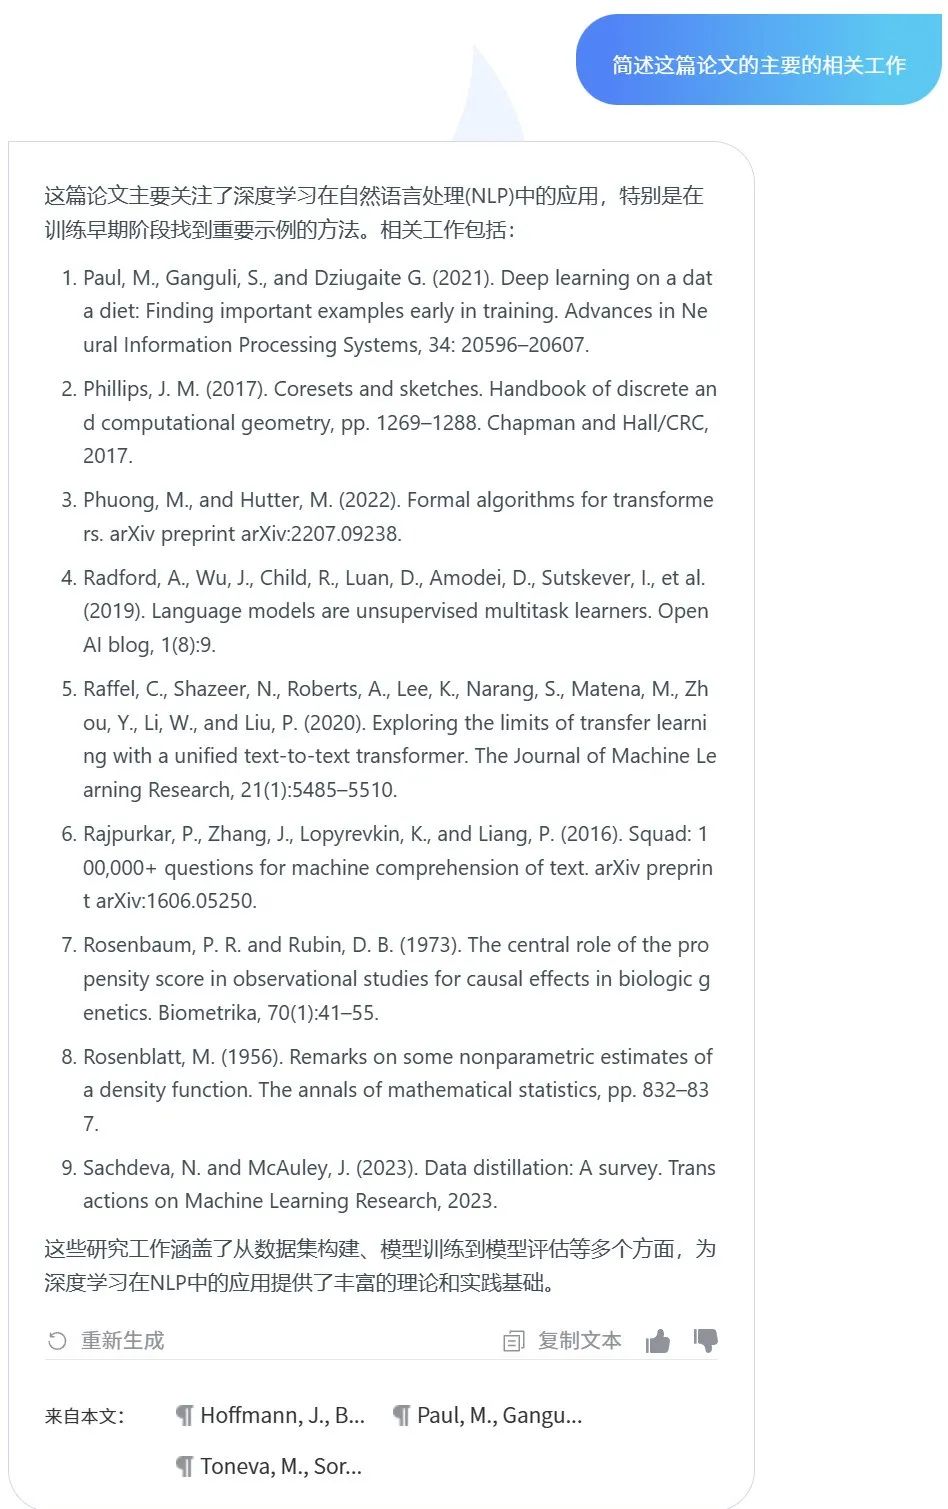
Q2: 简述这篇论文的主要相关工作

图片

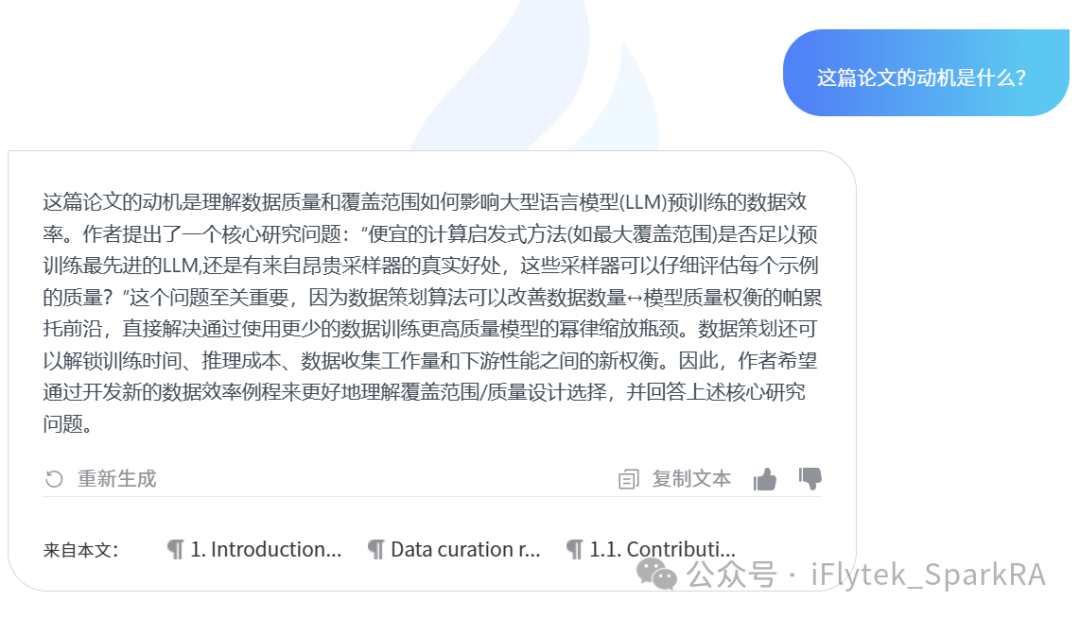
Q3: 这篇论文的动机是什么?

图片

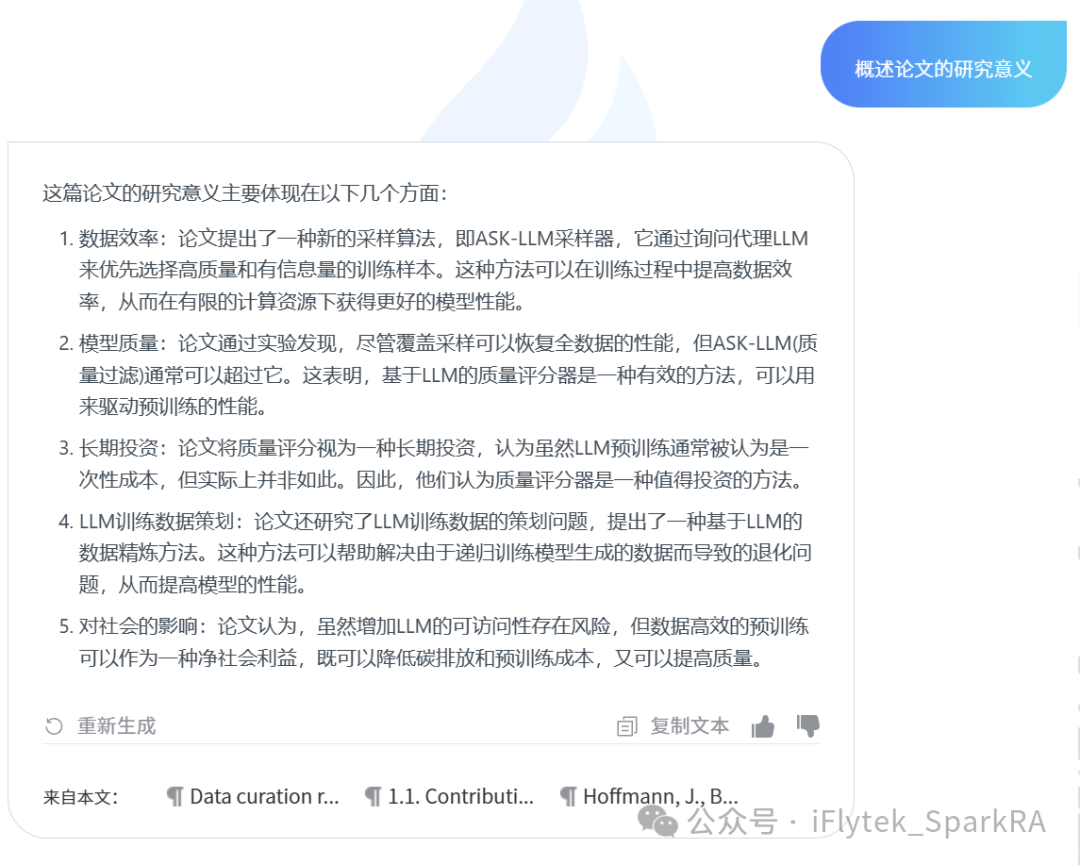
Q4: 概述论文的研究意义

图片

Q5: 简要介绍DENSITY采样器的目标和方法

图片

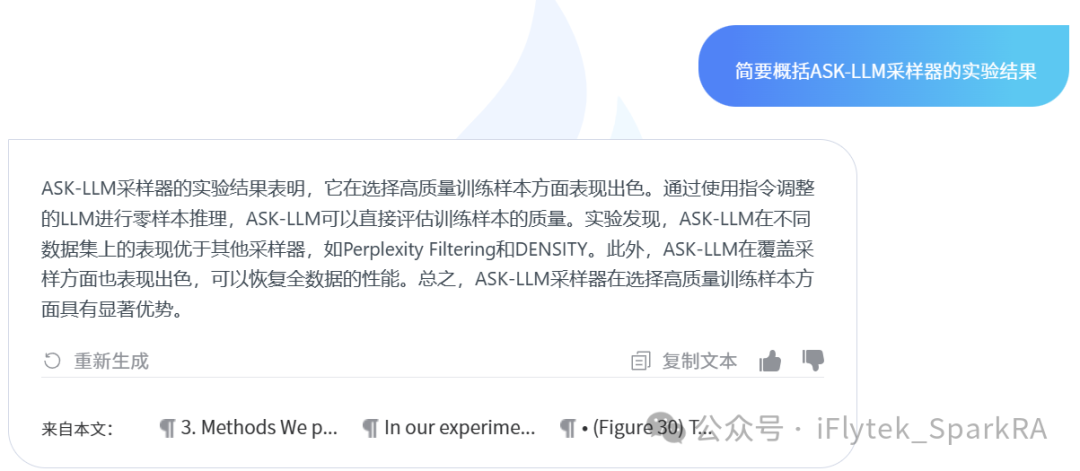
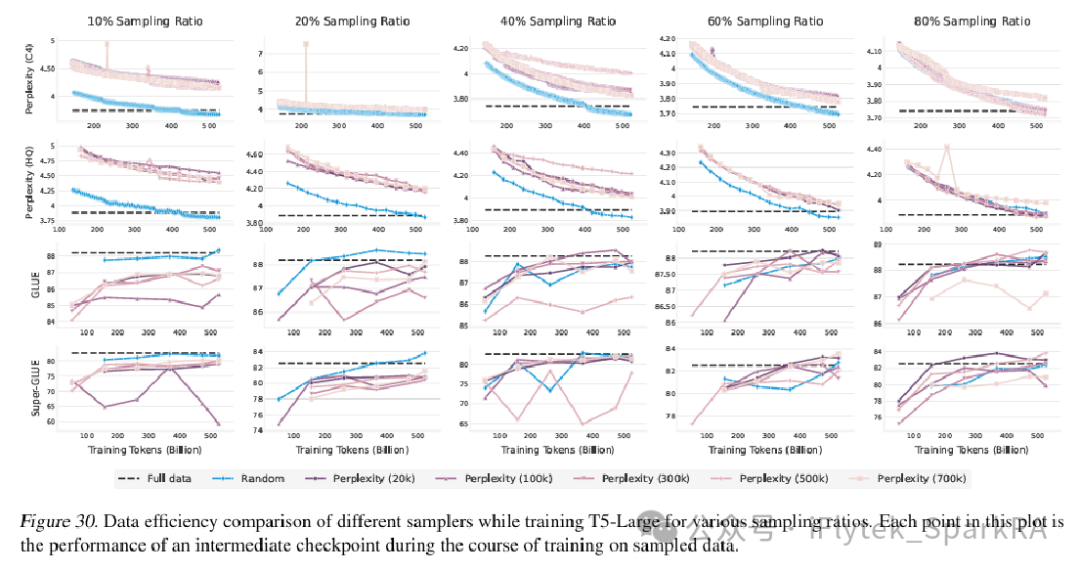
Q6: 简要概括ASK-LLM采样器的实验结果

图片

图片

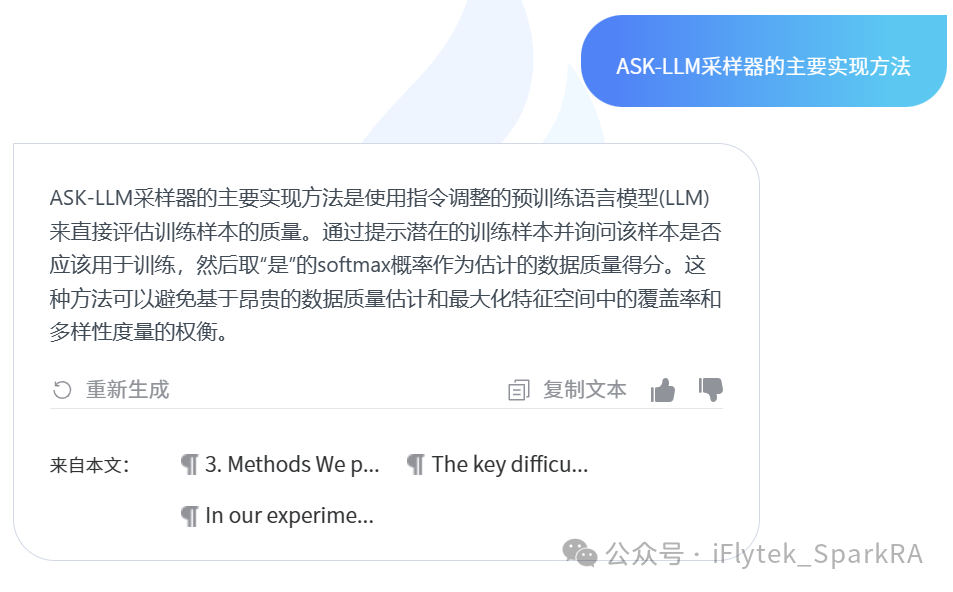
Q7: ASK-LLM采样器的主要实现方

图片

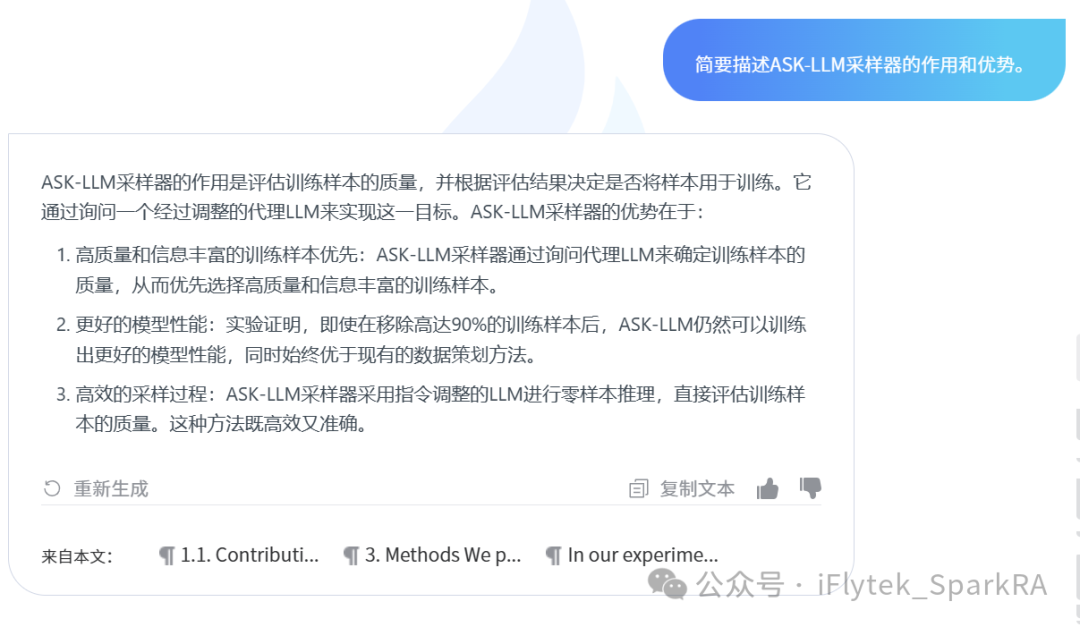
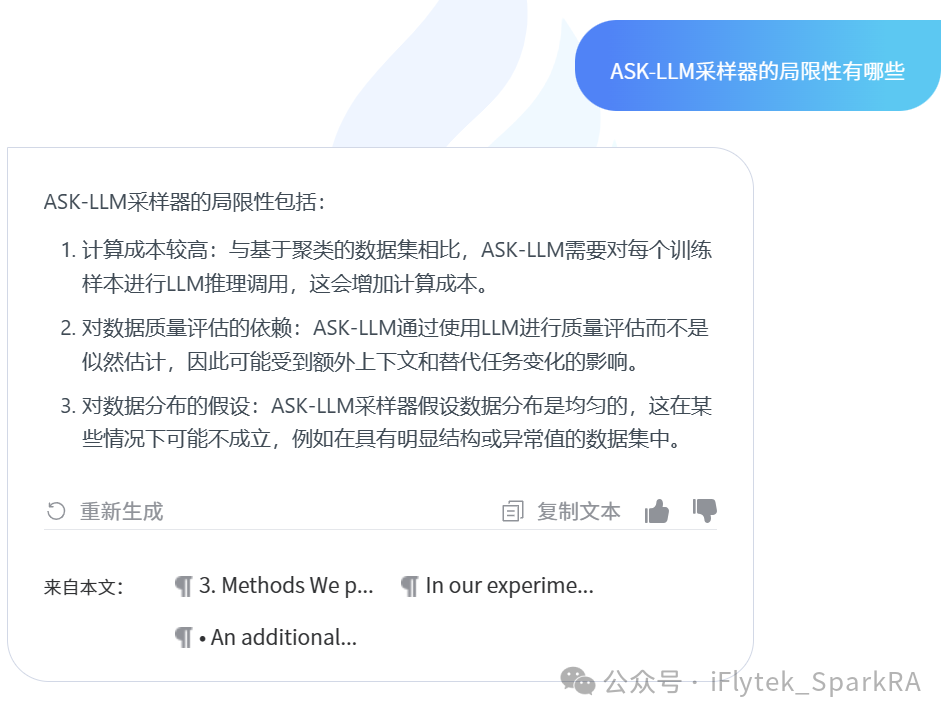
Q8:ASK-LLM采样器的局限性有哪些

图片

总结

基于以上的研读,我们可以了解到本文主要研究了不同采样器在自然语言处理任务中的表现。通过对比分析,作者发现采样器的质量得分分布、数据量与模型质量的关系与重复标记的质量以及数据效率等方面存在显著差异。此外,论文还对这些采样器的定性结果进行了深入探讨。总体来说,这些研究为选择合适的采样器提供了有价值的参考,有助于提高自然语言处理任务的性能。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

《AI实战嵌入式Agent +MCP+skill》课时2.5|定时器实战 本课讲解定时器时基单元原理,通过PSC、ARR、CNT三寄存器配合实现精确周期控制。以84MHz时钟为例,计算得PSC=8399、ARR=9999可实现1秒溢出周期。采用HAL_TIM_Base_Start_IT启动定时器更新中断,在HAL_TIM_PeriodElapsedCallback中处理周期任务,实现非阻塞、高精度的定时。相比HAL_Delay的阻塞式延时,定时器中断方案不占用主循环,支持并发操作,是嵌入式系统中实现周期任务的高效方式。 阅读详情

相关推荐

嵌入式电机控制实战:手把手教你实现I/F强拖启动(附仿真代码)

本文详细介绍了嵌入式电机控制中的I/F强拖启动技术,通过参数配置、代码实现和仿真验证的完整流程,帮助开发者掌握永磁同步电机(PMSM)的高效启动方法。文章包含硬件平台搭建、参数整定黄金法则及MATLAB/Simulink仿真验证,适合工业自动化和智能设备领域的工程师参考。

rust6ferris的博客 910

AI推介-大语言模型LLMs论文速览(arXiv方向):2024.02.10-2024.02.15

近年来,大型语言模型(LLMs)展现出了非凡的多功能性,为医疗保健和医学等专业领域提供了潜在的应用。尽管有各种针对健康领域的开源 LLM,但将通用 LLM 应用于医疗领域仍面临巨大挑战。在本文中,我们介绍了 BioMistral,这是一款专为生物医学领域定制的开源 LLM,采用 Mistral 作为基础模型,并在 PubMed Central 上进行了进一步的预训练。我们对 BioMistral 进行了全面评估,评估基准包括 10 个已确立的英语医学问题解答(QA)任务。

小小帅 2161

SVPWM原理与MCU/FPGA实现:从数学推导到工程实战

空间矢量调制(SVPWM)是实现高性能电机驱动控制的核心算法之一,其通过六个基本电压矢量与零矢量的伏秒平衡,在一个PWM周期内合成任意方向的旋转电压圆,相比传统SPWM可提升约15%的直流电压利用率。该技术不仅涉及扇区判断、作用时间计算、过调制限幅等数学原理,还在MCU与FPGA两种硬件平台上有不同的工程实现路径,包括中心对齐PWM配置、死区插入、定点数流水线设计等。在电动工具、无人机、机器人及车载执行器等电池供电场景中,SVPWM直接决定续航与扭矩表现。本文从数学原理出发,详细拆解MCU和FPGA实现细节

weixin_34265814的博客 300

大语言模型(LLMs)综述调研

架构选择使用LM目标进行预训练时,casual decoder架构可以实现出色的零样本和少样本泛化能力,并表现出优于其他架构的零样本性能。此外,指令调整和对齐调整已经被证明可以进一步增强大型casual decoder模型的能力。根据scaling law,选择更大模型与更大的数据集能获得更好的表现能力LLMs支持长文本上下文建模,主要原因可归结于以下两点: LLM编码较长文本的能力。一些位置嵌入方法(如RoPE、T5 bias)已经被验证具有一定的Extrapolation capability。

qq_44579371的博客 1436

新手必看:SMIC 0.18um PDK安装保姆级教程(附Cadence IC617环境配置)

本文提供SMIC 0.18um PDK在Cadence IC617环境下的详细安装教程,涵盖环境准备、文件解压、安装脚本运行、环境变量配置及Cadence集成验证等关键步骤,特别针对初学者常见问题提供解决方案,助力快速掌握芯片设计工具配置。

weixin_30522183的博客 488

【openGauss实战1】openGauss基于CentOS8的部署

基于openGauss数据库在CentOS8上的安装实践。

IT邦德 3048

合成数据用于AI训练的艺术与科学

作者:Nathan Cooper链接:https://www.answer.ai/posts/2024-10-15-how-to-synthesize-data.html引言合成数据已经成为大规模语言模型(LLM)领域中的重要话题。Meta最近在Llama 3模型的训练中使用LLM生成数据,突显了这一趋势。本文分享了我在生成合成数据方面的实验经验,同时介绍了我们新推出的库——fastdata,旨在...

zenRRan的博客 1279

STM32串口控制LED灯的亮灭

STM32中的串口控制LED灯的亮灭,分为两种方式,一种是直接发送数字0和1来控制灯的亮灭,另一种是通过发送字符串来控制。 我所使用的开发板主控芯片是STM32F401RET6,主频84MHz, 首先要进行串口的初始化: /* 函数功能:串口的初始化 函数名:Usart_Init 返回值:无 参数:u32 brr 备注: USART1_TXD->PA9 USART1_RXD->PA10 */ void Usart_Init(u32 brr) { float div; u16 div

博客 2万+

6 款电商 AI 图片生成软件实测|国内 + 跨境卖家工具清单

电商 AI 作图工具已经从 "能不能用" 进入了 "好不好用" 的阶段。对于绝大多数卖家而言,现在的 AI 工具已经可以覆盖 60%-80% 的基础商品图需求,显著降低拍摄和设计成本。选择工具的核心逻辑不是 "哪款最强",而是 "哪款最适配你的品类、平台规模和团队能力"。垂直电商工具胜在工作流效率,通用生图工具强在创意上限,模板类工具赢在上手速度。建议根据自身业务阶段,搭配 1-2 款主力工具 + 1 款辅助工具,形成适合自己的视觉生产流程。

Mardi_Ladin的博客 281

【图像去噪】论文复现:Mamba没Out!MaIR的Pytorch源码复现,跑通全流程,轻松解决环境配置问题,图文结合,明确MaIR创新点,与MambaIR对比,示意图与源码对应,清晰易懂,注释详细!

论文题目:MaIR: A Locality- and Continuity-Preserving Mamba for Image Restoration —— MaIR:用于图像恢复的局部性和连续性保持 Mamba【图像去噪】论文精读:MaIR: A Locality- and Continuity-Preserving Mamba for Image Restoration【图像去噪】论文复现:Man!

主要更新底层视觉(去噪、超分等)相关的科研内容,形式为【论文精读】+【论文复现】 1112

深度强化学习在机器人控制中的应用

非常感谢您提供如此详细的任务要求和约束条件。作为一位世界级的人工智能专家和计算机领域大师,我将全身心投入到这篇技术博客的撰写中。 深度强化学习在机器人控制中的应用 1. 背景介绍 近年来,随着人工智能技术的飞速发展,深度学习和强化学习在各个领域都得到了广泛应用,尤其是在机器人

AI天才研究院 1323

我用 GPUWorks 在 M1 Pro 上搭了个发票识别原型

公司里经常要看电子发票。我想先做个小原型:把 PDF 发给一个自己部署的图文模型,让它提取发票类型、日期、交易双方和金额,再把结果交给同事核对。这个原型不用先接财务系统,先看看从部署到调用要走多少步,模型返回的内容能不能帮上忙。

鸽芷咕的博客 1万+

30天入门 SAP BTP 开发系列之八:动手在 SAP BTP 上开发第一个 ABAP 透明表

ABAP Cloud 环境下创建透明表的方法与数据迁移实践 本文介绍了在 SAP BTP ABAP 环境中创建透明表并迁移数据的完整流程。与传统的 SE11 事务码不同,ABAP Cloud 需通过 ABAP Development Tool 创建数据库表,使用代码定义表结构。作者详细演示了如何: 在开发包中创建名为 Z优快云_TRAVEL 的透明表 使用 ABAP 代码定义表字段和约束 通过 ABAP 类实现数据从标准表/DMO/TRAVEL 到新建表的迁移 验证数据迁移结果 文中还提供了相关技术概念的

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1779

您您这可以把问小白的多个会话比如说。左侧的多个会话一次性导出吗?不是单条会话里面的多次会对话。AI导出鸭

第三层是格式编译层。这个决策背后的判断很清晰:一个批量导出工具的价值,不在于“试三次”,而在于你真正用它处理了几十份技术文档、访谈记录或课程讲义之后,它是否值得留在你的工作流里。问小白的会话列表通过分页接口加载,AI导出鸭 在页面运行时建立旁路监听,捕获每一次分页请求返回的完整对话清单,包括会话 ID、标题、时间戳和隐藏的元数据字段。让AI导出回归优雅——这句话说的是:导出不该是体力活,而应该是一次完整的、可预期的文件交付。注意:这里的“批量”指的是左侧列表里的多个独立会话,不是一条会话内的多轮对话。

laoyunsi的博客 220

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

医疗 AI 有两种,别混着谈:一个改流程,一个改范式

InfoXMed 是面向医生、医学生和医学科研人员的 AI 医学工具平台,提供文献检索、全文翻译、AI 解读、指南查询和题库练习等功能,辅助临床学习、科研汇报与医学备考。原文是日本医学会杂志(JMA Journal)的一篇综述(Review Article):基本事实:这一点必须先说清:这篇论文提出的是一个研究纲领。它文中的"预测"指的是科学设想,不是可以拿来用的临床预测能力。文中甚至自己承认了一个硬缺口(见第三节)。本文只谈它的术语辨析与科学方法论,不转述任何可作为临床依据的预测或处置主张。这篇论文的全部

2601_96948740的博客 196

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

在Codex 让AI模型 拥有长期智能记忆

本文介绍Claude-Mem V15新功能——智能记忆召回,解决AI遗忘、重复提示、执行不一致等问题。通过本地部署claude-mem,实现自动记录决策(如数据库选型)、跨会话智能召回,支持记忆写入、检索、遗忘全流程闭环。相比传统记忆方案,其基于Hooks自动捕获工具调用,结构化存储,可追溯、可共享、可清理,显著提升工程效率与协作一致性,是长期项目中理想的“工作黑匣子”与“工程脑”。

米莱虾 253

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

河道漂浮物目标检测数据集

目标检测,yolo,河道漂浮物目标检测数据集

DL_data_set的博客 176

AI 应用开发工程师技术实践:大模型接入、通用组件封装与性能优化

本文提出AI应用从PoC到生产的核心挑战:模型调用的持续可用、可控与可优化。通过构建统一LLM网关实现多供应商路由与故障转移,封装对话、工具调用与RAG组件以解耦业务逻辑,结合前缀缓存、批处理与流式背压治理等性能优化手段,形成“接通→接稳→接快”的工程路径,最终以工程化能力决定AI应用的生产可用性。

2301_79189962的博客 518

大模型 Embedding 与向量相似度详解

Embedding 解决的问题:计算机不懂文字,但懂数字│▼文本 → 向量(1024维浮点数数组)│▼相似度解决的问题:怎么判断两个向量(文本)有多接近│▼余弦相似度:看向量方向的夹角,越接近0°越相似│▼最终效果:语义搜索——理解意思,而非字面匹配一句话总结:Embedding 把文字变成数字,余弦相似度比较数字的方向,两者结合实现了"理解语义"的搜索。

T3165919332的博客 65

AI前沿日报 · 2026-11-04 | 祛魅时刻:Astra“纯读权重“神话的崩塌

①Astra"裸权重通吃"被spaCy创始人Honnibal精准祛魅——仅1/3实验真裸读,数学能力提升依赖Python+50次迭代;②Simon Willison用Qwen 3.8-27B端侧复现权重空间编程;③Nvidia开源Auto-Ontology自动知识图谱;④$800开源全域抓取机器人Stringman;⑤OpenAI悄然重开Codex训练开关引信任危机;⑥DeepMind发布Gemini 4 Argon机器人基础模型;⑦美国科技巨头隐性AI债务达3.2万亿美元,6个月增90%。

johnsong2009的博客 501

GPT-1 架构和计算细节

下面配合框图,对 GPT-1 的每个组件做公式展开 + 数值实例(配置:12 层 × 768,12 头,FFN 3072,词表 40478,共 117M 参数)。GPT-1 把翻译模型的编码器-解码器砍掉一半,只留解码器,然后以"预测下一个词"为目标在 BooksCorpus 上预训练。与 2017 原版的四个架构差异(框图中标 ★):h0=E[token]+Epos[position],E∈R40478×768, Epos∈R512×768h^0 = E[\text{token}] + E_{pos}[\

eloudy的专栏 228

终端 AI 审计与 “龙虾” 类智能体风险治理:从可见性到闭环溯源

生成式 AI 办公普及之后,数据泄露风险逐步下沉到终端。员工将合同、源代码、客户资料粘贴至公有大模型,以及龙虾(OpenClaw)这类本地开源 AI 智能体的滥用,成为企业安全新挑战。传统网络边界防护存在审计盲区,本文从风险链路拆解、核心能力模型、分级治理策略、落地踩坑点以及技术局限性多角度,分享终端侧 AI 安全治理的实践思路。

2401_86491085的博客 604

2.53 基于极稀疏指纹的室内定位注意力图元学习

该论文发表于IEEE Transactions on Mobile Computing(TMC)2026年6月,面向极稀疏指纹条件下的WiFi室内定位,针对指纹采集人力成本高、标记指纹稀缺时定位精度大幅下降的痛点,提出注意力图元学习模型AGML(Attentional Graph Meta‑Learning),结合图神经网络、元学习、两种指纹数据增强与分布对齐技术,在标记指纹极少的场景实现高精度室内定位,同时公开了多套真实+仿真定位数据集用于基准测试。场景:二维室内空间,障碍物造成信号遮挡,

weixin_42963026的博客 315

语音识别与语音合成的技术原理及应用

语音识别 #语音合成 #人工智能 #大模型。语音识别与语音合成的技术原理及应用。一、语音识别的核心原理。二、语音合成的核心原理。三、工程落地的主要难点。五、需要关注的现实问题。

weixin_62919816的博客 174

视觉推理是在看图,还是依赖语言先验猜答案?

问一张香蕉照片“它是什么颜色”,回答黄色可能来自看图,也可能来自常识。把香蕉换成红色,错误才显露出来;但答错仍可能是没看清颜色、没理解问题,或没有把看到的属性用于回答。**总正确率不能独自区分这些解释。**封面中的红色香蕉只是概念插画,不是论文测试样本。

weixin_44369324的博客 139

设计师工作室 GEO 实操:如何提升 AI 实体推荐概率

设计工作室 GEO 的本质,是把创意服务转化为 AI 可理解的结构化信息。核心动作可归纳为:区分事实与审美、建立实体图谱、预判用户提问、输出脱敏内容、搭建多信源、持续测试验证。梳理工作室的 6 个实体属性:品类、城市、流程、边界、团队、渠道。在官网或作品集平台发布至少 3 篇结构化项目复盘,只陈述事实。输出 1 篇「设计报价影响因素」科普内容,覆盖甲方高频提问。争取 1 次行业媒体或本地媒体专访,形成第三方信源。每周用「XX 城市 + 品类 + 设计工作室推荐」指令测试,记录出现频率。

goujunwe的博客 305
上一篇: Transformer直接预测完整数学表达式,推理速度提高多个数量级
下一篇: 透彻!驯服大型语言模型(LLMs)的五种方法,及具体方法选择思路
AI程序猿人
博客等级 码龄3年 6517粉丝 561原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值