Transformer直接预测完整数学表达式,推理速度提高多个数量级

Transformer长期时序预测 transformer主要对输入特征进行编码、解码等,在这里原理并不过多的介绍,我们通过实例来完成transformer在时间序列上的预测应用。transformer预测的结果并不是单一的值,而是一个集合,预测出在该时间序列的可能值,然后再根据具体的业务需求完成最后的值,下图展示了结果中的某一样本的预测值。我们使用的是某一零件的耗用量,预测未来半年的该零件的耗用情况,时间维度是月,数据的示意图如下图所示。如上图所示,蓝色部分为训练数据,红色为测试部分。紧接着搭建训练样本、测试样本以及验证样本的数据加载器。 阅读详情

符号回归,即根据观察函数值来预测函数数学表达式的任务,通常涉及两步过程:预测表达式的「主干」并选择数值常数,然后通过优化非凸损失函数来拟合常数。其中用到的方法主要是遗传编程,通过多次迭代子程序实现算法进化。神经网络最近曾在一次尝试中预测出正确的表达式主干,但仍然没有那么强大。

在近期的一项研究中,来自 Meta AI(Facebook)、法国索邦大学、巴黎高师的研究者提出了一种 E2E 模型,尝试一步完成预测,让 Transformer 直接预测完整的数学表达式,包括其中的常数。随后通过将预测常数作为已知初始化提供给非凸优化器来更新预测常数。
图片

论文地址:https://arxiv.org/abs/2204.10532

该研究进行消融实验以表明这种端到端方法产生了更好的结果,有时甚至不需要更新步骤。研究者针对 SRBench 基准测试中的问题评估了该模型,并表明该模型接近 SOTA 遗传编程的性能,推理速度提高了几个数量级。

方法

Embedder

该模型提供了 N 个输入点 (x, y) ∈ R^(D+1),每个输入点被表征为 d_emb 维度的 3(D + 1) 个 token。随着 D 和 N 变大,这会导致输入序列很长(例如,D = 10 和 N = 200 时有 6600 个 token),这对 Transformer 的二次复杂度提出了挑战。

为了缓解这种情况,该研究提出了一个嵌入器( embedder )来将每个输入点映射成单一嵌入。嵌入器将空输入维度填充(pad)到 D_max,然后将 3(D_max+1)d_emb 维向量馈入具有 ReLU 激活的 2 层全连接前馈网络 (FFN) 中,该网络向下投影到 d_emb 维度,得到的 d_emb 维的 N 个嵌入被馈送到 Transformer。

该研究使用一个序列到序列的 Transformer 架构,它有 16 个 attention head,嵌入维度为 512,总共包含 86M 个参数。像《 ‘Linear algebra with transformers 》研究中一样,研究者观察到解决这个问题的最佳架构是不对称的,解码器更深:在编码器中使用 4 层,在解码器中使用 16 层。该任务的一个显著特性是 N 个输入点的排列不变性。为了解释这种不变性,研究者从编码器中删除了位置嵌入。

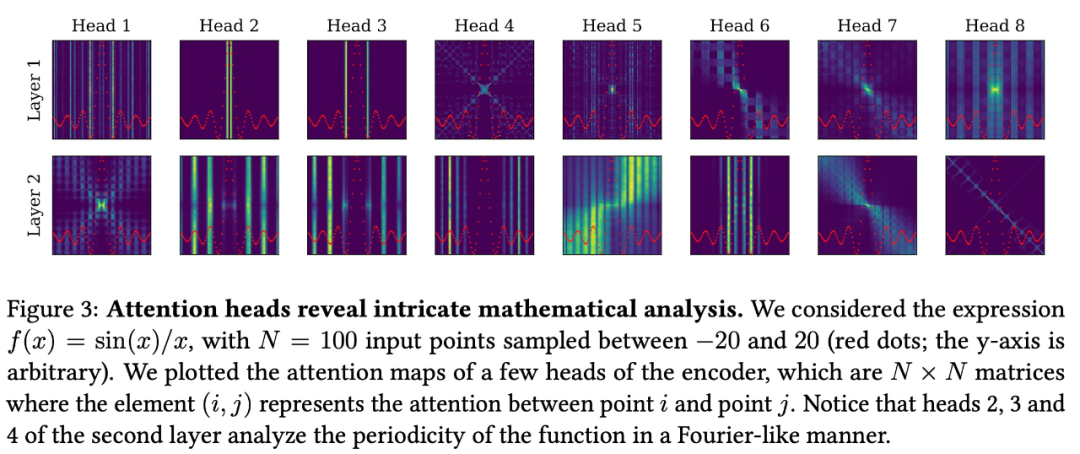
如下图 3 所示,编码器捕获所考虑函数的最显著特征,例如临界点和周期性,并将专注于局部细节的短程 head 与捕获函数全局的长程 head 混合在一起。
图片

训练

该研究使用 Adam 优化器优化交叉熵损失,在前 10000 步中将学习率从 10^(-7) 提升到 2.10^(-4),然后按照论文《 Attention is all you need 》中的方法将其衰减为步数的平方根倒数(inverse square root)。该研究提供了包含来自同一生成器的 10^4 个样本的验证集,并训练模型,直到验证集的准确率达到饱和(大约 50 个 epoch 的 3M 个样本)。

输入序列长度随点数 N 显著变化;为了避免浪费填充,该研究将相似长度的样本一起批处理,确保一个完整的批处理包含至少 10000 个 token。

实验结果

该研究不仅评估了域内准确性,也展示了在域外数据集上的结果。

域内性能

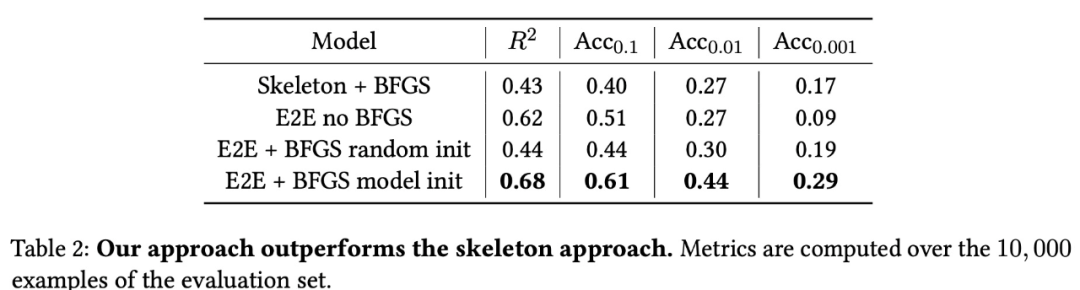
表 2 给出了该模型的平均域内结果。如果不进行修正,E2E 模型在低精度预测(R^2 和 Acc_0.1 指标)方面优于在相同协议下训练的 skeleton 模型,但常数预测中存在的错误会导致在高精度(Acc_0.001)下的性能较低。
图片

修正之后的程序显著缓解了这个问题,让 Acc_0.001 提升了三倍,同时其他指标也有所改进。
图片

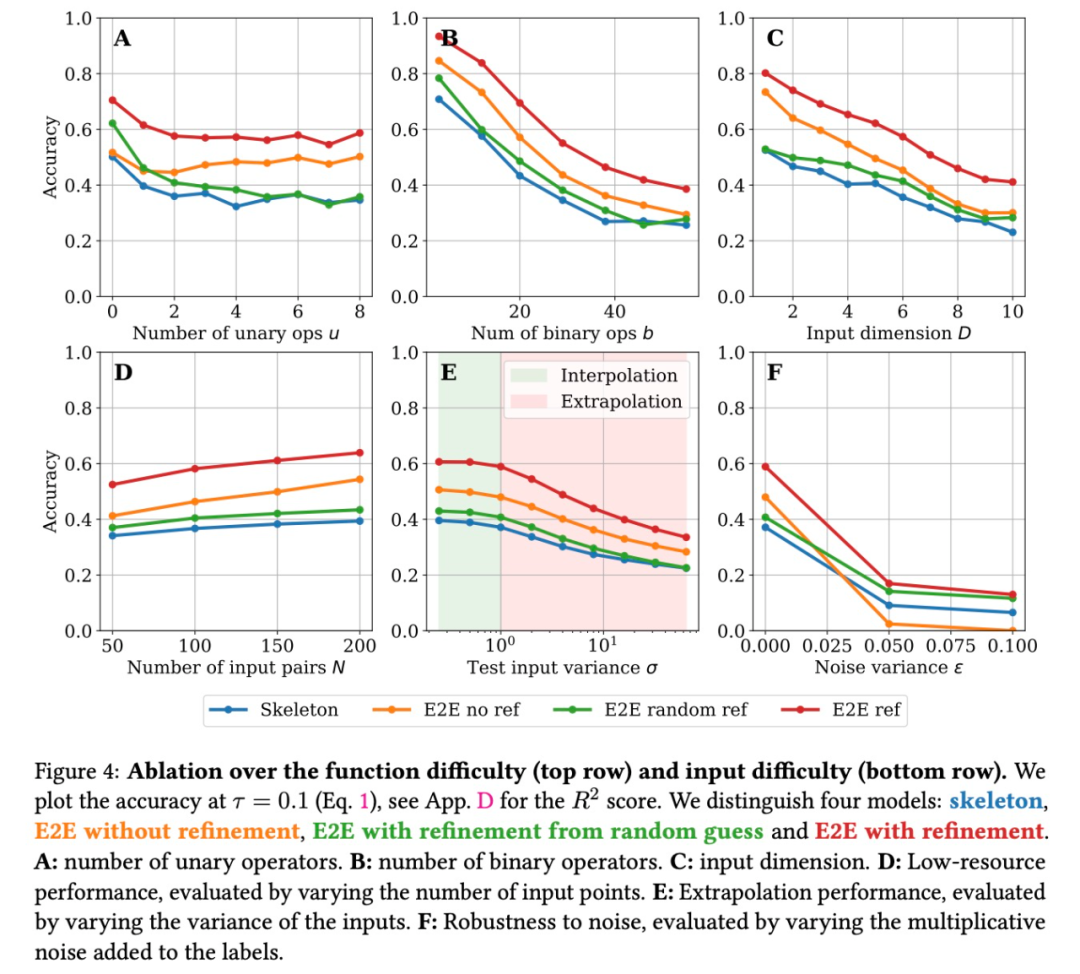
图 4A、B、C 给出了 3 个公式难度指标的消融实验结果(从左到右):一元算子的数量、二元算子的数量和输入维数。正如人们所预料的那样,在所有情况下,增加难度系数会降低性能。这可能会让人认为该模型在输入维度上不能很好地扩展,但实验表明,与并发方法相比,该模型在域外数据集上的扩展性能非常好,如下图所示。
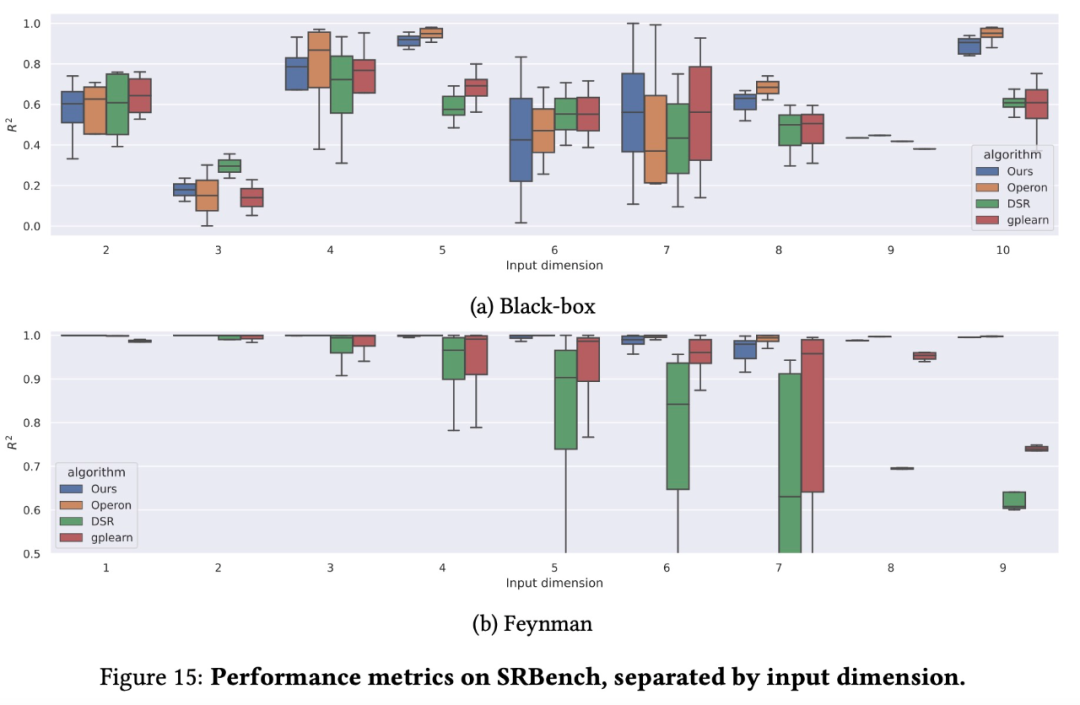
图片

图 4D 显示了性能与输入模型的点数 N 之间的关系。在所有情况下,性能都会提高,但 E2E 模型比 skeleton 模型更显著,这证明大量数据对于准确预测表达式中的常数是非常重要的。

外推和稳健性。如图 4E 所示,该研究通过改变测试点的规模来检查模型内插 / 外推的能力:该研究没有将测试点归一化为单位方差,而是将它们归一化为 σ。随着 σ 的增加,性能会下降,但是即使远离输入(σ = 32),外推性能仍然不错。

最后,如图 4F 所示,研究者检查了使用方差 σ 的乘性噪声(multiplicative noise)对目标 y 的影响:y → y(1 + ξ), ξ ∼ N (0, ε)。这个结果揭示了一些有趣的事情:如果不进行修正,E2E 模型对噪声的稳健性不强,实际上在高噪声下性能比 skeleton 模型差。这显示了 Transformer 在预测常数时对输入的敏感程度。修正之后 E2E 模型的稳健性显著提高,但将常数初始化为估计值的影响较小,因为常数的预测被噪声破坏了。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
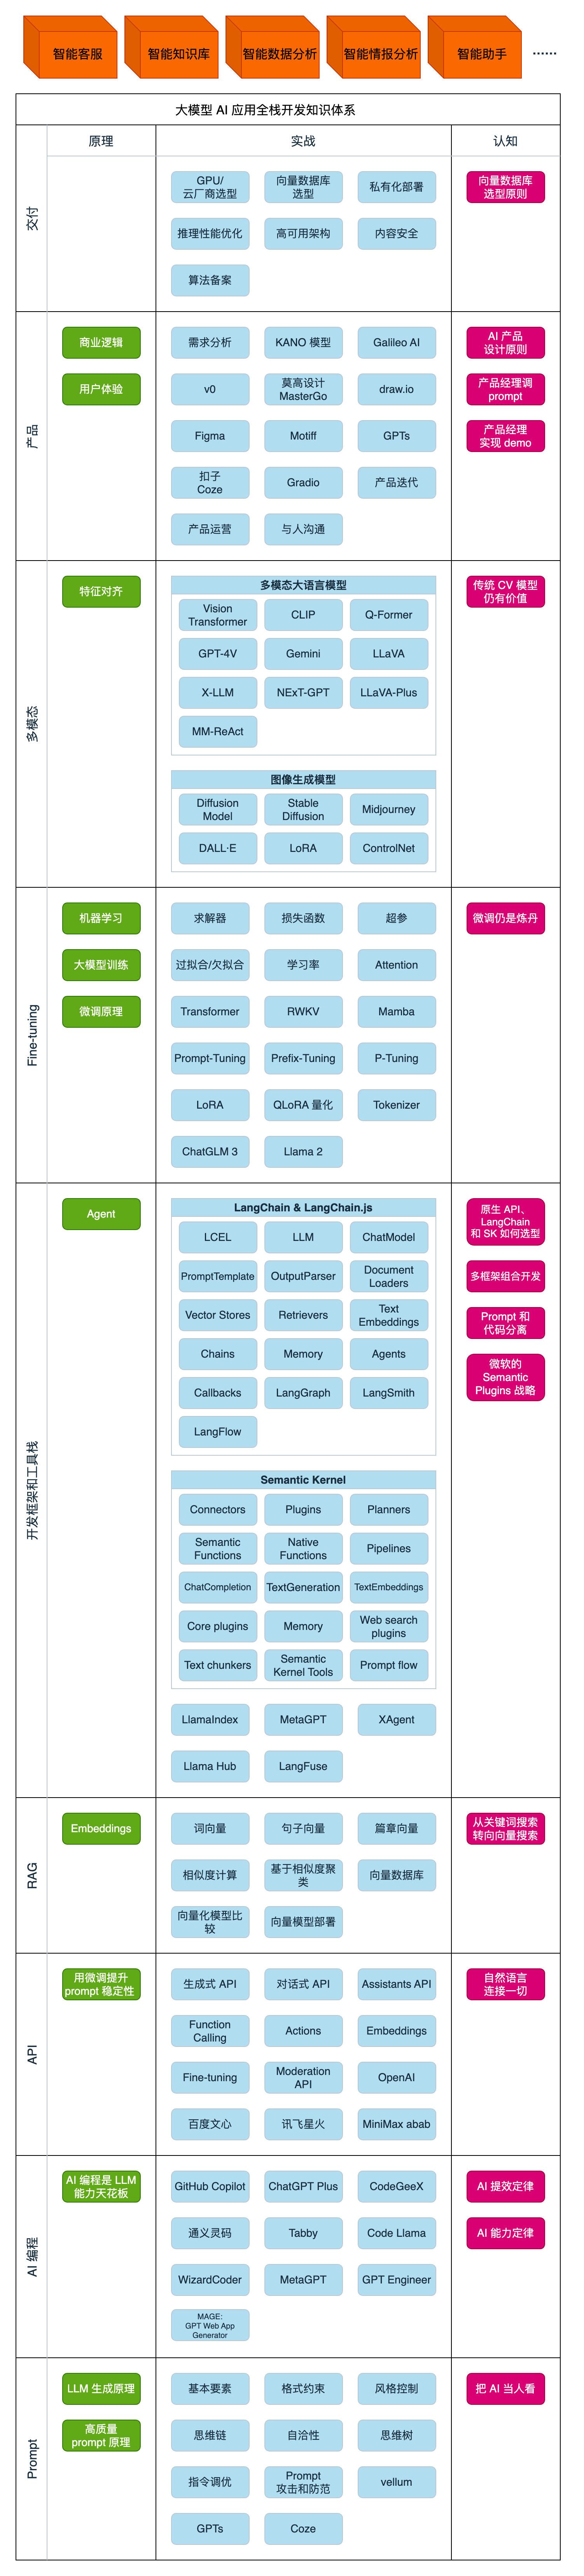
在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
【python量化】将Transformer模型用于股票价格预测 前言 下面的这篇文章主要教大家如何搭建一个基于Transformer的简单预测模型,并将其用于股票价格预测当中。原代码在文末进行获取。 1、Transformer模型 Transformer 是 Google 的团队在 2017 年提出的一种 NLP 经典模型,现在比较火热的 Bert 也是基于 Transformer。Transformer 模型使用了 Self-Attention 机制,不采用 RNN 的顺序结构,使得模型可以并行化训练,而且能够拥有全局信息。这篇文章的目的主要是将带大家通过Pytor 阅读详情

相关推荐

每日算法讲解(一):基于Transformer的时间序列预测

Transformer模型最初由Vaswani等人在2017年的论文《Attention is All You Need》中提出。与传统的RNN模型不同,Transformer模型完全基于注意力机制(Attention Mechanism),可以并行处理数据,具有更高的效率和更强的长程依赖捕捉能力。Transformer模型由编码器(Encoder)和解码器(Decoder)组成。编码器负责将输入序列编码为隐藏表示,解码器根据这些隐藏表示生成输出序列。在时间序列预测中,我们通常只使用编码器部分。

rhtee的博客 4717

学习笔记:基于Transformer的时间序列预测模型

基于Transformer的时间序列预测

xxt228的博客 3万+

符号回归技术:从遗传编程到LLM融合的数学表达式发现

符号回归是一种通过算法自动发现数据背后数学表达式的机器学习技术,其核心价值在于同时实现高精度预测和可解释模型构建。该技术通过遗传编程、深度学习和强化学习等方法,在数学表达式空间中进行智能搜索。其中,遗传编程采用进化算法迭代优化表达式,而深度学习方法如E2E和NeSymReS利用Transformer架构实现端到端训练。最新进展显示,结合大语言模型(LLM)的符号回归框架(如LLM-SR)能显著提升方程发现效率,在材料科学、物理建模等领域展现出强大应用潜力。实践表明,符号回归特别适合解决需要明确数学表达的科学

weixin_30345577的博客 397

NLP实战9:Transformer实战-单词预测

cuda# 定义编码器层# 定义编码器,pytorch将Transformer编码器进行了打包,这里直接调用即可# 初始化权重"""Arguments:src : Tensor, 形状为 [seq_len, batch_size]src_mask: Tensor, 形状为 [seq_len, seq_len]Returns:输出的 Tensor, 形状为 [seq_len, batch_size, ntoken]"""# 生成位置编码的位置张量# 计算位置编码的除数项。

m0_62237233的博客 5291

YOLO与Transformer核心原理及工程实践:从代码实现到生产部署

目标检测和序列建模是计算机视觉与自然语言处理的基础技术。目标检测通过定位和识别图像中的物体,为自动驾驶、安防监控等应用提供核心能力;序列建模则利用自注意力机制处理文本、语音等序列数据。YOLO模型采用端到端的回归方法实现高效实时检测,其网格划分和边界框预测机制显著提升了推理速度。Transformer架构通过多头自注意力机制捕获长距离依赖关系,解决了传统RNN的梯度消失问题。在工程实践中,YOLOv8的anchor-free设计和Transformer的编码器-解码器结构为模型部署提供了优化基础。通过PyT

weixin_33046983的博客 264

基于Transformer的车道线检测:LSTR模型实战解析

本文深入解析了基于Transformer的端到端车道线检测模型LSTR。该模型摒弃了传统的像素级分割与后处理流程,通过直接预测车道线的参数化曲线方程,实现了高效、鲁棒的检测。文章详细阐述了其架构原理,包括轻量化Backbone、Transformer编码器-解码器及匈牙利损失,并提供了从环境搭建、数据准备到模型训练与部署的完整实战指南,助力开发者在自动驾驶等场景中应用。

weixin_29062671的博客 379

【深度学习】Transformer直接预测完整数学表达式,推理速度提高多个数量级

机器之心报道机器之心编辑部来自 Mata AI、法国索邦大学、巴黎高师的研究者成功让 Transformer 直接预测出完整的数学表达式。符号回归,即根据观察函数值来预测函数数学表达式的任务,通常涉及两步过程:预测表达式的「主干」并选择数值常数,然后通过优化非凸损失函数来拟合常数。其中用到的方法主要是遗传编程,通过多次迭代子程序实现算法进化。神经网络最近曾在一次尝试中预测...

fengdu78的博客 927

全桥LLC谐振变换器变频控制工作原理与仿真

全桥LLC谐振变换器以其效率高、全范围软开关、器件电应力小等优点,越来越多地应用于大功率场合。电力电子技术的发展日益追求高频化,所带来的问题是半导体开关器件高频运行时的开关损耗急剧增加。各种软开关电路随之出现。可以有效减小开关损耗,使进一步提高开关频率成为可能。谐振式开关因其可在电流自然过零点开通半导体器件,实现零电压开关,特别适合采用MOSFET作开关的装置。最简单的谐振电路有串联谐振(SRC)和并联谐振(PRC)。SRC只能工作于降压状态,应用受限;

晞子的技术札记 3060

NeurIPS|基于Transformer的端到端符号回归方法

这是一项具有挑战性的任务,通常需要通过两步流程完成:首先预测表达式的“骨架”(即不包含具体数值常数的结构),随后通过优化一个非凸损失函数来拟合其中的常数参数。ill-posed problem),难以提供充分的监督信息:同一骨架的不同实例可能具有截然不同的函数形状,而结构完全不同的骨架在函数空间中却可能非常接近。骨架决定了表达式的大体形式,但尚未确定具体的数值常数,例如。后一类方法虽然放宽了对潜在规律的假设,但其得到的模型通常较难解释,并且在小规模实验数据上容易发生过拟合,从而导致较差的外推性能。

zuiyishihefang的博客 384

UART中断接收的实战陷阱:HAL库常见误区与性能调优指南

本文深入解析STM32 HAL库UART中断接收机制,揭示常见实战陷阱如数据溢出、中断优先级配置不当等,并提供性能调优方案。重点介绍如何使用空闲中断处理不定长数据、DMA与中断混合模式优化,以及工业级错误恢复与流量控制策略,帮助开发者构建稳定可靠的串口通信系统。

pea55的博客 746

lumerical-环形谐振器

利用mode求解器优化得到所需的环的总长度,即环形器的半径,然后通过varFDTD得到光场分布和透过率.

m0_61776728的博客 2188

【论文+代码】基于transformer的端到端符号回归算法

✅作者简介:双一流博士,人工智能领域学习者,深耕机器学习,交叉学科实践者。已发表SCI1/区top论文10+,发明专利10+。可提供论文服务,代码复现,专利思路和指导,提供科研小工具,分享科研经验,欢迎交流!📌个人主页: https://blog.youkuaiyun.com/allein_STR?📞联系博主:博文留言+主页底部联系方式+WeChat: Allein_STR📙本文内容:【基于transformer的端到端符号回归算法】

allein_STR的博客 2809

H5获取手机相机或相册图片两种方式-Android通过webview传递多张照片给H5

H5调用公共获取图片文件方法,在android手机端,H5主要依赖Webview,这边在webview声明并重写该方法onShowFileChooser使用工具类打开相机或相册,可以两种方式安卓原生方式或者利用第三方组件库方式选中图片,返回uri列表给H5H5收到uri照片列表,并且使用前端方式展示创造价值,乐哉分享!

m0_74823947的博客 3095

杜克大学研究揭示:简单模型在时序预测中超越Transformer

杜克大学研究揭示:简单模型在时序预测中超越Transformer

至顶AI实验室 679

波束形成算法:LCMV实现(MATLAB)

阵列信号处理,波束成形,

weixin_43601588的博客 1万+

8位2路选择器设计

8位2路选择器设计

好好学习,天天向上 4286

从各个角度讲透一个强大的算法模型,Transformer !!

摘要:本文深入解析Transformer模型的核心原理与优势。Transformer通过自注意力机制突破传统RNN/LSTM的序列处理局限,实现全局并行信息检索。其核心架构包含编码器-解码器结构、位置编码、多头注意力等模块,具有效率高、建模能力强、适用性广等特点。文章通过时间序列预测任务进行实战演示,详细讲解模型各组件实现细节,包括注意力机制、残差连接、层归一化等关键技术,并提供了完整的训练流程和可视化分析方法。最后总结了Transformer的核心优势在于其全局注意力机制和多头多视角的并行学习能力。

一个不怎么正经的算法工程师的博客~不定期更新一些我所覆盖领域的干货~~~包你满意噢~~ 1113

【数据结构】期末考试复习(考点+例题)

1.线性表定义及其存储实现:顺序表和链接表,优缺点分析(顺序存储可随 机访问,链式存储可灵活利用空间),相关操作的时间复杂度。 2.链表的插入删除操作 3.两种特殊的线性表及其应用:栈、队列 4.栈、队列上的(插入/删除)操作及其特点 5.循环队列满和空的条件 6.能够定义线性表、栈、队列的数据存储结构,能够实现相关操作的算法并 分析时间复杂度(例如插入、删除及其它应用等) 7.理解线性结构的应用( 如根据要求能灵活定义线性表结构,能根据线性表 的插入、删除操作解决实际问题) 二叉树基本概念与性质(高

Molly 的博客 9366

MTP技术解析:大语言模型如何实现多token预测与性能提升

自回归语言模型是自然语言处理的基础技术,其核心原理是通过前文预测下一个词元(token)。传统方法采用逐词预测方式,虽然实现简单,但在训练效率和学习深度上存在局限。多token预测(MTP)技术通过让模型同时预测多个未来词元,改变了这一范式。从技术价值看,MTP迫使模型学习更深层次的语言结构,而不仅仅是表面词序关系,显著提升了模型的语言理解能力。在应用场景上,这项技术特别适合需要长文本理解和生成的任务,如文档摘要、代码生成等。基于Transformer架构的MTP实现需要对输出层进行改造,增加多个预测头来处

weixin_34195142的博客 340

淋巴结病理数字玻片读取与处理代码

Whole-slide images are generally stored in a multi-resolution pyramid structure. 首先安装openslide模块 pip install openslide-python import os.path as osp import openslide from pathlib import Path...

猫头军师兵书 1275

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

MTP多令牌预测:突破自回归生成的文本生成新范式

自回归生成是自然语言处理中的基础技术,模型通过逐个预测令牌来生成文本序列。其核心原理是基于当前上下文预测下一个最可能的令牌,这种串行生成方式虽然简单直观,但在实际应用中面临误差累积和效率瓶颈等挑战。多令牌预测技术通过让模型一次性预测多个未来令牌,不仅提升了生成效率,更重要的是改善了模型的梯度信号和长程依赖建模能力。在代码生成、公式推导等具有强结构性的应用场景中,MTP技术能够显著提升生成质量和连贯性。本文探讨的MTP实现方案展示了如何通过修改模型架构和训练策略,让传统Transformer具备前瞻预测能力,

weixin_30819085的博客 376

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

数学推理模型优化:MHPO框架设计与性能提升

数学推理是人工智能领域的关键挑战,要求模型具备逻辑推导、符号运算和多步推理能力。传统Transformer架构在处理数学表达式时存在符号表示效率低、误差累积等问题。通过引入分层优化架构和动态注意力机制,MHPO框架显著提升了模型性能。该框架包含符号表示层、推理过程层和知识整合层,支持数学专用token嵌入和状态追踪。在MATH数据集测试中,代数正确率提升46%,几何正确率提升64%。这种优化方法不仅适用于数学问题求解,也为复杂逻辑推理任务提供了新的技术思路,特别是在教育科技和自动定理证明等领域具有广泛应用前

weixin_33713707的博客 373

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

基于Transformer的高频风险因子挖掘,实现30%投资回报率提升

本文提出了IRFT,一种利用Transformer直接从高频交易数据挖掘公式型风险因子的端到端方法。该方法通过将风险因子挖掘转化为符号序列生成任务,成功生成包含运算符、特征与常数在内的闭合式数学表达式,并利用BFGS对常数进行精修,提升了对短期市场波动的拟合精度。实证结果显示,该方法不仅在预测性能上显著领先多种基线方法,而且在推断时间和稳定性方面有明显优势。同时,在多市场、多维特征与大规模数据情境下仍保持良好的泛化能力。

m0_59164304的博客 2236

从BERT到ViT:Transformer架构的NLP与CV实战指南

Transformer架构通过自注意力机制实现了序列数据的并行化处理,其核心价值在于突破RNN的顺序计算限制,显著提升长距离依赖建模能力。在自然语言处理领域,以BERT为代表的预训练模型通过掩码语言建模任务,实现了上下文感知的词向量表示;而在计算机视觉领域,ViT创新性地将图像分块编码为token序列,证明Transformer同样适用于非序列数据。这两种技术都依赖于预训练-微调范式,其中模型蒸馏和量化部署是关键工程实践。当前技术演进呈现高效化(如Linformer)、多模态(如CLIP)和专业化(如Cod

weixin_30572613的博客 349
上一篇: 热点王炸模型!准确率高达100%!Transformer+GASF+RP-1D-2D-GRU 小白也能发一区!创新性拉满!
下一篇: SparkRA带你读论文 | 如何训练数据高效的 LLMs
AI程序猿人
博客等级 码龄3年 6517粉丝 561原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值