5个简单好用的本地运行大模型的方法

五个简单好用的本地运行大模型的方法 像ChatGPT、Claude.ai和phind这样的聊天机器人非常有用,但可能并不总是希望的问题或敏感数据由外部应用程序处理。在平台上尤其如此,在这些平台上,你的互动可能会被人类审查,并以其他方式用于帮助训练未来的模型。一种解决方案是下载一个大型语言模型(LLM)并在自己的机器上运行它。这样一来,外部公司就永远无法访问的数据。这也是尝试一些新专业模型的一个快速选择,如Meta最近宣布的Code Llama系列模型,这些模型经过了编码调整,以及Seamless M4T,旨在实现文本到语音和语言翻译。 阅读详情

像ChatGPT、Claude.ai和phind这样的聊天机器人非常有用,但可能并不总是希望的问题或敏感数据由外部应用程序处理。在平台上尤其如此,在这些平台上,你的互动可能会被人类审查,并以其他方式用于帮助训练未来的模型。

一种解决方案是下载一个大型语言模型(LLM)并在自己的机器上运行它。这样一来,外部公司就永远无法访问的数据。这也是尝试一些新专业模型的一个快速选择,如Meta最近宣布的Code Llama系列模型,这些模型经过了编码调整,以及Seamless M4T,旨在实现文本到语音和语言翻译。

运行自己的LLM听起来可能很复杂,但有了正确的工具,它会出奇地容易。而且许多型号的硬件要求并没有想象中那么疯狂。我已经在两个系统上测试了本文中提供的选项:一个是带有英特尔i9处理器、64GB RAM和英伟达GeForce 12GB GPU(可能没有参与运行该软件的大部分工作)的戴尔PC,另一个是只有16GB RAM的M1芯片的Mac。

请注意,可能需要一点研究才能找到一个在的任务中运行良好并在桌面硬件上运行的模型。而且,很少有人能像你习惯的ChatGPT(尤其是GPT-4)或Claude.ai这样的工具那样好。命令行工具LLM的创建者Simon Willison在上个月的一次演示中认为,即使本地模型的响应是错误的,运行它也是值得的:

图片

在你的笔记本电脑上运行的[一些]会产生疯狂的幻觉——我认为这实际上是运行它们的一个很好的理由,因为在你的电脑上运行弱型号是了解这些东西如何工作及其局限性的一种更快的方式。

同样值得注意的是,开源模型可能会不断改进,一些行业观察人士预计,它们与商业领袖之间的差距会缩小。

图片

使用GPT4All运行本地聊天机器人

如果你想要一个在本地运行、不会在其他地方发送数据的聊天机器人,ᅠGPT4Allᅠ提供了一个易于设置的桌面客户端供下载。它包括在自己的系统上运行的型号的选项,还有Windows、macOS和Ubuntu的版本。

当第一次打开GPT4All桌面应用程序时,将看到下载大约10个(截至本文撰写之时)可以在本地运行的模型的选项。其中包括Meta AI的模型Llama-2-7B聊天。如果你有API密钥,你也可以设置OpenAI的GPT-3.5和GPT-4(如果你有访问权限)供非本地使用。

GPT4All接口的模型下载部分一开始有点令人困惑。在我下载了几个模型后,我仍然可以选择全部下载。这表明下载不起作用。然而,当我检查下载路径时,模型就在那里。

图片

GPT4All中模型下载接口的一部分。一旦我打开应用程序的使用部分,我下载的模型就会自动出现。

一旦建立了模型,聊天机器人界面本身就很干净,易于使用。方便的选项包括将聊天复制到剪贴板并生成响应。

图片

GPT4All聊天界面简洁易用

还有一个新的测试版LocalDocs插件,可以让你在本地与自己的文档“聊天”。可以在中启用Settings > Plugins 选项卡,将看到“LocalDocs插件(BETA)设置”标题和在特定文件夹路径创建集合的选项。

该插件正在进行中,并且ᅠ文档ᅠ 警告说,即使LLM可以访问添加的专家信息,它仍可能“产生幻觉”(编造)。尽管如此,这是一个有趣的功能,随着开源模型变得更加强大,它可能会得到改进。

除了聊天机器人应用程序,GPT4All还绑定了Python、Node和命令行界面(CLI)。还有一种服务器模式,可以让你通过一个结构非常像OpenAI的HTTP API与本地LLM交互。目标是通过更改几行代码,让你用本地LLM交换OpenAI的LLM。

图片命令行启动LLM

Simon Willison的LLM是我见过的在自己的机器上本地下载和使用开源LLM的更简单的方法之一。虽然确实需要安装Python来运行它,但不应该接触任何Python代码。如果你在Mac电脑上使用Homebrew,只需使用

brew install llm

如果在Windows计算机上,请使用最喜欢的安装Python库的方式,例如

pip install llm

LLM默认使用OpenAI模型,但可以使用插件在本地运行其他模型。例如,如果安装gpt4all插件,将可以从gpt4all访问其他本地模型。还有用于llama、MLC项目和MPT-30B的插件,以及其他远程模型。

在命令行上安装一个插件,名称为llm Install model:

llm install llm-gpt4all

可以使用命令llm-models-list查看所有可用的型号——远程和已安装的型号,包括每种型号的简要信息。

图片

当要求LLM列出可用型号时显示。

要将查询发送到本地LLM,语法如下:

llm -m the-model-name "Your query"

如何选择正确的模型?可以前往ᅠGPT4All主页ᅠ并向下滚动到与GPT4All兼容的模型的模型资源管理器。falcon-q4_0选项是一款评级较高的相对较小的型号,具有允许商业使用的许可证,所以我从那里开始。

然后,我问了它一个类似于ChatGPT的问题,但没有发出单独的命令下载模型:

llm -m ggml-model-gpt4all-falcon-q4_0 "Tell me a joke about computer programming"

这是LLM用户体验如此优雅的一点:如果本地系统上不存在GPT4All模型,LLM工具会在运行查询之前自动为下载它。下载模型时,将在终端中看到进度条。

图片

LLM自动下载了我在查询中使用的模型

这里有一个笑话:“程序员为什么关掉电脑?因为他想看看它是否还在工作!”——但事实上,这个查询确实起了作用。如果结果令人失望,那是因为模型性能或用户提示不足,而不是LLM工具。

还可以为LLM中的模型设置别名,以便可以使用较短的名称来引用它们:

llm aliases set falcon ggml-model-gpt4all-falcon-q4_0

要查看所有可用的别名,请输入:llm aliases。

这个ᅠMeta的Llama模型的LLM插件ᅠ需要比GPT4All多一点的设置。阅读上的详细信息ᅠLLM插件的GitHub回购。请注意,通用llama-2-7b-chat确实设法在我的工作Mac上运行了M1 Pro芯片,只有16GB的RAM。与为没有GPU的小型机器优化的GPT4All型号相比,它运行得相当慢,在我更健壮的家用电脑上表现更好。

LLM还有其他功能,例如argument标志,使可以从以前的聊天中继续,并能够在Python脚本中使用它。9月初,该应用程序获得了ᅠ用于生成文本嵌入的工具,可用于搜索相关文档的文本含义的数字表示。可以在LLM网站上看到更多信息。Willison是流行的Python Django框架的联合创建者,他希望社区中的其他人能为LLM生态系统贡献更多插件。

图片桌面上调用模型:Ollama

Ollama是一种比LLM更容易下载和运行模型的方法。然而,该项目仅限于macOS和Linux,直到2月中旬,Windows的预览版终于问世。我测试了Mac版本。

图片

通过点击安装是一种优雅的体验。尽管Ollama是一个命令行工具,但只有一个命令具有以下语法ollama run model-name名称。与LLM一样,如果模型还没有在的系统上,它将自动下载。

可以在上查看可用型号的列表ᅠhttps://ollama.ai/library,截至本文撰写之时,它包括基于Llama的模型的几个版本,如通用Llama 2、Code Llama、针对某些编程任务进行微调的DeepSE的CodeUp,以及针对回答医学问题进行微调的meddlama2。

这个ᅠOllama GitHub repo’s README 文件包括一些型号规格的有用列表和建议,“你应该至少有8GB的RAM来运行3B型号,16GB来运行7B型号,32GB来运行13B型号。”在我的16GB RAM Mac上,7B Code Llama的性能出奇地快。它将回答有关的问题ᅠbash/zshᅠshell命令以及Python和JavaScript等编程语言。

图片

在Ollama终端窗口中运行Code Llama的外观

尽管它是家族中最小的模型,但如果不完美地回答了一个R编码问题,这会让一些更大的模型感到困惑,那它还是很好的:“为ggplot2图写R代码,其中的条形图是钢蓝色的。”代码是正确的,只是其中两行代码中有两个额外的右括号,这很容易在我的IDE中找到。我怀疑更大的Code Llama本可以做得更好。

Ollama还有一些附加功能,例如ᅠLangChainᅠ集成和使用PrivateGPT运行的能力,除非检查ᅠGitHub repo的教程页面。

如果你在Mac电脑上,想使用Code Llama,你可以在终端窗口中运行它,每次有问题时都会把它拉出来。我期待着在我的家用电脑上使用Ollama Windows版本。

图片

与自己的文档聊天:H2OGPT

H2O.aiᅠ一段时间以来,该公司一直致力于自动化机器学习,因此很自然地进入了聊天LLM领域。它的一些工具最好由熟悉该领域的人使用,但安装其测试版本的说明ᅠh20GPTᅠ聊天桌面应用程序快速而直接,即使对于机器学习新手来说也是如此。

你可以访问web上的演示版本(显然不是使用系统本地的LLM),网址:ᅠgpt.h2o.ai。


图片

本地LLaMa模型基于VS代码文档回答问题

无需添加自己的文件,就可以将该应用程序用作通用聊天机器人。或者,可以上传一些文档并询问有关这些文件的问题。兼容的文件格式包括PDF、Excel、CSV、Word、文本、标记等。测试应用程序在我的16GB Mac上运行良好,尽管较小型号的结果无法与带GPT-4的付费ChatGPT相比(一如既往,这是型号的函数,而不是应用程序的函数)。H2OGPT UI为知道自己在做什么的用户提供了一个专家选项卡,其中包含许多配置选项。这为更有经验的用户提供了尝试改进其结果的选项。

图片

如果你想对流程进行更多控制,并为更多型号提供选项,请下载完整的应用程序。对于带有GPU或仅带有CPU的系统,有适用于Windows和macOS的一键安装程序。请注意,我的Windows防病毒软件对Windows版本不满意,因为它没有签名。我熟悉H2O.ai的其他软件,代码在GitHub上也有,所以我愿意下载并安装它。

Rob Mulla,现在在H2O.ai,发布了一个ᅠYouTube视频ᅠ关于在Linux上安装该应用程序。尽管该视频已经发布了几个月,应用程序用户界面似乎也发生了变化,但该视频仍然有有用的信息,包括关于H2O.ai LLM的有用解释。

图片

轻松但缓慢的数据聊天:PrivateGPT

PrivateGPTᅠ还设计用于让使用自然语言查询自己的文档,并获得生成的人工智能响应。此应用程序中的文档可以包括几十种不同的格式。README确保数据“100%私有,任何时候都不会有数据离开的执行环境。可以在没有互联网连接的情况下获取文档并提出问题!”

PrivateGPT的特点是脚本可以摄取数据文件,将其分割成块,创建“embeddings”(文本含义的数字表示),并将这些嵌入存储在本地Chroma矢量存储中。当你提出问题时,该应用程序会搜索相关文档,并将其发送给LLM以生成答案。

如果熟悉Python以及如何设置Python项目,可以克隆完整的PrivateGPT存储库并在本地运行它。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

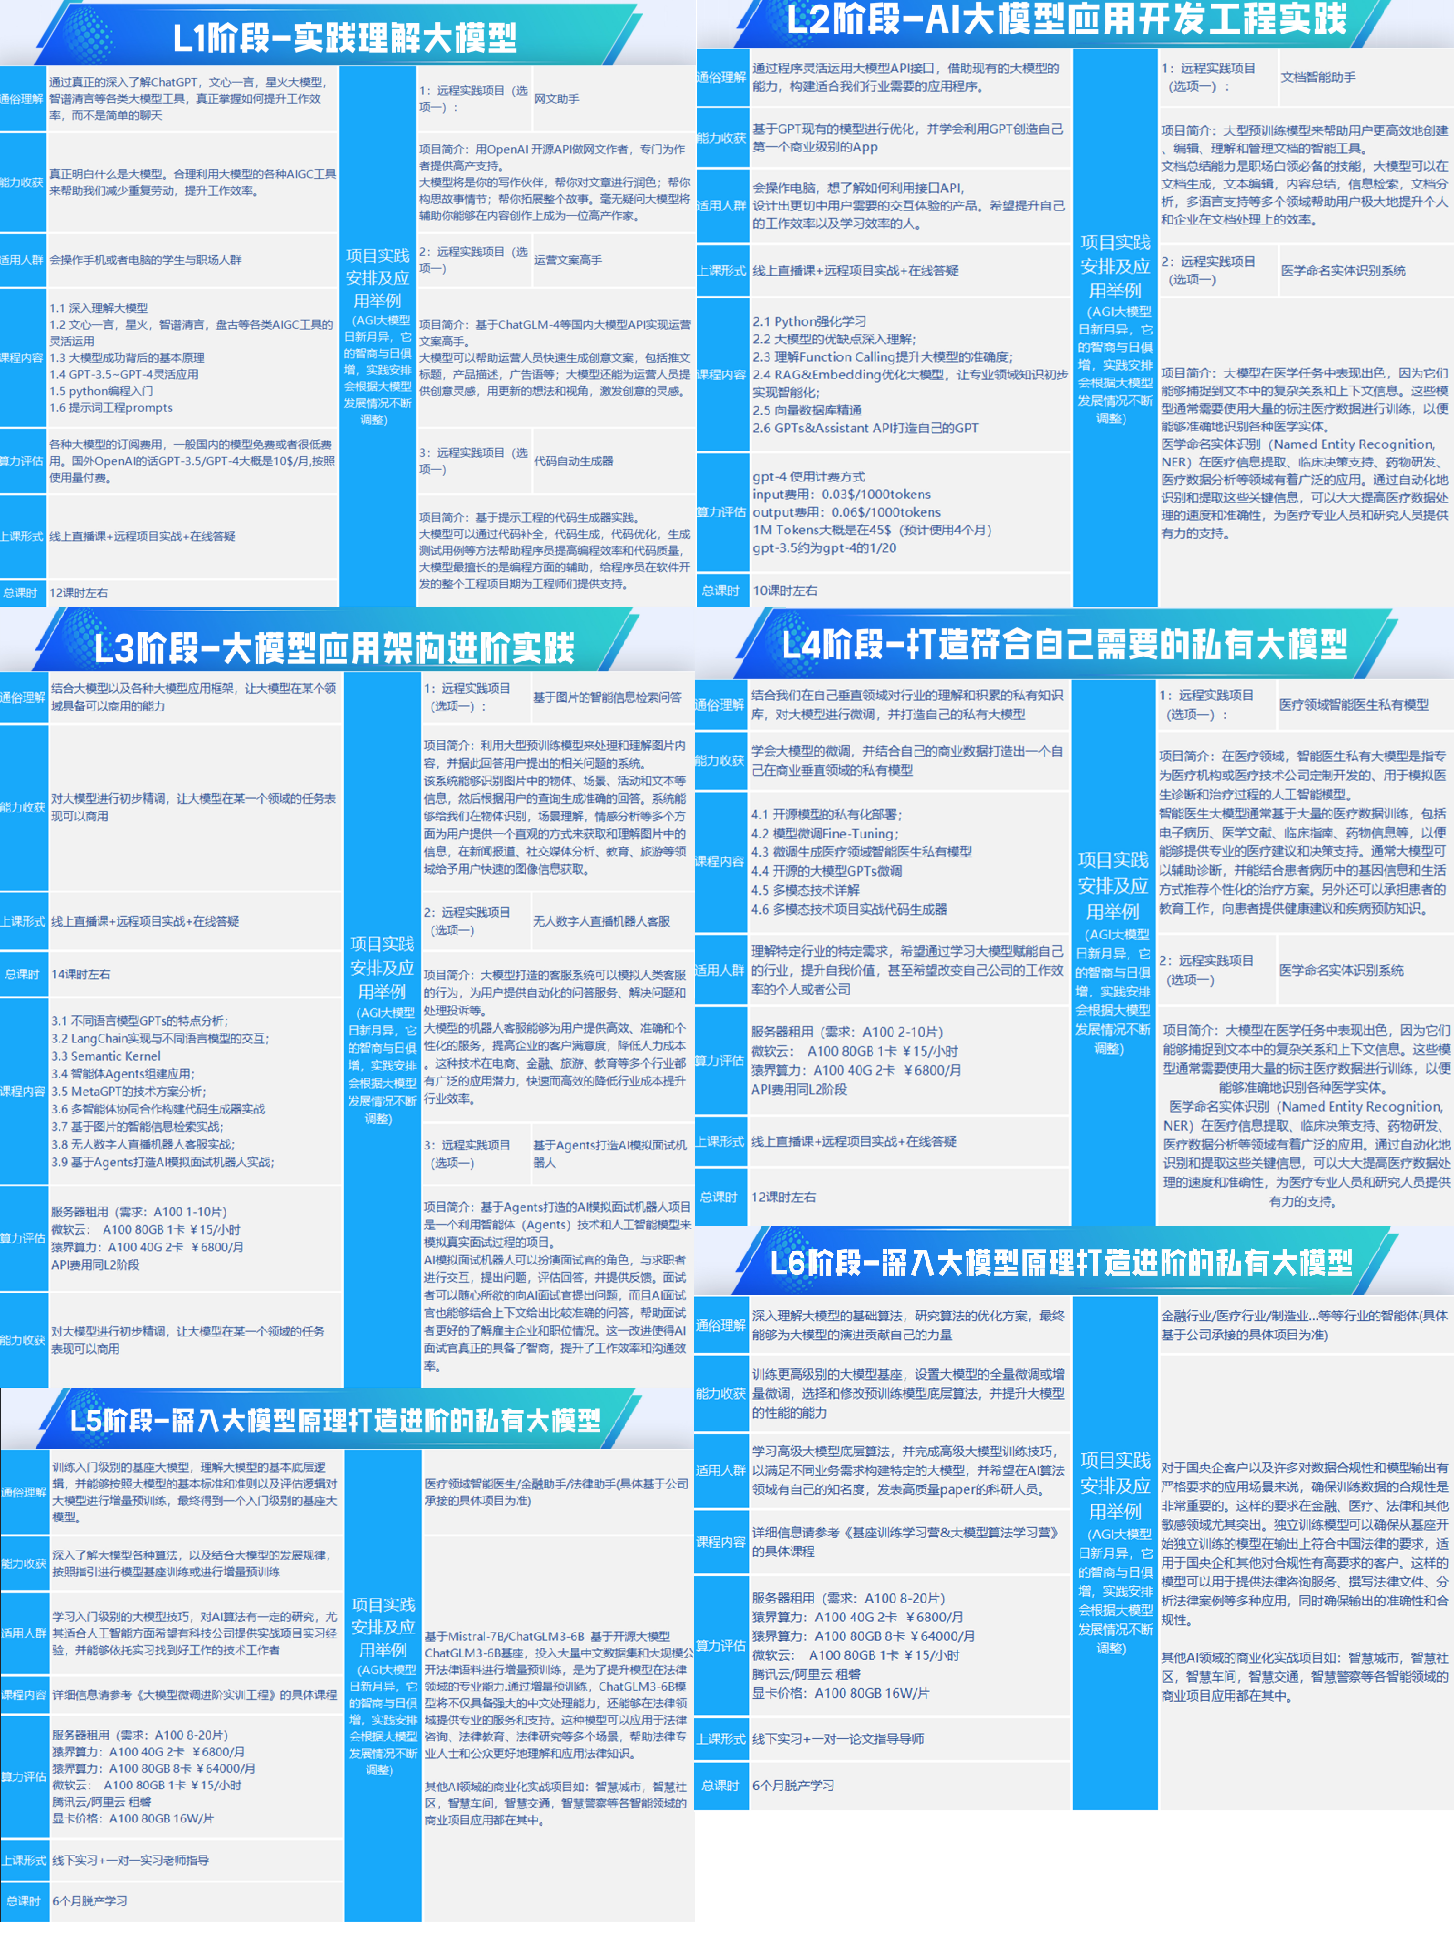
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
img

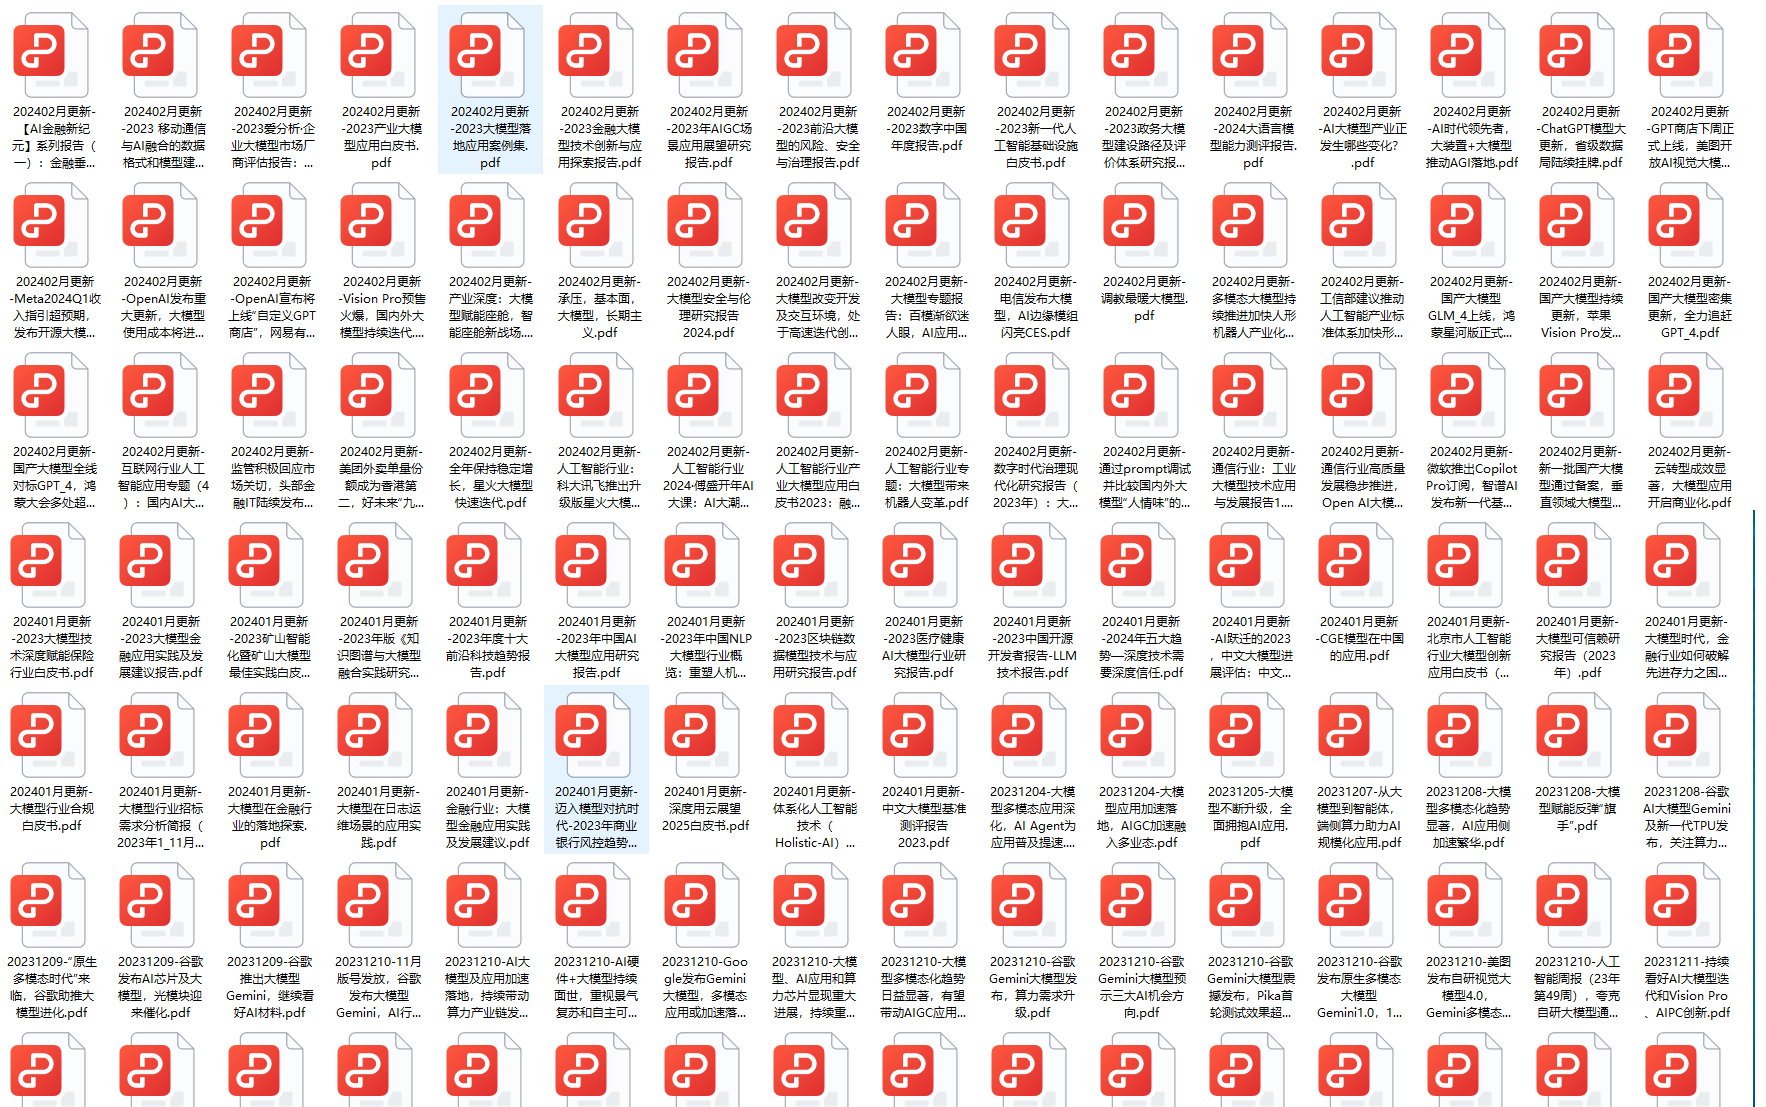
二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

YOLOV5:在本地电脑训练模型 一、YOLOV5环境搭建 (官方要求:python>=3.6.0,pytorch>=1.7) YOLOV5 GitHub地址:https://github.com/ultralytics/yolov5 1、下载整个项目到本地桌面 . 阅读详情

相关推荐

私有化部署 Llama3 大模型, 支持 API 访问

原文 https://ducafecat.com/blog/llama3-model-api-local通过 ollama 本地运行 Llama3 大模型其实对我们开发来说很有意义,你可以私有化放服务上了。然后通过 api 访问,来处理我们的业务,比如翻译多语言、总结文章、提取关键字等等。你也可以安装 enchanted 客户端去直接访问这个服务 api 使用。

chenxyuan1tuo的博客 2044

AI探索实践8 - 本地运行大模型

大模型的本地化运行,是创建企业内部AI应用重要组成部分。选取开源的、对中文支持友好的、开源协议友好的开源大模型可以帮助我们快速建立低成本、高性能的AI应用。通过使用Ollama软件,让我们能够轻松搭建和运行一个本地大模型实例。

专注AI领域的技术研究探索、技术落地 4285

有哪些在本地运行大模型的方法

在本文中,我们将看到在本地运行任何 LLM 的不同方法

RA AI衍生者训练营的博客 1271

AI大模型的本地驯服——如何在自己电脑上训练一个专属大模型

2025年3月12日记 这是我第一次实现大模型的微调训练,电脑的配置是显卡NVIDIA GeForce RTX 3050 Ti Laptop GPU,三年前的笔记本了,不过还是能跑起来的,训练的是Deep Seek-r1 的 1.5B 模型,之前跑 7B 的直接卡死了。如果大家有更好的显卡,可以尝试一下。那么废话不多说,直接开始!(默认大家有一定的基础)

HELLO_CPY的博客 1万+

【Ai教程】Ollma安装 | 0代码本地运行Qwen大模型,保姆级教程来了!

我们平时使用的ChatGPT、kimi、豆包等Ai对话工具,其服务器都是部署在各家公司的机房里,如果我们有一些隐私数据发到对话中,很难保证信息是否安全等问题,如何在保证数据安全的情况下,又可以使用大预言模型,Ollma(哦拉玛)可以告诉你答案!

王傲旗的大数据之路 3660

一步一步教你写股票走势图——K线图一(概述)

股票分时图部分已经开发完毕,受到了广大开发者的好评!界面、功能都挺完美,解决了好一些MP开发者的问题,博主甚是欣悦,更有动力去开源K线图。这里说一下,如果有问题直接留言或者发邮件,github上个人信息有邮件,我看到基本都会回复,博主不加qq的,体谅O(∩_∩)O。分析好了,废话不多说,我们分析下K线图吧,首先我们看下自选股K线图的效果吧效果还是很赞的,经过分时图的研究后,博主越来越确信自选股用的应

体验Android编程之美 3万+

Qwen3.5 去审查版火了:0 拒绝、4090 可跑,本地大模型正在进入“失控边缘”?

过去这一年,本地大模型圈有一个很明显的变化:大家讨论的重点,已经从“能不能跑起来”,慢慢变成了“跑起来之后,它到底会说什么”。前几年玩本地模型,很多人还在折腾显卡、量化、推理速度和上下文长度。到了现在,硬件门槛越来越低,工具链越来越成熟,真正让社区情绪被点燃的,往往已经不是某个 benchmark 又涨了几点,而是某个模型突然“没有护栏了”。。它最吸引眼球的一点很简单:有人专门把 Qwen3.5-35B-A3B 的拒绝机制拆掉了,测了 465 个通常会被模型回避的提示词,结果是。

aifs2025的博客 4358

DAC8760高精度数模转换器原理与工业级嵌入式应用

数模转换器(DAC)是工业测控系统中实现数字指令到模拟执行的关键接口,其核心性能由分辨率、线性度、温漂及系统级TUE(总未调整误差)共同决定。DAC8760作为一款16位四象限精密DAC,集成了可编程增益放大器(PGA)、内部基准源与SPI高速接口,支持电压/电流双模输出,显著提升闭环控制精度与硬件适配灵活性。其技术价值在于将高精度模拟前端与数字控制深度耦合,满足PLC、ATE及激光偏置等严苛场景对长期稳定性与多通道同步性的要求。本文围绕DAC8760的寄存器配置、HAL/LL驱动实践、PCB布局规范、现场

weixin_42315569的博客 581

搭建本地大模型和知识库最简单的方法

每款大模型都有不同版本,根据自己的机器来选择,根据官网的文档也说明了,一般7B的模型至少需要8G的内存,13B的模型至少需要16G内存,70B的模型至少需要64G内存。包括:大模型学习线路汇总、学习阶段,大模型实战案例,大模型学习视频,人工智能、机器学习、大模型书籍PDF。以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;不管你是在PC上跑大模型,在Mac上跑大模型,还有在树莓派上跑大模型,

lvaolan的博客 896

NFC门禁卡复制全解析:从M1卡到UID卡的攻防实践

本文深入解析了NFC门禁卡的安全机制与攻防实践。从M1卡基于Crypto1算法的原理漏洞讲起,详细阐述了利用Proxmark3等工具进行侦听、破解密钥及使用UID卡进行复制的完整攻击链条。同时,为防御方提供了从升级CPU卡、启用全扇区认证到部署多因子验证的系统性防护策略,旨在帮助管理员构建更稳固的物理安全防线。

weixin_29182481的博客 1401

分布式定时任务(XXL-JOB)整合达梦数据库 带源码

背景 1. 因公司需要可视化管理配置调度任务,查询项目选择XXL-JOB,它是开源项目,入手很简单,详情可以参考官方文档; 2. 因项目的机密性,选择数据库为国内知名的达梦数据库7,与Java项目的整合详情可以参考SpringBoot 集成 达梦数据库 maven依赖本地jar包; 3. 因XXL-JOB暂时没有找到集成达梦数据库的案例,博主自己整合DM7踩过很多的坑,特此整合一个简单可直接...

艾斯-李的博客 3814

Ollama:本地大模型运行指南

Ollama 是一个基于 Go 语言开发的可以本地运行大模型的开源框架。

python123456_的博客 3809

浅谈武术擂台格斗机器人大赛

武术擂台机器人赛是工科类专业的一个跨学科的竞赛项目,它涵盖了机械结构、硬件电路和计算机程序等技术领域。笔者在校期间有幸参加过四次这样的比赛,有成功也有失败,对此深有感悟。本文仅为个人观点,有说得不对的地方,望积极指出,希望能帮助到有需要的人。

weixin_43811044的博客 1万+

超简单,手把手教你在本地运行Llama 3大模型

Ollama是一款开源工具,专为在本地计算机上运行像Llama 3这样的大型语言模型而设计。随着AI技术的进步,现代的大型语言模型已经摆脱了对庞大虚拟内存、计算资源和存储空间的依赖,转而优化以适应笔记本电脑等更轻便的设备。在众多支持本地部署大型语言模型的工具和框架中,Ollama的设置流程和使用最为简单。用户可以直接通过终端或Powershell快速启用LLMs,无需复杂配置即可立即投入应用。Ollama的最大优势在于其强大的兼容性和集成能力。

xiangxueerfei的博客 2329

【即插即用模块】注意力篇 | TGRS 2025 | SCPP:独家复现!三特征多尺度注意力融合,涨点必备!

摘要:SCPP(Scale-aware Pyramid Pooling)是一种创新的多尺度特征融合模块,专为U型网络瓶颈设计。它通过局部特征提取(1×1卷积)、多尺度膨胀卷积(1/3/5膨胀率分支)和全局特征聚合(全局平均池化)三重结构,结合SE通道注意力机制和自适应加权融合,显著提升特征表达能力。实验表明,SCPP能有效解决边缘模糊和错误检测问题,在遥感图像分割等任务中表现优异。该模块支持即插即用,适用于各类需要多尺度特征增强的视觉任务。

主要更新底层视觉(去噪、超分等)相关的科研内容,形式为【论文精读】+【论文复现】 939

uniapp - 实现手机端H5网页直播功能效果,拿到后端推流地址或播放资源后进行前端的流畅播放和画面展示功能,uniapp实时推流/拉流直播系统详细教程(提供完整示例代码,一键复制开箱即用!)

uniapp,h5网页,手机端H5网页,uniapp h5直播功能页面,uniapp直播实时推送显示,uniapp h5直播怎么做,怎么使用uniapp去实现移动端手机H5直播,h5 vue+uniapp怎么做直播,uniapp中使用videojs构建H5直播播放器,uniappH5端怎么实现直播推流,uniapp如何实现直播,直播聊天功能,h5平台端直播用什么插件,uniapp手机网页直播用什么组件插件播放器,uniapp手机H5直播播放器详细教程,直播项目,怎么使用vue+uniapp怎么做H5实时直播

✅ 精选推荐文章 8792

DeepSeek-R1大模型个人电脑部署教程,本地运行AI竟如此简单!

今天要教大家一个超实用的AI技能:用普通家用电脑就能运行的DeepSeek-R1 蒸馏版1.5B参数大模型!无需高端显卡,不需要复杂配置,跟着这篇教程走,小白也能玩转大语言模型!✨

瓦罗兰特顶级C位的博客 1788

【STK】手把手教你利用STK进行覆盖分析05-方位覆盖分析、覆盖网络检查工具和单对象覆盖分析

这一篇是我们STK覆盖模块的理论部分的最后一篇文章,之后会找尽可能多的论文来复现论文中关于STK覆盖模块的仿真的部分,到时候大家遇到不会的就可以结合前面的理论部分来看。

weixin_44184852的博客 1493

本地部署运行大模型

随着近两年大语言模型 (LLM) 的快速发展,人们的关注度和使用频率越来越高。然而,大多数 LLM 由大型科技公司掌控,并以云服务的形式提供,这限制了开发者和研究人员对其进行探索和定制的自由度。

2401_82469710的博客 2903

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

本地运行大模型:从 Hugging Face 下载到本地部署

本地部署大语言模型实践指南 本文将介绍如何从Hugging Face下载模型权重并在本地运行大语言模型。本地部署具有数据隐私性好、响应速度快、便于深入调试等优势。具体步骤包括:通过Hugging Face官网或国内镜像站下载模型文件,安装PyTorch和Transformers依赖库,编写Python代码实现模型加载与对话功能。文中提供了完整的代码示例,支持CPU/GPU运行,包含对话格式化、响应生成和特殊标记处理等功能。本地运行虽需较大存储空间(建议500G硬盘),但能提供更安全的AI开发体验。

m0_64144677的博客 2054

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

上一篇: 大模型部署推理应用技术浅析
下一篇: “三国杀”:互联网云鏖战“云+大模型”
AI程序猿人
博客等级 码龄3年 6517粉丝 561原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值