自己动手微调一个大模型

【大模型】模型微调(非常详细)从入门到精通,看这一篇就够了 本文结合示例简单讨论如何使用LoRA微调 (FT) 预训练的 LLM。LoRA原理将在接下来的文章里详细讨论。 阅读详情

什么是微调7

模型微调,是在通用大语言模型(比如deepseek,qwen,llama,豆包)基础上,针对特定任务,使用特定的数据来训练,让它在这个任务上表现更优秀。用人话来说就是,用目标数据来训练它让它更符合我们的目标。

为什么要微调

比如一个通用大语言模型在大规模通用文本上训练,能学习到通用语言特征。但电商评论情感分析场景下,直接使用效果不好。微调时加入电商评论数据,模型可学习到 “颜值高”,“物流慢”,“卖家秀” 等特定领域情感表达模式,从而更精准判断评论情感倾向。

虽然这篇文章写的是微调,但模型效果不好,需要分析原因,沿着下面这个思路来优化

  • 提示词优化,在大语言模型提示词永远是第一位的,提示词是激发模型小宇宙的一把金钥匙。

  • 利用RAG,整合自己的知识库,为模型提供私有领域的知识,比如说公司的管理制度和组织架构(董事长是谁,总经理是谁。。。)

  • 智能体和工作流,最大程度把大模型和外部能力结合起来,比如,查询北京明天的天气,为用户制定北京的旅游计划。这里面【北京明天的天气】,是所有大模型都不知道的信息,要通过外部接口让模型知道了北京天气,然后根据天气情况来设计攻略。

如果前面的方法不管用,最后一步才是模型调优,而模型调优的首选方式就是微调。

顺便说一句,微调后的模型,依然可以和提示词优化,RAG,智能体和工作流一起使用。

开始动手

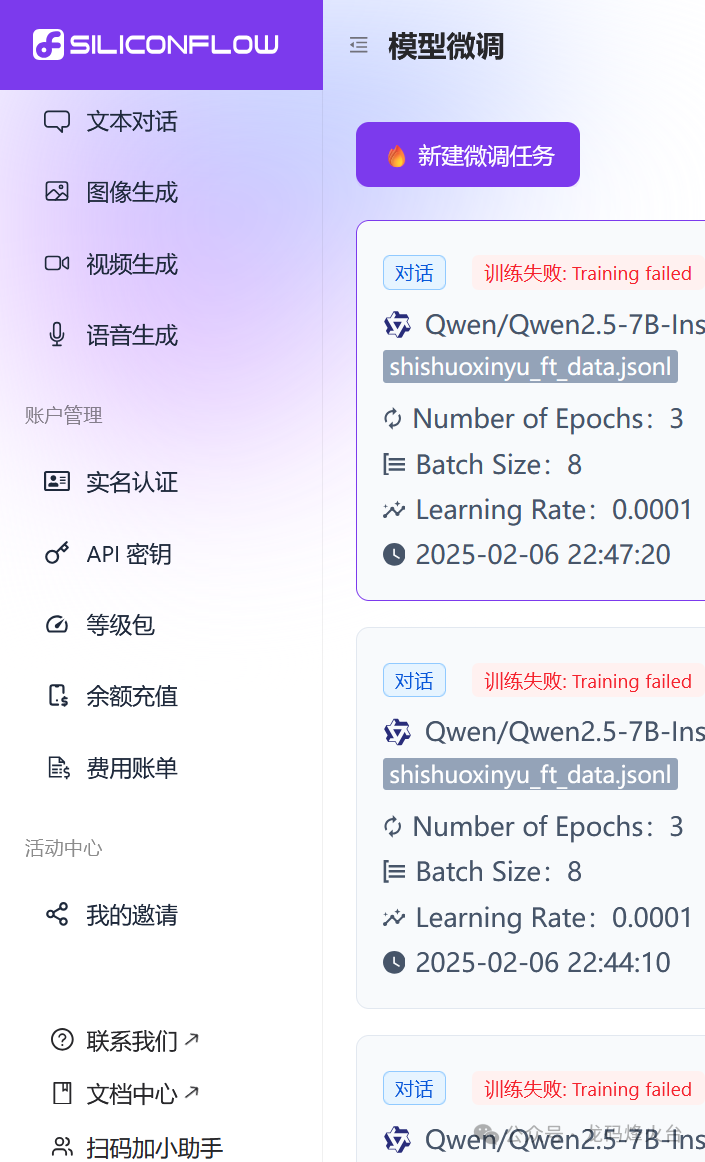
这个微调的案例来自于硅基流动,没错,就是这段时间因为deepseek广为人知的硅基。

但是这个案例我在硅基上居然训练失败,一开始以为是赠送金额不能用于微调,充了值以后还是不成功(心疼我的10块钱img),提交了工单也没人理我。
img

硅基不行,那就去找别人吧:阿里云百炼。

  • 微调的目标

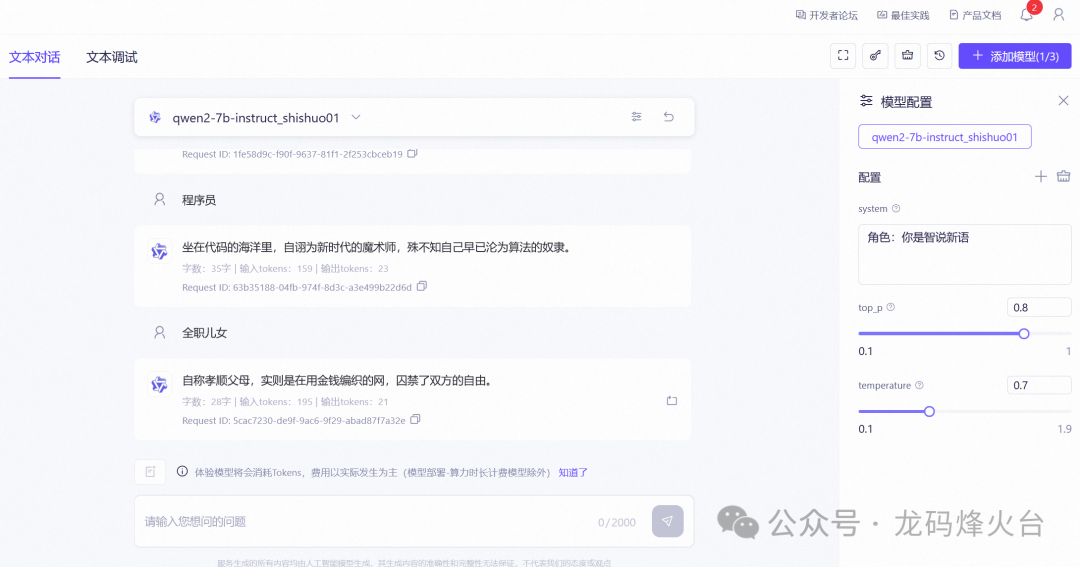
    智说新语,让大模型为输入的名词自动造一个“金句”,下面是效果图

img

直接开干

训练数据长这样,完整的数据地址在下面

{"messages": [{"role": "system", "content": "你是智说新语生成器"}, {"role": "user", "content": "鞋易净"}, {"role": "assistant", "content": "鞋面光鲜亮丽,却掩不住脚下的泥泞之路。"}]}
{"messages": [{"role": "system", "content": "你是智说新语生成器"}, {"role": "user", "content": "提示词赛道"}, {"role": "assistant", "content": "赛道上人人争先恐后,以为奔跑就能抵达终点,却不知真正的胜负早已在起跑线上划定。"}]}{"messages": [{"role": "system", "content": "你是智说新语生成器"}, {"role": "user", "content": "产品经理"}, {"role": "assistant", "content": "产品经理,一边吹嘘着用户体验至上的圣歌,一边悄悄在后台数着广告点击的金币。"}]}
{"messages": [{"role": "system", "content": "你是智说新语生成器"}, {"role": "user", "content": "信息数字化科"}, {"role": "assistant", "content": "数据的洪流中,我们自以为驾驭了知识的航船,殊不知早已成了算法的奴隶。"}]}

微调要花钱,确保阿里云账户有钱,我有优惠券,这次微调账单才几毛钱。

进入阿里云百炼控制台,

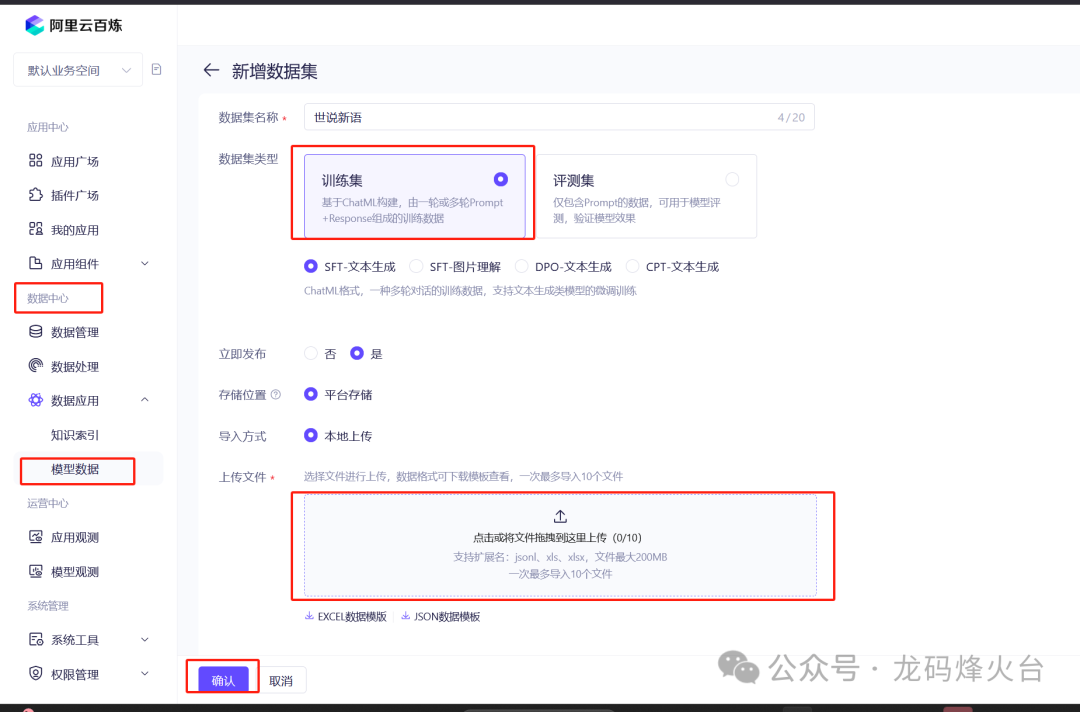
先到数据中心,把训练数据上传到百炼
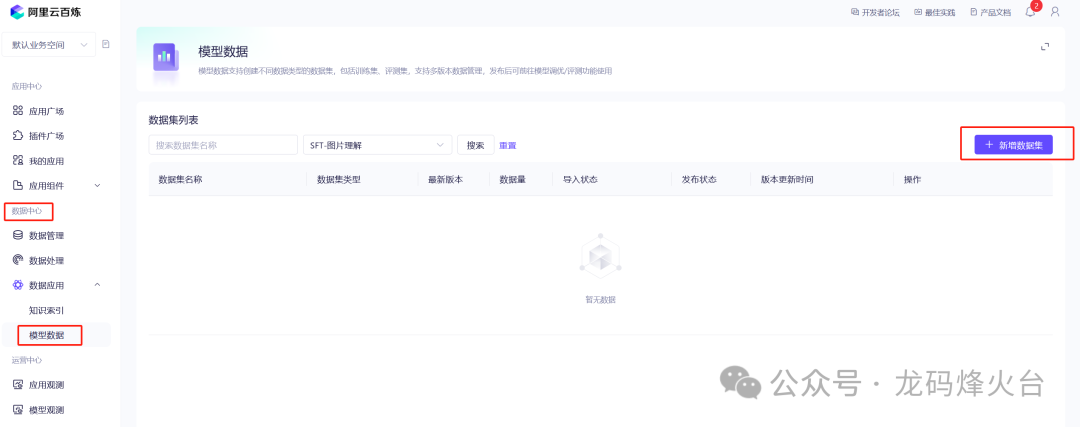
img

img

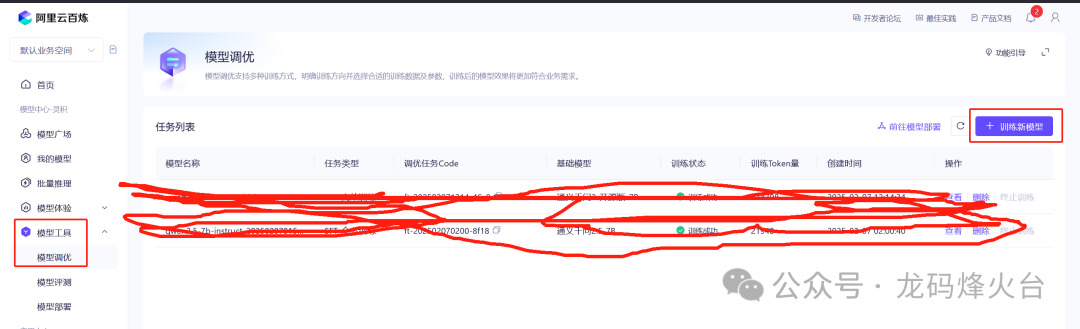
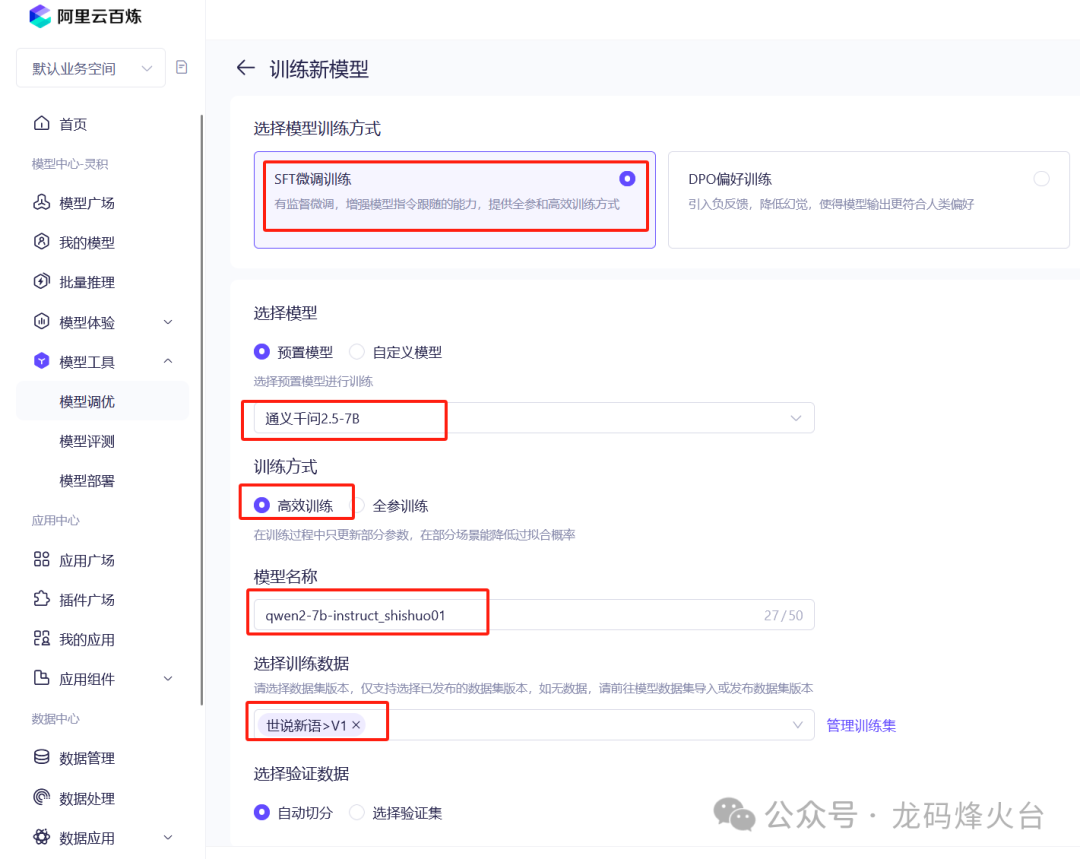
然后选择 模型工具-模型调优-训练新模型

img

img

训练方案:必须是SFT微调训练

训练模型:通义千问2.5-7B。7B的小模型,训练费用便宜,模型太大了,耗费的token也多,费用也高。

训练方式:必须选择高效训练。为什么不用全参训练,后面再展开来说。

**模型名称:起一个容易理解的。

**

训练数据:就用刚刚上传的那份数据集。

其它训练超参数保持默认就行。

开始训练,等待训练成功
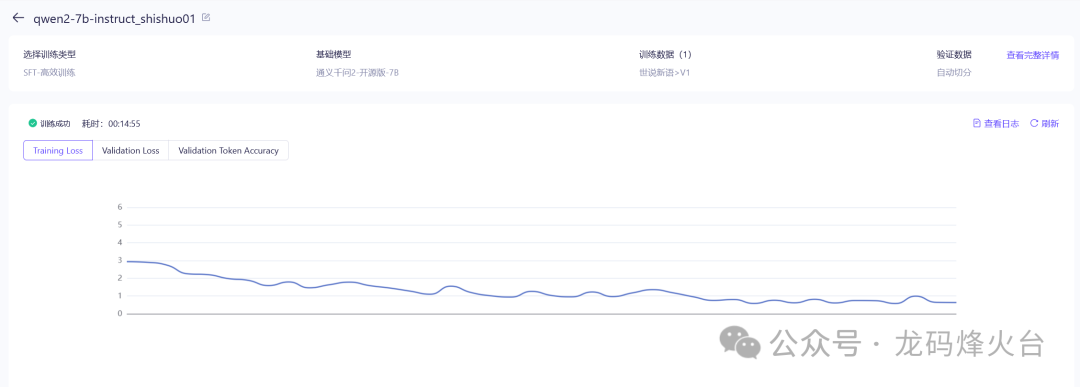
img

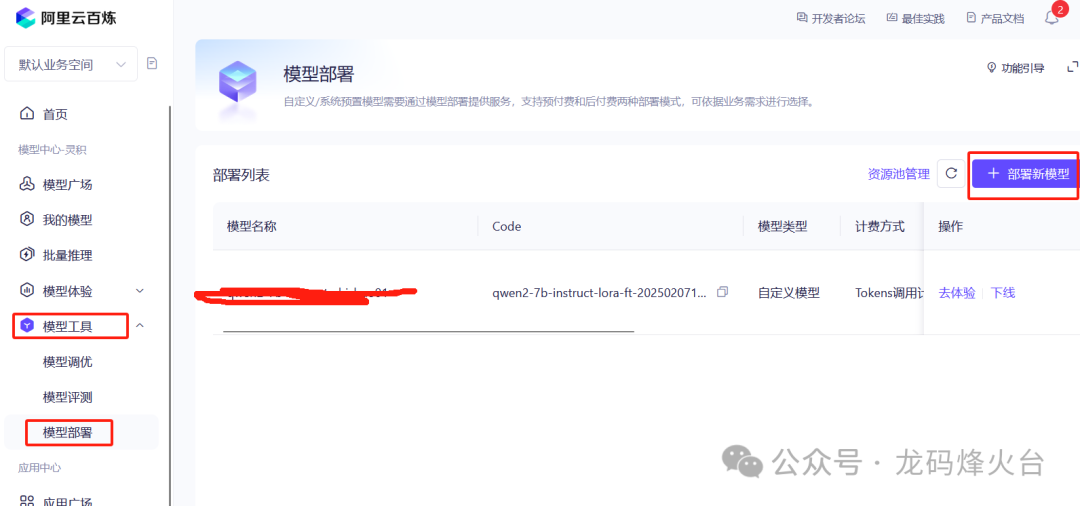
微调训练成功后,就有了一个“新模型” ,接下来就是部署。

img

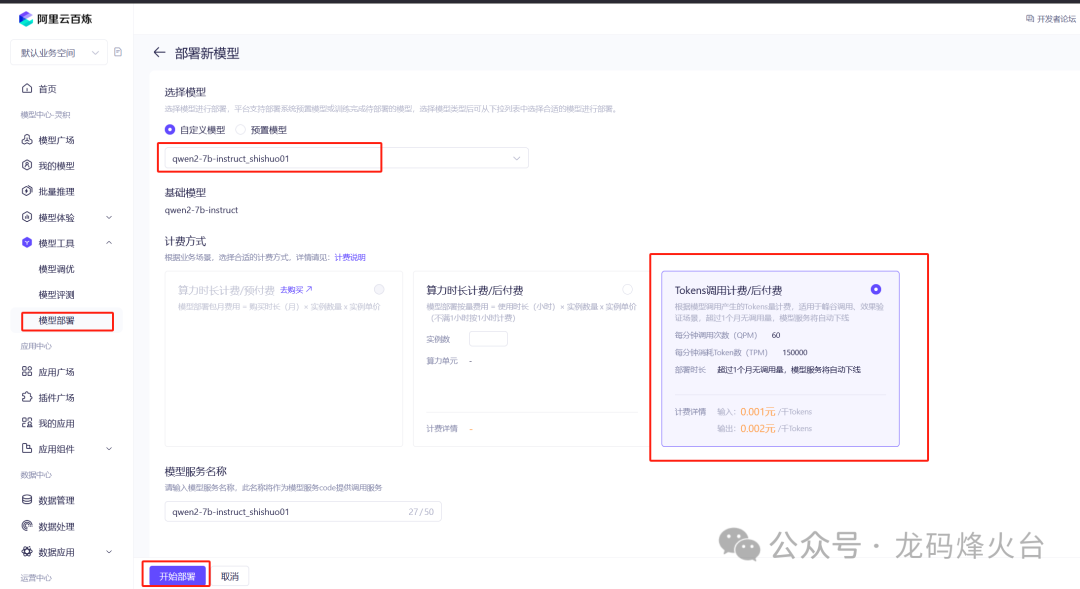
img

在百炼部署一个模型很简单,选择微调后的模型,计费方式选择token后付费,用多少给多少。高效训练策略的模型部署很快的,几分钟就成功。

部署成功了,可以在线体验
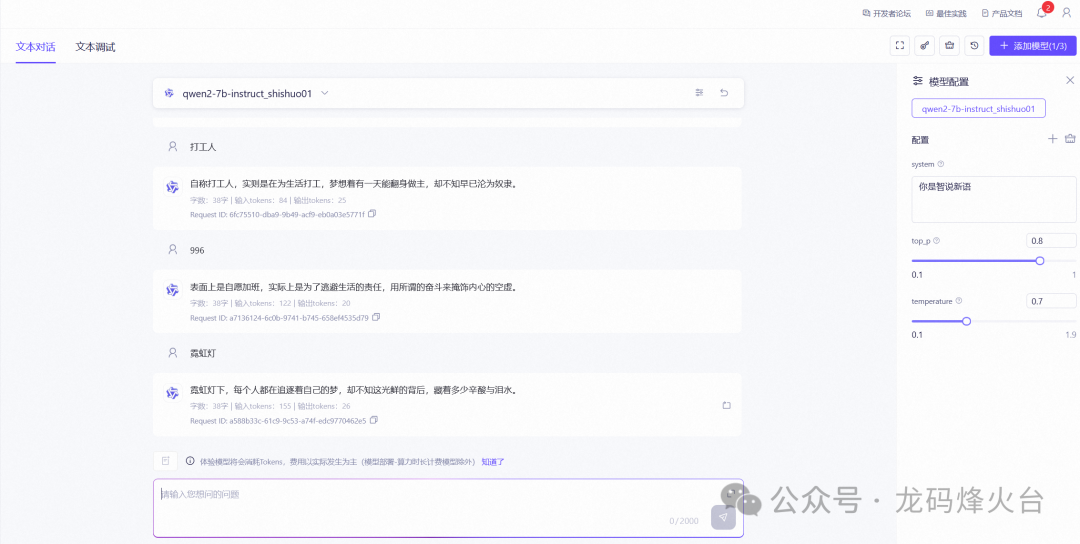
img

后话

  • 训练方式为什么不选择全参

模型调优,有全参和微调,微调就是冻结一部分网络层,只需要调整少部分网络层。

全参,一般需要比较大量的数据,数量太少效果不好。全参也以为着全部参数会发生改变,训练后需要把整个大模型给部署起来,费用不低,阿里云针对**全参训练的模型不运行使用token后付费方式部署。

高效训练使用LoRA训练策略,

LoRA(Low-Rank Adaptation of Large Language Models),大语言模型的低秩适配,是一种高效的模型微调方法,微软 2021 年提出来的。

LoRA的原理很复杂,直观来理解就是,原先的基础模型保持不变,还是那些参数,比如我们用的千问2.5-7B模型,有70亿参数,这些参数不会改变,也不需要我们重新部署。

针对我们的微调任务,新生成了一批参数,数量很小。模型部署只需要把加载这批小参数。

模型在处理用户输入的提示词时,结合【新参数】和【基础模型】完成推理,得到输出。
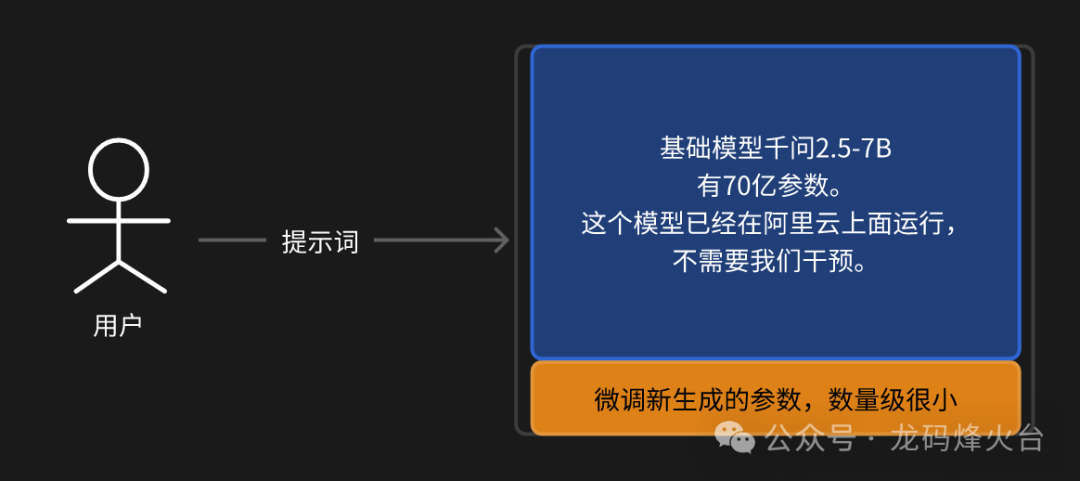
img

如何学习AI大模型?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高

那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

全套AGI大模型学习大纲+路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

在这里插入图片描述
在这里插入图片描述

在这里插入图片描述
在这里插入图片描述

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

img

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

阿里云百炼SFT微调实践 n\n将第二个方程代入第一个方程,我们得到:\n\n\\[T + 12 + T = 40\\]\n\n合并同类项:\n\n\\[2T + 12 = 40\\]\n\n两边同时减去 12:\n\n\\[2T = 28\\]\n\n两边同时除以 2:\n\n\\[T = 14\\]\n\n现在我们知道了 $T = 14$,可以通过将 $T$ 代入一个原方程来找到 $B$ 的值。准备数据过程中一个常有的问题是数据量不足的问题,从保证数据质量的角度考虑,数据量不足情况下 最好基于专业人员进行数据构造和标注; 阅读详情

相关推荐

计算巢实现大模型微调——如何发布一个微调服务

各位看官,最近是否被大模型相关信息刷屏了呢,铺天盖地的大模型预训练、微调等各种关键词是否让你眼花缭乱呢?在如此热度之下,你有没有想过自己亲自动手部署一个大模型执行训练或者微调呢,或许你曾经尝试过却被某个繁琐的步骤劝退了呢?又或者你是模型的研究人员或开发人员,想要让你的模型服务更多用户、有更大的影响力?如果你有自己的基础大模型供给其他人精调,却苦于难以部署、难以让用户上手使用等各种问题,来试试计算巢吧,你的这些问题都将迎刃而解!

阿里云云栖号 940

模型微调(fine-tune)

模型微调(fine-tune)

爱敲代码的狼仔 6277

模型微调有哪些不同方法?

模型微调(Fine-tuning)有许多不同的方法,这些方法可以根据任务类型、数据情况和模型结构进行调整。首先,将预训练模型的底部几层(或全部层)冻结,这些层包含了在大规模数据上学到的通用特征。为不同的层设置不同的学习率,通常底层使用较小的学习率,而顶层使用较大的学习率。在预训练模型的基础上,逐层进行微调,从顶层开始,逐步向底层微调。在预训练模型的基础上,对整个模型进行微调,包括底层和顶层。从底层开始,逐层解冻并进行微调。在微调时,考虑目标域的特点,使用一些领域适应方法来提高模型在特定领域的性能。

优快云 精品推荐 1475

一文讲解:模型微调(fine-tune)

对于图片来说,我们CNN的前几层学习到的都是低级的特征,比如,点、线、面,这些低级的特征对于任何图片来说都是可以抽象出来的,所以我们将他作为通用数据,只微调这些低级特征组合起来的高级特征即可,例如,这些点、线、面,组成的是园还是椭圆,还是正方形,这些代表的含义是我们需要后面训练出来的。此时,模型的最后一层大小并不是预想的,因此需要获取输入到最后一层全连接层之前的维度大小,然后根据数据集的类别数来指定最后输出的out_features数目,以此代替原来的全连接层。数据多,数据类似程度高:这是最理想的情况。

Python栈 4655

避开这5个坑!用MATLAB做核密度估计时90%人会犯的错误

本文详细解析了使用MATLAB进行核密度估计时常见的5个高频错误,包括三维数据可视化、带宽参数优化、大数据量处理、核函数选择及版本兼容性问题。特别针对核密度估计中的关键参数带宽(bandwidth)提供了数据驱动的优化策略,帮助用户提升分析精度与效率。

jenkins8butler的博客 277

金蝶个版本下载地址,记得保存收藏。

专业版 V10.0 http://downloads.cmcloud.cn/kis/kis_pro/10.0/kiszybV10sp1.rar V11.0 http://downloads.cmcloud.cn/kis/kis_pro/11.0/KISV11Setup.rar V12.0 http://dow...

饺子的博客 2506

【建议收藏】一个月掌握AI大模型:从零基础到项目实战的程序员完整指南

本文提供了一个为期一个月的AI大模型学习计划,四周内容分别为:第一周学习Transformer架构理论基础;第二周掌握Hugging Face工具和模型应用;第三周学习模型微调与定制技术;第四周通过RAG系统构建、模型量化和毕业项目进行实战应用。文章强调动手实践的重要性,并提供具体学习资源和实践任务,帮助读者在短期内建立对AI大模型的系统性认知并具备应用开发能力。要在一个月内完成目标,你并非需要从零开始。:理解大模型的“灵魂”——Transformer架构,并掌握其核心概念。

python12345_的博客 1253

RT-Thread与LWIP协议栈在GD32F450XX上的移植实战:从FreeRTOS到RT-Thread的切换指南

本文详细介绍了将LWIP协议栈从FreeRTOS移植到RT-Thread系统,并在GD32F450XX开发板上实现的完整实战指南。重点解析了sys_arch适配层、邮箱与信号量接口的关键改造,以及网络驱动ethernetif.c的适配步骤,帮助开发者解决线程通信差异,实现稳定网络连接。

linux6sysadmin的博客 824

【收藏必备】一个月搞定大模型:从理论到应用的完整学习计划

文章提供四周大模型学习计划:第一周掌握Transformer架构理论基础;第二周学习Hugging Face工具与模型调用;第三周实践模型微调与定制技术;第四周构建知识库问答系统并完成项目实战。强调动手学习重要性,附赠系统学习资料,帮助读者快速掌握大模型技术,成为AI时代的实践者。

2401_85375186的博客 1068

别再乱装了!Win10下NVIDIA显卡驱动、CUDA 11.0和cuDNN 8.0.5保姆级配置指南(含版本匹配避坑)

本文提供Win10下NVIDIA显卡驱动、CUDA 11.0和cuDNN 8.0.5的保姆级配置指南,详细解析版本匹配逻辑与安装步骤。从驱动选择到环境变量配置,再到框架测试,手把手教你避开常见坑点,确保深度学习环境一次配置成功。特别强调版本匹配的重要性,帮助开发者高效搭建GPU开发环境。

weixin_30600197的博客 307

Crossformer实战:从零开始搭建多变量时间序列预测模型(附ETTh1数据集调参指南)

本文提供了从零开始搭建Crossformer多变量时间序列预测模型的实战指南,并附有详细的ETTh1数据集调参攻略。文章深入解析了Crossformer的核心设计,重点探讨了seg_len和win_size等关键参数对模型性能的影响,并分享了环境配置、训练调试及常见问题的解决方案,帮助开发者高效应用这一前沿深度学习模型。

weixin_29281915的博客 318

动手学大模型:降低AI学习门槛的开源实践

大模型技术作为人工智能领域的重要突破,其核心在于Transformer架构和海量参数的智能涌现。通过模型压缩和量化技术,开发者可以在消费级硬件上实现大模型的微调与部署,显著降低计算资源门槛。开源项目《动手学大模型》采用模块化设计,涵盖从基础概念到前沿技术的完整学习路径,特别适合希望快速掌握大模型实践的开发者。该项目通过精心设计的Jupyter Notebook案例,结合HuggingFace生态和量化工具链,使学习者在GTX 1060等普通显卡上就能完成BERT微调等实战任务。对于AI教育领域而言,这种将理

weixin_29051811的博客 359

压电阀控制器设计-总章

本文章用于回顾记录本人制作压电阀控制器的关键技术,本人所制作压电阀控制器已经上市得到应用,特在此对一些关键技术进行回顾记录,欢迎从事压电控制及压电阀相关人员一起讨论

qq_42712859的博客 849

传统程序员如何在30天快速入门大模型开发?这份超详细的大模型系统学习路线图

本文提供了一个为期一个月的AI大模型学习计划,分为四周:第一周学习Transformer架构等理论基础;第二周掌握Hugging Face工具和模型应用;第三周学习模型微调技术;第四周通过RAG系统、模型量化和项目实战提升实践能力。文章详细列出了每日学习任务、必备资源和学习建议,强调动手实践的重要性,帮助学习者在一个月内从零开始成为大模型的实践者。

2401_85375151的博客 1392

手把手教你学GPU的KMD专栏--3.1 设备初始化流程深度解析

本文深入解析了KMD(内核模式驱动)设备初始化流程,这是GPU驱动开发最基础且关键的环节。初始化流程包括6个核心阶段:KMD模块加载、PCIe设备探测匹配、GPU硬件初始化、显存分配映射、中断系统配置和设备注册。每个阶段都有详细步骤解析,涉及关键数据结构和错误处理机制。文章还分析了常见问题(驱动加载失败、显存分配失败、中断配置失败)的解决方案,并指出未来趋势将向动态初始化、安全增强和AI优化方向发展。正确高效的初始化流程是确保GPU被操作系统安全使用的前提,也是后续内存管理、任务调度等功能的基础。

MHD0815的博客 262

把外部系统一键装进 SAP Build Work Zone:从零开始创建 HTML5 URL App

HTML5 URL App 是一种轻量级解决方案,可将外部网页或系统入口快速集成到SAP企业门户中。开发者只需在manifest.json中配置目标URL、导航模式等参数,无需开发完整前端应用。该方案利用SAP BTP的HTML5 Application Repository集中存储静态资源,通过HTML5 Apps Content Provider将应用暴露给子账号,最终在SAP Build Work Zone中以Fiori磁贴形式呈现。文章详细介绍了manifest.json的关键配置、三种基础设施组件

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 241

【大模型理论篇】大模型微调之指令微调(Instruction Fine-Tuning)

指令微调、大模型、instruction fine-tuning、监督微调、微调技术、大模型微调、llm fine tune、指令数据集、prompt、微调实战、Alpaca、llama2微调

源泉的小广场 2万+

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

动手玩转大模型 —— 开启你的AI探索之旅

???? 动手玩转大模型 —— 开启你的AI探索之旅 在这个数字时代,大型语言模型正以前所未有的方式改变着我们生活与工作的每一个角落。无论是在学术界还是工业界,掌握大模型的应用与优化已成为一种必不可少的能力。为此,《动手学大模型》应运而生——一款专注于大模型实践教学的开源项目,引领你深入理解并驾驭这一技术浪潮! ???? 项目介绍 《动手学大模型》不仅是一套详尽的教学材料集合,更是通向AI未来的桥梁。该项目源...

gitblog_00057的博客 997

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

大模型微调学习之旅④ — XTuner 大模型单卡低成本微调实战

图解:Alpaca 格式,斯坦福大学开源数据集的格式,也是社区开源项目使用较多的一种格式MOSS 格式,复旦大学开源指令微调数据集的格式,包含多轮对话和工具调用Gunacao 格式,QLoRA 项目中所使用数据集的格式OpenAI 格式,GPT-3.5-Turbo Finetune 接口要求的数据集格式。

HOOK1的博客 4624

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

大模型微调技术有哪些?我敢说这是大模型微调最全总结

大模型微调技术通常指的是在大型预训练模型的基础上,通过少量的参数调整来适应特定任务或领域的技术。微调(Fine-tuning):这是大型模型微调中最常见的技术。在这种方法中,预训练模型的参数会根据特定任务进行调整。这通常涉及到在模型的顶部添加一个新的输出层,并针对新任务对模型进行训练。特征提取(Feature Extraction):在这种方法中,预训练模型的底层被用作特征提取器,其顶层被替换或修改以适应新任务。底层模型的参数在微调过程中保持不变。

xzp740813的博客 1231

Qwen2.5大模型本地部署及微调教程

作为非科班小白,一开始接触大模型相关知识属于兴趣使然,随着看的论文和报告越来越多,一直想要动手去实践大模型,但又无从下手。相信很多同学与当初的我有相同的境遇,本文将手把手教会您如何部署和微调大模型,踏出实践的第一步。01微调技术介绍微调(Fine-tuning)是指通过特定领域数据对预训练模型进行针对性优化,以提升其在特定任务上的性能。微调的核心原因是赋予大模型更加定制化的功能。通用大模型虽然强大,但在特定领域可能表现不佳。通过微调,可以使模型更好地适应特定领域的需求和特征。

python1222_的博客 4021

大模型微调总结

为具体任务添加适当的输出层(如分类头、回归头等),以便模型能够处理任务需求。

xiangxueerfei的博客 1122

大模型微调技术有哪些?我敢说这是大模型微调最全总结!!!

大模型微调技术通常指的是在大型预训练模型的基础上,通过少量的参数调整来适应特定任务或领域的技术。微调(Fine-tuning):这是大型模型微调中最常见的技术。在这种方法中,预训练模型的参数会根据特定任务进行调整。这通常涉及到在模型的顶部添加一个新的输出层,并针对新任务对模型进行训练。特征提取(Feature Extraction):在这种方法中,预训练模型的底层被用作特征提取器,其顶层被替换或修改以适应新任务。底层模型的参数在微调过程中保持不变。

xzp740813的博客 1083

大模型微调

非常好 👍你已经有(这点非常有优势),转向其实正是目前最有潜力的方向之一。下面我帮你系统梳理一下——的完整路线图,分为四个阶段讲清楚每个阶段该学什么、做到什么水平,以及可以如何结合你的已有技术栈。

m0_37225702的博客 783
上一篇: DeepSeek R1打造自己的知识库,越用越聪明的秘密!喂饭级教学,全程干货!
下一篇: 2025智算与大模型人才白皮书(文末附PDF免费下载)
少喝冰美式
博客等级 码龄3年 6839粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值