5分钟手把手系列(二):本地部署Graphrag(Pycharm+Ollama+LM Studio)

【GraphRAG】本地部署全流程!超详细介绍! graphrag本地部署 阅读详情
AI摘要

本文围绕GraphRAG展开,先介绍RAG是大语言模型搜索增强主要方案,GraphRAG结合知识图谱与RAG技术优势显著。接着详细阐述GraphRAG本地搭建过程,包括Ollama、LM Studio和Pycharm的使用。最后对比传统RAG,少量文本测试显示GraphRAG效果较好,还分享了AI大模型学习资料。

背景

大型语言模型(LLM)的前沿研究中,一个核心挑战与机遇并存的领域是扩展它们的能力,以解决超出其训练数据范畴的问题,如目前比较火热的AI Agent的解决方案,使得LLM有了自己的分析决策能力,并能通过调用Tool来获取外部最新的数据信息,或者使用开源模型Groq/Llama-3-Groq-8B-Tool-Use,均可使得LLM有获取最新数据的能力来解决用户提出的问题,但在更多的场景下,用户需要咨询的信息是无法从公开的网络中进行获取,甚至大部分问题可能是某些公司内部业务的领域知识或者是企业的私有数据等,这时候就需要用到在RAG方案来增强这样的AI场景处理效率。

RAG(Retrieve Augment Generation,检索增强)

目前,RAG是大语言模型搜索增强的主要方案之一。它允许大语言模型在从固定的数据库中抽取相关内容的基础上生成答案,从而限制随意发挥,提升答案的可靠性。可以说,RAG是目前各类大模型落地项目不可缺少的实用技术组件。目前集团内外基于AI知识库问答的功能,大部分使用了RAG技术。

GraphRAG ( Graph-based Retrieval Augmented Generation,基于知识图谱的检索增强生成)

github.com/microsoft/g…

GraphRAG全称为Graph-based Retrieval Augmented Generation是一种结合了知识图谱和检索增强生成(RAG)技术的新方法。 传统的RAG技术通过从外部知识库中检索相关信息,增强生成模型的输出质量。而GraphRAG则进一步引入了知识图谱,将信息以节点和边的形式存储,提供更丰富的上下文和关系信息,从而提升生成效果。 相比于传统的RAG技术,GraphRAG在多个方面展现出了显著的优势:

  • GraphRAG通过构建知识图谱,能够捕捉到整个数据集的全貌,而不仅仅是局部文本片段。这使得它在处理大规模数据集时,能够生成更加全面和准确的答案。
  • 提高摘要质量和多样性:GraphRAG通过并行生成社区摘要,并汇总这些摘要来生成最终答案,能够从不同的角度和社区中提取信息,生成更丰富的摘要。

虽然看起来graphrag确实令人眼前一亮,但从AI学习群里一些小伙伴的反馈,大家对grahprag的使用效果还是有所存疑,带着这个疑问,笔者也准备本地搭建一套graphrag的demo来测试一下检索效果,对比一下传统rag方案与graphrag到底有没有提升~

搭建

本文准备通过Ollama工具提供本地LLM模型服务,通过LM Studio来提供嵌入模型服务,运行环境在Python venv下,Python环境3.11~3.12均可。

Ollama启动

可以看《5分钟手把手系列(一):使用Mac Book Pro本地部署大模型(Ollama+Llama3.1_8B+Docker+OpenWebUI)》,这个就不再重复了

本地LLM使用的是gemma,启动命令如下 ollama run gemma

LM Studio

因为目前ollama无法提供符合openai标准的嵌入模型接口(听说其实也可以,但不想折腾了),所以这里使用LM Studio来启动嵌入模型提供服务,大家可以直接去lmstudio.ai/ 官网下载对应的芯片版本。下载后进行安装。

在这里插入图片描述
但首次使用的时候,直接通过关键字搜索模型是会报网络错误,核心原因是LM通过本地网络访问huggingface.co时访问失败,可以通过解决方案来解决此错误。

下载嵌入模型

搜索nomic关键字,选择nomic-embed-text-v1.5.Q4_K_M.gguf模型下载,下载成功后。

在这里插入图片描述

启动嵌入模型

选择我们刚刚下载的嵌入模型nomic-embed-text-v1.5.Q4_K_M.gguf,点击启动服务即可

在这里插入图片描述

Pycharm

新建Python工程,类型选择venv,Python版本选择3.11

在这里插入图片描述

安装graphrag

工程创建之后,在Pycharm终端执行命令安装graphrag pip3 install graphrag

在这里插入图片描述
安装完成后,再执行如下命令创建资料输入目录 mkdir -p ./ragtest/input 然后在input目录下录入想要测试的文本资料,文件格式txt 我是选取的三国演义的内容作为测试内容,大家可以自行选取感兴趣的内容

在这里插入图片描述

初始化graphrag环境:graphrag.index --init

终端执行如下代码 python3 -m graphrag.index --init --root ./ragtest 此时初始化成功后工程结构如下

在这里插入图片描述

配置settings.yaml

由于我们使用本地环境,所以env文件不用去理会,直接开始配置settings.yaml,如下代码是我修改的配置区块,主要是关于LLM、embeddings还有chunk的size设置,其他保持默认

  api_key: ollama
  type: openai_chat # or azure_openai_chat
  model: gemma
  model_supports_json: false # recommended if this is available for your model.
  api_base: http://127.0.0.1:11434/v1

embeddings:
  ## parallelization: override the global parallelization settings for embeddings
  async_mode: threaded # or asyncio
  llm:
    api_key: lm-studio
    type: openai_embedding # or azure_openai_embedding
    model: nomic-ai/nomic-embed-text-v1.5-GGUF/nomic-embed-text-v1.5.Q4_K_M.gguf
    api_base: http://localhost:1234/v1

chunks:
  size: 300
  overlap: 100
  group_by_columns: [id] # by default, we don't allow chunks to cross documents

建立索引:graphrag.index --root

当graphrag环境配置完成后,执行如下命令对input文件夹txt内容建立索引,执行如下命令 python3 -m graphrag.index --root 终端会显示相关的一些graphrag的流水线执行过程日志

在这里插入图片描述

当执行索引成功后,就可以通过命令执行提问了,说实话,看到🚀All workflows completed successfully. 这个提示语,笔者是留下了激动的泪水,

  • 虽然过程看起来很简单,但其实中间还是有不少的坑,其中一直困扰我的一个报错就是 Columns must be same length as key,尝试搜索了很多资料,甚至也去debug了graphrag包的Python源码,但收效甚微。 最终笔者尝试了以下几个方向的分析调试: ollama本地模型的选择:笔者尝试过llama3.1、qwen2、mistral,最终成功的case是使用gemma:latest,曾经一度也放弃过demo的搭建,因为在github.com/microsoft/g… graphrag的技术人员也明确提出了对本地ollama环境的支持不是特别完善,很有很多问题,也委婉表示了暂时没有精力来解决此类问题,以至于我认为graphrag确实不适合通过本地模型环境来进行搭建
  • 嵌入模型的选择,开始使用的nomic-embed-text-v1.5.Q5_K_M.gguf,后改用nomic-embed-text-v1.5.Q4_K_M.gguf
  • 由于“ Columns must be same length as key”一直报错,也尝试更改chunk size: 1200->300
  • 怀疑是不是本地API服务没起来,通过Apifox来测试ollama的API服务,发现是成功的
查询问题:graphrag.query

python3 -m graphrag.query --root ./ragtest --method global "刘备是谁?"

python3 -m graphrag.query --root ./ragtest --method global "刘备关羽张飞是什么关系?" 由于我只索引了三国演义的第一章(全文需要索引的时间太长了,好像看了要7~8个小时,马上就终止了),所以目前能搜索摘要出来的内容有限

在这里插入图片描述

传统RAG效果对比

下图是我使用AnytingLLM,通过传统RAG技术搜索出来的结果,能关联的内容较少,而通过GraphRAG 极大地改进了 RAG 的“检索”部分,用更高相关性的内容来显示检索结果,从而得到更好的答案

在这里插入图片描述

写到最后

通过搭建GraphRAG本地demo后,笔者通过少量的文本内容(三国演义第一章),初略对比了一下传统RAG方案与GraphRAG方案,基于少量文本内容而言,GraphRAG的效果还是符合其宣传内容的,后续更严谨的测试还是需要海量数据的进行验证。 希望本文能帮助到对GraphRAG有兴趣的朋友,毕竟读万卷书不如行万里路,看再多的理论介绍,不如自己亲自去动手验证一把来的实在~

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

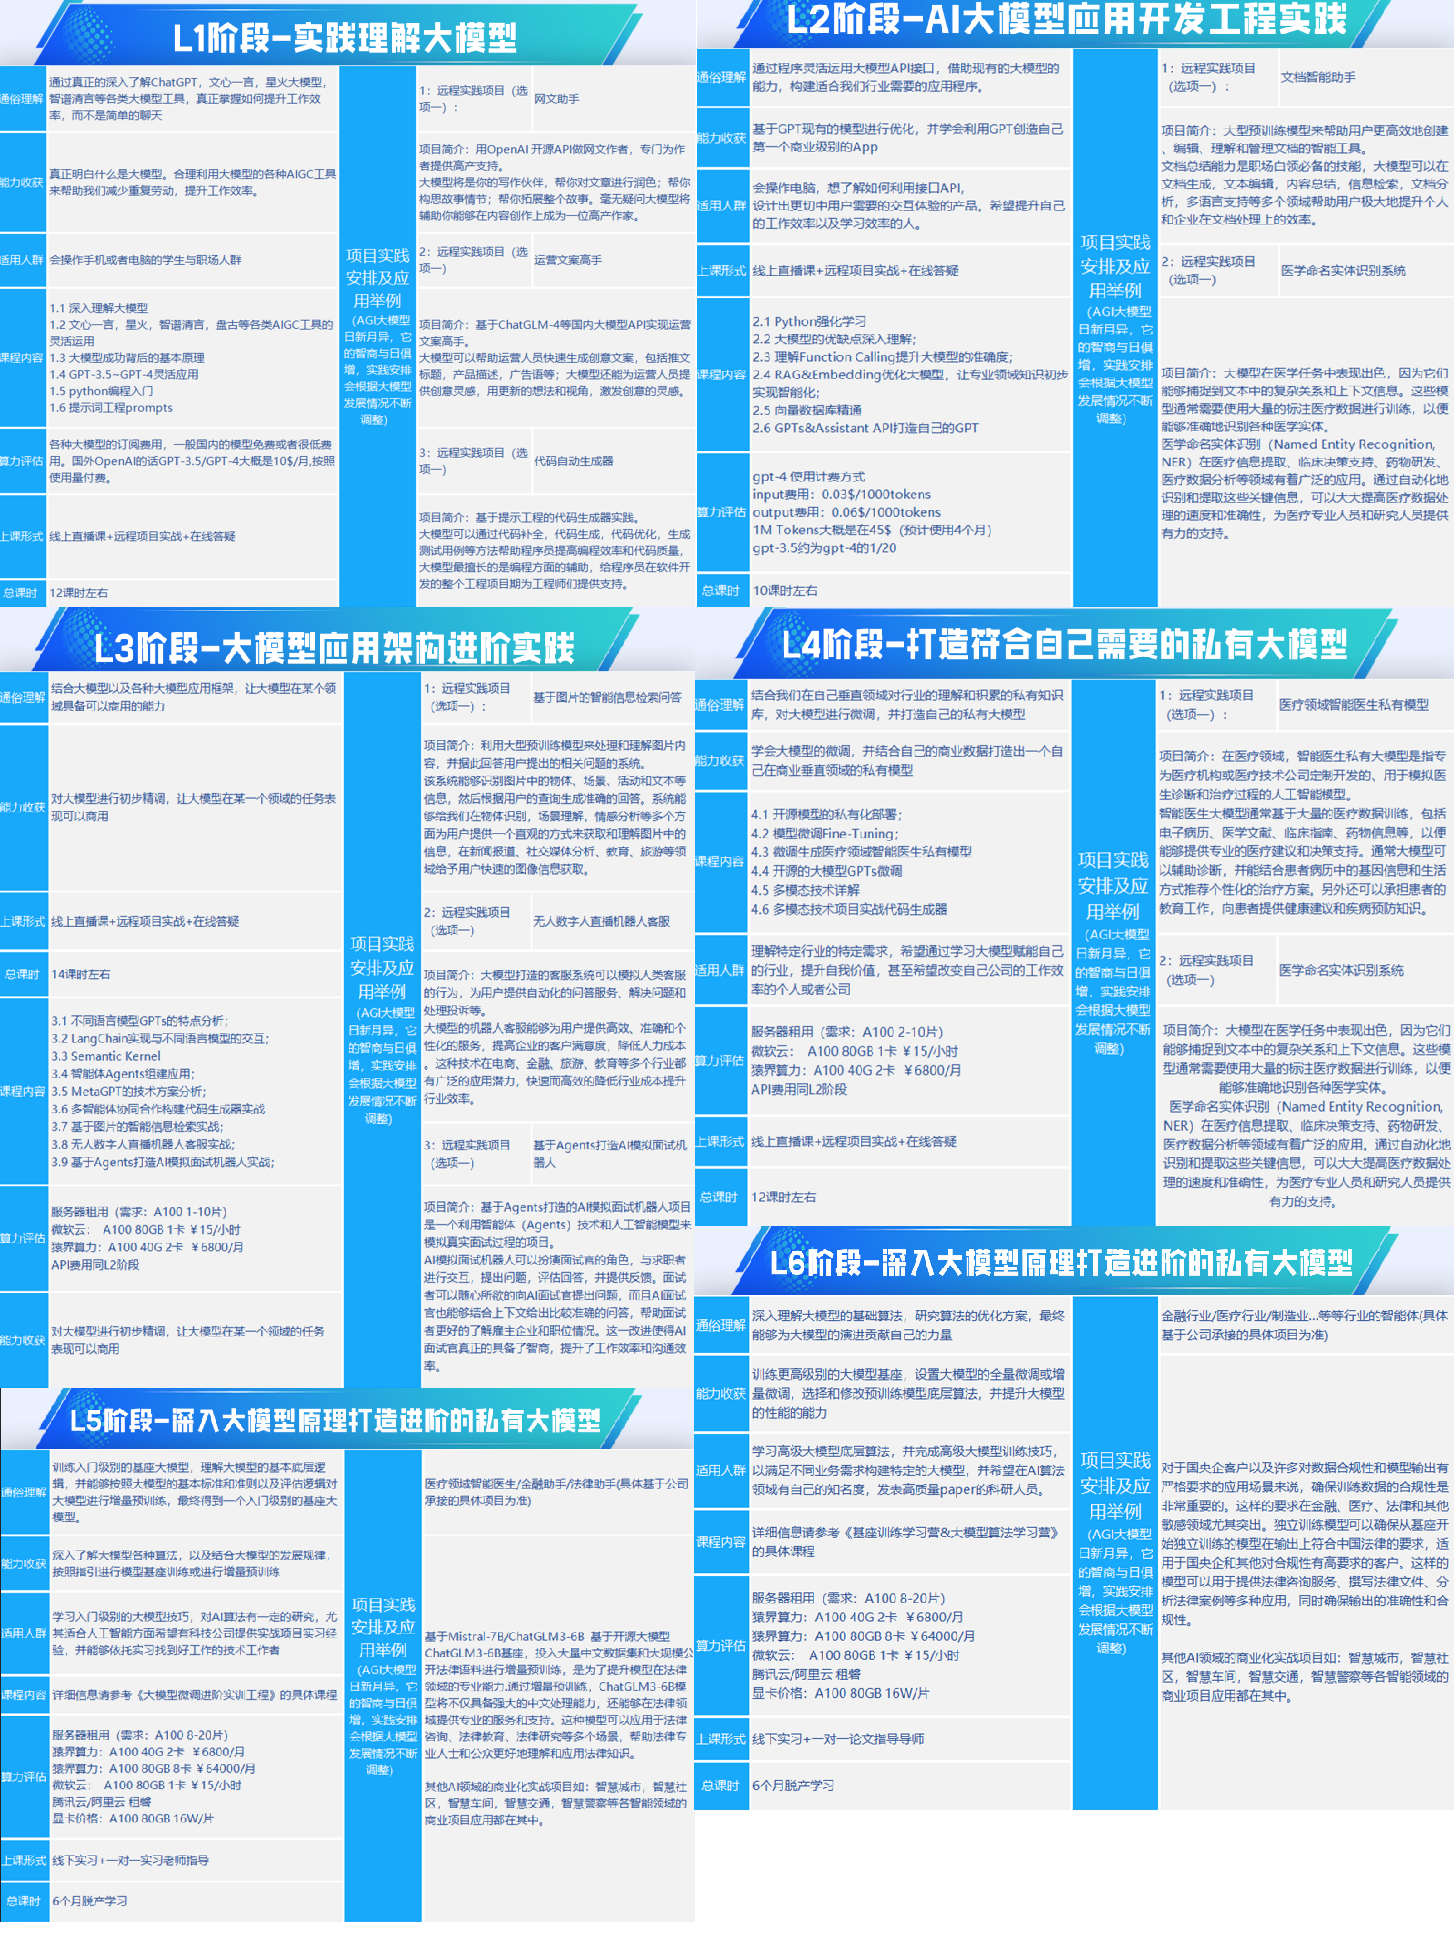
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
img

三、AI大模型经典PDF籍

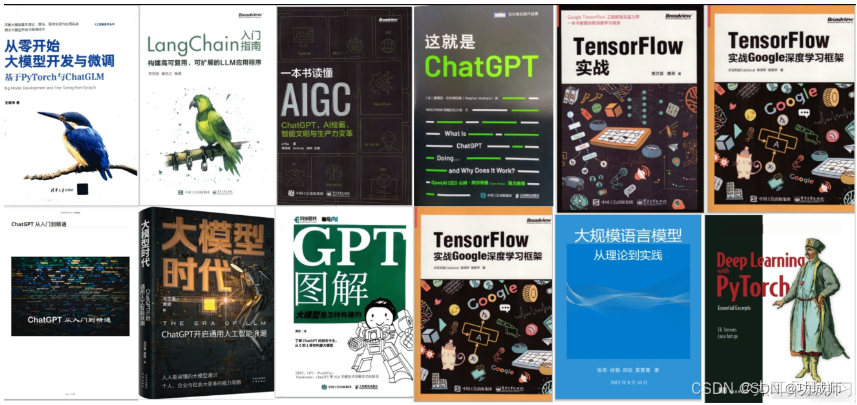
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。 img
外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传

四、100+套大模型面试题库

在这里插入图片描述

五、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

简话 RAG 本地部署(DeepSeek + RAGFlow) RAG = DeepSeek + OLlama + Docker + RAGFlow + Windows 11 简话 RAG 本地部署 阅读详情

相关推荐

本地大模型5:在pycharm用python调用ollama本地大模型

python调用ollama本地大模型

weixin_74825941的博客 8377

TensorFlow相关组件的安装

TensorFlow相关组件的安装

AAI666666的博客 3942

傻瓜操作:GraphRAG、Ollama 本地部署及踩坑记录

这里按惯例介绍一下 GraphRAG (其实就是水字数,大部分是 GPT 写的)这是我踩的最大的坑,折腾了两个小时。原因是一些模型无法生成有效的 json 输出,将 settings.yaml 中的 model_supports_json 选项设为 false 仍然无法解决。后来改用 mistral 模型就很顺利。所以请注意你的模型。

lintong的博客 1万+

GraphRAG + Ollama 本地部署全攻略:避坑实战指南

▼最近直播超级多,预约保你有收获—1—为什么要对 GraphRAG 本地部署?微软开源 GraphRAG 后,热度越来越高,目前 GraphRAG 只支持 OpenAI 的闭源大模型,导致部署后使用范围大大受限,本文通过 GraphRAG 源码的修改,来支持更广泛的 Embedding 模型和开源大模型,从而使得 GraphRAG 的更容易上手使用。如果对 GrapRAG 还不太熟悉的同学,可以看...

musicml的博客 8925

RS485 MODBUS转PROFINET网关案例丨汇川变频器接入到1200 PROFINET

本案例介绍的是用北京小疆智控(北京)技术有限公司生产的GW-PN5003型MODBUS RTU转PROFINET网关将汇川变频器接入西门子PLC1200 PROFINET网络的使用方法。

bjxjzk的博客 1891

CentOS7下Graylog3.0高效日志管理:从零搭建到实战应用

本文详细介绍了在CentOS7操作系统上从零开始搭建Graylog3.0日志管理平台的完整过程。内容涵盖Java环境准备、MongoDB与Elasticsearch依赖安装、Graylog Server核心配置,并实战演示了通过Graylog Sidecar集中管理日志采集器以及配置邮件告警功能,为中小型团队提供了一个比ELK更轻量、易维护的一体化日志解决方案。

weixin_29207149的博客 88

Pycharm+Ollama+LM Studio:5分钟内学会Graphrag本地部署

通过搭建GraphRAG本地demo后,笔者通过少量的文本内容(三国演义第一章),初略对比了一下传统RAG方案与GraphRAG方案,基于少量文本内容而言,GraphRAG的效果还是符合其宣传内容的,后续更严谨的测试还是需要海量数据的进行验证。希望本文能帮助到对GraphRAG有兴趣的朋友,毕竟读万卷书不如行万里路,看再多的理论介绍,不如自己亲自去动手验证一把来的实在~

m0_63171455的博客 3361

PyCharm中Matplotlib中文显示问题的终极解决方案

本文详细解析了PyCharm中Matplotlib中文显示问题的根本原因,并提供了从简单三行代码到深入配置的多套解决方案。针对Windows、Mac和Linux不同系统环境,分别推荐了最优字体配置方案,同时涵盖了PyCharm特定环境下的后端设置、字体路径指定等高级技巧,帮助开发者彻底解决中文乱码问题。

weixin_28221501的博客 306

【AI大模型】5分钟手把手系列(二):本地部署Graphrag

通过搭建GraphRAG本地demo后,笔者通过少量的文本内容(三国演义第一章),初略对比了一下传统RAG方案与GraphRAG方案,基于少量文本内容而言,GraphRAG的效果还是符合其宣传内容的,后续更严谨的测试还是需要海量数据的进行验证。希望本文能帮助到对GraphRAG有兴趣的朋友,毕竟读万卷书不如行万里路,看再多的理论介绍,不如自己亲自去动手验证一把来的实在~如果你对AI大模型应用感兴趣,这套大模型学习资料一定对你有用。

顶峰 1266

《Hadoop大数据技术原理与应用》(第2版)黑马程序员的课后习题答案

《Hadoop大数据技术原理与应用》(第2版)黑马程序员的课后习题答案

qq_36773158的博客 4656

华为OD机试真题 2026-9-2【查找幸运数】

华为OD机试真题 新系统【查找幸运数】,提供C语言、Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解,以及在线OJ模拟做题。华为OD机试真题 【查找幸运数】多语言题解。

qq_45776114的博客 507

GraphRAG本地部署(Xinference本地模型)+ neo4j可视化

模型供应商可以选择ollama,Xinference等供应商,也可以用我们本地api封装的大模型。

2303_78780633的博客 6832

学Simulink——基于故障诊断与容错控制的场景实例:并网逆变器在短路故障下的动态响应及恢复策略

本文详细介绍了使用Simulink进行并网逆变器短路故障模拟与保护策略设计的方法。通过构建高精度逆变器模型,模拟IGBT击穿和桥臂直通故障,分析动态响应特性。重点设计了基于Stateflow的微秒级快速保护逻辑,包括过流检测、PWM闭锁和故障报警。同时提出完整的恢复策略流程,涵盖放电、去磁、自检和软启动等关键步骤。仿真结果表明,该方法能在200μs内有效限制短路电流,保护器件安全,并实现系统可靠恢复。文章还探讨了硬件保护协同、多级保护和预测保护等高级策略,为新能源系统的安全运行提供了重要参考。

amy_mhd的博客 144

GraphRAG+Ollama 本地部署,保姆教程,踩坑无数,闭坑大法

最近RAG热度不减,微软开源了GraphRAG,很是火爆呀,本着学习的态度,我也部署使用了一下,无奈没有梯子,不能用openAI,于是想着能不能使用本机的模型,替换openAI的 llm和embedding模型,说干就干,整个过程真是曲折,踩坑不少,但最终 结果还是好的,终于完美部署到本机使用了,哈哈,下面来给大家分享一下,自己也记录一下,以免后边再使用时重复进坑。本人也搞了一个RAG项目,非常适合学习,自用,二次开发,欢迎stargraphRAG的安装还是很简单的,直接pip。

xx_nm98的博客 1万+

让 ABAP Screen Variant 安稳上车:SHD0 与 SHD0_MANDT 的 Transport 全攻略

摘要: SAP项目常需优化交易码界面,通过SHD0的Transaction Variant和Screen Variant可实现字段精简、默认值预设及权限控制,避免修改标准代码。但跨系统迁移时易出现变式丢失或版本兼容问题。核心概念包括: Screen Variant:针对单个屏幕的字段属性配置(跨Client); Transaction Variant:串联多屏幕变式(分跨Client和Client-specific); 版本差异:4.70/6.x后需区分SHD0(跨Client)与SHD0_MANDT(Cl

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 230

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

ollama轻松部署本地GraphRAG(避雷篇)

本篇文章主要介绍如何使用ollama本地部署微软的Graph RAG,,Graph RAG成为RAG一种新范式,对于全局总结性问题表现突出,由ollama一站式解决。但是中间也出现非常多的问题,比如Columns must be same length as key。跟着本篇文章使用ollama+mistral-nemo+mxbai-embed-larg`实现本地的GraphRAG的部署!

weixin_63866037的博客 1万+

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

【速成】LLM大模型学习路径指南

大家好!整理了一些我的大模型学习路线和参考资料,供初学者入门了解和实践LLM大模型算法学习路径LLM发展历程入门系列进阶系列计算资源云服务器:t讯云/a里云/火s引擎 GPU云服务器资源,按量每小时约10元本地服务器:单卡/多卡训练,最低6G显存,4090可媲美A100显卡项目应用实践SFT微调:QA数据集构建、Chat基座微调RAG知识库问答:知识库解析、向量检索、LLM生成Agent智能体:workflow定义、tools构建、function call模型训练。

m0_63171455的博客 1321

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

本地大模型部署和基于RAG方案的私有知识库搭建

以上就是本地大模型部署和基于RAG方案的私有知识库搭建的基本操作。除此之外,还有更多丰富有趣的功能等待探索。如今大模型遍布各行各业、各个领域,基于RAG方案的私有知识库技术也逐渐发展,成为提升个人工作效率与创造潜能的新风尚。本地部署模型意味着用户能在自己的设备上享受即时响应的智能辅助,无需依赖云端,既保护了个人数据隐私,又确保了操作的低延迟与高可靠性。结合RAG方案的私有知识库,则让每位用户能够构建专属自己的知识宇宙。

youmaob的博客 2692

GraphRAG开发指南:从环境配置到项目部署

本文全面介绍了GraphRAG(Graph-based Retrieval Augmented Generation)项目的开发流程。我们将从环境配置、项目结构、开发工具等多个维度,深入解析如何高效地进行GraphRAG项目的开发工作。通过本文,您将掌握GraphRAG项目的开发最佳实践,以及如何解决开发过程中遇到的常见问题。完善的环境配置清晰的项目结构高效的开发工具完整的测试体系。

加入“Super Entity”,与全能开发团队共探AI智能体与数字人项目,开启前沿技术之旅。 1748

大模型 | GraphRAG + Ollama 本地部署全攻略:避坑实战指南

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

老皮的博客 6188

Ollama VS LmStudio,谁是本地化模型运行工具最佳

相较于ollama来讲,LMStudio定位是一个功能全面的闭源平台,拥有一系列强大的特性和简单易用的操作界面,提供了一套完整的工具组合,用于训练、评估和部署模型,既适合科研也适合实际应用环境。当前,越来越多的开发者投入到大模型开发中,其中面临一个比较大的痛点就是如何让模型运行在本地电脑上,这通常来自两个使用场景,一是方便在离线状态下进行大模型应用开发调试,另一个是能够开发一些不依赖于网络的本地化大模型应用。提供了一系列广泛的预训练模型:由于模型种类和构架的多样性,用户能根据其需求挑选到最合适的模型。

s_156的博客 8769

从零开始搭建RAG系统系列:一文搞懂RAG系统部署流程

将开发好的RAG系统部署到实际应用环境中,是使其发挥价值的关键一步。部署方案的选择通常取决于应用的规模、预期的并发量、对可用性和成本的考量等因素。本节将介绍两种常见的部署思路:本地部署(适用于快速验证和小型应用)和云平台部署(适用于生产环境)。

大模型研究中心 2471

实战微软新一代RAG:GraphRAG强大的全局理解能力,碾压朴素RAG?

大语言模型(LLM)是在大量数据上训练,但他们并不是在我们私有数据上训练,因此要想让LLM能够回答我们私有数据集上的问题,我们就得使用一种叫做检索增强生成(RAG)的技术。它的基本原理是加载我们的文档,然后将每个文档按照一定的规则,比如Token数量、字符数量、语义和层次分割等,将每个文档拆分为一个一个小片段(chunk)。然后使用嵌入技术对这些chunk生成embeding,存储到高维向量数据库中,生成索引Index。

Python_cocola的博客 5226

幻X2025基于LM Studio+LangChain本地部署RAG

本文使用ROG幻x2025电脑,实战演练基于LM Studio快速本地部署RAG,演练构建企业内部知识库、产品问答系统 等应用,实战以下基本流程

huang9604的博客 2065
上一篇: 5分钟手把手系列(一):使用Mac Book Pro本地部署大模型(Ollama+Llama3.1_8B+Docker+OpenWebUI)
下一篇: 一书直接讲透自然语言处理《Getting Started with Google BERT_ Build and train》
少喝冰美式
博客等级 码龄3年 6847粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值