Transformers是如何学习基本的加减乘除的?

开放权重模型强化学习微调实战:从GRPO原理到工程落地 大模型微调正在从监督微调(SFT)向强化学习(RL)演进。SFT能教会模型模仿格式,却难以突破策略探索与泛化能力。RL微调通过奖励信号驱动模型自主优化,成为数学推理、代码生成与Agent决策等场景的关键技术。本文先梳理策略梯度、PPO与GRPO等核心算法原理,再对比TRL、OpenRLHF等主流开源框架的选型要点。针对开放权重模型(如Qwen2.5-7B),给出基于TRL的GRPO微调完整案例,覆盖数据准备、奖励函数设计、LoRA配置与训练脚本编写,并汇总显存不足、奖励崩溃、过拟合等高频问题的排查思路。无论 阅读详情

数学,特别是算术,本质上是由一系列简单的函数构成,这些函数可以看作是特定的模式。而Transformer模型则是一个强大的模式识别系统,它通过对输入和输出的关系进行建模,试图学习并复现这些模式。因此,训练Transformer模型来执行基本的数学运算是一个非常有趣的尝试。

概念验证

算术运算通常非常简洁,每个算式的长度通常不会超过17个字符,而Transformer的嵌入层具备足够的表达能力来处理这些简短的算式。在初步的实验中,使用了一个包含200万参数的Transformer模型,目标是让模型学习最基础的“加1”运算。

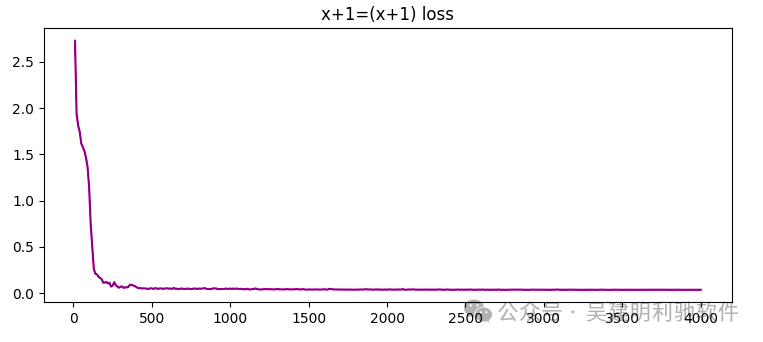
实验结果非常出色。在训练的前10步,损失值就从初始的高值下降到0.0425,经过100步后,损失值稳定在0.03左右,几乎达到了理想状态。这表明Transformer能够迅速掌握简单的算术规律。

以下是模型在训练过程中生成的一些加1示例:

4719+1=4720
4720+1=4721
4721+1=4722
4722+1=4723
4723+1=4724
4448+1=4449
4449+1=4450
4450+1=4451
4451+1=4452
4452+1=4453
4453+1=4454
img

损失曲线

算术运算的进一步探索

在完成简单的“加1”运算并取得令人满意的结果后,实验进一步扩展至更复杂的算术操作,包括加法、减法、乘法和除法。每种算术操作均使用了规模庞大的数据集(1亿个示例)进行训练,以下是对不同算术运算任务的训练结果及分析:

加法

加法任务的训练过程相比“加1”稍显复杂,损失值下降速度较慢,但在约5000步后趋于平稳,最终达到1.1。以下是模型在加法任务中的部分示例输出:

6719+6207=12926
9472+8559=18031
8079+3103=11182
9483+9138=18621
8133+6652=14785
5478+4446=9924
4076+3936=7012
1599+7550=9049
4721+7543=12264
8487+4040=12527
6258+8013=14271
4860+8373=13233
1286+8721=10007
298+9025=9323

观察:

  • • 大多数情况下,模型能够生成准确的加法结果,尤其是在小数值范围内表现优异。
  • • 随着数值变大或样本间存在复杂关系时,偶尔出现错误,但总体表现稳定且接近实际值。

减法

减法任务的训练表现略逊于加法,损失值收敛至约1.3,整体表现尚可。以下是一些示例输出:

4529 -2147=2382
8376-4298=4078
1208-987=221
6792-7456=-664  

观察:

  • • 减法结果大多正确,但偶尔会出现误差或符号问题。
  • • 适当调整数据分布或模型结构,可能进一步提升对负值与边界情况的处理能力。

乘法

在乘法任务中,模型的训练收敛较快,损失值在2000步时下降至约1.6,5000步后稳定在1.48。以下为部分训练结果示例:

680*258=173440 (真实答案是175440,差1位)
7412*2528=18716036
12*1307=9162084

观察:

  • • 模型在乘法任务上的表现令人惊喜,对大数计算的精度较高。
  • • 少量误差通常集中在个位或进位问题上,优化模型参数可能进一步改善精度。

除法

除法任务是所有算术运算中最具挑战性的,模型损失值在初期较高(约2.8),收敛速度显著慢于其他运算。以下是部分示例:

9137 ÷7041=1.2998
9636÷494=19.5
2498÷8702=0.287  

观察:

  • • 除法结果中,整数部分的表现尚可,但处理小数点后位数和精度时,模型显得不足。
  • • 浮点数学习难度较高,模型在除法任务中常生成噪声,尤其是在复杂分母场景下。

RASP vs Transformer

RASP (Random Access Sequence Processing) 是一种为 Transformer 提供解释性基础的简化编程模型,可以被视为适用于 Transformer 的图灵机。它强调对序列操作的灵活性,适用于构建和解释复杂的操作逻辑,如加法、减法等基本算术运算。

Transformer 是一种基于注意力机制的深度学习架构,广泛应用于自然语言处理和序列建模任务。尽管其强大的学习能力适用于许多复杂任务,但在某些数学运算(如精确的加减乘除)上,仍面临挑战,尤其是涉及精确条件分支(如借位、进位)时。

加法

加法的逻辑较为直观,主要通过以下步骤完成:

  1. \1. 序列反转:将数字序列从右至左排列,便于逐位计算。
  2. \2. 逐位求和:处理当前位的数值,并加上进位。
  3. \3. 处理进位:确保每位数字都在 0-9 范围内,额外的进位传递到更高位。
  4. \4. 反转结果:将结果反转回标准形式。

伪代码:

num1 = [1, 2, 3]  # 表示数字123
num2 = [4, 5, 6]  # 表示数字456
rev1 = reverse(num1)  # [3, 2, 1]
rev2 = reverse(num2)  # [6, 5, 4]
pairs = zip(rev1, rev2)  # [(3, 6), (2, 5), (1, 4)]
sum_digits = map(add, pairs)  # [9, 7, 5]
carry = 0
final_sum = []
for digit in sum_digits:
    digit += carry
    carry = digit // 10  # 获取进位
    final_sum.append(digit % 10)  # 获取当前位
result = reverse(final_sum)  # [5, 7, 9]

观察:

  • • RASP 实现难度:操作清晰,层次简单,易于通过直接逻辑完成。
  • • Transformer 表现:学习进位规则时表现较好,模型能够迅速收敛。

减法

减法需要额外考虑正负号和借位问题:

  1. \1. 比较大小:判断被减数与减数的大小,决定结果的正负号。
  2. \2. 逐位减法:从最低位开始,逐位减去,并处理借位。
  3. \3. 借位逻辑:如果当前位结果小于 0,则从更高位借 1,并调整当前位的值。

伪代码:

num1 = [1, 2, 3]
num2 = [4, 5, 6]
if num1 >= num2:
    sign = 1
    larger, smaller = num1, num2
else:
    sign = -1
    larger, smaller = num2, num1

rev_larger = reverse(larger)
rev_smaller = reverse(smaller)
diffs = map(sub, rev_larger, rev_smaller)  # [7, 7, 3]
borrow = 0
final_diff = []
for digit in diffs:
    digit -= borrow
    if digit < 0:
        digit += 10
        borrow = 1
    else:
        borrow = 0
    final_diff.append(digit)
if sign == -1:
    final_diff.append('-')
result = reverse(final_diff)

观察:

  • • RASP 难度:借位的逻辑复杂性较高,需通过显式状态跟踪完成。
  • • Transformer 表现:模型在捕获借位规则时可能遇到困难,损失收敛速度较慢。

乘法

乘法可以视为多次加法的扩展:

  1. \1. 逐位相乘:将被乘数的每一位与乘数的每一位相乘。
  2. \2. 处理进位:处理每次相乘后的结果进位。
  3. \3. 结果累加:将每次相乘的结果按照权重(位数)累加。

伪代码:

num1 = [1, 2, 3]
num2 = [4, 5, 6]
rev1 = reverse(num1)
rev2 = reverse(num2)
result = [0] * (len(rev1) + len(rev2))
for i, digit1 in enumerate(rev1):
    carry = 0
    for j, digit2 in enumerate(rev2):
        product = digit1 * digit2 + result[i + j] + carry
        result[i + j] = product % 10
        carry = product // 10
    result[i + len(rev2)] += carry
final_result = reverse(result)

观察:

  • • RASP 难度:需要嵌套的迭代操作,复杂度较高,但能通过明确逻辑实现。
  • • Transformer 表现:模型较易捕获重复加法的模式,因此乘法效果优于减法。

除法

除法是最复杂的运算,涉及多次减法、判断和商的累积:

  1. \1. 模拟长除法:通过多次减法模拟商的生成。
  2. \2. 判断条件:比较当前余数是否大于或等于除数。
  3. \3. 计算小数部分:在余数存在时,通过多次乘 10 的操作生成小数。

伪代码:

num1 = [1, 2, 3, 4]
num2 = [5, 6]
rev1 = reverse(num1)
rev2 = reverse(num2)
result = []
remainder = rev1
while remainder >= rev2:
    shift = len(remainder) - len(rev2)
    multiple = rev2 + [0] * shift
    remainder = map(sub, remainder, multiple)
    result.append(shift)
remainder = reverse(remainder)
if remainder:
    result.append('.')  # 处理小数
    whilelen(remainder) > 0:
        remainder *= 10
        result.append(remainder // num2)
        remainder %= num2
final_result = reverse(result)

观察:

  • • RASP 难度:多层循环嵌套且需处理条件分支,逻辑极其复杂。
  • • Transformer 表现:模型对条件判断(如借位)和多分支路径学习效果较差,精度显著下降。

总体来看,RASP 的实现难度与 Transformer 的学习难度在某种程度上存在相似性。尽管 Transformer 对复杂运算(如除法)的学习能力有限,但相比于 RASP 的层数和操作步骤,Transformer 的局限性显得更为有趣。尤其是对于长除法和余数操作,Transformer 可能由于数据中缺乏充分的显式逻辑提示,而难以正确学习这类任务。某些涉及会计逻辑的复杂任务,也加剧了这种挑战。

具体而言,在代码实现中,任务的复杂性大致呈现为:加法 > 减法 > 乘法 > 除法;

而对于 Transformer 的学习表现,则更倾向于:加法 > 乘法 > 减法 > 除法。

这表明,Transformer 在处理反向逻辑时(如减法中的借位机制,相当于反向的进位)会遇到明显障碍。此外,长除法中包含的大量条件分支(如 if/else 判断)和复杂的操作步骤,使得低层 Transformer 更难以准确推导出计算规律。

结论

通过对Transformer模型的训练和实验,可以看出,在处理加法、减法和乘法等基本算术任务时,Transformer能够取得令人满意的结果。

然而,除法操作仍然是一个挑战,模型在这类运算上表现较差,主要原因在于浮点数运算和除法中产生的复杂性。

参考:https://vatsadev.github.io/articles/transformerMath.html

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

数据分析实战:从模型构建到评估的完整机器学习闭环 机器学习是数据科学的核心技术,其本质是让计算机从数据中自动学习规律并进行预测或决策。其基本原理是通过算法构建模型,发现特征与目标变量之间的映射关系。这项技术的核心价值在于将原始数据转化为可行动的洞察,驱动智能化决策。在实际应用中,从客户流失预测到销量预估,机器学习模型已成为业务优化的关键引擎。要构建一个有效的模型,必须遵循一个严谨的闭环流程:从清晰的问题定义与数据准备开始,这包括至关重要的数据集划分,以防止数据泄露;接着进行模型选择与初步训练,例如使用随机森林或逻辑回归作为基线;然后通过精确率、召回率、F1 阅读详情

相关推荐

【推理优化】Transformers 快速回炉:推理工程师必须懂的架构细节

本文摘要: Transformer架构彻底改变了序列建模范式,通过自注意力机制解决了RNN的长程遗忘和并行性问题。核心创新在于:1)用O(n²)计算复杂度换取完全并行的训练能力;2)每个token直接关注全局上下文;3)推理时通过KV缓存优化生成效率。Transformer由五个关键模块组成:嵌入层处理离散符号、多头注意力实现token间交互、FFN增强表达能力、LayerNorm稳定训练、残差连接保障梯度流动。该架构使模型能够处理超长上下文(如GPT-4的128K窗口),同时保持高效的并行计算特性,成为大

ruiqideng的博客 290

从零实现Transformer的简易版与强大版:从300多行到3000多行

transformer强大到什么程度呢,基本是17年之后绝大部分有影响力模型的基础架构都基于的transformer(比如,有200来个,包括且不限于基于decode的GPT、基于encode的BERT、基于encode-decode的T5等等)通过博客内的这篇文章《》,我们已经详细了解了transformer的原理(如果忘了,建议先务必复习下再看本文)

结构之法 算法之道 5万+

【AI大模型进阶】第一天:别怕!用你小学二年级的语文水平,彻底搞懂什么是“大模型”

AI大模型入门指南:用小学语文水平理解"超级聪明小学生" 本文用生活化比喻和极简代码,帮助零基础读者理解AI大模型。核心观点: 大模型本质是一个"博览群书的小学生",通过阅读海量文本自学语言规律,而非依赖预设规则; 工作原理是"逐字猜词":根据输入内容预测下一个字的概率,逐步生成完整回答; 与传统程序不同,大模型具有通用性,能处理写作、翻译、编程等多种任务; 包含两个可直接运行的代码示例(本地轻量模型和在线API调用),让读者亲手体验; 纠正常见误区:大模型没有真正的思考能力,参数大小并非绝对标准,存在"幻

unber的博客 154

Transformer详解学习

拼接相加都可以,只是本身词向量的维度512维就已经蛮大了,再拼接一个512维的位置向量,变成1024维,这样训练起来会相对慢一些,影响效率。两者的效果是差不多地,既然效果差不多当然是选择学习习难度较小的相加了。Transformer 的 Decoder的输入与Encoder的输出处理方法步骤是一样地,一个接受source数据,一个接受target数据,对应到上面例子里面就是:Encoder接受英文"Tom chase Jerry",Decoder接受中文"汤姆追逐杰瑞"。

二十年蝉电子学习博客 887

HFSS - 侧馈矩形微带天线设计与仿真

一、设计指标 中心频率:2.45GHz 介质板厚度:1.6mm 介质板相对介电常数:4.4 二、理论计算 辐射贴片宽度w=c2f(εr+12)−12w=\frac{c}{2 f}\left(\frac{\varepsilon_{r}+1}{2}\right)^{-\frac{1}{2}}w=2fc​(2εr​+1​)−21​ 辐射贴片长度L=cfεe−2ΔLL=\frac{c}{f \sqrt{\varepsilon_{\mathrm{e}}}}-2 \Delta LL=fεe​​c​−2ΔL

MaxWei 1万+

7系列ZYNQ硬件调试:Vitis无法识别ARM DAP的排查与解决

本文针对7系列ZYNQ开发中Vitis无法识别ARM DAP的典型硬件调试问题,提供了系统性的排查与解决方案。文章深入剖析了问题本质,指出ARM DAP无法访问的核心原因在于PS部分的电源、时钟或复位等硬件基础条件未满足,并重点强调了PS参考时钟(如33.333MHz晶振)的完整性是关键排查点。通过从电源完整性、时钟与复位信号到JTAG连接与焊接的逐步硬件排查,并结合软件配置交叉验证,为开发者提供了清晰的故障定位思路与实战指南。

weixin_29280657的博客 626

关于深度学习和大模型的基础认知

这年头,作为一个技术人,话头里没有“大模型”,和人聊天都聊不下去。为了让自己和大家能更好的参与话头,特撰写此文,提供一些对大模型的基础认知能力(门外汉,浅尝辄止)。旨在解自己的一些困惑,比如,模型是什么意思?千亿/万亿参数意味着什么?为什么大模型如此耗费算力?什么是机器学习?关于什么是机器学习,李宏毅老师在其课程中说地很精辟,即 机器学习 ≈ 机器自动找一个函数f( )函数(function)就是...

我的新书《代码精进之路:从码农到工匠》 9769

OAI骨关节炎数据集申请与DICOM下载全流程避坑指南

医学影像分析中,DICOM格式是存储与交换CT、MRI等数据的通用标准,其元数据Tag承载着像素间距、层厚等关键物理信息,直接影响定量分析的准确性。在骨关节炎研究领域,OAI数据集因样本量大、随访时间长而成为高价值资源,但获取需通过NDA协议申请,并借助nda-tools命令行工具完成TB级影像的批量下载与断点续传。这一流程涉及浏览器环境配置、DICOM格式转换及Python预处理等工程环节,任一细节疏漏都可能导致数据读取异常或分析偏差。掌握从申请到落地的完整链路,能显著提升医学影像AI研究的效率与可复现性

weixin_30843121的博客 276

Transformers学习笔记1. 一些基本概念和编码器、字典

Hugging Face是一家纽约的聊天机器人初创服务商,他们开源了Transformers库,并在开源社区大火起来,其官网地址: https://huggingface.co/自回归:GPT2, Transfoer-XL, XLNet自编码:BERT, ALBERT, RoBERTa, ELECTRATransformers是一个NLP自然语言处理库。开源地址:文档地址:教程地址:T5 modelBert modelXLM model。

猿来这样-谢厂节的博客 1829

STM32独立实现CANOpen主机功能:从零构建轻量级控制方案

本文详细介绍了如何在STM32上不依赖CanFestival库,从零构建一个轻量级的CANOpen主机方案。文章深入剖析了CANOpen主机的三大核心功能——NMT网络管理、SDO参数配置与PDO过程数据交换,并提供了从硬件准备、驱动层构建到协议实现的完整代码实战。该方案代码精简,资源占用低,特别适合在资源受限的STM32平台上实现工业控制、电机驱动等场景的稳定通信。

potato的博客 1072

第1.1节 构网型 vs. 跟网型:根本区别与技术原理

构网型与跟网型变流器的本质区别在于控制哲学与等效模型。跟网型变流器采用"电压跟随,电流注入"策略,等效为受控电流源,依赖电网电压作为参考,在弱电网下存在稳定性问题。构网型变流器采用"自主同步,电压构建"策略,等效为受控电压源,能主动构建电压和频率,具备自主运行、黑启动和电网支撑能力。两者的核心差异体现在同步机制、电网依赖性、故障行为和系统支撑等方面。构网型变流器更适合高比例新能源、弱电网和微电网场景,是未来电力系统的重要发展方向。

技术工作者 1395

这次终于能把Transformer弄清楚了!

本文将深入探讨Transformer架构,这是当今几乎所有尖端大型语言模型架构的核心组成部分。首先,我们将简要回顾一些与自然语言处理(NLP)相关的基本概念,随后逐步解析Transformer的工作原理。:本文适合对自然语言处理(NLP)感兴趣的任何人阅读。:尽管本文并不复杂,但由于涉及众多概念,可能对新手来说有一定的难度。:为了更好地理解本文内容,大家需要对标准神经网络有基本的工作理解,还需要对嵌入、编码器和解码器有初步认识。

m0_59235699的博客 1220

ROSTCM6+Gephi的网络语义分析详细教程(附案例实战)

ROSTCM6是武汉大学沈阳教授研发编码的国内目前唯一的以辅助人文社会科学研究的大型免费社会计算平台。该软件可以实现微博分析、聊天分析、全网分析、网站分析、浏览分析、分词、词频统计、英文词频统计、流量分析、聚类分析等一系列文本分析。Gephi是一款开源免费跨平台基于JVM的复杂网络分析软件,可用于各种图形和网络的可视化和探索,是最受欢迎的网络可视化软件之一。

m0_64336780的博客 1万+

Transformers库-入门-Pipeline实践

《Transformers库入门到熟悉》系列教程摘要:文章介绍了第四章至第六章的核心内容,包括Transformers库的pipeline应用(情感分析、文本生成等7类任务)、模型与分词器的使用(7种模型结构及分词策略),以及必备PyTorch知识(张量操作、自动微分等)。重点讲解了pipeline的预处理-模型处理-后处理流程,模型加载/保存方法,分词器的3种策略,以及PyTorch的数据加载、模型训练流程。最后附有代码示例和互动邀请,强调用户反馈对内容优化的重要性。全文涵盖NLP任务实现的关键技术点,适

乐于创作,乐于分享,志于创作高价值博文 1070

HMC7044调试指南与FPGA开发

最后,我们介绍了在FPGA开发中使用HMC7044的几个常见应用场景,包括时钟分配、时钟同步、高精度时钟生成和时钟域交叉。根据您的应用需求,您可以选择不同的时钟分配方案,例如使用PLL生成特定频率的时钟信号,或者通过分频器生成较低频率的时钟信号。HMC7044可以提供精确的时钟同步功能,确保各个FPGA板之间的时钟信号保持一致,从而实现可靠的数据传输和协同操作。HMC7044可以实现时钟域之间的交叉,通过生成和分配不同频率的时钟信号,使得不同时钟域的模块能够协同工作。FPGA开发中的HMC7044应用。

CqpFsharp的博客 3619

23、电生理与CSD分析:探索大脑活动的前沿技术

本文介绍了电生理与电流源密度(CSD)分析在探索大脑活动中的前沿应用。从电生理技术的发展现状,到局部场电位(LFPs)的起源与解释,重点阐述了CSD分析的原理、实验方法及其在绘制皮层兴奋流、解析突触输入和研究自发振荡中的广泛应用。文章还总结了该领域的优势与挑战,并展望了技术改进、多模态融合、数据分析创新及临床拓展的未来方向,展示了这些技术在揭示大脑功能机制中的关键作用。

Apple的专栏 121

CUDA、PyTorch、TorchVision、Transformers与vLLM的作用、依赖及版本问题解析

深度学习工具链解析:CUDA、PyTorch、TorchVision、Transformers与vLLM构成了一套完整的深度学习技术栈。CUDA是底层GPU计算基础,PyTorch提供核心计算框架,TorchVision专注计算机视觉任务,Transformers支持NLP大模型开发,vLLM优化大模型推理性能。这些组件相互依赖,版本需严格匹配,如vLLM 0.8.5可能自动安装最新版Transformers 5.2.0。理解各组件的功能定位和版本关系,对构建稳定高效的深度学习环境至关重要。

小虾米 1964

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

LLM论文笔记 12: Teaching Arithmetic to Small Transformers

观察到算数运算(加减乘除开根)上简单微调NTP是次优的(如加法123+456=579第一个预测的结果位是5,但是5由7和9决定),提出。注:本系列不包括基础的知识点讲解,为笔记/大纲性质而非教程,用于论文知识点和思想和快速记忆和回顾,更多细节建议阅读论文原文。3. 泛化能力:对训练中未见的数值表现出一定的泛化能力,但对未训练的更长位数加法的泛化能力有限(基本没有长度泛化)->还发现了平衡不同位数和进位的sample显著提高性能。格式(CoT)可以显著提高精确度,cot可以显著减小需要的训练数据量。

m0_65305142的博客 460

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

诸神缄默不语-个人技术博文与视频目录

诸神缄默不语的优快云博文目录

诸神缄默不语的博客 1万+

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

《Accelerating Private Large Transformers Inferencethrough Fine-grained Collaborative Computation》笔记

总之,这是在特定安全模型下,一种“简化流程、提升整体效率”的优化,牺牲了部署的灵活性(必须是三方)来换取性能。它将一个复杂的向量内积或卷积运算,直接映射成了一次原生的多项式乘法,这样可以直接利用HE的乘法,结果多项式的系数里就包含需要的结果,避免了复杂的旋转操作。在线阶段,双方只需进行极少量、轻量级的通信,然后所有计算都是本地完成的,计算压力转移到了离线阶段。预计算均值/方差:如果处理的数据有规律,可以拿公开数据事先算好一个固定的均值和方差存起来,推理时直接用,就把动态计算转为了静态常量。

m0_65356559的博客 412

PyTorch张量运算与自动微分

由Facebook人工智能研究院于2017年推出,具有强大的GPU加速张量计算功能,并且能够自动进行微分计算,从而可以使用基于梯度的方法对模型参数进行优化,大部分研究人员、公司机构、数据比赛都使用PyTorch。

qq_35328355的博客 1229

【4】Transformers快速入门:自然语言模型 vs 统计语言模型

(就像加减乘除是数学的基础,统计模型是AI学说话的基础工具)自然语言模型 = 智能手机(能聊天打游戏):判断“银行”指金融机构还是河边。统计模型 = 算盘(只能加减)

叫好与叫座虽然不是对立面,但想在同一个作品中达到双重效果很难。 636

2026 最新 Python+AI 从零搭建人工智能项目全攻略

📝 本章学习目标:本教程专为 2026 年零基础学习者打造,从 Python 基础语法入手,系统覆盖 AI 核心工具库、机器学习、大模型应用开发,最终带你从零搭建完整 AI 项目。全程无晦涩数学、无前置要求,,学完即可独立开发 AI 应用、胜任 AI 开发入门岗位。文章标签:#Python #AI 入门 #人工智能 #大模型 #机器学习 #零基础教程。

qq_28372005的博客 638

Qwen3-0.6B-FP8极速对话工具:Python入门与模型调用教程

本文介绍了如何在星图GPU平台自动化部署⚡ Qwen3-0.6B-FP8极速对话工具镜像,实现高效的AI对话功能。该镜像适用于文本生成场景,如智能问答、文案创作和编程辅助,帮助用户快速构建本地对话应用,提升交互体验与工作效率。

weixin_35811662的博客 90

一周深度学习实战课:认知脚手架搭建与教学节奏控制

深度学习入门教学面临的核心矛盾,是知识复杂性与人类认知带宽的天然冲突。基于工作记忆容量限制(Miller定律)和神经网络可解释性需求,现代短周期AI课程必须从‘知识灌输’转向‘认知转译’——将反向传播具象为梯度流、把卷积核类比为图像滤镜、用Excel可视化损失曲面。这种以‘可操作、可观察、可修复’为准则的教学设计,本质上是面向零基础学习者的认知压缩工程,适用于高校短期选修课、企业AI通识培训及跨学科技术扫盲。本文聚焦真实课堂验证的72小时作战地图,覆盖数据加载、模型乐高化构建、梯度可视化、失败驱动评估与零配

dezhen7015的博客 457
上一篇: 智算与大模型人才白皮书(附完整PDF下载)
下一篇: 通过阿里云 Milvus 和 LangChain 快速构建 LLM 问答系统
少喝冰美式
博客等级 码龄3年 6839粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


