


01
背景介绍
阿里云向量检索服务 Milvus 版(简称阿里云 Milvus)是一款云上全托管服务,确保了与开源 Milvus 的100%兼容性,并支持无缝迁移。在开源版本的基础上增强了可扩展性,能提供大规模 AI 向量数据的相似性检索服务。相比于自建,目前阿里云 Milvus 具备易用性、可用性、安全性、低成本与生态优势。凭借其开箱即用的特性、灵活的扩展能力和全链路监控告警,阿里云Milvus 云服务成为多样化 AI 应用场景的理想选择,包括多模态搜索、检索增强生成(RAG)、搜索推荐、内容风险识别等。您还可以利用开源的 Attu 工具进行可视化操作,进一步促进应用的快速开发和部署。
本文介绍如何通过整合阿里云向量检索服务 Milvus 版、阿里云百炼 DashScope Embedding 模型与阿里云 PAI(EAS)模型服务,构建一个由 LLM(大型语言模型)驱动的问题解答应用,并着重演示了如何搭建基于这些技术的 RAG 对话系统。
02
前提条件
已创建 Milvus 实例
进入阿里云 Milvus 页面【https://www.aliyun.com/product/milvus】,登录阿里云 Milvus 控制台【https://milvus.console.aliyun.com/#/overview】。并在左侧导航栏,单击 Milvus 实例,并继续创建实例。
已开通 PAI(EAS)并创建了默认工作空间
登录 PAI 控制台【https://pai.console.aliyun.com】,在左上角选择需要开通的地域后,进行认证、授权并开通服务,待开通成功后,便可进入控制台进行 AI 开发。
已开通百炼服务并获得 API-KEY
登陆阿里云百炼大模型服务平台【https://bailian.console.aliyun.com】,在页面右上角的下拉菜单中单击 API-KEY,进行创建。
03
使用限制
- Milvus 实例和 PAI(EAS)须在相同地域下。
- 请确保您的运行环境中已安装 Python 3.8 或以上版本,以便顺利安装并使用 DashScope。
04
方案架构
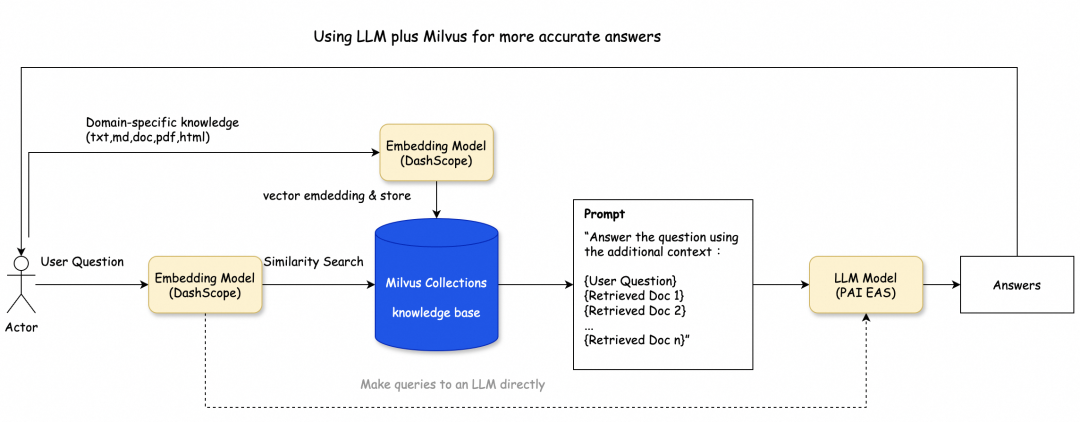
该方案架构如下图所示,主要包含以下几个处理过程:
- 知识库预处理: 您可以借助 LangChain SDK 对文本进行分割,作为 Embedding 模型的输入数据。
- 知识库存储: 选定的 Embedding 模型(DashScope)负责将输入文本转换为向量,并将这些向量存入阿里云 Milvus 中。
- 向量相似性检索: Embedding 模型处理用户的查询输入,并将其向量化。随后,利用阿里云Milvus的索引功能来识别出相应的 Retrieved 文档集。
- RAG(Retrieval-Augmented Generation)对话验证: 您使用 LangChain SDK,并将相似性检索的结果作为上下文,将问题导入到 LLM 模型(本例中用的是阿里云PAI EAS),以产生最终的回答。此外,结果可以通过将问题直接查询 LLM 模型得到的答案进行核实。
05
操作流程
步骤一:部署对话模型推理服务
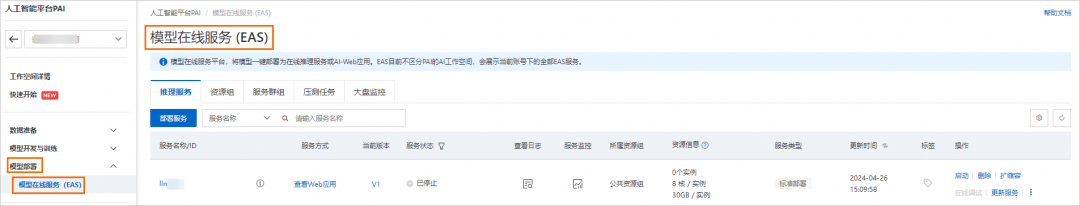
\1. 进入模型在线服务页面。
-
- 登录 PAI 控制台【https://pai.console.aliyun.com/】。
- 在左侧导航栏单击工作空间列表,在工作空间列表页面中单击待操作的工作空间名称,进入对应工作空间内。
- 在工作空间页面的左侧导航栏选择模型部署>模型在线服务(EAS),进入模型在线服务(EAS)页面。
\2. 在模型在线服务页面,单击部署服务。
\3. 在部署服务页面,选择大模型 RAG 对话系统。
\4. 在部署大模型 RAG 对话系统页面,配置以下关键参数,其余参数可使用默认配置,更多参数详情请参见大模型 RAG 对话系统【https://help.aliyun.com/zh/pai/user-guide/deploy-a-rag-based-dialogue-system】。
| 参数 | 描述 | |
|---|---|---|
| 基本信息 | 服务名称 | 您可以自定义。 |
| 模型来源 | 使用默认的开源公共模型。 | |
| 模型类别 | 通常选择通义千问7B。例如,Qwen1.5-7b。 | |
| 资源配置 | 实例数 | 使用默认的1。 |
| 资源配置选择 | 按需选择GPU资源配置。例如,ml.gu7i.c16m30.1-gu30。 | |
| 向量检索库设置 | 版本类型 | 选择 Milvus。 |
| 访问地址 | Milvus实例的内网地址。您可以在Milvus实例的实例详情页面查看。 | |
| 代理端口 | Milvus实例的Proxy Port。您可以在Milvus实例的实例详情页面查看。 | |
| 账号 | 配置为root。 | |
| 密码 | 配置为创建Milvus实例时,您自定义的root用户的密码。 | |
| 数据库名称 | 配置为数据库名称,例如default。创建Milvus实例时,系统会默认创建数据库default,您也可以手动创建新的数据库,具体操作,请参见管理Databases【https://help.aliyun.com/zh/milvus/user-guide/manage-databases】。 | |
| Collection名称 | 输入新的Collection名称或已存在的Collection名称。对于已存在的Collection,Collection结构应符合PAI-RAG要求,例如您可以填写之前通过EAS部署RAG服务时自动创建的Collection。 | |
| 专有网络配置 | VPC | 创建阿里云Milvus实例选择时的VPC、交换机和安全组。您可以在Milvus实例的实例详情页面查看。 |
| 交换机 | ||
| 安全组名称 |
\5. 单击部署。
当服务状态变为运行中时,表示服务部署成功。
\6. 获取 VPC 地址调用的服务访问地址和 Token。
-
- 单击服务名称,进入概览页面。
- 在基本信息区域,单击查看调用信息。
- 在调用信息对话框的 VPC 地址调用页签,获取服务访问地址和 Token,并保存到本地。
步骤二:创建并执行Python文件
\1. (可选)在 ECS 控制台创建并启动一个开通公网的 ECS 实例,用于运行 Python 文件,详情请参见通过控制台使用 ECS 实例(快捷版)【https://x.sm.cn/HT1aj0n】。
您也可以在本地机器执行Python文件,具体请根据您的实际情况作出合适的选择。
\2. 执行以下命令,安装相关依赖库。
pip3 install pymilvus langchain dashscope beautifulsoup4
\3. 执行以下命令,创建milvusr-llm.py文件。
vim milvusr-llm.py
milvusr-llm.py文件内容如下所示。
from langchain_community.document_loaders import WebBaseLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.vectorstores.milvus import Milvus
from langchain.schema.runnable import RunnablePassthrough
from langchain.prompts import PromptTemplate
from langchain_community.embeddings import DashScopeEmbeddings
from langchain_community.llms.pai_eas_endpoint import PaiEasEndpoint

# 设置Milvus Collection名称。
COLLECTION_NAME = 'doc_qa_db'

# 设置向量维度。
DIMENSION = 768

loader = WebBaseLoader([
'https://milvus.io/docs/overview.md',
'https://milvus.io/docs/release_notes.md',
'https://milvus.io/docs/architecture_overview.md',
'https://milvus.io/docs/four_layers.md',
'https://milvus.io/docs/main_components.md',
'https://milvus.io/docs/data_processing.md',
'https://milvus.io/docs/bitset.md',
'https://milvus.io/docs/boolean.md',
'https://milvus.io/docs/consistency.md',
'https://milvus.io/docs/coordinator_ha.md',
'https://milvus.io/docs/replica.md',
'https://milvus.io/docs/knowhere.md',
'https://milvus.io/docs/schema.md',
'https://milvus.io/docs/dynamic_schema.md',
'https://milvus.io/docs/json_data_type.md',
'https://milvus.io/docs/metric.md',
'https://milvus.io/docs/partition_key.md',
'https://milvus.io/docs/multi_tenancy.md',
'https://milvus.io/docs/timestamp.md',
'https://milvus.io/docs/users_and_roles.md',
'https://milvus.io/docs/index.md',
'https://milvus.io/docs/disk_index.md',
'https://milvus.io/docs/scalar_index.md',
'https://milvus.io/docs/performance_faq.md',
'https://milvus.io/docs/product_faq.md',
'https://milvus.io/docs/operational_faq.md',
'https://milvus.io/docs/troubleshooting.md',
])

docs = loader.load()

text_splitter = RecursiveCharacterTextSplitter(chunk_size=1024, chunk_overlap=0)

# 使用LangChain将输入文档安照chunk_size切分
all_splits = text_splitter.split_documents(docs)

# 设置embedding模型为DashScope(可以替换成自己模型)。

embeddings = DashScopeEmbeddings(
    model="text-embedding-v2", dashscope_api_key="your_api_key"
)

# 创建connection,host为阿里云Milvus的访问域名。

connection_args = {"host": "c-xxxx.milvus.aliyuncs.com", "port": "19530", "user": "your_user", "password": "your_password"}
# 创建Collection
vector_store = Milvus(
    embedding_function=embeddings,
    connection_args=connection_args,
    collection_name=COLLECTION_NAME,
    drop_old=True,
).from_documents(
    all_splits,
    embedding=embeddings,
    collection_name=COLLECTION_NAME,
    connection_args=connection_args,
)

# 利用Milvus向量数据库进行相似性检索。

query = "What are the main components of Milvus?"
docs = vector_store.similarity_search(query)
print(len(docs))

# 声明LLM 模型为PAI EAS(可以替换成自己模型)。

llm = PaiEasEndpoint(
    eas_service_url="your_pai_eas_url",
    eas_service_token="your_token",
)

# 将上述相似性检索的结果作为retriever,提出问题输入到LLM之后,获取检索增强之后的回答。

retriever = vector_store.as_retriever()

template = """Use the following pieces of context to answer the question at the end.
If you don't know the answer, just say that you don't know, don't try to make up an answer.
Use three sentences maximum and keep the answer as concise as possible.
Always say "thanks for asking!" at the end of the answer.
{context}
Question: {question}
Helpful Answer:"""
rag_prompt = PromptTemplate.from_template(template)

rag_chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | rag_prompt
    | llm
)

print(rag_chain.invoke("Explain IVF_FLAT in Milvus."))
以下参数请根据实际环境替换。
| 参数 | 说明 |
|---|---|
| COLLECTION_NAME | 设置Milvus Collection名称,您可以自定义。 |
| model | 模型名称。本文示例使用的Embedding模型(text-embedding-v2),您也可以替换成您实际使用的模型。有关Embedding的更多信息,请参见Embedding(https://help.aliyun.com/zh/model-studio/user-guide/embedding)。 |
| dashscope_api_key | 百炼的API-KEY。 |
| connection_args | “host”:Milvus实例的公网地址。您可以在Milvus实例的实例详情页面查看。“port”:Milvus实例的Proxy Port。您可以在Milvus实例的实例详情页面查看。**“user”:配置为创建Milvus实例时,您自定义的用户名。“password”:**配置为创建Milvus实例时,您自定义用户的密码。 |
| eas_service_url | 配置为步骤1中获取的服务访问地址。本文示例声明LLM模型为PAI(EAS),您也可以替换成您实际使用的模型。 |
| eas_service_token | 配置为步骤1中获取的服务Token。 |
\4. 执行以下命令运行文件。
python3 milvusr-llm.py
返回如下类似信息。
4
IVF_FLAT is a type of index in Milvus that divides vector data into nlist cluster units and compares distances between the target input vector and the center of each cluster. It uses a smaller number of clusters than IVF_FLAT, which means it may have slightly higher query time but also requires less memory. The encoded data stored in each unit is consistent with the original data.
如何学习大模型
现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。
作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。
下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线
很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

二、AI大模型视频教程

三、AI大模型各大学习书籍

四、AI大模型各大场景实战案例

五、结束语
学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。
再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。
因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。
 9531


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


