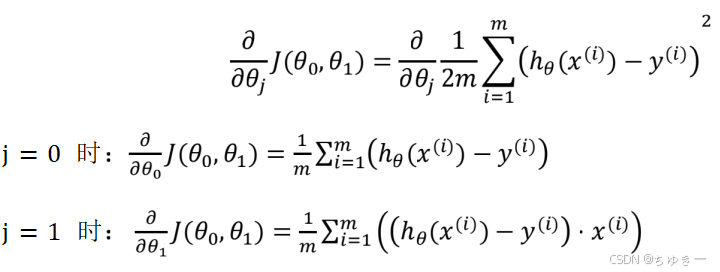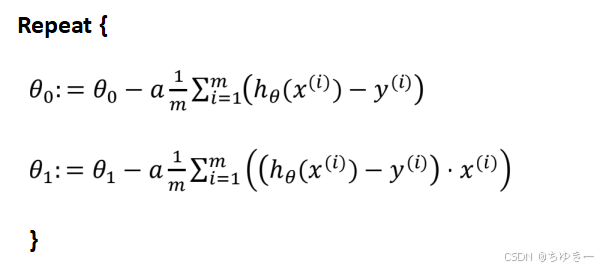吴恩达机器学习笔记:梯度下降

【算法】梯度下降 梯度下降算法是一种优化方法,用于最小化损失函数并找到模型参数的最佳值。其核心思想是通过迭代更新参数,沿着损失函数梯度的反方向逐步逼近最优解。在每次迭代中,算法计算损失函数相对于参数的梯度,然后根据设定的学习率调整参数值。梯度下降有多种变体,包括批量梯度下降(使用整个数据集计算梯度)、随机梯度下降(每次迭代使用单个样本)和小批量梯度下降(使用数据的小批量)。此外,动量法和自适应学习率算法(如Adam)可以提高收敛速度和稳定性。选择合适的梯度下降方法和调整超参数对于模型训练的效率和效果至关重要。 阅读详情

1.梯度下降

梯度下降是一个用来求函数最小值的算法,我们将使用梯度下降算法来求出代价函数 J(θ0, θ1) 的最小值。
梯度下降背后的思想是:开始时我们随机选择一个参数的组合(θ0, θ1, . . . . . . , θn ),计算代价函数,然后我们寻找下一个能让代价函数值下降最多的参数组合。
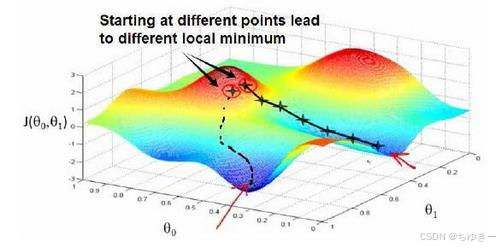
我们持续这么做直到到一个局部最小值(local minimum),因为我们并没有尝试完所有的参数组合,所以不能确定我们得到的局部最小值是否便是全局最小值(global minimum),选择不同的初始参数组合,可能会找到不同的局部最小值。
在这里插入图片描述
想象一下你正站立在山的这一点上,站立在你想象的公园这座红色山上,在梯度下降算法中,我们要做的就是旋转360度,看看我们的周围,并问自己要在某个方向上,用小碎步尽快下山。
这些小碎步需要朝什么方向?如果我们站在山坡上的这一点,你看一下周围,你会发现最佳的下山方向,走一步到达一个低一点的点,你再看看周围,然后再一次想想,我应该从什么方向迈着小碎步下山?然后你按照自己的判断又迈出一步,重复上面的步骤,从这个新的点,你环顾四周,并决定从什么方向将会最快下山,然后又迈进了一小步,并依此类推,直到你接近局部最低点的位置。

批量梯度下降(batch gradient descent)算法的公式为:
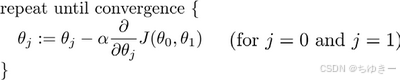
在这里插入图片描述
其中a是学习率(learningrate),它决定了我们沿着能让代价函数下降程度最大的方向向下迈出的步子有多大,在批量梯度下降中,我们每一次都同时让所有的参数减去学习率乘以代价函数的导数。
在这里插入图片描述
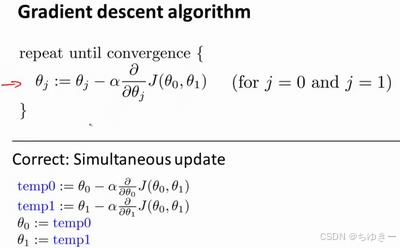
在梯度下降算法中,还有一个更微妙的问题,梯度下降中,我们要更新θ0和θ1,当j=0和j=1时,会产生更新,所以你将更新J(θ0)和J(θ1)。

实现梯度下降算法的微妙之处是,在这个表达式中,如果你要更新这个等式,你需要同时更新θ0和θ1,意思是在这个等式中,我们要这样更新:
先计算出右边的值,然后同时更新θ0和θ1

在梯度下降算法中,这是正确实现同时更新的方法。不用纠结为什么需要同时更新,同时更新是梯度下降中的一种常用方法。

2.直观理解

梯度下降算法如下:在这里插入图片描述
描述:对θ赋值,使得J(θ)按梯度下降最快方向进行,一直迭代下去,最终得到局部最小值。
其中a是学习率(learning rate),它决定了我们沿着能让代价函数下降程度最大的方向向下迈出的步子有多大。
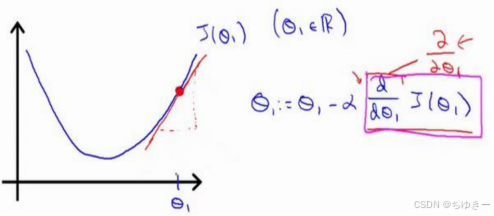
在这里插入图片描述
对于这个问题,求导基本上可以说取这个红点的切线,就是这样一条红色的直线,刚好与函数相切于这一点,看看这条红色直线的斜率正好是这个三角形的高度除以这个水平长度,现在,这条线有一个正斜率,也就是说它有正导数,因此,我得到的新的θ1,θ1 更新后等于θ1减去一个正数乘以a。

如果a太小或a太大会出现什么情况呢:
如果a太小了,即我的学习速率太小,结果就是只能这样像小宝宝一样一点点地挪动, 去努力接近最低点,这样就需要很多步才能到达最低点,所以如果a太小的话,可能会很慢, 因为它会一点点挪动,它会需要很多步才能到达全局最低点。
如果a太大,那么梯度下降法可能会越过最低点,甚至可能无法收敛,下一次迭代又移 动了一大步,越过一次,又越过一次,一次次越过最低点,直到你发现实际上离最低点越来越远,所以,如果a太大,它会导致无法收敛,甚至发散。

假设将θ1初始化在局部最低点,在这儿,它已经在一个局部的最优处。 结果是局部最优点的导数将等于零。这意味着你已经在局部最优点,它使得θ1 不再改变,也就是新的θ1等于原来的θ1 ,因此,如果你的参数已经处于局部最低点,那么梯度下降法更新其实什么都没做,它不会改变参数的值。这也解释了为什么即使 学习速率a保持不变时,梯度下降也可以收敛到局部最低点。

看一个例子:
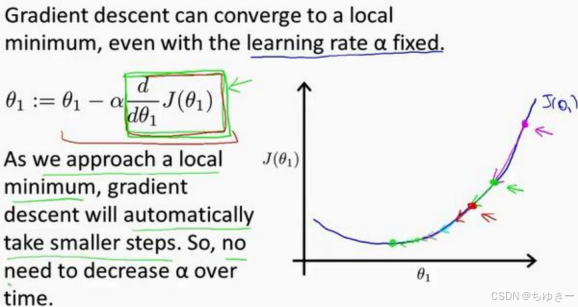
在这里插入图片描述
想找到它的最小值,首先初始化梯度下降算法,在那个品红色的点初始化,如果更新一步梯度下降,也许它会带我到这个绿点,因为这个点的导数是相当陡的。现在,在这个绿色的点,如果我再更新一步,你会发现我的导数,也即斜率,是没那么陡的。随着我接近最低点,我的导数越来越接近零,所以,梯度下降一步后,新的导数会变小一点点。然后我想再梯度下降一步,在这个绿点,我自然会用一个稍微跟刚才在那个品红点时比,再小一 点的一步,到了新的红色点,更接近全局最低点了,因此这点的导数会比在绿点时更小。所以,我再进行一步梯度下降时,我的导数项是更小的,θ1 更新的幅度就会更小。所以随着梯度下降法的运行,你移动的幅度会自动变得越来越小,直到最终移动幅度非常小,你会发现, 已经收敛到局部极小值。

所以当我们接 近局部最低时,导数值会自动变得越来越小,所以梯度下降将自动采取较小的幅度,这就是梯度下降的做法。所以实际上没有必要再另外减小a。

3.梯度下降的线性回归

梯度下降算法和线性回归算法比较如图:在这里插入图片描述对我们之前的线性回归问题运用梯度下降法,关键在于求出代价函数的导数,即:
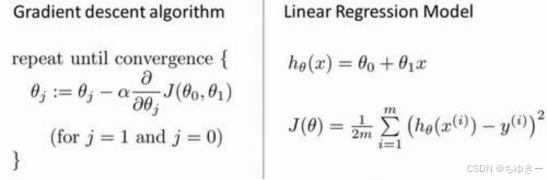
在这里插入图片描述
算法改写成:
在这里插入图片描述
刚刚使用的算法,有时也称为批量梯度下降。实际上,在机器学习中,通常不太会给算法起名字,但这个名字”批量梯度下降”,指的是在梯度下降的每一步中,我们都用到了所有的训练样本,在梯度下降中,在计算微分求导项时,我们需要进行求和运算,所以,在每一个单独的梯度下降中,我们最终都要计算这样一个东西,这个项需要对所有训练样本求和。因此,批量梯度下降法这个名字说明了我们需要考虑所有这一"批"训练样本,而事实上,有时也有其他类型的梯度下降法,不是这种"批量"型的,不考虑整个的训练集,而是每次只关注训练集中的一些小的子集。

应用刚刚学到的算法,你应该已经掌握了批量梯度算法,并且能把它应用到线性回归中了,这就是用于线性回归的梯度下降法。

梯度下降求最小值和线性方程(线性回归详解) 线性回归 梯度下降法一般用于求解最小值,以下分别例举两种求最小值情况: 1)二次函数求最小值的情况 2)预测线性函数的情况(已知x和y,求解最合适的w和b,是预测误差最小) 以下就按照上述的两种情况进行分析。 1、二次函数求最小值的情况 1)首先导入包 import numpy as np import matplotlib.pyplot as plt %matplotlib inline 2)定义二次函数与其导数方程,并画出函数图便于观察,也可以不画。 f = lambda x : x**2 -5*x 阅读详情

相关推荐

【深度学习原理】如何利用梯度下降法,寻找损失函数最小值?

梯度下降(Gradient Descent)是用于寻找函数最小值的一种优化算法。我们常常利用梯度下降法来使损失函数Loss function的值尽可能小,即让神经网络的预测值(实际输出)和标签值(预期的输出)尽可能接近。在这个过程中,网络参数——各层的权值与偏重将得到调整,这也正是神经网络的训练原理。可见熟悉梯度下降的原理对于理解神经网络相当重要。 本文将从损失函数概念、梯度下降原理 &...

hennyxu的博客 7912

梯度下降优化算法综述

本文翻译自Sebastian Ruder的“An overview of gradient descent optimization algoritms”,作者首先在其博客中发表了这篇文章,其博客地址为:An overview of gradient descent optimization algoritms,之后,作者将其整理完放在了arxiv中,其地址为:An overview of grad

null的专栏 5万+

吴恩达机器学习之单变量线性回归(二):梯度下降、梯度下降的直观理解、梯度下降的线性回归(详细笔记,建议收藏专栏)

吴恩达机器学习栏目清单 文章目录单变量线性回归(Linear Regression with One Variable)2.5 梯度下降2.6 梯度下降的直观理解2.7 梯度下降的线性回归2.8 接下来的内容 单变量线性回归(Linear Regression with One Variable) 2.5 梯度下降 参考视频: 2 - 5 - Gradient Descent (11 min)....

汪雯琦的博客 744

梯度下降算法(Gradient descent)

人工智能基础算法 梯度下降算法Gradient descent

醉蕤的博客 3万+

一种车内UWB圆极化天线的理论推导及具体实现

本文详细描述了一款工作于UWB channel 9也即中心频率为7987.2MHz,带宽为499.2MHz的圆极化天线。首先是理论推导圆极化天线的物理尺寸参数,分析物理尺寸参数对天线性能指标的影响。然后分析圆极化天线在汽车驾驶室这种狭窄空间应用中带来的优势,也即可以最大化的极化损失多径,提高主径接收信号的信噪比。

weixin_44555637的博客 2957

告别手动复制粘贴!用R语言脚本批量抓取TCMSP中药靶点基因(附完整代码)

本文介绍如何使用R语言脚本自动化抓取TCMSP数据库中的中药靶点基因数据,告别手动复制粘贴的低效操作。通过详细的代码示例和参数设置,帮助研究人员快速获取并过滤符合药代动力学标准的中药成分及其靶点基因,大幅提升研究效率。特别适合生物信息学和中药现代化研究领域的从业者。

weixin_26950847的博客 261

吴恩达机器学习笔记:多变量梯度下降

这个公式中有个n+1参数和个n变量,为了使得公式能够简化一些,引入x0=1 则公式转化为:ℎθ (x) = θ0x0 + θ1x1 + θ2x2 +. . . +θnxn。此时模型中的参数是一个n + 1维的向量,任何一个训练实例也都是n + 1维的向量公式可以简化为:ℎθ(x) = θᵀX其中上标T代表矩阵转置。之前我们探讨了单变量/特征的回归模型,现在我们对房价模型增加更多的特征,例如房间数楼层等,构成一个含有多个变量的模型,模型中的特征为。

projectfailed的博客 757

如何在Ubuntu 22.04上为AlphaFold3配置NVIDIA A100 GPU(含驱动安装避坑指南)

本文提供了在Ubuntu 22.04系统上为AlphaFold3部署NVIDIA A100 GPU的完整安装教程。内容涵盖从系统环境准备、NVIDIA驱动安装与避坑指南,到Docker容器化部署、数据库获取以及最终构建运行AlphaFold3的详细步骤,旨在帮助研究者和开发者高效配置高性能计算环境,充分发挥A100的硬件潜力。

nft7creator的博客 468

吴恩达机器学习之大规模机器学习(Large Scale Machine Learning):大型数据集的学习、随机梯度下降法、小批量梯度下降、映射化简和数据并行(详细笔记,建议收藏,已有专栏)

吴恩达机器学习栏目清单 专栏直达:https://blog.youkuaiyun.com/qq_35456045/category_9762715.html 文章目录17.大规模机器学习(Large Scale Machine Learning)17.1 大型数据集的学习17.2 随机梯度下降法17.3 小批量梯度下降17.4 随机梯度下降收敛17.5 在线学习17.6 映射化简和数据并行 17.大规模机器学...

汪雯琦的博客 694

基于Dify与DeepSeek构建中医智能问答工作流:从知识库到精准处方

本文详细介绍了如何利用Dify与DeepSeek构建中医智能问答工作流,实现从知识库构建到精准处方的全流程。通过模型编排和知识检索技术,系统能够结合中医辨证思维与AI推理能力,为基层医师、学生和爱好者提供结构化诊疗建议。文章重点分享了知识库选材、症状标准化处理、智能检索与辨证推理等核心环节的实战经验。

weixin_29062255的博客 251

避开PSRR仿真三大坑:用Cadence psspxf分析分频器时,这些设置错了白忙活

本文深入探讨了使用Cadence psspxf工具进行分频器PSRR仿真时常见的三大技术陷阱,包括扰动信号参数设置、收敛性优化和后处理信号提取。通过详细的参数推荐和实战技巧,帮助工程师避免仿真误差,提升PSRR分析效率与准确性,特别适用于16分频器等数字-模拟混合电路设计。

weixin_29258297的博客 300

吴恩达机器学习课程笔记:多元梯度下降法

简单了解特征缩放的方法,多元梯度下降算法

一个搬运知识的笨小孩 992

UniApp 覆盖安装后首次进入 APP pages.json 不生效的解决方案

通过以上步骤,解决了缓存问题导致的首次加载异常。此方案的关键在于强制更新文件名,从根本上避免旧缓存的干扰。

代码简单说 Vue、JAVA、PHP、Node.js 熟练运用,接口、架构、性能全搞定。 681

吴恩达《Machine Learning》精炼笔记 2:梯度下降与正规方程

作者 | Peter编辑 |AI有道今天带来第二周课程的笔记:梯度下降与正规方程。主要内容:多维特征多变量梯度下降梯度下降法实践正规方程多维特征Multiple Features还是利...

红色石头的专栏 824

从零开始跑通3DGS教程:(五)3DGS训练

本文介绍了在Docker环境中训练3DGS(3D Gaussian Splatting)的方法,属于《从零开始跑通3DGS教程》系列文章的第五部分。主要内容包括:Docker环境准备(基于pytorch/pytorch:1.13.1-cuda11.6-cudnn8-runtime镜像)、容器内conda环境配置(安装必要依赖和3DGS相关组件)、以及训练命令执行步骤。文章提供了详细的命令行操作流程,帮助读者快速搭建3DGS训练环境。适合在Linux系统、Nvidia GPU环境下使用,完整教程可参考系列文章

诺有缸的高飞鸟的博客 1749

2、微软 Power Automate 入门指南

本文是一篇关于微软 Power Automate 的入门指南,详细介绍了 Power Automate 的基本概念、相关术语、登录方式以及如何创建一个简单的自动化流。文章还探讨了 Power Automate 在业务流程中的应用场景和优势,并展望了其高级功能和未来发展。适合希望快速入门 Power Automate 并提升业务自动化效率的读者。

corn8的博客 440

吴恩达机器学习课程笔记:梯度下降法

简要了解梯度下降法的原理

一个搬运知识的笨小孩 710

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

吴恩达机器学习笔记:多维梯度下降实践

以房价问题为例,假设我们使用两个特征,房屋的尺寸和房间的数量,尺寸的值为 0- 2000 平方英尺,而房间数量的值则是 0-5,以两个参数分别为横纵坐标,绘制代价函数的等高线图能看出图像会显得很扁,梯度下降算法需要非常多次的迭代才能收敛。梯度下降算法收敛所需要的迭代次数根据模型的不同而不同,我们不能提前预知,我们可以绘制迭代次数和代价函数的图表来观测算法在何时趋于收敛。梯度下降算法的每次迭代受到学习率的影响,如果学习率a过小,则达到收敛所需的迭代次数会非常高;其中 μn 是平均值,sn 是标准差。

projectfailed的博客 574

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

2022吴恩达机器学习(Deep learning)课程对应笔记12:梯度下降3

下面是具体实现梯度下降算法。w和bw和bw和bww−α∂∂wJwbww−α∂w∂​Jwbbb−α∂∂bJwbbb−α∂b∂​Jwb其中α\alphaα是学习率,我们要同时更新w和bw和bw和b来是模型不断下降。同时更新w和bw和bw和btempww−α∂∂wJwbwtempww=temp\_wtempww−α∂w∂​。

bubu_的博客 145

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

2022吴恩达机器学习(Deep learning)课程对应笔记17:多元回归的梯度下降法

首先要统一一下符号说明。就是向量化后的多元回归的符号表示。下面是比较一下只有一个特征的线性回归和有多个特征的多元回归之间的梯度下降的区别。

bubu_的博客 156

吴恩达机器学习笔记:(四)矩阵、多元梯度下降

矩阵基础知识 矩阵逆运算 矩阵的转置 实践陈发:乘法 多元梯度下降 特征缩放 学习率α 学习率的选择:

weixin_44322778的博客 423

python解zuobiaoxi方程_吴恩达《Machine Learning》精炼笔记 2:梯度下降与正规方程

作者:Peter红色石头的个人网站:红色石头的个人博客-机器学习、深度学习之路​www.redstonewill.com今天带来第二周课程的笔记:梯度下降与正规方程。主要内容:多维特征多变量梯度下降梯度下降法实践正规方程多维特征Multiple Features还是利用房价模型的例子,增加了更多的特征,比如:房间楼层、房间数量、地理位置等,构成了一个含有多个变量的模型n:代表的是特征的数量x(i)...

weixin_39645165的博客 170

2022吴恩达机器学习(Deep learning)课程对应笔记14:线性回归中的梯度下降

回忆一下我们之前讲到的章节,线性回归模型fwbxwxbfwb​xwxb损失函数是Jwb12m∑i1mfwbxi−yi2Jwb2m1​∑i1m​fwb​xi−yi2梯度更新方式,重复下面的式子,直到收敛(即梯度为0,∂∂wJw0∂w∂​Jw0ww−α∂∂wJwb→1m∑i1mfwbxi−yixiww−α∂w。

bubu_的博客 209

吴恩达机器学习笔记1:机器学习的简介,分类,单变量线性回归,梯度下降

目录 机器学习是什么 机器学习的分类 监督学习 Supervised Learning 无监督学习Unsupervised Learning 单变量线性回归 Linear Regression with One Variable 符号说明 代价函数 梯度下降Gradient Descent 思想 批量梯度下降 Batch Gradient Descent 线性代...

mxb1234567的博客 316

2022吴恩达机器学习(Deep learning)课程对应笔记11:梯度下降2

下面是具体实现梯度下降算法。w和bw和bw和bww−α∂∂wJwbww−α∂w∂​Jwbbb−α∂∂bJwbbb−α∂b∂​Jwb其中α\alphaα是学习率,我们要同时更新w和bw和bw和b来是模型不断下降。同时更新w和bw和bw和btempww−α∂∂wJwbwtempww=temp\_wtempww−α∂w∂​。

bubu_的博客 198

吴恩达机器学习笔记:(三)梯度下降法

梯度下降法 知识点: 偏导数、微积分、局部最优解 概念介绍 梯度下降法目的是为了“下降”,下降的方法是按照“梯度”。比如你在一座山上,当前你只能迈出一步,如何走才能使你的高度下降的最多呢,根据梯度的理论,我们沿着当前梯度的反方向走,会让我们的下降幅度最大。 上述例子中,山就是一个函数,在山上的你就是函数中待优化的变量,人的坐标表示变量初始值,我们要 求的是函数最小值即到达山底,人该如何走即如何迭代变量。所以我们只要沿着函数梯度的反方向,就能最快的到达我们要去的地方。 梯度下降是一种更新参数的方

weixin_44322778的博客 510
上一篇: 吴恩达机器学习笔记:代价函数
下一篇: 吴恩达机器学习笔记:多变量梯度下降
ちゆきー
博客等级 码龄4年 324粉丝 62原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值