堆排序(headSort)

堆排序-Head Sort 堆排序的思路与C++具体实现 阅读详情

堆排序(headSort)

定义

按照惯例我们先来点入门的知识点,这样方便大家理解后面的知识点。
按照百科的说法,堆排序是指利用堆积树这种数据结构所设计的一种排序算法,但对于没有接触这个算法的人来说,会误以为是需要将数组转化为一种树型结构再进行排序,但其实并不是如此,堆排序只是利用树的性质,并利用数组的特点快速定位指定索引位置。
举个例子:
数组 【1,2,3,4,5,6】,长度为len=6
我们可以把它看作是一棵完全二叉树的存储结构

这里写图片描述
那么对于任何非叶子结点(1,2,3)来说,它们的左、右子结点为 i*2 , i*2+1 (如果存在);
最后一个非叶子结点就是len/2;
比如结点i=1的左孩子结点为 1*2=2, 右孩子结点为 1*2+1=3 。最后一个非叶子结点为 6/2=3;

  • 注意这里是下标从1开始,如果下标从0开始,即【0,1,2,3,4,5】,那么非叶子结点的左右子结点为 *i*2+1 , i*2+2 ;最后一个非叶子结点则为len/2-1;

堆排序

理解完上面这些,再来学习堆排序就相对简单多了。
我先讲一下堆排序思路:

1、构造最大堆(最小堆)
首先,构造最大堆(或最小堆),最大堆要求父结点不小于其左右子结点(最小堆就是父结点不大于其左右子结点),举个例子吧,看下图,图1是最大堆,图2是最小堆

这里写图片描述这里写图片描述
如何构造最大堆?从最后一个非叶子结点开始,从右往左,从下往上遍历结点,每一个结点都与其左右子结点相比较(如果存在),如果父结点的值小于其子结点的值 ,则将父结点与子结点的位置进行调换。遍历完之后,数组中的最大值就会被移动到堆顶。

2、把堆顶元素与最后一个元素互换位置,对前len-1个元素重新进行构造最大堆。

把堆顶元素与最后一个元素互换位置,对剩余前len-1个元素重新进行构造最大堆,重新此过程直到只剩下最后一个元素,这时候数组就已经排序完成。

举个粟子吧

数组【16,7,3,20,17,8】,len=6
先把它看成一棵完全二叉树
这里写图片描述
接下来我们进行构造最大堆,首先从最后一个非叶子结点(3)开始,3比8小,将3跟8交换位置
这里写图片描述 —–》这里写图片描述
然后我们再看倒数第二个非叶子结点(7),7 < 16 < 20 ,7跟20交换位置
这里写图片描述 —–》这里写图片描述
第2层的非叶子结点已经遍历完,接下来再往上找非叶子结点,看16,16 < 20 ,所以16跟20交换位置
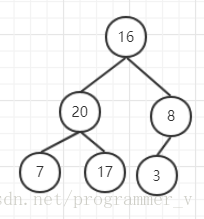
这里写图片描述 ——》这里写图片描述
这样最大值已经移动到了堆顶,将堆顶元素与最后一个元素交换位置,重新构造前len-1位元素(即【3,16,8,7,17】,len=5)的最大堆,再与第len位元素交换位置。
这里写图片描述

例子是参考这位老哥的:https://www.cnblogs.com/0zcl/p/6737944.html

最后给上用java实现的代码

package 算法题;/**
 * Created by VLoye on 2018/7/26.
 */

/**
 * @author VLoye
 * @ClassName HeapSort
 * @Description
 * @Date 11:50  2018/7/26
 * @Version 1.0
 **/
public class HeapSort {

    private static void heapSort(int[] arr) {
        int len = arr.length ;
        //len/2-1 即最后一个有孩子的结点
       makeHeap(arr,len);
        len--;
        while (len >=0){
            swap(arr,0,len);    //将堆顶元素与尾节点交换后,长度减1,尾元素最大
            makeHeap(arr,len--);    //再次对堆进行调整
        }
    }
    //构造堆  自下往上
    public static void makeHeap(int[] arr,int len){
        for(int i = len/2 - 1; i >=0; i --){ //堆构造,自下往上
            heapAndjust(arr,i,len);
        }
    }
    //被makeHeap调用
    public static  void heapAndjust(int[] arr,int i,int len){
        int left,right,j ;
        while((left = 2*i+1) < len){    //判断当前父节点有无左节点(即有无孩子节点,left为左节点)
            if((right=left+1) >= len)
                right = left;
            j = left;   //j"指针指向左节点"
            if(j < len && arr[left] < arr[right])    //右节点大于左节点
                j ++;     //当前把"指针"指向右节点
            if(arr[i] < arr[j])    //将父节点与孩子节点交换(如果上面if为真,则arr[j]为右节点,如果为假arr[j]则为左节点)
                swap(arr,i,j);
            else         //说明比孩子节点都大,直接跳出循环语句
                break;
            i = j;
        }
    }

    public static  void swap(int[] arr,int i,int len){
        int temp = arr[i];
        arr[i] = arr[len];
        arr[len] = temp;
    }

    public static void main(String[] args) {
        int array[] = {20,50,20,40,70,10,80,30,60,90};
        int array2[] ={16,7,3,20,17,8};
        System.out.println("排序之前:");
        for(int element : array2){
            System.out.print(element+" ");
        }
        heapSort(array2);
        System.out.println("\n排序之后:");
        for(int element : array2){
            System.out.print(element+" ");
        }
    }
}

其实理解了也不是很难,就是 重复构造最大堆,交换堆顶跟最后一位元素的位置,直到堆只有一个元素。

headsort:headsort:流式排序+比gnu排序快2倍-开源 headsort按行和字段对文件排序。 选项可以选择字段顺序等。通常与gnu sort(1)兼容。 它还有几种尝试的排序算法。 通常,在涉及管道或多列选择的情况下,headsort的排序时间是sort(1)(mergesort)的1/2。 两者均小于1/2。 最好的情况与sort(1)*相反。 NEW * hsort主要算法速度提高(适用于全部; 27、29、31)。 现在比sort(1)更快(在所有情况下都经过测试)。 使用三角剖分,当第一个bin完成后,hsort开始通过管道排序输出。 这意味着它在分布式计算中有新的应用,在某些情况下,不需要直流电。 (gnu sort必须完成所有bins)与gnu sort很好兼容(大多数不应复制到sort二进制文件上)。 如果使用菜单,则还具有其他算法:冒泡,选择,插入,外壳,分配计数,直基数,基数交换,快速,合并。 (有些是按字符显示的,有些是按行显示的,有些是两者都显示的) 立即下载

相关推荐

文章详细介绍了进行DoIP(DiagnosticoverInternetProtocol)测试的完整过程,包括样件的正确接线、CANoe软件的环境配置、端口设置、VLAN配置、IP和MAC地址的设定

关于Tester和DUT的地址,其实最主要的就是DUT的IP、MAC和逻辑地址,如果不知道Tester的IP、MAC和逻辑地址,可以配置为与DUT同一网段的就可以。ps:最重的是知道DUT的IP、逻辑、MAC地址,如果有VLAN也需要知道,Tester的地址可以根据DUT地址进行设定,其余的值可根据DoIP的报文查到相关参数。ps:如果在通信中没有建立VLAN,但是源地址和目的地址都填写正确,此时就要考虑是否是遗漏了VLAN,建立一个VLAN,在重新试试是否可通信。此处与硬件连接是相对应的,要注意!

qq_40965861的博客 1130

无聊写排序之 ---- 堆排序(HeadSort)

还记得之前说的选择排序么?忘记了看这里选择排序>。 选择排序i时,我们需要从n-i+1个序列中选择一个最小的数字, 那么势必就要比较多次来寻找到最小的那一个元素从而来进行排序,这种排序虽然相对于冒泡排序有效的减少了交换所带来的开销,但是多次比较对于比较的结果却没有进行记录,当排序第1个数字的时候需要从第1.....n中找到最小的数字进行和第1个进行比较交换,当我们需要排序第2个数字时,同样需要将上

尜尜君的小世界 969

MAX96712在车载摄像头系统中的带宽分配与传输能力计算解析

在计算摄像头带宽与传输接口的关系时,需要考虑视频流的像素分辨率、帧率、颜色深度等因素。以 MAX96712 这种 GMSL2 产品为例,它支持每个链路在正向方向以 3Gbps 或 6Gbps 的固定速率工作。

weixin_43199439的博客 3330

学习回顾算法(堆排序算法)

堆排序算法简介堆排序(Heapsort)是指利用堆积数(堆)这种数据结构所设计的一种排序算法,它是选择排序的一种。可以利用数组的特点快速定位指定索引的元素。堆分为大根堆和小根堆,是完全二叉树。大根堆要求是每个节点的值都不大于其父节点的值。在数组的非降序排序中,需要使用大根堆。因为最大值一定在堆顶。堆排序原理堆排序利用了大根堆(或小根堆)堆顶记录的值最大(或最小)这一特征。 一、用大根堆排序的基本思

课前的博客 502

从SFF-8087到SFF-8643:详解服务器硬盘背板连接线缆的演变与实战接线

本文深度解析了服务器硬盘背板连接技术从SFF-8087到SFF-8643的演进历程,重点介绍了SAS、SATA和U.2接口的技术特点与实战接线方案。通过对比不同连接器标准的物理特性和电气规范,提供了混合环境下的线缆选择策略和常见故障排查指南,帮助IT专业人员优化存储系统性能与稳定性。

weixin_30603633的博客 278

国科大作业考试资料《人工智能原理与算法》2024新编-第二次作业整理

1、对于下列活动,分别给出任务环境的PEAS描述, 并按2.3.2节列出的性质进行分析: 3、为图2.2中描述的吸尘器世界实现一个可以进行性能度量的环境模拟器。你的实现是必须是模块化的,以使传感器、执行器和环境特征(大小、形状、灰尘放置等)便于修改。 4、实现上述题目真空吸尘器环境中的简单反射Agent。用所有可能的初始灰尘分布和Agent位置,运行环境模拟器和Agent。记录Agent在每种情况下的性能评分和总体平均评分。

MatsumotoChrikk 1187

大顶堆、小顶堆、堆排序

堆的定义:      n个元素的序列{k1,k2,…,kn}当且仅当满足下列关系之一时,称之为堆。      大顶堆:ki >= k2i 且ki >= k2i+1。      小顶堆:ki 2i 且ki <= k2i+1。       堆序列可以理解成一个完全二叉树,该树任意一个结点的关键字的值都小于或等于它的孩子结点的关键字。例如:        堆排序:   若在

yangling098的专栏 2231

Qemu开发ARM篇-5、buildroot制作根文件系统并挂载启动

在上一篇中,我们编译了kernel,并在qemu上进行了运行,但到最后,在挂载根文件系统时候,挂载失败,这是因为我们还没有根文件系统,在本章中,我们将制作根文件系统。rootfs制作方式有很多方式,如busyBoxbuildrootYocto等,在该篇章中,我们使用buildroot来制作根文件系统,主要考虑到busyBox制作完还需要手动首改一些启动配置比较繁琐,而Yocto如果电脑配置不是很好,编译时间过长,比较麻烦。

sinat_33909696的博客 2465

shell常用命令面试总结(涉及head、tail、cut、sort、wc命令用法、四种变量命名方式及特点、全局,本地,内置变量特点)(一)

今日状态:充充实实 打卡学习 星期一 星期二 星期三 星期四 星期五 星期六 星期日 成功 成功 成功 成功 成功 成功 成功 成功 shell常用命令 🌙1、head:默认获取文件前10行 head -3 文件:获取文件前3行内容 🌙2、tail:默认获取文件的后10行 1、tail -2 文件:获取文件的最后2行 2、tail -f 文件:跟踪日志 3、获取文件的第4到8行:head -8 file | tail 5 🌙3、cut:截切、取出文本中指定的列、默认以空格或者tab键..

python全栈 3654

零基础入门simulink仿真建模--通信领域的编码与纠错技术--基于Simulink的CRC校验算法仿真建模示例

CRC是一种广泛应用于数字网络和存储设备中的错误检测码。它的基本原理是利用除法运算来产生固定长度的校验位,这些校验位被附加到原始数据之后发送出去。接收端收到数据后,重新计算校验值并与接收到的校验值进行比较,如果两者相同,则认为数据没有错误;否则,表示数据可能已被损坏。发送端:随机比特生成模块 + CRC生成模块。信道:模拟数据传输过程中的潜在错误(可选)。接收端:CRC校验模块 + 错误指示模块。通过本指南,我们介绍了如何基于Simulink搭建一个简单的CRC校验系统模型,并进行了仿真分析。

amy_mhd的博客 730

27、单阶段目标检测算法(SSD):原理、训练与实战

本文详细介绍了单阶段目标检测算法SSD的原理、训练方法与实战应用。内容涵盖SSD的核心机制,如特征图离散化、边界框预测、损失函数设计及难负样本挖掘,并通过使用dlib车辆数据集从零开始训练SSD模型的完整流程展示了实际操作步骤。文章还讨论了训练中的关键问题,如边界框坐标处理和‘忽略区域’缺失的影响,提供了模型评估与优化策略,包括超参数调整、基础网络替换和数据增强。最后总结了SSD的优势与局限性,并展望了未来目标检测技术的发展方向。

nice1的博客 505

选择排序——堆排序、直接选择排序

选择排序——堆排序、直接选择排序

qq2127189274的博客 88

常用元器件使用方法3:电平转换芯片74LVC1T45的使用方法

介绍: 74LVC1T45是一个单位双向可控电平转换芯片。   芯片特性: 1、宽供给电压范围:1.65V到5.5V; 2、3.3V时,可输出24mA电流; 3、最大16uA电能损耗; 4、高噪音抑制;   型号:   引脚: VCC(A) 1 A端和DIR电源 GND 2 地 A 3 数据输入/输出 B 4 ...

snmplink的博客 1万+

堆排序-减治法

注意,C++语言的数组下标是从0开始,则r[i]的左子树是r[2i+1],右子树是r[2i+2]; #include<stdio.h> #include <iostream> #include<iomanip> using namespace std; void SiftHeap(int r[],int k,int n){ int i,j,temp; i=...

weixin_42395580的博客 1883

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

Leetcode算法--堆排序

堆排序思路和代码实现

j18874964028sss的博客 1181

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

堆排序简介

1.基本思想: 堆排序(Head sort)就是利用堆(假设利用大顶堆)进行排序的方法。他的基本思想如下: 将待排序的序列构造成一个大顶堆。此时,整个序列的最大值就是堆顶的根结点,将他移走(其实就是将其与堆数组的末尾元素交换,此时末尾元素就是最大值),然后将剩余的n-1 个序列重新够造成一个堆,这样就会得到n个元素中的值,如此反复便会得到一个有序序列。 问题: 1、如何由一个无序序列构建一个大顶堆? 2、如果在输出堆顶元素后,调整剩余元素成为一个新的堆。 2、代码演示 /*对顺序表L进行堆排序*/ voi

shassd的博客 255

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

堆排序详解(c语言和java完整代码)

堆排序详解首先来看headify函数heapify:堆调整bulid_head:从最后一个父节点开始构建堆headsort:开始实现堆排序java完整实现代码 首先来看headify函数 heapify:堆调整 1,针对结点 i,将其两个子节点找出来,此三个结点构成一个最小单位的完全二叉树(越界的忽略) 2,找到这个最小单位的完全二叉树 的最大值,并将其交换至父节点的位置 3,递归调用,维护交换后 子节点与其子结点被破坏的堆关系,递归出口为叶节点 4,结果,构造一个最小单位的完全二叉树对应的堆 void h

weixin_44623752的博客 402

最大/最小堆排序

void swap(int *arr, int a, int b){//交互两个数的位置 int temp = arr[a]; arr[a] = arr[b]; arr[b] = temp; } void BuildMaxHeap(int *arr, int i, int n){//建立大顶堆,进行调整 int parent = arr[i], j; fo

风儿-zsj的专栏 394

堆排序

排序

qiandididi的博客 143

十大经典排序之:选择排序 |堆排序

十大经典排序之:选择排序 |堆排序选择排序选择排序原理算法实现例题堆排序堆排序原理算法实现例题

菜菜bu菜的博客 1612

堆排序思想及代码实现

```java import java.io.*; import java.util.*; /** * 堆排序的思想:先初始化一个大顶堆,在对剩下的元素再使用堆排序。 * * 注意数组下标从0开始,左孩子就为2*index+1了,总长度n=n-1 */ public class Heap { static void sift(int[] R,int low,int high) { int i=low,j=2*i+1; int temp=R[.

ZYF__2015的博客 284

堆排序学习、Java代码实现

堆排序(HeadSort)只需要一个记录大小的辅助空间,每个待排序的记录仅占有一个存储空间。 堆的定义:n个元素的序列 {k(1),k(2),... k(n)} ,当其满足k(i)<=k(2*i)&& k(i)<= k(2*i+1)或者k(i)>=k(2*i) && k(i)>= k(2*i+1),称这个序列为堆。 i...

学习笔记 478

经典排序之 堆排序

下面来说一下堆排序,这个有点复杂; 堆是一种数据结构,可以把它看成一棵完全二叉树,这棵完全二叉树满足任何一个非叶子节点的值都不大于或不小于其左右孩子节点的值,分别叫做大顶堆和小顶堆。 算法思想:   堆排序的算法分为两步:建立堆和排序; 1)建堆:     将序列调整为大顶堆,每一次都是父节点和子节点进行比较然后进行调整;   2)排序:     在已经建好的大顶...

aaa520288的博客 135
上一篇: 数据库索引个人笔记
下一篇: git 协作开发流程
VLoye
博客等级 码龄10年 9粉丝 9原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
